Strzałka na strzałce
Definicję i wzór modelu z iloczynem znajdziesz w haśle moderacja, a pełną procedurę – we wpisach analiza moderacji krok po kroku, moderacja w jamovi i mediacja i moderacja w SPSS z PROCESS. Tu pokazujemy na rysunkach, jak wygląda moderacja: zależność X → Y, której nachylenie zmienia się wraz z trzecią zmienną W. Na diagramie to strzałka wbita w strzałkę, na wykresie – wachlarz prostych.
Przykład jest fikcyjny. Trzystu pracowników oceniło obciążenie pracą (X, skala 1–7), autonomię w pracy (W, 1–7) i wyczerpanie emocjonalne (Y, 0–40). Hipoteza: autonomia osłabia związek obciążenia z wyczerpaniem. Parametry populacji ustaliliśmy ręcznie tak, by interakcja była wyraźna, a granica obszaru istotności wypadła w zakresie danych (nachylenie 1.5 przy średniej autonomii, interakcja −0.6, SD błędu 5). Ziarno 596 ustalono raz i nie zmieniano go. Dane pobierzesz jako moderacja-wizualizacja-dane.csv. W próbie: obciążenie M = 3.95 (SD = 1.19), autonomia M = 4.35 (SD = 1.34), wyczerpanie M = 20.18 (SD = 5.22). Interakcja: b = −0.68, SE = 0.17, t(296) = −4.01, p < .001. Dodanie iloczynu podniosło R² z .228 do .268 (ΔR² = .040).
Rysunek 1: proste nachylenia przy trzech wartościach autonomii
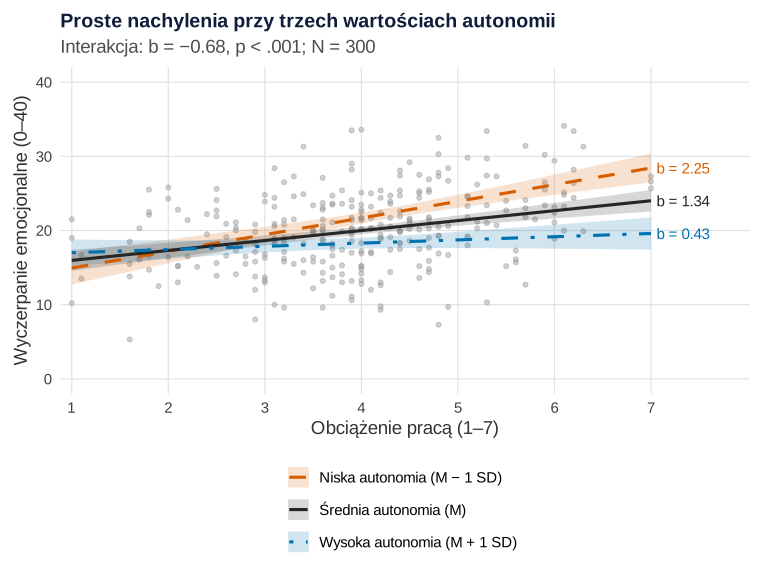
set.seed(596)).Co widać. Trzy proste nachylenia obciążenia przy autonomii M − 1 SD (3.00), M (4.35) i M + 1 SD (5.69). Przy niskiej autonomii każdy punkt obciążenia to średnio 2.25 punktu wyczerpania więcej (95% CI [1.60, 2.89]), przy średniej – 1.34 [0.90, 1.79], a przy wysokiej – tylko 0.43 [−0.18, 1.05], t(296) = 1.38, p = .168. Linie nie są równoległe – to cały obraz interakcji.
Czego ten wykres nie pokazuje. Trzy linie to trzy arbitralne punkty na ciągłym moderatorze. Spiller i in. (2013) zalecają efekty proste przy wartościach ważnych merytorycznie, a gdy takich nie ma – podanie zakresu, w którym efekt jest istotny (rysunek 2). Typy interakcji (porządkująca, krzyżowa) opisuje hasło wykres interakcji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: efekt warunkowy i obszar Johnsona–Neymana
Zamiast trzech punktów rysujemy nachylenie obciążenia przy każdej wartości autonomii, czyli efekt warunkowy b1 + b3·W, z 95% przedziałem ufności. Granice przedziału Johnsona–Neymana to wartości W, przy których przedział dotyka zera.
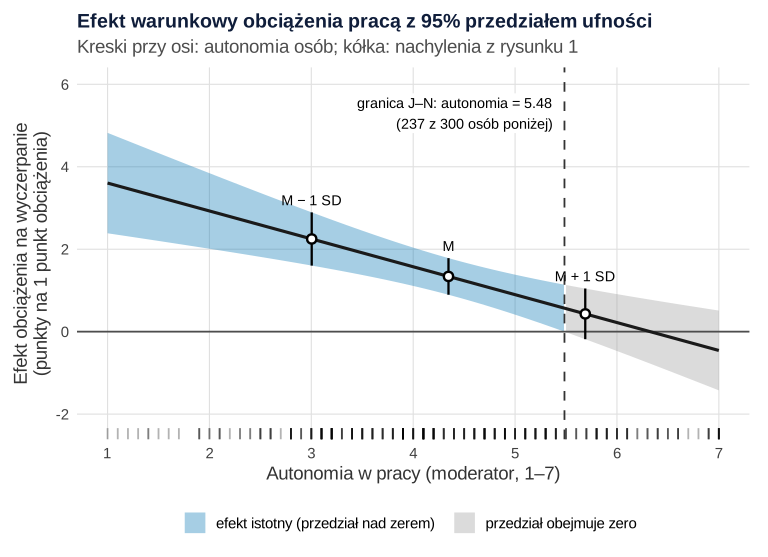
Co widać. Efekt obciążenia maleje liniowo: 2.93 przy autonomii 2, 1.57 przy 4, 0.22 przy 6 (p = .529) i −0.46 przy 7. Granica wynosi 5.48. Poniżej niej przedział ufności leży w całości nad zerem, a takich osób jest 237 z 300 (79%). Drugie rozwiązanie równania (8.39) leży poza skalą, więc go nie interpretujemy. Kółka to proste nachylenia z rysunku 1 – trzy przekroje tej samej linii. Bauer i Curran (2005) opisują technikę Johnsona–Neymana jako ogólniejszą od testowania prostych nachyleń w wybranych punktach. Własny model policzysz w kalkulatorze Johnsona–Neymana.
Czego ten wykres nie pokazuje – i jak może zmylić. Model z iloczynem wymusza, by efekt zmieniał się liniowo. Hainmueller i in. (2019) pokazali, że w opublikowanych analizach to założenie często zawodzi, a efekty warunkowe tam, gdzie brakuje obserwacji, wprowadzają w błąd. Dlatego kreski przy osi są obowiązkowe: przy autonomii 6–7 jest niewiele osób, a „ujemny efekt” przy 7 to ekstrapolacja. „Nieistotny” obszar nie znaczy też „brak efektu” – przedział przy autonomii 6 sięga od −0.47 do 0.91.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: mapa przewidywań – wachlarz zamiast pasów
Model z dwiema zmiennymi ciągłymi to powierzchnia nad płaszczyzną X × W. Rysujemy ją z góry: kolor to przewidywane wyczerpanie, białe linie – poziomice.
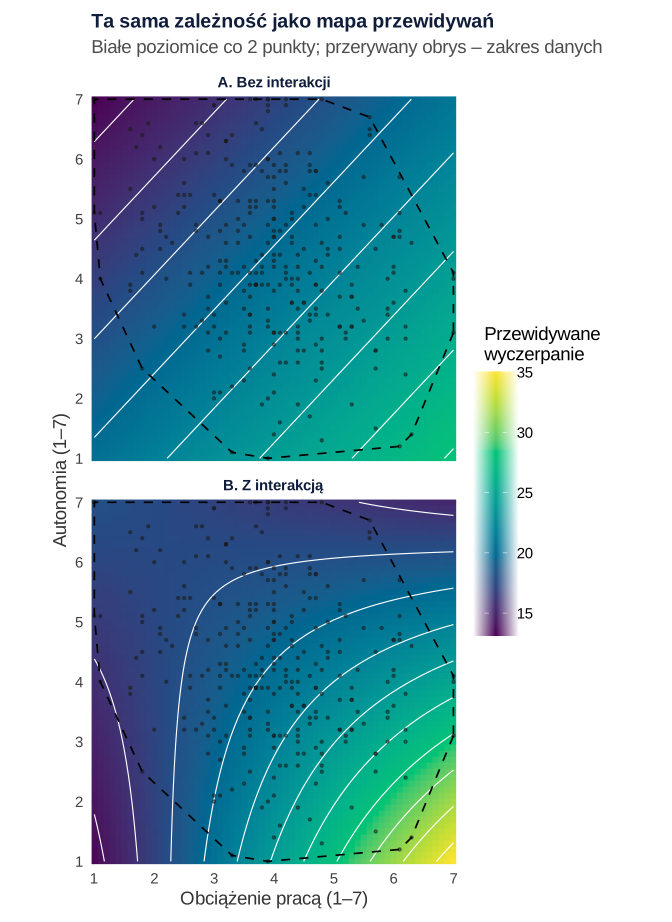
Co widać. W modelu bez interakcji poziomice są równoległymi prostymi: wzrost obciążenia o punkt wszędzie dodaje tyle samo. W modelu z interakcją poziomice rozchodzą się w wachlarz. Przy niskiej autonomii biegną pionowo i gęsto (każdy krok w prawo zmienia wynik), a przy wysokiej – prawie poziomo i rzadko (krok w prawo prawie nic nie zmienia). Różnicę widać w rogach: przy obciążeniu 7 i autonomii 1 model bez interakcji przewiduje 28.2 punktu, a model z interakcją 35.0. Przy obciążeniu 1 i autonomii 1 jest odwrotnie: 20.4 wobec 13.4.
Czego ten wykres nie pokazuje. Tych rogów nie ma w danych: nikt w próbie nie ma obciążenia i autonomii jednocześnie ≥ 6 ani jednocześnie ≤ 2. Najbardziej efektowne kolory to ekstrapolacja, a obrys (otoczka wypukła) jest hojny. Mapa nie pokazuje też niepewności – to ilustracja, nie dowód.
Podpis do pracy (np. w aneksie lub prezentacji na obronę):
Zdanie do Dyskusji:
Rysunek 4: moderator dwuwartościowy – praca zmianowa
Drugi zbiór fikcyjny: 200 pracowników, w tym 76 na zmiany i 124 bez zmian. Moderator ma dwie wartości (0 = bez zmian, 1 = zmianowa), więc proste nachylenia to dwie proste. Parametry ustawiono ręcznie: nachylenie 1.0 bez zmian i 2.6 na zmiany (ziarno 596, osobny blok kodu).
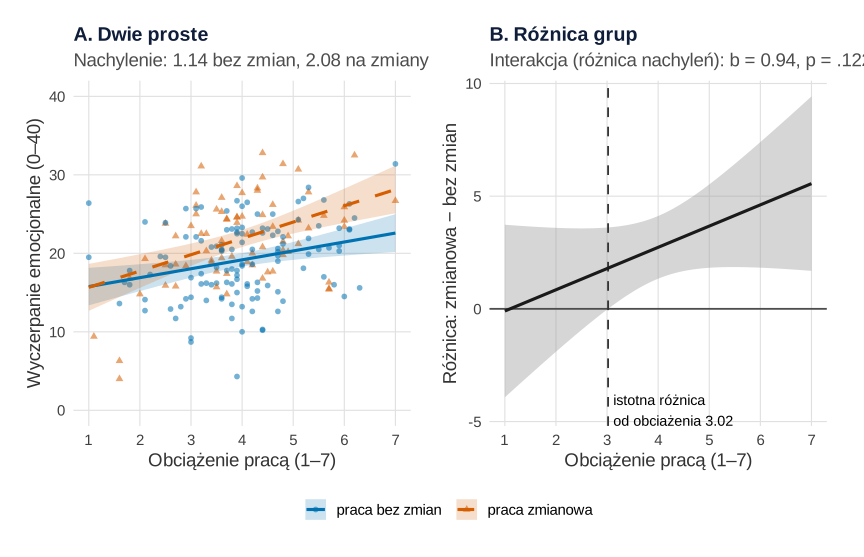
set.seed(596)).Co widać. Przy kodowaniu 0/1 współczynnik obciążenia to nachylenie w grupie „bez zmian”: 1.14, 95% CI [0.39, 1.88]. Współczynnik iloczynu to różnica nachyleń: na zmiany nachylenie wynosi 2.08 [1.14, 3.01], czyli o 0.94 więcej, ale t(196) = 1.55, p = .122. Panel B pokazuje tę samą interakcję od drugiej strony – obciążenie moderuje różnicę grup. Różnica wynosi 0.85 [−1.90, 3.60] przy obciążeniu 2, 2.73 [1.34, 4.12] przy 4 i 4.61 [1.83, 7.40] przy 6. Od obciążenia 3.02 w górę jest istotna (162 z 200 osób).
Czego ten wykres nie pokazuje – i jak może zmylić. Oba nachylenia są istotne, różnica grup ma obszar istotności, a test interakcji jest nieistotny. To nie dowodzi, że praca zmianowa wzmacnia związek: obszar istotności opisuje efekt warunkowy, a o moderacji świadczy test różnicy nachyleń. Prawdopodobna przyczyna – za mała próba (rysunek 6). Współczynnik grupy (−1.04, p = .680) to różnica przy obciążeniu 0, czyli poza skalą 1–7 – stąd rysunek 5. Ten sam układ z interakcją grupa × kowariant to sprawdzenie równoległości prostych w ANCOVA – wizualizacji na obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: centrowanie przesuwa punkt odczytu, nie interakcję
Ten sam model z rysunku 1 szacujemy drugi raz po wycentrowaniu obu predyktorów (odjęciu średniej).
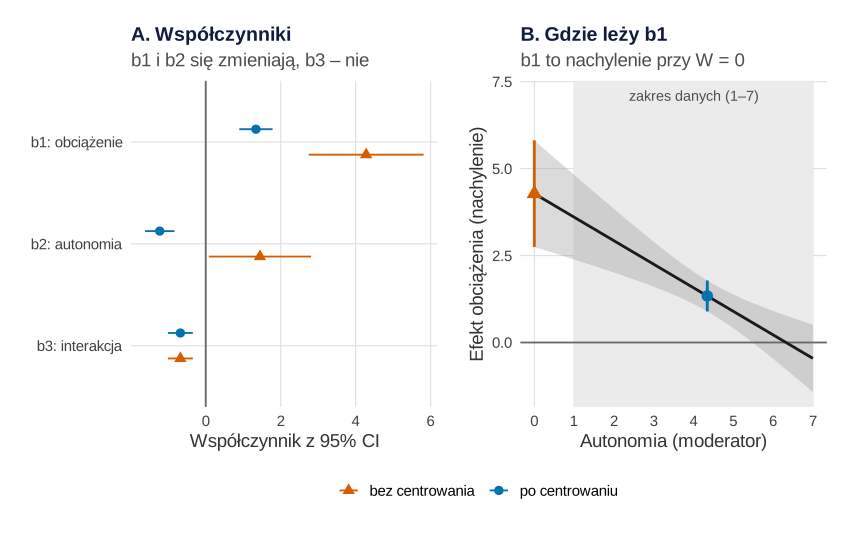
Co widać. Interakcja jest identyczna: −0.68, t = −4.01 w obu modelach. R² jest ten sam (.268), a przewidywane wartości różnią się o 0. Zmieniły się współczynniki niższego rzędu. Współczynnik obciążenia spadł z 4.28 do 1.34, a autonomii zmienił znak (z 1.45 na −1.23). Panel B wyjaśnia dlaczego: przy iloczynie b1 to nachylenie X tam, gdzie W = 0 – bez centrowania przy autonomii 0, spoza skali 1–7, po centrowaniu przy średniej. Oba b1 leżą na tej samej linii. Aiken i West (1991) omawiają, jak przeskalowanie predyktorów zmienia współczynniki w modelach z interakcją.
Czego ten wykres nie pokazuje. Centrowanie obniżyło korelację obciążenia z iloczynem z .596 do .055, ale to współliniowość „techniczna”. Dalal i Zickar (2012) pokazali, że centrowanie nie zmienia najwyższego współczynnika, dopasowania modelu ani mocy wykrycia moderacji. Jego zaletą jest tylko łatwiejsza interpretacja efektów głównych.
Podpis do pracy (np. w aneksie):
Zdanie do Metody:
Rysunek 6: moc testu interakcji w 1000 badań
Z populacji o parametrach z przykładu losujemy 1000 badań przy każdej z sześciu liczebności (50–500 osób). W każdym badaniu dopasowujemy model z interakcją i zapisujemy, czy efekt obciążenia (przy średniej autonomii) i interakcja dały p < .05. Błąd Monte Carlo odsetka wynosi najwyżej 1.6 punktu procentowego (przy mocy .50).
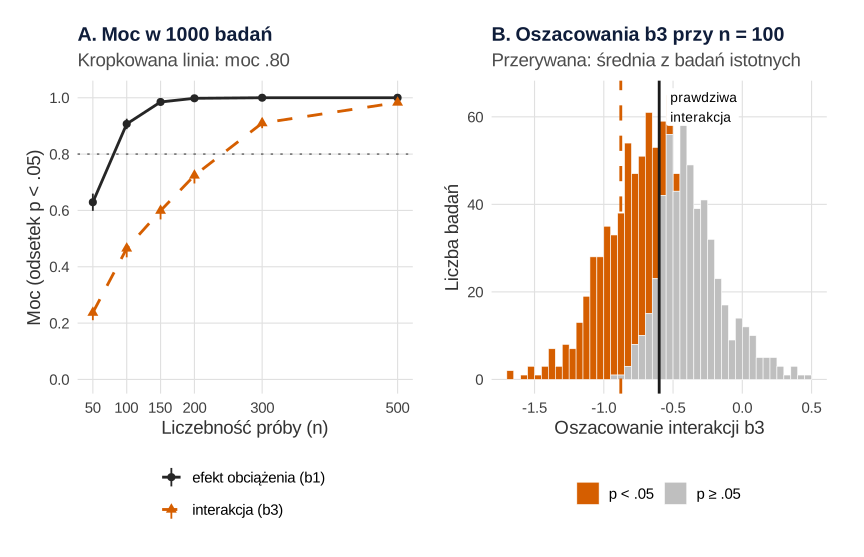
set.seed(596)).Co widać. Przy 100 osobach test efektu obciążenia wykrywa go w 90.7% badań, a test interakcji z tej samej populacji – w 46.5%. Moc interakcji rośnie wolno: .237 przy 50 osobach, .599 przy 150, .724 przy 200, .910 przy 300 i .983 przy 500. Próg .80 interakcja przekracza dopiero między 200 a 300 osobami. Panel B pokazuje drugi koszt małej próby: średnie oszacowanie interakcji ze wszystkich 1000 badań (−0.601) trafia w prawdziwą wartość, ale średnia z badań istotnych to −0.877, czyli o 46% za dużo. Zjawisko szerzej pokazuje wpis moc testu w obrazkach.
Czego ten wykres nie pokazuje. Symulacja zakłada idealny pomiar. McClelland i Judd (1993) pokazali, że testy interakcji w badaniach terenowych mają często mniej niż 20% efektywności optymalnych planów eksperymentalnych. Wiążą to z łącznym rozkładem predyktorów – u nas widać go jako puste rogi na rysunku 3. Błąd pomiaru obniża moc jeszcze bardziej. Jak planować liczebność, opisuje wpis moc testu dla interakcji. Dzielenie moderatora na medianie mocy nie dodaje – zob. podział na medianie – wizualizacja na obrazkach.
Podpis do pracy (np. w uzasadnieniu liczebności):
Zdanie do Metody:
Moderacja a mediacja: wachlarz a łańcuch
Moderator mówi, kiedy lub dla kogo X działa silniej – na rysunkach to wachlarz prostych albo opadający efekt warunkowy. Mediator mówi, przez co X działa – to łańcuch X → M → Y, a na rysunku dwie strzałki i iloczyn ścieżek. Baron i Kenny (1986) podkreślali, że obu nazw nie wolno używać zamiennie. Mediację na wykresach pokazuje wpis mediacja w obrazkach. Test: „autonomia osłabia związek” to moderacja; „obciążenie zwiększa wyczerpanie, bo skraca odpoczynek” – mediacja.
Który rysunek do pracy i co zrobić w praktyce
- Do Wyników – rysunek 1 (kształt interakcji na tle danych) albo rysunek 2 (cały obszar istotności). Przy moderatorze dwuwartościowym – panel A rysunku 4.
- Do Metody – zdanie o centrowaniu (rysunek 5) i o liczebności dobranej pod interakcję, nie pod efekt główny (rysunek 6).
- Na obronę – mapa przewidywań (rysunek 3).
W praktyce: zaplanuj próbę pod interakcję, wybierz wartości moderatora z teorii albo pokaż obszar Johnsona–Neymana, zawsze dodaj rozkład moderatora przy osi i nie interpretuj przewidywań poza zakresem danych. Zasady rysowania wyników regresji omawia wpis wynik regresji na wykresie. Pojęcia efektu interakcji w ANOVA i regresji porządkuje hasło efekt interakcji.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 4 i 6), zaczyna się od własnego set.seed(596), więc skopiowany osobno da te same liczby co na stronie. Przepisy 2, 3 i 5 nie losują. Ziarno 596 ustalono raz i nie zmieniano go. Ręcznie ustalono: 300 osób, średnie i SD obciążenia (4, 1.2) i autonomii (4.2, 1.3), ich korelację (−.2), współczynniki populacji (1.5, −1.0, −0.6) i SD błędu 5 – tak, by granica Johnsona–Neymana wypadła w zakresie danych; w przykładzie z pracą zmianową: 200 osób, odsetek zmianowych 40%, nachylenia 1.0 i 2.6 i różnicę grup 2 punkty; w symulacji mocy: sześć liczebności i 1000 badań przy każdej (razem 6000 modeli). W symulacji wartości nie są zaokrąglane ani przycinane do skali 1–7. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane, model z interakcją i proste nachylenia: Rysunek 1
R
# Rysunek 1. Proste nachylenia: obciążenie pracą a wyczerpanie przy niskiej, średniej i wysokiej autonomii
library(ggplot2)

# Paleta Okabe–Ito (cynober, niebieski i czerń rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(nisko = "#D55E00", srednio = "grey15", wysoko = "#0072B2", szary = "grey60", tlo = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03
p_apa <- function(p) ifelse(p < .001, "p < .001", paste("p =", bz(p, 3)))

# 300 pracowników: obciążenie pracą (X, 1–7), autonomia w pracy (W, 1–7), wyczerpanie emocjonalne (Y, 0–40).
# Parametry populacji ustalone ręcznie tak, by interakcja była wyraźna, a granica Johnsona–Neymana
# wypadła w zakresie danych: nachylenie X przy średniej W = 1.5, interakcja = −0.6, SD błędu = 5
n <- 300; b0 <- 20; b_x <- 1.5; b_w <- -1.0; b_xw <- -0.6; sd_e <- 5
set.seed(596)                                    # ziarno ustalone raz, bez dobierania pod wynik
z1 <- rnorm(n); z2 <- rnorm(n)
obciazenie <- pmin(pmax(round(4 + 1.2 * z1, 1), 1), 7)
autonomia <- pmin(pmax(round(4.2 + 1.3 * (-0.2 * z1 + sqrt(1 - 0.2^2) * z2), 1), 1), 7)
wyczerpanie <- b0 + b_x * (obciazenie - 4) + b_w * (autonomia - 4.2) +
  b_xw * (obciazenie - 4) * (autonomia - 4.2) + rnorm(n, 0, sd_e)
wyczerpanie <- pmin(pmax(round(wyczerpanie, 1), 0), 40)
dane <- data.frame(obciazenie, autonomia, wyczerpanie)
write.csv(dane, "moderacja-wizualizacja-dane.csv", row.names = FALSE)
round(sapply(dane, function(v) c(M = mean(v), SD = sd(v), min = min(v), max = max(v))), 2)
round(cor(dane), 2)

# Model bez interakcji i z interakcją (surowe skale, bez centrowania)
m0 <- lm(wyczerpanie ~ obciazenie + autonomia, data = dane)
m <- lm(wyczerpanie ~ obciazenie * autonomia, data = dane)
round(summary(m)$coefficients, 4)
round(c(R2_bez = summary(m0)$r.squared, R2_z = summary(m)$r.squared,
        delta_R2 = summary(m)$r.squared - summary(m0)$r.squared), 4)
anova(m0, m)

# Proste nachylenia X przy W = M − 1 SD, M, M + 1 SD: b1 + b3·W, błąd z macierzy kowariancji współczynników
b <- coef(m); V <- vcov(m); df_res <- df.residual(m)
w_M <- mean(dane$autonomia); w_SD <- sd(dane$autonomia)
poziomy <- c(nisko = w_M - w_SD, srednio = w_M, wysoko = w_M + w_SD)
nachyl <- function(w) {
  est <- b[["obciazenie"]] + b[["obciazenie:autonomia"]] * w
  se <- sqrt(V["obciazenie", "obciazenie"] + 2 * w * V["obciazenie", "obciazenie:autonomia"] +
               w^2 * V["obciazenie:autonomia", "obciazenie:autonomia"])
  c(W = w, nachylenie = est, SE = se, t = est / se, p = 2 * pt(-abs(est / se), df_res),
    CI_dolna = est - qt(.975, df_res) * se, CI_gorna = est + qt(.975, df_res) * se)
}
proste <- t(sapply(poziomy, nachyl))
round(proste, 3)

# Linie przewidywań z 95% pasmem ufności przy trzech wartościach autonomii, na tle danych
etyk <- c(nisko = "Niska autonomia (M − 1 SD)", srednio = "Średnia autonomia (M)",
          wysoko = "Wysoka autonomia (M + 1 SD)")
siatka <- expand.grid(obciazenie = seq(min(dane$obciazenie), max(dane$obciazenie), length.out = 60),
                      poziom = names(poziomy))
siatka$autonomia <- poziomy[as.character(siatka$poziom)]
pr <- predict(m, siatka, interval = "confidence")
siatka <- cbind(siatka, pr)
siatka$poziom <- factor(etyk[as.character(siatka$poziom)], etyk)
konce <- siatka[siatka$obciazenie == max(siatka$obciazenie), ]
konce$tekst <- sprintf("b = %.2f", proste[, "nachylenie"])
p1 <- ggplot(siatka, aes(obciazenie, fit)) +
  geom_point(data = dane, aes(obciazenie, wyczerpanie), inherit.aes = FALSE, colour = kol[["szary"]],
             size = 1.3, alpha = 0.45) +
  geom_ribbon(aes(ymin = lwr, ymax = upr, fill = poziom), alpha = 0.18) +
  geom_line(aes(colour = poziom, linetype = poziom), linewidth = 1.1) +
  geom_text(data = konce, aes(label = tekst, colour = poziom), hjust = -0.1, size = 4, show.legend = FALSE) +
  scale_colour_manual(values = setNames(kol[c("nisko", "srednio", "wysoko")], etyk), name = NULL) +
  scale_fill_manual(values = setNames(kol[c("nisko", "srednio", "wysoko")], etyk), name = NULL) +
  scale_linetype_manual(values = setNames(c("dashed", "solid", "dotdash"), etyk), name = NULL) +
  scale_x_continuous(breaks = 1:7, expand = expansion(mult = c(0.02, 0.17))) +
  coord_cartesian(ylim = c(0, 40)) +
  guides(colour = guide_legend(ncol = 1), fill = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(x = "Obciążenie pracą (1–7)", y = "Wyczerpanie emocjonalne (0–40)",
       title = "Proste nachylenia przy trzech wartościach autonomii",
       subtitle = sprintf("Interakcja: b = %s, %s; N = %d", sub("-", "−", sprintf("%.2f", b[["obciazenie:autonomia"]])),
                          p_apa(summary(m)$coefficients["obciazenie:autonomia", 4]), n)) + motyw
p1   # zapis: ggsave("moderacja-wizualizacja-proste-nachylenia.svg", p1, width = 8, height = 6)
Wynik w R
    obciazenie autonomia wyczerpanie
M         3.95      4.35       20.18
SD        1.19      1.34        5.22
min       1.00      1.00        5.30
max       7.00      7.00       34.10
            obciazenie autonomia wyczerpanie
obciazenie        1.00     -0.24        0.37
autonomia        -0.24      1.00       -0.38
wyczerpanie       0.37     -0.38        1.00
                     Estimate Std. Error t value Pr(>|t|)
(Intercept)            8.3435     3.3099  2.5208   0.0122
obciazenie             4.2812     0.7788  5.4975   0.0000
autonomia              1.4469     0.6934  2.0865   0.0378
obciazenie:autonomia  -0.6767     0.1689 -4.0064   0.0001
  R2_bez     R2_z delta_R2
  0.2278   0.2676   0.0397
Analysis of Variance Table

Model 1: wyczerpanie ~ obciazenie + autonomia
Model 2: wyczerpanie ~ obciazenie * autonomia
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    297 6300.8
2    296 5976.7  1     324.1 16.052 7.804e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            W nachylenie    SE     t     p CI_dolna CI_gorna
nisko   3.004      2.248 0.328 6.856 0.000    1.603    2.894
srednio 4.346      1.340 0.226 5.930 0.000    0.895    1.785
wysoko  5.689      0.431 0.312 1.382 0.168   -0.183    1.046
2. Efekt warunkowy i granice Johnsona–Neymana: Rysunek 2
R
# Rysunek 2. Efekt warunkowy obciążenia w całym zakresie autonomii i obszar Johnsona–Neymana
# (kontynuacja: dane, m, b, V, df_res, proste, nachyl, kol, motyw, bz z bloku 1; bez losowania)
library(ggplot2)

# Granice Johnsona–Neymana: wartości W, przy których |b1 + b3·W| / SE(W) = t krytyczne (równanie kwadratowe)
t_kr <- qt(.975, df_res)
v11 <- V["obciazenie", "obciazenie"]; v13 <- V["obciazenie", "obciazenie:autonomia"]
v33 <- V["obciazenie:autonomia", "obciazenie:autonomia"]
b1 <- b[["obciazenie"]]; b3 <- b[["obciazenie:autonomia"]]
A <- b3^2 - t_kr^2 * v33; B <- 2 * (b1 * b3 - t_kr^2 * v13); C <- b1^2 - t_kr^2 * v11
granice <- sort((-B + c(-1, 1) * sqrt(B^2 - 4 * A * C)) / (2 * A))
round(c(t_kryt = t_kr, granica_1 = granice[1], granica_2 = granice[2], zero_efektu = -b1 / b3), 3)
range(dane$autonomia)
# Ilu pracowników ma autonomię w obszarze, w którym efekt obciążenia jest istotny (W < granicy w zakresie danych)?
gr <- granice[granice > min(dane$autonomia) & granice < max(dane$autonomia)]
c(granica_w_zakresie = round(gr, 2), n_istotny = sum(dane$autonomia < gr),
  odsetek = round(mean(dane$autonomia < gr), 3))
round(t(sapply(c(2, 3, 4, 5, 6, 7), nachyl)), 3)          # efekt warunkowy w kilku punktach

# Efekt warunkowy z 95% przedziałem w gęstej siatce W
ef <- as.data.frame(t(sapply(seq(1, 7, by = 0.02), nachyl)))
ef$obszar <- factor(ifelse(ef$CI_dolna > 0, "efekt istotny (przedział nad zerem)", "przedział obejmuje zero"),
                    c("efekt istotny (przedział nad zerem)", "przedział obejmuje zero"))
pkt <- data.frame(proste, poziom = c("M − 1 SD", "M", "M + 1 SD"))
p2 <- ggplot(ef, aes(W, nachylenie)) +
  geom_ribbon(aes(ymin = CI_dolna, ymax = CI_gorna, fill = obszar), alpha = 0.35) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_vline(xintercept = gr, linetype = "dashed", colour = "grey20") +
  geom_line(linewidth = 1.1, colour = "grey10") +
  geom_pointrange(data = pkt, aes(W, nachylenie, ymin = CI_dolna, ymax = CI_gorna), shape = 21,
                  fill = "white", size = 0.6, linewidth = 0.8) +
  geom_text(data = pkt, aes(W, CI_gorna, label = poziom), vjust = -0.7, size = 3.8) +
  annotate("label", x = gr - 0.08, y = 5.3, hjust = 1, size = 3.8, linewidth = 0, fill = "white",
           label = sprintf("granica J–N: autonomia = %.2f\n(%d z %d osób poniżej)", gr,
                           sum(dane$autonomia < gr), nrow(dane))) +
  geom_rug(data = dane, aes(x = autonomia), inherit.aes = FALSE, sides = "b", alpha = 0.3, length = unit(0.03, "npc")) +
  scale_fill_manual(values = c(kol[["wysoko"]], kol[["szary"]]), name = NULL) +
  scale_x_continuous(breaks = 1:7) +
  coord_cartesian(ylim = c(-2.2, 6)) +
  labs(x = "Autonomia w pracy (moderator, 1–7)", y = "Efekt obciążenia na wyczerpanie\n(punkty na 1 punkt obciążenia)",
       title = "Efekt warunkowy obciążenia pracą z 95% przedziałem ufności",
       subtitle = "Kreski przy osi: autonomia osób; kółka: nachylenia z rysunku 1") + motyw
p2   # zapis: ggsave("moderacja-wizualizacja-johnson-neyman.svg", p2, width = 8, height = 5.8)
Wynik w R
     t_kryt   granica_1   granica_2 zero_efektu
      1.968       5.485       8.385       6.326
[1] 1 7
granica_w_zakresie          n_istotny            odsetek
              5.48             237.00               0.79
     W nachylenie    SE      t     p CI_dolna CI_gorna
[1,] 2      2.928 0.466  6.285 0.000    2.011    3.844
[2,] 3      2.251 0.328  6.854 0.000    1.605    2.897
[3,] 4      1.574 0.236  6.665 0.000    1.109    2.039
[4,] 5      0.897 0.247  3.641 0.000    0.412    1.383
[5,] 6      0.221 0.350  0.630 0.529   -0.469    0.910
[6,] 7     -0.456 0.492 -0.927 0.355   -1.424    0.512
3. Mapa przewidywań: Rysunek 3
R
# Rysunek 3. Mapa przewidywań: model bez interakcji (równoległe poziomice) i z interakcją (wachlarz)
# (kontynuacja: dane, m0, m, motyw z bloku 1; bez losowania)
library(ggplot2)
library(colorspace)

# Przewidywane wyczerpanie na siatce obciążenie × autonomia, z obu modeli
siatka3 <- expand.grid(obciazenie = seq(1, 7, by = 0.1), autonomia = seq(1, 7, by = 0.1))
mapa <- rbind(data.frame(siatka3, model = "A. Bez interakcji", Y = predict(m0, siatka3)),
              data.frame(siatka3, model = "B. Z interakcją", Y = predict(m, siatka3)))
# Przewidywania w czterech narożnikach siatki – w narożnikach bez danych model ekstrapoluje
naroza <- expand.grid(obciazenie = c(1, 7), autonomia = c(1, 7))
round(cbind(naroza, bez_interakcji = predict(m0, naroza), z_interakcja = predict(m, naroza)), 1)
# Obrys danych (otoczka wypukła) – poza nim nie ma obserwacji
otoczka <- dane[chull(dane$obciazenie, dane$autonomia), c("obciazenie", "autonomia")]
# Ile osób ma jednocześnie wysokie obciążenie (≥ 6) i wysoką autonomię (≥ 6)?
c(oba_wysokie = sum(dane$obciazenie >= 6 & dane$autonomia >= 6),
  oba_niskie = sum(dane$obciazenie <= 2 & dane$autonomia <= 2))

p3 <- ggplot(mapa, aes(obciazenie, autonomia)) +
  geom_raster(aes(fill = Y)) +
  geom_contour(aes(z = Y), breaks = seq(0, 40, by = 2), colour = "white", linewidth = 0.4) +
  geom_point(data = dane, colour = "grey10", size = 0.7, alpha = 0.5) +
  geom_polygon(data = otoczka, fill = NA, colour = "black", linetype = "dashed", linewidth = 0.6) +
  facet_wrap(~ model, ncol = 1) +
  scale_fill_continuous_sequential(palette = "Viridis", rev = FALSE, name = "Przewidywane\nwyczerpanie") +
  scale_x_continuous(breaks = 1:7, expand = c(0, 0)) + scale_y_continuous(breaks = 1:7, expand = c(0, 0)) +
  coord_fixed() +
  labs(x = "Obciążenie pracą (1–7)", y = "Autonomia (1–7)",
       title = "Ta sama zależność jako mapa przewidywań",
       subtitle = "Białe poziomice co 2 punkty; przerywany obrys – zakres danych") +
  motyw + theme(legend.position = "right", legend.key.height = unit(1.4, "cm"))
p3   # zapis: ggsave("moderacja-wizualizacja-mapa-przewidywan.svg", p3, width = 7, height = 9.6)
Wynik w R
  obciazenie autonomia bez_interakcji z_interakcja
1          1         1           20.4         13.4
2          7         1           28.2         35.0
3          1         7           13.1         18.0
4          7         7           20.9         15.3
oba_wysokie  oba_niskie
          0           0
4. Moderator dwuwartościowy: Rysunek 4
R
# Rysunek 4. Moderator dwuwartościowy: praca zmianowa (tak/nie) a związek obciążenia z wyczerpaniem
# (kontynuacja: kol, motyw, bz, p_apa z bloku 1; nowe dane – własne losowanie)
library(ggplot2)
library(patchwork)

# 200 pracowników, w tym ok. 40% na zmiany. Parametry populacji ustalone ręcznie: nachylenie 1.0 bez zmian,
# 2.6 przy pracy zmianowej, różnica grup przy średnim obciążeniu 2 punkty, SD błędu 5
n2 <- 200
set.seed(596)                                    # to samo ziarno, osobny blok
zmianowa <- factor(ifelse(rbinom(n2, 1, 0.4) == 1, "tak", "nie"), c("nie", "tak"))
obc2 <- pmin(pmax(round(rnorm(n2, 4, 1.2), 1), 1), 7)
wycz2 <- 19 + 1.0 * (obc2 - 4) + 2 * (zmianowa == "tak") + 1.6 * (obc2 - 4) * (zmianowa == "tak") + rnorm(n2, 0, 5)
dane2 <- data.frame(obciazenie = obc2, zmianowa, wyczerpanie = pmin(pmax(round(wycz2, 1), 0), 40))
table(dane2$zmianowa)

# Kodowanie 0/1 (nie = 0): b1 to nachylenie w grupie „nie”, b3 – różnica nachyleń
m2 <- lm(wyczerpanie ~ obciazenie * zmianowa, data = dane2)
round(summary(m2)$coefficients, 4)
b2 <- coef(m2); V2 <- vcov(m2); df2 <- df.residual(m2)
# Nachylenie w każdej grupie z 95% CI (w grupie „tak” = b1 + b3)
L <- rbind(nie = c(0, 1, 0, 0), tak = c(0, 1, 0, 1))
est <- drop(L %*% b2); se <- sqrt(diag(L %*% V2 %*% t(L)))
round(cbind(nachylenie = est, SE = se, CI_dolna = est - qt(.975, df2) * se, CI_gorna = est + qt(.975, df2) * se), 3)

# Różnica grup (tak − nie) jako funkcja obciążenia: b2 + b3·X, czyli moderatorem jest teraz obciążenie
roznica <- function(x) {
  e <- b2[["zmianowatak"]] + b2[["obciazenie:zmianowatak"]] * x
  s <- sqrt(V2["zmianowatak", "zmianowatak"] + 2 * x * V2["zmianowatak", "obciazenie:zmianowatak"] +
              x^2 * V2["obciazenie:zmianowatak", "obciazenie:zmianowatak"])
  c(X = x, roznica = e, CI_dolna = e - qt(.975, df2) * s, CI_gorna = e + qt(.975, df2) * s)
}
rz <- as.data.frame(t(sapply(seq(min(obc2), max(obc2), by = 0.02), roznica)))
granica2 <- min(rz$X[rz$CI_dolna > 0])          # od jakiego obciążenia grupy różnią się istotnie
round(c(granica_JN = granica2, n_powyzej = sum(obc2 >= granica2), odsetek = mean(obc2 >= granica2)), 3)
round(t(sapply(c(2, 4, 6), roznica)), 2)

# A: dwie linie z pasmami ufności na tle danych (kształt punktu = grupa)
etyk2 <- c(nie = "praca bez zmian", tak = "praca zmianowa")
siatka4 <- expand.grid(obciazenie = seq(min(obc2), max(obc2), length.out = 50), zmianowa = levels(zmianowa))
siatka4 <- cbind(siatka4, predict(m2, siatka4, interval = "confidence"))
pa <- ggplot(siatka4, aes(obciazenie, fit, colour = zmianowa, fill = zmianowa)) +
  geom_point(data = dane2, aes(obciazenie, wyczerpanie, shape = zmianowa), size = 1.6, alpha = 0.55) +
  geom_ribbon(aes(ymin = lwr, ymax = upr), alpha = 0.2, colour = NA) +
  geom_line(aes(linetype = zmianowa), linewidth = 1.1) +
  scale_colour_manual(values = c(nie = kol[["wysoko"]], tak = kol[["nisko"]]), labels = etyk2, name = NULL) +
  scale_fill_manual(values = c(nie = kol[["wysoko"]], tak = kol[["nisko"]]), labels = etyk2, name = NULL) +
  scale_shape_manual(values = c(nie = 16, tak = 17), labels = etyk2, name = NULL) +
  scale_linetype_manual(values = c(nie = "solid", tak = "dashed"), labels = etyk2, name = NULL) +
  scale_x_continuous(breaks = 1:7) + coord_cartesian(ylim = c(0, 40)) +
  labs(x = "Obciążenie pracą (1–7)", y = "Wyczerpanie emocjonalne (0–40)", title = "A. Dwie proste",
       subtitle = sprintf("Nachylenie: %.2f bez zmian, %.2f na zmiany", est[["nie"]], est[["tak"]])) + motyw

# B: różnica między grupami w funkcji obciążenia, z przedziałem ufności
pb <- ggplot(rz, aes(X, roznica)) +
  geom_ribbon(aes(ymin = CI_dolna, ymax = CI_gorna), fill = kol[["szary"]], alpha = 0.4) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_vline(xintercept = granica2, linetype = "dashed", colour = "grey20") +
  geom_line(linewidth = 1.1, colour = "grey10") +
  annotate("text", x = granica2 + 0.1, y = -4.5, hjust = 0, size = 3.8,
           label = sprintf("istotna różnica\nod obciążenia %.2f", granica2)) +
  scale_x_continuous(breaks = 1:7) +
  labs(x = "Obciążenie pracą (1–7)", y = "Różnica: zmianowa − bez zmian", title = "B. Różnica grup",
       subtitle = sprintf("Interakcja (różnica nachyleń): b = %.2f, %s", b2[["obciazenie:zmianowatak"]],
                          p_apa(summary(m2)$coefficients["obciazenie:zmianowatak", 4]))) + motyw
p4 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("moderacja-wizualizacja-moderator-dwuwartosciowy.svg", p4, width = 9, height = 5.8)
Wynik w R
nie tak
124  76
                       Estimate Std. Error t value Pr(>|t|)
(Intercept)             14.6252     1.5708  9.3104   0.0000
obciazenie               1.1366     0.3783  3.0041   0.0030
zmianowatak             -1.0383     2.5167 -0.4125   0.6804
obciazenie:zmianowatak   0.9421     0.6068  1.5527   0.1221
    nachylenie    SE CI_dolna CI_gorna
nie      1.137 0.378    0.390    1.883
tak      2.079 0.474    1.143    3.014
granica_JN  n_powyzej    odsetek
      3.02     162.00       0.81
     X roznica CI_dolna CI_gorna
[1,] 2    0.85    -1.90     3.60
[2,] 4    2.73     1.34     4.12
[3,] 6    4.61     1.83     7.40
5. Centrowanie: Rysunek 5
R
# Rysunek 5. Centrowanie: zmieniają się współczynniki niższego rzędu, interakcja i przewidywania – nie
# (kontynuacja: dane, m, nachyl, kol, motyw z bloku 1; bez losowania)
library(ggplot2)
library(patchwork)

# Ten sam model na zmiennych wycentrowanych (odjęta średnia)
dane$obc_c <- dane$obciazenie - mean(dane$obciazenie)
dane$aut_c <- dane$autonomia - mean(dane$autonomia)
m_c <- lm(wyczerpanie ~ obc_c * aut_c, data = dane)
wsp <- rbind(surowe = coef(m), wycentrowane = coef(m_c))
colnames(wsp) <- c("b0", "b1_obciazenie", "b2_autonomia", "b3_interakcja")
round(wsp, 4)
round(rbind(surowe = summary(m)$coefficients[4, ], wycentrowane = summary(m_c)$coefficients[4, ]), 4)
round(c(R2_surowe = summary(m)$r.squared, R2_wycentrowane = summary(m_c)$r.squared,
        max_roznica_przewidywan = max(abs(fitted(m) - fitted(m_c)))), 6)
# Współliniowość „techniczna”: korelacja X z iloczynem przed i po centrowaniu
round(c(r_X_XW_surowe = cor(dane$obciazenie, dane$obciazenie * dane$autonomia),
        r_X_XW_wycentrowane = cor(dane$obc_c, dane$obc_c * dane$aut_c)), 3)
# b1 to nachylenie X przy W = 0: w modelu surowym przy autonomii 0 (poza skalą 1–7), po centrowaniu – przy średniej
round(rbind(W_0 = nachyl(0), W_srednia = nachyl(mean(dane$autonomia))), 3)

# A: współczynniki z 95% CI w obu modelach
ci <- function(mod, model) {
  s <- summary(mod)$coefficients[-1, ]; k <- confint(mod)[-1, ]
  data.frame(model, wsp = c("b1: obciążenie", "b2: autonomia", "b3: interakcja"),
             est = s[, 1], dolna = k[, 1], gorna = k[, 2])
}
wspd <- rbind(ci(m, "bez centrowania"), ci(m_c, "po centrowaniu"))
wspd$wsp <- factor(wspd$wsp, rev(unique(wspd$wsp)))
pa <- ggplot(wspd, aes(est, wsp, colour = model, shape = model)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), position = position_dodge(width = 0.5), size = 0.6) +
  scale_colour_manual(values = c("bez centrowania" = kol[["nisko"]], "po centrowaniu" = kol[["wysoko"]]), name = NULL) +
  scale_shape_manual(values = c("bez centrowania" = 17, "po centrowaniu" = 16), name = NULL) +
  labs(x = "Współczynnik z 95% CI", y = NULL, title = "A. Współczynniki",
       subtitle = "b1 i b2 się zmieniają, b3 – nie") + motyw

# B: efekt warunkowy X w funkcji autonomii – jedna linia; b1 każdego modelu to inny punkt na tej linii
ef5 <- as.data.frame(t(sapply(seq(0, 7, by = 0.05), nachyl)))
pkt5 <- data.frame(W = c(0, mean(dane$autonomia)), est = c(wsp["surowe", 2], wsp["wycentrowane", 2]),
                   model = c("bez centrowania", "po centrowaniu"))
pkt5 <- cbind(pkt5, t(sapply(pkt5$W, nachyl))[, c("CI_dolna", "CI_gorna")])
pb <- ggplot(ef5, aes(W, nachylenie)) +
  annotate("rect", xmin = min(dane$autonomia), xmax = max(dane$autonomia), ymin = -Inf, ymax = Inf,
           fill = "grey92") +
  annotate("text", x = 4, y = 7.1, label = "zakres danych (1–7)", size = 3.8, colour = "grey30") +
  geom_ribbon(aes(ymin = CI_dolna, ymax = CI_gorna), fill = kol[["szary"]], alpha = 0.35) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(linewidth = 1, colour = "grey10") +
  geom_pointrange(data = pkt5, aes(W, est, ymin = CI_dolna, ymax = CI_gorna, colour = model, shape = model),
                  size = 0.8, linewidth = 1, show.legend = FALSE) +
  scale_colour_manual(values = c("bez centrowania" = kol[["nisko"]], "po centrowaniu" = kol[["wysoko"]]), name = NULL) +
  scale_shape_manual(values = c("bez centrowania" = 17, "po centrowaniu" = 16), name = NULL) +
  scale_x_continuous(breaks = 0:7) +
  labs(x = "Autonomia (moderator)", y = "Efekt obciążenia (nachylenie)", title = "B. Gdzie leży b1",
       subtitle = "b1 to nachylenie przy W = 0") + motyw
p5 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("moderacja-wizualizacja-centrowanie.svg", p5, width = 9, height = 5.6)
Wynik w R
                  b0 b1_obciazenie b2_autonomia b3_interakcja
surowe        8.3435        4.2812       1.4469       -0.6767
wycentrowane 19.9272        1.3398      -1.2276       -0.6767
             Estimate Std. Error t value Pr(>|t|)
surowe        -0.6767     0.1689 -4.0064    1e-04
wycentrowane  -0.6767     0.1689 -4.0064    1e-04
              R2_surowe         R2_wycentrowane max_roznica_przewidywan
               0.267565                0.267565                0.000000
      r_X_XW_surowe r_X_XW_wycentrowane
              0.596               0.055
              W nachylenie    SE     t p CI_dolna CI_gorna
W_0       0.000      4.281 0.779 5.498 0    2.749    5.814
W_srednia 4.346      1.340 0.226 5.930 0    0.895    1.785
6. Symulacja mocy: Rysunek 6
R
# Rysunek 6. Moc testu interakcji i efektu obciążenia: 1000 badań przy każdym n
# (kontynuacja: kol, motyw z bloku 1; parametry populacji te same co w bloku 1, własne losowanie)
library(ggplot2)
library(patchwork)

# Populacja jak w bloku 1: nachylenie X przy średniej W = 1.5, b2 = −1.0, interakcja = −0.6, SD błędu = 5
b_x <- 1.5; b_w <- -1.0; b_xw <- -0.6; sd_e <- 5
jedno_badanie <- function(n) {
  z1 <- rnorm(n); z2 <- rnorm(n)
  x <- 4 + 1.2 * z1; w <- 4.2 + 1.3 * (-0.2 * z1 + sqrt(1 - 0.2^2) * z2)
  y <- 20 + b_x * (x - 4) + b_w * (w - 4.2) + b_xw * (x - 4) * (w - 4.2) + rnorm(n, 0, sd_e)
  xc <- x - mean(x); wc <- w - mean(w)
  s <- summary(lm(y ~ xc * wc))$coefficients
  c(b1 = s["xc", 1], p_b1 = s["xc", 4], b3 = s["xc:wc", 1], p_b3 = s["xc:wc", 4])
}
liczebnosci <- c(50, 100, 150, 200, 300, 500)
R <- 1000                                        # 1000 badań przy każdej liczebności
set.seed(596)                                    # ziarno ustalone raz, bez dobierania pod wynik
sym <- lapply(liczebnosci, function(n) t(replicate(R, jedno_badanie(n))))
names(sym) <- liczebnosci
moc <- data.frame(n = liczebnosci,
                  efekt_obciazenia = sapply(sym, function(s) mean(s[, "p_b1"] < .05)),
                  interakcja = sapply(sym, function(s) mean(s[, "p_b3"] < .05)))
moc
round(sqrt(0.5 * 0.5 / R), 4)                    # największy błąd Monte Carlo odsetka (przy mocy .50)

# Przy n = 100: oszacowania interakcji w badaniach istotnych i nieistotnych
s100 <- as.data.frame(sym[["100"]])
s100$wynik <- factor(ifelse(s100$p_b3 < .05, "p < .05", "p ≥ .05"), c("p < .05", "p ≥ .05"))
round(c(moc = mean(s100$p_b3 < .05), sr_b3_wszystkie = mean(s100$b3),
        sr_b3_istotne = mean(s100$b3[s100$p_b3 < .05]),
        przeszacowanie = mean(s100$b3[s100$p_b3 < .05]) / b_xw), 3)

# A: krzywe mocy z ±2 błędami Monte Carlo
md <- rbind(data.frame(n = moc$n, moc = moc$efekt_obciazenia, efekt = "efekt obciążenia (b1)"),
            data.frame(n = moc$n, moc = moc$interakcja, efekt = "interakcja (b3)"))
md$se <- sqrt(md$moc * (1 - md$moc) / R)
pa <- ggplot(md, aes(n, moc, colour = efekt, shape = efekt, linetype = efekt)) +
  geom_hline(yintercept = 0.8, colour = "grey50", linetype = "dotted") +
  geom_line(linewidth = 1) +
  geom_pointrange(aes(ymin = moc - 2 * se, ymax = moc + 2 * se), size = 0.5) +
  scale_colour_manual(values = c(kol[["srednio"]], kol[["nisko"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = liczebnosci) + scale_y_continuous(breaks = seq(0, 1, .2)) + coord_cartesian(ylim = c(0, 1.01)) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Liczebność próby (n)", y = "Moc (odsetek p < .05)", title = "A. Moc w 1000 badań",
       subtitle = "Kropkowana linia: moc .80") + motyw

# B: rozkład 1000 oszacowań interakcji przy n = 100; istotne (wypełnione) są średnio przesadzone
pb <- ggplot(s100, aes(b3, fill = wynik)) +
  geom_histogram(binwidth = 0.05, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = b_xw, linewidth = 1, colour = "grey10") +
  geom_vline(xintercept = mean(s100$b3[s100$p_b3 < .05]), linewidth = 1, linetype = "dashed", colour = kol[["nisko"]]) +
  annotate("label", x = b_xw + 0.05, y = Inf, vjust = 1.2, hjust = 0, size = 3.6, linewidth = 0, fill = "white",
           label = "prawdziwa\ninterakcja") +
  scale_fill_manual(values = c("p < .05" = kol[["nisko"]], "p ≥ .05" = "grey75"), name = NULL) +
  labs(x = "Oszacowanie interakcji b3", y = "Liczba badań", title = "B. Oszacowania b3 przy n = 100",
       subtitle = "Przerywana: średnia z badań istotnych") + motyw + theme(legend.position = "bottom")
p6 <- pa + pb & theme(legend.position = "bottom")
p6   # zapis: ggsave("moderacja-wizualizacja-moc-interakcji.svg", p6, width = 9, height = 5.8)
Wynik w R
      n efekt_obciazenia interakcja
50   50            0.629      0.237
100 100            0.907      0.465
150 150            0.985      0.599
200 200            0.998      0.724
300 300            1.000      0.910
500 500            1.000      0.983
[1] 0.0158
            moc sr_b3_wszystkie   sr_b3_istotne  przeszacowanie
          0.465          -0.601          -0.877           1.462
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (niska / wysoka autonomia; zmianowa / bez zmian)" = c("#D55E00", "#0072B2"),
             "cynober – czarny (niska / średnia autonomia; interakcja / b1)" = c("#D55E00", "#262626"),
             "niebieski – szary (efekt istotny / przedział obejmuje zero)" = c("#0072B2", "#999999"),
             "cynober – jasnoszary (p < .05 / p ≥ .05)" = c("#D55E00", "#BFBFBF"),
             "Viridis: koniec skali – początek skali" = sequential_hcl(2, "Viridis"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                     widzenie_typowe
cynober – niebieski (niska / wysoka autonomia; zmianowa / bez zmian)           114.6
cynober – czarny (niska / średnia autonomia; interakcja / b1)                   86.0
niebieski – szary (efekt istotny / przedział obejmuje zero)                     44.9
cynober – jasnoszary (p < .05 / p ≥ .05)                                        80.1
Viridis: koniec skali – początek skali                                         143.1
czerwony – zielony (do unikania)                                               121.7
                                                                     deuteranopia
cynober – niebieski (niska / wysoka autonomia; zmianowa / bez zmian)        108.3
cynober – czarny (niska / średnia autonomia; interakcja / b1)                75.9
niebieski – szary (efekt istotny / przedział obejmuje zero)                  48.9
cynober – jasnoszary (p < .05 / p ≥ .05)                                     65.5
Viridis: koniec skali – początek skali                                      128.9
czerwony – zielony (do unikania)                                             21.1
                                                                     protanopia
cynober – niebieski (niska / wysoka autonomia; zmianowa / bez zmian)       91.9
cynober – czarny (niska / średnia autonomia; interakcja / b1)              62.8
niebieski – szary (efekt istotny / przedział obejmuje zero)                40.6
cynober – jasnoszary (p < .05 / p ≥ .05)                                   61.5
Viridis: koniec skali – początek skali                                    143.7
czerwony – zielony (do unikania)                                           31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele regresji, przedziały ufności, przewidywania i losowania – pakiet stats; otoczka wypukła – funkcja chull() pakietu grDevices. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; skalę barw mapy przewidywań i kontrolę palety wykonano pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Tylko trzy linie przy ±1 SD bez danych w tle. Wartości ±1 SD są umowne, a bez punktów nie widać, gdzie są obserwacje (rysunki 1 i 2).
- „Efekt nieistotny przy wysokim W”, więc „moderacja potwierdzona”. O moderacji świadczy test interakcji, nie różnica istotności efektów prostych (rysunek 4).
- Interpretowanie b1 z modelu bez centrowania jako „efektu głównego”. To nachylenie przy W = 0, często poza skalą (rysunek 5).
- Liczebność dobrana pod efekt główny. Interakcja potrzebowała tu około trzy razy więcej osób (rysunek 6).
Najczęstsze pytania
Który wykres moderacji wybrać do pracy: proste nachylenia czy wykres Johnsona–Neymana?
Proste nachylenia przy trzech wartościach moderatora dobrze pokazują kształt interakcji na tle danych. Wykres efektu warunkowego z 95% przedziałem pokazuje efekt przy każdej wartości moderatora i to, od jakiej wartości przestaje być istotny. W przykładzie trzy linie sugerowały „brak efektu przy wysokiej autonomii”, a wykres Johnsona–Neymana pokazał granicę 5.48, poniżej której było 237 z 300 osób. Do Wyników zwykle wystarczy jeden z nich, drugi do aneksu.
Dlaczego nachylenie przy +1 SD moderatora jest nieistotne, skoro interakcja jest istotna?
Bo to dwa różne pytania. Test interakcji sprawdza, czy nachylenie zmienia się wraz z moderatorem, a test prostego nachylenia – czy w danym punkcie różni się od zera. W przykładzie interakcja miała p < .001, a nachylenie przy +1 SD autonomii wynosiło 0.43, p = .168. Wybór punktu ±1 SD jest umowny, dlatego lepiej podać wartości ważne merytorycznie albo cały obszar istotności.
Czy po wycentrowaniu predyktorów zmieni się wynik testu interakcji?
Nie. W przykładzie współczynnik interakcji (−0.68), jego t (−4.01), R² (.268) i wszystkie przewidywane wartości były identyczne przed centrowaniem i po nim. Zmieniły się tylko współczynniki niższego rzędu: współczynnik obciążenia spadł z 4.28 do 1.34, bo przed centrowaniem oznaczał nachylenie przy autonomii równej 0, czyli poza skalą 1–7.
Dlaczego do wykrycia interakcji potrzeba większej próby niż do wykrycia efektu głównego?
Bo efekt interakcji jest zwykle mniejszy i szacowany mniej precyzyjnie. W symulacji 1000 badań przy każdej liczebności test efektu obciążenia osiągnął moc .91 przy 100 osobach, a test interakcji z tej samej populacji – .47; moc .91 interakcja osiągnęła dopiero przy 300 osobach. Istotne oszacowania interakcji przy 100 osobach były przy tym średnio o 46% większe od prawdziwej wartości.
Czy obszar Johnsona–Neymana dowodzi moderacji, gdy sam test interakcji jest nieistotny?
Nie. W przykładzie z pracą zmianową różnica nachyleń wyniosła 0.94, p = .122, a mimo to różnica grup była istotna od obciążenia 3.02 w górę. Obszar istotności mówi, gdzie efekt warunkowy różni się od zera, a nie, że efekt zmienia się wraz z moderatorem. Wnioskuj o moderacji z testu interakcji, a obszar traktuj jako opis.
Powiązane hasła
Przeczytaj też
Analiza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikModeracja w jamovi krok po kroku
Interakcja w Linear Regression, moduły medmod i GAMLj, centrowanie, proste nachylenia, wykres Johnsona–Neymana i opis APA – z danymi do pobrania.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikMediacja w obrazkach
Diagram ścieżek w ggplot2, iloczyn ab jako łańcuch nachyleń, bootstrap obok testu Sobela, c = c′ + ab i moc przy małych próbach – pięć rysunków z kodem R.
Czytaj →Masz hipotezę moderacyjną i nie wiesz, jak ją pokazać?
Pomożemy oszacować model z interakcją, wybrać wartości moderatora, wyznaczyć obszar Johnsona–Neymana i przygotować wykres z opisem, który obronisz przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage.
- Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373–400. https://doi.org/10.1207/s15327906mbr4003_5 ● Otwarty dostęp
- Dalal, D. K., & Zickar, M. J. (2012). Some common myths about centering predictor variables in moderated multiple regression and polynomial regression. Organizational Research Methods, 15(3), 339–362. https://doi.org/10.1177/1094428111430540
- Hainmueller, J., Mummolo, J., & Xu, Y. (2019). How much should we trust estimates from multiplicative interaction models? Simple tools to improve empirical practice. Political Analysis, 27(2), 163–192. https://doi.org/10.1017/pan.2018.46 ● Otwarty dostęp
- McClelland, G. H., & Judd, C. M. (1993). Statistical difficulties of detecting interactions and moderator effects. Psychological Bulletin, 114(2), 376–390. https://doi.org/10.1037/0033-2909.114.2.376
- Spiller, S. A., Fitzsimons, G. J., Lynch, J. G., Jr., & McClelland, G. H. (2013). Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression. Journal of Marketing Research, 50(2), 277–288. https://doi.org/10.1509/jmr.12.0420
Cytowania BibTeX
@book{aiken1991multiple, author={Aiken, Leona S. and West, Stephen G.}, title={{Multiple regression: Testing and interpreting interactions}}, year={1991}, publisher={Sage}}@article{baron1986moderator, author={Baron, Reuben M. and Kenny, David A.}, title={{The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations}}, journal={Journal of Personality and Social Psychology}, year={1986}, volume={51}, number={6}, pages={1173--1182}, doi={10.1037/0022-3514.51.6.1173}}@article{bauer2005probing, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Probing interactions in fixed and multilevel regression: Inferential and graphical techniques}}, journal={Multivariate Behavioral Research}, year={2005}, volume={40}, number={3}, pages={373--400}, doi={10.1207/s15327906mbr4003_5}}@article{dalal2012some, author={Dalal, Dev K. and Zickar, Michael J.}, title={{Some common myths about centering predictor variables in moderated multiple regression and polynomial regression}}, journal={Organizational Research Methods}, year={2012}, volume={15}, number={3}, pages={339--362}, doi={10.1177/1094428111430540}}@article{hainmueller2019how, author={Hainmueller, Jens and Mummolo, Jonathan and Xu, Yiqing}, title={{How much should we trust estimates from multiplicative interaction models? Simple tools to improve empirical practice}}, journal={Political Analysis}, year={2019}, volume={27}, number={2}, pages={163--192}, doi={10.1017/pan.2018.46}}@article{mcclelland1993statistical, author={McClelland, Gary H. and Judd, Charles M.}, title={{Statistical difficulties of detecting interactions and moderator effects}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={2}, pages={376--390}, doi={10.1037/0033-2909.114.2.376}}@article{spiller2013spotlights, author={Spiller, Stephen A. and Fitzsimons, Gavan J. and Lynch, Jr., John G. and McClelland, Gary H.}, title={{Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression}}, journal={Journal of Marketing Research}, year={2013}, volume={50}, number={2}, pages={277--288}, doi={10.1509/jmr.12.0420}}