ANCOVA na jednym obrazku: dwie równoległe proste
Definicję, model i założenia znajdziesz w haśle ANCOVA (analiza kowariancji), a porównanie czterech strategii analizy badania przed–po z grupą kontrolną – we wpisie ANCOVA w badaniu przed i po. Okna programów opisują wpisy ANCOVA w SPSS i ANCOVA w jamovi. Tu pokazujemy na rysunkach, co ANCOVA robi z danymi, skąd bierze precyzję i kiedy jej obraz przestaje być prawdziwy.
Przykład jest fikcyjny. Sześćdziesięciu uczniów wylosowano do sześciotygodniowej nauki słówek z aplikacją (30 osób) albo zwykłej nauki (30 osób). Przed nauką i po niej rozwiązali test słownictwa (0–60 punktów). Parametry populacji ustawiliśmy ręcznie: średnia 30 punktów przed, SD = 8 w obu pomiarach, korelacja pomiarów .7 i prawdziwy efekt aplikacji 4 punkty (0.5 SD). Ziarno 598 ustalono raz i nie zmieniano go. Dane pobierzesz jako ancova-slownictwo-60-osob.csv. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: średnie surowe i skorygowane
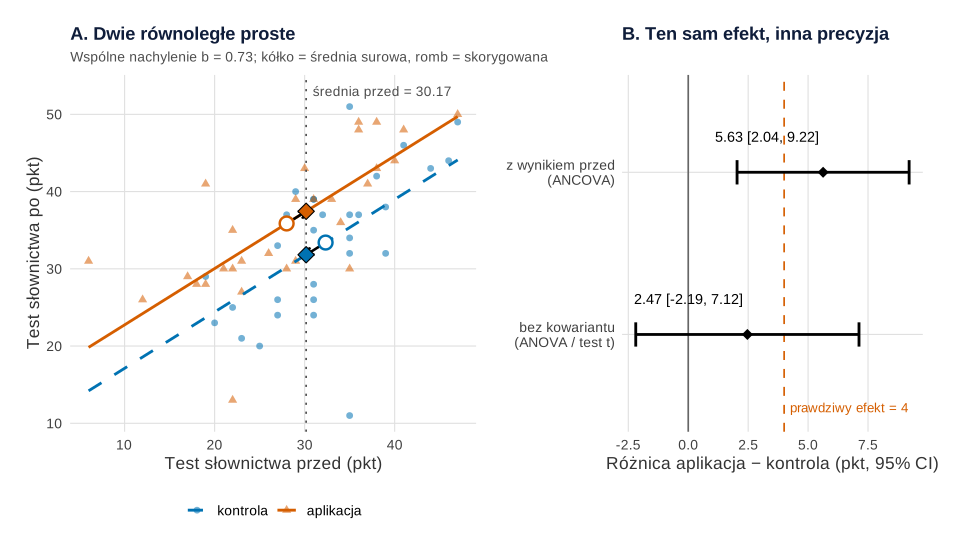
set.seed(598)).Co widać. ANCOVA dopasowuje w każdej grupie prostą wyniku po względem wyniku przed, z tym samym nachyleniem (b = 0.73). Kółko to średnia surowa grupy. Leży na prostej swojej grupy, bo prosta przechodzi przez środek chmury. Mimo losowania grupa kontrolna zaczynała wyżej: 32.33 wobec 28.00 punktu. Strzałka przesuwa każdą średnią wzdłuż prostej do średniego wyniku przed całej próby (30.17). Romb to średnia skorygowana: 31.82 w kontroli i 37.45 z aplikacją. Kontrola „traci” 1.58 punktu, bo startowała wyżej, a grupa z aplikacją tyle samo zyskuje. Efekt to pionowa odległość między prostymi.
Panel B pokazuje skutek. Same wyniki po dają różnicę 2.47 punktu, 95% CI [−2.19, 7.12], t(58) = 1.06, p = .293. ANCOVA daje 5.63 punktu, 95% CI [2.04, 9.22], t(57) = 3.14, p = .003. Różnica między liczbami to nachylenie razy przewaga kontroli na starcie: 0.73 × 4.33 ≈ 3.16.
Czego ten wykres nie pokazuje. Nie widać, czy nachylenia naprawdę są równe – model je zrównał (zob. rysunek 4). Przy losowym przydziale różnica 4.33 punktu na starcie jest przypadkowa. Korekta nie „naprawia” badania, tylko usuwa szum, który przypadek dołożył do jednej próby. W tej próbie ANCOVA trafiła dalej od prawdziwych 4 punktów niż różnica surowa. To też przypadek – o tym, co jest typowe, mówi dopiero rysunek 3. Jak ten sam szum wygląda w 1000 losowań, pokazuje wpis losowy przydział w eksperymencie w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: skąd bierze się precyzja
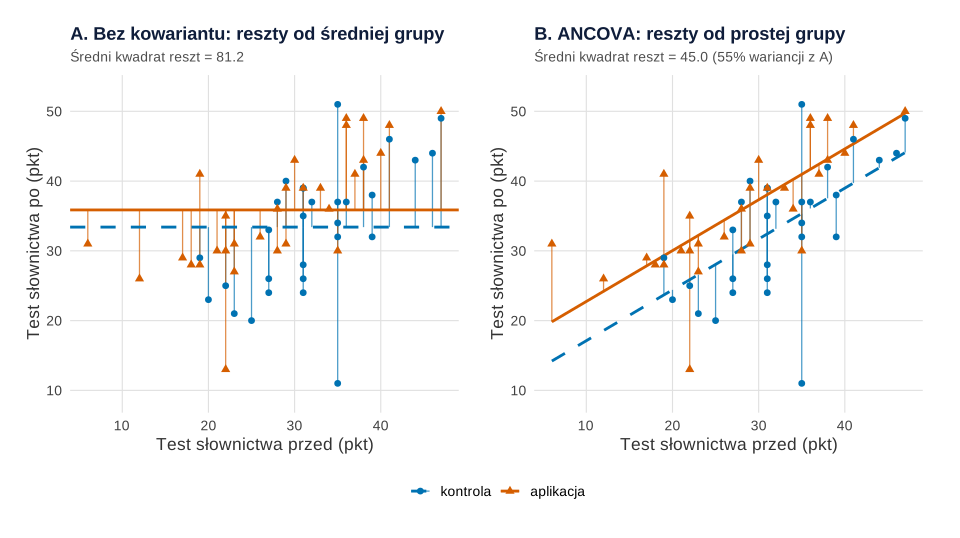
Co widać. Błąd w każdym modelu to pionowe odcinki od punktów do tego, co model przewiduje. Bez kowariantu przewidywaniem jest średnia grupy, czyli pozioma linia. W ANCOVA – prosta grupy. Uczeń, który miał dużo punktów przed, ma ich zwykle dużo także po. Pozioma linia tego nie widzi, prosta tak. Średni kwadrat reszt spada z 81.18 do 45.04, czyli do 55% wartości wyjściowej. Przybliżenie z kowariancji pomiarów daje 1 − r² = .545 przy korelacji w grupach r = .67. Podział wariancji przy trzech grupach rysuje wpis ANOVA w obrazkach.
Czego ten wykres nie pokazuje. Błąd standardowy różnicy spadł z 2.33 do 1.79, czyli mniej, niż sugeruje stosunek wariancji (pierwiastek z .555 to .745, a wyszło .77). Część zysku zjada korekta nierównowagi: im bardziej grupy różnią się kowariantem, tym mniej pewne jest przesunięcie wzdłuż prostych. Rysunek nie pokazuje też, że kowariant kosztuje jeden stopień swobody. Przy słabej korelacji to koszt bez zysku.
Podpis do pracy (np. w aneksie):
Zdanie do Metody:
Rysunek 3: 1000 badań bez kowariantu i z nim
Jedna próba może zmylić, więc powtarzamy badanie 1000 razy dla każdej z pięciu korelacji pomiarów (0, .3, .5, .7 i .9; wartości ustawione ręcznie). Schemat jest ten sam: 2 × 30 osób, losowy przydział, prawdziwy efekt 4 punkty. Liczymy różnicę bez kowariantu i ANCOVA. Błąd Monte Carlo pokrycia przedziału wynosi 0.69 punktu procentowego.
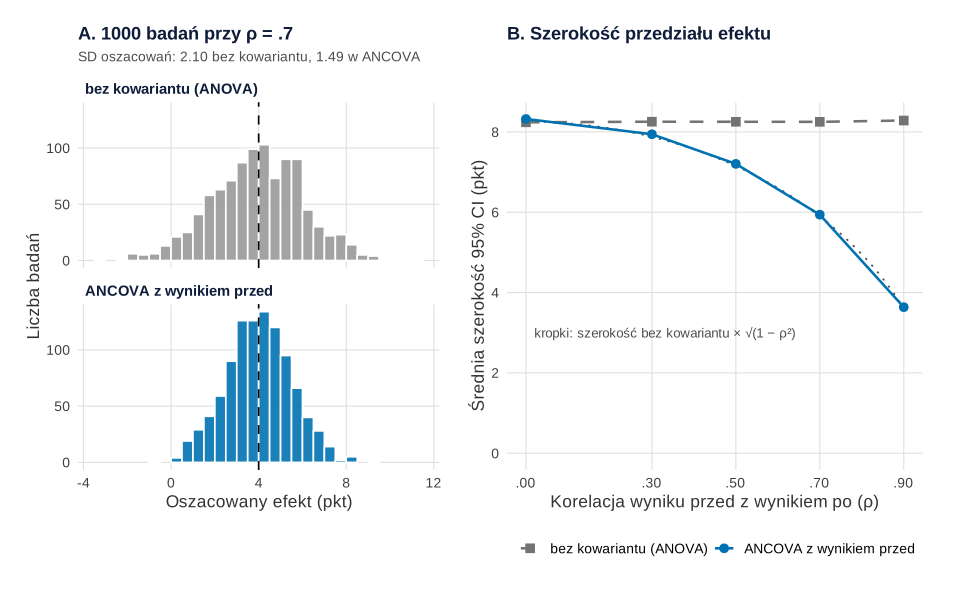
set.seed(598)).Co widać. Przy ρ = .7 oba histogramy mają środek przy 4 punktach (średnio 3.97 bez kowariantu i 4.01 w ANCOVA), ale rozrzut ANCOVA jest węższy: SD oszacowań 1.49 zamiast 2.10. Panel B: bez kowariantu średnia szerokość 95% CI nie zależy od korelacji (8.24–8.28 punktu). W ANCOVA maleje do 7.20 przy ρ = .5, 5.94 przy .7 i 3.64 przy .9. Kropkowana krzywa „szerokość × √(1 − ρ²)” prawie pokrywa się z symulacją. Przy ρ = 0 ANCOVA jest minimalnie szersza (8.32), bo traci stopień swobody na kowariant. Oba przedziały trafiały w prawdziwy efekt w 94.1–95.7% badań, czyli zgodnie z deklarowanym poziomem. Wzór Borma i in. (2007) mówi to samo w języku liczebności: ANCOVA na grupach liczących (1 − ρ²)n osób ma taką moc jak test na grupach po n osób. Przy ρ = .7 zamiast 30 osób na grupę wystarczy około 15.3, a przy ρ = .5 – 22.5.
Czego ten wykres nie pokazuje. Że ANCOVA jest nieobciążona i precyzyjniejsza także przy przypadkowej nierównowadze wyjściowej – to wynik symulacji Egbewalego i in. (2014). Van Breukelen (2006) dodaje, że w badaniach randomizowanych ANCOVA ma też większą moc niż analiza wskaźników zmiany. U nas moc przy ρ = .7 wyniosła .757 wobec .484 bez kowariantu. Moc trzech analiz w zależności od korelacji pokazuje wpis o badaniu przed i po, a ogólną zależność mocy od n – wpis moc testu w obrazkach.
Podpis do pracy (np. przy uzasadnieniu liczebności):
Zdanie do Metody (analiza liczebności):
Rysunek 4: gdy proste nie są równoległe
ANCOVA zakłada jedno nachylenie w obu grupach. Sprawdzamy wariant, w którym to nieprawda. W nowych fikcyjnych danych (120 uczniów, po 60 w grupie) aplikacja pomaga głównie słabszym na starcie. Parametry ustawiliśmy ręcznie: nachylenie 0.70 w kontroli i 0.35 z aplikacją, efekt 4 punkty przy wyniku przed równym 30.
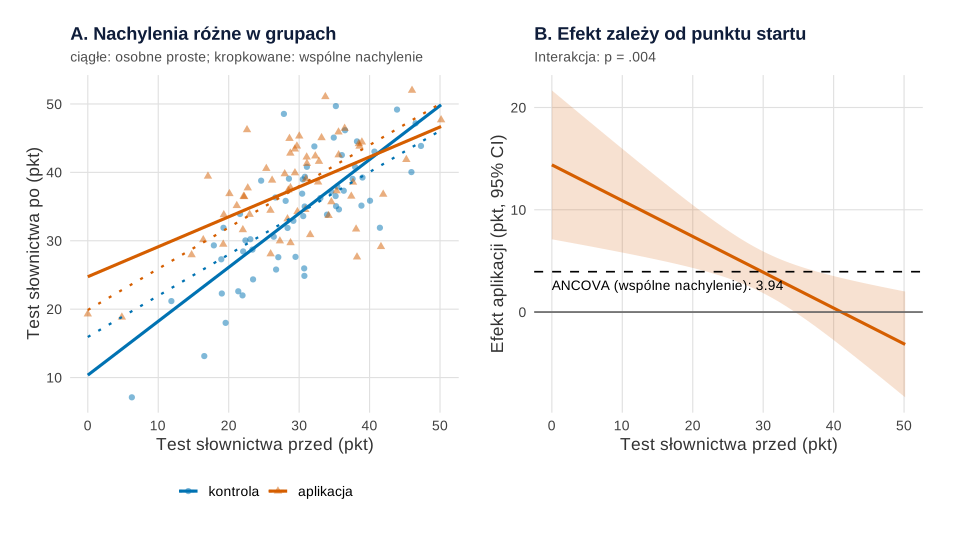
set.seed(598)).Co widać. W próbie nachylenia wyniosły 0.79 i 0.44, a test jednorodności nachyleń (interakcja wynik przed × grupa) dał F(1, 116) = 8.77, p = .004. Kropkowane proste ze wspólnym nachyleniem uśredniają dwie różne historie. ANCOVA podaje jeden efekt: 3.94 punktu. Model z interakcją pokazuje (panel B), że efekt zależy od wyniku przed. Przy 21.07 punktu (średnia − 1 SD) wynosi 7.01, 95% CI [4.12, 9.91], przy średniej (29.83) 3.95 [1.91, 5.99], a przy 38.58 punktu (+1 SD) 0.88 [−2.00, 3.77]. Powyżej około 34.3 punktu przedział obejmuje zero – to granica przedziału Johnsona–Neymana.
Czego ten wykres nie pokazuje. Nieistotny test interakcji nie dowodzi równoległości. W 1000 badaniach z tą samą różnicą nachyleń test wykrył ją w 48.1% badań przy 30 osobach na grupę (błąd MC 1.6 pp) i w 94.6% przy 100 osobach. Gdy interakcja jest wyraźna, opisz ją jak moderację, a nie „wyrównuj”. Proste nachylenia i wykres efektu warunkowego omawia wpis moderacja – wizualizacja na obrazkach. Szerokie pasmo na brzegach oznacza, że opiera się na kilku osobach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: grupy nierandomizowane i niedokładny kowariant
Wszystko powyżej dotyczy losowego przydziału. Teraz quasi-eksperyment (schemat quasi-eksperymentalny). Aplikację dostały dwie klasy profilowane językowo, a kontrolą są dwie klasy ogólne, po 60 uczniów. Prawdziwy poziom słownictwa wynosi średnio 36 i 28 punktów. Aplikacja nie działa: wszyscy zyskują po 3 punkty. Testy przed i po mierzą prawdziwy poziom z błędem. Rzetelność testu przed zmieniamy od .5 do 1, rzetelność testu po wynosi .8 (wartości ustawione ręcznie). Dla każdej rzetelności losujemy 1000 badań.
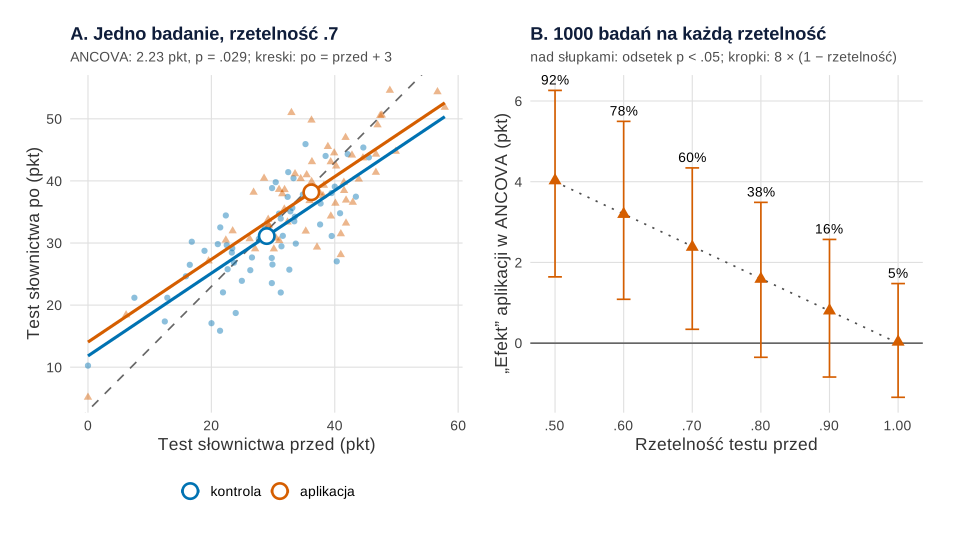
set.seed(598)).Co widać. W jednym badaniu przy rzetelności .7 klasy językowe miały na starcie przewagę 7.23 punktu, a po nauce 7.05 – przewaga się nie zmieniła. Nachylenie w ANCOVA wynosi jednak tylko 0.67, bo błąd pomiaru spłaszcza prostą. Korekta odejmuje więc tylko dwie trzecie różnicy wyjściowej, a resztę ANCOVA odczytuje jako efekt aplikacji: 2.23 punktu, p = .029. Panel B pokazuje, że to reguła, a nie pech. Przy rzetelności .7 ANCOVA dawała średnio 2.38 punktu i „istotny efekt” w 60.0% badań. Przy .5 – 4.03 punktu i 92.3%, przy .9 – 0.80 punktu i 15.6%. Dopiero przy pomiarze bez błędu wynik spadł do 0.03 punktu, a odsetek fałszywych alarmów do 4.5%. Średnie leżą na kropkowanej linii 8 × (1 − rzetelność), czyli różnica prawdziwego poziomu razy część, której kowariant „nie widzi”. Mechanizm spłaszczania prostej przez błąd pomiaru pokazuje wpis rzetelność i błąd pomiaru – wizualizacja na obrazkach, a cofanie się skrajnych wyników – wpis regresja do średniej – wizualizacja na obrazkach.
Culpepper i Aguinis (2011) opisują ten sam problem analitycznie i w symulacjach: przy kowariancie mierzonym z błędem ANCOVA w badaniach nieeksperymentalnych daje obciążone oszacowania i zawyżony odsetek błędów I rodzaju. Miller i Chapman (2001) przestrzegają przed używaniem ANCOVA do „kontrolowania” rzeczywistych różnic między grupami. Lord (1967) pokazał już dawno, że przy grupach naturalnych, nierównych na starcie, wynik zależy od wyboru analizy.
Czego ten wykres nie pokazuje. W tych danych analiza zmian (po − przed) trafiła w zero (średnio od −0.01 do 0.06 punktu), ale tylko dlatego, że wygenerowaliśmy je z równym przyrostem w obu grupach. Gdy do grupy kwalifikuje się według samego wyniku przed, rację ma ANCOVA, a analiza zmian się myli. Trzy takie scenariusze porównuje wpis paradoks Lorda: ANCOVA czy wynik różnicowy?, a przyczynowe ujęcie – wpis zmienna zakłócająca i collider – wizualizacja na obrazkach. Van Breukelen (2006) podsumowuje: w badaniach nierandomizowanych obie metody mogą dawać sprzeczne wyniki, bo ANCOVA zakłada brak różnic wyjściowych.
Podpis do pracy (aneks lub Dyskusja):
Zdanie do Dyskusji:
Co z tego wziąć do pracy
- Kowariant zaplanuj przed badaniem i wybierz go dlatego, że silnie koreluje z wynikiem, a nie dlatego, że grupy „istotnie różniły się” na starcie (rysunki 1–3).
- Pokaż rysunek 1 albo jego wariant – chmurę punktów z prostymi grup i średnimi skorygowanymi. To lepsze niż dwa słupki średnich surowych.
- Sprawdź równoległość prostych na wykresie i testem interakcji (rysunek 4). Przy wyraźnej interakcji raportuj efekty warunkowe.
- Przy grupach istniejących (klasy, oddziały, kierunki) opisz, jak powstały grupy, podaj rzetelność kowariantu i oba wyniki: ANCOVA i analizę zmian. Bez randomizacji wniosek przyczynowy formułuj ostrożnie (rysunek 5).
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 3, 4 i 5), zaczyna się od własnego set.seed(598), więc skopiowany osobno da te same liczby co na stronie. Ziarno 598 ustalono raz i nie zmieniano go. Ręcznie ustalono: średnią 30 punktów przed, SD = 8, korelację .7 i efekt 4 punkty w przykładzie z 60 osobami; pięć korelacji i 1000 powtórzeń w symulacji precyzji; nachylenia 0.70 i 0.35, SD reszt 5.5 i 60 osób na grupę w przykładzie z nierównymi nachyleniami; poziomy 36 i 28 punktów, przyrost 3 punkty, rzetelności .5–1 (test przed) i .8 (test po) w quasi-eksperymencie. Wyniki obcięto do skali testu 0–60 w przepisach 4 i 5. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilkanaście sekund.
1. Dane, dwa modele i średnie skorygowane: Rysunek 1
R
# Rysunek 1. ANCOVA jako dwie równoległe proste: średnie surowe i skorygowane (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(kontrola = "#0072B2", aplikacja = "#D55E00", szary = "grey55")
ksz <- c(kontrola = 16, aplikacja = 17)                    # kształt punktów: koło i trójkąt
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03
p_apa <- function(p) ifelse(p < .001, "p < .001", paste("p =", bz(p, 3)))

# Fikcyjny eksperyment: 60 uczniów wylosowanych do nauki słówek z aplikacją (30) albo zwykłej nauki (30).
# Test słownictwa (0–60 pkt) przed 6 tygodniami nauki i po nich.
# Parametry populacji ustalone ręcznie: średnia 30 pkt przed, SD 8 w obu pomiarach,
# korelacja pomiarów .7, po nauce +3 pkt w kontroli i +7 pkt z aplikacją (efekt 4 pkt = 0.5 SD)
n <- 30; sd_pop <- 8; rho <- 0.7; efekt <- 4
set.seed(598)                                     # ziarno ustalone raz, bez dobierania pod wynik
grupa <- factor(rep(c("kontrola", "aplikacja"), each = n), c("kontrola", "aplikacja"))
z1 <- rnorm(2 * n); z2 <- rnorm(2 * n)
przed <- round(30 + sd_pop * z1)
po <- round(33 + efekt * (grupa == "aplikacja") + sd_pop * (rho * z1 + sqrt(1 - rho^2) * z2))
dane <- data.frame(id = 1:(2 * n), grupa, przed, po)
write.csv(dane, "ancova-slownictwo-60-osob.csv", row.names = FALSE)

# Średnie w grupach i korelacja pomiarów wewnątrz grup
opis <- aggregate(cbind(przed, po) ~ grupa, dane, mean)
opis[-1] <- round(opis[-1], 2); opis
round(c(r_w_grupach = cor(resid(lm(przed ~ grupa, dane)), resid(lm(po ~ grupa, dane)))), 2)

# Dwa modele: porównanie samych wyników po (ANOVA = test t) i ANCOVA z wynikiem przed
m_anova <- lm(po ~ grupa, dane)
m_ancova <- lm(po ~ przed + grupa, dane)
round(rbind(ANOVA = c(coef(summary(m_anova))["grupaaplikacja", ], confint(m_anova)["grupaaplikacja", ]),
            ANCOVA = c(coef(summary(m_ancova))["grupaaplikacja", ], confint(m_ancova)["grupaaplikacja", ])), 3)
round(coef(m_ancova), 3)

# Średnie skorygowane = wartość prostej grupy przy średnim wyniku przed (całej próby)
mx <- mean(dane$przed)
skor <- predict(m_ancova, data.frame(przed = mx, grupa = levels(grupa)), interval = "confidence")
srednie <- data.frame(grupa = factor(levels(grupa), levels(grupa)), przed_M = opis$przed, po_M = opis$po,
                      skorygowana = skor[, "fit"], dolna = skor[, "lwr"], gorna = skor[, "upr"])
srednie$korekta <- srednie$skorygowana - srednie$po_M      # = −b × (średnia grupy przed − średnia ogólna)
round(cbind(srednie[-1]), 2); round(mx, 2)

# A: punkty, dwie równoległe proste, przesunięcie średnich wzdłuż prostych do średniej ogólnej
siatka <- expand.grid(przed = seq(min(dane$przed), max(dane$przed), length.out = 50), grupa = levels(grupa))
siatka$po <- predict(m_ancova, siatka)
pa <- ggplot(dane, aes(przed, po, colour = grupa, shape = grupa)) +
  geom_point(size = 2, alpha = 0.55) +
  geom_line(data = siatka, aes(linetype = grupa), linewidth = 1) +
  geom_vline(xintercept = mx, linetype = "dotted", colour = "grey30") +
  geom_segment(data = srednie, aes(x = przed_M, y = po_M, xend = mx, yend = skorygowana),
               arrow = arrow(length = unit(2.2, "mm")), linewidth = 0.9, colour = "black", show.legend = FALSE) +
  geom_point(data = srednie, aes(przed_M, po_M), size = 4, shape = 21, fill = "white", stroke = 1.3,
             show.legend = FALSE) +
  geom_point(data = srednie, aes(mx, skorygowana, fill = grupa), size = 4.2, shape = 23, colour = "black",
             show.legend = FALSE) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_fill_manual(values = kol[1:2], guide = "none") +
  scale_shape_manual(values = ksz, name = NULL) +
  scale_linetype_manual(values = c(kontrola = "dashed", aplikacja = "solid"), name = NULL) +
  annotate("text", x = mx, y = max(dane$po) + 2, label = paste("średnia przed =", sprintf("%.2f", mx)),
           hjust = -0.05, size = 3.6, colour = "grey30") +
  labs(x = "Test słownictwa przed (pkt)", y = "Test słownictwa po (pkt)",
       title = "A. Dwie równoległe proste",
       subtitle = sprintf("Wspólne nachylenie b = %.2f; kółko = średnia surowa, romb = skorygowana",
                          coef(m_ancova)["przed"])) + motyw

# B: różnica grup (aplikacja − kontrola) z 95% CI bez kowariantu i z nim
roznice <- data.frame(model = factor(c("bez kowariantu\n(ANOVA / test t)", "z wynikiem przed\n(ANCOVA)"),
                                     c("bez kowariantu\n(ANOVA / test t)", "z wynikiem przed\n(ANCOVA)")),
                      est = c(coef(m_anova)[2], coef(m_ancova)[3]),
                      dolna = c(confint(m_anova)[2, 1], confint(m_ancova)[3, 1]),
                      gorna = c(confint(m_anova)[2, 2], confint(m_ancova)[3, 2]))
pb <- ggplot(roznice, aes(est, model)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_vline(xintercept = efekt, linetype = "dashed", colour = kol[["aplikacja"]]) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, linewidth = 1, orientation = "y") +
  geom_point(size = 3.5, shape = 18) +
  geom_text(aes(label = sprintf("%.2f [%.2f, %.2f]", est, dolna, gorna)), nudge_y = 0.22, hjust = 1.05, size = 3.8) +
  annotate("text", x = efekt, y = 0.55, label = "prawdziwy efekt = 4", hjust = -0.05, size = 3.5,
           colour = kol[["aplikacja"]]) +
  labs(x = "Różnica aplikacja − kontrola (pkt, 95% CI)", y = NULL, title = "B. Ten sam efekt, inna precyzja") +
  motyw
p1 <- pa + pb + plot_layout(widths = c(1.35, 1))
p1   # zapis: ggsave("ancova-rownolegle-proste.svg", p1, width = 10, height = 5.6)
Wynik w R
      grupa przed    po
1  kontrola 32.33 33.40
2 aplikacja 28.00 35.87
r_w_grupach
       0.67
       Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
ANOVA     2.467      2.326   1.060    0.293 -2.190  7.124
ANCOVA    5.626      1.792   3.139    0.003  2.036  9.215
   (Intercept)          przed grupaaplikacja
         9.828          0.729          5.626
  przed_M  po_M skorygowana dolna gorna korekta
1   32.33 33.40       31.82 29.32 34.32   -1.58
2   28.00 35.87       37.45 34.95 39.94    1.58
[1] 30.17
2. Reszty bez kowariantu i w ANCOVA: Rysunek 2
R
# Rysunek 2. Skąd ANCOVA bierze precyzję: reszty wokół średnich grup i wokół równoległych prostych
# (kontynuacja: dane, m_anova, m_ancova, kol, ksz, motyw z przepisu 1)
library(ggplot2)
library(patchwork)

dane$dop_anova <- fitted(m_anova)                 # średnia grupy w wyniku po
dane$dop_ancova <- fitted(m_ancova)               # punkt na prostej grupy
# Wariancja błędu (średni kwadrat reszt) i błąd standardowy różnicy grup w obu modelach
mse <- c(ANOVA = sigma(m_anova)^2, ANCOVA = sigma(m_ancova)^2)
se <- c(ANOVA = coef(summary(m_anova))["grupaaplikacja", 2], ANCOVA = coef(summary(m_ancova))["grupaaplikacja", 2])
r_w <- cor(resid(lm(przed ~ grupa, dane)), resid(lm(po ~ grupa, dane)))
round(rbind(MSE = mse, SE_roznicy = se, szerokosc_CI = 2 * qt(.975, c(58, 57)) * se), 2)
round(c(stosunek_MSE = unname(mse["ANCOVA"] / mse["ANOVA"]), jeden_minus_r2 = 1 - r_w^2,
        stosunek_SE = unname(se["ANCOVA"] / se["ANOVA"])), 3)

rysuj <- function(dop, tytul, podtytul, linie) {
  ggplot(dane, aes(przed, po, colour = grupa, shape = grupa)) +
    geom_segment(aes(xend = przed, yend = .data[[dop]]), linewidth = 0.45, alpha = 0.7) +
    linie +
    geom_point(size = 2) +
    scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
    scale_linetype_manual(values = c(kontrola = "dashed", aplikacja = "solid"), name = NULL) +
    coord_cartesian(ylim = range(dane$po) + c(-2, 2)) +
    labs(x = "Test słownictwa przed (pkt)", y = "Test słownictwa po (pkt)", title = tytul, subtitle = podtytul) +
    motyw
}
sr <- aggregate(po ~ grupa, dane, mean)
siatka <- expand.grid(przed = range(dane$przed), grupa = levels(dane$grupa))
siatka$po <- predict(m_ancova, siatka)
p2a <- rysuj("dop_anova", "A. Bez kowariantu: reszty od średniej grupy",
             sprintf("Średni kwadrat reszt = %.1f", mse["ANOVA"]),
             geom_hline(data = sr, aes(yintercept = po, colour = grupa, linetype = grupa), linewidth = 1))
p2b <- rysuj("dop_ancova", "B. ANCOVA: reszty od prostej grupy",
             sprintf("Średni kwadrat reszt = %.1f (%.0f%% wariancji z A)", mse["ANCOVA"],
                     100 * mse["ANCOVA"] / mse["ANOVA"]),
             geom_line(data = siatka, aes(linetype = grupa), linewidth = 1))
p2 <- p2a + p2b + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("ancova-reszty-bez-i-z-kowariantem.svg", p2, width = 10, height = 5.6)
Wynik w R
             ANOVA ANCOVA
MSE          81.18  45.04
SE_roznicy    2.33   1.79
szerokosc_CI  9.31   7.18
  stosunek_MSE jeden_minus_r2    stosunek_SE
         0.555          0.545          0.770
3. 1000 badań dla pięciu korelacji: Rysunek 3
R
# Rysunek 3. 1000 badań: rozkład oszacowań i szerokość 95% CI bez kowariantu i z nim
# (kontynuacja: kol, motyw z przepisu 1)
library(ggplot2)
library(patchwork)

# Ten sam schemat co w przykładzie: 2 × 30 osób, losowy przydział, SD = 8, efekt 4 pkt (0.5 SD);
# zmieniamy tylko korelację wyniku przed z wynikiem po (ustalone ręcznie: 0, .3, .5, .7, .9)
jedno_badanie <- function(rho, n = 30, sd_pop = 8, efekt = 4) {
  g <- rep(0:1, each = n); z1 <- rnorm(2 * n); z2 <- rnorm(2 * n)
  przed <- 30 + sd_pop * z1
  po <- 33 + efekt * g + sd_pop * (rho * z1 + sqrt(1 - rho^2) * z2)
  wynik <- function(m) { s <- coef(summary(m))["g", ]; ci <- confint(m)["g", ]
    c(est = s[["Estimate"]], szer = diff(ci), trafia = ci[1] <= efekt & efekt <= ci[2], istotny = s[[4]] < .05) }
  c(rho = rho, roznica_przed = mean(przed[g == 1]) - mean(przed[g == 0]),
    anova = wynik(lm(po ~ g)), ancova = wynik(lm(po ~ przed + g)))
}
R <- 1000
set.seed(598)                                     # to samo ziarno co w przepisie 1
sym <- as.data.frame(do.call(rbind, lapply(c(0, .3, .5, .7, .9), function(r)
  t(replicate(R, jedno_badanie(r))))))

# Dla każdej korelacji: średnie oszacowanie, SD oszacowań, średnia szerokość CI, pokrycie, moc
podsum <- do.call(rbind, lapply(split(sym, sym$rho), function(s) data.frame(
  rho = s$rho[1], model = c("ANOVA", "ANCOVA"),
  srednia = c(mean(s$anova.est), mean(s$ancova.est)), SD = c(sd(s$anova.est), sd(s$ancova.est)),
  szer_CI = c(mean(s$anova.szer), mean(s$ancova.szer)),
  pokrycie = c(mean(s$anova.trafia), mean(s$ancova.trafia)), moc = c(mean(s$anova.istotny), mean(s$ancova.istotny)))))
rownames(podsum) <- NULL
podsum$wzor_szer <- ifelse(podsum$model == "ANCOVA", 1, NA) *
  podsum$szer_CI[podsum$model == "ANOVA"][match(podsum$rho, unique(podsum$rho))] * sqrt(1 - podsum$rho^2)
print(cbind(podsum[1:2], round(podsum[-(1:2)], 3)), row.names = FALSE)
round(c(blad_MC_pokrycia = sqrt(.95 * .05 / R), blad_MC_mocy_max = sqrt(.25 / R)), 4)
# Równoważna liczebność wg wzoru (1 − ρ²): ilu osób na grupę potrzebuje ANCOVA zamiast 30 bez kowariantu
round(setNames(30 * (1 - c(0, .3, .5, .7, .9)^2), c(0, .3, .5, .7, .9)), 1)

# A: 1000 oszacowań przy ρ = .7 – ten sam środek, różny rozrzut
s7 <- subset(sym, rho == 0.7)
d7 <- data.frame(model = factor(rep(c("bez kowariantu (ANOVA)", "ANCOVA z wynikiem przed"), each = R),
                                c("bez kowariantu (ANOVA)", "ANCOVA z wynikiem przed")),
                 est = c(s7$anova.est, s7$ancova.est))
p3a <- ggplot(d7, aes(est, fill = model)) +
  geom_histogram(binwidth = 0.5, boundary = 4, colour = "white", alpha = 0.9) +
  geom_vline(xintercept = 4, linetype = "dashed") +
  facet_wrap(~ model, ncol = 1) +
  scale_fill_manual(values = c("grey60", kol[["kontrola"]]), guide = "none") +
  labs(x = "Oszacowany efekt (pkt)", y = "Liczba badań", title = "A. 1000 badań przy ρ = .7",
       subtitle = sprintf("SD oszacowań: %.2f bez kowariantu, %.2f w ANCOVA",
                          sd(s7$anova.est), sd(s7$ancova.est))) + motyw

# B: średnia szerokość 95% CI efektu w funkcji korelacji przed–po
pod_b <- subset(podsum, select = c(rho, model, szer_CI))
pod_b$model <- factor(pod_b$model, c("ANOVA", "ANCOVA"), c("bez kowariantu (ANOVA)", "ANCOVA z wynikiem przed"))
wzor <- data.frame(rho = seq(0, .9, .01))
wzor$szer <- mean(podsum$szer_CI[podsum$model == "ANOVA"]) * sqrt(1 - wzor$rho^2)
p3b <- ggplot(pod_b, aes(rho, szer_CI, colour = model, shape = model)) +
  geom_line(data = wzor, aes(rho, szer), inherit.aes = FALSE, linetype = "dotted", colour = "grey30") +
  geom_line(aes(linetype = model), linewidth = 0.9) + geom_point(size = 3) +
  scale_colour_manual(values = c("grey45", kol[["kontrola"]]), name = NULL) +
  scale_shape_manual(values = c(15, 16), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_x_continuous(breaks = c(0, .3, .5, .7, .9), labels = bz) +
  scale_y_continuous(limits = c(0, NA)) +
  annotate("text", x = 0.02, y = 3, label = "kropki: szerokość bez kowariantu × √(1 − ρ²)", hjust = 0,
           size = 3.5, colour = "grey30") +
  labs(x = "Korelacja wyniku przed z wynikiem po (ρ)", y = "Średnia szerokość 95% CI (pkt)",
       title = "B. Szerokość przedziału efektu") + motyw
p3 <- p3a + p3b + plot_layout(widths = c(1, 1.15)) & theme(legend.position = "bottom")
p3   # zapis: ggsave("ancova-1000-badan-precyzja.svg", p3, width = 10, height = 6)
Wynik w R
 rho  model srednia    SD szer_CI pokrycie   moc wzor_szer
 0.0  ANOVA   3.916 2.098   8.239    0.943 0.467        NA
 0.0 ANCOVA   3.905 2.126   8.322    0.943 0.448     8.239
 0.3  ANOVA   3.968 2.045   8.255    0.957 0.468        NA
 0.3 ANCOVA   3.956 1.974   7.942    0.957 0.499     7.874
 0.5  ANOVA   3.969 2.110   8.253    0.948 0.480        NA
 0.5 ANCOVA   3.982 1.806   7.204    0.945 0.591     7.147
 0.7  ANOVA   3.970 2.103   8.251    0.941 0.484        NA
 0.7 ANCOVA   4.007 1.494   5.939    0.950 0.757     5.893
 0.9  ANOVA   4.014 2.102   8.284    0.941 0.483        NA
 0.9 ANCOVA   4.037 0.929   3.636    0.943 0.988     3.611
blad_MC_pokrycia blad_MC_mocy_max
          0.0069           0.0158
   0  0.3  0.5  0.7  0.9
30.0 27.3 22.5 15.3  5.7
4. Nierówne nachylenia i efekt warunkowy: Rysunek 4
R
# Rysunek 4. Złamana jednorodność nachyleń: efekt aplikacji zależy od wyniku przed
# (kontynuacja: kol, ksz, motyw, p_apa z przepisu 1)
library(ggplot2)
library(patchwork)

# Fikcyjny wariant: aplikacja pomaga głównie słabszym na starcie. Parametry ustalone ręcznie:
# kontrola: nachylenie 0.70, aplikacja: 0.35; przy wyniku przed = 30 efekt 4 pkt; SD reszt 5.5
gen_nachylenia <- function(n) {
  g <- rep(0:1, each = n); przed <- 30 + 8 * rnorm(2 * n)
  po <- 33 + 4 * g + (0.70 - 0.35 * g) * (przed - 30) + 5.5 * rnorm(2 * n)
  przed <- pmin(pmax(przed, 0), 60); po <- pmin(pmax(po, 0), 60)     # skala testu 0–60 pkt
  data.frame(grupa = factor(g, 0:1, c("kontrola", "aplikacja")), przed, po)
}
set.seed(598)
d4 <- gen_nachylenia(60)

# Test jednorodności nachyleń (interakcja wynik przed × grupa) i nachylenia w grupach
m_wspolne <- lm(po ~ przed + grupa, d4)
m_inter <- lm(po ~ przed * grupa, d4)
anova(m_wspolne, m_inter)
round(c(nachyl_kontrola = coef(m_inter)[["przed"]],
        nachyl_aplikacja = coef(m_inter)[["przed"]] + coef(m_inter)[["przed:grupaaplikacja"]],
        efekt_ANCOVA_wspolne = coef(m_wspolne)[["grupaaplikacja"]]), 2)

# Efekt aplikacji przy różnych wynikach przed (z modelu z interakcją) z 95% CI
efekt_przy <- function(x) {
  L <- c(0, 0, 1, x)                                # grupa + interakcja × x
  est <- sum(L * coef(m_inter)); se <- sqrt(drop(t(L) %*% vcov(m_inter) %*% L))
  c(przed = x, efekt = est, dolna = est - qt(.975, df.residual(m_inter)) * se,
    gorna = est + qt(.975, df.residual(m_inter)) * se)
}
M <- mean(d4$przed); S <- sd(d4$przed)
round(t(sapply(c(M - S, M, M + S), efekt_przy)), 2)
krzywa <- as.data.frame(t(sapply(seq(min(d4$przed), max(d4$przed), length.out = 200), efekt_przy)))
# Granica, powyżej której 95% CI efektu obejmuje zero (odczyt z siatki – obszar Johnsona–Neymana)
round(max(krzywa$przed[krzywa$dolna > 0]), 1)

# Ile badań wykryje taką różnicę nachyleń? 1000 badań po 30 i po 100 osób na grupę
set.seed(598)
moc_inter <- sapply(c(30, 100), function(n) mean(replicate(1000, {
  d <- gen_nachylenia(n); anova(lm(po ~ przed + grupa, d), lm(po ~ przed * grupa, d))[2, "Pr(>F)"] < .05 })))
round(rbind(n_na_grupe = c(30, 100), moc_testu_interakcji = moc_inter,
            blad_MC = sqrt(moc_inter * (1 - moc_inter) / 1000)), 3)

# A: osobne proste (ciągłe) i wymuszone równoległe proste ANCOVA (kropkowane)
sia <- expand.grid(przed = range(d4$przed), grupa = levels(d4$grupa))
sia$osobne <- predict(m_inter, sia); sia$wspolne <- predict(m_wspolne, sia)
p4a <- ggplot(d4, aes(przed, po, colour = grupa, shape = grupa)) +
  geom_point(size = 1.8, alpha = 0.5) +
  geom_line(data = sia, aes(y = osobne), linewidth = 1.1) +
  geom_line(data = sia, aes(y = wspolne), linewidth = 0.8, linetype = "dotted") +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  labs(x = "Test słownictwa przed (pkt)", y = "Test słownictwa po (pkt)",
       title = "A. Nachylenia różne w grupach",
       subtitle = "ciągłe: osobne proste; kropkowane: wspólne nachylenie") + motyw

# B: efekt aplikacji w funkcji wyniku przed, z 95% CI; poziomo – jedna liczba z ANCOVA
p4b <- ggplot(krzywa, aes(przed, efekt)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = kol[["aplikacja"]], alpha = 0.18) +
  geom_line(linewidth = 1.1, colour = kol[["aplikacja"]]) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_hline(yintercept = coef(m_wspolne)[["grupaaplikacja"]], linetype = "dashed") +
  annotate("text", x = min(d4$przed), y = coef(m_wspolne)[["grupaaplikacja"]] - 1.3, hjust = 0, size = 3.6,
           label = sprintf("ANCOVA (wspólne nachylenie): %.2f", coef(m_wspolne)[["grupaaplikacja"]])) +
  labs(x = "Test słownictwa przed (pkt)", y = "Efekt aplikacji (pkt, 95% CI)",
       title = "B. Efekt zależy od punktu startu",
       subtitle = sprintf("Interakcja: %s", p_apa(anova(m_wspolne, m_inter)[2, "Pr(>F)"]))) + motyw
p4 <- p4a + p4b & theme(legend.position = "bottom")
p4   # zapis: ggsave("ancova-niejednorodne-nachylenia.svg", p4, width = 10, height = 5.6)
Wynik w R
Analysis of Variance Table

Model 1: po ~ przed + grupa
Model 2: po ~ przed * grupa
  Res.Df    RSS Df Sum of Sq      F   Pr(>F)
1    117 3958.4
2    116 3680.1  1    278.24 8.7704 0.003714 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
     nachyl_kontrola     nachyl_aplikacja efekt_ANCOVA_wspolne
                0.79                 0.44                 3.94
     przed efekt dolna gorna
[1,] 21.07  7.01  4.12  9.91
[2,] 29.83  3.95  1.91  5.99
[3,] 38.58  0.88 -2.00  3.77
[1] 34.3
                       [,1]    [,2]
n_na_grupe           30.000 100.000
moc_testu_interakcji  0.481   0.946
blad_MC               0.016   0.007
5. Quasi-eksperyment i rzetelność kowariantu: Rysunek 5
R
# Rysunek 5. Grupy nierandomizowane i kowariant mierzony z błędem: ANCOVA „znajduje” nieistniejący efekt
# (kontynuacja: kol, ksz, motyw, bz, p_apa z przepisu 1)
library(ggplot2)
library(patchwork)

# Fikcyjny quasi-eksperyment: aplikację dostały 2 klasy profilowane językowo, kontrolą są 2 klasy ogólne
# (po 60 uczniów). Prawdziwy poziom słownictwa: 36 vs 28 pkt (SD 7). Aplikacja NIE działa:
# wszyscy zyskują 3 pkt. Test przed i po mierzą prawdziwy poziom z błędem; rzetelność testu przed
# zmieniamy (ustalone ręcznie: .5–1), rzetelność testu po = .8
quasi <- function(rzet, n = 60, roznica = 8, sd_T = 7) {
  g <- rep(0:1, each = n); T <- 28 + roznica * g + sd_T * rnorm(2 * n)
  sd_e <- function(r) sd_T * sqrt((1 - r) / r)
  przed <- T + sd_e(rzet) * rnorm(2 * n)
  po <- T + 3 + sd_e(0.8) * rnorm(2 * n)
  przed <- pmin(pmax(przed, 0), 60); po <- pmin(pmax(po, 0), 60)     # skala testu 0–60 pkt
  data.frame(g, grupa = factor(g, 0:1, c("kontrola", "aplikacja")), T, przed, po)
}
set.seed(598)
d5 <- quasi(0.7)                                   # jedno badanie przy rzetelności .7
m5 <- lm(po ~ przed + grupa, d5)
round(c(roznica_przed = diff(tapply(d5$przed, d5$grupa, mean)), roznica_po = diff(tapply(d5$po, d5$grupa, mean)),
        nachylenie = coef(m5)[["przed"]], ANCOVA = coef(m5)[["grupaaplikacja"]],
        p_ANCOVA = coef(summary(m5))["grupaaplikacja", 4],
        zmiana = coef(lm(I(po - przed) ~ grupa, d5))[["grupaaplikacja"]]), 3)

# 1000 badań dla każdej rzetelności testu przed: oszacowanie ANCOVA i odsetek „istotnych efektów”
R <- 1000; rzetelnosci <- c(.5, .6, .7, .8, .9, 1)
set.seed(598)
q <- do.call(rbind, lapply(rzetelnosci, function(r) t(replicate(R, {
  d <- quasi(r); s <- coef(summary(lm(po ~ przed + grupa, d)))["grupaaplikacja", ]
  c(rzet = r, est = s[[1]], istotny = s[[4]] < .05, zmiana = coef(lm(I(po - przed) ~ grupa, d))[[2]]) }))))
q <- as.data.frame(q)
wyn5 <- do.call(rbind, lapply(split(q, q$rzet), function(s) c(rzet = s$rzet[1], srednia = mean(s$est),
  dolny_2.5 = unname(quantile(s$est, .025)), gorny_97.5 = unname(quantile(s$est, .975)),
  wzor = 8 * (1 - s$rzet[1]), istotne = mean(s$istotny), blad_MC = sd(s$istotny) / sqrt(R),
  zmiana_srednia = mean(s$zmiana))))
round(wyn5, 3)

# A: jedno badanie (rzetelność .7) – chmury punktów i równoległe proste ANCOVA
sia <- expand.grid(przed = range(d5$przed), grupa = levels(d5$grupa)); sia$po <- predict(m5, sia)
sr5 <- aggregate(cbind(przed, po) ~ grupa, d5, mean)
p5a <- ggplot(d5, aes(przed, po, colour = grupa, shape = grupa)) +
  geom_abline(intercept = 3, slope = 1, colour = "grey40", linetype = "dashed") +
  geom_point(size = 1.8, alpha = 0.45) +
  geom_line(data = sia, linewidth = 1.1) +
  geom_point(data = sr5, size = 4.5, shape = 21, fill = "white", stroke = 1.4) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  labs(x = "Test słownictwa przed (pkt)", y = "Test słownictwa po (pkt)",
       title = "A. Jedno badanie, rzetelność .7",
       subtitle = sprintf("ANCOVA: %.2f pkt, %s; kreski: po = przed + 3",
                          coef(m5)[["grupaaplikacja"]], p_apa(coef(summary(m5))["grupaaplikacja", 4]))) + motyw

# B: średnie oszacowanie ANCOVA (95% oszacowań) w funkcji rzetelności testu przed
w5 <- as.data.frame(wyn5)
p5b <- ggplot(w5, aes(rzet, srednia)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(aes(y = wzor), linetype = "dotted", colour = "grey30") +
  geom_errorbar(aes(ymin = dolny_2.5, ymax = gorny_97.5), width = 0.02, colour = kol[["aplikacja"]]) +
  geom_point(size = 3, colour = kol[["aplikacja"]], shape = 17) +
  geom_text(aes(y = gorny_97.5, label = paste0(sprintf("%.0f", 100 * istotne), "%")), vjust = -0.6, size = 3.6) +
  scale_x_continuous(breaks = rzetelnosci, labels = bz) +
  labs(x = "Rzetelność testu przed", y = "„Efekt” aplikacji w ANCOVA (pkt)",
       title = "B. 1000 badań na każdą rzetelność",
       subtitle = "nad słupkami: odsetek p < .05; kropki: 8 × (1 − rzetelność)") + motyw
p5 <- p5a + p5b & theme(legend.position = "bottom")
p5   # zapis: ggsave("ancova-grupy-nielosowe-rzetelnosc.svg", p5, width = 10, height = 5.6)
Wynik w R
roznica_przed.aplikacja    roznica_po.aplikacja              nachylenie
                  7.227                   7.046                   0.666
                 ANCOVA                p_ANCOVA                  zmiana
                  2.231                   0.029                  -0.181
    rzet srednia dolny_2.5 gorny_97.5 wzor istotne blad_MC zmiana_srednia
0.5  0.5   4.029     1.642      6.263  4.0   0.923   0.008          0.064
0.6  0.6   3.195     1.086      5.496  3.2   0.783   0.013         -0.008
0.7  0.7   2.381     0.344      4.342  2.4   0.600   0.015          0.022
0.8  0.8   1.589    -0.351      3.488  1.6   0.380   0.015         -0.010
0.9  0.9   0.804    -0.839      2.570  0.8   0.156   0.011          0.006
1    1.0   0.030    -1.342      1.477  0.0   0.045   0.007          0.004
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (kontrola / aplikacja)" = c("#0072B2", "#D55E00"),
             "szary – niebieski (bez kowariantu / ANCOVA, rys. 3A)" = c("#999999", "#0072B2"),
             "ciemnoszary – niebieski (linie na rys. 3B)" = c("#737373", "#0072B2"),
             "cynober – białe tło (pasmo i punkty, rys. 4B i 5B)" = c("#D55E00", "#FFFFFF"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                     widzenie_typowe
niebieski – cynober (kontrola / aplikacja)                     114.6
szary – niebieski (bez kowariantu / ANCOVA, rys. 3A)            44.9
ciemnoszary – niebieski (linie na rys. 3B)                      41.5
cynober – białe tło (pasmo i punkty, rys. 4B i 5B)              89.3
czerwony – zielony (do unikania)                               121.7
                                                     deuteranopia protanopia
niebieski – cynober (kontrola / aplikacja)                  108.3       91.9
szary – niebieski (bez kowariantu / ANCOVA, rys. 3A)         48.9       40.6
ciemnoszary – niebieski (linie na rys. 3B)                   45.1       38.2
cynober – białe tło (pasmo i punkty, rys. 4B i 5B)           75.4       75.1
czerwony – zielony (do unikania)                             21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele liniowe, porównanie modeli, przedziały ufności i losowania – pakiet stats. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Kowariant dobrany po teście różnic wyjściowych. Przy losowym przydziale liczy się korelacja kowariantu z wynikiem, a nie p różnicy na starcie (rysunki 1 i 3).
- Raportowanie średnich surowych jako wyniku ANCOVA. Podaj średnie skorygowane i przy jakiej wartości kowariantu je liczono (rysunek 1).
- Kowariant zmierzony po interwencji. Może sam zależeć od grupy – korekta usuwa wtedy część efektu.
- „Interakcja nieistotna, więc nachylenia są równe”. Przy 30 osobach na grupę test wykrył realną różnicę nachyleń w mniej niż połowie badań (rysunek 4).
- ANCOVA jako „wyrównanie” grup istniejących. Przy kowariancie mierzonym z błędem zostaje część różnicy wyjściowej i pojawia się pozorny efekt (rysunek 5).
Najczęstsze pytania
Jak narysować wynik ANCOVA na wykresie?
Narysuj wykres rozrzutu wyniku po względem wyniku przed, z punktami w kolorach i kształtach grup i z równoległymi prostymi z modelu. Zaznacz średnie surowe i średnie skorygowane, czyli wartości prostych przy średnim wyniku przed. W naszym przykładzie średnie skorygowane wyniosły 31.82 i 37.45 punktu przy średnim wyniku przed 30.17. Taki obraz pokazuje, co model zrobił z danymi, czego nie widać na dwóch słupkach.
Dlaczego ANCOVA daje węższy przedział ufności niż ANOVA na wynikach po?
Bo kowariant wyjaśnia część różnic między osobami i zmniejsza wariancję błędu mniej więcej do (1 − ρ²) wartości wyjściowej, gdzie ρ to korelacja kowariantu z wynikiem. W 1000 symulowanych badaniach po 30 osób na grupę średnia szerokość 95% CI spadła z 8.25 do 5.94 punktu przy ρ = .7 i do 3.64 przy ρ = .9. Przy ρ = 0 kowariant nic nie daje, a kosztuje stopień swobody.
Czy ANCOVA wyrównuje różnice między grupami na starcie?
Przy losowym przydziale koryguje przypadkową nierównowagę i zwiększa precyzję. Przy grupach istniejących, które naprawdę różnią się poziomem wyjściowym, nie da się ich w ten sposób wyrównać, zwłaszcza gdy kowariant jest mierzony z błędem. W naszej symulacji quasi-eksperymentu bez efektu interwencji ANCOVA przy rzetelności kowariantu .7 dawała „istotny efekt” w 60% badań.
Co zrobić, gdy w ANCOVA nachylenia w grupach się różnią?
Nie podawaj jednego efektu ze wspólnym nachyleniem, tylko model z interakcją kowariant × grupa i efekty warunkowe, np. przy średniej i ± 1 SD kowariantu, najlepiej z wykresem efektu i przedziałem Johnsona–Neymana. W przykładzie przewaga grupy z aplikacją wynosiła 7.01 punktu u słabszych na starcie i 0.88 punktu u lepszych, a ANCOVA podawała jedną liczbę 3.94.
Ile osób oszczędza kowariant w analizie mocy?
Według przybliżenia Borma i in. (2007) ANCOVA na grupach liczących (1 − ρ²)n osób ma taką moc jak porównanie wyników końcowych na grupach po n osób. Przy korelacji .5 to 75% liczebności, a przy .7 – 51%. Korelację przyjmij ostrożnie, z pilotażu albo wcześniejszych badań, bo zawyżona daje za małą próbę.
Powiązane hasła
Przeczytaj też
ANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikParadoks Lorda: ANCOVA czy wynik różnicowy?
Kiedy obie analizy badania przed–po się zgadzają, kiedy myli się każda z nich, regresja do średniej, graf przyczynowy i symulacja w R.
Czytaj →PoradnikModeracja – wizualizacja na obrazkach
Proste nachylenia, obszar Johnsona–Neymana, mapa przewidywań, moderator dwuwartościowy, centrowanie i moc interakcji w 1000 badań – sześć rysunków z kodem R.
Czytaj →PoradnikRegresja do średniej – wizualizacja na obrazkach
Wynik prawdziwy i błąd, strzałki przed–po, chmura pomiarów w przód i wstecz, korelacja test–retest i 1000 badań kursu bez efektu – pięć rysunków z kodem R.
Czytaj →Masz badanie przed i po z grupą kontrolną?
Pomożemy wybrać kowariant, sprawdzić założenia ANCOVA, policzyć średnie skorygowane i opisać wynik w pracy – tak, żebyś umiał(a) wyjaśnić promotorowi i recenzentowi, dlaczego wybrano taką analizę.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Borm, G. F., Fransen, J., & Lemmens, W. A. J. G. (2007). A simple sample size formula for analysis of covariance in randomized clinical trials. Journal of Clinical Epidemiology, 60(12), 1234–1238. https://doi.org/10.1016/j.jclinepi.2007.02.006
- Culpepper, S. A., & Aguinis, H. (2011). Using analysis of covariance (ANCOVA) with fallible covariates. Psychological Methods, 16(2), 166–178. https://doi.org/10.1037/a0023355
- Egbewale, B. E., Lewis, M., & Sim, J. (2014). Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study. BMC Medical Research Methodology, 14(1), Article 49. https://doi.org/10.1186/1471-2288-14-49 ● Otwarty dostęp
- Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{borm2007simple, author={Borm, George F. and Fransen, Jaap and Lemmens, Wim A. J. G.}, title={{A simple sample size formula for analysis of covariance in randomized clinical trials}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={12}, pages={1234--1238}, doi={10.1016/j.jclinepi.2007.02.006}}@article{culpepper2011using, author={Culpepper, Steven Andrew and Aguinis, Herman}, title={{Using analysis of covariance (ANCOVA) with fallible covariates}}, journal={Psychological Methods}, year={2011}, volume={16}, number={2}, pages={166--178}, doi={10.1037/a0023355}}@article{egbewale2014bias, author={Egbewale, Bolaji E. and Lewis, Martyn and Sim, Julius}, title={{Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={49}, doi={10.1186/1471-2288-14-49}}@article{lord1967paradox, author={Lord, Frederic M.}, title={{A paradox in the interpretation of group comparisons}}, journal={Psychological Bulletin}, year={1967}, volume={68}, number={5}, pages={304--305}, doi={10.1037/h0025105}}@article{miller2001misunderstanding, author={Miller, Gregory A. and Chapman, Jean P.}, title={{Misunderstanding analysis of covariance}}, journal={Journal of Abnormal Psychology}, year={2001}, volume={110}, number={1}, pages={40--48}, doi={10.1037/0021-843x.110.1.40}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}