Kiedy ANCOVA i gdzie jest w jamovi
Analiza kowariancji (ANCOVA) porównuje średnie grup po uwzględnieniu zmiennej ilościowej związanej z wynikiem, czyli kowarianty. W pracach dyplomowych to zwykle badanie przed i po z grupą kontrolną: wynik po zajęciach jest zmienną zależną, grupa czynnikiem, a pomiar wyjściowy kowariantą. Dlaczego w takim schemacie ANCOVA zwykle wygrywa z analizą różnic, wyjaśnia wpis ANCOVA w badaniu przed i po. Tutaj zajmujemy się tylko jamovi: oknem, opcjami i tym, co przepisać z tabel.
W jamovi to osobne okno Analyses → ANOVA → ANCOVA (The jamovi project, b.d.-b). Dokumentacja pakietu jmv opisuje je jako tę samą analizę co ANOVA, tylko z dodanymi kowariantami (The jamovi project, b.d.-c). Większość opcji znasz z wpisu ANOVA w jamovi, a pierwsze kroki w programie – z wpisu jamovi krok po kroku. Nazwy opcji podajemy po angielsku według dokumentacji jamovi i definicji analiz jmv, a polskie – według pliku tłumaczeń jmv (The jamovi project, b.d.-c). W Twojej wersji etykiety mogą się nieco różnić. Ten sam przykład krok po kroku w SPSS opisuje wpis ANCOVA w SPSS.
Przykład i pliki do pobrania
Liczby pochodzą z jednego zbioru symulowanego (dane fikcyjne). 108 osób studiujących wylosowano do trzech grup po 36: warsztat oswajania ze statystyką, kurs e-learningowy albo grupa kontrolna bez zajęć. Przed zajęciami i po nich wszyscy wypełnili skalę lęku przed statystyką (10–50 pkt, więcej = silniejszy lęk). Czy po zajęciach grupy różnią się lękiem przy tym samym poziomie wyjściowym?
Pobierz plik CSV albo plik .sav z etykietami wartości i powtarzaj kroki w jamovi. Kolumny: id, grupa, pre (lęk przed) i post (lęk po).
Przygotowanie danych w jamovi
Jeden wiersz to jedna osoba, a pomiar przed i po to dwie osobne kolumny. Typ pomiaru (Measure type) zmienisz w edytorze zmiennej po dwukliku na nagłówku kolumny (The jamovi project, b.d.-a). Przed analizą sprawdź trzy rzeczy:
grupama typ Nominal, apreipost– Continuous. Pole Covariates przyjmuje zmienne liczbowe, a zalecany typ to Continuous (The jamovi project, b.d.-c);- kolejność poziomów: warsztat, e-learning, kontrolna. Poziom na górze listy pojawi się pierwszy w tabelach i na wykresach (The jamovi project, b.d.-a);
- kody braków, np. 99, wpisane w Missing values. Etykiety i braki opisuje wpis przygotowanie danych w jamovi.
Kowarianta musi być zmierzona przed przydziałem do grupy albo przed zajęciami. Zmienna zmierzona później może sama zależeć od grupy i wtedy korekta zniekształca efekt. ANCOVA nie „wyrówna” też grup, które naprawdę różnią się kowariantą, np. istniejących klas (Miller i Chapman, 2001). W takim schemacie przeczytaj najpierw o paradoksie Lorda.
Średnie i SD lęku przed i po w grupach da Analyses → Exploration → Descriptives z grupą w polu Split by (The jamovi project, b.d.-a). Przed zajęciami grupy były podobne: 32.64 (SD = 7.76) w warsztacie, 32.28 (SD = 7.15) w e-learningu i 31.58 (SD = 6.77) w kontrolnej. Po zajęciach średnie wyniosły odpowiednio 27.53 (SD = 7.16), 28.86 (SD = 6.28) i 30.81 (SD = 6.43).
Okno ANCOVA krok po kroku
- Analyses → ANOVA → ANCOVA.
postprzeciągnij do Dependent Variable (po polsku: Zmienna zależna),grupado Fixed Factors (Czynniki stałe), apredo Covariates (Współzmienne) (The jamovi project, b.d.-b). - Effect Size: zaznacz partial η² i ω² (The jamovi project, b.d.-c).
- Model: na razie zostaw domyślne Model Terms. jamovi dodaje kowariantę tylko jako efekt główny, bez interakcji z czynnikiem. Sum of squares zostaw na domyślnym Type 3 (The jamovi project, b.d.-c).
- Assumption Checks: Homogeneity test i Normality test; dla oka także Q-Q Plot.
- Post Hoc Tests:
grupana prawą listę. Domyślna korekta to Tukey. W Effect Size zaznacz Cohen's d z Confidence interval. - Estimated Marginal Means (Oszacowane średnie brzegowe):
grupado Term 1, zaznacz Marginal means tables. Wykres (Marginal means plots) jest włączony domyślnie (The jamovi project, b.d.-b, b.d.-c).
Tabele pokazujemy w układzie jamovi. Liczby policzyliśmy funkcją jmv::ancova, czyli tym samym kodem, który uruchamia program (Selker i in., 2025). Pogrubione są liczby, które trafią do pracy.
Krok 1: jednorodność nachyleń
ANCOVA zakłada, że związek lęku przed z lękiem po jest w każdej grupie taki sam. Linie regresji mają być równoległe. Sprawdzisz to modelem z interakcją grupa × kowarianta. W sekcji Model zaznacz w liście składników jednocześnie grupa i pre, kliknij strzałkę z menu rozwijanym i wybierz Interaction. Nowy składnik trafi do Model Terms (The jamovi project, b.d.-b).
| Sum of Squares | df | Mean Square | F | p | |
|---|---|---|---|---|---|
| grupa | 49.883 | 2 | 24.941 | 1.294 | .279 |
| pre | 2571.779 | 1 | 2571.779 | 133.453 | < .001 |
| grupa:pre | 49.117 | 2 | 24.559 | 1.274 | .284 |
| Residuals | 1965.651 | 102 | 19.271 |
Patrzysz tylko na wiersz interakcji: F(2, 102) = 1.27, p = .284. Nachylenia w grupach wynoszą 0.74 (warsztat), 0.55 (e-learning) i 0.77 (kontrolna) i nie różnią się istotnie. Wiersza grupa w tym modelu nie interpretuj – przy interakcji zależy on od wartości kowarianty, dla której porównuje się grupy.
Nieistotna interakcja nie dowodzi równoległości, bo test ma zwykle małą moc. Gdy interakcja jest wyraźna, zostaw ją w modelu, wycentruj kowariantę i opisz efekt dla kilku wartości wyjściowych. Tu interakcję usuwamy z Model Terms i wracamy do modelu domyślnego.
Krok 2: tabela ANCOVA
| Sum of Squares | df | Mean Square | F | p | η²p | ω² | |
|---|---|---|---|---|---|---|---|
| grupa | 291.713 | 2 | 145.857 | 7.529 | < .001 | .126 | .051 |
| pre | 2604.149 | 1 | 2604.149 | 134.423 | < .001 | .564 | .524 |
| Residuals | 2014.768 | 104 | 19.373 |
W odróżnieniu od SPSS tabela nie ma wierszy Corrected Model, Intercept, Total i Corrected Total (The jamovi project, b.d.-b). Wiersz grupa to efekt zajęć przy wyrównanym lęku wyjściowym: F(2, 104) = 7.53, p < .001, η²p = .13. Wiersz pre pokazuje silny związek lęku przed z lękiem po – podaj go, choć to nie hipoteza. Typ 3 oznacza, że każdy efekt jest skorygowany o pozostałe, więc kolejność składników nie zmienia wyniku.
Dlaczego ω² (.051) jest tak dużo mniejsza od η²p (.126)? To dwie różne miary. η² cząstkowe dzieli sumę kwadratów grupy przez nią samą plus sumę reszt. Pomija więc wariancję wyjaśnioną przez kowariantę. ω² w jmv 2.7.7 ma w mianowniku sumę kwadratów wszystkich wierszy tabeli, razem z wierszem pre, i odejmuje oczekiwany wkład błędu (The jamovi project, b.d.-c). Przeliczyliśmy to ręcznie: (291.71 − 2 × 19.37) / (4910.63 + 19.37) = .051 (przepis 2). W ANCOVA z silną kowariantą η²p wychodzi więc wyraźnie wyżej. W pracy nazwij miarę dokładnie i nie porównuj η²p z jednego badania z ω² z innego.
Założenia: test Levene’a jmv liczy jako ANOVA bezwzględnych reszt modelu ANCOVA względem grup (The jamovi project, b.d.-c). Był nieistotny, F(2, 105) = 0.39, p = .678. Test Shapiro–Wilka dla reszt też: W = .99, p = .352.
Średnie brzegowe i porównania post hoc
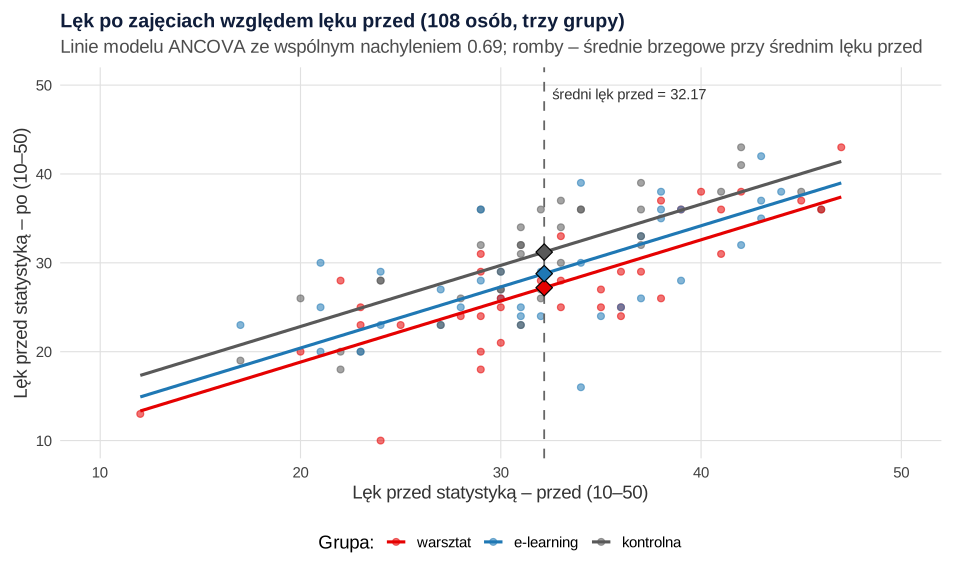
Średnie brzegowe to średnie przewidywane przez model, a nie obserwowane. W ANCOVA jamovi liczy je przy kowariancie ustawionej na jej średniej. Sprawdziliśmy to w kodzie jmv i ręcznie: przewidywania modelu przy średnim lęku przed (32.17) dają dokładnie te same liczby (przepis 2).
| grupa | Mean | SE | Lower | Upper |
|---|---|---|---|---|
| warsztat | 27.203 | 0.734 | 25.747 | 28.659 |
| e-learning | 28.785 | 0.734 | 27.330 | 30.239 |
| kontrolna | 31.207 | 0.734 | 29.751 | 32.663 |
Surowa różnica między warsztatem a grupą kontrolną wynosiła 3.28 pkt. Skorygowana to 4.00 pkt, bo osoby z warsztatu zaczynały z nieco wyższym lękiem. Rysunek 1 pokazuje, skąd biorą się te liczby: trzy równoległe linie modelu i średnie brzegowe na wysokości średniego lęku przed.
Porównania par zamówione w Post Hoc Tests są w tym oknie oparte na średnich brzegowych. Mówi o tym notka pod tabelą, a w kodzie jmv porównania liczy pakiet emmeans na całym modelu (The jamovi project, b.d.-c). Uwzględniają więc kowariantę. W SPSS jest inaczej: przycisk Post Hoc porównuje średnie nieskorygowane, o czym piszemy we wpisie o SPSS.
| grupa | grupa | Mean Difference | SE | df | t | ptukey | pholm | Cohen's d | Lower | Upper |
|---|---|---|---|---|---|---|---|---|---|---|
| warsztat | e-learning | −1.582 | 1.038 | 104 | −1.524 | .284 | .130 | −0.359 | −0.829 | 0.111 |
| warsztat | kontrolna | −4.004 | 1.039 | 104 | −3.852 | < .001 | < .001 | −0.910 | −1.394 | −0.425 |
| e-learning | kontrolna | −2.422 | 1.038 | 104 | −2.333 | .056 | .043 | −0.550 | −1.024 | −0.076 |
Warsztat obniżył lęk względem grupy kontrolnej o 4.00 pkt, t(104) = −3.85, pTukey < .001. Różnica e-learningu i grupy kontrolnej to 2.42 pkt. Z domyślną korektą Tukeya daje p = .056, a z poprawką Holma p = .043. Który wynik podać? Ten, którego korektę wybrałeś przed analizą. W naszym planie była to korekta Tukeya, więc różnicy e-learningu nie nazywamy istotną. Zamiana korekty po obejrzeniu tabeli to dopasowywanie wyniku.
Uwaga na d Cohena. W tym oknie jmv dzieli różnicę średnich brzegowych przez pierwiastek z MS reszt ANCOVA: 4.00 / √19.37 = 0.91 (The jamovi project, b.d.-c). Ta sama różnica podzielona przez połączone SD wyniku po w grupach (6.63) daje d = 0.60. Gdy porównujesz efekt z innymi badaniami, napisz, które SD jest w mianowniku.
Co dała kowarianta
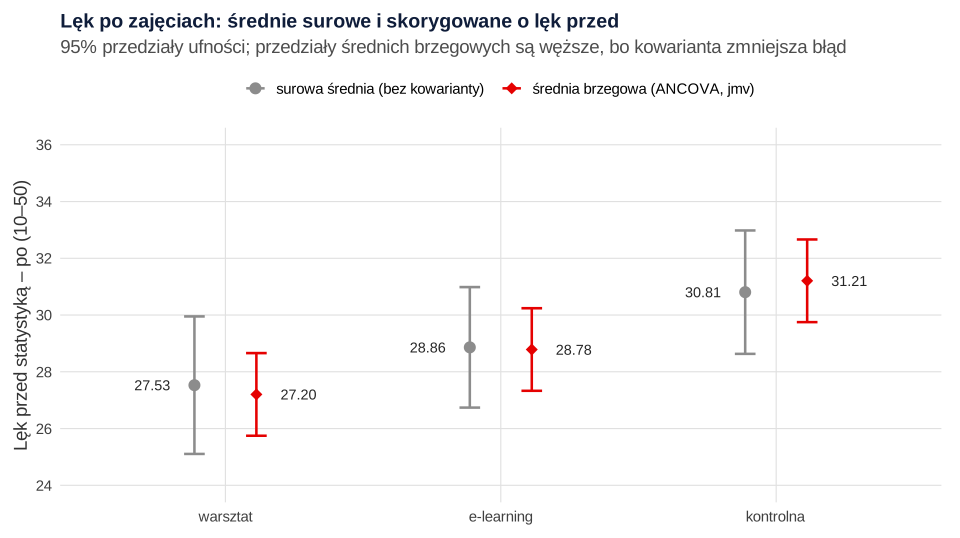
Ta sama analiza bez pre w Covariates daje F(2, 105) = 2.22, p = .113, η²p = .04. Lęk wyjściowy wyjaśnił dużą część różnic między osobami: suma kwadratów reszt spadła z 4618.92 do 2014.77. Przedziały ufności średnich zwęziły się o 31–40% (rysunek 2). W badaniach randomizowanych ANCOVA i analiza różnic są nieobciążone, ale ANCOVA ma większą moc (Van Breukelen, 2006). Clifton i Clifton (2019) pokazują, że wynik różnicowy nie usuwa regresji do średniej ani nierównowagi na starcie, i zalecają uwzględnianie pomiaru wyjściowego w ANCOVA. Analizę główną zapisz jednak w planie przed zebraniem danych. Wybór wersji, „która wyszła istotna”, to błąd.
Zapis wyników w stylu APA
Podaj sprawdzenie nachyleń, wynik ANCOVA z nazwaną miarą efektu, średnie brzegowe z przedziałami i porównania z korektą. W metodzie wpisz wersję jamovi, typ sum kwadratów i korektę. Wzór do dostosowania:
Obok średnich skorygowanych pokaż w tabeli średnie surowe przed i po (zob. tabela ANOVA w APA). Jak opisać sam schemat przed–po i czego nie wnioskować, wyjaśnia wpis badanie przed i po – jak opisać. Zdania do innych analiz przygotuje generator opisu wyników APA.
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc przepis 1 daje te same tabele co okno ANCOVA (Selker i in., 2025). Argumenty funkcji ancova odpowiadają opcjom okna, np. effectSize, homo, postHocCorr, emMeans (The jamovi project, b.d.-c). Interakcję do sprawdzenia nachyleń dopisujesz w formule jako grupa:pre. Samego jamovi tu nie uruchamialiśmy – liczby we wpisie pochodzą z tego kodu. Przepis 2 sprawdza ręcznie średnie brzegowe, ω² i d, a przepis 3 tworzy pliki do pobrania. Tabele wyników są szerokie: przewiń je w poziomie.
1. Okno ANCOVA funkcją jmv::ancova
R
# To samo w R: okno Analyses → ANOVA → ANCOVA wykonane pakietem jmv (silnik analiz jamovi)
library(jmv)
dane <- read.csv("ancova-w-jamovi-dane.csv")
dane$grupa <- factor(dane$grupa, levels = c("warsztat", "e-learning", "kontrolna"))

# 1. Exploration → Descriptives: lęk przed i po w trzech grupach (Split by: grupa)
descriptives(data = dane, vars = c("pre", "post"), splitBy = "grupa", desc = "rows",
             missing = FALSE, median = FALSE, min = FALSE, max = FALSE)

# 2. Krok 1 – jednorodność nachyleń: w Model Terms dodana interakcja grupa × pre
ancova(formula = post ~ grupa + pre + grupa:pre, data = dane, emmPlots = FALSE)

# 3. Krok 2 – właściwa ANCOVA (domyślny model: grupa + pre), η²p i ω², założenia,
#    post hoc z korektą Holma i d Cohena, średnie brzegowe przy średniej kowarianty
ancova(formula = post ~ grupa + pre, data = dane, effectSize = c("partEta", "omega"),
       homo = TRUE, norm = TRUE,
       postHoc = ~ grupa, postHocCorr = c("tukey", "holm"), postHocES = "d", postHocEsCi = TRUE,
       emMeans = ~ grupa, emmTables = TRUE, emmPlots = FALSE)

# 4. Dla porównania: ta sama analiza bez kowarianty (tylko wynik po)
ancova(formula = post ~ grupa, data = dane, effectSize = "partEta", emmPlots = FALSE)
Wynik:
 DESCRIPTIVES

 Descriptives
 ────────────────────────────────────────────────────
           grupa         N     Mean        SD
 ────────────────────────────────────────────────────
   pre     warsztat      36    32.63889    7.761269
           e-learning    36    32.27778    7.149870
           kontrolna     36    31.58333    6.771263
   post    warsztat      36    27.52778    7.161349
           e-learning    36    28.86111    6.275361
           kontrolna     36    30.80556    6.426816
 ────────────────────────────────────────────────────


 ANCOVA

 ANCOVA - post
 ─────────────────────────────────────────────────────────────────────────────────
                Sum of Squares    df     Mean Square    F             p
 ─────────────────────────────────────────────────────────────────────────────────
   grupa              49.88287      2       24.94144      1.294241     0.2785684
   pre              2571.77895      1     2571.77895    133.452720    < .0000001
   grupa:pre          49.11731      2       24.55866      1.274378     0.2840182
   Residuals        1965.65085    102       19.27109
 ─────────────────────────────────────────────────────────────────────────────────


 ANCOVA

 ANCOVA - post
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────
                Sum of Squares    df     Mean Square    F             p             η²p          ω²
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────
   grupa              291.7131      2      145.85653      7.528945     0.0008837    0.1264754    0.0513118
   pre               2604.1485      1     2604.14850    134.423131    < .0000001    0.5638007    0.5242950
   Residuals         2014.7682    104       19.37277
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────


 ASSUMPTION CHECKS

 Homogeneity of Variances Test (Levene's)
 ────────────────────────────────────────
   F            df1    df2    p
 ────────────────────────────────────────
   0.3897727      2    105    0.6781865
 ────────────────────────────────────────


 Normality Test (Shapiro-Wilk)
 ─────────────────────────────
   Statistic    p
 ─────────────────────────────
   0.9865299    0.3518737
 ─────────────────────────────


 POST HOC TESTS

 Post Hoc Comparisons - grupa
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   grupa              grupa         Mean Difference    SE          df          t            p-tukey      p-holm       Cohen's d     Lower         Upper
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   warsztat      -    e-learning          -1.581762    1.037653    104.0000    -1.524365    0.2837497    0.1304527    -0.3593730    -0.8294832     0.11073730
                 -    kontrolna           -4.003955    1.039321    104.0000    -3.852472    0.0005893    0.0006075    -0.9096898    -1.3943654    -0.42501423
   e-learning    -    kontrolna           -2.422193    1.038250    104.0000    -2.332957    0.0556874    0.0431505    -0.5503169    -1.0241724    -0.07646133
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Comparisons are based on estimated marginal means


 ESTIMATED MARGINAL MEANS

 GRUPA

 Estimated Marginal Means - grupa
 ───────────────────────────────────────────────────────────────
   grupa         Mean        SE           Lower       Upper
 ───────────────────────────────────────────────────────────────
   warsztat      27.20291    0.7341101    25.74714    28.65868
   e-learning    28.78467    0.7336048    27.32991    30.23944
   kontrolna     31.20686    0.7343913    29.75054    32.66319
 ───────────────────────────────────────────────────────────────


 ANCOVA

 ANCOVA - post
 ───────────────────────────────────────────────────────────────────────────────────────────
                Sum of Squares    df     Mean Square    F           p            η²p
 ───────────────────────────────────────────────────────────────────────────────────────────
   grupa              195.6296      2       97.81481    2.223585    0.1132922    0.0406330
   Residuals         4618.9167    105       43.98968
 ───────────────────────────────────────────────────────────────────────────────────────────
2. Kontrola ręczna: nachylenia, średnie brzegowe, ω² i d
R
# Kontrola ręczna liczb z tabel jamovi (bazowy R, te same dane)
dane <- read.csv("ancova-w-jamovi-dane.csv")
dane$grupa <- factor(dane$grupa, levels = c("warsztat", "e-learning", "kontrolna"))

# 1. Nachylenia pre → post osobno w grupach (to porównuje interakcja grupa:pre)
round(sapply(split(dane, dane$grupa), function(z) coef(lm(post ~ pre, data = z))[["pre"]]), 3)

# 2. Średnie brzegowe = przewidywania modelu ANCOVA przy średnim lęku przed
m <- lm(post ~ grupa + pre, data = dane)
sr_pre <- mean(dane$pre)
cat("średnia pre:", round(sr_pre, 3), "  wspólne nachylenie:", round(coef(m)[["pre"]], 3), "\n")
setNames(round(predict(m, newdata = data.frame(grupa = levels(dane$grupa), pre = sr_pre)), 3), levels(dane$grupa))

# 3. ω² w tabeli ANCOVA: (SS efektu − df × MS reszt) / (suma SS w tabeli + MS reszt)
SS <- c(grupa = 291.7131, pre = 2604.1485, Residuals = 2014.7682); MSE <- SS[["Residuals"]] / 104
cat("omega2 grupa =", round((SS[["grupa"]] - 2 * MSE) / (sum(SS) + MSE), 4),
    "  eta2p grupa =", round(SS[["grupa"]] / (SS[["grupa"]] + SS[["Residuals"]]), 4), "\n")

# 4. d Cohena w post hoc: różnica średnich brzegowych / pierwiastek z MS reszt ANCOVA
cat("pierwiastek MS reszt =", round(sqrt(MSE), 3), "  d (warsztat − kontrolna) =",
    round(-4.003955 / sqrt(MSE), 3), "\n")
# dla porównania: ta sama różnica podzielona przez połączone SD wyniku po w grupach (bez kowarianty)
sd_pol <- sigma(lm(post ~ grupa, data = dane))
cat("połączone SD wyniku po =", round(sd_pol, 3), "  d na tym SD =", round(-4.003955 / sd_pol, 3), "\n")
Wynik:
  warsztat e-learning  kontrolna
     0.737      0.554      0.773
średnia pre: 32.167   wspólne nachylenie: 0.688
  warsztat e-learning  kontrolna
    27.203     28.785     31.207
omega2 grupa = 0.0513   eta2p grupa = 0.1265
pierwiastek MS reszt = 4.401   d (warsztat − kontrolna) = -0.91
połączone SD wyniku po = 6.632   d na tym SD = -0.604
3. Dane symulowane i pliki CSV oraz .sav
R
# Dane symulowane do wpisu „ANCOVA w jamovi”: lęk przed statystyką (10–50) przed i po
# 108 osób wylosowanych do trzech grup po 36: warsztat, e-learning, kontrolna
library(haven)
set.seed(5402)
n <- 36
grupa <- rep(c("warsztat", "e-learning", "kontrolna"), each = n)
pre <- round(pmin(50, pmax(10, rnorm(3 * n, 32, 7))))
efekt <- c(warsztat = -5, "e-learning" = -2.5, kontrolna = 0)[grupa]
post <- round(pmin(50, pmax(10, 9 + 0.7 * pre + efekt + rnorm(3 * n, 0, 4.5))))
dane <- data.frame(id = seq_len(3 * n), grupa, pre, post)
dane <- dane[sample(nrow(dane)), ]; dane$id <- seq_len(nrow(dane)); rownames(dane) <- NULL
write.csv(dane, "ancova-w-jamovi-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Ten sam zbiór w .sav: kody grup z etykietami wartości i etykiety zmiennych
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$grupa <- labelled(match(dane$grupa, c("warsztat", "e-learning", "kontrolna")),
                      labels = c("warsztat" = 1, "e-learning" = 2, "kontrolna" = 3), label = "Grupa")
sav$pre <- labelled(sav$pre, label = "Lęk przed statystyką – przed (10–50)")
sav$post <- labelled(sav$post, label = "Lęk przed statystyką – po (10–50)")
write_sav(sav, "ancova-w-jamovi-dane.sav")
cat("Zapisano", nrow(dane), "wierszy\n")
print(head(dane, 4), row.names = FALSE)
print(table(grupa = factor(dane$grupa, c("warsztat", "e-learning", "kontrolna"))))
Wynik:
Zapisano 108 wierszy
 id     grupa pre post
  1  warsztat  30   21
  2  warsztat  37   29
  3  warsztat  22   28
  4 kontrolna  32   26
grupa
  warsztat e-learning  kontrolna
        36         36         36
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv, który do sum kwadratów typu 3 korzysta z pakietu car, a do średnich brzegowych, porównań i d – z pakietu emmeans. Pliki .sav zapisano pakietem haven, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi albo R, której faktycznie użyłeś(-aś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Kowarianta w Fixed Factors. Lęk przed to zmienna ilościowa i trafia do Covariates. Jako czynnik dałaby osobną grupę dla każdej wartości.
- Brak sprawdzenia nachyleń albo interpretacja wiersza
grupaz modelu z interakcją. - Średnie surowe w opisie efektu. Wynik ANCOVA dotyczy średnich brzegowych z tabeli Estimated Marginal Means.
- Zmiana korekty post hoc po obejrzeniu wyników, np. z Tukeya na Holma, bo „wtedy wychodzi”.
- η²p opisane jako η² albo porównywane z ω². Przepisz miarę pod nazwą z tabeli.
- Kowarianta zmierzona po zajęciach albo ANCOVA, która ma „wyrównać” grupy nielosowe (Miller i Chapman, 2001).
Przy trzech i więcej pomiarach tych samych osób sięgnij po Repeated Measures ANOVA w jamovi, a gdy chcesz sprawdzić, czy zmienna pośredniczy w efekcie zajęć – po wpis mediacja w jamovi. Jeśli nie wiesz, czy ANCOVA pasuje do hipotezy, skorzystaj z kreatora doboru testu.
Najczęstsze pytania
Gdzie w jamovi jest ANCOVA?
W menu Analyses → ANOVA → ANCOVA (The jamovi project, b.d.-b). Okno ma te same sekcje co ANOVA i dodatkowe pole Covariates na zmienne ilościowe. W polskiej wersji interfejsu pole kowariant nazywa się według pliku tłumaczeń jmv „Współzmienne”.
Jak w jamovi sprawdzić jednorodność nachyleń regresji?
W sekcji Model zaznacz jednocześnie czynnik i kowariantę, kliknij strzałkę z menu rozwijanym i wybierz Interaction (The jamovi project, b.d.-b). W tabeli ANCOVA odczytaj tylko wiersz interakcji, w przykładzie F(2, 102) = 1.27, p = .284. Potem usuń interakcję i policz właściwą ANCOVA.
Czy post hoc w ANCOVA w jamovi uwzględnia kowariantę?
Tak. Porównania z sekcji Post Hoc Tests są oparte na średnich brzegowych, czyli na średnich skorygowanych przy średniej wartości kowarianty. Mówi o tym notka pod tabelą, a kod jmv liczy je pakietem emmeans na całym modelu (The jamovi project, b.d.-c). Różnice w tabeli są więc równe różnicom średnich z Estimated Marginal Means.
Dlaczego ω² w ANCOVA jest dużo mniejsza niż η² cząstkowe?
W jmv 2.7.7 ω² ma w mianowniku sumę kwadratów wszystkich wierszy tabeli, także kowarianty, a η² cząstkowe tylko efekt i reszty (The jamovi project, b.d.-c). Przy silnej kowariancie różnica jest duża, w przykładzie .051 wobec .126. Podaj jedną miarę i nazwij ją dokładnie.
Czy zamiast ANCOVA mogę policzyć ANOVA na różnicach po − przed?
Możesz, ale w badaniu z losowym przydziałem ANCOVA ma większą moc, a obie metody są nieobciążone (Van Breukelen, 2006). Wynik różnicowy nie usuwa też regresji do średniej ani nierównowagi na starcie (Clifton i Clifton, 2019). Metodę wybierz przed analizą. Szczegóły opisuje wpis ANCOVA w badaniu przed i po.
Powiązane hasła
Przeczytaj też
ANCOVA w SPSS krok po kroku
GLM Univariate z kowariantą od pliku .sav po opis APA: jednorodność nachyleń, η² cząstkowe, średnie skorygowane z EMMEANS i składnia do wklejenia – na przykładzie przed i po z grupą kontrolną.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikANOVA w jamovi krok po kroku
Trzy okna ANOVA w jamovi na jednym zbiorze: Welch i Games–Howell, interakcja 2 × 3 z η²p i ω², post hoc i średnie brzegowe, sferyczność i poprawka GG – z kodem jmv.
Czytaj →PoradnikANOVA – zadania z rozwiązaniami
Dziesięć zadań: tabela ANOVA, Tukey HSD, Levene i Welch, ANOVA 2 × 2 z interakcją, η² i ω², pomiary powtarzane, kontrast planowany i F = t².
Czytaj →Masz ANCOVA w jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy Twój plik .omv, wybór kowarianty, model, założenia, średnie skorygowane i porównania post hoc i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Clifton, L., & Clifton, D. A. (2019). The correlation between baseline score and post-intervention score, and its implications for statistical analysis. Trials, 20(1), Article 43. https://doi.org/10.1186/s13063-018-3108-3 ● Otwarty dostęp
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.-a). jamovi documentation: ANOVA: One-Way, ANOVA, ANOVA: Repeated Measures, ANOVA: Mixed, Descriptive analyses and Data Variables. jamovi docs. https://docs.jamovi.org/analyses/jg_overview.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). From SPSS to jamovi: Analysis of Covariance (ANCOVA). jamovi docs. https://docs.jamovi.org/spss2jamovi/s2j_ANCOVA3.html ● Otwarty dostęp
- The jamovi project. (b.d.-c). jmv R package: ANCOVA (ancova). jamovi docs. https://docs.jamovi.org/jmv/jmv_ancova.html ● Otwarty dostęp
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{clifton2019correlation, author={Clifton, Lei and Clifton, David A.}, title={{The correlation between baseline score and post-intervention score, and its implications for statistical analysis}}, journal={Trials}, year={2019}, volume={20}, number={1}, eid={43}, doi={10.1186/s13063-018-3108-3}}@article{miller2001misunderstanding, author={Miller, Gregory A. and Chapman, Jean P.}, title={{Misunderstanding analysis of covariance}}, journal={Journal of Abnormal Psychology}, year={2001}, volume={110}, number={1}, pages={40--48}, doi={10.1037/0021-843x.110.1.40}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovindanovaprzewodnik, author={{The jamovi project}}, title={{jamovi documentation: ANOVA: One-Way, ANOVA, ANOVA: Repeated Measures, ANOVA: Mixed, Descriptive analyses and Data Variables}}, howpublished={jamovi docs}, year={b.d.-a}, url={https://docs.jamovi.org/analyses/jg_overview.html}}@misc{jamovindancovas2j, author={{The jamovi project}}, title={{From SPSS to jamovi: Analysis of Covariance (ANCOVA)}}, howpublished={jamovi docs}, year={b.d.-b}, url={https://docs.jamovi.org/spss2jamovi/s2j_ANCOVA3.html}}@misc{jamovindjmvancova, author={{The jamovi project}}, title={{jmv R package: ANCOVA (ancova)}}, howpublished={jamovi docs}, year={b.d.-c}, url={https://docs.jamovi.org/jmv/jmv_ancova.html}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}