Trzy okna ANOVA w jamovi – które wybrać
Analiza wariancji porównuje średnie zmiennej ilościowej w kilku grupach albo w kilku pomiarach tych samych osób. Logikę testu F opisuje poradnik ANOVA krok po kroku, a pierwsze kroki w programie i prostą jednoczynnikową ANOVA – wpis jamovi krok po kroku. Tu idziemy dalej: dwa czynniki z interakcją i pomiary powtarzane. Sam program opisuje hasło jamovi.
Ścieżki i nazwy opcji sprawdziliśmy w oficjalnej dokumentacji jamovi i w definicjach analiz pakietu jmv (The jamovi project, b.d.-a, b.d.-b). Podajemy je po angielsku. W polskiej wersji językowej interfejsu mogą brzmieć inaczej.
| Okno | Kiedy | Czego nie ma |
|---|---|---|
| One-Way ANOVA | jeden czynnik; test Welcha, Games–Howell | wielkości efektu, drugiego czynnika |
| ANOVA | kilka czynników, interakcja, η²p i ω², średnie brzegowe | testu Welcha |
| Repeated Measures ANOVA | pomiary tych samych osób, ANOVA mieszana | obsługi braków (osoba z brakiem odpada) |
Przykład i pliki do pobrania
Liczby pochodzą z jednego zbioru symulowanego. 150 osób studiujących pisało ten sam test wiedzy (0–40 punktów) w tygodniu 1, 5 i 10 semestru: kolumny wiedza1–wiedza3. Każda osoba ma dwie cechy: sposób notowania (odręcznie albo na laptopie) i format zajęć (stacjonarne, hybrydowe, online). To schemat 2 × 3 z nierównymi komórkami po 22–27 osób. Pobierz plik CSV albo plik .sav z etykietami wartości i powtarzaj kroki w jamovi.
Przygotowanie danych w jamovi
Każda zmienna ma typ pomiaru (Measure type: Continuous, Ordinal, Nominal, ID), który zmienisz w edytorze zmiennej po dwukliku na nagłówku kolumny (The jamovi project, b.d.-a). Przed ANOVA sprawdź:
- czynniki
notatkiiformatmają typ Nominal, a wynikiwiedza1–wiedza3– Continuous; - kolejność poziomów: stacjonarne, hybrydowe, online – poziom na górze listy pojawi się pierwszy w tabelach i na wykresach (The jamovi project, b.d.-a);
- kody braków, np. 99, wpisane w Missing values – inaczej jamovi policzy je jak wyniki.
Plik ma format szeroki: wiersz to osoba, a każdy pomiar to osobna kolumna. Tego wymaga Repeated Measures ANOVA (The jamovi project, b.d.-b). Etykiety, braki i wynik skali opisuje wpis przygotowanie danych i statystyki opisowe w jamovi.
One-Way ANOVA: jeden czynnik i test Welcha
Wybierz Analyses → ANOVA → One-Way ANOVA. wiedza3 przeciągnij do Dependent Variables, a format do Grouping Variable. W Variances domyślnie zaznaczone jest Don't assume equal (Welch's). Dodaj Descriptives table, Homogeneity test i w Post-Hoc Tests opcję Games-Howell (unequal variances) (The jamovi project, b.d.-b).
| F | df1 | df2 | p | ||
|---|---|---|---|---|---|
| wiedza3 | Welch's | 20.344 | 2 | 96.141 | < .001 |
| Fisher's | 21.719 | 2 | 147 | < .001 |
Wynik zależy od formatu, F Welcha(2, 96.14) = 20.34, p < .001. Grupa online (M = 17.02, SD = 6.68) miała według testu Gamesa–Howella niższy wynik niż stacjonarna (M = 23.96, SD = 5.64) i hybrydowa (M = 24.30, SD = 6.52), oba p < .001. Test Levene’a, liczony tu od średnich grup, był nieistotny, F(2, 147) = 1.22, p = .298. Welcha raportuj jednak bez względu na ten wynik – Delacre i in. (2019) zalecają go jako test domyślny. To okno nie podaje wielkości efektu. Ten sam przykład w SPSS: ANOVA w SPSS krok po kroku.
ANOVA z dwoma czynnikami: interakcja, efekty i post hoc
Co zaznaczyć w oknie ANOVA
- Analyses → ANOVA → ANOVA:
wiedza3do Dependent Variable,notatkiiformatdo Fixed Factors (The jamovi project, b.d.-a). - Effect Size: partial η² i ω². Model: w Model Terms oba czynniki i interakcja, Sum of squares – domyślne Type 3 (The jamovi project, b.d.-b).
- Assumption Checks: Homogeneity test, Normality test, Q-Q Plot.
- Post Hoc Tests: interakcja na prawą listę, w Correction zamiast domyślnego Tukey – Holm, w Effect Size – Cohen's d.
- Estimated Marginal Means: oba czynniki do Term 1, zaznacz Marginal means plots, Marginal means tables i Observed scores.
n, M i SD w komórkach da Analyses → Exploration → Descriptives z oboma czynnikami w Split by (The jamovi project, b.d.-a).
Tabela ANOVA
| Sum of Squares | df | Mean Square | F | p | η²p | ω² | |
|---|---|---|---|---|---|---|---|
| notatki | 21.701 | 1 | 21.701 | 0.579 | .448 | .004 | −.002 |
| format | 1730.997 | 2 | 865.499 | 23.101 | < .001 | .243 | .219 |
| notatki:format | 386.159 | 2 | 193.079 | 5.154 | .007 | .067 | .041 |
| Residuals | 5394.998 | 144 | 37.465 |
Czytaj od interakcji. Jest istotna, F(2, 144) = 5.15, p = .007, η²p = .07: różnica między notującymi odręcznie a na laptopie zależy od formatu zajęć. Efekt formatu jest duży, F(2, 144) = 23.10, p < .001, η²p = .24. Efekt notatek jest bliski zeru, F(1, 144) = 0.58, p = .448, ale przy istotnej interakcji to tylko uśrednienie przeciwnych różnic.
η² cząstkowe to udział efektu w wariancji bez pozostałych efektów, więc w jednym modelu η²p mogą sumować się powyżej 1. ω² jest mniej obciążona. Sprawdziliśmy ręcznie, że jamovi liczy ją względem całej wariancji: (1731.00 − 2 × 37.47) / (7533.86 + 37.47) = .22. Ujemne ω² dla notatek oznacza efekt praktycznie zerowy. Miary cząstkowe zależą od schematu badania (Olejnik i Algina, 2003), więc zawsze nazwij miarę, którą podajesz.
Typ 3 sum kwadratów to ustawienie domyślne. Przy nierównych komórkach typy dają różne wyniki dla efektów głównych, a Langsrud (2003) argumentuje za typem 2. Typ wybierz przed analizą i podaj w metodzie. Dla interakcji wszystkie typy dają ten sam wynik.
Założenia: test Levene’a, w tym oknie liczony na bezwzględnych resztach w komórkach (The jamovi project, b.d.-b), był nieistotny, F(5, 144) = 0.51, p = .770. Test Shapiro–Wilka dla reszt modelu też: W = .99, p = .190.
Wykres interakcji i porównania post hoc
Rysunek 1 pokazuje to, co da opcja Marginal means plots z Observed scores. W pełnym modelu średnie brzegowe komórek są równe ich średnim. W zajęciach stacjonarnych i hybrydowych linie prawie się pokrywają, a online rozchodzą się.
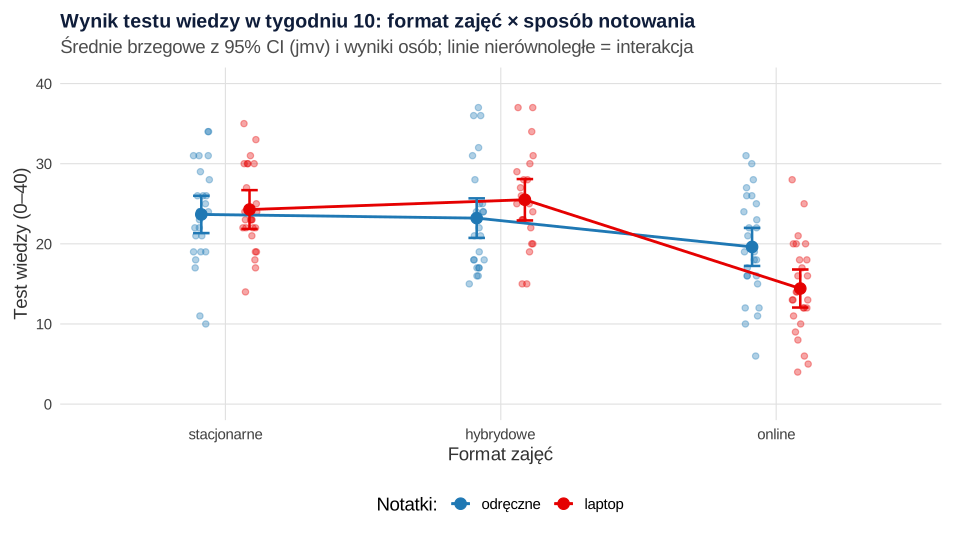
Okno ANOVA nie ma osobnej opcji efektów prostych (The jamovi project, b.d.-b). Najprościej zamówić post hoc dla interakcji: jamovi porówna każdą komórkę z każdą, czyli 15 par, i skoryguje p dla wszystkich. Odczytaj tylko pary z hipotezy: notatki odręczne a laptop w każdym formacie. Poprawka Holma jest mniej konserwatywna od Bonferroniego, a kontroluje błąd dla całej rodziny porównań.
| Porównanie | Mean Difference | SE | df | t | pholm | Cohen's d | Lower | Upper |
|---|---|---|---|---|---|---|---|---|
| odręczne stacjonarne − laptop stacjonarne | −0.613 | 1.699 | 144 | −0.361 | 1.000 | −0.100 | −0.649 | 0.449 |
| odręczne hybrydowe − laptop hybrydowe | −2.292 | 1.807 | 144 | −1.268 | 1.000 | −0.374 | −0.959 | 0.211 |
| odręczne online − laptop online | 5.192 | 1.698 | 144 | 3.059 | .027 | 0.848 | 0.291 | 1.405 |
Różnica dotyczy tylko zajęć online: notujący odręcznie mieli o 5.19 punktu więcej, t(144) = 3.06, pHolm = .027, d = 0.85, 95% CI [0.29, 1.41]. d to tu różnica podzielona przez pierwiastek z MS reszt: 5.19 / √37.47 = 0.85. W naszym uruchomieniu (jmv 2.7.7) znak d w kilku wierszach pełnej tabeli nie zgadzał się ze znakiem różnicy, więc kierunek odczytuj z Mean Difference. Jak opisać interakcję, wyjaśnia wpis interakcja w ANOVA – jak ją opisać, a te same kroki w SPSS – ANOVA dwuczynnikowa w SPSS.
Czy wykrycie interakcji to szczęśliwy traf? W 1000 powtórzeniach tego samego mechanizmu generowania danych była istotna w 80.9% prób (przepis 3). Interakcje wymagają dużych prób, więc liczebność planuj z myślą o nich.
Repeated Measures ANOVA: trzy pomiary tych samych osób
Definicja czynnika i opcje
- Analyses → ANOVA → Repeated Measures ANOVA (The jamovi project, b.d.-a).
- W Repeated Measures Factors zmień nazwę RM Factor 1 na
Tydzień. Domyślne poziomy Level 1 i Level 2 zastąp nazwami pomiarów i dodaj trzeci poziom, tak aby były 1, 5 i 10. Czynnika nie ma w pliku – tworzysz go tutaj. - Do Repeated Measures Cells przeciągnij
wiedza1–wiedza3, każdą do komórki właściwego poziomu. - Effect Size: Generalised η² i Partial η². Assumption Checks: Sphericity tests i w Sphericity corrections – None, Greenhouse-Geisser, Huynh-Feldt (The jamovi project, b.d.-b).
- Post Hoc Tests:
Tydzieńz korektą Holm; w Estimated Marginal Means –Tydzieńi tabela.
Czynnik przeciągnięty do Between Subject Factors zmieni analizę w ANOVA mieszaną (The jamovi project, b.d.-a) – zob. ANOVA mieszana krok po kroku. Według kodu jmv okno pomija osoby, którym brakuje choć jednego pomiaru (sprawdziliśmy to też na danych z brakami).
Sferyczność i poprawki
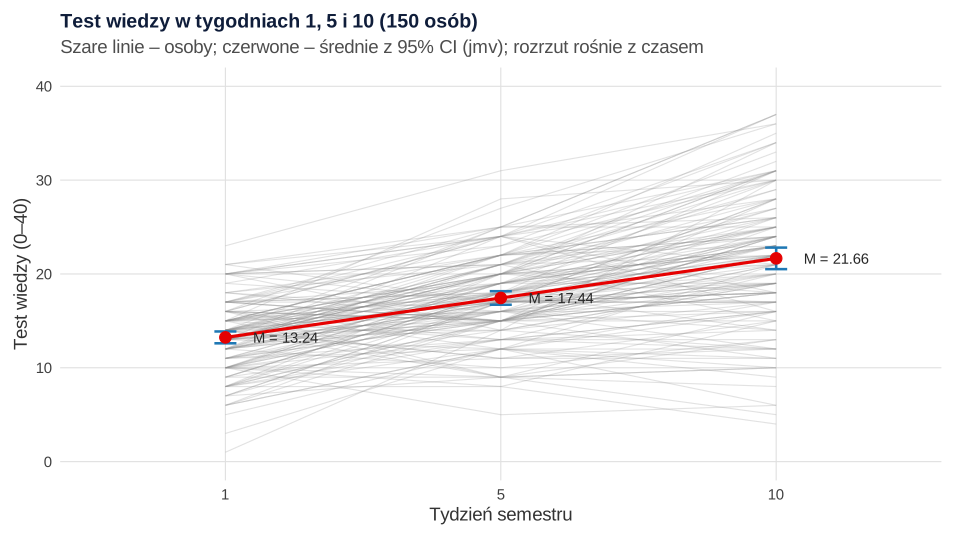
Sferyczność oznacza równe wariancje różnic między każdą parą pomiarów. Tu jej nie ma: SD różnic 5 − 1 i 10 − 5 wynoszą 4.34 i 4.59, a różnicy 10 − 1 – 6.70. Osoby uczą się w różnym tempie, więc rozrzut rośnie z czasem (rysunek 2).
| Mauchly's W | p | Greenhouse-Geisser ε | Huynh-Feldt ε | |
|---|---|---|---|---|
| Tydzień | 0.652 | < .001 | 0.742 | 0.747 |
Test Mauchly’ego jest istotny, W = .65, p < .001, ale ważniejsza jest wartość ε: 1 to pełna sferyczność, im niżej, tym większe naruszenie. Blanca i in. (2023) zalecają domyślnie poprawkę Greenhouse’a–Geissera, bez decydowania na podstawie testu Mauchly’ego. Gdy poprawki prowadzą do różnych wniosków, przy ε powyżej .60 radzą Huynha–Feldta. Tu wniosek jest ten sam.
| Sphericity Correction | Sum of Squares | df | Mean Square | F | p | η²G | η²p | |
|---|---|---|---|---|---|---|---|---|
| Tydzień | None | 5317.240 | 2 | 2658.620 | 188.005 | < .001 | .294 | .558 |
| Greenhouse-Geisser | 5317.240 | 1.484 | 3584.065 | 188.005 | < .001 | .294 | .558 | |
| Huynh-Feldt | 5317.240 | 1.495 | 3556.688 | 188.005 | < .001 | .294 | .558 | |
| Residual | None | 4214.093 | 298 | 14.141 | ||||
| Greenhouse-Geisser | 4214.093 | 221.053 | 19.064 | |||||
| Huynh-Feldt | 4214.093 | 222.755 | 18.918 |
Poprawka nie zmienia F, tylko mnoży oba df przez ε: 2 × .742 = 1.48 i 298 × .742 = 221.05. Do pracy przepisz wiersz Greenhouse-Geisser: F(1.48, 221.05) = 188.00, p < .001. η² uogólnione (η²G = .29) jest mniejsze od η²p (.56), bo zostawia w mianowniku zmienność między osobami. Olejnik i Algina (2003) zaproponowali je jako miarę porównywalną między schematami z pomiarami powtarzanymi i bez nich.
| Tydzień | Tydzień | Mean Difference | SE | df | t | pholm |
|---|---|---|---|---|---|---|
| 1 | 5 | −4.200 | 0.354 | 149 | −11.858 | < .001 |
| 1 | 10 | −8.420 | 0.547 | 149 | −15.387 | < .001 |
| 5 | 10 | −4.220 | 0.375 | 149 | −11.248 | < .001 |
Średnie rosły z 13.24 (SD = 3.92) przez 17.44 (SD = 4.47) do 21.66 punktu (SD = 7.11), każda para różni się istotnie. Porównania mają osobne błędy standardowe dla par, więc nie zakładają sferyczności. Tygodnie 1, 5 i 10 są tu kategoriami, a nie odstępami w czasie. Gdy liczy się tempo zmian albo są braki, rozważ model mieszany (ANOVA z powtarzanymi pomiarami czy model mieszany?). Ten schemat w SPSS: ANOVA z powtarzanymi pomiarami w SPSS.
Zapis wyników w stylu APA
W metodzie podaj wersję jamovi, typ sum kwadratów, korektę porównań i poprawkę sferyczności. Wzory do dostosowania:
Zdania do innych analiz przygotuje generator opisu wyników APA, a interpretację tabel przećwiczysz w zbiorze ANOVA – zadania z rozwiązaniami.
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc przepis 1 daje te same tabele co program (Selker i in., 2025). Każde wywołanie odpowiada jednemu oknu, a nazwy argumentów – opcjom z okna, np. effectSize, spherCorr, postHocCorr (The jamovi project, b.d.-b). Samego jamovi tu nie uruchamialiśmy – liczby we wpisie pochodzą z tego kodu. W jamovi taki kod pokaże tryb składni (Syntax mode), opisany we wpisie jamovi krok po kroku. Przepis 2 tworzy pliki do pobrania, a przepis 3 sprawdza, jak typowy jest przykład. Tabele wyników są szerokie: przewiń je w poziomie.
1. Trzy okna ANOVA funkcjami jmv
R
# B407 – to samo w R: analizy jamovi z menu ANOVA wykonane pakietem jmv (te same funkcje co w programie)
library(jmv)
dane <- read.csv("anova-w-jamovi-dane.csv")
dane$notatki <- factor(dane$notatki, levels = c("odręczne", "laptop"))
dane$format <- factor(dane$format, levels = c("stacjonarne", "hybrydowe", "online"))

# 1. ANOVA → One-Way ANOVA: wynik w tygodniu 10 a format zajęć (Welch i Fisher, Games–Howell)
anovaOneW(data = dane, deps = "wiedza3", group = "format", welchs = TRUE, fishers = TRUE,
          desc = TRUE, eqv = TRUE, phMethod = "gamesHowell")

# 2. Exploration → Descriptives: N, M i SD w sześciu komórkach (Split by: notatki, format)
descriptives(data = dane, vars = "wiedza3", splitBy = c("notatki", "format"), desc = "rows",
             missing = FALSE, median = FALSE, min = FALSE, max = FALSE)

# 3. ANOVA → ANOVA: schemat 2 × 3 z interakcją, η² cząstkowe i ω², założenia, post hoc i średnie brzegowe
ANOVA(formula = wiedza3 ~ notatki * format, data = dane, effectSize = c("partEta", "omega"),
      homo = TRUE, norm = TRUE, postHoc = ~ notatki:format, postHocCorr = "holm",
      postHocES = "d", postHocEsCi = TRUE,
      emMeans = ~ format:notatki, emmTables = TRUE, emmPlots = FALSE)

# 4. Przed Repeated Measures ANOVA: M i SD w trzech pomiarach oraz SD różnic między parami pomiarów
dane$r5_1 <- dane$wiedza2 - dane$wiedza1; dane$r10_1 <- dane$wiedza3 - dane$wiedza1
dane$r10_5 <- dane$wiedza3 - dane$wiedza2
descriptives(data = dane, vars = c("wiedza1", "wiedza2", "wiedza3", "r5_1", "r10_1", "r10_5"),
             missing = FALSE, median = FALSE, min = FALSE, max = FALSE)

# 5. ANOVA → Repeated Measures ANOVA: trzy pomiary wiedzy, sferyczność i poprawki
anovaRM(data = dane,
        rm = list(list(label = "Tydzień", levels = c("1", "5", "10"))),
        rmCells = list(list(measure = "wiedza1", cell = "1"), list(measure = "wiedza2", cell = "5"),
                       list(measure = "wiedza3", cell = "10")),
        depLabel = "Wiedza", effectSize = c("ges", "partEta"),
        spherTests = TRUE, spherCorr = c("none", "GG", "HF"),
        postHoc = list("Tydzień"), postHocCorr = "holm",
        emMeans = list("Tydzień"), emmTables = TRUE, emmPlots = FALSE)
Wynik:
 ONE-WAY ANOVA

 One-Way ANOVA
 ────────────────────────────────────────────────────────────────────
                          F           df1    df2         p
 ────────────────────────────────────────────────────────────────────
   wiedza3    Welch's     20.34408      2    96.14066    < .0000001
              Fisher's    21.71890      2         147    < .0000001
 ────────────────────────────────────────────────────────────────────


 Group Descriptives
 ─────────────────────────────────────────────────────────────────────
              format         N     Mean        SD          SE
 ─────────────────────────────────────────────────────────────────────
   wiedza3    stacjonarne    52    23.96154    5.639363    0.7820389
              hybrydowe      46    24.30435    6.524721    0.9620176
              online         52    17.01923    6.675946    0.9257871
 ─────────────────────────────────────────────────────────────────────


 ASSUMPTION CHECKS

 Homogeneity of Variances Test (Levene's)
 ──────────────────────────────────────────────────
              F           df1    df2    p
 ──────────────────────────────────────────────────
   wiedza3    1.219330      2    147    0.2983982
 ──────────────────────────────────────────────────


 POST HOC TESTS

 Games-Howell Post-Hoc Test – wiedza3
 ────────────────────────────────────────────────────────────────────────────
                                     stacjonarne    hybrydowe     online
 ────────────────────────────────────────────────────────────────────────────
   stacjonarne    Mean difference              —    -0.3428094     6.942308
                  p-value                      —     0.9587491    0.0000003

   hybrydowe      Mean difference                            —     7.285117
                  p-value                                    —    0.0000011

   online         Mean difference                                         —
                  p-value                                                 —
 ────────────────────────────────────────────────────────────────────────────


 DESCRIPTIVES

 Descriptives
 ────────────────────────────────────────────────────────────────────
              notatki     format         N     Mean        SD
 ────────────────────────────────────────────────────────────────────
   wiedza3    odręczne    stacjonarne    27    23.66667    6.044705
                          hybrydowe      24    23.20833    6.865029
                          online         26    19.61538    6.505855
              laptop      stacjonarne    25    24.28000    5.271938
                          hybrydowe      22    25.50000    6.061196
                          online         26    14.42308    5.879953
 ────────────────────────────────────────────────────────────────────


 ANOVA

 ANOVA - wiedza3
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                     Sum of Squares    df     Mean Square    F             p             η²p          ω²
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   notatki                 21.70129      1       21.70129     0.5792377     0.4478558    0.0040064    -0.0020821
   format                1730.99727      2      865.49864    23.1013609    < .0000001    0.2429130     0.2187289
   notatki:format         386.15893      2      193.07946     5.1535591     0.0068914    0.0667961     0.0411062
   Residuals             5394.99833    144       37.46527
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────


 ASSUMPTION CHECKS

 Homogeneity of Variances Test (Levene's)
 ────────────────────────────────────────
   F            df1    df2    p
 ────────────────────────────────────────
   0.5078517      5    144    0.7699745
 ────────────────────────────────────────


 Normality Test (Shapiro-Wilk)
 ─────────────────────────────
   Statistic    p
 ─────────────────────────────
   0.9873349    0.1896883
 ─────────────────────────────


 POST HOC TESTS

 Post Hoc Comparisons - notatki:format
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   notatki     format              notatki     format         Mean Difference    SE          df          t             p-holm        Cohen's d      Lower          Upper
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   odręczne    stacjonarne    -    odręczne    hybrydowe            0.4583333    1.717165    144.0000     0.2669128     1.0000000     0.07488021    -0.47970031    0.6294607
                              -    odręczne    online               4.0512821    1.681837    144.0000     2.4088441     0.1381370     0.66187819     0.11333072    1.2104257
                              -    laptop      stacjonarne         -0.6133333    1.698886    144.0000    -0.3610209     1.0000000    -0.10020333    -0.64893667    0.4485300
                              -    laptop      hybrydowe           -1.8333333    1.758001    144.0000    -1.0428509     1.0000000    -0.29952083    -0.86829068    0.2692490
                              -    laptop      online               9.2435897    1.681837    144.0000     5.4961284     0.0000022     1.51017143     0.93929567    2.0810472
               hybrydowe      -    odręczne    online               3.5929487    1.732635    144.0000     2.0736903     0.2792256     0.58699798     0.02332875    1.1506672
                              -    laptop      stacjonarne         -1.0716667    1.749189    144.0000    -0.6126648     1.0000000     0.17508354    -0.39013781    0.7403049
                              -    laptop      hybrydowe           -2.2916667    1.806660    144.0000    -1.2684551     1.0000000    -0.37440103    -0.95944032    0.2106383
                              -    laptop      online               8.7852564    1.732635    144.0000     5.0704596     0.0000144     1.43529123     0.85134393    2.0192385
               online         -    laptop      stacjonarne         -4.6646154    1.714521    144.0000    -2.7206522     0.0658670     0.76208152     0.20135363    1.3228094
                              -    laptop      hybrydowe           -5.8846154    1.773115    144.0000    -3.3187999     0.0125957     0.96139901     0.37797305    1.5448250
                              -    laptop      online               5.1923077    1.697629    144.0000     3.0585648     0.0265257     0.84829325     0.29125773    1.4053288
   laptop      stacjonarne    -    laptop      hybrydowe           -1.2200000    1.789295    144.0000    -0.6818327     1.0000000    -0.19931749    -0.77758813    0.3789531
                              -    laptop      online               9.8569231    1.714521    144.0000     5.7490826     0.0000007     1.61037476     1.02580933    2.1949402
               hybrydowe      -    laptop      online              11.0769231    1.773115    144.0000     6.2471527    < .0000001     1.80969226     1.19954955    2.4198350
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Comparisons are based on estimated marginal means


 ESTIMATED MARGINAL MEANS

 FORMAT:NOTATKI

 Estimated Marginal Means - format:notatki
 ───────────────────────────────────────────────────────────────────────────
   notatki     format         Mean        SE          Lower       Upper
 ───────────────────────────────────────────────────────────────────────────
   odręczne    stacjonarne    23.66667    1.177965    21.33833    25.99500
               hybrydowe      23.20833    1.249421    20.73876    25.67791
               online         19.61538    1.200405    17.24269    21.98807
   laptop      stacjonarne    24.28000    1.224178    21.86032    26.69968
               hybrydowe      25.50000    1.304978    22.92061    28.07939
               online         14.42308    1.200405    12.05039    16.79577
 ───────────────────────────────────────────────────────────────────────────


 DESCRIPTIVES

 Descriptives
 ──────────────────────────────────────────────────────────────────────────────────────────────
                         wiedza1     wiedza2     wiedza3     r5_1        r10_1       r10_5
 ──────────────────────────────────────────────────────────────────────────────────────────────
   N                          150         150         150         150         150         150
   Mean                  13.24000    17.44000    21.66000    4.200000    8.420000    4.220000
   Standard deviation    3.916374    4.466850    7.107827    4.338063    6.701968    4.594818
 ──────────────────────────────────────────────────────────────────────────────────────────────


 REPEATED MEASURES ANOVA

 Within Subjects Effects
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
               Sphericity Correction    Sum of Squares    df            Mean Square    F           p             η²-G         η²-p
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Tydzień     None                           5317.240             2     2658.62000    188.0046    < .0000001    0.2937179    0.5578695
               Greenhouse-Geisser             5317.240      1.483578     3584.06526    188.0046    < .0000001    0.2937179    0.5578695
               Huynh-Feldt                    5317.240      1.494998     3556.68819    188.0046    < .0000001    0.2937179    0.5578695

   Residual    None                           4214.093           298       14.14125
               Greenhouse-Geisser             4214.093    221.053106       19.06371
               Huynh-Feldt                    4214.093    222.754630       18.91810
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Type 3 Sums of Squares


 Between Subjects Effects
 ────────────────────────────────────────────────────────────────────────────────────────────────
               Sum of Squares    df     Mean Square    F    p            η²-G         η²-p
 ────────────────────────────────────────────────────────────────────────────────────────────────
   Residual          8571.887    149       57.52944
 ────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Type 3 Sums of Squares


 ASSUMPTIONS

 Tests of Sphericity
 ─────────────────────────────────────────────────────────────────────────────────
              Mauchly's W    p             Greenhouse-Geisser ε    Huynh-Feldt ε
 ─────────────────────────────────────────────────────────────────────────────────
   Tydzień      0.6519077    < .0000001               0.7417889        0.7474988
 ─────────────────────────────────────────────────────────────────────────────────


 POST HOC TESTS

 Post Hoc Comparisons - Tydzień
 ──────────────────────────────────────────────────────────────────────────────────────────────────
   Tydzień         Tydzień    Mean Difference    SE           df          t            p-holm
 ──────────────────────────────────────────────────────────────────────────────────────────────────
   1          -    5                -4.200000    0.3542014    149.0000    -11.85766    < .0000001
              -    10               -8.420000    0.5472134    149.0000    -15.38705    < .0000001
   5          -    10               -4.220000    0.3751653    149.0000    -11.24838    < .0000001
 ──────────────────────────────────────────────────────────────────────────────────────────────────


 ESTIMATED MARGINAL MEANS

 TYDZIEŃ

 Estimated Marginal Means - Tydzień
 ────────────────────────────────────────────────────────────
   Tydzień    Mean        SE           Lower       Upper
 ────────────────────────────────────────────────────────────
   1          13.24000    0.3197706    12.60813    13.87187
   5          17.44000    0.3647168    16.71931    18.16069
   10         21.66000    0.5803517    20.51322    22.80678
 ────────────────────────────────────────────────────────────
2. Dane symulowane i pliki CSV oraz .sav
R
# B407 – dane symulowane do wpisu /blog/anova-w-jamovi/: pliki CSV i .sav do otwarcia w jamovi
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b407-0-dane.R
library(haven)
set.seed(4071)
komorki <- expand.grid(format = c("stacjonarne", "hybrydowe", "online"), notatki = c("odręczne", "laptop"),
                       stringsAsFactors = FALSE)
n_kom <- c(27, 24, 26, 25, 22, 26)                  # nierówne liczebności komórek 2 × 3
format <- rep(komorki$format, n_kom); notatki <- rep(komorki$notatki, n_kom); N <- sum(n_kom)
# wynik testu wiedzy (0–40) w tygodniach 1, 5 i 10 semestru; przyrost różni się między osobami
start <- rnorm(N, 14, 3.5)
tempo <- rnorm(N, 1, 0.4)                          # indywidualne tempo uczenia się
efekt_f <- c(stacjonarne = 0, hybrydowe = -1, online = -3)[format]
efekt_n <- ifelse(notatki == "laptop", ifelse(format == "online", -6, 0.5), 0)
w1 <- start + rnorm(N, 0, 2.5)
w2 <- start + 5 * tempo + 0.5 * (efekt_f + efekt_n) + rnorm(N, 0, 2.5)
w3 <- start + 10 * tempo + efekt_f + efekt_n + rnorm(N, 0, 2.5)
ogr <- function(x) round(pmin(40, pmax(0, x)))
dane <- data.frame(id = seq_len(N), notatki, format, wiedza1 = ogr(w1), wiedza2 = ogr(w2), wiedza3 = ogr(w3))
dane <- dane[sample(N), ]; dane$id <- seq_len(N); rownames(dane) <- NULL
write.csv(dane, "../anova-w-jamovi-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
# ten sam zbiór w .sav: kody liczbowe z etykietami wartości i etykiety zmiennych
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$notatki <- labelled(match(dane$notatki, c("odręczne", "laptop")), labels = c("odręczne" = 1, "laptop" = 2),
                        label = "Sposób robienia notatek")
sav$format <- labelled(match(dane$format, c("stacjonarne", "hybrydowe", "online")),
                       labels = c("stacjonarne" = 1, "hybrydowe" = 2, "online" = 3), label = "Format zajęć")
for (t in 1:3) attr(sav[[paste0("wiedza", t)]], "label") <- c("Test wiedzy – tydzień 1 (0–40)",
  "Test wiedzy – tydzień 5 (0–40)", "Test wiedzy – tydzień 10 (0–40)")[t]
write_sav(sav, "../anova-w-jamovi-dane.sav")
cat("Zapisano", nrow(dane), "wierszy\n")
print(table(notatki = factor(dane$notatki, c("odręczne", "laptop")),
            format = factor(dane$format, c("stacjonarne", "hybrydowe", "online"))))
Wynik:
Zapisano 150 wierszy
          format
notatki    stacjonarne hybrydowe online
  odręczne          27        24     26
  laptop            25        22     26
3. Jak typowy jest przykład: 1000 powtórzeń
R
# B407 – jak typowy jest przykład? 1000 powtórzeń tego samego mechanizmu generowania danych co w b407-0-dane.R
# Liczymy, jak często interakcja notatki × format wychodzi istotna (moc) i jaki bywa ε Greenhouse'a–Geissera.
set.seed(4072)
n_kom <- c(27, 24, 26, 25, 22, 26)
komorki <- expand.grid(format = c("stacjonarne", "hybrydowe", "online"), notatki = c("odręczne", "laptop"),
                       stringsAsFactors = FALSE)
format <- factor(rep(komorki$format, n_kom)); notatki <- factor(rep(komorki$notatki, n_kom)); N <- sum(n_kom)
efekt_f <- c(stacjonarne = 0, hybrydowe = -1, online = -3)[as.character(format)]
efekt_n <- ifelse(notatki == "laptop", ifelse(format == "online", -6, 0.5), 0)
ogr <- function(x) round(pmin(40, pmax(0, x)))
gg_eps <- function(Y) {                       # ε Greenhouse'a–Geissera z macierzy kowariancji pomiarów
  k <- ncol(Y); C <- contr.poly(k); S <- t(C) %*% cov(Y) %*% C
  sum(diag(S))^2 / ((k - 1) * sum(S^2))
}
wyniki <- t(replicate(1000, {
  start <- rnorm(N, 14, 3.5); tempo <- rnorm(N, 1, 0.4)
  w1 <- ogr(start + rnorm(N, 0, 2.5))
  w2 <- ogr(start + 5 * tempo + 0.5 * (efekt_f + efekt_n) + rnorm(N, 0, 2.5))
  w3 <- ogr(start + 10 * tempo + efekt_f + efekt_n + rnorm(N, 0, 2.5))
  p_int <- anova(lm(w3 ~ notatki * format))["notatki:format", "Pr(>F)"]
  c(p_int = p_int, eps = gg_eps(cbind(w1, w2, w3)))
}))
c(moc_interakcji = mean(wyniki[, "p_int"] < .05))
round(quantile(wyniki[, "eps"], c(.05, .50, .95)), 3)
Wynik:
moc_interakcji
         0.809
   5%   50%   95%
0.733 0.787 0.848
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv, który do modeli z pomiarami powtarzanymi i średnich brzegowych korzysta z pakietów afex i emmeans. Pliki .sav zapisano pakietem haven, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi albo R, której faktycznie użyłeś(-aś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- afex (wersja 1.5.1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Czynnik jako Continuous. Format z kodami 1–3 i typem Continuous to dla jamovi liczba, a nie grupy. Zmień typ na Nominal.
- Efekty główne mimo istotnej interakcji. „Brak efektu notatek” ukrywa tu różnicę 5 punktów w zajęciach online.
- Szukanie testu Welcha w oknie ANOVA. Jest tylko w One-Way ANOVA.
- η²p opisane jako η². Przepisz miarę pod nazwą z tabeli.
- Wiersz None zamiast poprawki sferyczności. Przy ε = .74 df bez poprawki są zawyżone.
- Opis wszystkich 15 porównań post hoc. Przed analizą zdecyduj, które pary odpowiadają na hipotezę.
Przy dwóch grupach wystarczy test t w jamovi, a przy wynikach porządkowych lub silnie skośnych – testy nieparametryczne w jamovi. Jeśli nie wiesz, czy ANOVA pasuje do hipotezy, skorzystaj z kreatora doboru testu.
Najczęstsze pytania
Które okno ANOVA w jamovi wybrać: One-Way ANOVA czy ANOVA?
Przy jednym czynniku i nierównych wariancjach wybierz One-Way ANOVA, bo tylko ono ma test Welcha i porównania Gamesa–Howella. Dokumentacja jmv zaznacza, że test Welcha nie obsługuje więcej niż jednego czynnika (The jamovi project, b.d.-b). Gdy czynników jest kilka, potrzebujesz interakcji albo wielkości efektu η² cząstkowe lub ω², wybierz ANOVA.
Dlaczego jamovi pokazuje ujemne ω²?
ω² odejmuje od sumy kwadratów efektu jej oczekiwaną wartość przy braku efektu. Gdy F jest mniejsze od 1, wynik wychodzi ujemny, jak −.002 dla sposobu notowania w przykładzie. Ujemna ω² oznacza efekt praktycznie zerowy. Podaj ją jako .00 albo dosłownie i dopisz, że efekt jest pomijalny.
Jak w jamovi zrobić efekty proste po istotnej interakcji?
Okno ANOVA nie ma osobnej opcji efektów prostych (The jamovi project, b.d.-b). W Post Hoc Tests przenieś człon interakcji, czyli interakcję notatek i formatu zajęć, wybierz korektę Holma i odczytaj tylko porównania w obrębie poziomów drugiego czynnika. Pamiętaj, że jamovi koryguje p dla wszystkich par komórek, w przykładzie dla 15 porównań.
Kiedy w Repeated Measures ANOVA podać wynik z poprawką Greenhouse’a–Geissera?
Gdy czynnik ma co najmniej trzy poziomy, a ε jest wyraźnie poniżej 1. Blanca i in. (2023) zalecają poprawkę Greenhouse’a–Geissera domyślnie, bez czekania na wynik testu Mauchly’ego. Wtedy w pracy podajesz ułamkowe df z wiersza Greenhouse-Geisser, np. F(1.48, 221.05).
Czy wyniki z pakietu jmv w R są takie same jak w jamovi?
Tak. Pakiet jmv zawiera te same analizy, które uruchamia jamovi (Selker i in., 2025), dlatego kod z tego wpisu odtwarza tabele bez otwierania programu. Liczby mogą się różnić tylko zaokrągleniem, bo jamovi pokazuje mniej miejsc po przecinku.
Powiązane hasła
Przeczytaj też
ANOVA z powtarzanymi pomiarami w jamovi
Okno Repeated Measures ANOVA na schemacie grupa × czas: czynnik i poziomy, format szeroki, sferyczność z poprawką, η²G, post hoc z korektą i średnie brzegowe – z kodem jmv.
Czytaj →PoradnikANCOVA w jamovi krok po kroku
Okno ANCOVA w jamovi na badaniu przed i po: kowarianta, nachylenia, η²p i ω², średnie brzegowe i post hoc liczone na średnich skorygowanych – z kodem jmv.
Czytaj →Poradnikjamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikANOVA w SPSS krok po kroku
One-Way ANOVA w SPSS od przygotowania pliku po opis APA: opcje Welch i Brown-Forsythe, Tukey a Games–Howell, η² ręcznie i składnia ONEWAY – z plikiem .sav do pobrania.
Czytaj →Masz ANOVA w jamovi i nie wiesz, który wiersz przepisać do pracy?
Sprawdzimy Twój plik .omv, wybór okna i opcji, założenia, porównania post hoc i opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Arnau, J., García-Castro, F. J., Alarcón, R., & Bono, R. (2023). Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best? Frontiers in Psychology, 14, Article 1192453. https://doi.org/10.3389/fpsyg.2023.1192453 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Langsrud, Ø. (2003). ANOVA for unbalanced data: Use Type II instead of Type III sums of squares. Statistics and Computing, 13(2), 163–167. https://doi.org/10.1023/A:1023260610025
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.-a). jamovi documentation: ANOVA: One-Way, ANOVA, ANOVA: Repeated Measures, ANOVA: Mixed, Descriptive analyses and Data Variables. jamovi docs. https://docs.jamovi.org/analyses/jg_overview.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). jmv R package: One-Way ANOVA (anovaOneW), ANOVA (ANOVA) and Repeated Measures ANOVA (anovaRM). jamovi docs. https://docs.jamovi.org/jmv/jmv_ANOVA.html ● Otwarty dostęp
Cytowania BibTeX
@article{blanca2023repeated, author={Blanca, María J. and Arnau, Jaume and García-Castro, F. Javier and Alarcón, Rafael and Bono, Roser}, title={{Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best?}}, journal={Frontiers in Psychology}, year={2023}, volume={14}, eid={1192453}, doi={10.3389/fpsyg.2023.1192453}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{langsrud2003anova, author={Langsrud, Øyvind}, title={{ANOVA for unbalanced data: Use Type II instead of Type III sums of squares}}, journal={Statistics and Computing}, year={2003}, volume={13}, number={2}, pages={163--167}, doi={10.1023/a:1023260610025}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovindanovaprzewodnik, author={{The jamovi project}}, title={{jamovi documentation: ANOVA: One-Way, ANOVA, ANOVA: Repeated Measures, ANOVA: Mixed, Descriptive analyses and Data Variables}}, howpublished={jamovi docs}, year={b.d.-a}, url={https://docs.jamovi.org/analyses/jg_overview.html}}@misc{jamovindjmvanova, author={{The jamovi project}}, title={{jmv R package: One-Way ANOVA (anovaOneW), ANOVA (ANOVA) and Repeated Measures ANOVA (anovaRM)}}, howpublished={jamovi docs}, year={b.d.-b}, url={https://docs.jamovi.org/jmv/jmv_ANOVA.html}}