Gdzie jest ANOVA z powtarzanymi pomiarami w jamovi
ANOVA z powtarzanymi pomiarami porównuje średnie z kilku pomiarów tych samych osób. Gdy dochodzi podział na grupy, mówimy o ANOVA mieszanej (grupa × czas). Logikę obu analiz i obliczenia w R opisują wpisy ANOVA z powtarzanymi pomiarami krok po kroku i ANOVA mieszana krok po kroku. Tutaj zajmujemy się tylko jamovi.
W jamovi obie wersje liczy jedno okno: Analyses → ANOVA → Repeated Measures ANOVA (The jamovi project, b.d.-a). Prosty przykład z jedną grupą i trzema pomiarami pokazaliśmy we wpisie ANOVA w jamovi. Tu: dwie grupy, interakcja, braki i porównania. Nazwy opcji podajemy po angielsku według dokumentacji jamovi i plików definicji analiz jmv, a polskie – według pliku tłumaczeń jmv (The jamovi project, b.d.-c). W Twojej wersji etykiety mogą się nieco różnić. Ten sam schemat w SPSS opisuje wpis ANOVA z powtarzanymi pomiarami i mieszana w SPSS.
Przykład i pliki do pobrania
Liczby pochodzą z jednego zbioru symulowanego (dane fikcyjne). 80 osób uczyło się 40 słówek z obcego języka. Połowa uczyła się w kilku krótkich sesjach rozłożonych w czasie, a połowa w jednej długiej sesji (nauka zmasowana). Test słówek (0–40 pkt) wypełnili zaraz po nauce, po tygodniu i po miesiącu. Pięć osób nie przyszło na ostatni pomiar. Pytanie: czy tempo zapominania zależy od sposobu nauki?
Pobierz plik CSV albo plik .sav z etykietami i powtarzaj kroki w jamovi. Kolumny: id, grupa (rozłożona, zmasowana), zaraz, tydzien i miesiac. Ziarno losowania (set.seed(5470)) wybraliśmy spośród kilkunastu sprawdzonych tak, żeby test Mauchly’ego wyszedł istotny i było co poprawiać.
Przygotowanie danych: format szeroki
To okno wymaga formatu szerokiego: jeden wiersz to jedna osoba, a każdy pomiar to osobna kolumna ciągła (The jamovi project, b.d.-a). Dane w formacie długim (wiersz = pomiar) najpierw przekształć. Przed analizą sprawdź trzy rzeczy:
zaraz,tydzienimiesiacmają typ Continuous, agrupa– Nominal. Typ zmienisz w edytorze zmiennej po dwukliku na nagłówku kolumny (The jamovi project, b.d.-a);- kody braków, np. 99, są wpisane w Missing values. Inaczej jamovi policzy 99 jako wynik. Etykiety i braki opisuje wpis przygotowanie danych w jamovi.
Średnie i SD w grupach da Analyses → Exploration → Descriptives z grupą w polu Split by (The jamovi project, b.d.-a). Zaraz po nauce lepiej wypadła nauka zmasowana: 32.80 (SD = 4.47) wobec 29.65 (SD = 5.46). Po miesiącu było odwrotnie: 20.49 (SD = 5.89, n = 37) wobec 24.53 (SD = 5.07, n = 38). Wyniki po tygodniu były zbliżone: 26.50 i 27.95 pkt.
Okno Repeated Measures ANOVA krok po kroku
- Analyses → ANOVA → Repeated Measures ANOVA (po polsku: ANOVA dla powtarzanych pomiarów).
- Repeated Measures Factors (Czynniki wewnątrzobiektowe). Domyślny czynnik nazywa się RM Factor 1 i ma dwa poziomy, Level 1 i Level 2 (The jamovi project, b.d.-c). Zmień nazwę na
czas, poziomy nazarazitydzieńi dopisz trzeci,miesiąc. Czynnika nie ma w pliku – tworzysz go tutaj, a nazwy poziomów trafią do tabel i na wykres. - Repeated Measures Cells (Komórki z powtarzanymi pomiarami). Przeciągnij każdą kolumnę do komórki właściwego poziomu:
zarazdo „zaraz”,tydziendo „tydzień”,miesiacdo „miesiąc” (The jamovi project, b.d.-a). - Between Subject Factors (Czynniki międzyobiektowe):
grupa. Od tej chwili to ANOVA mieszana (The jamovi project, b.d.-a). Pole Covariates zostaw puste – kowarianta zmienia analizę w ANCOVA (The jamovi project, b.d.-c), o której piszemy we wpisie ANCOVA w jamovi. - Effect Size: zaznacz Generalised η² i Partial η² (Uogólnione η², Cząstkowe η²).
- Model: zostaw domyślne Repeated Measures Components i Between Subjects Components oraz Sum of squares = Type 3 (The jamovi project, b.d.-c). Interakcji czas × grupa nie dodajesz ręcznie: w kodzie jmv interakcje czynników wewnątrzobiektowych z międzyobiektowymi wchodzą do modelu automatycznie.
- Assumption Checks: Sphericity tests, w Sphericity corrections – None i Greenhouse-Geisser (dla porównania także Huynh-Feldt) oraz Homogeneity test.
- Post Hoc Tests: przenieś składnik
czas:grupana prawą listę i w Corrections zamiast domyślnego Tukey zaznacz Holm. - Estimated Marginal Means: do Term 1 wstaw
czasigrupa, zaznacz Marginal means tables. Wykres (Marginal means plots) jest włączony domyślnie, a opcja Observed scores dorysuje wyniki osób. - Options → Group summary: tabela z liczbą osób wziętych do analizy i pominiętych.
Drugi czynnik wewnątrzobiektowy, np. rodzaj zadania, dodasz w tym samym polu Repeated Measures Factors. Komórki pokażą wtedy wszystkie kombinacje poziomów (The jamovi project, b.d.-c). Tabele poniżej pokazujemy w układzie jamovi. Liczby policzyliśmy funkcją jmv::anovaRM, czyli tym samym kodem, który uruchamia program (Selker i in., 2025). Pogrubione są liczby, które trafią do pracy.
Tabela Within Subjects Effects
Najpierw tabela Group Summary: w grupie rozłożonej analizę objęło 38 osób (2 pominięte), w zmasowanej 37 (3 pominięte). jamovi usuwa z całej analizy każdą osobę z brakiem choćby jednego pomiaru (The jamovi project, b.d.-c).
| Sphericity Correction | Sum of Squares | df | Mean Square | F | p | η²G | η²p | |
|---|---|---|---|---|---|---|---|---|
| czas | None | 2826.176 | 2 | 1413.088 | 136.788 | < .001 | .323 | .652 |
| Greenhouse-Geisser | 2826.176 | 1.689 | 1673.682 | 136.788 | < .001 | .323 | .652 | |
| Huynh-Feldt | 2826.176 | 1.724 | 1639.108 | 136.788 | < .001 | .323 | .652 | |
| czas:grupa | None | 526.247 | 2 | 263.123 | 25.471 | < .001 | .082 | .259 |
| Greenhouse-Geisser | 526.247 | 1.689 | 311.647 | 25.471 | < .001 | .082 | .259 | |
| Huynh-Feldt | 526.247 | 1.724 | 305.209 | 25.471 | < .001 | .082 | .259 | |
| Residual | None | 1508.251 | 146 | 10.330 | ||||
| Greenhouse-Geisser | 1508.251 | 123.268 | 12.236 | |||||
| Huynh-Feldt | 1508.251 | 125.868 | 11.983 |
Ta tabela zawiera wszystko, co dotyczy pomiarów: efekt czasu, interakcję czasu z grupą i resztę wewnątrzobiektową. W badaniu z grupami hipotezę testuje wiersz interakcji. Pyta on, czy zmiana w czasie przebiega w grupach inaczej. Tu tak: F(1.69, 123.27) = 25.47, p < .001, η²G = .08. Efekt czasu (F(1.69, 123.27) = 136.79, p < .001, η²G = .32) mówi tylko, że po uśrednieniu grup wyniki spadały.
Poprawka nie zmienia F ani sum kwadratów. Mnoży tylko oba stopnie swobody przez ε Greenhouse’a–Geissera: 2 × .844 = 1.69 i 146 × .844 = 123.27. W kodzie jmv tak właśnie liczone jest p wierszy z poprawką (The jamovi project, b.d.-c). Do pracy przepisz wiersz Greenhouse-Geisser z ułamkowymi df.
Tabela Between Subjects Effects
| Sum of Squares | df | Mean Square | F | p | η²G | η²p | |
|---|---|---|---|---|---|---|---|
| grupa | 25.120 | 1 | 25.120 | 0.415 | .521 | .004 | .006 |
| Residual | 4415.795 | 73 | 60.490 |
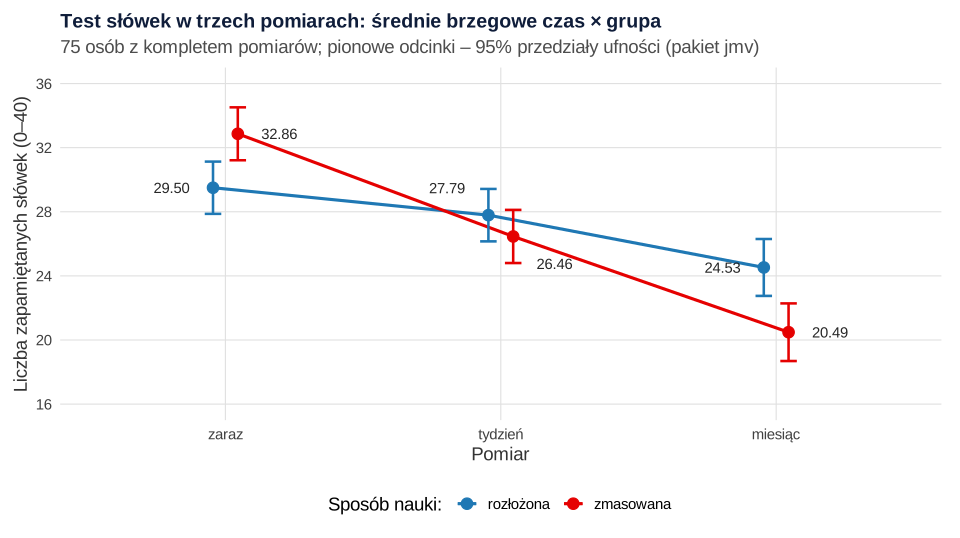
Efekt grupy porównuje średnie z trzech pomiarów razem. Jest nieistotny, F(1, 73) = 0.42, p = .521, ale to nie znaczy, że sposób nauki nie ma znaczenia. Grupy różnią się w przeciwnych kierunkach na początku i na końcu, a średnia z trzech pomiarów to ukrywa (rysunek 1).
Sferyczność i test Levene’a
| Mauchly's W | p | Greenhouse-Geisser ε | Huynh-Feldt ε | |
|---|---|---|---|---|
| czas | 0.816 | < .001 | 0.844 | 0.862 |
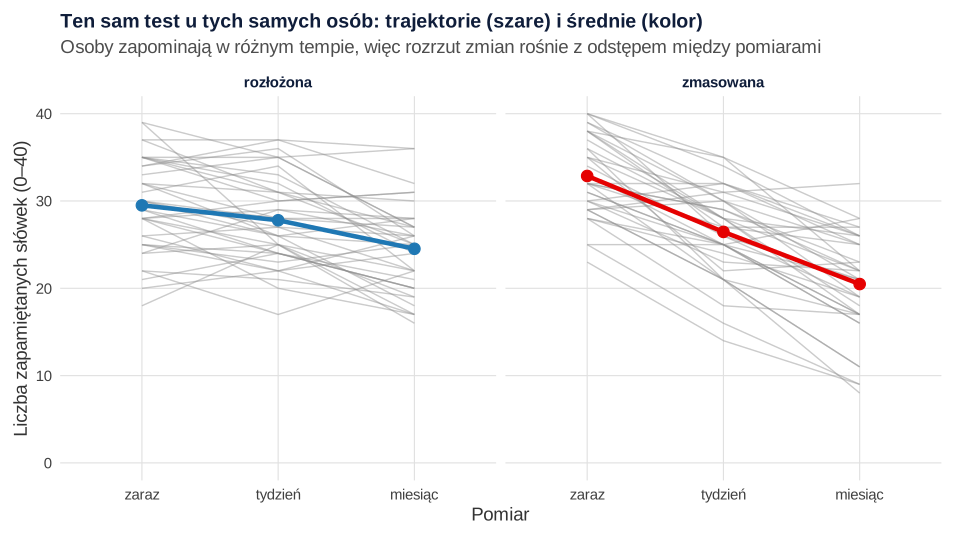
Sferyczność to równe wariancje różnic między każdą parą pomiarów. Tu jej nie ma. SD różnic (obie grupy razem) tydzień − zaraz i miesiąc − tydzień wynoszą 4.67 i 4.20, a różnicy miesiąc − zaraz – 6.56. Osoby zapominają w różnym tempie, więc rozrzut zmian rośnie z odstępem między pomiarami (rysunek 2). Test Mauchly’ego jest istotny, W = 0.82, p < .001, a ε = .84.
Co z tym zrobić? Blanca i in. (2023) w symulacjach pokazali, że nieskorygowane F przy naruszonej sferyczności daje za dużo fałszywych alarmów, a poprawki Greenhouse’a–Geissera i Huynha–Feldta kontrolują błąd I rodzaju. Zalecają poprawkę Greenhouse’a–Geissera domyślnie, bez decydowania na podstawie testu Mauchly’ego. Gdy poprawki prowadzą do różnych wniosków, przy ε od .60 do .90 radzą Huynha–Feldta. Tu wniosek jest ten sam.
Homogeneity test to w tym oknie test Levene’a liczony osobno dla każdego pomiaru: jmv bierze bezwzględne reszty pomiaru i porównuje je między grupami (The jamovi project, b.d.-c). Wszystkie trzy są nieistotne: zaraz F(1, 73) = 0.74, p = .393; po tygodniu F(1, 73) = 0.19, p = .662; po miesiącu F(1, 73) = 0.89, p = .348.
η²G czy η²p?
W tabeli Within Subjects Effects interakcja ma η²p = .26, a η²G = .08. To nie błąd. η² cząstkowe dzieli sumę kwadratów efektu tylko przez nią samą plus resztę z tego samego poziomu. Ta reszta nie zawiera stałych różnic między osobami, więc η²p wychodzi wysoko. Olejnik i Algina (2003) pokazali, że cechy schematu silnie zmieniają η²p, i zaproponowali uogólnione η², porównywalne między schematami. Bakeman (2005) zaleca podawać η²G rutynowo w analizach z pomiarami powtarzanymi. W kodzie jmv η²G liczy pakiet afex (The jamovi project, b.d.-c). Podaj jedną miarę i nazwij ją dokładnie, np. „η²G = .08”.
Porównania post hoc i średnie brzegowe
W definicji okna jmv 2.7.7 nie ma osobnej opcji efektów prostych (The jamovi project, b.d.-c). Zostaje Post Hoc Tests ze składnikiem czas:grupa. Daje on wszystkie 15 par komórek. Poniżej wybrane: grupy w każdym pomiarze i zmiany w każdej grupie.
| czas | grupa | czas | grupa | Mean Difference | SE | df | t | pholm |
|---|---|---|---|---|---|---|---|---|
| zaraz | rozłożona | zaraz | zmasowana | −3.365 | 1.165 | 73 | −2.890 | .025 |
| tydzień | rozłożona | tydzień | zmasowana | 1.330 | 1.169 | 73 | 1.138 | .259 |
| miesiąc | rozłożona | miesiąc | zmasowana | 4.040 | 1.268 | 73 | 3.187 | .013 |
| zaraz | rozłożona | tydzień | rozłożona | 1.711 | 0.658 | 73 | 2.600 | .044 |
| zaraz | rozłożona | miesiąc | rozłożona | 4.974 | 0.882 | 73 | 5.642 | < .001 |
| zaraz | zmasowana | miesiąc | zmasowana | 12.378 | 0.893 | 73 | 13.856 | < .001 |
Zaraz po nauce grupa zmasowana pamiętała o 3.36 słówka więcej, t(73) = −2.89, pHolm = .025. Po tygodniu różnica była nieistotna, a po miesiącu przewagę miała grupa rozłożona, 4.04 słówka, t(73) = 3.19, pHolm = .013. W ciągu miesiąca grupa rozłożona straciła średnio 4.97 słówka, a zmasowana 12.38. Porównania liczy pakiet emmeans na modelu wielowymiarowym (The jamovi project, b.d.-c). Każda para ma więc własny błąd standardowy i nie zakłada sferyczności.
Uwaga na korektę. Holm w tym oknie obejmuje wszystkie 15 par, także te bez sensu, np. „zaraz w grupie rozłożonej” z „miesiącem w zmasowanej”. Jeśli hipoteza dotyczy tylko trzech porównań grup w pomiarach, korekta na 15 jest zbyt surowa. Te same trzy porównania z korektą na trzy dają w R p = .010, .259 i .006 (przepis 2). Liczbę porównań ustal przed analizą i opisz ją w pracy.
| grupa | czas | Mean | SE | Lower | Upper |
|---|---|---|---|---|---|
| rozłożona | zaraz | 29.500 | 0.818 | 27.870 | 31.130 |
| tydzień | 27.789 | 0.821 | 26.153 | 29.426 | |
| miesiąc | 24.526 | 0.890 | 22.752 | 26.301 | |
| zmasowana | zaraz | 32.865 | 0.829 | 31.213 | 34.517 |
| tydzień | 26.459 | 0.832 | 24.801 | 28.118 | |
| miesiąc | 20.486 | 0.902 | 18.688 | 22.285 |
Przy kompletnych danych średnie brzegowe komórek to zwykłe średnie 75 osób z analizy. Przedziały ufności dotyczą pojedynczych średnich, a nie zmiany u tych samych osób – tę oceniają porównania post hoc.
Kiedy lepszy będzie model mieszany
ANOVA z powtarzanymi pomiarami usunęła pięć osób tylko dlatego, że nie przyszły na ostatni pomiar. Liniowy model mieszany na tych samych danych wykorzystuje wszystkie 235 pomiarów 80 osób. Daje ten sam wniosek: interakcja F(2, 151.91) = 26.06, p < .001 (przepis 2). Gueorguieva i Krystal (2004) wskazują, że modele mieszane korzystają ze wszystkich dostępnych danych, lepiej radzą sobie z brakami i elastyczniej modelują czas. Wybierz go przy większych brakach albo różnych odstępach między pomiarami. Porównanie obu podejść opisuje wpis ANOVA z powtarzanymi pomiarami czy model mieszany?, a wykonanie w jamovi – model mieszany w jamovi (GAMLj). Gdy rozkład wyników jest wyraźnie nienormalny, a grupa tylko jedna, alternatywą jest test Friedmana z wpisu testy nieparametryczne w jamovi.
Zapis wyników w stylu APA
Podaj schemat, liczbę osób w analizie, poprawkę sferyczności, wynik interakcji z η²G, efekty główne i porównania z nazwaną korektą. W metodzie wpisz wersję jamovi. Wzór do dostosowania:
Obok wyniku pokaż wykres średnich z rysunku 1 albo tabelę średnich i SD w komórkach. Zdania do innych analiz przygotuje generator opisu wyników APA, a czytanie takich tabel przećwiczysz w zbiorze ANOVA – zadania z rozwiązaniami.
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc przepis 1 daje te same tabele co okno Repeated Measures ANOVA (Selker i in., 2025). Argumenty funkcji anovaRM odpowiadają opcjom okna: rm to czynnik i poziomy, rmCells – komórki, bs – czynnik międzyobiektowy, a dalej effectSize, spherCorr, postHocCorr, emMeans (The jamovi project, b.d.-b). Liczby we wpisie pochodzą z tego kodu, nie z uruchomienia jamovi. Przepis 2 to kontrola w afex, efekty proste i model mieszany, a przepis 3 tworzy pliki. Tabele wyników są szerokie: przewiń je w poziomie.
1. Okno Repeated Measures ANOVA funkcją jmv::anovaRM
R
# To samo w R: okno Analyses → ANOVA → Repeated Measures ANOVA wykonane pakietem jmv (silnik analiz jamovi)
library(jmv)
dane <- read.csv("anova-z-powtarzanymi-pomiarami-w-jamovi-dane.csv")
dane$grupa <- factor(dane$grupa, levels = c("rozłożona", "zmasowana"))

# 1. Exploration → Descriptives: trzy pomiary w dwóch grupach (Split by: grupa)
descriptives(data = dane, vars = c("zaraz", "tydzien", "miesiac"), splitBy = "grupa", desc = "rows",
             median = FALSE, min = FALSE, max = FALSE)

# 2. Repeated Measures ANOVA: czynnik „czas” (3 poziomy) i czynnik międzyobiektowy „grupa”
anovaRM(data = dane,
        rm = list(list(label = "czas", levels = c("zaraz", "tydzień", "miesiąc"))),
        rmCells = list(list(measure = "zaraz", cell = "zaraz"),
                       list(measure = "tydzien", cell = "tydzień"),
                       list(measure = "miesiac", cell = "miesiąc")),
        bs = "grupa", depLabel = "Słówka",
        rmTerms = ~ czas, bsTerms = ~ grupa,
        effectSize = c("ges", "partEta"),
        spherTests = TRUE, spherCorr = c("none", "GG", "HF"), leveneTest = TRUE,
        postHoc = list(c("czas", "grupa")), postHocCorr = "holm",
        emMeans = ~ czas:grupa, emmTables = TRUE, emmPlots = FALSE,
        groupSumm = TRUE)
Wynik:
 DESCRIPTIVES

 Descriptives
 ─────────────────────────────────────────────────────────────────
              grupa        N     Missing    Mean        SD
 ─────────────────────────────────────────────────────────────────
   zaraz      rozłożona    40          0    29.65000    5.456354
              zmasowana    40          0    32.80000    4.473283
   tydzien    rozłożona    40          0    27.95000    5.073561
              zmasowana    40          0    26.50000    4.961389
   miesiac    rozłożona    38          2    24.52632    5.065713
              zmasowana    37          3    20.48649    5.890773
 ─────────────────────────────────────────────────────────────────


 REPEATED MEASURES ANOVA

 Within Subjects Effects
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                 Sphericity Correction    Sum of Squares    df            Mean Square    F            p             η²-G         η²-p
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   czas          None                          2826.1758             2     1413.08792    136.78815    < .0000001    0.3229833    0.6520299
                 Greenhouse-Geisser            2826.1758      1.688598     1673.68165    136.78815    < .0000001    0.3229833    0.6520299
                 Huynh-Feldt                   2826.1758      1.724216     1639.10767    136.78815    < .0000001    0.3229833    0.6520299

   czas:grupa    None                           526.2469             2      263.12347     25.47058    < .0000001    0.0815850    0.2586618
                 Greenhouse-Geisser             526.2469      1.688598      311.64723     25.47058    < .0000001    0.0815850    0.2586618
                 Huynh-Feldt                    526.2469      1.724216      305.20939     25.47058    < .0000001    0.0815850    0.2586618

   Residual      None                          1508.2508           146       10.33049
                 Greenhouse-Geisser            1508.2508    123.267669       12.23558
                 Huynh-Feldt                   1508.2508    125.867775       11.98282
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Type 3 Sums of Squares


 Between Subjects Effects
 ───────────────────────────────────────────────────────────────────────────────────────────────────────
               Sum of Squares    df    Mean Square    F            p            η²-G         η²-p
 ───────────────────────────────────────────────────────────────────────────────────────────────────────
   grupa             25.12015     1       25.12015    0.4152754    0.5213238    0.0042225    0.0056565
   Residual        4415.79540    73       60.49035
 ───────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Type 3 Sums of Squares


 ASSUMPTIONS

 Tests of Sphericity
 ─────────────────────────────────────────────────────────────────────────────
           Mauchly's W    p            Greenhouse-Geisser ε    Huynh-Feldt ε
 ─────────────────────────────────────────────────────────────────────────────
   czas      0.8155856    0.0006500               0.8442991        0.8621081
 ─────────────────────────────────────────────────────────────────────────────


 Homogeneity of Variances Test (Levene's)
 ───────────────────────────────────────────────────
              F            df1    df2    p
 ───────────────────────────────────────────────────
   zaraz      0.7385339      1     73    0.3929443
   tydzien    0.1931696      1     73    0.6615899
   miesiac    0.8909381      1     73    0.3483368
 ───────────────────────────────────────────────────


 POST HOC TESTS

 Post Hoc Comparisons - czas:grupa
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   czas       grupa             czas       grupa        Mean Difference    SE           df          t            p-holm
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   zaraz      rozłożona    -    zaraz      zmasowana          -3.364865    1.1645147    73.00000    -2.889500     0.0253848
                           -    tydzień    rozłożona           1.710526    0.6579158    73.00000     2.599917     0.0443738
                           -    tydzień    zmasowana           3.040541    1.1666874    73.00000     2.606131     0.0443738
                           -    miesiąc    rozłożona           4.973684    0.8815330    73.00000     5.642085     0.0000027
                           -    miesiąc    zmasowana           9.013514    1.2178032    73.00000     7.401453    < .0000001
              zmasowana    -    tydzień    rozłożona           5.075391    1.1666303    73.00000     4.350471     0.0003039
                           -    tydzień    zmasowana           6.405405    0.6667473    73.00000     9.606947    < .0000001
                           -    miesiąc    rozłożona           8.338549    1.2164308    73.00000     6.854931    < .0000001
                           -    miesiąc    zmasowana          12.378378    0.8933661    73.00000    13.855885    < .0000001
   tydzień    rozłożona    -    tydzień    zmasowana           1.330014    1.1687991    73.00000     1.137932     0.2588698
                           -    miesiąc    rozłożona           3.263158    0.6489805    73.00000     5.028129     0.0000274
                           -    miesiąc    zmasowana           7.302987    1.2198264    73.00000     5.986907     0.0000007
              zmasowana    -    miesiąc    rozłożona           1.933144    1.2185110    73.00000     1.586480     0.2339058
                           -    miesiąc    zmasowana           5.972973    0.6576920    73.00000     9.081717    < .0000001
   miesiąc    rozłożona    -    miesiąc    zmasowana           4.039829    1.2675386    73.00000     3.187145     0.0126942
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────


 ESTIMATED MARGINAL MEANS

 CZAS:GRUPA

 Estimated Marginal Means - czas:grupa
 ─────────────────────────────────────────────────────────────────────────
   grupa        czas       Mean        SE           Lower       Upper
 ─────────────────────────────────────────────────────────────────────────
   rozłożona    zaraz      29.50000    0.8179282    27.86987    31.13013
                tydzień    27.78947    0.8209375    26.15335    29.42560
                miesiąc    24.52632    0.8902899    22.75197    26.30066
   zmasowana    zaraz      32.86486    0.8289076    31.21285    34.51688
                tydzień    26.45946    0.8319573    24.80137    28.11755
                miesiąc    20.48649    0.9022406    18.68832    22.28465
 ─────────────────────────────────────────────────────────────────────────


 Group Summary
 ───────────────────────────────
   grupa        N     Excluded
 ───────────────────────────────
   rozłożona    38           2
   zmasowana    37           3
 ───────────────────────────────
2. Kontrola: afex, efekty proste i model mieszany
R
# Kontrola liczb z jamovi pakietem afex (inna droga do tej samej ANOVA) oraz to, czego okno nie podaje
suppressPackageStartupMessages({library(afex); library(emmeans); library(lmerTest)})
dane <- read.csv("anova-z-powtarzanymi-pomiarami-w-jamovi-dane.csv")
dane$grupa <- factor(dane$grupa, levels = c("rozłożona", "zmasowana"))

# Format długi: jeden wiersz = jeden pomiar jednej osoby
dl <- reshape(dane, direction = "long", varying = c("zaraz", "tydzien", "miesiac"), v.names = "slowka",
              timevar = "czas", times = c("zaraz", "tydzień", "miesiąc"), idvar = "id")
dl$czas <- factor(dl$czas, levels = c("zaraz", "tydzień", "miesiąc"))
cat("Wiersze w formacie długim:", nrow(dl), "  pomiary z wynikiem:", sum(!is.na(dl$slowka)), "\n")

# 0. Osoby z kompletem pomiarów: średnie komórek (= średnie brzegowe z jamovi) i SD różnic między pomiarami
pe <- dane[complete.cases(dane), ]
print(aggregate(cbind(zaraz, tydzien, miesiac) ~ grupa, data = pe, FUN = function(x) round(mean(x), 3)))
cat("SD różnic tydzień − zaraz, miesiąc − tydzień, miesiąc − zaraz:",
    round(c(sd(pe$tydzien - pe$zaraz), sd(pe$miesiac - pe$tydzien), sd(pe$miesiac - pe$zaraz)), 2), "\n")

# 1. ANOVA mieszana w afex na osobach z kompletem pomiarów (jak w jamovi): typ 3, η²G i η²p, poprawka GG
pelne <- dl[dl$id %in% pe$id, ]
m <- aov_car(slowka ~ grupa + Error(id / czas), data = pelne, type = 3, anova_table = list(es = "ges"))
print(nice(m, correction = "GG", es = c("ges", "pes")))
print(summary(m)$sphericity.tests)

# 2. Efekty proste (czego okno Repeated Measures ANOVA nie ma): grupy w każdym pomiarze, korekta Holma
emm <- emmeans(m, ~ grupa | czas)
print(summary(pairs(emm), adjust = "holm", by = NULL))

# 3. Model mieszany na wszystkich 80 osobach (osoby z brakiem zostają z dwoma pomiarami)
lmm <- lmer(slowka ~ grupa * czas + (1 | id), data = dl)
print(anova(lmm))
cat("Osoby w modelu mieszanym:", ngrps(lmm)[["id"]], "  pomiary:", nobs(lmm), "\n")
Wynik:
Wiersze w formacie długim: 240   pomiary z wynikiem: 235
      grupa  zaraz tydzien miesiac
1 rozłożona 29.500  27.789  24.526
2 zmasowana 32.865  26.459  20.486
SD różnic tydzień − zaraz, miesiąc − tydzień, miesiąc − zaraz: 4.67 4.2 6.56
Contrasts set to contr.sum for the following variables: grupa
Anova Table (Type 3 tests)

Response: slowka
      Effect           df   MSE          F  ges  pes p.value
1      grupa        1, 73 60.49       0.42 .004 .006    .521
2       czas 1.69, 123.27 12.24 136.79 *** .323 .652   <.001
3 grupa:czas 1.69, 123.27 12.24  25.47 *** .082 .259   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
           Test statistic    p-value
czas              0.81559 0.00064999
grupa:czas        0.81559 0.00064999
 contrast              czas    estimate   SE df t.ratio p.value
 rozłożona - zmasowana zaraz      -3.36 1.16 73  -2.890  0.0102
 rozłożona - zmasowana tydzień     1.33 1.17 73   1.138  0.2589
 rozłożona - zmasowana miesiąc     4.04 1.27 73   3.187  0.0063

P value adjustment: holm method for 3 tests
Type III Analysis of Variance Table with Satterthwaite's method
            Sum Sq Mean Sq NumDF   DenDF  F value    Pr(>F)
grupa         6.88    6.88     1  78.188   0.6789    0.4125
czas       2870.94 1435.47     2 151.913 141.7420 < 2.2e-16 ***
grupa:czas  527.83  263.92     2 151.913  26.0599  1.86e-10 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Osoby w modelu mieszanym: 80   pomiary: 235
3. Dane symulowane i pliki CSV oraz .sav
R
# Dane symulowane do wpisu „ANOVA z powtarzanymi pomiarami w jamovi”
# 80 osób uczy się 40 słówek: połowa w sesjach rozłożonych, połowa w jednej sesji (zmasowana).
# Test słówek (0–40) zaraz po nauce, po tygodniu i po miesiącu; 5 osób nie przyszło na pomiar po miesiącu.
library(haven)
set.seed(5470)  # ziarno wybrane spośród kilkunastu tak, by test Mauchly'ego był istotny
n <- 40
grupa <- rep(c("rozłożona", "zmasowana"), each = n)
u0 <- rnorm(2 * n, 0, 4.5)          # różnice między osobami w poziomie
u1 <- rnorm(2 * n, 0, 1.6)          # różnice między osobami w tempie zapominania
mu <- rbind(rozłożona = c(29, 27, 25), zmasowana = c(31, 25, 20))
y <- t(sapply(seq_len(2 * n), function(i) mu[grupa[i], ] + u0[i] + u1[i] * c(0, 1, 2) + rnorm(3, 0, 2.6)))
y[] <- round(pmin(40, pmax(0, y)))
dane <- data.frame(id = seq_len(2 * n), grupa, zaraz = y[, 1], tydzien = y[, 2], miesiac = y[, 3])
dane$miesiac[sample(2 * n, 5)] <- NA
write.csv(dane, "anova-z-powtarzanymi-pomiarami-w-jamovi-dane.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# Ten sam zbiór w .sav: kody grup z etykietami wartości i etykiety zmiennych
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$grupa <- labelled(match(dane$grupa, c("rozłożona", "zmasowana")),
                      labels = c("rozłożona" = 1, "zmasowana" = 2), label = "Sposób nauki")
sav$zaraz <- labelled(sav$zaraz, label = "Test słówek zaraz po nauce (0–40)")
sav$tydzien <- labelled(sav$tydzien, label = "Test słówek po tygodniu (0–40)")
sav$miesiac <- labelled(sav$miesiac, label = "Test słówek po miesiącu (0–40)")
write_sav(sav, "anova-z-powtarzanymi-pomiarami-w-jamovi-dane.sav")
cat("Zapisano", nrow(dane), "wierszy; brak pomiaru po miesiącu:", sum(is.na(dane$miesiac)), "\n")
print(head(dane, 4), row.names = FALSE)
print(table(grupa = dane$grupa, komplet = complete.cases(dane)))
Wynik:
Zapisano 80 wierszy; brak pomiaru po miesiącu: 5
 id     grupa zaraz tydzien miesiac
  1 rozłożona    30      26      18
  2 rozłożona    22      17      22
  3 rozłożona    39      25      22
  4 rozłożona    35      33      25
           komplet
grupa       FALSE TRUE
  rozłożona     2   38
  zmasowana     3   37
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv, który do modelu korzysta z pakietu afex (a ten z car), a do średnich brzegowych i porównań – z pakietu emmeans. Model mieszany policzono pakietem lmerTest (na bazie lme4), pliki .sav zapisano pakietem haven, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi albo R, której faktycznie użyłeś(-aś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- afex (wersja 1.5.1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Dane w formacie długim. Okno potrzebuje jednej kolumny na pomiar. Kolumna „czas” z wartościami 1, 2, 3 trafiona do Between Subject Factors da zwykłą ANOVA, jakby to były różne osoby.
- Kolumny w złych komórkach. Program nie zgłosi błędu.
- Wniosek z efektu czasu zamiast z interakcji czas × grupa w badaniu z grupami.
- Wiersz None przy naruszonej sferyczności albo wybór poprawki po obejrzeniu, która daje p < .05.
- η²p opisane jako η² albo porównywane z η² z badań międzygrupowych.
- Post hoc na wszystkich parach, gdy hipoteza dotyczy kilku porównań – albo odwrotnie: korekta na trzy pary dopasowana po obejrzeniu wyników.
Pierwsze kroki w programie opisuje wpis jamovi krok po kroku. Jeśli nie wiesz, czy ten schemat pasuje do Twojej hipotezy, skorzystaj z kreatora doboru testu.
Najczęstsze pytania
Gdzie w jamovi jest ANOVA z powtarzanymi pomiarami?
W menu Analyses → ANOVA → Repeated Measures ANOVA (The jamovi project, b.d.-a). W polskiej wersji interfejsu analiza nazywa się według pliku tłumaczeń jmv „ANOVA dla powtarzanych pomiarów” (The jamovi project, b.d.-c). Ten sam program ma osobne okno Repeated Measures ANOVA w podmenu Non-Parametric – to test Friedmana, a nie ANOVA.
Jak w jamovi zrobić ANOVA mieszaną?
W tym samym oknie Repeated Measures ANOVA. Zdefiniuj czynnik pomiarów i komórki, a zmienną grupującą przeciągnij do Between Subject Factors (The jamovi project, b.d.-a). Interakcję czasu z grupą jamovi doda sam – zobaczysz ją w tabeli Within Subjects Effects, a efekt grupy w tabeli Between Subjects Effects.
Którą poprawkę sferyczności wybrać w jamovi?
W Assumption Checks zaznacz Sphericity tests i w Sphericity corrections poprawkę Greenhouse-Geisser. Blanca i in. (2023) zalecają ją domyślnie, bez uzależniania decyzji od testu Mauchly’ego; gdy poprawki dają różne wnioski, przy ε między .60 a .90 radzą Huynha–Feldta. W przykładzie ε = .84 i obie prowadzą do tego samego wniosku.
Czy jamovi liczy efekty proste w ANOVA z powtarzanymi pomiarami?
W definicji okna jmv 2.7.7 nie ma osobnej opcji efektów prostych (The jamovi project, b.d.-c). Najprościej zamówić w Post Hoc Tests składnik interakcji i odczytać potrzebne pary, pamiętając, że korekta obejmuje wszystkie pary w tabeli. Efekty proste z korektą tylko dla wybranych porównań policzysz w R pakietem emmeans albo w module GAMLj.
Co robi jamovi z osobami, którym brakuje jednego pomiaru?
Usuwa je z całej analizy. W kodzie jmv osoby z pustą komórką są pomijane przed policzeniem modelu, a opcja Group summary pokazuje ich liczbę w kolumnie Excluded (The jamovi project, b.d.-c). W przykładzie z 80 osób zostało 75. Przy większych brakach rozważ model mieszany, który wykorzystuje wszystkie dostępne pomiary (Gueorguieva i Krystal, 2004).
Powiązane hasła
Przeczytaj też
ANOVA z powtarzanymi pomiarami i mieszana w SPSS
GLM Repeated Measures od formatu szerokiego po opis APA: Define Factors, test Mauchly’ego, Greenhouse–Geisser, η² cząstkowe i efekty proste z EMMEANS – z plikiem .sav do pobrania.
Czytaj →PoradnikANOVA mieszana krok po kroku
Sferyczność, test M Boxa, interakcja grupa × czas, efekty proste w emmeans i wzór opisu APA – na przykładzie trzech grup i trzech pomiarów.
Czytaj →PoradnikANOVA w jamovi krok po kroku
Trzy okna ANOVA w jamovi na jednym zbiorze: Welch i Games–Howell, interakcja 2 × 3 z η²p i ω², post hoc i średnie brzegowe, sferyczność i poprawka GG – z kodem jmv.
Czytaj →PoradnikModel mieszany w jamovi (GAMLj) krok po kroku
Moduł GAMLj w jamovi: format długi, klaster, losowy wyraz wolny i nachylenie, ICC w Random Components, średnie brzegowe, simple effects i różnice wobec MIXED w SPSS.
Czytaj →Masz ANOVA z powtarzanymi pomiarami w jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy Twój plik .omv, definicję czynnika i komórek, poprawkę sferyczności, wielkości efektu i porównania post hoc i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Blanca, M. J., Arnau, J., García-Castro, F. J., Alarcón, R., & Bono, R. (2023). Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best? Frontiers in Psychology, 14, Article 1192453. https://doi.org/10.3389/fpsyg.2023.1192453 ● Otwarty dostęp
- Gueorguieva, R., & Krystal, J. H. (2004). Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry. Archives of General Psychiatry, 61(3), 310–317. https://doi.org/10.1001/archpsyc.61.3.310
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.-a). jamovi documentation: ANOVA: One-Way, ANOVA, ANOVA: Repeated Measures, ANOVA: Mixed, Descriptive analyses and Data Variables. jamovi docs. https://docs.jamovi.org/analyses/jg_overview.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). jmv R package: One-Way ANOVA (anovaOneW), ANOVA (ANOVA) and Repeated Measures ANOVA (anovaRM). jamovi docs. https://docs.jamovi.org/jmv/jmv_ANOVA.html ● Otwarty dostęp
- The jamovi project. (b.d.-c). jmv: Repeated Measures ANOVA – analysis definition files (anovarm.a.yaml, anovarm.u.yaml, anovarm.r.yaml). GitHub – jamovi/jmv. https://github.com/jamovi/jmv/tree/master/jamovi ● Otwarty dostęp
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{blanca2023repeated, author={Blanca, María J. and Arnau, Jaume and García-Castro, F. Javier and Alarcón, Rafael and Bono, Roser}, title={{Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best?}}, journal={Frontiers in Psychology}, year={2023}, volume={14}, eid={1192453}, doi={10.3389/fpsyg.2023.1192453}}@article{gueorguieva2004move, author={Gueorguieva, Ralitza and Krystal, John H.}, title={{Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry}}, journal={Archives of General Psychiatry}, year={2004}, volume={61}, number={3}, pages={310--317}, doi={10.1001/archpsyc.61.3.310}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovindanovaprzewodnik, author={{The jamovi project}}, title={{jamovi documentation: ANOVA: One-Way, ANOVA, ANOVA: Repeated Measures, ANOVA: Mixed, Descriptive analyses and Data Variables}}, howpublished={jamovi docs}, year={b.d.-a}, url={https://docs.jamovi.org/analyses/jg_overview.html}}@misc{jamovindjmvanova, author={{The jamovi project}}, title={{jmv R package: One-Way ANOVA (anovaOneW), ANOVA (ANOVA) and Repeated Measures ANOVA (anovaRM)}}, howpublished={jamovi docs}, year={b.d.-b}, url={https://docs.jamovi.org/jmv/jmv_ANOVA.html}}@misc{jamovigithubjmvanovarm, author={{The jamovi project}}, title={{jmv: Repeated Measures ANOVA – analysis definition files (anovarm.a.yaml, anovarm.u.yaml, anovarm.r.yaml)}}, howpublished={GitHub – jamovi/jmv}, year={b.d.-c}, url={https://github.com/jamovi/jmv/tree/master/jamovi}}