ANOVA – zadania z rozwiązaniami: jak z nich korzystać
Poniżej znajdziesz ANOVA – zadania z rozwiązaniami w takiej formie, w jakiej trafiają na kolokwium i egzamin ze statystyki na drugim roku: krótka historyjka, mała tabela danych albo niepełna tabela wyników. Zadania prowadzą od jednoczynnikowej analizy wariancji przez post hoc, założenia i wielkość efektu do ANOVA dwuczynnikowej, pomiarów powtarzanych i kontrastów.
Każde zadanie ma ten sam układ: treść, rozwiązanie krok po kroku, interpretacja i typowy błąd. Wyniki zaokrąglamy do dwóch miejsc po kropce, a p i miary efektu do trzech. Wszystkie liczby sprawdziliśmy w R – każde zadanie dwa razy: wzorem, jak na kartce, i gotową funkcją (kod na końcu wpisu). Wzory są zgodne z podręcznikami (King i Minium, 2009; Maxwell i in., 2018). Zbiór nie powtarza zadania 9 z zadań ze statystyki na psychologii (trzy równe grupy po 5 osób i podstawowa tabela ANOVA). Pełny przykład z opisem założeń i interpretacją znajdziesz w poradniku ANOVA krok po kroku.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | trzy formy edukacji pacjentów z cukrzycą (n = 5, 7, 6) | ANOVA jednoczynnikowa z sum przy nierównych liczebnościach |
| 2 | cztery warianty szkolenia sprzedawców | uzupełnianie tabeli ANOVA, p, η² |
| 3 | te same dane | test Tukeya HSD ręcznie (q z tablic lub qtukey) |
| 4 | czas rozwiązania łamigłówki w trzech grupach wiekowych | test Levene’a (wokół średniej i mediany) |
| 5 | te same dane | ANOVA Welcha a klasyczne F |
| 6 | forma szkolenia × doświadczenie pielęgniarek | ANOVA 2 × 2: efekty główne, interakcja, efekty proste |
| 7 | dane z zadań 6 i 1 | η², cząstkowe η² i ω² |
| 8 | zgięcie kolana po endoprotezie: 3 pomiary | ANOVA z powtarzanymi pomiarami, SS osób, sferyczność |
| 9 | szkolenia sprzedawców (dane z zadania 2) | kontrast planowany |
| 10 | błędy w dyktandzie w dwóch klasach | ANOVA a test t: F = t² |
Surowe dane do wszystkich zadań pobierzesz w pliku anova-zadania-dane.csv (format długi: zadanie, id, czynnik_a, czynnik_b, wynik). Wartości krytyczne F odczytasz z tablic rozkładów t, χ² i F. Dane są wymyślone.
Zadanie 1. ANOVA jednoczynnikowa przy nierównych liczebnościach
Treść zadania
Pielęgniarka edukacyjna porównała trzy formy edukacji pacjentów z cukrzycą typu 2. Po miesiącu pacjenci rozwiązali test wiedzy (0–20 pkt). Ulotka (n = 5): 9, 11, 8, 12, 10. Rozmowa z pielęgniarką (n = 7): 14, 12, 15, 13, 16, 11, 17. Zajęcia grupowe (n = 6): 12, 13, 11, 14, 12, 10. Czy forma edukacji różnicuje wiedzę (α = .05)? Policz sumy kwadratów z sum, bez odchyleń od średnich.
Rozwiązanie krok po kroku
Krok 1. Sumy w grupach. Dla każdej grupy policz liczebność nj, sumę wyników Tj i sumę kwadratów wyników Σx².
| Grupa | nj | Tj | Mj | Σx² |
|---|---|---|---|---|
| ulotka | 5 | 50 | 10.00 | 510 |
| rozmowa | 7 | 98 | 14.00 | 1400 |
| zajęcia grupowe | 6 | 72 | 12.00 | 874 |
| Razem | N = 18 | T = 220 | 12.22 | 2784 |
Krok 2. Całkowita suma kwadratów (składnik T²/N = 220² / 18 = 2688.89 to tzw. poprawka):
Krok 3. Suma kwadratów między grupami – każdą sumę grupy dzielisz przez jej liczebność:
Krok 4. Reszta i tabela. SSW = 95.11 − 47.11 = 48.00 (kontrola: Σ(nj − 1)sj² = 48.00). df = 2 i 15, MSB = 23.56, MSW = 3.20.
Interpretacja
Mniej obciążone ω² dla tych danych policzysz w zadaniu 7.
Typowy błąd
Liczenie średniej ogólnej jako średniej trzech średnich: (10 + 14 + 12) / 3 = 12.00 zamiast 220 / 18 = 12.22. Przy nierównych grupach daje to złą SSB (48.00 zamiast 47.11).
Zadanie 2. Uzupełnianie tabeli ANOVA
Treść zadania
Firma sprawdziła cztery warianty szkolenia sprzedawców: grupa kontrolna (bez szkolenia), e-learning, warsztat oraz warsztat z coachingiem – po 8 osób. Wynik to liczba umów podpisanych w miesiącu po szkoleniu. Średnie: 22, 24, 27 i 29. Z wydruku zostały tylko trzy liczby. Uzupełnij tabelę, oblicz p i η².
| Źródło | SS | df | MS | F |
|---|---|---|---|---|
| Między grupami | 232.00 | ? | ? | ? |
| Wewnątrz grup | ? | ? | 5.00 | |
| Ogółem | 372.00 | ? |
Rozwiązanie krok po kroku
Krok 1. Stopnie swobody. k = 4, N = 32: dfmiędzy = k − 1 = 3, dfwewn = N − k = 28, dfogółem = N − 1 = 31 (kontrola: 3 + 28 = 31).
Krok 2. Brakujące sumy i średnie kwadraty. SSW = SST − SSB = 372 − 232 = 140.00 (kontrola: 140 / 28 = 5.00 – zgadza się z podanym MSW). MSB = 232 / 3 = 77.33.
Krok 3. Statystyka F i decyzja.
Interpretacja
Gotowy układ tabeli do pracy znajdziesz w haśle tabela ANOVA w APA, a wielkość efektu omawia hasło eta kwadrat.
Typowy błąd
Wpisywanie w wiersz „Ogółem” sumy MS (77.33 + 5.00). Sumują się tylko SS i df; średnie kwadraty się nie sumują.
Zadanie 3. Test Tukeya HSD ręcznie
Treść zadania
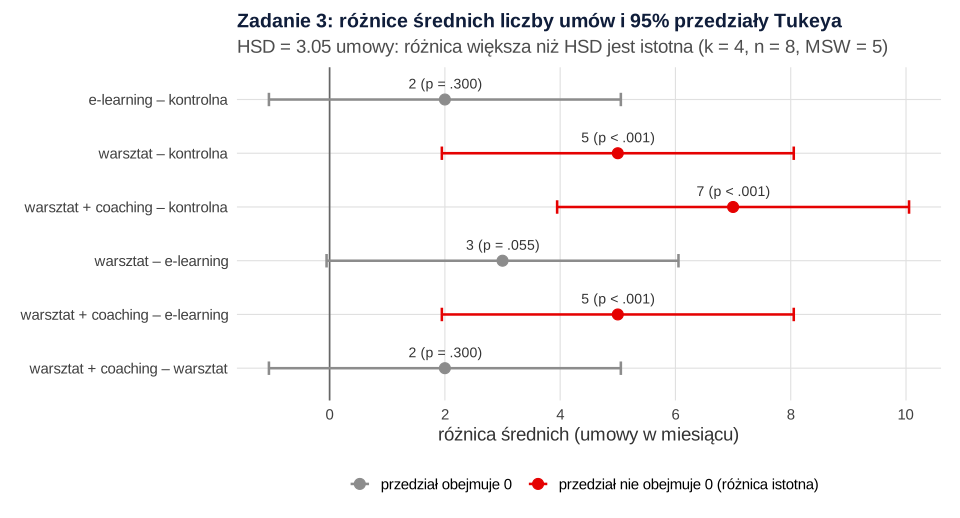
Dla danych z zadania 2 (MSW = 5.00, n = 8 w każdej grupie, df = 28) wykonaj test Tukeya HSD (α = .05). Które warianty szkolenia różnią się od siebie?
Rozwiązanie krok po kroku
Krok 1. Wartość q. Z tablic rozkładu studentyzowanego rozstępu dla k = 4 średnich i df = 28 (w R: qtukey(0.95, 4, 28)): q = 3.861.
Krok 2. Najmniejsza istotna różnica (test Tukeya HSD):
Krok 3. Porównanie wszystkich par. Przy 4 grupach jest 4 × 3 / 2 = 6 par.
| Para | Różnica | > 3.05? | p (Tukey) |
|---|---|---|---|
| e-learning – kontrolna | 2 | nie | .300 |
| warsztat – kontrolna | 5 | tak | < .001 |
| warsztat + coaching – kontrolna | 7 | tak | < .001 |
| warsztat – e-learning | 3 | nie | .055 |
| warsztat + coaching – e-learning | 5 | tak | < .001 |
| warsztat + coaching – warsztat | 2 | nie | .300 |
Interpretacja
Różnica warsztat – e-learning (3 umowy) jest tuż pod progiem – to nie dowód braku różnicy. Kiedy zamiast Tukeya wybrać inny test, wyjaśnia wpis testy post hoc – który wybrać.
Typowy błąd
Porównanie każdej pary zwykłym testem t (granica tkryt(28) × √(2MSW/n)) zamiast q. Taka granica jest niższa i nie kontroluje ryzyka błędu dla całej rodziny sześciu porównań.
Zadanie 4. Test Levene’a: czy wariancje są równe?
Treść zadania
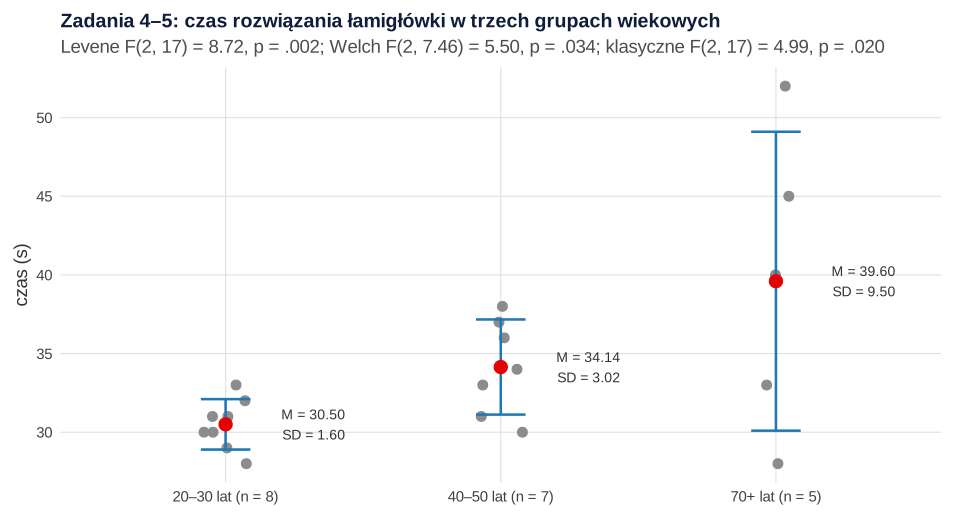
Psycholożka zmierzyła czas rozwiązania łamigłówki (s) w trzech grupach wiekowych. 20–30 lat (n = 8): 30, 32, 29, 31, 33, 30, 28, 31. 40–50 lat (n = 7): 34, 30, 38, 33, 36, 31, 37. 70+ lat (n = 5): 45, 28, 52, 33, 40. Sprawdź testem Levene’a założenie równości wariancji.
Rozwiązanie krok po kroku
Krok 1. Opis grup. Średnie: 30.50, 34.14 i 39.60; SD: 1.60, 3.02 i 9.50 (wariancje 2.57 i 90.30 różnią się 35-krotnie).
Krok 2. Odchylenia bezwzględne. Test Levene’a zamienia każdy wynik na jego odległość od średniej własnej grupy, |x − Mj|. W grupie 70+ są to: 5.40, 11.60, 12.40, 6.60, 0.40. Średnie odchylenia w grupach: 1.25, 2.45 i 7.28.
Krok 3. Zwykła ANOVA na odchyleniach.:
Krok 4. Wersja z medianą. Brown i Forsythe (1974) zaproponowali odległość od mediany, odporniejszą na rozkłady nienormalne: F(2, 17) = 7.98, p = .004. Tę wersję car::leveneTest() liczy domyślnie, a wersję ze średnią – po dodaniu center = mean.
Interpretacja
Wariancje różnią się istotnie, F(2, 17) = 8.72, p = .002 – założenie homogeniczności wariancji nie jest spełnione, a najmniejsza grupa ma największy rozrzut. Klasyczny test F trzeba tu zastąpić ANOVA Welcha (zadanie 5).
Typowy błąd
Uznanie wyniku Levene’a za test różnic średnich („Levene istotny, więc grupy się różnią”). Levene porównuje rozrzuty, nie poziomy. Przy małych grupach bywa też nieistotny mimo dużych różnic wariancji.
Zadanie 5. ANOVA Welcha przy nierównych wariancjach
Treść zadania
Dla danych z zadania 4 oblicz statystykę F Welcha i jej stopnie swobody. Porównaj wynik z klasyczną ANOVA.
Rozwiązanie krok po kroku
Krok 1. Wagi. Każda grupa dostaje wagę wj = nj / sj²: 8 / 2.57 = 3.111, 7 / 9.14 = 0.766, 5 / 90.30 = 0.055. Średnia ważona Mw = ΣwjMj / Σwj = 31.34.
Krok 2. Licznik i poprawka.
λ = Σ(1 − wj/Σw)² / (nj − 1) = 0.357; mianownik = 1 + 2(k − 2)/(k² − 1) × λ = 1.089
Krok 3. Statystyka i df. FW = 5.994 / 1.089 = 5.50; df1 = 2, df2 = (k² − 1) / (3λ) = 7.46; p = .034. Tak samo liczy oneway.test(), w którym Welch jest ustawieniem domyślnym.
Krok 4. Porównanie. Klasyczna ANOVA daje F(2, 17) = 4.99, p = .020. Wniosek się nie zmienia, ale klasyczne p jest za małe, bo wspólna wariancja „pożycza” małą zmienność grupie 70+.
Interpretacja
Welch (1951) zaproponował ten test do porównywania kilku średnich, a Delacre i in. (2019) zalecają go jako domyślny zamiast klasycznego F. Porównania par wykonaj wtedy testem Gamesa–Howella, nie Tukeya (zob. ANOVA Welcha).
Typowy błąd
Zaokrąglanie df2 do liczby całkowitej w opisie albo wpisywanie df = 17 z klasycznej ANOVA. Ułamkowe stopnie swobody (7.46) to normalna cecha testu Welcha.
Zadanie 6. ANOVA dwuczynnikowa 2 × 2 z interakcją
Treść zadania
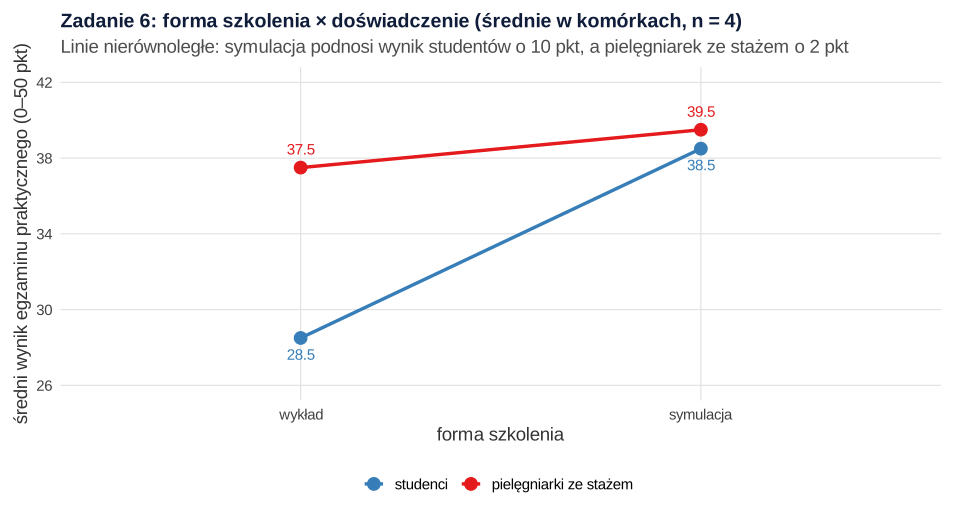
Na egzaminie praktycznym z resuscytacji (0–50 pkt) porównano dwie formy szkolenia (wykład, symulacja) u studentów pielęgniarstwa i u pielęgniarek z co najmniej pięcioletnim stażem – po 4 osoby w komórce. Studenci po wykładzie: 27, 31, 26, 30; studenci po symulacji: 37, 41, 38, 38; pielęgniarki po wykładzie: 36, 40, 37, 37; pielęgniarki po symulacji: 38, 42, 39, 39. Wykonaj ANOVA 2 × 2, narysuj wykres interakcji i zbadaj efekty proste.
Rozwiązanie krok po kroku
Krok 1. Tabela średnich.
| Doświadczenie | Wykład | Symulacja | Średnia brzegowa |
|---|---|---|---|
| studenci | 28.5 | 38.5 | 33.5 |
| pielęgniarki | 37.5 | 39.5 | 38.5 |
| średnia brzegowa | 33.0 | 39.0 | M = 36.0 |
Krok 2. Sumy kwadratów (układ zrównoważony, n = 4 w komórce, więc 8 osób na każdy poziom czynnika):
SSkomórek = 4 × Σ(Mij − 36)² = 308.00; SSinterakcja = 308 − 100 − 144 = 64.00
SSwewn = 44.00 (odchylenia od średnich komórek); MSwewn = 44 / 12 = 3.667
Krok 3. Testy F (każdy efekt ma df = 1, błąd df = 16 − 4 = 12): doświadczenie F = 27.27, forma F = 39.27 (oba p < .001), interakcja F = 64 / 3.667 = 17.45, p = .001.
Krok 4. Efekty proste. Efekt formy liczysz osobno w każdym wierszu, ze wspólnym MSwewn = 3.667:
pielęgniarki: SS = 4 × [(37.5 − 38.5)² + (39.5 − 38.5)²] = 8.00; F(1, 12) = 2.18, p = .165
Interpretacja
Interakcja to tu „różnica różnic”: 10 − 2 = 8 pkt (efekt interakcji). Jak opisywać interakcję krzyżową i porządkującą, pokazuje wpis interakcja w ANOVA – jak ją opisać.
Typowy błąd
Pisanie „symulacja jest lepsza od wykładu” na podstawie efektu głównego (33 vs 39 pkt), gdy interakcja jest istotna – średnia brzegowa miesza duży efekt u studentów z prawie żadnym u doświadczonych.
Zadanie 7. Eta kwadrat, cząstkowe eta kwadrat i omega kwadrat
Treść zadania
Dla trzech efektów z zadania 6 (SSogółem = 352, SSwewn = 44, MSwewn = 3.667, N = 16) oblicz η², cząstkowe η² i ω². Policz też ω² dla zadania 1. Dlaczego te miary dają różne liczby?
Rozwiązanie krok po kroku
Krok 1. Wzory.
ω² = (SSefekt − dfefekt × MSwewn) / (SSogółem + MSwewn)
Krok 2. Wyniki. Na przykład dla interakcji: η² = 64 / 352 = .182, η²p = 64 / (64 + 44) = .593, ω² = (64 − 3.667) / (352 + 3.667) = .170.
| Efekt | SS | η² | η²p | ω² | cząstkowe ω² |
|---|---|---|---|---|---|
| doświadczenie | 100 | .284 | .694 | .271 | .622 |
| forma | 144 | .409 | .766 | .395 | .705 |
| interakcja | 64 | .182 | .593 | .170 | .507 |
| Suma | 308 | .875 | 2.053 |
Krok 3. Zadanie 1. η² = .495, a ω² = (47.11 − 2 × 3.20) / (95.11 + 3.20) = .414.
Interpretacja
η² mówi, jaką część całej zmienności wyjaśnia efekt – w jednym modelu te części sumują się do R² (.875). Cząstkowe η² usuwa z mianownika pozostałe efekty, więc jest większe, a suma może przekroczyć 1 (tu 2.053). Olejnik i Algina (2003) pokazują, że cząstkowe miary zależą od schematu badania, co utrudnia porównania między badaniami. ω² koryguje obciążenie η² w górę (Lakens, 2013); przy 18 osobach w zadaniu 1 różnica wynosi aż .08. Zob. omega kwadrat.
Typowy błąd
Podawanie „η²”, gdy program (np. SPSS) wypisał cząstkowe η². W ANOVA jednoczynnikowej obie miary są równe, przy dwóch czynnikach – nie.
Zadanie 8. ANOVA z powtarzanymi pomiarami
Treść zadania
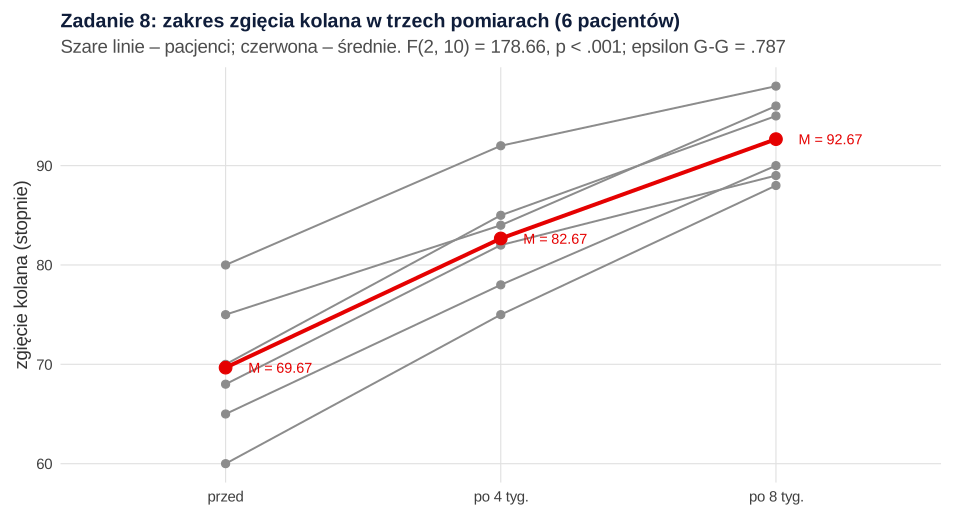
Fizjoterapeuta zmierzył zakres zgięcia kolana (stopnie) u 6 pacjentów po endoprotezie: przed rehabilitacją, po 4 i po 8 tygodniach. P1: 70, 85, 95; P2: 65, 78, 90; P3: 80, 92, 98; P4: 60, 75, 88; P5: 75, 84, 96; P6: 68, 82, 89. Czy zakres ruchu zmienia się w czasie? Oceń założenie sferyczności.
Rozwiązanie krok po kroku
Krok 1. Średnie. Pomiary: 69.67, 82.67 i 92.67; średnia ogólna 81.67. Średnie pacjentów: od 74.33 (P4) do 90.00 (P3).
Krok 2. Podział zmienności. W schemacie wewnątrzobiektowym z SSogółem = 2112.00 wydzielasz różnice między osobami:
SSosoby = 3 × Σ(Mosoby − 81.67)² = 471.33; SSbłąd = 2112.00 − 1596.00 − 471.33 = 44.67
Krok 3. Test F. dfczas = 2, dfbłąd = (3 − 1)(6 − 1) = 10.
Krok 4. Sferyczność. Założenie sferyczności wymaga podobnych wariancji różnic między pomiarami: tu 5.20, 13.20 i 8.40. Test Mauchly’ego: W = .729, p = .532. ε Greenhouse’a–Geissera = .787; po korekcie df = 1.57 i 7.87, p nadal < .001.
Interpretacja
Przy 6 osobach test Mauchly’ego ma bardzo małą moc, dlatego wielu autorów od razu raportuje korektę Greenhouse’a–Geissera. Dłuższy przykład z porównaniami par: ANOVA z powtarzanymi pomiarami krok po kroku.
Typowy błąd
Policzenie ANOVA dla grup niezależnych, jakby w każdym pomiarze byli inni pacjenci. Różnice między osobami (471.33) trafiają wtedy do błędu: F(2, 15) spada z 178.66 do 23.20.
Zadanie 9. Kontrast planowany
Treść zadania
Przed badaniem z zadania 2 postawiono dwie hipotezy: (H1) każde szkolenie daje więcej umów niż brak szkolenia; (H2) szkolenia stacjonarne (warsztat, warsztat z coachingiem) dają więcej niż e-learning. Średnie: 22, 24, 27, 29; MSW = 5.00; n = 8; df = 28. Przetestuj obie hipotezy kontrastami.
Rozwiązanie krok po kroku
Krok 1. Wagi. Wagi kontrastu sumują się do zera. H1: (3, −1, −1, −1) – grupa kontrolna przeciw średniej trzech szkoleń. H2: (0, −2, 1, 1). Iloczyn wag obu kontrastów sumuje się do zera (0 + 2 − 1 − 1), więc są ortogonalne.
Krok 2. Wartość i błąd kontrastu.
H2: L = −2 × 24 + 27 + 29 = 8.00; SE = √(5 × 6 / 8) = 1.936; t(28) = 4.13, p < .001
Krok 3. Kontrola. SS kontrastu = L² / (Σc²/n): 130.67 i 85.33. Z trzecim kontrastem ortogonalnym (0, 0, −1, 1 – warsztat vs warsztat z coachingiem: SS = 16.00, t(28) = 1.79, p = .084) sumują się do SSB = 232.00.
Interpretacja
W zadaniu 3 Tukey nie potwierdził różnic e-learning – kontrolna ani warsztat – e-learning, bo rozkładał ryzyko błędu na 6 par. Pytanie postawione przed zebraniem danych ma większą moc. Więcej o wagach i trendach: kontrasty planowane i analiza trendu.
Typowy błąd
Wymyślanie kontrastu po obejrzeniu średnich i testowanie go jak planowanego. Taki kontrast jest porównaniem post hoc i wymaga korekty (np. Scheffégo).
Zadanie 10. ANOVA a test t przy dwóch grupach
Treść zadania
Nauczycielka policzyła błędy w dyktandzie w dwóch klasach po 6 uczniów. Klasa A: 4, 6, 3, 5, 7, 5. Klasa B: 7, 9, 6, 8, 10, 6. Wykonaj test t dla prób niezależnych i ANOVA. Co łączy oba wyniki?
Rozwiązanie krok po kroku
Krok 1. Test t. Średnie 5.00 i 7.67, SD 1.41 i 1.63. Wariancje: 2.000 i 2.667, więc wariancja łączna sp² = (5 × 2.000 + 5 × 2.667) / 10 = 2.333.
Krok 2. ANOVA. F(1, 10) = 9.143, p = .013, a MSW = 2.333 – to ta sama wariancja łączna.
Krok 3. Związek. t² = 3.024² = 9.143 = F, a p jest identyczne. To samo dotyczy wersji Welcha: kwadrat t Welcha równa się F z oneway.test() (9.143, df = 9.80).
Interpretacja
Przy dwóch grupach wybór między testem t dla prób niezależnych a ANOVA nie zmienia wniosku; test t pozwala jednak na hipotezę jednostronną (tu p = .006), a F jest zawsze „dwustronne”. Oba wyniki z samych średnich i SD policzysz w kalkulatorze testu t i ANOVA.
Typowy błąd
Dzielenie p z ANOVA przez 2 „dla hipotezy jednostronnej” bez sprawdzenia kierunku różnicy – F nie ma znaku i nie pokazuje, która grupa ma wyższą średnią.
Ściąga wzorów do zadań z ANOVA
| Wielkość | Wzór | Szybka kontrola |
|---|---|---|
| SST, SSB | Σx² − T²/N; Σ(Tj²/nj) − T²/N | SSB + SSW = SST |
| Stopnie swobody | k − 1; N − k; N − 1 | sumują się; MS nie |
| Tukey HSD | q(k, dfwewn) × √(MSW/n) | liczba par = k(k − 1)/2 |
| Levene | ANOVA na |x − Mj| (lub |x − Mej|) | bada rozrzuty, nie średnie |
| Interakcja 2 × 2 | SSkomórek − SSA − SSB | linie wykresu nierównoległe |
| Pomiary powtarzane | SSbłąd = SSogółem − SSczas − SSosoby | dfbłąd = (k − 1)(n − 1) |
| Kontrast | t = ΣcjMj / √(MSWΣcj²/n) | Σcj = 0 |
| η², ω² | SSefekt/SSogółem; (SSefekt − df × MSW)/(SSogółem + MSW) | ω² < η² |
Gdy ANOVA nie pasuje do danych (silnie skośne wyniki w małych grupach), alternatywą jest test Kruskala–Wallisa.
Inne zbiory zadań ze statystyki
Ten wpis należy do serii zbiorów zadań z rozwiązaniami – wszystkie zebraliśmy na stronie zadania ze statystyki z rozwiązaniami. Najbliżej ANOVA są: estymacja i testowanie hipotez, testy nieparametryczne (Kruskal–Wallis i Friedman), korelacja i regresja (test F w regresji) oraz moc testu i liczebność próby. Gdy przyjdzie czas na ANOVA we własnej pracy dyplomowej, możesz skorzystać z konsultacji analizy statystycznej dla studentów.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone dwa razy: najpierw wzorem, tak jak na kartce, potem gotową funkcją R jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–5: ANOVA z sum, tabela ANOVA, Tukey HSD, test Levene’a i ANOVA Welcha
R
# B387 – zadania 1–5: ANOVA jednoczynnikowa przy nierównych liczebnościach (sumy kwadratów z sum),
# uzupełnianie tabeli ANOVA, test Tukeya HSD ręcznie, test Levene’a i ANOVA Welcha
# Dane wpisane na sztywno – te same co w treści zadań. Funkcje bazowego R (stats) i car::leveneTest.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))   # bez zera przed kropką
pp <- function(p) if (p < .001) "< .001" else paste("=", bz(p))                            # zapis p jak w APA

# Zadanie 1. Test wiedzy o cukrzycy (0–20 pkt) po trzech formach edukacji pacjentów (n = 5, 7, 6)
ulotka   <- c(9, 11, 8, 12, 10)
rozmowa  <- c(14, 12, 15, 13, 16, 11, 17)
zajecia  <- c(12, 13, 11, 14, 12, 10)
z1 <- list(ulotka = ulotka, rozmowa = rozmowa, zajecia = zajecia)
n_j <- sapply(z1, length); T_j <- sapply(z1, sum); M_j <- sapply(z1, mean); Q_j <- sapply(z1, function(x) sum(x^2))
N1 <- sum(n_j); T1 <- sum(T_j); k1 <- length(z1)
cat("Zadanie 1\n")
print(data.frame(grupa = names(z1), n = n_j, suma = T_j, srednia = round(M_j, 2), suma_kwadratow = Q_j), row.names = FALSE)
cat("N =", N1, "; suma ogólna T =", T1, "; średnia ogólna =", z2(T1 / N1), "; suma x^2 =", sum(Q_j), "\n")
SST1 <- sum(Q_j) - T1^2 / N1
SSB1 <- sum(T_j^2 / n_j) - T1^2 / N1
SSW1 <- SST1 - SSB1
cat("SST = suma x^2 - T^2 / N =", sum(Q_j), "-", T1, "^2 /", N1, "=", z2(SST1), "\n")
cat("SSB = suma(T_j^2 / n_j) - T^2 / N =", z2(sum(T_j^2 / n_j)), "-", z2(T1^2 / N1), "=", z2(SSB1), "\n")
cat("SSB ze średnich = suma n_j (M_j - M)^2 =", z2(sum(n_j * (M_j - T1 / N1)^2)), "\n")
cat("SSW = SST - SSB =", z2(SSW1), "; kontrola suma (n_j - 1) s_j^2 =", z2(sum((n_j - 1) * sapply(z1, var))), "\n")
F1 <- (SSB1 / (k1 - 1)) / (SSW1 / (N1 - k1))
cat("MSB =", z2(SSB1 / (k1 - 1)), "; MSW =", z2(SSW1 / (N1 - k1)), "; F(", k1 - 1, ",", N1 - k1, ") =", z2(F1),
    "; F krytyczne =", z2(qf(0.95, k1 - 1, N1 - k1)), "; p", pp(pf(F1, k1 - 1, N1 - k1, lower.tail = FALSE)), "\n")
cat("eta^2 = SSB / SST =", bz(SSB1 / SST1, 2), "\n")
d1 <- data.frame(wynik = unlist(z1), grupa = factor(rep(names(z1), n_j), levels = names(z1)))
print(summary(aov(wynik ~ grupa, data = d1)))
cat("Błąd: średnia ogólna jako średnia średnich =", z2(mean(M_j)), "; SSB liczone z nią =",
    z2(sum(n_j * (M_j - mean(M_j))^2)), "\n\n")

# Zadanie 2. Cztery warianty szkolenia sprzedawców, po 8 osób; wynik = liczba umów w miesiącu po szkoleniu
umowy <- list(kontrolna = c(20, 24, 22, 18, 25, 21, 23, 23),
              elearning = c(23, 26, 24, 21, 27, 25, 22, 24),
              warsztat  = c(27, 25, 29, 24, 28, 26, 30, 27),
              coaching  = c(28, 33, 27, 30, 25, 32, 29, 28))
d2 <- data.frame(umowy = unlist(umowy), grupa = factor(rep(names(umowy), each = 8), levels = names(umowy)))
a2 <- anova(lm(umowy ~ grupa, data = d2))
cat("Zadanie 2\n")
cat("Średnie grup:", z2(sapply(umowy, mean)), "; SD:", z2(sapply(umowy, sd)), "\n")
SSB2 <- a2$`Sum Sq`[1]; SSW2 <- a2$`Sum Sq`[2]; SST2 <- SSB2 + SSW2
k2 <- 4; N2 <- 32
cat("Podane w treści: SSB =", z2(SSB2), "; SST =", z2(SST2), "; MSW =", z2(SSW2 / (N2 - k2)), "\n")
cat("df między = k - 1 =", k2 - 1, "; df wewnątrz = N - k =", N2 - k2, "; df ogółem = N - 1 =", N2 - 1, "\n")
cat("SSW = SST - SSB =", z2(SST2 - SSB2), "; MSB = SSB / 3 =", z2(SSB2 / 3), "; F = MSB / MSW =", z2((SSB2 / 3) / (SSW2 / 28)), "\n")
cat("F krytyczne(3, 28) =", z2(qf(0.95, 3, 28)), "; p", pp(pf((SSB2 / 3) / (SSW2 / 28), 3, 28, lower.tail = FALSE)),
    "; eta^2 =", bz(SSB2 / SST2, 2), "\n")
print(a2)
cat("\n")

# Zadanie 3. Test Tukeya HSD ręcznie dla danych z zadania 2
MSW2 <- SSW2 / 28
q <- qtukey(0.95, nmeans = 4, df = 28)
HSD <- q * sqrt(MSW2 / 8)
cat("Zadanie 3\n")
cat("q(0.95; 4, 28) =", z3(q), "; HSD = q * sqrt(MSW / n) =", z3(q), "* sqrt(", z3(MSW2), "/ 8 ) =", z2(HSD), "\n")
M2 <- sapply(umowy, mean)
pary <- combn(names(M2), 2)
tab3 <- data.frame(para = paste(pary[2, ], "-", pary[1, ]), roznica = M2[pary[2, ]] - M2[pary[1, ]])
tab3$istotna <- ifelse(abs(tab3$roznica) > HSD, "tak", "nie")
print(tab3, row.names = FALSE)
tk <- TukeyHSD(aov(umowy ~ grupa, data = d2))$grupa
print(data.frame(round(tk[, 1:3], 3), p_skor = sapply(tk[, 4], function(p) paste("p", pp(p)))))
cat("\n")

# Zadanie 4. Test Levene’a: czas rozwiązania łamigłówki (s) w trzech grupach wiekowych (n = 8, 7, 5)
mlodzi  <- c(30, 32, 29, 31, 33, 30, 28, 31)
srednie <- c(34, 30, 38, 33, 36, 31, 37)
starsi  <- c(45, 28, 52, 33, 40)
z4 <- list(mlodzi = mlodzi, srednie = srednie, starsi = starsi)
d4 <- data.frame(czas = unlist(z4), grupa = factor(rep(names(z4), sapply(z4, length)), levels = names(z4)))
cat("Zadanie 4\n")
cat("n:", sapply(z4, length), "; średnie:", z2(sapply(z4, mean)), "; SD:", z2(sapply(z4, sd)), "; wariancje:", z2(sapply(z4, var)), "\n")
d4$odch <- abs(d4$czas - ave(d4$czas, d4$grupa))           # |x - średnia grupy| (klasyczny test Levene’a)
d4$odch_med <- abs(d4$czas - ave(d4$czas, d4$grupa, FUN = median))   # |x - mediana grupy| (Brown i Forsythe, 1974)
for (g in names(z4)) cat("|x - M|", g, ":", z2(d4$odch[d4$grupa == g]), "\n")
cat("Średnie odchylenia bezwzględne od średniej:", z2(tapply(d4$odch, d4$grupa, mean)), "\n")
lev <- anova(lm(odch ~ grupa, data = d4))
cat("Levene (wokół średniej) = ANOVA na |x - M_j|: F(", lev$Df[1], ",", lev$Df[2], ") =", z2(lev$`F value`[1]),
    "; p", pp(lev$`Pr(>F)`[1]), "\n")
print(car::leveneTest(czas ~ grupa, data = d4, center = mean))
bf <- anova(lm(odch_med ~ grupa, data = d4))
cat("Brown–Forsythe (wokół mediany): F =", z2(bf$`F value`[1]), "; p", pp(bf$`Pr(>F)`[1]), "\n")
print(car::leveneTest(czas ~ grupa, data = d4))   # domyślnie center = median
cat("Stosunek największej do najmniejszej wariancji =", z2(max(sapply(z4, var)) / min(sapply(z4, var))), "\n\n")

# Zadanie 5. ANOVA Welcha dla danych z zadania 4 – wzór i oneway.test()
n5 <- sapply(z4, length); M5 <- sapply(z4, mean); s2 <- sapply(z4, var); k5 <- 3
w <- n5 / s2; Mw <- sum(w * M5) / sum(w)
A <- sum(w * (M5 - Mw)^2) / (k5 - 1)
lam <- sum((1 - w / sum(w))^2 / (n5 - 1))
FW <- A / (1 + 2 * (k5 - 2) / (k5^2 - 1) * lam)
df2W <- (k5^2 - 1) / (3 * lam)
cat("Zadanie 5\n")
cat("wagi w_j = n_j / s_j^2:", z3(w), "; ważona średnia =", z2(Mw), "\n")
cat("licznik = suma w_j (M_j - Mw)^2 / (k - 1) =", z3(A), "; suma (1 - w_j/W)^2 / (n_j - 1) =", z3(lam), "\n")
cat("mianownik = 1 + 2 (k - 2) / (k^2 - 1) * lambda =", z3(1 + 2 * (k5 - 2) / (k5^2 - 1) * lam), "\n")
cat("F Welcha =", z2(FW), "; df1 =", k5 - 1, "; df2 = (k^2 - 1) / (3 * lambda) =", z2(df2W),
    "; p", pp(pf(FW, k5 - 1, df2W, lower.tail = FALSE)), "\n")
print(oneway.test(czas ~ grupa, data = d4))                    # var.equal = FALSE (Welch) – domyślnie
klas <- oneway.test(czas ~ grupa, data = d4, var.equal = TRUE)
cat("Klasyczne F (równe wariancje): F(", klas$parameter[1], ",", klas$parameter[2], ") =", z2(klas$statistic),
    "; p", pp(klas$p.value), "\n")
Wynik w R
Zadanie 1
   grupa n suma srednia suma_kwadratow
  ulotka 5   50      10            510
 rozmowa 7   98      14           1400
 zajecia 6   72      12            874
N = 18 ; suma ogólna T = 220 ; średnia ogólna = 12.22 ; suma x^2 = 2784
SST = suma x^2 - T^2 / N = 2784 - 220 ^2 / 18 = 95.11
SSB = suma(T_j^2 / n_j) - T^2 / N = 2736.00 - 2688.89 = 47.11
SSB ze średnich = suma n_j (M_j - M)^2 = 47.11
SSW = SST - SSB = 48.00 ; kontrola suma (n_j - 1) s_j^2 = 48.00
MSB = 23.56 ; MSW = 3.20 ; F( 2 , 15 ) = 7.36 ; F krytyczne = 3.68 ; p = .006
eta^2 = SSB / SST = .50
            Df Sum Sq Mean Sq F value  Pr(>F)
grupa        2  47.11   23.56   7.361 0.00592 **
Residuals   15  48.00    3.20
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Błąd: średnia ogólna jako średnia średnich = 12.00 ; SSB liczone z nią = 48.00

Zadanie 2
Średnie grup: 22.00 24.00 27.00 29.00 ; SD: 2.27 2.00 2.00 2.62
Podane w treści: SSB = 232.00 ; SST = 372.00 ; MSW = 5.00
df między = k - 1 = 3 ; df wewnątrz = N - k = 28 ; df ogółem = N - 1 = 31
SSW = SST - SSB = 140.00 ; MSB = SSB / 3 = 77.33 ; F = MSB / MSW = 15.47
F krytyczne(3, 28) = 2.95 ; p < .001 ; eta^2 = .62
Analysis of Variance Table

Response: umowy
          Df Sum Sq Mean Sq F value    Pr(>F)
grupa      3    232  77.333  15.467 3.991e-06 ***
Residuals 28    140   5.000
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Zadanie 3
q(0.95; 4, 28) = 3.861 ; HSD = q * sqrt(MSW / n) = 3.861 * sqrt( 5.000 / 8 ) = 3.05
                  para roznica istotna
 elearning - kontrolna       2     nie
  warsztat - kontrolna       5     tak
  coaching - kontrolna       7     tak
  warsztat - elearning       3     nie
  coaching - elearning       5     tak
   coaching - warsztat       2     nie
                    diff    lwr    upr   p_skor
elearning-kontrolna    2 -1.053  5.053 p = .300
warsztat-kontrolna     5  1.947  8.053 p < .001
coaching-kontrolna     7  3.947 10.053 p < .001
warsztat-elearning     3 -0.053  6.053 p = .055
coaching-elearning     5  1.947  8.053 p < .001
coaching-warsztat      2 -1.053  5.053 p = .300

Zadanie 4
n: 8 7 5 ; średnie: 30.50 34.14 39.60 ; SD: 1.60 3.02 9.50 ; wariancje: 2.57 9.14 90.30
|x - M| mlodzi : 0.50 1.50 1.50 0.50 2.50 0.50 2.50 0.50
|x - M| srednie : 0.14 4.14 3.86 1.14 1.86 3.14 2.86
|x - M| starsi : 5.40 11.60 12.40 6.60 0.40
Średnie odchylenia bezwzględne od średniej: 1.25 2.45 7.28
Levene (wokół średniej) = ANOVA na |x - M_j|: F( 2 , 17 ) = 8.72 ; p = .002
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value   Pr(>F)
group  2  8.7231 0.002472 **
      17
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Brown–Forsythe (wokół mediany): F = 7.98 ; p = .004
Levene's Test for Homogeneity of Variance (center = median)
      Df F value   Pr(>F)
group  2   7.979 0.003599 **
      17
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Stosunek największej do najmniejszej wariancji = 35.12

Zadanie 5
wagi w_j = n_j / s_j^2: 3.111 0.766 0.055 ; ważona średnia = 31.34
licznik = suma w_j (M_j - Mw)^2 / (k - 1) = 5.994 ; suma (1 - w_j/W)^2 / (n_j - 1) = 0.357
mianownik = 1 + 2 (k - 2) / (k^2 - 1) * lambda = 1.089
F Welcha = 5.50 ; df1 = 2 ; df2 = (k^2 - 1) / (3 * lambda) = 7.46 ; p = .034

	One-way analysis of means (not assuming equal variances)

data:  czas and grupa
F = 5.5024, num df = 2.000, denom df = 7.463, p-value = 0.03401

Klasyczne F (równe wariancje): F( 2 , 17 ) = 4.99 ; p = .020
Zadania 6–10: ANOVA 2 × 2, miary efektu, pomiary powtarzane, kontrasty i F = t²
R
# B387 – zadania 6–10: ANOVA dwuczynnikowa 2 × 2 z interakcją i efektami prostymi, eta² / cząstkowe eta² / omega²,
# ANOVA z powtarzanymi pomiarami (sferyczność), kontrast planowany, ANOVA a test t (F = t²)
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))
pp <- function(p) if (p < .001) "< .001" else paste("=", bz(p))

# Zadanie 6. Egzamin praktyczny (0–50 pkt): forma szkolenia (wykład / symulacja) × doświadczenie (studenci / pielęgniarki), n = 4
d6 <- data.frame(
  dosw  = factor(rep(c("studenci", "pielegniarki"), each = 8), levels = c("studenci", "pielegniarki")),
  forma = factor(rep(rep(c("wyklad", "symulacja"), each = 4), 2), levels = c("wyklad", "symulacja")),
  wynik = c(27, 31, 26, 30,  37, 41, 38, 38,   36, 40, 37, 37,  38, 42, 39, 39))
n6 <- 4
M_kom <- tapply(d6$wynik, list(d6$dosw, d6$forma), mean)
M_A <- rowMeans(M_kom); M_B <- colMeans(M_kom); M <- mean(d6$wynik)
cat("Zadanie 6\nŚrednie w komórkach:\n"); print(M_kom)
cat("Średnie brzegowe – doświadczenie:", z2(M_A), "; forma:", z2(M_B), "; ogólna =", z2(M), "\n")
SS_A  <- 2 * n6 * sum((M_A - M)^2)
SS_B  <- 2 * n6 * sum((M_B - M)^2)
SS_kom <- n6 * sum((M_kom - M)^2)
SS_AB <- SS_kom - SS_A - SS_B
SS_W  <- sum((d6$wynik - ave(d6$wynik, d6$dosw, d6$forma))^2)
SS_T  <- sum((d6$wynik - M)^2)
df_W <- 16 - 4; MS_W <- SS_W / df_W
cat("SS_dosw =", z2(SS_A), "; SS_forma =", z2(SS_B), "; SS_komorek =", z2(SS_kom), "; SS_interakcja =", z2(SS_AB), "\n")
cat("SS_wewn =", z2(SS_W), "; SS_ogółem =", z2(SS_T), "; MS_wewn =", z3(MS_W), "\n")
for (ef in c("dosw", "forma", "interakcja")) {
  ss <- c(dosw = SS_A, forma = SS_B, interakcja = SS_AB)[[ef]]
  cat("F(1, 12)", ef, "=", z2(ss / MS_W), "; p", pp(pf(ss / MS_W, 1, df_W, lower.tail = FALSE)), "\n")
}
cat("Kontrast interakcji (różnica różnic) =", z2((M_kom[1, 2] - M_kom[1, 1]) - (M_kom[2, 2] - M_kom[2, 1])), "\n")
print(anova(lm(wynik ~ dosw * forma, data = d6)))
# Efekty proste: efekt formy osobno u studentów i u pielęgniarek (wspólny MS_wewn, df = 12)
for (g in levels(d6$dosw)) {
  ss <- n6 * sum((M_kom[g, ] - mean(M_kom[g, ]))^2)
  cat("Efekt prosty formy –", g, ": różnica =", z2(M_kom[g, 2] - M_kom[g, 1]), "; SS =", z2(ss), "; F(1, 12) =", z2(ss / MS_W),
      "; p", pp(pf(ss / MS_W, 1, df_W, lower.tail = FALSE)), "\n")
}
print(anova(lm(wynik ~ dosw / forma, data = d6)))   # kontrola: forma zagnieżdżona w doświadczeniu = dwa efekty proste
cat("\n")

# Zadanie 7. eta², cząstkowe eta² i omega² dla zadania 6 oraz omega² dla zadania 1
cat("Zadanie 7\n")
ss_ef <- c(dosw = SS_A, forma = SS_B, interakcja = SS_AB)
tab7 <- data.frame(efekt = names(ss_ef), SS = round(ss_ef, 2),
                   eta2 = round(ss_ef / SS_T, 3),
                   eta2_czastkowe = round(ss_ef / (ss_ef + SS_W), 3),
                   omega2 = round((ss_ef - 1 * MS_W) / (SS_T + MS_W), 3),
                   omega2_czastkowe = round((ss_ef - 1 * MS_W) / (ss_ef + (16 - 1) * MS_W), 3))
print(tab7, row.names = FALSE)
cat("Suma eta^2 =", z3(sum(ss_ef / SS_T)), "; suma cząstkowych eta^2 =", z3(sum(ss_ef / (ss_ef + SS_W))), "\n")
# zadanie 1: te same dane co w pierwszym przepisie (k = 3, N = 18)
w1 <- c(9, 11, 8, 12, 10,  14, 12, 15, 13, 16, 11, 17,  12, 13, 11, 14, 12, 10)
g1 <- factor(rep(c("ulotka", "rozmowa", "zajecia"), c(5, 7, 6)))
a1 <- anova(lm(w1 ~ g1)); SSB1 <- a1$`Sum Sq`[1]; SST1 <- sum(a1$`Sum Sq`); MSW1 <- a1$`Mean Sq`[2]
cat("Zadanie 1: SSB =", z2(SSB1), "; SST =", z2(SST1), "; MSW =", z2(MSW1), "\n")
cat("Zadanie 1: eta^2 =", bz(SSB1 / SST1), "; omega^2 = (SSB - (k - 1) MSW) / (SST + MSW) =", bz((SSB1 - 2 * MSW1) / (SST1 + MSW1)), "\n\n")

# Zadanie 8. Zakres zgięcia kolana (stopnie) u 6 pacjentów: przed, po 4 i po 8 tygodniach rehabilitacji
rom <- matrix(c(70, 85, 95,
                65, 78, 90,
                80, 92, 98,
                60, 75, 88,
                75, 84, 96,
                68, 82, 89), ncol = 3, byrow = TRUE, dimnames = list(paste0("P", 1:6), c("przed", "t4", "t8")))
n8 <- nrow(rom); k8 <- ncol(rom); M8 <- mean(rom)
cat("Zadanie 8\n")
cat("Średnie pomiarów:", z2(colMeans(rom)), "; średnie osób:", z2(rowMeans(rom)), "; średnia ogólna =", z2(M8), "\n")
SS_czas <- n8 * sum((colMeans(rom) - M8)^2)
SS_osob <- k8 * sum((rowMeans(rom) - M8)^2)
SS_tot  <- sum((rom - M8)^2)
SS_bl   <- SS_tot - SS_czas - SS_osob
df_c <- k8 - 1; df_b <- (k8 - 1) * (n8 - 1)
F8 <- (SS_czas / df_c) / (SS_bl / df_b)
cat("SS_ogółem =", z2(SS_tot), "; SS_czas =", z2(SS_czas), "; SS_osoby =", z2(SS_osob), "; SS_błąd =", z2(SS_bl), "\n")
cat("MS_czas =", z2(SS_czas / df_c), "; MS_błąd =", z3(SS_bl / df_b), "; F(", df_c, ",", df_b, ") =", z2(F8),
    "; p", pp(pf(F8, df_c, df_b, lower.tail = FALSE)), "\n")
cat("Cząstkowe eta^2 = SS_czas / (SS_czas + SS_błąd) =", bz(SS_czas / (SS_czas + SS_bl)), "\n")
dl8 <- data.frame(id = factor(rep(rownames(rom), k8)), czas = factor(rep(colnames(rom), each = n8), levels = colnames(rom)),
                  rom = as.vector(rom))
print(summary(aov(rom ~ czas + Error(id / czas), data = dl8)))
# Błąd: ANOVA dla grup niezależnych na tych samych danych (SS osób trafia do błędu)
print(summary(aov(rom ~ czas, data = dl8)))
# Sferyczność: wariancje różnic, test Mauchly’ego i poprawka Greenhouse’a–Geissera
roz <- cbind(`t4-przed` = rom[, 2] - rom[, 1], `t8-przed` = rom[, 3] - rom[, 1], `t8-t4` = rom[, 3] - rom[, 2])
cat("Wariancje różnic:", z2(apply(roz, 2, var)), "\n")
fit8 <- lm(rom ~ 1)
print(mauchly.test(fit8, X = ~1))
Cmat <- contr.poly(k8)                                   # kontrasty ortonormalne
S <- t(Cmat) %*% cov(rom) %*% Cmat
eps <- sum(diag(S))^2 / ((k8 - 1) * sum(diag(S %*% S)))
cat("epsilon G-G =", z3(eps), "; df po poprawce:", z2(eps * df_c), ",", z2(eps * df_b),
    "; p", pp(pf(F8, eps * df_c, eps * df_b, lower.tail = FALSE)), "\n")
print(anova(fit8, X = ~1, test = "Spherical"))
cat("\n")

# Zadanie 9. Kontrast planowany dla danych z zadania 2 (kontrolna vs trzy szkolenia; e-learning vs dwa stacjonarne)
umowy <- list(kontrolna = c(20, 24, 22, 18, 25, 21, 23, 23),
              elearning = c(23, 26, 24, 21, 27, 25, 22, 24),
              warsztat  = c(27, 25, 29, 24, 28, 26, 30, 27),
              coaching  = c(28, 33, 27, 30, 25, 32, 29, 28))
d9 <- data.frame(umowy = unlist(umowy), grupa = factor(rep(names(umowy), each = 8), levels = names(umowy)))
M9 <- sapply(umowy, mean); MSW9 <- 5; n9 <- 8; df9 <- 28
cat("Zadanie 9\n")
for (c9 in list(c(3, -1, -1, -1), c(0, -2, 1, 1), c(0, 0, -1, 1))) {
  L <- sum(c9 * M9); se <- sqrt(MSW9 * sum(c9^2) / n9); t9 <- L / se
  cat("wagi", paste(c9, collapse = ", "), ": L =", z2(L), "; SE = sqrt(MSW * suma c^2 / n) =", z3(se), "; t(28) =", z2(t9),
      "; p", pp(2 * pt(-abs(t9), df9)), "; F = t^2 =", z2(t9^2), "; SS_kontrastu =", z2(L^2 / (sum(c9^2) / n9)), "\n")
}
contrasts(d9$grupa) <- cbind(k_vs_szkolenia = c(3, -1, -1, -1), e_vs_stacjonarne = c(0, -2, 1, 1), warsztat_vs_coaching = c(0, 0, -1, 1))
print(round(summary(lm(umowy ~ grupa, data = d9))$coefficients, 4))
cat("Kontrola: SS kontrastów ortogonalnych sumują się do SSB:",
    z2(sum(sapply(list(c(3, -1, -1, -1), c(0, -2, 1, 1), c(0, 0, -1, 1)), function(c9) sum(c9 * M9)^2 / (sum(c9^2) / n9)))), "\n\n")

# Zadanie 10. Dwie grupy: liczba błędów w dyktandzie w dwóch klasach (po 6 uczniów) – ANOVA a test t
klasaA <- c(4, 6, 3, 5, 7, 5)
klasaB <- c(7, 9, 6, 8, 10, 6)
d10 <- data.frame(bledy = c(klasaA, klasaB), klasa = factor(rep(c("A", "B"), each = 6)))
cat("Zadanie 10\n")
cat("Średnie:", z2(tapply(d10$bledy, d10$klasa, mean)), "; SD:", z2(tapply(d10$bledy, d10$klasa, sd)),
    "; wariancje:", z3(tapply(d10$bledy, d10$klasa, var)), "\n")
sp2 <- (5 * var(klasaA) + 5 * var(klasaB)) / 10
t10 <- (mean(klasaB) - mean(klasaA)) / sqrt(sp2 * (1 / 6 + 1 / 6))
cat("Wariancja łączna =", z3(sp2), "; t(10) =", z3(t10), "; t^2 =", z3(t10^2), "\n")
tt <- t.test(bledy ~ klasa, data = d10, var.equal = TRUE)
a10 <- anova(lm(bledy ~ klasa, data = d10))
cat("t.test: t =", z3(tt$statistic), "; p", pp(tt$p.value), "; p (5 miejsc) =", bz(tt$p.value, 5), "\n")
cat("ANOVA: F(1, 10) =", z3(a10$`F value`[1]), "; p", pp(a10$`Pr(>F)`[1]), "; p (5 miejsc) =", bz(a10$`Pr(>F)`[1], 5),
    "; MSW =", z3(a10$`Mean Sq`[2]), "(= wariancja łączna)\n")
tw <- t.test(bledy ~ klasa, data = d10)
ow <- oneway.test(bledy ~ klasa, data = d10)
cat("Welch: t^2 =", z3(tw$statistic^2), "; F Welcha =", z3(ow$statistic), "; df =", z2(tw$parameter), "i", z2(ow$parameter[2]), "\n")
cat("Jednostronny t (B > A): p", pp(t.test(klasaB, klasaA, var.equal = TRUE, alternative = "greater")$p.value), "\n")
Wynik w R
Zadanie 6
Średnie w komórkach:
             wyklad symulacja
studenci       28.5      38.5
pielegniarki   37.5      39.5
Średnie brzegowe – doświadczenie: 33.50 38.50 ; forma: 33.00 39.00 ; ogólna = 36.00
SS_dosw = 100.00 ; SS_forma = 144.00 ; SS_komorek = 308.00 ; SS_interakcja = 64.00
SS_wewn = 44.00 ; SS_ogółem = 352.00 ; MS_wewn = 3.667
F(1, 12) dosw = 27.27 ; p < .001
F(1, 12) forma = 39.27 ; p < .001
F(1, 12) interakcja = 17.45 ; p = .001
Kontrast interakcji (różnica różnic) = 8.00
Analysis of Variance Table

Response: wynik
           Df Sum Sq Mean Sq F value    Pr(>F)
dosw        1    100 100.000  27.273 0.0002139 ***
forma       1    144 144.000  39.273 4.149e-05 ***
dosw:forma  1     64  64.000  17.454 0.0012814 **
Residuals  12     44   3.667
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Efekt prosty formy – studenci : różnica = 10.00 ; SS = 200.00 ; F(1, 12) = 54.55 ; p < .001
Efekt prosty formy – pielegniarki : różnica = 2.00 ; SS = 8.00 ; F(1, 12) = 2.18 ; p = .165
Analysis of Variance Table

Response: wynik
           Df Sum Sq Mean Sq F value    Pr(>F)
dosw        1    100 100.000  27.273 0.0002139 ***
dosw:forma  2    208 104.000  28.364 2.833e-05 ***
Residuals  12     44   3.667
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Zadanie 7
      efekt  SS  eta2 eta2_czastkowe omega2 omega2_czastkowe
       dosw 100 0.284          0.694  0.271            0.622
      forma 144 0.409          0.766  0.395            0.705
 interakcja  64 0.182          0.593  0.170            0.507
Suma eta^2 = 0.875 ; suma cząstkowych eta^2 = 2.053
Zadanie 1: SSB = 47.11 ; SST = 95.11 ; MSW = 3.20
Zadanie 1: eta^2 = .495 ; omega^2 = (SSB - (k - 1) MSW) / (SST + MSW) = .414

Zadanie 8
Średnie pomiarów: 69.67 82.67 92.67 ; średnie osób: 83.33 77.67 90.00 74.33 85.00 79.67 ; średnia ogólna = 81.67
SS_ogółem = 2112.00 ; SS_czas = 1596.00 ; SS_osoby = 471.33 ; SS_błąd = 44.67
MS_czas = 798.00 ; MS_błąd = 4.467 ; F( 2 , 10 ) = 178.66 ; p < .001
Cząstkowe eta^2 = SS_czas / (SS_czas + SS_błąd) = .973

Error: id
          Df Sum Sq Mean Sq F value Pr(>F)
Residuals  5  471.3   94.27

Error: id:czas
          Df Sum Sq Mean Sq F value  Pr(>F)
czas       2 1596.0   798.0   178.7 1.5e-08 ***
Residuals 10   44.7     4.5
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Df Sum Sq Mean Sq F value   Pr(>F)
czas         2   1596   798.0    23.2 2.57e-05 ***
Residuals   15    516    34.4
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Wariancje różnic: 5.20 13.20 8.40

	Mauchly's test of sphericity
	Contrasts orthogonal to
	~1


data:  SSD matrix from lm(formula = rom ~ 1)
W = 0.72912, p-value = 0.5316

epsilon G-G = 0.787 ; df po poprawce: 1.57 , 7.87 ; p < .001
Analysis of Variance Table


Contrasts orthogonal to
~1

Greenhouse-Geisser epsilon: 0.7869
Huynh-Feldt epsilon:        1.0860

            Df      F num Df den Df     Pr(>F)     G-G Pr     H-F Pr
(Intercept)  1 178.66      2     10 1.4956e-08 4.3382e-07 1.4956e-08
Residuals    5

Zadanie 9
wagi 3, -1, -1, -1 : L = -14.00 ; SE = sqrt(MSW * suma c^2 / n) = 2.739 ; t(28) = -5.11 ; p < .001 ; F = t^2 = 26.13 ; SS_kontrastu = 130.67
wagi 0, -2, 1, 1 : L = 8.00 ; SE = sqrt(MSW * suma c^2 / n) = 1.936 ; t(28) = 4.13 ; p < .001 ; F = t^2 = 17.07 ; SS_kontrastu = 85.33
wagi 0, 0, -1, 1 : L = 2.00 ; SE = sqrt(MSW * suma c^2 / n) = 1.118 ; t(28) = 1.79 ; p = .084 ; F = t^2 = 3.20 ; SS_kontrastu = 16.00
                          Estimate Std. Error t value Pr(>|t|)
(Intercept)                25.5000     0.3953 64.5105   0.0000
grupak_vs_szkolenia        -1.1667     0.2282 -5.1121   0.0000
grupae_vs_stacjonarne       1.3333     0.3227  4.1312   0.0003
grupawarsztat_vs_coaching   1.0000     0.5590  1.7889   0.0845
Kontrola: SS kontrastów ortogonalnych sumują się do SSB: 232.00

Zadanie 10
Średnie: 5.00 7.67 ; SD: 1.41 1.63 ; wariancje: 2.000 2.667
Wariancja łączna = 2.333 ; t(10) = 3.024 ; t^2 = 9.143
t.test: t = -3.024 ; p = .013 ; p (5 miejsc) = .01281
ANOVA: F(1, 10) = 9.143 ; p = .013 ; p (5 miejsc) = .01281 ; MSW = 2.333 (= wariancja łączna)
Welch: t^2 = 9.143 ; F Welcha = 9.143 ; df = 9.80 i 9.80
Jednostronny t (B > A): p = .006
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz funkcja leveneTest z pakietu car); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jak uzupełnić tabelę ANOVA, gdy brakuje kilku pól?
Zacznij od stopni swobody: k − 1, N − k i N − 1. Potem wykorzystaj to, że sumy kwadratów się sumują (SST = SSB + SSW), a MS = SS / df i F = MSB / MSW. W zadaniu 2 z SSB = 232, SST = 372 i MSW = 5 wychodzi F(3, 28) = 15.47. Średnie kwadraty nigdy się nie sumują.
Czy przy nierównych liczebnościach grup można liczyć ANOVA tak samo jak przy równych?
Tak, ale każdą sumę grupy dziel przez jej własne n: SSB = Σ(Tj²/nj) − T²/N, a średnią ogólną licz z wszystkich wyników, nie jako średnią średnich. Przy nierównych grupach i nierównych wariancjach klasyczne F bywa zbyt liberalne – wtedy wybierz ANOVA Welcha (zadania 4–5).
Który test post hoc wybrać na kolokwium po istotnej ANOVA?
Przy równych wariancjach i porównaniu wszystkich par – test Tukeya HSD (zadanie 3); przy nierównych wariancjach – Gamesa–Howella. Jeśli przed badaniem postawiono jedną lub dwie konkretne hipotezy, lepsze są kontrasty planowane (zadanie 9), bo mają większą moc niż porównanie wszystkich par.
Czym różni się eta kwadrat od cząstkowego eta kwadrat w zadaniach z ANOVA dwuczynnikowej?
η² dzieli sumę kwadratów efektu przez całkowitą sumę kwadratów, więc η² wszystkich efektów sumują się do R² modelu. Cząstkowe η² dzieli ją tylko przez sumę efektu i błędu, dlatego jest większe i może sumować się powyżej 1. W zadaniu 7 dla interakcji η² = .182, a cząstkowe η² = .593.
Po co w ANOVA z powtarzanymi pomiarami liczy się sumę kwadratów osób?
Bo różnice poziomu między osobami są stałe we wszystkich pomiarach i nie są błędem losowym. Po ich odjęciu błąd maleje: w zadaniu 8 SS osób = 471.33, błąd = 44.67 i F(2, 10) = 178.66. Gdyby policzyć ANOVA jak dla grup niezależnych, F spadłoby do 23.20.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikInterakcja w ANOVA – jak ją opisać
Co zrobić po istotnej interakcji: wykres, efekty proste na średnich brzegowych, interakcja porządkująca i krzyżowa oraz gotowy wzór opisu APA.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami krok po kroku
Cztery warunki, te same osoby: sferyczność i poprawka GG, η²G, porównania parami w emmeans, wykres z CI wewnątrzosobowymi, schemat mieszany i opis APA.
Czytaj →Masz własne dane do pracy i nie wiesz, który test wybrać?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3–4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330
Cytowania BibTeX
@article{brown1974robust, author={Brown, Morton B. and Forsythe, Alan B.}, title={{Robust tests for the equality of variances}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={346}, pages={364--367}, doi={10.1080/01621459.1974.10482955}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@book{maxwell2018designing, author={Maxwell, Scott E. and Delaney, Harold D. and Kelley, Ken}, title={{Designing experiments and analyzing data: A model comparison perspective}}, year={2018}, edition={3rd}, publisher={Routledge}, doi={10.4324/9781315642956}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}@article{welch1951comparison, author={Welch, B. L.}, title={{On the comparison of several mean values: An alternative approach}}, journal={Biometrika}, year={1951}, volume={38}, number={3–4}, pages={330--336}, doi={10.1093/biomet/38.3-4.330}}