Moc testu i liczebność próby: zadania z rozwiązaniami – jak z nich korzystać
W zadaniach z mocy testu i liczebności próby nie liczysz statystyki z danych, tylko odpowiadasz na pytania „ile osób zbadać?” i „co wykryje próba, którą mam?”. Poniżej znajdziesz 10 zadań z rozwiązaniami z mocy testu i liczebności próby – od najprostszego wzoru do pułapki z mocą liczoną po badaniu.
Każde zadanie ma treść, rozwiązanie krok po kroku, interpretację i typowy błąd. Liczby policzyliśmy wzorem przybliżonym (jak na kartce) i dokładną funkcją R – kod jest na końcu wpisu. Wzory są standardowe i znajdziesz je w podręcznikach (np. King i Minium, 2009). Różnica w ostatniej cyfrze między wzorem a programem jest normalna: wzory korzystają z rozkładu normalnego, programy – z niecentralnego rozkładu t.
Zbiór uzupełnia zadania z estymacji i testowania hipotez (błąd II rodzaju dla testu z, liczebność z marginesu błędu). Jak uzasadnić liczebność w pracy, opisuje poradnik dobór liczebności próby.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | ćwiczenia oddechowe a lęk przed egzaminem | n na grupę dla testu t: wzór i power.t.test |
| 2 | edukacja pielęgniarska a przestrzeganie zaleceń | n dla dwóch proporcji, h Cohena |
| 3 | eksperyment do licencjatu: 30 osób na grupę | moc przy ustalonym n |
| 4 | dwie szkoły po 42 uczniów | minimalny wykrywalny efekt |
| 5 | badanie z trzema pomiarami | korekta na ubytek i wykluczenia |
| 6 | programy czytania losowane całymi klasami | efekt schematu (DEFF) i liczba klas |
| 7 | jakość snu a wynik egzaminu | n dla korelacji (transformacja Fishera) |
| 8 | 36 osób: dwie grupy czy dwa pomiary? | moc testu dla par a dla grup niezależnych |
| 9 | zadanie 1 przy innym α | wpływ α = .01 i testu jednostronnego |
| 10 | „policz moc po badaniu” | dlaczego moc obserwowana nic nie mówi |
W zadaniach używasz dwóch wartości z rozkładu normalnego: z1−α/2 = 1.960 (α = .05, test dwustronny) i z1−β = 0.842 (moc .80). Inne odczytasz z tablic rozkładu normalnego. Założenia wszystkich zadań są w jednym pliku: moc-testu-i-liczebnosc-proby-zadania-dane.csv (format długi: zadanie, parametr, wartość).
Zadanie 1. Liczebność dla testu t dwóch grup: wzór i power.t.test
Treść zadania
Planujesz eksperyment: jedna grupa studentów przez dwa tygodnie przed sesją wykonuje ćwiczenia oddechowe, druga nie. Wynikiem jest lęk przed egzaminem na skali 0–80. W podobnym badaniu (po 30 osób w grupie) odchylenia standardowe wynosiły 9.6 i 10.4. Za najmniejszą różnicę wartą wykrycia uznajesz 6 punktów. Ile osób potrzebujesz w każdej grupie przy α = .05 (test dwustronny) i mocy .80? Policz (a) wzorem przybliżonym, (b) dokładnie w R.
Rozwiązanie krok po kroku
Krok 1. Wspólne odchylenie standardowe i d. Przy równych grupach to pierwiastek ze średniej wariancji:
To d Cohena dla najmniejszego interesującego efektu (SESOI).
Krok 2. Wzór przybliżony (rozkład normalny):
Na zaokrąglonym d = 0.60 wychodzi 43.60; R liczy na niezaokrąglonym d i podaje 43.67. W obu przypadkach: 44.
Krok 3. Poprawka na rozkład t. Wzór normalny lekko zaniża wynik; poprawka to dodanie z1−α/2² / 4 = 0.96: n = 44.64 → 45.
Krok 4. Dokładnie w R. power.t.test(delta = 6, sd = 10.01, power = 0.80) daje n = 44.66 → 45; pwr.t.test z pakietu pwr – to samo. Sprawdzenie: przy 44 osobach moc wynosi .794, a przy 45 – .803.
Interpretacja
Potrzebujesz 45 osób w każdej grupie, razem 90. To samo policzysz w kalkulatorze liczebności próby albo w programie G*Power, który opisuje hasło analiza mocy a priori. Konwencję mocy .80 i tabele liczebności dla standardowych testów spopularyzował Cohen (1992).
Typowy błąd
Odczytanie 45 jako liczebności całej próby. Funkcje mocy podają n na grupę; 45 osób łącznie (około 22 na grupę) dałoby moc .493.
Zadanie 2. Liczebność dla porównania dwóch proporcji
Treść zadania
Na oddziale około 50% pacjentów po wypisie przestrzega zaleceń dotyczących leków. Pielęgniarki chcą sprawdzić program edukacyjny, po którym odsetek ten ma wzrosnąć do 65%. Ilu pacjentów potrzeba w każdej grupie (α = .05, test dwustronny, moc .80)? Jak zmieni się wynik, jeśli oczekiwane odsetki to 50% i 60% albo 10% i 25%?
Rozwiązanie krok po kroku
Krok 1. Średni odsetek. p̄ = (0.50 + 0.65) / 2 = 0.575.
Krok 2. Wzór dla testu dla dwóch proporcji (pierwszy składnik dotyczy rozkładu przy H0, drugi – przy H1):
= [1.960 × √(2 × 0.575 × 0.425) + 0.842 × √(0.25 + 0.2275)]² / 0.15² = 169.31 → 170
Krok 3. Kontrola w R. power.prop.test korzysta z tego samego wzoru: 169.31 → 170.
Krok 4. Wersja z h Cohena. Pakiet pwr przekształca odsetki funkcją arcus sinus: h Cohena = 2 arcsin√0.65 − 2 arcsin√0.50 = 0.305, a pwr.2p.test(h = 0.305, power = 0.80) daje 169.09 → 170. Obie metody się zgadzają.
Krok 5. Inne odsetki. Dla 50% i 60% potrzeba 388 osób na grupę, a dla 10% i 25% – tylko 100.
Interpretacja
Potrzeba 170 pacjentów w każdej grupie (340 łącznie). Ta sama różnica 15 punktów procentowych wymaga 100 osób na grupę przy odsetkach 10% i 25%, ale 170 przy 50% i 65%.
Typowy błąd
Liczenie liczebności z marginesu błędu jednej proporcji, choć celem jest porównanie grup. Margines dotyczy precyzji odsetka, a nie mocy testu różnicy.
Zadanie 3. Moc przy ustalonej liczebności
Treść zadania
Studentka planuje eksperyment do pracy licencjackiej. Ma dostęp do 60 osób, czyli 30 na grupę. Jaką moc ma dwustronny test t dla prób niezależnych (α = .05), jeśli prawdziwy efekt wynosi d = 0.3, 0.5 albo 0.8? Policz przybliżeniem normalnym i dokładnie.
Rozwiązanie krok po kroku
Krok 1. Przesunięcie rozkładu statystyki. Gdy efekt istnieje, statystyka testu jest przesunięta średnio o δ = d × √(n/2), gdzie n to liczebność jednej grupy. Ta wielkość to parametr niecentralności. Przy n = 30: √15 = 3.873.
Krok 2. Przybliżenie normalne. Moc ≈ Φ(δ − 1.960), czyli pole pod krzywą normalną na prawo od wartości krytycznej:
| d | δ = d × 3.873 | Moc – przybliżenie z | Moc – niecentralny t |
|---|---|---|---|
| 0.3 | 1.162 | .212 | .208 |
| 0.5 | 1.936 | .491 | .478 |
| 0.8 | 3.098 | .873 | .861 |
Krok 3. Wynik dokładny. Dokładnie liczysz z niecentralnego rozkładu t o df = 58 (wartość krytyczna 2.002). power.t.test(n = 30, delta = 0.5, sd = 1) podaje .478 (dla d = 0.3: .207, bo pomija znikomy „zły” ogon).
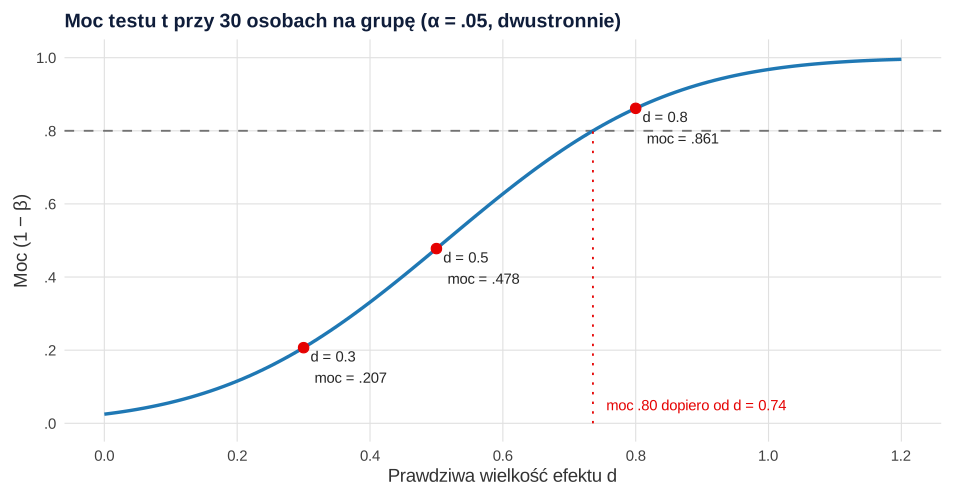
power.t.test).Interpretacja
Efekt średni (d = 0.5) zostanie wykryty mniej więcej w co drugim badaniu (.478), a mały – w co piątym (.207). Moc .80 próba ma dopiero od d = 0.74 (Rysunek 1). Jak oceniać wielkość efektu w swojej dziedzinie, opisuje wpis wielkość efektu – interpretacja.
Typowy błąd
Uznanie reguły „30 osób na grupę wystarczy” za analizę mocy. Wystarcza ona tylko przy efekcie dużym.
Zadanie 4. Minimalny wykrywalny efekt przy danej próbie
Treść zadania
Pedagog porównuje wyniki testu matematycznego (SD = 12 punktów) w dwóch szkołach: w jednej uczniowie uczyli się nową metodą, w drugiej tradycyjną. W każdej szkole przebadać można 42 uczniów. (a) Jaki najmniejszy efekt d wykryje test t z mocą .80 (α = .05, dwustronnie)? (b) Ile to punktów testu? (c) Jaka jest moc dla różnicy 5 punktów?
Rozwiązanie krok po kroku
Krok 1. Przekształć wzór z zadania 1 względem d:
Krok 2. Dokładnie. power.t.test(n = 42, power = 0.80, sd = 1) szuka delta i podaje dmin = 0.619 (pwr: to samo). W punktach testu to 0.619 × 12 = 7.42 punktu. Przy wymaganej mocy .90: dmin = 0.716, czyli 8.59 punktu.
Krok 3. Moc dla 5 punktów. d = 5 / 12 = 0.417; power.t.test(n = 42, delta = 5, sd = 12) daje moc .471.
Interpretacja
Przy 42 uczniach w każdej szkole badanie wiarygodnie wykryje różnicę od około 7.4 punktu wzwyż. Różnicę 5 punktów wykryje mniej więcej w co drugim powtórzeniu. To analiza wrażliwości: zamiast „ile osób potrzebuję?” pytasz „co wykryje próba, którą mam?”. Lakens (2022) wymienia ograniczenia zasobów wśród uprawnionych sposobów uzasadnienia liczebności i proponuje wtedy pokazać, jakie efekty badanie wykrywa z wystarczającą mocą. Wersję dla ankiet z tabelą gotowych wartości znajdziesz we wpisie ile osób do ankiety w pracy licencjackiej.
Typowy błąd
Wniosek „różnica nieistotna, więc metody są równie skuteczne”. Przy mocy .471 dla 5 punktów brak istotności takiej różnicy nie wyklucza; brak efektu wykazuje test równoważności.
Zadanie 5. Korekta na ubytek uczestników
Treść zadania
Eksperyment z zadania 1 przekształcasz w badanie z trzema pomiarami (przed, po 2 tygodniach, po 2 miesiącach). Do analizy nadal potrzebujesz 45 osób na grupę. W podobnych badaniach do ostatniego pomiaru nie dotrwała co czwarta osoba (ubytek 25%). (a) Ile osób zrekrutować? (b) Co się stanie, jeśli policzysz 45 × 1.25? (c) Ile osób potrzeba, jeśli dodatkowo 10% ankiet odrzucisz przy czyszczeniu danych?
Rozwiązanie krok po kroku
Krok 1. Poprawny wzór. Do analizy trafi tylko odsetek (1 − u) zrekrutowanych, więc liczebność dzielisz:
Sprawdzenie: 60 × 0.75 = 45.
Krok 2. Błędny wzór. 45 × 1.25 = 56.25 → 57. Po ubytku 25% zostanie 57 × 0.75 = 42.75, czyli w praktyce 42 osoby. Moc spada wtedy do .775.
Krok 3. Dwa źródła strat. Odsetki osób, które „przechodzą dalej”, mnożysz:
Interpretacja
Do badania trzeba zaprosić 60 osób na grupę, a przy dodatkowych wykluczeniach – 67. Rutterford i in. (2015) wymieniają ubytek wśród typowych odstępstw od prostego planu, które trzeba uwzględnić przy liczeniu liczebności. Większa rekrutacja chroni tylko moc: jeśli rezygnują głównie osoby o wysokim lęku, wyniki będą obciążone – zob. utrata uczestników (attrition).
Typowy błąd
Mnożenie przez (1 + u) zamiast dzielenia przez (1 − u). Przy 25% brakuje już 3 osób na grupę (57 zamiast 60), a przy 40% – 12 osób (63 zamiast 75).
Zadanie 6. Losowanie całych klas: efekt schematu
Treść zadania
Porównujesz dwa programy nauki czytania w klasach trzecich. Program przydzielasz losowo całym klasom, a nie pojedynczym uczniom. Zakładasz efekt d = 0.35 i korelację wewnątrzklasową ICC = .05 (α = .05, dwustronnie, moc .80). (a) Ilu uczniów i ile klas potrzeba, jeśli w badaniu bierze udział średnio 25 uczniów z klasy? (b) A jeśli tylko 15 uczniów z klasy (np. brak zgód rodziców)?
Rozwiązanie krok po kroku
Krok 1. Liczebność przy losowaniu osób. power.t.test(delta = 0.35, sd = 1, power = 0.80) daje 130 uczniów na program.
Krok 2. Efekt schematu. Uczniowie jednej klasy są do siebie podobni, a miarą tego podobieństwa jest ICC:
Krok 3. Liczebność i liczba klas. 130 × 2.20 = 286 uczniów na program, czyli 286 / 25 = 11.44 → 12 klas (300 uczniów) na program, 24 klasy łącznie.
Krok 4. Mniejsze klasy. Przy 15 uczniach z klasy DEFF = 1 + 14 × 0.05 = 1.70, więc potrzeba 130 × 1.70 = 221 uczniów, czyli 15 klas (225 uczniów) na program, 30 klas łącznie.
Interpretacja
Przy losowaniu klas potrzeba ponad dwa razy więcej uczniów. Liczy się przede wszystkim liczba klas: wariant (b) wymaga mniej uczniów (225 zamiast 300), ale więcej klas. Takie najprostsze podejście – liczebność dla losowania osób pomnożona przez efekt schematu – opisują Rutterford i in. (2015). Przy nierównych klasach i innych komplikacjach podają oni dokładniejsze wzory. Wynik dla własnych założeń sprawdzisz w kalkulatorze ICC i efektu schematu.
Typowy błąd
Zebranie 130 uczniów z 5–6 klas i analiza, jakby byli niezależni. To odpowiada tylko 59 niezależnym obserwacjom, a moc spada do .471.
Zadanie 7. Liczebność dla korelacji: transformacja Fishera
Treść zadania
Chcesz sprawdzić, czy jakość snu w tygodniu przed sesją wiąże się z wynikiem egzaminu. Na podstawie wcześniejszych badań spodziewasz się korelacji r = .25. Ilu studentów potrzebujesz (α = .05, dwustronnie, moc .80)? Ilu przy teście jednostronnym, a ilu przy r = .40? Jaką moc da próba 60 osób?
Rozwiązanie krok po kroku
Krok 1. Transformacja Fishera. Rozkład r jest skośny, ale z′ = atanh(r) = ½ ln[(1 + r)/(1 − r)] ma w przybliżeniu rozkład normalny z błędem standardowym 1/√(n − 3). Dla r = .25: z′ = 0.255.
Krok 2. Wzór:
Krok 3. Kontrola. Funkcja pwr.r.test daje 122.45 → 123. Pakiet stosuje nieco dokładniejsze przybliżenie, więc różnica jednej osoby jest oczekiwana.
Krok 4. Warianty. Przy teście jednostronnym (z = 1.645) potrzeba 98 osób, a przy r = .40 – 47 osób. Moc dla N = 60 i r = .25: Φ(0.255 × √57 − 1.960) = .487.
Interpretacja
Do wykrycia korelacji .25 potrzeba około 124 osób. Próba 60 osób wykryje ją mniej więcej w co drugim badaniu. Korelacje rzędu .25 i słabsze wymagają ponad 100 osób.
Typowy błąd
Przyjęcie do obliczeń korelacji z jednego małego badania pilotażowego („w pilotażu na 20 osobach wyszło r = .50”). Przy tak małej próbie oszacowanie jest bardzo niepewne. Jeśli celem jest dokładne oszacowanie siły związku, a nie sam test, planuj szerokość przedziału ufności – zob. liczebność próby z precyzji (AIPE).
Zadanie 8. Ta sama liczba osób: test dla par czy dwie grupy?
Treść zadania
Masz 36 uczestników i chcesz porównać czas reakcji w dwóch warunkach (ćwiczenie w ciszy i w hałasie). Efekt między warunkami szacujesz na d = 0.45 (w jednostkach SD pojedynczego pomiaru). Porównaj moc dwóch planów (α = .05, dwustronnie): (a) dwie grupy po 18 osób, (b) wszystkie 36 osób w obu warunkach (kolejność losowa). W planie (b) przyjmij korelację pomiarów ρ = 0, .5 albo .7.
Rozwiązanie krok po kroku
Krok 1. Plan międzygrupowy. power.t.test(n = 18, delta = 0.45, sd = 1) daje moc .259.
Krok 2. Efekt dla różnic. W teście t dla prób zależnych liczy się średnia różnic podzielona przez SD różnic. Ta miara to dz. SD różnic maleje, gdy pomiary są skorelowane:
Krok 3. Moc w planie wewnątrzosobowym (type = "paired", n = 36):
| ρ | dz | Moc przy 36 osobach | Osób dla mocy .80 |
|---|---|---|---|
| 0 | 0.318 | .459 | 80 |
| .5 | 0.450 | .747 | 41 |
| .7 | 0.581 | .923 | 26 |
| dwie grupy po 18 (d = 0.45) | .259 | 79 na grupę (158) | |
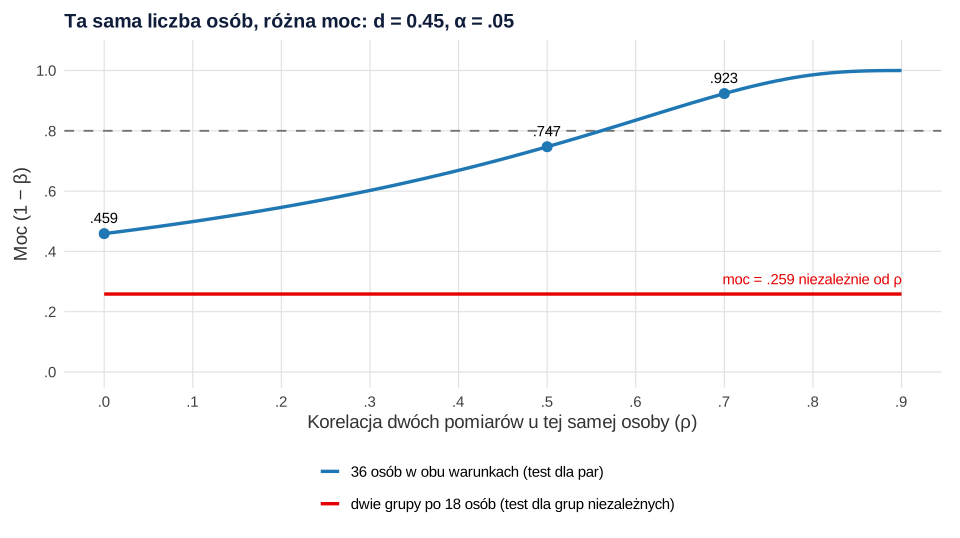
Interpretacja
Przy tej samej liczbie osób plan z pomiarem powtarzanym ma dużo większą moc: .747 zamiast .259 przy ρ = .5. Nawet przy ρ = 0 moc jest wyższa (.459), bo każda osoba daje dwa pomiary. Zbliżony wniosek z tabel liczebności wyciąga Brysbaert (2019): przy zmiennej wewnątrzosobowej wystarcza wyraźnie mniej uczestników niż przy porównaniu grup.
Typowy błąd
Wpisanie do analizy mocy dla planu wewnątrzosobowego zwykłego d z badań międzygrupowych tak, jakby było dz. Przy ρ = .7 zaniża to moc, a przy ρ < .5 – zawyża. Efekt kolejności kontroluj losową kolejnością warunków.
Zadanie 9. Wpływ poziomu istotności i testu jednostronnego
Treść zadania
Wróć do zadania 1 (d = 0.60, moc .80). Policz liczebność na grupę dla czterech wariantów: α = .05 lub .01, test dwustronny lub jednostronny. Jaką moc ma 45 osób na grupę przy α = .01? Co się stanie w teście jednostronnym, jeśli efekt okaże się odwrotny?
Rozwiązanie krok po kroku
Krok 1. Co zmienia α. We wzorze z zadania 1 zmienia się tylko wartość krytyczna (z1−α/2 albo z1−α dla testu jednostronnego), a liczebność jest proporcjonalna do (zα + z1−β)².
| Wariant | z krytyczne | (zα + 0.842)² | power.t.test | Na grupę |
|---|---|---|---|---|
| α = .05, dwustronnie | 1.960 | 7.85 | 44.59 | 45 |
| α = .05, jednostronnie | 1.645 | 6.18 | 35.04 | 36 |
| α = .01, dwustronnie | 2.576 | 11.68 | 66.56 | 67 |
| α = .01, jednostronnie | 2.326 | 10.04 | 57.13 | 58 |
Krok 2. Proporcja i moc. Przejście z α = .05 na .01 zwiększa liczebność 11.68 / 7.85 = 1.49 raza (z 45 do 67). Przy 45 osobach na grupę i α = .01 moc wynosi tylko .586.
Krok 3. Efekt w przeciwną stronę. Jeśli w teście jednostronnym (H1: ćwiczenia obniżają lęk) prawdziwy efekt ma przeciwny znak, moc jest praktycznie zerowa: funkcja pwr.t.test podaje 3.9 × 10⁻⁶.
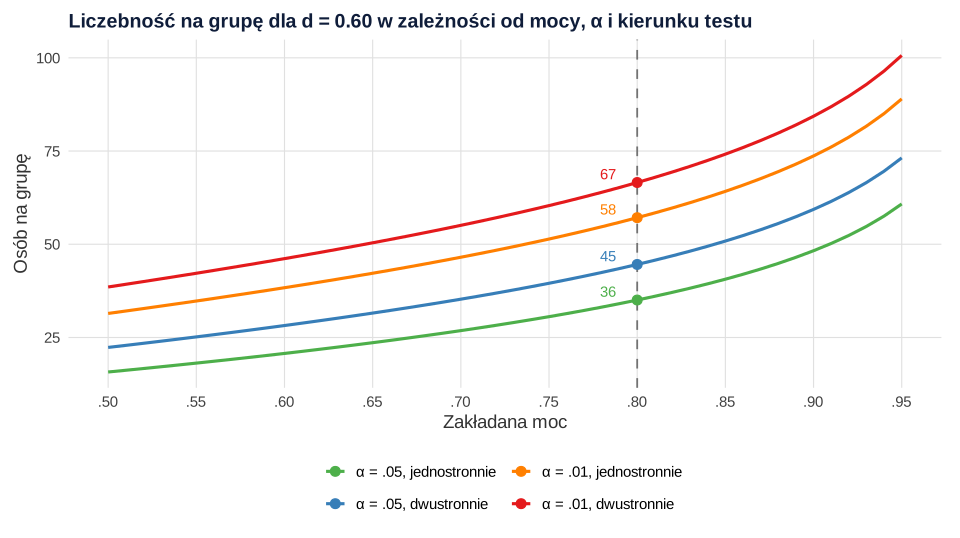
power.t.test).Interpretacja
Surowszy poziom istotności zmniejsza ryzyko błędu I rodzaju, ale przy tej samej próbie zwiększa ryzyko błędu II rodzaju. Test jednostronny jest „tańszy” o mniej więcej 20% osób. Wybierz go tylko wtedy, gdy kierunek zapisano przed badaniem, a efekt odwrotny nie byłby ważny – zob. test jednostronny i dwustronny.
Typowy błąd
Planowanie próby dla testu jednostronnego (36 osób), a potem raportowanie wyniku dwustronnego, bo „tak się przyjęło”. Przy 36 osobach na grupę test dwustronny ma moc .709, a nie .80 – licz próbę dla testu, który naprawdę wykonasz.
Zadanie 10. Dlaczego „moc po fakcie” nic nie mówi
Treść zadania
Recenzent pracy pisze: „Wynik nieistotny (p = .20) – proszę podać moc obserwowaną”. (a) Policz moc obserwowaną dla p = .01, .05, .20 i .50 w przybliżeniu normalnym. (b) Sprawdź symulacją: 5000 badań z dwiema grupami po 49 osób i prawdziwym efektem d = 0.4 (prawdziwa moc .500). Jak rozkłada się moc obserwowana?
Rozwiązanie krok po kroku
Krok 1. Moc obserwowana to inny zapis p. Zakłada, że prawdziwy efekt równa się efektowi z próby, więc parametr niecentralności zastępujesz uzyskanym |z|:
| p | |z| | Moc obserwowana |
|---|---|---|
| .010 | 2.576 | .731 |
| .050 | 1.960 | .500 |
| .200 | 1.282 | .249 |
| .500 | 0.674 | .104 |
Wystarczyło samo p, więc moc obserwowana nie niesie żadnej informacji ponad p. Przy każdym wyniku nieistotnym wychodzi poniżej .50.
Krok 2. Symulacja. W 5000 badaniach o prawdziwej mocy .500 wynik istotny wyszedł w .509 z nich. Moc obserwowana miała średnią .512, ale rozrzut od kilku procent do prawie 1: kwartyle .261 i .762, w .188 badań była niższa niż .20, a w .212 – wyższa niż .80. Wśród wyników nieistotnych najwyższa moc obserwowana wynosiła .502. Korelacja rang mocy obserwowanej z p wyniosła −1.000, czyli moc obserwowana jest funkcją p.
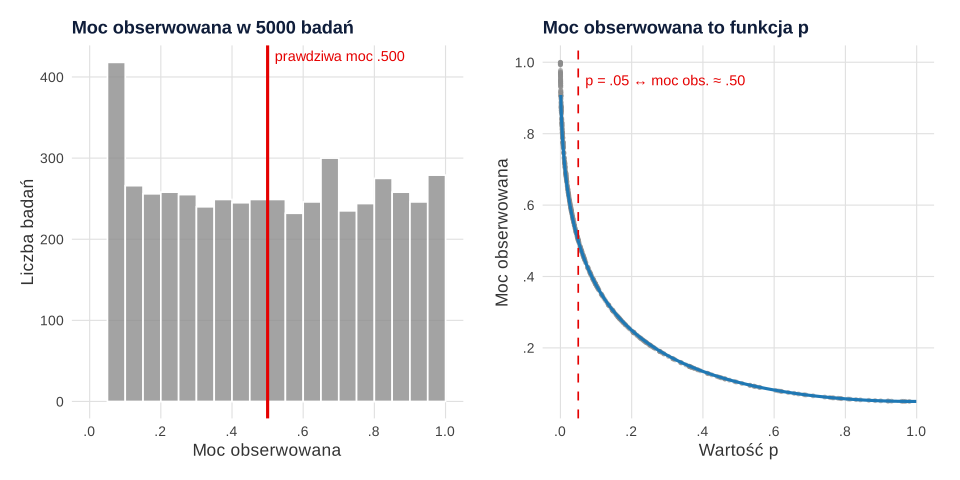
Interpretacja
Mimo tej samej prawdziwej mocy moc obserwowana przyjmowała niemal dowolne wartości – zgodnie z wynikiem Yuana i Maxwella (2005): moc post hoc prawie zawsze jest obciążonym estymatorem prawdziwej mocy, a gdy prawdziwa moc wynosi .5, jej rozkład jest jednostajny. Hoenig i Heisey (2001) nazywają interpretowanie wyniku nieistotnego za pomocą mocy obserwowanej podejściem z gruntu błędnym. Zamiast niej podaj efekt z przedziałem ufności i minimalny wykrywalny efekt, tak jak w zadaniu 4. Więcej w haśle analiza mocy post hoc.
Typowy błąd
Zdanie „moc wyniosła tylko .25, dlatego wynik nie był istotny”. To tautologia: niska moc obserwowana wynika z wysokiego p, a nie odwrotnie.
Ściąga: wzory na liczebność i moc
Wszystkie wzory mają ten sam rdzeń: (zα + z1−β)² podzielone przez kwadrat efektu – dwa razy mniejszy efekt to cztery razy większa próba.
| Sytuacja | Wzór przybliżony | Funkcja R | Na co uważać |
|---|---|---|---|
| Dwie średnie, grupy niezależne | n = 2(zα + zβ)² / d² (+ zα²/4) | power.t.test, pwr.t.test | n na grupę; zaokrąglaj w górę |
| Dwie proporcje | wzór z zadania 2 | power.prop.test, pwr.2p.test | ta sama różnica kosztuje najwięcej przy odsetkach bliskich 50% |
| Korelacja | n = [(zα + zβ) / atanh(r)]² + 3 | pwr.r.test | nie bierz r z małego pilotażu |
| Pomiar powtarzany | dz = d / √[2(1 − ρ)] | power.t.test(type = "paired") | korelacja pomiarów decyduje o mocy |
| Minimalny efekt | dmin = (zα + zβ) √(2/n) | power.t.test(n = …, power = …) | to analiza wrażliwości, nie moc po fakcie |
| Ubytek | n / (1 − u) | – | nie mnóż przez (1 + u) |
| Losowanie grup | n × [1 + (m − 1) ICC] | – | liczba klas waży więcej niż liczba osób |
Moc dla ANOVA, χ² i regresji policzysz w kalkulatorze mocy; czynniki wpływające na moc opisuje hasło moc testu.
Inne zbiory zadań
- Zadania ze statystyki z rozwiązaniami – wszystkie zbiory.
- Estymacja i testowanie hipotez – zadania z rozwiązaniami (błąd II rodzaju dla testu z, liczebność z marginesu błędu).
- Zadania ze statystyki na psychologii (testy t i d Cohena z danych).
- ANOVA – zadania z rozwiązaniami.
- Korelacja i regresja – zadania z rozwiązaniami.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań. Założenia są wpisane w kod, tak jak w treści zadań. Każde zadanie jest policzone najpierw wzorem, tak jak na kartce, a potem dokładną funkcją R jako kontrola. Losowanie występuje tylko w symulacji z zadania 10 (ziarno 391). Rysunki i plik CSV powstały w osobnym skrypcie, który korzysta z wartości z tych przepisów.
Zadania 1–5: liczebność dla testu t i dwóch proporcji, moc, minimalny efekt, ubytek
R
# B391 – zadania 1–5: liczebność dla testu t (wzór i power.t.test), dwie proporcje,
# moc przy ustalonym n, minimalny wykrywalny efekt, korekta na ubytek
# Założenia wpisane na sztywno – te same co w treści zadań. Funkcje pakietów stats i pwr.
library(pwr)
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))   # bez zera przed kropką (moc, p)
za <- qnorm(0.975); zb <- qnorm(0.80)               # alfa = .05 dwustronnie, moc .80

# Zadanie 1. Program ćwiczeń oddechowych a lęk przed egzaminem (skala 0–80)
# Wcześniejsze badanie: SD = 9.6 i 10.4 (po 30 osób); najmniejsza ważna różnica = 6 punktów
sd_p <- sqrt((29 * 9.6^2 + 29 * 10.4^2) / 58)
d1 <- 6 / sd_p
n_wzor <- 2 * (za + zb)^2 / d1^2
n_popr <- n_wzor + za^2 / 4                          # poprawka na rozkład t
pt1 <- power.t.test(delta = 6, sd = sd_p, power = 0.80, sig.level = 0.05)
cat("Zadanie 1\n")
cat("z(1 - alfa/2) =", z3(za), "; z(1 - beta) =", z3(zb), "\n")
cat("SD łączne =", z2(sd_p), "; d =", z2(d1), "\n")
cat("Wzór przybliżony: n =", z2(n_wzor), "-> w górę:", ceiling(n_wzor),
    "; z zaokrąglonym d = 0.60:", z2(2 * (za + zb)^2 / 0.60^2), "\n")
cat("Z poprawką z^2/4: n =", z2(n_popr), "-> w górę:", ceiling(n_popr), "\n")
cat("power.t.test: n =", z2(pt1$n), "-> w górę:", ceiling(pt1$n), "\n")
cat("pwr.t.test:   n =", z2(pwr.t.test(d = d1, power = 0.80, sig.level = 0.05)$n), "\n")
cat("Moc przy 44 osobach:", bz(power.t.test(n = 44, delta = d1, sd = 1)$power),
    "; przy 45:", bz(power.t.test(n = 45, delta = d1, sd = 1)$power),
    "; błąd – 45 osób łącznie (22 na grupę):", bz(power.t.test(n = 22, delta = d1, sd = 1)$power), "\n\n")

# Zadanie 2. Przestrzeganie zaleceń po edukacji pielęgniarskiej: 50% vs 65%
p1 <- 0.50; p2 <- 0.65; pbar <- (p1 + p2) / 2
n2_wzor <- (za * sqrt(2 * pbar * (1 - pbar)) + zb * sqrt(p1 * (1 - p1) + p2 * (1 - p2)))^2 / (p2 - p1)^2
pp2 <- power.prop.test(p1 = p1, p2 = p2, power = 0.80, sig.level = 0.05)
h2 <- ES.h(p2, p1)
cat("Zadanie 2\n")
cat("Średni odsetek =", z3(pbar), "; wzór: n =", z2(n2_wzor), "-> w górę:", ceiling(n2_wzor), "\n")
cat("power.prop.test: n =", z2(pp2$n), "-> w górę:", ceiling(pp2$n), "\n")
cat("h Cohena =", z3(h2), "; pwr.2p.test: n =", z2(pwr.2p.test(h = h2, power = 0.80)$n), "\n")
cat("Dla 50% vs 60%: n =", ceiling(power.prop.test(p1 = 0.50, p2 = 0.60, power = 0.80)$n),
    "; dla 10% vs 25%: n =", ceiling(power.prop.test(p1 = 0.10, p2 = 0.25, power = 0.80)$n), "\n\n")

# Zadanie 3. Moc przy 30 osobach na grupę dla kilku wielkości efektu
cat("Zadanie 3\n")
for (d in c(0.3, 0.5, 0.8)) {
  ncp <- d * sqrt(30 / 2); tk <- qt(0.975, df = 58)
  moc_t <- 1 - pt(tk, df = 58, ncp = ncp) + pt(-tk, df = 58, ncp = ncp)
  moc_z <- pnorm(ncp - za)
  cat(sprintf("d = %.1f: d*sqrt(n/2) = %s ; moc (przybliżenie z) = %s ; moc (niecentralne t) = %s ; power.t.test = %s\n",
              d, z3(ncp), bz(moc_z), bz(moc_t), bz(power.t.test(n = 30, delta = d, sd = 1)$power)))
}
cat("t krytyczne (df = 58) =", z3(qt(0.975, df = 58)), "\n\n")

# Zadanie 4. Minimalny wykrywalny efekt: dwie szkoły po 42 uczniów, test matematyczny SD = 12
n4 <- 42; sd4 <- 12
d_wzor <- (za + zb) * sqrt(2 / n4)
d_dokl <- power.t.test(n = n4, power = 0.80, sd = 1)$delta
d_dokl90 <- power.t.test(n = n4, power = 0.90, sd = 1)$delta
cat("Zadanie 4\n")
cat("Wzór: d_min =", z3(d_wzor), "; power.t.test: d_min =", z3(d_dokl), "\n")
cat("W punktach testu: ", z2(d_dokl * sd4), "; przy mocy .90: d_min =", z3(d_dokl90), "=", z2(d_dokl90 * sd4), "pkt\n")
cat("pwr.t.test: d_min =", z3(pwr.t.test(n = n4, power = 0.80)$d), "\n")
cat("Moc dla różnicy 5 punktów (d =", z3(5 / sd4), "):", bz(power.t.test(n = n4, delta = 5, sd = sd4)$power), "\n\n")

# Zadanie 5. Korekta na ubytek w badaniu z trzema pomiarami
n_analiza <- ceiling(pt1$n)                          # 45 osób na grupę z zadania 1
u <- 0.25; w <- 0.10
n_rekr <- n_analiza / (1 - u)
n_blad <- n_analiza * (1 + u)
n_oba <- n_analiza / ((1 - w) * (1 - u))
cat("Zadanie 5\n")
cat("Potrzeba do analizy:", n_analiza, "na grupę\n")
cat("Poprawnie n/(1 - u) =", z2(n_rekr), "-> w górę:", ceiling(n_rekr), "; zostanie:", z2(ceiling(n_rekr) * (1 - u)), "\n")
cat("Błąd n*(1 + u) =", z2(n_blad), "-> w górę:", ceiling(n_blad), "; zostanie:", z2(ceiling(n_blad) * (1 - u)),
    "; moc przy", floor(ceiling(n_blad) * (1 - u)), "osobach:", bz(power.t.test(n = floor(ceiling(n_blad) * (1 - u)), delta = d1, sd = 1)$power), "\n")
cat("Ubytek 40%: n/(1 - u) =", ceiling(n_analiza / 0.60), "; n*(1 + u) =", ceiling(n_analiza * 1.40),
    "; brakuje:", ceiling(n_analiza / 0.60) - ceiling(n_analiza * 1.40), "\n")
cat("Wykluczenia 10% i ubytek 25%: n =", z2(n_oba), "-> w górę:", ceiling(n_oba), "na grupę; razem", 2 * ceiling(n_oba), "\n")
Wynik w R
Zadanie 1
z(1 - alfa/2) = 1.960 ; z(1 - beta) = 0.842
SD łączne = 10.01 ; d = 0.60
Wzór przybliżony: n = 43.67 -> w górę: 44 ; z zaokrąglonym d = 0.60: 43.60
Z poprawką z^2/4: n = 44.64 -> w górę: 45
power.t.test: n = 44.66 -> w górę: 45
pwr.t.test:   n = 44.66
Moc przy 44 osobach: .794 ; przy 45: .803 ; błąd – 45 osób łącznie (22 na grupę): .493

Zadanie 2
Średni odsetek = 0.575 ; wzór: n = 169.31 -> w górę: 170
power.prop.test: n = 169.31 -> w górę: 170
h Cohena = 0.305 ; pwr.2p.test: n = 169.09
Dla 50% vs 60%: n = 388 ; dla 10% vs 25%: n = 100

Zadanie 3
d = 0.3: d*sqrt(n/2) = 1.162 ; moc (przybliżenie z) = .212 ; moc (niecentralne t) = .208 ; power.t.test = .207
d = 0.5: d*sqrt(n/2) = 1.936 ; moc (przybliżenie z) = .491 ; moc (niecentralne t) = .478 ; power.t.test = .478
d = 0.8: d*sqrt(n/2) = 3.098 ; moc (przybliżenie z) = .873 ; moc (niecentralne t) = .861 ; power.t.test = .861
t krytyczne (df = 58) = 2.002

Zadanie 4
Wzór: d_min = 0.611 ; power.t.test: d_min = 0.619
W punktach testu:  7.42 ; przy mocy .90: d_min = 0.716 = 8.59 pkt
pwr.t.test: d_min = 0.619
Moc dla różnicy 5 punktów (d = 0.417 ): .471

Zadanie 5
Potrzeba do analizy: 45 na grupę
Poprawnie n/(1 - u) = 60.00 -> w górę: 60 ; zostanie: 45.00
Błąd n*(1 + u) = 56.25 -> w górę: 57 ; zostanie: 42.75 ; moc przy 42 osobach: .775
Ubytek 40%: n/(1 - u) = 75 ; n*(1 + u) = 63 ; brakuje: 12
Wykluczenia 10% i ubytek 25%: n = 66.67 -> w górę: 67 na grupę; razem 134
Zadania 6–10: efekt schematu, korelacja, pomiar powtarzany, α i moc po fakcie
R
# B391 – zadania 6–10: efekt schematu przy doborze klas, liczebność dla korelacji (Fisher z),
# test dla par a grupy niezależne, wpływ alfa i jednostronności, moc „po fakcie”
# Założenia wpisane na sztywno – te same co w treści zadań. Funkcje pakietów stats i pwr.
library(pwr)
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))
za <- qnorm(0.975); zb <- qnorm(0.80)

# Zadanie 6. Dwa programy nauki czytania, losowanie całych klas; d = 0.35, ICC = .05
n_ind <- ceiling(power.t.test(delta = 0.35, sd = 1, power = 0.80)$n)
cat("Zadanie 6\n")
cat("Losowanie osób: n =", n_ind, "uczniów na program\n")
for (m in c(25, 15)) {
  deff <- 1 + (m - 1) * 0.05
  n_kl <- n_ind * deff
  k <- ceiling(n_kl / m)
  cat(sprintf("m = %d: DEFF = %s ; n = %s -> klas na program: %d (%d uczniów) ; klas razem: %d\n",
              m, z2(deff), z2(n_kl), k, k * m, 2 * k))
}
n_ef <- n_ind / (1 + 24 * 0.05)
cat("Błąd: 130 uczniów w klasach po 25 to efektywnie", z2(n_ef), "osoby ; moc =",
    bz(power.t.test(n = n_ef, delta = 0.35, sd = 1)$power), "\n\n")

# Zadanie 7. Korelacja jakości snu z wynikiem egzaminu: oczekiwane r = .25
r7 <- 0.25
zr <- atanh(r7)
n7 <- ((za + zb) / zr)^2 + 3
cat("Zadanie 7\n")
cat("z Fishera = atanh(.25) =", z3(zr), "; n =", z2(n7), "-> w górę:", ceiling(n7), "\n")
cat("pwr.r.test: n =", z2(pwr.r.test(r = r7, power = 0.80)$n), "\n")
cat("Jednostronnie: n =", ceiling(((qnorm(0.95) + zb) / zr)^2 + 3), "; dla r = .40: n =", ceiling(((za + zb) / atanh(0.40))^2 + 3), "\n")
cat("Moc przy N = 60 dla r = .25:", bz(pnorm(atanh(r7) * sqrt(60 - 3) - za)), "\n\n")

# Zadanie 8. Ta sama liczba osób (36): dwie grupy po 18 albo wszyscy w obu warunkach
d8 <- 0.45; N8 <- 36
cat("Zadanie 8\n")
cat("Grupy niezależne 18 + 18, d = 0.45: moc =", bz(power.t.test(n = 18, delta = d8, sd = 1)$power), "\n")
for (rho in c(0, 0.5, 0.7)) {
  dz <- d8 / sqrt(2 * (1 - rho))
  cat(sprintf("Pomiary powtarzane, rho = %.1f: dz = %s ; moc przy n = 36: %s ; n dla mocy .80: %d\n",
              rho, z3(dz), bz(power.t.test(n = N8, delta = dz, sd = 1, type = "paired")$power),
              ceiling(power.t.test(delta = dz, sd = 1, power = 0.80, type = "paired")$n)))
}
cat("pwr.t.test (paired, rho = .5): moc =", bz(pwr.t.test(n = N8, d = d8 / sqrt(2 * 0.5), type = "paired")$power), "\n")
cat("Grupy niezależne: n na grupę dla mocy .80 =", ceiling(power.t.test(delta = d8, sd = 1, power = 0.80)$n), "\n\n")

# Zadanie 9. Wpływ alfa i jednostronności (d = 0.60 jak w zadaniu 1, moc .80)
cat("Zadanie 9\n")
for (a in c(0.05, 0.01)) for (alt in c("two.sided", "one.sided")) {
  n9 <- power.t.test(delta = 0.6, sd = 1, power = 0.80, sig.level = a, alternative = alt)$n
  zk <- if (alt == "two.sided") qnorm(1 - a / 2) else qnorm(1 - a)
  cat(sprintf("alfa = %.2f, %s: z krytyczne = %s ; (z_a + z_b)^2 = %s ; n = %s -> %d na grupę\n",
              a, alt, z3(zk), z2((zk + zb)^2), z2(n9), ceiling(n9)))
}
cat("Moc testu dwustronnego (alfa = .05) przy 36 osobach:", bz(power.t.test(n = 36, delta = 0.6, sd = 1)$power), "\n")
cat("Moc przy 45 osobach i alfa = .01 (dwustronnie):", bz(power.t.test(n = 45, delta = 0.6, sd = 1, sig.level = 0.01)$power), "\n")
cat("Moc przy 45 osobach, jednostronnie, gdy prawdziwy efekt ma przeciwny znak (d = -0.6):",
    signif(pwr.t.test(n = 45, d = -0.6, alternative = "greater")$power, 2), "\n\n")

# Zadanie 10. Moc „po fakcie” z zaobserwowanego efektu
cat("Zadanie 10\n")
cat("(a) Moc obserwowana jako funkcja p (przybliżenie normalne):\n")
for (p in c(0.01, 0.05, 0.20, 0.50)) {
  zobs <- qnorm(1 - p / 2)
  cat(sprintf("  p = %s: |z| = %s ; moc obserwowana = %s\n", bz(p), z3(zobs), bz(pnorm(zobs - za) + pnorm(-zobs - za))))
}
n10 <- ceiling(power.t.test(delta = 0.4, sd = 1, power = 0.50)$n)
moc_prawdziwa <- power.t.test(n = n10, delta = 0.4, sd = 1)$power
cat("(b) Prawdziwy efekt d = 0.4, n =", n10, "na grupę, prawdziwa moc =", bz(moc_prawdziwa), "\n")
set.seed(391)
R <- 5000; df10 <- 2 * n10 - 2; tk <- qt(0.975, df10)
wyn <- t(replicate(R, {
  x <- rnorm(n10, 0.4, 1); y <- rnorm(n10, 0, 1)
  sp <- sqrt((var(x) + var(y)) / 2); d_obs <- (mean(x) - mean(y)) / sp
  tt <- d_obs * sqrt(n10 / 2)
  c(d_obs = d_obs, p = 2 * pt(-abs(tt), df10),
    moc_obs = 1 - pt(tk, df10, ncp = abs(tt)) + pt(-tk, df10, ncp = abs(tt)))
}))
cat("Odsetek wyników istotnych:", bz(mean(wyn[, "p"] < 0.05)), "\n")
cat("Moc obserwowana: średnia =", bz(mean(wyn[, "moc_obs"])), "; mediana =", bz(median(wyn[, "moc_obs"])),
    "; kwartyle =", bz(quantile(wyn[, "moc_obs"], 0.25)), "i", bz(quantile(wyn[, "moc_obs"], 0.75)), "\n")
cat("Odsetek badań z mocą obserwowaną < .20:", bz(mean(wyn[, "moc_obs"] < 0.20)),
    "; > .80:", bz(mean(wyn[, "moc_obs"] > 0.80)), "\n")
cat("Najwyższa moc obserwowana wśród wyników nieistotnych:", bz(max(wyn[wyn[, "p"] >= 0.05, "moc_obs"])), "\n")
cat("Korelacja Spearmana mocy obserwowanej z p:", z3(cor(wyn[, "moc_obs"], wyn[, "p"], method = "spearman")), "\n")
Wynik w R
Zadanie 6
Losowanie osób: n = 130 uczniów na program
m = 25: DEFF = 2.20 ; n = 286.00 -> klas na program: 12 (300 uczniów) ; klas razem: 24
m = 15: DEFF = 1.70 ; n = 221.00 -> klas na program: 15 (225 uczniów) ; klas razem: 30
Błąd: 130 uczniów w klasach po 25 to efektywnie 59.09 osoby ; moc = .471

Zadanie 7
z Fishera = atanh(.25) = 0.255 ; n = 123.32 -> w górę: 124
pwr.r.test: n = 122.45
Jednostronnie: n = 98 ; dla r = .40: n = 47
Moc przy N = 60 dla r = .25: .487

Zadanie 8
Grupy niezależne 18 + 18, d = 0.45: moc = .259
Pomiary powtarzane, rho = 0.0: dz = 0.318 ; moc przy n = 36: .459 ; n dla mocy .80: 80
Pomiary powtarzane, rho = 0.5: dz = 0.450 ; moc przy n = 36: .747 ; n dla mocy .80: 41
Pomiary powtarzane, rho = 0.7: dz = 0.581 ; moc przy n = 36: .923 ; n dla mocy .80: 26
pwr.t.test (paired, rho = .5): moc = .747
Grupy niezależne: n na grupę dla mocy .80 = 79

Zadanie 9
alfa = 0.05, two.sided: z krytyczne = 1.960 ; (z_a + z_b)^2 = 7.85 ; n = 44.59 -> 45 na grupę
alfa = 0.05, one.sided: z krytyczne = 1.645 ; (z_a + z_b)^2 = 6.18 ; n = 35.04 -> 36 na grupę
alfa = 0.01, two.sided: z krytyczne = 2.576 ; (z_a + z_b)^2 = 11.68 ; n = 66.56 -> 67 na grupę
alfa = 0.01, one.sided: z krytyczne = 2.326 ; (z_a + z_b)^2 = 10.04 ; n = 57.13 -> 58 na grupę
Moc testu dwustronnego (alfa = .05) przy 36 osobach: .709
Moc przy 45 osobach i alfa = .01 (dwustronnie): .586
Moc przy 45 osobach, jednostronnie, gdy prawdziwy efekt ma przeciwny znak (d = -0.6): 3.9e-06

Zadanie 10
(a) Moc obserwowana jako funkcja p (przybliżenie normalne):
  p = .010: |z| = 2.576 ; moc obserwowana = .731
  p = .050: |z| = 1.960 ; moc obserwowana = .500
  p = .200: |z| = 1.282 ; moc obserwowana = .249
  p = .500: |z| = 0.674 ; moc obserwowana = .104
(b) Prawdziwy efekt d = 0.4, n = 49 na grupę, prawdziwa moc = .500
Odsetek wyników istotnych: .509
Moc obserwowana: średnia = .512 ; mediana = .512 ; kwartyle = .261 i .762
Odsetek badań z mocą obserwowaną < .20: .188 ; > .80: .212
Najwyższa moc obserwowana wśród wyników nieistotnych: .502
Korelacja Spearmana mocy obserwowanej z p: -1.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakiet pwr); rysunki przygotowano w pakietach ggplot2, patchwork, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis [R package]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jak policzyć liczebność próby na kolokwium bez programu?
Użyj wzoru n = 2(z1−α/2 + z1−β)² / d² dla dwóch grup: przy α = .05 (dwustronnie) i mocy .80 podstawiasz 1.960 i 0.842. Dla d = 0.60 wychodzi 43.67, czyli 44 osoby na grupę; program podaje 45, bo liczy z rozkładu t. Na kolokwium dodaj z²/4 ≈ 0.96 albo zaznacz, że wynik jest przybliżony.
Dlaczego power.t.test podaje więcej osób niż wzór z rozkładu normalnego?
Wzór przybliżony zakłada rozkład normalny statystyki, a test t ma grubsze ogony, zwłaszcza przy małych próbach. Funkcja power.t.test liczy moc z niecentralnego rozkładu t, więc wynik jest zwykle o jedną osobę większy (w zadaniu 1: 44.66 zamiast 43.67). W pracy podawaj wynik dokładny.
Czy przy losowaniu całych klas wystarczy zbadać tylu uczniów, ilu wychodzi z analizy mocy?
Nie. Liczebność dla losowania pojedynczych osób trzeba pomnożyć przez efekt schematu DEFF = 1 + (m − 1) × ICC. Przy 25 uczniach w klasie i ICC = .05 DEFF wynosi 2.20, więc zamiast 130 uczniów na program potrzeba 286, czyli 12 klas. O mocy decyduje głównie liczba klas.
Dlaczego badanie z pomiarem powtarzanym potrzebuje mniej osób niż porównanie grup?
Bo każda osoba jest swoją własną kontrolą, a różnice między ludźmi nie wchodzą do błędu. Wielkość efektu dla różnic dz = d / √[2(1 − ρ)] rośnie z korelacją pomiarów. Przy 36 osobach i d = 0.45 plan z dwoma pomiarami (ρ = .5) ma moc .747, a dwie grupy po 18 – tylko .259.
Co podać zamiast mocy obserwowanej, gdy wynik jest nieistotny?
Podaj wielkość efektu z przedziałem ufności i analizę wrażliwości: najmniejszy efekt, który badanie wykrywało z mocą .80 przy uzyskanej liczebności. Moc obserwowana jest tylko innym zapisem p – przy p = .05 wynosi około .50, a przy każdym wyniku nieistotnym mniej.
Powiązane hasła
Przeczytaj też
Moc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikEstymacja i testowanie hipotez – zadania
Dziesięć zadań jak na kolokwium: przedziały ufności (z, t, Wilson), liczebność próby, testy dla średniej i proporcji, test jednostronny, błąd II rodzaju i moc.
Czytaj →PoradnikKalkulator liczebności próby
Ile osób do testu t, korelacji albo ankiety z marginesem błędu? Kalkulator zgodny z R, wzory, przykład i gotowy opis analizy mocy.
Czytaj →Planujesz badanie i nie wiesz, ilu osób potrzebujesz?
Pomożemy dobrać wielkość efektu i przeliczyć liczebność dla Twojego planu badania, sprawdzimy obliczenia w R i przygotujemy opis analizy mocy, który obronisz przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Rutterford, C., Copas, A., & Eldridge, S. (2015). Methods for sample size determination in cluster randomized trials. International Journal of Epidemiology, 44(3), 1051–1067. https://doi.org/10.1093/ije/dyv113 ● Otwarty dostęp
- Yuan, K.-H., & Maxwell, S. (2005). On the post hoc power in testing mean differences. Journal of Educational and Behavioral Statistics, 30(2), 141–167. https://doi.org/10.3102/10769986030002141
Cytowania BibTeX
@article{brysbaert2019how, author={Brysbaert, Marc}, title={{How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{rutterford2015methods, author={Rutterford, Clare and Copas, Andrew and Eldridge, Sandra}, title={{Methods for sample size determination in cluster randomized trials}}, journal={International Journal of Epidemiology}, year={2015}, volume={44}, number={3}, pages={1051--1067}, doi={10.1093/ije/dyv113}}@article{yuan2005post, author={Yuan, Ke-Hai and Maxwell, Scott}, title={{On the post hoc power in testing mean differences}}, journal={Journal of Educational and Behavioral Statistics}, year={2005}, volume={30}, number={2}, pages={141--167}, doi={10.3102/10769986030002141}}