Estymacja i testowanie hipotez: zadania z rozwiązaniami – jak z nich korzystać
Estymacja i testowanie hipotez to zwykle jeden dział kolokwium: szacujesz parametr populacji z próby i sprawdzasz, czy dane są zgodne z hipotezą o nim. Poniżej znajdziesz 10 zadań z rozwiązaniami z estymacji i testowania hipotez w stylu kolokwium na 1. i 2. roku.
Każde zadanie ma treść z danymi, rozwiązanie krok po kroku (wzór, podstawienie, wynik, wartość krytyczna albo p), interpretację i typowy błąd. Historyjki pochodzą z pedagogiki, zarządzania i życia studenckiego. Wszystkie liczby policzyliśmy w R (kod na końcu wpisu); inna ostatnia cyfra na kalkulatorze to zwykle skutek zaokrągleń.
Zadania uzupełniają zbiór zadań ze statystyki na psychologii (tam są testy t dla dwóch grup) i idą głębiej w logikę wnioskowania. Wzory są standardowe – znajdziesz je w podręcznikach statystyki dla studentów (np. King i Minium, 2009).
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | test kompetencji matematycznych w gminie | przedział ufności dla średniej, σ znane (z); 90%, 95%, 99% |
| 2 | czas snu studentów w sesji | przedział ufności dla średniej, σ nieznane (t) |
| 3 | rezygnacja ze studiów: 2 z 20 osób | przedział dla proporcji: Wald i Wilson |
| 4 | planowanie ankiety wśród studentów | minimalna liczebność próby (średnia i proporcja) |
| 5 | masa opakowań kawy na linii produkcyjnej | test z dla jednej średniej |
| 6 | czas odrabiania lekcji przez uczniów | test t dla jednej średniej, związek z przedziałem ufności |
| 7 | absolwenci pracujący w zawodzie | test dla jednej proporcji |
| 8 | zdawalność egzaminu: kurs online i stacjonarny | test dla dwóch proporcji, przedział dla różnicy |
| 9 | program korepetycji | test jednostronny a dwustronny |
| 10 | kontrola jakości z zadania 5 | błąd I i II rodzaju, moc, liczebność dla mocy .80 |
Wartości krytyczne podajemy przy każdym zadaniu, ale na kolokwium musisz je odczytać sam(a) – przydadzą się tablice rozkładów t, χ², F i z. Dane do zadań z surowymi wynikami (2, 3, 6, 7 i 8) są w jednym pliku: estymacja-i-testowanie-hipotez-zadania-dane.csv (format długi; odpowiedzi tak/nie jako 1/0).
Zadanie 1. Przedział ufności dla średniej, gdy σ jest znane
Treść zadania
Ogólnopolski test kompetencji matematycznych ma w normach odchylenie standardowe σ = 15 punktów. W jednej gminie wylosowano 36 uczniów; ich średni wynik wyniósł M = 104.2. Oblicz 90%, 95% i 99% przedział ufności dla średniego wyniku wszystkich uczniów gminy.
Rozwiązanie krok po kroku
Krok 1. Błąd standardowy średniej. Skoro σ jest znane z norm, błąd standardowy liczysz bez szacowania SD z próby:
Krok 2. Wartości krytyczne z rozkładu normalnego. Dla 90% ufności z = 1.645, dla 95% – 1.960, dla 99% – 2.576.
Krok 3. Margines błędu i przedziały według wzoru M ± z × SE:
| Poziom ufności | z | Margines | Przedział | Szerokość |
|---|---|---|---|---|
| 90% | 1.645 | 4.11 | [100.09, 108.31] | 8.22 |
| 95% | 1.960 | 4.90 | [99.30, 109.10] | 9.80 |
| 99% | 2.576 | 6.44 | [97.76, 110.64] | 12.88 |
Interpretacja
Średni wynik uczniów gminy to 104.2 punktu, 95% CI [99.30, 109.10]. Wyższy poziom ufności oznacza szerszy przedział, a precyzję poprawia liczebność: przy 144 uczniach margines 95% spadłby z 4.90 do 2.45. Więcej w haśle estymacja przedziałowa.
Typowy błąd
Zdanie „z prawdopodobieństwem 95% średnia gminy leży między 99.30 a 109.10”. Poziom ufności opisuje procedurę: w 95% powtórzeń losowania przedział obejmie prawdziwą średnią. Greenland i in. (2016) wymieniają takie odczytanie konkretnego przedziału wśród typowych błędnych interpretacji przedziałów ufności.
Zadanie 2. Przedział ufności dla średniej, gdy σ jest nieznane
Treść zadania
Dwunastu studentów zapisywało w czasie sesji, ile godzin śpią w nocy (średnio z tygodnia): 6.5, 7.0, 5.5, 8.0, 6.0, 7.5, 6.5, 5.0, 7.0, 6.5, 8.5, 6.0. Oblicz 95% przedział ufności dla średniego czasu snu studentów w sesji.
Rozwiązanie krok po kroku
Krok 1. Średnia. Suma wynosi 80, n = 12, więc M = 80 / 12 = 6.667 godziny.
Krok 2. SD z próby. Suma kwadratów odchyleń od średniej SS = 11.167, więc s = √(11.167 / 11) = 1.008 godziny. σ nie znasz, więc potrzebujesz rozkładu t.
Krok 3. Błąd standardowy i wartość krytyczna. SE = 1.008 / √12 = 0.291. Z rozkładu t-Studenta przy df = 11 i 95% ufności: tkryt = 2.201.
Interpretacja
Studenci spali w sesji średnio M = 6.67 godziny (SD = 1.01), 95% CI [6.03, 7.31]. Przedział nie obejmuje 8 godzin, więc dane nie są zgodne z hipotezą, że przeciętny student śpi w sesji 8 godzin. Wynik sprawdzisz w kalkulatorze przedziału ufności.
Typowy błąd
Pomylenie SD z SE: „M ± 1.96 SD” daje [4.69, 8.64]. To nie jest przedział ufności dla średniej, tylko przybliżony zakres, w którym mieści się większość pojedynczych studentów.
Zadanie 3. Przedział ufności dla proporcji: Wald i Wilson
Treść zadania
W pilotażowej grupie 20 studentów nowego kierunku 2 osoby zrezygnowały ze studiów w pierwszym semestrze. Oblicz 95% przedział ufności dla odsetka rezygnacji metodą Walda i metodą Wilsona. Porównaj wyniki z sytuacją, w której na roku jest 200 osób, a zrezygnowało 20.
Rozwiązanie krok po kroku
Krok 1. Odsetek z próby. p̂ = 2 / 20 = .100 (10%).
Krok 2. Przedział Walda (wzór podręcznikowy):
Dolna granica jest ujemna, a ujemnego odsetka być nie może.
Krok 3. Przedział Wilsona liczysz w trzech krokach:
połowa szerokości = [z / (1 + z²/n)] × √[p̂(1 − p̂)/n + z²/(4n²)] = 0.137
95% CI = 0.164 ± 0.137 → [.028, .301]
Środek (.164) jest przesunięty od p̂ = .100 w stronę .50, więc przedział nie wychodzi poza zakres 0–1.
Krok 4. Duża próba. Przy 20 rezygnacjach na 200 osób (ten sam odsetek 10%): Wald [.058, .142], Wilson [.066, .149]. Różnica między metodami prawie znika.
Interpretacja
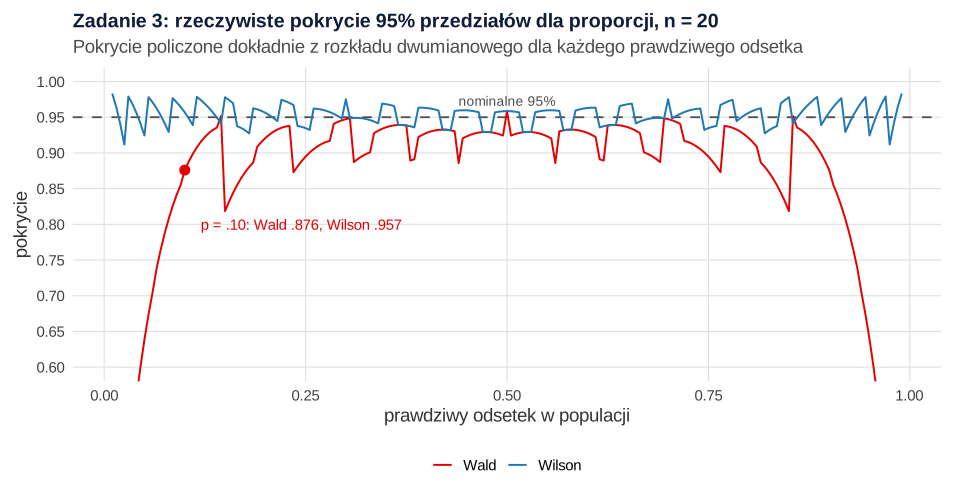
W pilotażu zrezygnowało 10% studentów, 95% CI (Wilson) [2.8%, 30.1%]. Przy 20 osobach oszacowanie jest bardzo nieprecyzyjne. Rysunek 1 pokazuje, dlaczego warto wybrać Wilsona: przy n = 20 i prawdziwym odsetku 10% przedział Walda obejmuje go tylko w 87.6% prób, a Wilsona – w 95.7%. Brown i in. (2001) pokazali, że chaotyczne pokrycie przedziału Walda utrzymuje się znacznie uporczywiej, niż się sądzi, i przy małym n zalecają m.in. przedział Wilsona. Według Agrestiego i Coulla (1998) pokrycie Wilsona jest bliskie nominalnemu nawet w bardzo małych próbach. Inne metody opisuje hasło przedział ufności dla proporcji.
Typowy błąd
Obcięcie ujemnej granicy Walda do zera i podanie [0, .231] jako „poprawionego” wyniku. Obcięcie nie poprawia pokrycia – policz od razu przedział Wilsona (w R robi to prop.test(x, n, correct = FALSE)).
Zadanie 4. Ile osób zbadać, żeby osiągnąć zadany margines błędu
Treść zadania
Samorząd studencki planuje ankietę. (a) Chce oszacować średnie miesięczne wydatki studenta na materiały do nauki z marginesem błędu ±10 zł (95% ufności); z poprzedniej edycji wiadomo, że SD ≈ 80 zł. (b) Chce oszacować odsetek studentów korzystających z poradni psychologicznej z marginesem ±5 punktów procentowych, nie wiedząc nic o tym odsetku. (c) Jak zmieni się wynik (b), jeśli z wcześniejszych badań odsetek wynosi ok. 15%? (d) A jeśli na uczelni studiuje tylko 1200 osób?
Rozwiązanie krok po kroku
Krok 1. Średnia. Przekształć wzór na margines E = z × σ / √n względem n:
Krok 2. Proporcja bez wiedzy wstępnej. Iloczyn p(1 − p) jest największy dla p = .50 („najgorszy przypadek”):
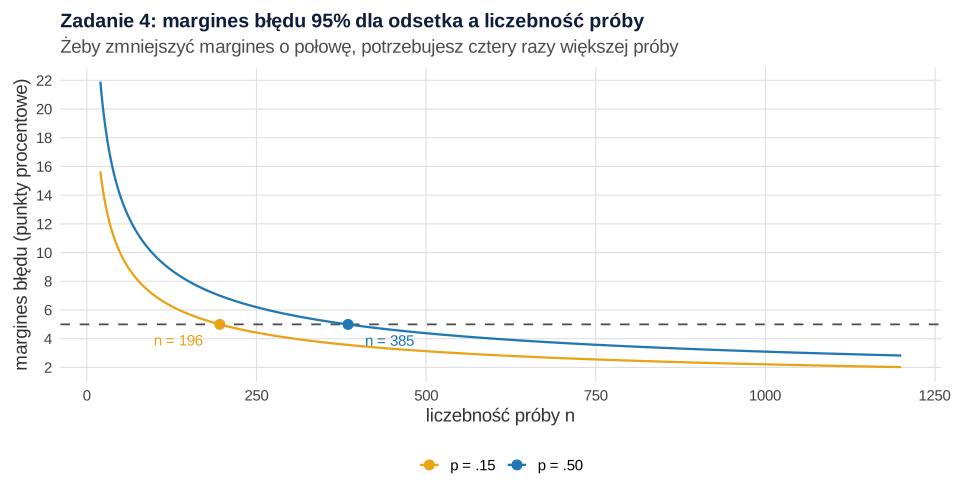
Krok 3. Proporcja z wiedzą wstępną. Dla p = .15: n = 1.96² × 0.15 × 0.85 / 0.05² = 195.92 → 196 osób, czyli prawie o połowę mniej.
Krok 4. Mała populacja. Gdy próba to spora część populacji, stosuje się korektę na populację skończoną: n = n0 / [1 + (n0 − 1) / N]. Dla N = 1200 wychodzi 291.18 → 292 osoby.
Wyniki pośrednie liczone w R z niezaokrąglonym z różnią się na drugim miejscu po kropce (245.85, 384.15, 195.91), ale po zaokrągleniu w górę dają te same liczebności.
Interpretacja
Potrzeba 246 osób do średniej i 385 do odsetka (przy uczelni liczącej 1200 osób – 292). To liczby ankiet oddanych, więc zaproszeń trzeba wysłać więcej. Inne założenia policzysz w kalkulatorze liczebności próby, a szerzej temat opisuje poradnik dobór liczebności próby i hasło margines błędu w sondażu.
Typowy błąd
Zapominanie, że margines dotyczy całej próby. Podgrupa 120 osób (np. pierwszy rok) ma margines ±8.9 punktu procentowego – planuj liczebność dla najmniejszej podgrupy, którą chcesz analizować.
Zadanie 5. Test z dla jednej średniej
Treść zadania
Maszyna pakuje kawę do opakowań o deklarowanej masie 250 g. Z dokumentacji wiadomo, że σ = 4 g. Kontroler zważył 25 losowo wybranych opakowań i uzyskał M = 248.2 g. Czy na poziomie α = .05 można twierdzić, że maszyna jest rozregulowana (średnia różni się od 250 g)?
Rozwiązanie krok po kroku
Krok 1. Hipotezy. H0: μ = 250, H1: μ ≠ 250 (test dwustronny, bo rozregulowanie w każdą stronę jest problemem). Zob. hipotezy statystyczne H0 i H1.
Krok 2. Statystyka testowa. σ jest znane, więc używasz rozkładu normalnego:
Krok 3. Decyzja przez wartość krytyczną. Przy α = .05 dwustronnie wartość krytyczna wynosi ±1.960. Ponieważ |−2.25| > 1.960, statystyka leży w obszarze krytycznym – odrzucasz H0. Równoważnie: obszar przyjęcia H0 dla średniej to 250 ± 1.96 × 0.80 = [248.432, 251.568], a 248.2 leży poza nim.
Krok 4. Wartość p. p = 2 × Φ(−2.25) = .024. Przy α = .01 (zkryt = 2.576) H0 nie zostałaby odrzucona.
Interpretacja
Średnia masa opakowań w próbie (M = 248.2 g) była istotnie niższa od deklarowanej, z = −2.25, p = .024; 95% CI [246.63, 249.77]. Przedział nie zawiera 250, co zgadza się z decyzją testu. O tym, czy 1.8 g to dużo, decyduje kontekst, a nie wartość p.
Typowy błąd
Użycie testu z z SD policzonym z małej próby. Gdy σ szacujesz z tych samych danych, użyj testu t (zadanie 6).
Zadanie 6. Test t dla jednej średniej i przedział ufności
Treść zadania
Szkoła deklaruje w materiałach dla rodziców, że uczniowie poświęcają na zadania domowe średnio 60 minut dziennie. Pedagog zebrał dzienniczki 10 uczniów: 52, 61, 48, 55, 66, 50, 58, 45, 63, 54 minuty. Sprawdź hipotezę testem t (α = .05, dwustronnie), oblicz 95% i 99% przedział ufności i porównaj obie decyzje.
Rozwiązanie krok po kroku
Krok 1. Statystyki opisowe. M = 55.20, SS = 413.60, SD = √(413.60 / 9) = 6.78, SE = 6.78 / √10 = 2.14.
Krok 2. Decyzja. tkryt(9) = 2.262. Ponieważ |−2.24| < 2.262, nie ma podstaw do odrzucenia H0; dokładnie p = .052.
Krok 3. Przedziały ufności. 95% CI = 55.20 ± 2.262 × 2.14 → [50.35, 60.05]; 99% CI (tkryt = 3.250) → [48.23, 62.17].
Krok 4. Związek przedziału z testem. 95% przedział obejmuje 60 (ledwo – górna granica to 60.05), więc dwustronny test na α = .05 nie odrzuca H0. Reguła działa zawsze: μ0 poza (1 − α) przedziałem oznacza p < α. Przedział 99% odpowiada testowi na α = .01.
Interpretacja
Brak istotności nie dowodzi, że szkoła ma rację: przedział sięga od ok. 50 do 60 minut, a d = −0.71 to efekt umiarkowanie duży. Więcej: test t dla jednej próby.
Typowy błąd
Zapis „p = .052, więc H0 jest prawdziwa” albo „wynik prawie istotny, więc czas pracy jest krótszy”. Test nie dowodzi H0, a p = .052 i p = .048 to praktycznie ta sama siła dowodów.
Zadanie 7. Test dla jednej proporcji
Treść zadania
Uczelnia podaje w materiałach promocyjnych, że 70% absolwentów kierunku pracuje w zawodzie. W losowej próbie 120 absolwentów w zawodzie pracowało 72 osoby. Sprawdź twierdzenie uczelni (α = .05, dwustronnie).
Rozwiązanie krok po kroku
Krok 1. Hipotezy i warunek stosowania. H0: π = .70, H1: π ≠ .70. Przybliżenie normalne jest uprawnione, bo nπ0 = 84 i n(1 − π0) = 36 – obie liczby są wyraźnie większe niż 5–10.
Krok 2. Statystyka z. Odsetek w próbie p̂ = 72 / 120 = .600. Błąd standardowy liczysz z wartości z hipotezy zerowej (π0), nie z próby:
Z zaokrąglonym SE wychodzi na kalkulatorze −2.38; R liczy na niezaokrąglonych wartościach i podaje −2.39.
Krok 3. Decyzja. |−2.39| > 1.960, p = .017 – odrzucasz H0. prop.test(…, correct = FALSE) podaje ten sam test jako χ²(1) = 5.71 = z²; dokładny binom.test daje p = .022.
Interpretacja
W pracy zawodowej było 60.0% absolwentów (72/120), istotnie mniej niż deklarowane 70%, z = −2.39, p = .017; 95% CI (Wilson) [51.1%, 68.3%]. Przedział Wilsona powstaje przez odwrócenie właśnie tego testu, dlatego jego wynik zawsze zgadza się z decyzją testu: 70% leży poza przedziałem, a p < .05.
Typowy błąd
Liczenie SE z odsetka w próbie (√(0.6 × 0.4 / 120) = 0.045, z = −2.24). W teście zakładasz prawdziwość H0, więc używasz π0.
Zadanie 8. Test dla dwóch proporcji
Treść zadania
Egzamin z ekonomii zdało 43 z 56 studentów, którzy uczyli się w kursie online, i 31 z 54 studentów z kursu stacjonarnego. Czy odsetki zdających różnią się (α = .05, dwustronnie)? Oblicz 95% przedział ufności dla różnicy odsetków.
Rozwiązanie krok po kroku
Krok 1. Odsetki. Online: p̂1 = 43/56 = .768; stacjonarnie: p̂2 = 31/54 = .574; różnica = .194 (19.4 punktu procentowego).
Krok 2. Wspólny odsetek. Przy H0 (π1 = π2) najlepszym oszacowaniem jest odsetek w obu grupach łącznie: p̂ = (43 + 31) / (56 + 54) = 74 / 110 = .673.
(Na zaokrąglonych liczbach 0.194 / 0.089 daje 2.18 – to różnica z zaokrągleń, R podaje 2.17).
Krok 3. Decyzja. 2.17 > 1.960, p = .030 – odrzucasz H0. Najmniejsza liczność oczekiwana w tabeli 2 × 2 wynosi 17.67, więc przybliżenie normalne jest w porządku.
Krok 4. Przedział dla różnicy. Do przedziału nie łączysz grup (nie zakładasz H0): SE = √[p̂1(1 − p̂1)/n1 + p̂2(1 − p̂2)/n2] = 0.088, więc 95% CI = .194 ± 1.96 × 0.088 → [.022, .366].
Interpretacja
Przedział jest szeroki. Studenci sami wybierali kurs, więc różnica nie musi wynikać z formy nauki. Zapis χ²(1) = 4.69 (= z²) i przedział Newcombe’a opisuje hasło test dla dwóch proporcji.
Typowy błąd
Porównanie wyniku ręcznego z domyślnym prop.test(), który dla tabeli 2 × 2 stosuje poprawkę Yatesa: daje χ² = 3.85, p = .050 (dokładniej .0497). Żeby uzyskać wynik z kroku 2, dopisz correct = FALSE.
Zadanie 9. Test jednostronny a dwustronny
Treść zadania
Średni wynik próbnego egzaminu w województwie wynosi 60 punktów. Dwudziestu uczniów po programie korepetycji uzyskało M = 63.6, SD = 8.5. (a) Wykonaj test dwustronny. (b) Wykonaj test jednostronny H1: μ > 60, który autorzy programu zapisali przed badaniem. (c) Co by było, gdyby uczniowie uzyskali M = 56.4?
Rozwiązanie krok po kroku
Krok 1. Statystyka t (ta sama w obu wersjach):
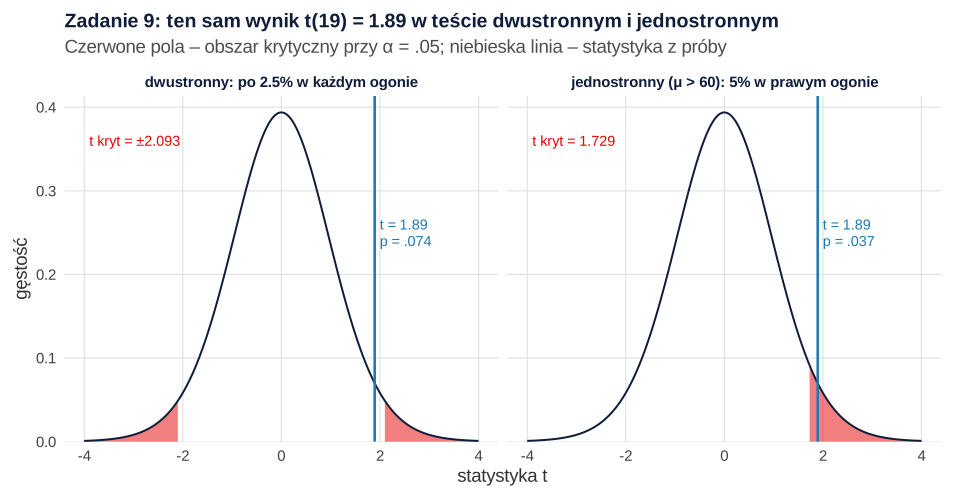
Krok 2. Test dwustronny. α = .05 dzielisz na dwa ogony po .025: tkryt = ±2.093. 1.894 < 2.093, p = .074 – nie odrzucasz H0.
Krok 3. Test jednostronny. Całe α = .05 trafia do prawego ogona: tkryt = 1.729. 1.894 > 1.729, p = .037 – odrzucasz H0. Jednostronne p to połowa dwustronnego, gdy wynik idzie w przewidywanym kierunku.
Krok 4. Wynik w przeciwnym kierunku. Dla M = 56.4 statystyka wynosi t = −1.894, a jednostronne p = .963. Test jednostronny „w górę” nie wykryje spadku, nawet dużego.
Interpretacja
Uczniowie po korepetycjach uzyskali średnio 63.6 punktu (SD = 8.5). W teście jednostronnym, zapisanym przed zebraniem danych, wynik był istotnie wyższy od średniej wojewódzkiej, t(19) = 1.89, p = .037 (jednostronnie). W teście dwustronnym różnica nie była istotna (p = .074). W pracy napisz, którą wersję wybrałeś i dlaczego. Zob. test jednostronny i dwustronny oraz test jednostronny czy dwustronny.
Typowy błąd
Wybór testu jednostronnego dopiero po obejrzeniu danych, „bo dwustronny nie wyszedł”. Rzeczywisty poziom istotności wynosi wtedy nie .05, lecz .10.
Zadanie 10. Błąd I i II rodzaju oraz moc testu
Treść zadania
Wróć do kontroli opakowań kawy z zadania 5 (H0: μ = 250 g, σ = 4 g, n = 25, α = .05, test dwustronny). Załóż, że maszyna naprawdę pakuje średnio 248 g. (a) Jakie jest prawdopodobieństwo błędu II rodzaju β i jaka jest moc testu? (b) Ile opakowań trzeba ważyć, żeby moc wynosiła .80?
Rozwiązanie krok po kroku
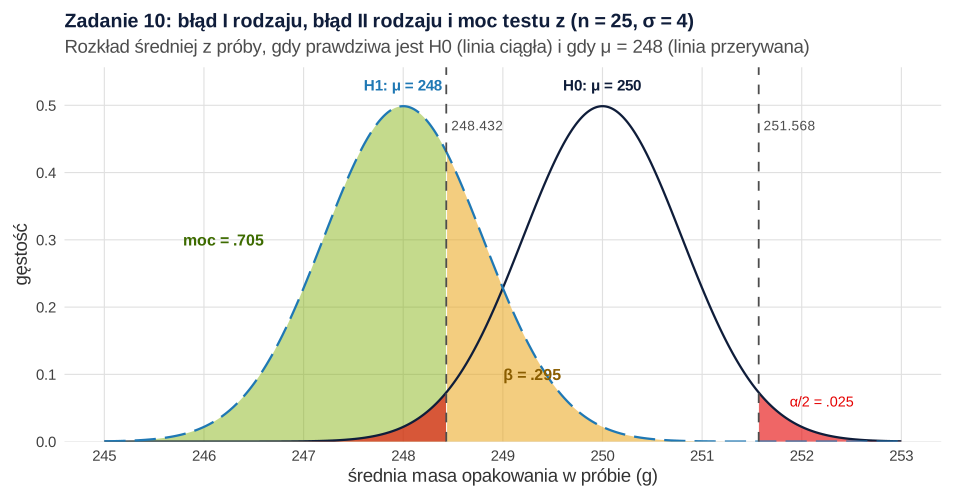
Krok 1. Obszar przyjęcia H0 w jednostkach średniej. Z zadania 5: H0 przyjmujesz, gdy średnia z próby leży w [248.432, 251.568]. Ryzyko odrzucenia prawdziwej H0 (błąd I rodzaju) to α = .05.
Krok 2. Rozkład średniej przy H1. Jeśli μ = 248, średnie z próby mają rozkład normalny ze średnią 248 i SE = 0.80. Zamień granice na wyniki z względem 248:
Krok 3. β i moc. β to szansa, że średnia z próby mimo wszystko trafi do obszaru przyjęcia H0:
Krok 4. Liczebność dla mocy .80. Dla testu dwustronnego n = [(z1−α/2 + z1−β) × σ / Δ]² = [(1.960 + 0.842) × 4 / 2]² = 31.40 → 32 opakowania. Przy n = 32 moc wynosi .807.
Interpretacja
Jeśli maszyna pakuje średnio 248 g, kontrola na 25 opakowaniach wykryje to w ok. 70% przypadków, a w ok. 30% przeoczy. Symulacja 10 000 kontroli w R dała odsetek odrzuceń H0 .702 przy μ = 248 i .052 przy μ = 250. Przy α = .01 moc spada do .470, przy μ = 249 do .240, a przy 50 opakowaniach rośnie do .942. Pojęcia błędu I i II rodzaju oraz mocy należą do podejścia Neymana i Pearsona (1933). Konwencję mocy .80 spopularyzował Cohen (1992), który zestawił liczebności potrzebne do jej osiągnięcia w ośmiu standardowych testach. Zob. błąd I i II rodzaju i moc testu.
Typowy błąd
Liczenie mocy „po fakcie” z efektu zaobserwowanego w próbie i wniosek „test nie wyszedł, bo moc była mała”. Taka moc jest funkcją uzyskanego p i nic nowego nie mówi; moc liczy się dla efektu ustalonego z góry (tu 2 g).
Ściąga: wzory, przedział a test
Prawie wszystko sprowadza się do schematu oszacowanie ± wartość krytyczna × SE (przedział) i (oszacowanie − wartość z H0) / SE (test). Zmieniają się tylko SE i rozkład.
| Sytuacja | Błąd standardowy | Rozkład | Na co uważać |
|---|---|---|---|
| Średnia, σ znane | σ / √n | z | σ musi pochodzić spoza próby |
| Średnia, σ nieznane | s / √n | t, df = n − 1 | SD to nie SE |
| Proporcja – przedział | √[p̂(1 − p̂)/n] (Wald) albo wzór Wilsona | z | przy małym n wybierz Wilsona |
| Proporcja – test | √[π0(1 − π0)/n] | z | SE z wartości z H0 |
| Dwie proporcje – test | wspólny odsetek p̂ obu grup | z (= √χ²) | domyślny prop.test ma poprawkę Yatesa |
| Liczebność dla średniej | n = (zσ / E)² | z | zawsze zaokrąglaj w górę |
| Liczebność dla proporcji | n = z²p(1 − p) / E² | z | bez wiedzy wstępnej p = .50 |
Zapamiętaj też regułę łączącą oba działy. Dwustronny test na poziomie α odrzuca H0 wtedy i tylko wtedy, gdy wartość z H0 leży poza (1 − α) przedziałem ufności policzonym tą samą metodą. Pokazują to zadania 5, 6 i 7. Przedział mówi więcej niż test, bo pokazuje wielkość efektu – w pracy podawaj oba.
Inne zbiory zadań
- Statystyka opisowa – zadania z rozwiązaniami.
- Prawdopodobieństwo i rozkłady – zadania z rozwiązaniami.
- Korelacja i regresja – zadania z rozwiązaniami.
- Testy nieparametryczne – zadania z rozwiązaniami.
- Statystyka medyczna – zadania dla pielęgniarstwa i kierunków medycznych.
- Zadania ze statystyki na psychologii.
- Pytania na egzamin ze statystyki – z odpowiedziami.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod. Każde zadanie jest policzone najpierw wzorem, tak jak na kartce, a potem – tam, gdzie się da – gotową funkcją R jako kontrola. Losowanie występuje tylko w symulacji mocy w zadaniu 10 (ziarno 380). Rysunki i plik CSV powstały w osobnym skrypcie, który korzysta z danych z tych przepisów.
Zadania 1–5: przedziały ufności, liczebność próby i test z
R
# B380 – zadania 1–5: przedział ufności dla średniej (z i t), dla proporcji (Wald i Wilson),
# minimalna liczebność próby, test z dla jednej średniej
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))   # bez zera przed kropką (p)

# Zadanie 1. Test kompetencji matematycznych: sigma = 15 znane z norm, n = 36, M = 104.2
M1 <- 104.2; sigma1 <- 15; n1 <- 36
SE1 <- sigma1 / sqrt(n1)
cat("Zadanie 1\n")
cat("SE =", z2(SE1), "\n")
for (pu in c(0.90, 0.95, 0.99)) {
  zk <- qnorm(1 - (1 - pu) / 2)
  cat(sprintf("%.0f%%: z krytyczne = %s ; margines = %s ; CI = [%s, %s] ; szerokość = %s\n",
              100 * pu, z3(zk), z2(zk * SE1), z2(M1 - zk * SE1), z2(M1 + zk * SE1), z2(2 * zk * SE1)))
}
cat("Przy n = 144 (4 razy więcej): margines 95% =", z2(qnorm(0.975) * sigma1 / sqrt(144)), "\n\n")

# Zadanie 2. Czas snu (godziny) 12 studentów w sesji, sigma nieznane
sen <- c(6.5, 7.0, 5.5, 8.0, 6.0, 7.5, 6.5, 5.0, 7.0, 6.5, 8.5, 6.0)
n2 <- length(sen); M2 <- mean(sen); SD2 <- sd(sen); SE2 <- SD2 / sqrt(n2)
tk2 <- qt(0.975, df = n2 - 1)
cat("Zadanie 2\n")
cat("n =", n2, "; suma =", sum(sen), "; M =", z3(M2), "; SS =", z3(sum((sen - M2)^2)), "; SD =", z3(SD2), "; SE =", z3(SE2), "\n")
cat("t krytyczne (df = 11, 95%) =", z3(tk2), "; margines =", z3(tk2 * SE2), "\n")
cat("95% CI = [", z2(M2 - tk2 * SE2), ",", z2(M2 + tk2 * SE2), "]\n")
cat("Kontrola t.test():", z2(t.test(sen)$conf.int), "\n")
cat("Błąd: M ± 1.96 SD = [", z2(M2 - 1.96 * SD2), ",", z2(M2 + 1.96 * SD2), "]\n\n")

# Zadanie 3. Rezygnacja ze studiów: 2 z 20 osób; dla porównania 20 z 200
wald <- function(x, n, pu = 0.95) {
  p <- x / n; z <- qnorm(1 - (1 - pu) / 2); se <- sqrt(p * (1 - p) / n)
  c(p - z * se, p + z * se)
}
wilson <- function(x, n, pu = 0.95) {
  p <- x / n; z <- qnorm(1 - (1 - pu) / 2)
  srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z / (1 + z^2 / n) * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  c(srodek - pol, srodek + pol)
}
cat("Zadanie 3\n")
z95w <- qnorm(0.975)
for (d in list(c(2, 20), c(20, 200))) {
  x <- d[1]; n <- d[2]
  cat(sprintf("x = %d, n = %d: odsetek = %s ; SE Walda = %s\n", x, n, z3(x / n), z3(sqrt((x / n) * (1 - x / n) / n))))
  cat("  Wald   [", z3(wald(x, n)), "]\n")
  cat("  Wilson [", z3(wilson(x, n)), "] ; środek Wilsona =", z3(mean(wilson(x, n))), "\n")
  cat("  Wilson krok po kroku: z^2/(2n) =", z3(z95w^2 / (2 * n)), "; 1 + z^2/n =", z3(1 + z95w^2 / n),
      "; połowa szerokości =", z3(diff(wilson(x, n)) / 2), "\n")
  cat("  Kontrola prop.test(correct = FALSE):", z3(prop.test(x, n, correct = FALSE)$conf.int), "\n")
}
# Rzeczywiste pokrycie 95% przedziałów przy n = 20 i prawdziwym odsetku 10% (dokładnie z rozkładu dwumianowego)
pokrycie <- function(metoda, n, p) {
  x <- 0:n
  w <- sapply(x, function(k) { g <- metoda(k, n); g[1] <= p & p <= g[2] })
  sum(dbinom(x, n, p) * w)
}
cat("Pokrycie przy n = 20 i odsetku 0.10: Wald =", z3(pokrycie(wald, 20, 0.10)), "; Wilson =", z3(pokrycie(wilson, 20, 0.10)), "\n\n")

# Zadanie 4. Minimalna liczebność próby dla zadanego marginesu błędu (95%)
z95 <- qnorm(0.975)
n_sr <- (z95 * 80 / 10)^2                    # średnia: sigma = 80 zł, margines E = 10 zł
n_p50 <- z95^2 * 0.5 * 0.5 / 0.05^2          # proporcja: odsetek 0.5 (najgorszy przypadek), E = 5 pkt proc.
n_p15 <- z95^2 * 0.15 * 0.85 / 0.05^2        # proporcja: odsetek 0.15 z wcześniejszych badań
N_pop <- 1200
n_skon <- n_p50 / (1 + (n_p50 - 1) / N_pop) # korekta na populację skończoną
cat("Zadanie 4\n")
cat("Średnia: n =", z2(n_sr), "-> zaokrąglij w górę:", ceiling(n_sr), "\n")
cat("Proporcja, odsetek 0.50: n =", z2(n_p50), "->", ceiling(n_p50), "\n")
cat("Proporcja, odsetek 0.15: n =", z2(n_p15), "->", ceiling(n_p15), "\n")
cat("Z tablicową wartością 1.96: średnia =", z2((1.96 * 80 / 10)^2), "; odsetek 0.50:", z2(1.96^2 * 0.25 / 0.05^2),
    "; odsetek 0.15:", z2(1.96^2 * 0.15 * 0.85 / 0.05^2), "\n")
cat("Populacja N = 1200, odsetek 0.50: n =", z2(n_skon), "->", ceiling(n_skon), "\n")
cat("Kontrola: margines przy n = 385 i odsetku 0.50 =", z3(z95 * sqrt(0.25 / 385)), "\n")
cat("Błąd: podgrupa 120 osób z próby 385 ma margines =", z3(z95 * sqrt(0.25 / 120)), "\n\n")

# Zadanie 5. Kontrola masy opakowań kawy: H0: mu = 250 g, sigma = 4 g, n = 25, M = 248.2 g
mu0 <- 250; sigma5 <- 4; n5 <- 25; M5 <- 248.2
SE5 <- sigma5 / sqrt(n5); z5 <- (M5 - mu0) / SE5
cat("Zadanie 5\n")
cat("SE =", z2(SE5), "; z =", z2(z5), "; z krytyczne =", z3(qnorm(0.975)), "\n")
cat("p dwustronne =", bz(2 * pnorm(-abs(z5))), "; p jednostronne (mu < 250) =", bz(pnorm(z5)), "\n")
cat("Obszar przyjęcia H0 dla średniej z próby: [", z3(mu0 - qnorm(0.975) * SE5), ",", z3(mu0 + qnorm(0.975) * SE5), "]\n")
cat("95% CI dla mu = [", z2(M5 - qnorm(0.975) * SE5), ",", z2(M5 + qnorm(0.975) * SE5), "]\n")
cat("Przy alfa = .01: z krytyczne =", z3(qnorm(0.995)), "\n")
Wynik w R
Zadanie 1
SE = 2.50
90%: z krytyczne = 1.645 ; margines = 4.11 ; CI = [100.09, 108.31] ; szerokość = 8.22
95%: z krytyczne = 1.960 ; margines = 4.90 ; CI = [99.30, 109.10] ; szerokość = 9.80
99%: z krytyczne = 2.576 ; margines = 6.44 ; CI = [97.76, 110.64] ; szerokość = 12.88
Przy n = 144 (4 razy więcej): margines 95% = 2.45

Zadanie 2
n = 12 ; suma = 80 ; M = 6.667 ; SS = 11.167 ; SD = 1.008 ; SE = 0.291
t krytyczne (df = 11, 95%) = 2.201 ; margines = 0.640
95% CI = [ 6.03 , 7.31 ]
Kontrola t.test(): 6.03 7.31
Błąd: M ± 1.96 SD = [ 4.69 , 8.64 ]

Zadanie 3
x = 2, n = 20: odsetek = 0.100 ; SE Walda = 0.067
  Wald   [ -0.031 0.231 ]
  Wilson [ 0.028 0.301 ] ; środek Wilsona = 0.164
  Wilson krok po kroku: z^2/(2n) = 0.096 ; 1 + z^2/n = 1.192 ; połowa szerokości = 0.137
  Kontrola prop.test(correct = FALSE): 0.028 0.301
x = 20, n = 200: odsetek = 0.100 ; SE Walda = 0.021
  Wald   [ 0.058 0.142 ]
  Wilson [ 0.066 0.149 ] ; środek Wilsona = 0.108
  Wilson krok po kroku: z^2/(2n) = 0.010 ; 1 + z^2/n = 1.019 ; połowa szerokości = 0.042
  Kontrola prop.test(correct = FALSE): 0.066 0.149
Pokrycie przy n = 20 i odsetku 0.10: Wald = 0.876 ; Wilson = 0.957

Zadanie 4
Średnia: n = 245.85 -> zaokrąglij w górę: 246
Proporcja, odsetek 0.50: n = 384.15 -> 385
Proporcja, odsetek 0.15: n = 195.91 -> 196
Z tablicową wartością 1.96: średnia = 245.86 ; odsetek 0.50: 384.16 ; odsetek 0.15: 195.92
Populacja N = 1200, odsetek 0.50: n = 291.18 -> 292
Kontrola: margines przy n = 385 i odsetku 0.50 = 0.050
Błąd: podgrupa 120 osób z próby 385 ma margines = 0.089

Zadanie 5
SE = 0.80 ; z = -2.25 ; z krytyczne = 1.960
p dwustronne = .024 ; p jednostronne (mu < 250) = .012
Obszar przyjęcia H0 dla średniej z próby: [ 248.432 , 251.568 ]
95% CI dla mu = [ 246.63 , 249.77 ]
Przy alfa = .01: z krytyczne = 2.576
Zadania 6–10: test t, testy dla proporcji, test jednostronny i moc
R
# B380 – zadania 6–10: test t dla jednej średniej i przedział ufności, test dla jednej proporcji,
# test dla dwóch proporcji, test jednostronny a dwustronny, błąd II rodzaju i moc testu z
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))   # bez zera przed kropką (p, d)

# Zadanie 6. Czas odrabiania lekcji (minuty dziennie), 10 uczniów; H0: mu = 60
lekcje <- c(52, 61, 48, 55, 66, 50, 58, 45, 63, 54)
n6 <- length(lekcje); M6 <- mean(lekcje); SD6 <- sd(lekcje); SE6 <- SD6 / sqrt(n6)
t6 <- (M6 - 60) / SE6
cat("Zadanie 6\n")
cat("n =", n6, "; M =", z2(M6), "; SS =", z2(sum((lekcje - M6)^2)), "; SD =", z2(SD6), "; SE =", z2(SE6), "\n")
cat("t(", n6 - 1, ") =", z2(t6), "; t krytyczne 95% =", z3(qt(0.975, n6 - 1)), "; 99% =", z3(qt(0.995, n6 - 1)), "\n")
cat("p dwustronne =", bz(2 * pt(-abs(t6), n6 - 1)), "; d =", z2((M6 - 60) / SD6), "\n")
for (pu in c(0.95, 0.99)) {
  tk <- qt(1 - (1 - pu) / 2, n6 - 1)
  cat(sprintf("%.0f%% CI = [%s, %s]\n", 100 * pu, z2(M6 - tk * SE6), z2(M6 + tk * SE6)))
}
tt6 <- t.test(lekcje, mu = 60)
cat("Kontrola t.test(mu = 60): t =", z2(tt6$statistic), "; p =", bz(tt6$p.value), "; 95% CI [", z2(tt6$conf.int), "]\n\n")

# Zadanie 7. Absolwenci pracujący w zawodzie: 72 ze 120; H0: pi = 0.70
x7 <- 72; n7 <- 120; p0 <- 0.70; p7 <- x7 / n7
SE7 <- sqrt(p0 * (1 - p0) / n7); z7 <- (p7 - p0) / SE7
cat("Zadanie 7\n")
cat("odsetek =", z3(p7), "; SE przy H0 =", z3(SE7), "; z =", z2(z7), "; p dwustronne =", bz(2 * pnorm(-abs(z7))), "\n")
cat("Warunek n*pi0 =", n7 * p0, "; n*(1 - pi0) =", n7 * (1 - p0), "\n")
pt7 <- prop.test(x7, n7, p = p0, correct = FALSE)
cat("Kontrola prop.test(correct = FALSE): chi^2 =", z2(pt7$statistic), "(= z^2 =", z2(z7^2), "); p =", bz(pt7$p.value),
    "; 95% CI Wilsona [", z3(pt7$conf.int), "]\n")
cat("Test dokładny binom.test(): p =", bz(binom.test(x7, n7, p = p0)$p.value), "\n")
SEw <- sqrt(p7 * (1 - p7) / n7)
cat("Błąd: SE z p z próby zamiast pi0 =", z3(SEw), "; z =", z2((p7 - p0) / SEw), "\n\n")

# Zadanie 8. Zdawalność egzaminu: kurs online 43/56, kurs stacjonarny 31/54
x8 <- c(online = 43, stacjonarny = 31); n8 <- c(online = 56, stacjonarny = 54)
p8 <- x8 / n8; pw <- sum(x8) / sum(n8)
SE8 <- sqrt(pw * (1 - pw) * (1 / n8[1] + 1 / n8[2])); z8 <- unname((p8[1] - p8[2]) / SE8)
SEr <- sqrt(sum(p8 * (1 - p8) / n8))
cat("Zadanie 8\n")
cat("Odsetki:", z3(p8), "; różnica =", z3(p8[1] - p8[2]), "; wspólny odsetek =", z3(pw), "\n")
cat("SE (wspólny odsetek) =", z3(SE8), "; z =", z2(z8), "; p dwustronne =", bz(2 * pnorm(-abs(z8))), "\n")
cat("95% CI różnicy (Wald, SE bez łączenia =", z3(SEr), "): [", z3(p8[1] - p8[2] - qnorm(0.975) * SEr), ",",
    z3(p8[1] - p8[2] + qnorm(0.975) * SEr), "]\n")
pt8 <- prop.test(x8, n8, correct = FALSE)
cat("Kontrola prop.test(correct = FALSE): chi^2 =", z2(pt8$statistic), "; p =", bz(pt8$p.value), "\n")
pt8y <- prop.test(x8, n8)
cat("Domyślnie (poprawka Yatesa): chi^2 =", z2(pt8y$statistic), "; p =", bz(pt8y$p.value),
    "; dokładniej p =", sub("^0", "", formatC(pt8y$p.value, format = "f", digits = 4)), "\n")
cat("Najmniejsza liczność oczekiwana =", z2(min(outer(n8, c(pw, 1 - pw)))), "\n\n")

# Zadanie 9. Program korepetycji: n = 20, M = 63.6, SD = 8.5; H0: mu = 60
n9 <- 20; M9 <- 63.6; SD9 <- 8.5; SE9 <- SD9 / sqrt(n9)
t9 <- (M9 - 60) / SE9
cat("Zadanie 9\n")
cat("SE =", z3(SE9), "; t(19) =", z3(t9), "\n")
cat("t krytyczne: dwustronne =", z3(qt(0.975, 19)), "; jednostronne =", z3(qt(0.95, 19)), "\n")
cat("p dwustronne =", bz(2 * pt(-abs(t9), 19)), "; p jednostronne (mu > 60) =", bz(pt(t9, 19, lower.tail = FALSE)), "\n")
t9b <- (56.4 - 60) / SE9
cat("Gdyby M = 56.4: t =", z3(t9b), "; p jednostronne (mu > 60) =", bz(pt(t9b, 19, lower.tail = FALSE)), "\n\n")

# Zadanie 10. Moc testu z zadania 5: H0: mu = 250, sigma = 4, n = 25, alfa = .05 (dwustronnie); H1: mu = 248
mu0 <- 250; mu1 <- 248; sigma <- 4; n10 <- 25; SE10 <- sigma / sqrt(n10)
gr <- mu0 + c(-1, 1) * qnorm(0.975) * SE10
beta <- pnorm(gr[2], mu1, SE10) - pnorm(gr[1], mu1, SE10)
cat("Zadanie 10\n")
cat("Granice obszaru przyjęcia H0: [", z3(gr), "]\n")
cat("z dla dolnej granicy przy mu = 248:", z3((gr[1] - mu1) / SE10), "; dla górnej:", z3((gr[2] - mu1) / SE10), "\n")
cat("Phi(4.460) =", z3(pnorm((gr[2] - mu1) / SE10)), "; Phi(0.540) =", z3(pnorm((gr[1] - mu1) / SE10)), "\n")
cat("beta =", z3(beta), "; moc =", z3(1 - beta), "\n")
moc_z <- function(n, delta = 2, s = 4, alfa = 0.05) {
  se <- s / sqrt(n); zk <- qnorm(1 - alfa / 2)
  pnorm(-zk + delta / se) + pnorm(-zk - delta / se)
}
cat("Moc przy alfa = .01:", z3(moc_z(25, alfa = 0.01)), "; przy n = 50:", z3(moc_z(50)), "; dla mu = 249:", z3(moc_z(25, delta = 1)), "\n")
n_80 <- ((qnorm(0.975) + qnorm(0.80)) * sigma / (mu0 - mu1))^2
cat("z dla 1 - beta = .80:", z3(qnorm(0.80)), "; n dla mocy .80 =", z2(n_80), "->", ceiling(n_80), "; moc przy n = 32:", z3(moc_z(32)), "\n")
set.seed(380)
sym <- replicate(10000, { m <- mean(rnorm(n10, mu1, sigma)); abs((m - mu0) / SE10) > qnorm(0.975) })
sym0 <- replicate(10000, { m <- mean(rnorm(n10, mu0, sigma)); abs((m - mu0) / SE10) > qnorm(0.975) })
cat("Symulacja 10 000 prób: odsetek odrzuceń H0 przy mu = 248 =", z3(mean(sym)), "; przy mu = 250 =", z3(mean(sym0)), "\n")
Wynik w R
Zadanie 6
n = 10 ; M = 55.20 ; SS = 413.60 ; SD = 6.78 ; SE = 2.14
t( 9 ) = -2.24 ; t krytyczne 95% = 2.262 ; 99% = 3.250
p dwustronne = .052 ; d = -0.71
95% CI = [50.35, 60.05]
99% CI = [48.23, 62.17]
Kontrola t.test(mu = 60): t = -2.24 ; p = .052 ; 95% CI [ 50.35 60.05 ]

Zadanie 7
odsetek = 0.600 ; SE przy H0 = 0.042 ; z = -2.39 ; p dwustronne = .017
Warunek n*pi0 = 84 ; n*(1 - pi0) = 36
Kontrola prop.test(correct = FALSE): chi^2 = 5.71 (= z^2 = 5.71 ); p = .017 ; 95% CI Wilsona [ 0.511 0.683 ]
Test dokładny binom.test(): p = .022
Błąd: SE z p z próby zamiast pi0 = 0.045 ; z = -2.24

Zadanie 8
Odsetki: 0.768 0.574 ; różnica = 0.194 ; wspólny odsetek = 0.673
SE (wspólny odsetek) = 0.089 ; z = 2.17 ; p dwustronne = .030
95% CI różnicy (Wald, SE bez łączenia = 0.088 ): [ 0.022 , 0.366 ]
Kontrola prop.test(correct = FALSE): chi^2 = 4.69 ; p = .030
Domyślnie (poprawka Yatesa): chi^2 = 3.85 ; p = .050 ; dokładniej p = .0497
Najmniejsza liczność oczekiwana = 17.67

Zadanie 9
SE = 1.901 ; t(19) = 1.894
t krytyczne: dwustronne = 2.093 ; jednostronne = 1.729
p dwustronne = .074 ; p jednostronne (mu > 60) = .037
Gdyby M = 56.4: t = -1.894 ; p jednostronne (mu > 60) = .963

Zadanie 10
Granice obszaru przyjęcia H0: [ 248.432 251.568 ]
z dla dolnej granicy przy mu = 248: 0.540 ; dla górnej: 4.460
Phi(4.460) = 1.000 ; Phi(0.540) = 0.705
beta = 0.295 ; moc = 0.705
Moc przy alfa = .01: 0.470 ; przy n = 50: 0.942 ; dla mu = 249: 0.240
z dla 1 - beta = .80: 0.842 ; n dla mocy .80 = 31.40 -> 32 ; moc przy n = 32: 0.807
Symulacja 10 000 prób: odsetek odrzuceń H0 przy mu = 248 = 0.702 ; przy mu = 250 = 0.052
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Kiedy w zadaniu użyć rozkładu z, a kiedy t?
Rozkład z stosujesz, gdy odchylenie standardowe populacji σ jest znane spoza próby (z norm testu, dokumentacji maszyny) – jak w zadaniach 1 i 5. Gdy σ szacujesz z tych samych danych, używasz rozkładu t z n − 1 stopniami swobody (zadania 2, 6 i 9). Przy dużych próbach oba rozkłady prawie się pokrywają, ale na kolokwium liczy się poprawny wybór.
Dlaczego przedział Walda dla proporcji może mieć ujemną granicę?
Bo jest symetryczny wokół odsetka z próby, a przy małym n i odsetku blisko 0 (lub 1) margines bywa większy niż sam odsetek. W zadaniu 3 dla 2 rezygnacji na 20 osób Wald daje [−.031, .231]. Przedział Wilsona [.028, .301] mieści się w zakresie 0–1 i ma pokrycie bliższe deklarowanym 95%.
Dlaczego liczebność próby zaokrągla się zawsze w górę?
Bo wzór podaje minimalną liczbę osób, przy której margines nie przekracza założonej wartości. Wynik 384.16 zaokrąglony w dół do 384 dałby margines minimalnie większy niż ±5 punktów procentowych, a w górę do 385 – spełnia warunek. Pamiętaj też, że to liczba ankiet zwróconych, a nie wysłanych.
Czy przedział ufności i test zawsze dają tę samą odpowiedź?
Tak, jeśli liczysz je tą samą metodą i na tym samym poziomie: dwustronny test na α = .05 odrzuca H0 dokładnie wtedy, gdy wartość z H0 leży poza 95% przedziałem. Różnice pojawiają się przy proporcjach, gdy test liczysz z SE z H0, a przedział metodą Walda; przedział Wilsona zawsze zgadza się z testem score (zadanie 7).
Jak policzyć moc testu na kolokwium bez programu?
Wyznacz granice obszaru przyjęcia H0 w jednostkach oryginalnej zmiennej, przelicz je na wyniki z względem średniej z hipotezy alternatywnej i odczytaj z tablicy pole między nimi – to β. Moc to 1 − β. W zadaniu 10 wychodzi β = .295 i moc .705.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →PoradnikHipotezy H0 i H1 – jak je zapisać?
Od hipotezy badawczej do H0 i H1: parametr populacji, zapis jedno- i dwustronny, tabela dla popularnych analiz i pułapka testu Manna–Whitneya.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Masz własne dane i nie wiesz, jaki przedział lub test policzyć?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A., & Coull, B. A. (1998). Approximate is better than “exact” for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009 ● Otwarty dostęp
Cytowania BibTeX
@article{agresti1998approximate, author={Agresti, Alan and Coull, Brent A.}, title={{Approximate is better than “exact” for interval estimation of binomial proportions}}, journal={The American Statistician}, year={1998}, volume={52}, number={2}, pages={119--126}, doi={10.1080/00031305.1998.10480550}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{neyman1933problem, author={Neyman, Jerzy and Pearson, Egon S.}, title={{On the problem of the most efficient tests of statistical hypotheses}}, journal={Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character}, year={1933}, volume={231}, number={694–706}, pages={289--337}, doi={10.1098/rsta.1933.0009}}