Pytania na egzamin ze statystyki z odpowiedziami – spis działów
Zebraliśmy tu pytania na egzamin ze statystyki z odpowiedziami w formie, w jakiej padają na egzaminie ustnym i w części teoretycznej egzaminu pisemnego na 1. i 2. roku: „co to jest…”, „kiedy stosujemy…”, „czym różni się…”. Każda odpowiedź ma 1–4 zdania, które możesz nauczyć się prawie na pamięć, a przy części pytań jest mały przykład liczbowy. Pytania o analizy z własnej pracy dyplomowej są w osobnym tekście: pytania ze statystyki na obronę pracy magisterskiej.
| Dział | Pytań | Przykładowe zagadnienia |
|---|---|---|
| 1. Skale pomiarowe i zmienne | 7 | skala nominalna, porządkowa, ilościowa; Likert; zmienna zależna |
| 2. Statystyki opisowe | 9 | średnia a mediana, SD z n − 1, IQR, współczynnik zmienności, skośność |
| 3. Rozkłady i prawdopodobieństwo | 7 | rozkład normalny, wynik z, rozkład dwumianowy, CTG, rozkład t |
| 4. Estymacja | 6 | błąd standardowy, przedział ufności dla średniej i proporcji |
| 5. Testowanie hipotez | 9 | H0 i H1, wartość p, α, błędy I i II rodzaju, moc, test jednostronny |
| 6. Wybór testu | 7 | próby zależne i niezależne, test nieparametryczny, ANOVA, χ² |
| 7. Korelacja i regresja | 7 | Pearson a Spearman, istotność r, równanie regresji, R² |
| 8. Wielkość efektu i raportowanie | 6 | d Cohena, miary efektu, zapis APA, wynik nieistotny |
| 9. Pytania „wyjaśnij różnicę” | 8 | SD a SE, parametr a statystyka, istotność statystyczna a praktyczna |
Liczby w przykładach policzono w R – kod jest na końcu wpisu. Wyniki zapisujemy z kropką dziesiętną, jak w stylu APA i w wydrukach programów statystycznych. Zakres egzaminu zależy od prowadzącego, więc porównaj tę listę z sylabusem; szerszy wykład tych zagadnień znajdziesz w podręcznikach, np. u Kinga i Minium (2009).
1. Skale pomiarowe i zmienne
Jakie są skale pomiarowe?
Według klasycznego podziału Stevensa (1946) są cztery: nominalna (kategorie bez kolejności), porządkowa (kategorie uporządkowane), interwałowa (równe odstępy, umowne zero) i ilorazowa (równe odstępy i zero bezwzględne). Dwie ostatnie łączy się często jako skalę ilościową.
Na jakiej skali mierzymy wykształcenie, płeć, temperaturę w °C i wiek?
Płeć – nominalna, wykształcenie – porządkowa, temperatura w °C – interwałowa (0°C nie oznacza braku temperatury), wiek w latach – ilorazowa (40 lat to dwa razy więcej niż 20).
Dlaczego dla płci zakodowanej jako 1 i 2 nie liczy się średniej?
Bo kody są tylko etykietami: równie dobrze można by wpisać 7 i 3, więc średnia z takich kodów nic nie znaczy. Dla zmiennej nominalnej podaje się liczebności i procenty.
Czym różni się zmienna ciągła od dyskretnej?
Zmienna ciągła może przyjąć dowolną wartość z przedziału (czas reakcji, wzrost), a dyskretna – tylko wartości oddzielne, zwykle liczby całkowite (liczba dzieci, liczba poprawnych odpowiedzi).
Co to jest zmienna zależna i niezależna?
Zmienna niezależna to ta, której wpływ lub związek badamy (np. metoda nauczania), a zależna – wynik, który mierzymy (np. wynik testu). W badaniu bez manipulacji mówi się raczej o predyktorze i zmiennej objaśnianej.
Czy wynik ze skali Likerta to zmienna ilościowa?
Pojedyncza pozycja (1–5) jest porządkowa. Suma lub średnia z kilku pozycji jest zwykle traktowana jako ilościowa, ale warto umieć to uzasadnić – pisze o tym tekst czy skala Likerta jest ilościowa.
Dlaczego skala pomiarowa decyduje o wyborze statystyki?
Bo każda skala dopuszcza inne operacje: dla nominalnej sensowne są tylko częstości i dominanta, dla porządkowej – także mediana i korelacja rang, a średnia, SD i test t wymagają równych odstępów, czyli skali ilościowej.
2. Statystyki opisowe
Przykład do całego działu: siedem osób uczyło się do egzaminu odpowiednio 2, 3, 3, 4, 5, 6 i 19 godzin w tygodniu.
Kiedy lepiej podać medianę niż średnią?
Gdy rozkład jest wyraźnie skośny albo są wartości odstające. W przykładzie średnia wynosi 6.00 godziny, a mediana 4; bez osoby z 19 godzinami średnia spada do 3.83, a mediana tylko do 3.5. Mediana jest odporna na wartości skrajne, średnia – nie.
Co to jest dominanta?
Wartość występująca najczęściej – w przykładzie 3 godziny. To jedyna miara tendencji centralnej, którą można podać dla zmiennej nominalnej (np. najczęściej wybierany kierunek studiów).
Co mierzy odchylenie standardowe?
Odchylenie standardowe mówi, o ile średnio wyniki odchylają się od średniej, w jednostkach pomiaru. W przykładzie SD = 5.89 godziny – rozrzut jest duży w porównaniu ze średnią 6.00.
Dlaczego we wzorze na SD z próby dzieli się przez n − 1?
Bo odchylenia liczymy od średniej z próby, a nie od nieznanej średniej populacji, więc suma kwadratów jest trochę za mała; dzielenie przez n − 1 to koryguje i daje nieobciążony estymator wariancji. W przykładzie daje to 5.89, a dzielenie przez n – 5.45.
Czym jest wariancja i dlaczego częściej podaje się SD?
Wariancja to średni kwadrat odchyleń od średniej, a SD – pierwiastek z wariancji. Wariancja jest w jednostkach do kwadratu (godziny²), dlatego do opisu danych używa się SD, a wariancja pojawia się we wzorach, np. w ANOVA.
Co to jest rozstęp ćwiartkowy (IQR)?
Różnica między trzecim a pierwszym kwartylem, czyli zakres środkowych 50% wyników. W przykładzie Q1 = 3, Q3 = 5.5, więc IQR = 2.5, podczas gdy rozstęp (19 − 2) wynosi aż 17. Programy liczą kwartyle według różnych definicji, więc wynik z tablicy i z R może się nieco różnić.
Do czego służy współczynnik zmienności?
Do porównania rozrzutu zmiennych o różnych średnich lub jednostkach: CV = SD / średnia × 100%. W przykładzie CV = 98.13%, czyli zmienność bardzo duża. Ma sens tylko dla skali ilorazowej z dodatnimi wartościami.
Co znaczy, że rozkład jest prawoskośny?
Że ma długi „ogon” w stronę wysokich wartości: większość wyników jest niska, a nieliczne bardzo wysokie. Wtedy zwykle średnia jest większa od mediany – jak w przykładzie (6.00 a 4) – a współczynnik skośności jest dodatni.
Jakie statystyki opisowe podać dla zmiennej porządkowej?
Liczebności i procenty w każdej kategorii, medianę i rozstęp ćwiartkowy. Średnią i SD podaje się dla porządkowych pozycji najwyżej pomocniczo, jeśli tak przyjęto w danej dziedzinie.
3. Rozkłady i prawdopodobieństwo
Jakie cechy ma rozkład normalny?
Jest symetryczny i jednomodalny, a średnia, mediana i dominanta są równe. W odległości ±1 SD od średniej leży 68.27% wyników, ±2 SD – 95.45%, a ±3 SD – 99.73%. Zob. rozkład normalny.
Co to jest wynik z?
Wynik wyrażony w odchyleniach standardowych od średniej: z = (x − M) / SD. Przy IQ o średniej 100 i SD 15 wynik 115 to z = 1. Dzięki temu można porównywać wyniki z różnych testów.
Jaki odsetek osób ma IQ powyżej 130?
IQ 130 to z = 2, a powyżej tej wartości leży 2.28% rozkładu normalnego. Z tablicy dystrybuanty rozkładu normalnego odczytuje się pole na lewo od z = 2 i odejmuje je od 1.
Kiedy stosuje się rozkład dwumianowy?
Gdy liczymy sukcesy w n niezależnych próbach o tym samym prawdopodobieństwie sukcesu. Przy zgadywaniu w teście 10 pytań z czterema odpowiedziami oczekiwana liczba trafień to 2.5, a prawdopodobieństwo co najmniej 6 trafień wynosi 0.020 – zob. rozkład dwumianowy.
Co mówi centralne twierdzenie graniczne?
Że rozkład średnich z wielu prób zbliża się do normalnego, gdy liczebność próby rośnie, nawet jeśli sama zmienna nie ma rozkładu normalnego. Dlatego testy oparte na średnich działają dobrze przy większych próbach – więcej w tekście o centralnym twierdzeniu granicznym.
Czym różni się rozkład t od normalnego?
Rozkład t ma grubsze ogony i zależy od liczby stopni swobody; im większe df, tym bardziej przypomina normalny. Dlatego wartość krytyczna dla 95% wynosi 1.960 w rozkładzie normalnym, a 2.064 w rozkładzie t z 24 stopniami swobody.
Co to jest rozkład z próby (rozkład próbkowy)?
Rozkład wartości statystyki – np. średniej – w wielu hipotetycznych próbach z tej samej populacji. Jego odchylenie standardowe to błąd standardowy, na którym opierają się przedziały ufności i testy.
4. Estymacja
Czym różni się estymacja punktowa od przedziałowej?
Estymacja punktowa podaje jedną liczbę jako oszacowanie parametru (np. średnia z próby 50), a przedziałowa – zakres wartości zgodnych z danymi wraz z poziomem ufności (np. 95% CI [45.87, 54.13]).
Co to jest błąd standardowy średniej i jak go policzyć?
To odchylenie standardowe rozkładu średnich z prób: SE = SD / √n. Przy SD = 10 i n = 25 wynosi 10 / 5 = 2. Mówi, jak bardzo średnia z próby mogłaby się zmieniać między próbami – zob. błąd standardowy.
Jak policzyć 95% przedział ufności dla średniej?
Średnia ± wartość krytyczna t × SE. Przy M = 50, SD = 10, n = 25: 50 ± 2.064 × 2, czyli 95% CI [45.87, 54.13]. Przy dużej próbie wartość krytyczna zbliża się do 1.96.
Co znaczy „95% ufności”?
Że metoda budowania przedziału w 95% prób daje przedział zawierający prawdziwy parametr. W symulacji 1000 prób po 25 osób 952 przedziały (95.20%) objęły prawdziwą średnią 100. Nie znaczy to, że konkretny, już policzony przedział zawiera parametr z prawdopodobieństwem 95% (Greenland i in., 2016) – zob. przedział ufności.
Od czego zależy szerokość przedziału ufności?
Od rozrzutu danych (SD), liczebności próby i poziomu ufności. Czterokrotnie większa próba zmniejsza przedział mniej więcej o połowę: przy n = 100 i tym samym SD przedział to [48.02, 51.98] zamiast [45.87, 54.13]. Przedział 99% jest szerszy niż 95%.
Jak oszacować odsetek w populacji?
Przedziałem ufności dla proporcji. Jeśli 120 z 400 badanych pracuje w trakcie studiów, odsetek wynosi 30.00%, a 95% przedział Wilsona – [25.72%, 34.66%]. Przy małej próbie lub odsetku bliskim 0 albo 100% lepiej nie używać najprostszego wzoru Walda.
5. Testowanie hipotez
Co to są hipoteza zerowa i alternatywna?
Hipoteza zerowa (H0) mówi o braku różnicy lub związku w populacji (np. μ1 = μ2), a alternatywna (H1) – że różnica lub związek istnieje. Test sprawdza, czy dane są wystarczająco niezgodne z H0, by ją odrzucić.
Co oznacza wartość p?
To prawdopodobieństwo otrzymania wyniku co najmniej tak skrajnego jak w próbie, gdyby H0 była prawdziwa (i spełnione były założenia testu). Małe p oznacza, że dane słabo pasują do H0 (Wasserstein i Lazar, 2016) – zob. wartość p.
Czego wartość p nie mówi?
Nie jest prawdopodobieństwem, że H0 jest prawdziwa, ani że wynik jest przypadkowy; nie mówi też, jak duży jest efekt ani czy jest ważny. Te nieporozumienia omawiają szczegółowo Greenland i in. (2016).
Co to jest poziom istotności α?
Próg ustalony przed badaniem, poniżej którego odrzucamy H0 – najczęściej .05. Jest to zarazem dopuszczalne ryzyko błędu I rodzaju.
Czym jest błąd I i II rodzaju?
Błąd I rodzaju to odrzucenie prawdziwej H0 („fałszywy alarm”), a błąd II rodzaju – nieodrzucenie fałszywej H0 („przeoczenie efektu”). W symulacji 1000 testów t przy prawdziwej H0 46 dało p < .05, czyli 4.60% – blisko założonego α. Zob. błąd pierwszego i drugiego rodzaju.
Co to jest moc testu?
Prawdopodobieństwo odrzucenia H0, gdy jest fałszywa, czyli 1 − β. Dla dwóch grup po 20 osób i średniego efektu (d = 0.5) moc wynosi tylko .34, a do mocy .80 potrzeba 64 osób w grupie – takie tabele podaje Cohen (1992). Zob. moc testu.
Od czego zależy moc testu?
Od wielkości efektu, liczebności próby, poziomu α i rozrzutu danych. W symulacji dwóch grup po 30 osób z różnicą d = 0.5 test był istotny w 46.20% powtórzeń, a wzór daje moc .48 – połowa takich badań przeoczyłaby prawdziwy efekt.
Czym różni się test jednostronny od dwustronnego?
Dwustronny wykrywa różnicę w obu kierunkach, jednostronny – tylko w kierunku zapowiedzianym przed badaniem. Przy t(24) = 2.10 p dwustronne wynosi .046, a jednostronne .023; wartość krytyczna z to 1.960 albo 1.645. Zob. test jednostronny i dwustronny.
Czy nieodrzucenie H0 oznacza, że H0 jest prawdziwa?
Nie. Wynik nieistotny znaczy tylko, że dane nie dały wystarczających podstaw do odrzucenia H0; przy małej mocy łatwo przeoczyć prawdziwy efekt. Dlatego mówimy „nie ma podstaw do odrzucenia H0”, a nie „H0 została potwierdzona”.
6. Wybór testu
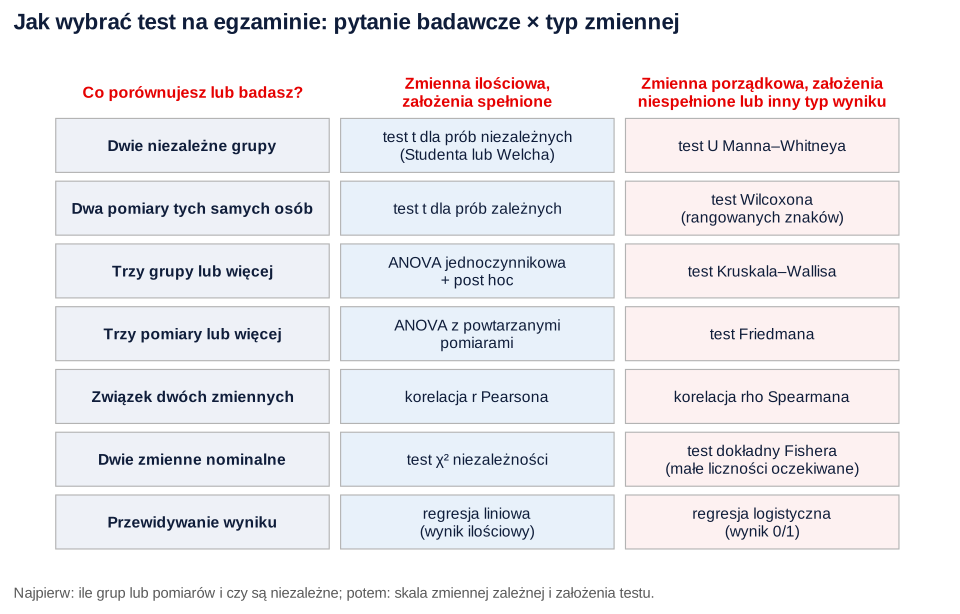
Od czego zależy wybór testu statystycznego?
Od pytania badawczego (różnica czy związek), liczby porównywanych grup lub pomiarów, tego, czy próby są zależne, oraz od skali zmiennej zależnej i spełnienia założeń (Rysunek 1). Szerzej – w tekście jak dobrać test statystyczny do hipotezy.
Czym różnią się próby zależne od niezależnych?
Próby niezależne to różne osoby w każdej grupie (kobiety i mężczyźni), a zależne – te same osoby mierzone dwukrotnie albo dobrane w pary (pomiar przed i po zajęciach). Dla prób zależnych stosuje się m.in. test t dla prób zależnych, który analizuje różnice w parach.
Jakie są założenia testu t dla prób niezależnych?
Niezależność obserwacji, zmienna zależna na skali ilościowej, rozkład w grupach zbliżony do normalnego (mniej ważne przy większych grupach) i równe wariancje. Gdy wariancje się różnią, używa się wersji Welcha.
Kiedy wybrać test nieparametryczny?
Gdy zmienna jest porządkowa albo gdy przy małej próbie rozkład jest silnie skośny lub ma wartości odstające. Na przykład zamiast testu t dla dwóch niezależnych grup – test U Manna–Whitneya, który porównuje rangi, a nie średnie.
Dlaczego przy trzech grupach nie robi się trzech testów t?
Bo każdy test niesie ryzyko błędu I rodzaju, które się sumuje: przy trzech niezależnych testach na poziomie .05 szansa co najmniej jednego fałszywego alarmu wynosi 14.26%. ANOVA sprawdza jedną hipotezę o wszystkich średnich, a porównania parami robi się potem testami post hoc z kontrolą błędu.
Co sprawdza test chi-kwadrat niezależności i ile ma stopni swobody?
Czy dwie zmienne nominalne są ze sobą powiązane, porównując liczności obserwowane z oczekiwanymi przy braku związku. Stopnie swobody to (wiersze − 1)(kolumny − 1): dla tabeli 3 × 4 jest to 6, a wartość krytyczna przy α = .05 wynosi 12.59. Zob. test chi-kwadrat niezależności.
Kiedy zamiast chi-kwadrat używa się testu dokładnego Fishera?
Gdy liczności oczekiwane są małe – według popularnej reguły, gdy w więcej niż 20% komórek są mniejsze niż 5. Najczęściej dotyczy to tabeli 2 × 2 przy małej próbie.
7. Korelacja i regresja
Co mierzy współczynnik korelacji Pearsona?
Siłę i kierunek związku liniowego między dwiema zmiennymi ilościowymi; przyjmuje wartości od −1 do 1. Wartość bliska zera nie wyklucza związku nieliniowego (np. w kształcie litery U) – dlatego zawsze warto obejrzeć wykres rozrzutu. Zob. korelacja Pearsona.
Kiedy zamiast Pearsona liczy się korelację Spearmana?
Gdy co najmniej jedna zmienna jest porządkowa, związek jest monotoniczny, ale nieliniowy, albo są wartości odstające. Korelacja Spearmana to korelacja Pearsona policzona na rangach.
Czy korelacja r = .30 jest istotna?
Zależy od liczebności. Przy n = 50 statystyka testowa wynosi t(48) = 2.18, p = .034, więc tak; ta sama korelacja przy 20 osobach daje t(18) = 1.33, p = .199 i nie jest istotna. Kwadrat korelacji r² = .09 oznacza, że zmienne mają 9% wspólnej wariancji.
Czy silna korelacja dowodzi związku przyczynowego?
Nie. Związek może wynikać z trzeciej zmiennej wpływającej na obie, z odwrotnego kierunku zależności albo z przypadku. Przyczynowość uzasadnia dopiero plan badania, najlepiej eksperyment z losowym przydziałem – zob. korelacja a przyczynowość.
Jak interpretować równanie regresji liniowej?
W równaniu wynik = 40 + 3 × godziny stała 40 to przewidywany wynik przy zerze godzin nauki, a współczynnik 3 – o ile średnio rośnie wynik, gdy liczba godzin wzrośnie o jedną. Dla 6 godzin przewidywany wynik to 58 punktów. Zob. regresja liniowa.
Co oznacza współczynnik determinacji R²?
Jaką część zmienności zmiennej zależnej wyjaśnia model. R² = .09 oznacza 9% wyjaśnionej wariancji; w regresji z jednym predyktorem R² to kwadrat korelacji Pearsona. Zob. R kwadrat.
Co to jest reszta w regresji?
Różnica między wartością zaobserwowaną a przewidzianą przez model. Metoda najmniejszych kwadratów dobiera prostą tak, aby suma kwadratów reszt była najmniejsza; na rozkładzie reszt sprawdza się założenia regresji.
8. Wielkość efektu i raportowanie
Po co podawać wielkość efektu, skoro mamy wartość p?
Bo p zależy od liczebności, a wielkość efektu mówi, jak duża jest różnica lub związek. Przy dwóch grupach po 5000 osób różnica 0.75 punktu na skali o SD = 15 daje t(9998) = 2.50, p = .012, ale d = 0.05 – wynik istotny, a efekt znikomy.
Jak interpretować d Cohena?
d to różnica średnich wyrażona w odchyleniach standardowych. Według umownych progów Cohena (1992) 0.2 to efekt mały, 0.5 – średni, 0.8 – duży, ale progi te są tylko orientacyjne. Zob. d Cohena – interpretacja.
Jaką miarę efektu podać przy danym teście?
Przy teście t – d Cohena, przy ANOVA – η² lub ω², przy chi-kwadrat – φ albo V Craméra, przy korelacji – samo r, przy regresji – R² i współczynniki, przy testach nieparametrycznych – np. r = Z / √N.
Jak zapisać wynik testu w stylu APA?
Symbol statystyki kursywą, stopnie swobody w nawiasie, wartość, dokładne p i wielkość efektu, np. t(24) = 2.10, p = .046. Przed wynikiem testu podaje się średnie i SD grup. Więcej wzorów w tekście jak opisać wyniki w stylu APA.
Dlaczego p zapisuje się bez zera przed kropką?
Bo w stylu APA nie pisze się zera przed kropką dla wartości, które nie mogą przekroczyć 1: p, r, α, R². Gdy p jest bardzo małe, pisze się p < .001, a nie p = .000.
Jak opisać wynik nieistotny?
Tak samo jak istotny: statystyka, df, dokładne p i wielkość efektu z przedziałem ufności. Szeroki przedział pokazuje, że dane są zgodne zarówno z brakiem efektu, jak i z efektem praktycznie ważnym.
9. Pytania „wyjaśnij różnicę”
Czym różni się odchylenie standardowe od błędu standardowego?
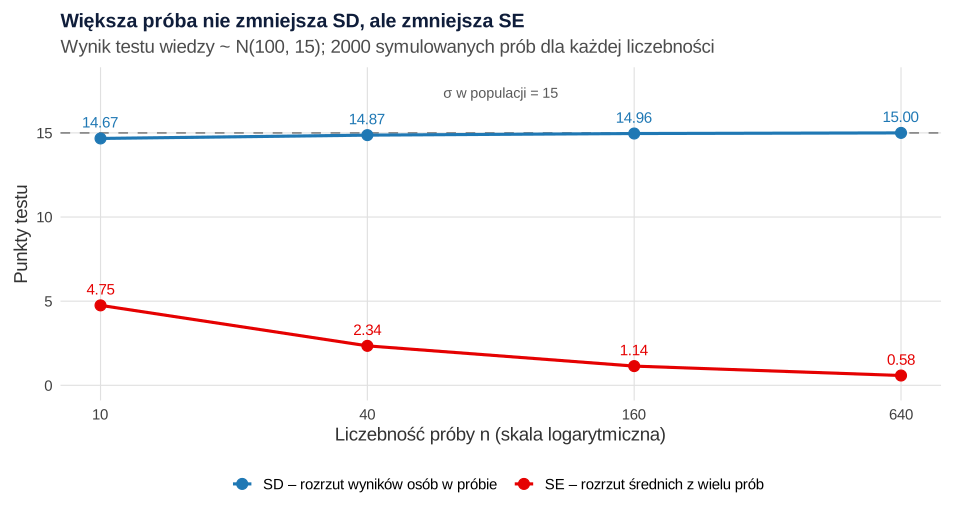
SD opisuje rozrzut wyników osób w próbie, a SE – niepewność oszacowania średniej (Altman i Bland, 2005). Ze wzrostem próby SD się nie zmienia, a SE maleje: w symulacji średnie SD wynosiło od 14.67 do 15.00 przy każdym n, a rozrzut średnich spadał z 4.75 przy n = 10 do 0.58 przy n = 640 (Rysunek 2).
Czym różni się parametr od statystyki?
Parametr opisuje populację i zwykle jest nieznany (μ, σ, ρ), a statystyka jest liczona z próby (M, SD, r) i służy do oszacowania parametru. Statystyka zmienia się od próby do próby, parametr – nie.
Czym różni się statystyka opisowa od wnioskowania statystycznego?
Statystyka opisowa streszcza zebrane dane (średnie, SD, procenty, wykresy), a wnioskowanie statystyczne pozwala na ich podstawie mówić o populacji: estymować parametry i testować hipotezy, z podaniem niepewności.
Czym różni się test parametryczny od nieparametrycznego?
Test parametryczny zakłada określony rozkład w populacji (zwykle normalny) i dotyczy parametrów, np. średnich. Test nieparametryczny ma słabsze założenia i zwykle opiera się na rangach – zob. testy nieparametryczne. Przy spełnionych założeniach test parametryczny ma zwykle nieco większą moc.
Czym różni się istotność statystyczna od praktycznej?
Istotność statystyczna mówi, czy wynik jest mało zgodny z H0, a praktyczna – czy efekt jest na tyle duży, by miał znaczenie w realnym świecie. Przy bardzo dużej próbie nawet znikoma różnica (d = 0.05 w przykładzie z działu 8) bywa istotna statystycznie.
Czym różni się korelacja od regresji?
Korelacja opisuje siłę i kierunek związku i jest symetryczna (r między X i Y jest taki sam jak między Y i X). Regresja wyróżnia zmienną zależną i opisuje, jak zmienia się ona wraz z predyktorem, co pozwala przewidywać wartości.
Czym różni się przedział ufności od wartości p?
Wartość p odpowiada na pytanie, czy dane są zgodne z jedną wartością (zwykle zerem), a przedział ufności pokazuje cały zakres wartości parametru zgodnych z danymi, a więc także wielkość efektu i precyzję. Jeśli 95% CI dla różnicy nie zawiera zera, test dwustronny na poziomie .05 jest istotny.
Czym różni się odrzucenie H0 od udowodnienia hipotezy badawczej?
Odrzucenie H0 oznacza tylko, że dane są mało prawdopodobne przy braku efektu; nie dowodzi, że prawdziwe jest konkretne wyjaśnienie teoretyczne. Hipotezę badawczą wspiera wynik w połączeniu z planem badania, wielkością efektu i powtórzeniami w innych badaniach.
Jak się uczyć do egzaminu ze statystyki
- Ucz się parami pojęć. Większość pytań ustnych to „czym różni się…” – dział 9 i pary z innych działów (średnia i mediana, błąd I i II rodzaju, test jedno- i dwustronny) dają gotowy szkielet odpowiedzi.
- Do każdej definicji dopisz liczbę. Odpowiedź z przykładem („SE = 10 / √25 = 2”) brzmi pewniej i pokazuje, że rozumiesz wzór.
- Policz zadania, nie tylko czytaj. Teoria utrwala się przy rozwiązywaniu – skorzystaj ze zbiorów zadań poniżej i sprawdzaj wyniki w programie.
- Naucz się czytać tablice. Wartości krytyczne z, t, χ² i F odczytasz z tablic rozkładów; zapamiętaj 1.96 i 1.645.
- Mów odpowiedzi na głos. Na egzaminie ustnym liczy się płynność: definicja, przykład, jedno zdanie o tym, kiedy to stosujemy.
Zbiory zadań do przećwiczenia
Każdy dział teorii ma swój zbiór zadań z rozwiązaniami krok po kroku:
- statystyka opisowa – zadania z rozwiązaniami (działy 1–2),
- prawdopodobieństwo i rozkłady – zadania (dział 3),
- estymacja i testowanie hipotez – zadania (działy 4–5),
- korelacja i regresja – zadania (dział 7),
- testy nieparametryczne – zadania (dział 6),
- statystyka medyczna – zadania dla pielęgniarstwa,
- zadania ze statystyki na psychologii – przekrój całego materiału w 10 zadaniach.
Kod R: skąd pochodzą liczby w odpowiedziach
Dwa krótkie przepisy w bazowym R liczą wszystkie liczby z przykładów. Pierwszy działa na danych wpisanych na sztywno (godziny nauki, IQ, test wyboru, przedział ufności, wartości p, moc, korelacja), drugi to symulacje: SD a SE, co znaczy „95% ufności” i jak często test myli się przy prawdziwej H0. Możesz zmieniać liczby w kodzie i sprawdzać, jak zmieniają się wyniki. Rysunki przygotowano w osobnym skrypcie na tych samych danych.
Część 1: liczby do przykładów w odpowiedziach
R
# B384 – liczby do przykładów w odpowiedziach na egzamin ze statystyki (bazowy R, dane wpisane na sztywno)
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
pp <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0\\.", ".", z3(p)))

cat("1. Statystyki opisowe: godziny nauki w tygodniu przed egzaminem (7 osób)\n")
x <- c(2, 3, 3, 4, 5, 6, 19)
cat("Średnia =", z2(mean(x)), "; mediana =", median(x), "; dominanta =", names(which.max(table(x))), "\n")
cat("Bez osoby z 19 h: średnia =", z2(mean(x[-7])), "; mediana =", median(x[-7]), "\n")
cat("SD (n − 1) =", z2(sd(x)), "; SD (n) =", z2(sqrt(mean((x - mean(x))^2))), "\n")
cat("Rozstęp =", diff(range(x)), "; IQR (type = 7) =", IQR(x), "; Q1 =", quantile(x, .25), "; Q3 =", quantile(x, .75), "\n")
cat("Współczynnik zmienności =", z2(100 * sd(x) / mean(x)), "%\n\n")

cat("2. Rozkład normalny: IQ ~ N(100, 15)\n")
cat("z dla IQ = 115:", (115 - 100) / 15, "; P(IQ > 130) =", z2(100 * pnorm(130, 100, 15, lower.tail = FALSE)), "%\n")
cat("Odsetek w M ± 1 SD =", z2(100 * (pnorm(1) - pnorm(-1))), "%; M ± 2 SD =", z2(100 * (pnorm(2) - pnorm(-2))),
    "%; M ± 3 SD =", z2(100 * (pnorm(3) - pnorm(-3))), "%\n")
cat("Kwantyle z: 0.975 →", z3(qnorm(.975)), "; 0.95 →", z3(qnorm(.95)), "\n\n")

cat("3. Rozkład dwumianowy: test 10 pytań z 4 odpowiedziami, zgadywanie (szansa trafienia 0.25)\n")
cat("E(X) =", 10 * .25, "; P(X >= 6) =", z3(pbinom(5, 10, .25, lower.tail = FALSE)), "\n\n")

cat("4. Estymacja: n = 25, M = 50, SD = 10\n")
se <- 10 / sqrt(25); tk <- qt(.975, 24)
cat("SE =", se, "; t kryt.(24) =", z3(tk), "; 95% CI [", z2(50 - tk * se), ",", z2(50 + tk * se), "]\n")
cat("Ten sam SD przy n = 100: SE =", 10 / sqrt(100), "; 95% CI [", z2(50 - qt(.975, 99) * 1), ",", z2(50 + qt(.975, 99) * 1), "]\n")
pr <- prop.test(120, 400, correct = FALSE)
cat("Proporcja 120/400 =", z2(100 * 120 / 400), "%; 95% CI (Wilson) [", z2(100 * pr$conf.int[1]), ",",
    z2(100 * pr$conf.int[2]), "] %\n\n")

cat("5. Testowanie hipotez: t = 2.10 przy df = 24\n")
cat("p dwustronne =", sub("^0\\.", ".", z3(2 * pt(2.10, 24, lower.tail = FALSE))), "; p jednostronne =",
    sub("^0\\.", ".", z3(pt(2.10, 24, lower.tail = FALSE))), "\n")
pw <- power.t.test(n = 20, delta = 0.5, sd = 1)
nn <- power.t.test(power = .80, delta = 0.5, sd = 1)
cat("Moc testu t (dwie grupy po 20, d = 0.5, alfa = .05) =", z2(pw$power), "\n")
cat("n na grupę dla mocy .80 przy d = 0.5:", ceiling(nn$n), "\n\n")

cat("6. Istotność a wielkość efektu: dwie grupy po 5000 osób, różnica 0.75 pkt przy SD = 15\n")
tt <- 0.75 / (15 * sqrt(2 / 5000))
cat("t(9998) =", z2(tt), ",", pp(2 * pt(tt, 9998, lower.tail = FALSE)), "; d =", z2(0.75 / 15), "\n\n")

cat("7. Korelacja i regresja: r = .30 przy n = 50\n")
r <- .30; n <- 50; tr <- r * sqrt(n - 2) / sqrt(1 - r^2)
cat("t(48) =", z2(tr), ",", pp(2 * pt(tr, n - 2, lower.tail = FALSE)), "; r² =", sub("^0\\.", ".", z2(r^2)), "\n")
t20 <- r * sqrt(18) / sqrt(1 - r^2)
cat("Ta sama korelacja przy n = 20: t(18) =", z2(t20), ",", pp(2 * pt(t20, 18, lower.tail = FALSE)), "\n")
cat("Prognoza z równania wynik = 40 + 3 × godziny dla 6 godzin:", 40 + 3 * 6, "\n\n")

cat("8. Chi-kwadrat: stopnie swobody tabeli 3 × 4 =", (3 - 1) * (4 - 1), "; wartość krytyczna (alfa = .05) =",
    z2(qchisq(.95, 6)), "\n\n")

cat("9. Trzy testy t zamiast ANOVA (3 grupy, każdy test na alfa = .05)\n")
cat("Szansa co najmniej jednego błędu I rodzaju przy 3 niezależnych testach =", z2(100 * (1 - .95^3)), "%\n")
Wynik w R
1. Statystyki opisowe: godziny nauki w tygodniu przed egzaminem (7 osób)
Średnia = 6.00 ; mediana = 4 ; dominanta = 3
Bez osoby z 19 h: średnia = 3.83 ; mediana = 3.5
SD (n − 1) = 5.89 ; SD (n) = 5.45
Rozstęp = 17 ; IQR (type = 7) = 2.5 ; Q1 = 3 ; Q3 = 5.5
Współczynnik zmienności = 98.13 %

2. Rozkład normalny: IQ ~ N(100, 15)
z dla IQ = 115: 1 ; P(IQ > 130) = 2.28 %
Odsetek w M ± 1 SD = 68.27 %; M ± 2 SD = 95.45 %; M ± 3 SD = 99.73 %
Kwantyle z: 0.975 → 1.960 ; 0.95 → 1.645

3. Rozkład dwumianowy: test 10 pytań z 4 odpowiedziami, zgadywanie (szansa trafienia 0.25)
E(X) = 2.5 ; P(X >= 6) = 0.020

4. Estymacja: n = 25, M = 50, SD = 10
SE = 2 ; t kryt.(24) = 2.064 ; 95% CI [ 45.87 , 54.13 ]
Ten sam SD przy n = 100: SE = 1 ; 95% CI [ 48.02 , 51.98 ]
Proporcja 120/400 = 30.00 %; 95% CI (Wilson) [ 25.72 , 34.66 ] %

5. Testowanie hipotez: t = 2.10 przy df = 24
p dwustronne = .046 ; p jednostronne = .023
Moc testu t (dwie grupy po 20, d = 0.5, alfa = .05) = 0.34
n na grupę dla mocy .80 przy d = 0.5: 64

6. Istotność a wielkość efektu: dwie grupy po 5000 osób, różnica 0.75 pkt przy SD = 15
t(9998) = 2.50 , p = .012 ; d = 0.05

7. Korelacja i regresja: r = .30 przy n = 50
t(48) = 2.18 , p = .034 ; r² = .09
Ta sama korelacja przy n = 20: t(18) = 1.33 , p = .199
Prognoza z równania wynik = 40 + 3 × godziny dla 6 godzin: 58

8. Chi-kwadrat: stopnie swobody tabeli 3 × 4 = 6 ; wartość krytyczna (alfa = .05) = 12.59

9. Trzy testy t zamiast ANOVA (3 grupy, każdy test na alfa = .05)
Szansa co najmniej jednego błędu I rodzaju przy 3 niezależnych testach = 14.26 %
Część 2: SD a SE, przedziały ufności i błąd I rodzaju w symulacji
R
# B384 – symulacje do odpowiedzi: SD a SE, co znaczy „95% ufności”, ile razy myli się test przy prawdziwej H0
# Populacja: wynik testu wiedzy ~ N(100, 15). Bazowy R.
set.seed(384)
z2 <- function(x) formatC(x, format = "f", digits = 2)

cat("A. SD i SE w 2000 próbach dla każdej liczebności n\n")
sd_se <- t(sapply(c(10, 40, 160, 640), function(n) {
  prob <- replicate(2000, rnorm(n, 100, 15))
  c(n = n, SD_srednio = mean(apply(prob, 2, sd)), SE_wzor = 15 / sqrt(n),
    SD_srednich = sd(colMeans(prob)))
}))
print(round(sd_se, 2))
cat("\n")

cat("B. 1000 przedziałów ufności 95% dla średniej (n = 25 w każdej próbie)\n")
ci <- t(replicate(1000, t.test(rnorm(25, 100, 15))$conf.int))
pokrywa <- ci[, 1] <= 100 & ci[, 2] >= 100
cat("Przedziały zawierające prawdziwą średnią 100:", sum(pokrywa), "z 1000 (", z2(100 * mean(pokrywa)), "%)\n")
cat("Średnia szerokość przedziału =", z2(mean(ci[, 2] - ci[, 1])), "\n\n")

cat("C. 1000 testów t dla dwóch grup po 30 osób, gdy H0 jest prawdziwa (obie średnie = 100)\n")
p_h0 <- replicate(1000, t.test(rnorm(30, 100, 15), rnorm(30, 100, 15), var.equal = TRUE)$p.value)
cat("Wyniki z p < .05:", sum(p_h0 < .05), "z 1000 (", z2(100 * mean(p_h0 < .05)), "%) – to błędy I rodzaju\n")
cat("Ta sama sytuacja, gdy różnica wynosi 7.5 pkt (d = 0.5):\n")
p_h1 <- replicate(1000, t.test(rnorm(30, 107.5, 15), rnorm(30, 100, 15), var.equal = TRUE)$p.value)
cat("Wyniki z p < .05:", sum(p_h1 < .05), "z 1000 (", z2(100 * mean(p_h1 < .05)), "%) – oszacowana moc\n")
cat("Moc ze wzoru (power.t.test):", z2(power.t.test(n = 30, delta = 7.5, sd = 15)$power), "\n")
Wynik w R
A. SD i SE w 2000 próbach dla każdej liczebności n
       n SD_srednio SE_wzor SD_srednich
[1,]  10      14.67    4.74        4.75
[2,]  40      14.87    2.37        2.34
[3,] 160      14.96    1.19        1.14
[4,] 640      15.00    0.59        0.58

B. 1000 przedziałów ufności 95% dla średniej (n = 25 w każdej próbie)
Przedziały zawierające prawdziwą średnią 100: 952 z 1000 ( 95.20 %)
Średnia szerokość przedziału = 12.25

C. 1000 testów t dla dwóch grup po 30 osób, gdy H0 jest prawdziwa (obie średnie = 100)
Wyniki z p < .05: 46 z 1000 ( 4.60 %) – to błędy I rodzaju
Ta sama sytuacja, gdy różnica wynosi 7.5 pkt (d = 0.5):
Wyniki z p < .05: 462 z 1000 ( 46.20 %) – oszacowana moc
Moc ze wzoru (power.t.test): 0.48
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jakie pytania teoretyczne najczęściej padają na egzaminie ze statystyki?
Najczęściej pytania o definicje i różnice: co mierzy odchylenie standardowe, czym różni się od błędu standardowego, co oznacza wartość p i przedział ufności, czym są błędy I i II rodzaju i moc testu, kiedy wybrać test nieparametryczny i czym korelacja różni się od regresji. Zakres zależy od prowadzącego, więc porównaj go z sylabusem.
Jak krótko odpowiedzieć na egzaminie, co to jest wartość p?
Na przykład: „wartość p to prawdopodobieństwo otrzymania wyniku co najmniej tak skrajnego jak w próbie, gdyby hipoteza zerowa była prawdziwa”. Dodaj jedno zdanie o tym, czego p nie mówi: nie jest prawdopodobieństwem prawdziwości H0 i nie mierzy wielkości efektu.
Czy na egzaminie ze statystyki trzeba znać wzory na pamięć?
Zwykle trzeba znać przynajmniej podstawowe: średnią, wariancję i SD z n − 1, wynik z, błąd standardowy średniej i przedział ufności. Wzory na statystyki testowe bywają podawane na egzaminie albo w tablicach, ale warto rozumieć, co jest w liczniku i w mianowniku, bo o to pytają na egzaminie ustnym.
Jak zapamiętać różnicę między błędem I i II rodzaju?
Błąd I rodzaju to „fałszywy alarm” – odrzucasz H0, która jest prawdziwa, a jego ryzyko to α. Błąd II rodzaju to „przeoczenie” – nie odrzucasz fałszywej H0, a jego ryzyko to β; moc testu to 1 − β. Pomaga przykład z testem diagnostycznym: wynik dodatni u zdrowej osoby a wynik ujemny u chorej.
Jak długo uczyć się do egzaminu ze statystyki?
To zależy od zakresu i od tego, ile zadań rozwiązywałeś(-aś) w semestrze. Rozsądnie jest rozłożyć naukę na kilka sesji: najpierw pojęcia i pary pojęć z listy pytań, potem zadania obliczeniowe z każdego działu, na końcu powtórka odpowiedzi na głos. Sama lektura bez liczenia zadań rzadko wystarcza.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →PoradnikEstymacja i testowanie hipotez – zadania
Dziesięć zadań jak na kolokwium: przedziały ufności (z, t, Wilson), liczebność próby, testy dla średniej i proporcji, test jednostronny, błąd II rodzaju i moc.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikPytania ze statystyki na obronę magisterską
Pytania promotora i recenzenta ułożone według analizy – od testu t i chi-kwadrat po regresję, ANOVA i alfę Cronbacha – z krótkimi odpowiedziami na liczbach.
Czytaj →Statystyka z przedmiotu to dopiero początek – czeka Cię analiza do pracy?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{stevens1946theory, author={Stevens, S. S.}, title={{On the theory of scales of measurement}}, journal={Science}, year={1946}, volume={103}, number={2684}, pages={677--680}, doi={10.1126/science.103.2684.677}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}