Statystyka medyczna: zadania z rozwiązaniami – jak z nich korzystać
Ten wpis to statystyka medyczna – zadania z rozwiązaniami dla studentów pielęgniarstwa, ratownictwa medycznego, fizjoterapii i położnictwa. Na tych kierunkach statystyka wygląda inaczej niż na psychologii: zamiast średnich i korelacji dominują tabele 2 × 2, ryzyko, testy diagnostyczne i czas do zdarzenia. Poniżej znajdziesz dziesięć ćwiczeń jak na kolokwium lub egzamin z biostatystyki: od ryzyka względnego i NNT, przez czułość, swoistość i wartości predykcyjne, po test McNemara, krzywą Kaplana–Meiera i test Wilcoxona dla skali bólu.
Każde zadanie ma ten sam układ: treść z danymi, rozwiązanie krok po kroku, interpretację i typowy błąd. Wszystko policzysz kalkulatorem, a każdą liczbę sprawdziliśmy w R (kod na końcu wpisu); inna ostatnia cyfra to zwykle skutek wcześniejszego zaokrąglenia. Wzory są standardowe – znajdziesz je w podręcznikach statystyki medycznej (np. Petrie i Sabin, 2006).
Jakie analizy pojawiają się w pracach dyplomowych, opisujemy osobno: statystykę w pracy z pielęgniarstwa, statystykę w pracy z ratownictwa medycznego albo statystykę dla fizjoterapeuty.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | materac zmiennociśnieniowy a odleżyny | ryzyko, RR i OR z 95% CI |
| 2 | to samo badanie – korzyść dla pacjenta | ARR, RRR, NNT z 95% CI |
| 3 | cewnik moczowy a zakażenie (badanie kliniczno-kontrolne) | iloraz szans z 95% CI |
| 4 | szybki test na grypę a PCR | czułość, swoistość, PPV, NPV |
| 5 | ten sam test na oddziale i w przesiewie | PPV i NPV przy dwóch rozpowszechnieniach |
| 6 | opatrunek z chlorheksydyną a zakażenie wkłucia | test dokładny Fishera |
| 7 | technika inhalacji przed edukacją i po niej | test McNemara |
| 8 | cukrzyca w przychodni POZ | chorobowość, zapadalność |
| 9 | ponowna hospitalizacja po wypisie | krzywa Kaplana–Meiera (tabela) |
| 10 | ból w skali NRS przed fizjoterapią i po niej | test Wilcoxona, r |
Dane z surowymi wynikami możesz pobrać w jednym pliku: statystyka-medyczna-zadania-dane.csv (format długi; tabele 2 × 2 rozpisane na pacjentów, 1 = tak, 0 = nie).
W zadaniach 1–3 i 6 posługujemy się tym samym oznaczeniem komórek tabeli 2 × 2: w wierszach grupa (narażona lub leczona u góry), w kolumnach zdarzenie (tak, nie). Komórki to a i b (górny wiersz) oraz c i d (dolny wiersz).
Zadanie 1. Ryzyko, ryzyko względne i iloraz szans
Treść zadania
Na oddziale opieki długoterminowej 240 pacjentów z grupy ryzyka odleżyn losowo przydzielono do materaca zmiennociśnieniowego albo standardowego (po 120 osób). W ciągu 14 dni odleżyna pojawiła się u 9 pacjentów na materacu zmiennociśnieniowym i u 24 na standardowym. Oblicz ryzyko w obu grupach, ryzyko względne (RR) i iloraz szans (OR) z 95% przedziałami ufności.
Rozwiązanie krok po kroku
Krok 1. Tabela. a = 9, b = 111 (materac zmiennociśnieniowy), c = 24, d = 96 (standardowy).
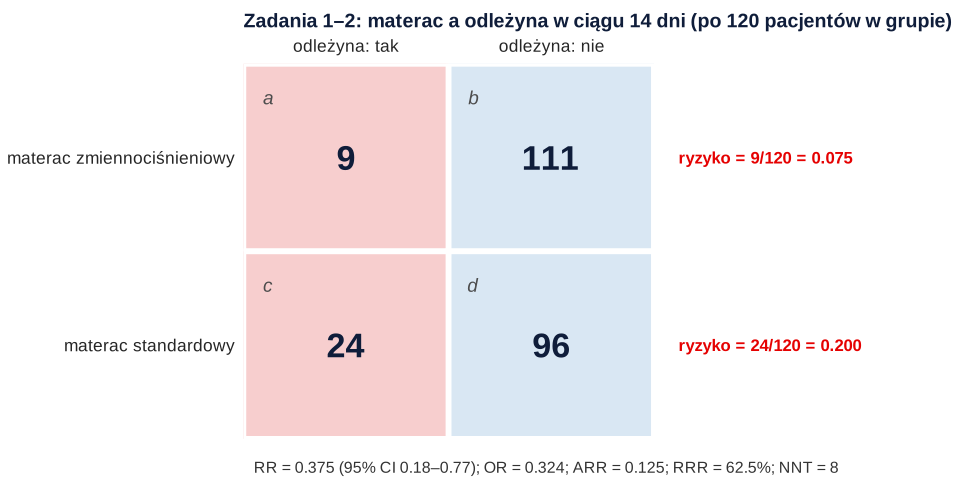
Krok 2. Ryzyko w grupach. Materac zmiennociśnieniowy: a / (a + b) = 9 / 120 = 0.075. Standardowy: c / (c + d) = 24 / 120 = 0.200.
Krok 3. Przedział dla RR. Przedział liczysz na skali logarytmu, a potem wracasz funkcją wykładniczą: ln(0.375) = −0.981, więc 95% CI = exp(−0.981 ± 1.96 × 0.369) = [0.18, 0.77].
Krok 4. Szanse i iloraz szans. Szansa odleżyny to liczba osób ze zdarzeniem podzielona przez liczbę osób bez zdarzenia: 9 / 111 = 0.081 i 24 / 96 = 0.250.
95% CI = exp(−1.126 ± 1.96 × 0.415) = [0.14, 0.73].
Interpretacja
Przedział dla RR nie obejmuje 1, więc dane są zgodne z ochronnym działaniem materaca. Więcej: ryzyko względne i iloraz szans.
Typowy błąd
Czytanie OR jak RR („ryzyko odleżyny spadło do 32% ryzyka na zwykłym materacu”). Przy częstym zdarzeniu OR leży dalej od 1 niż RR (tu 0.324 wobec 0.375); oba są bliskie sobie tylko przy rzadkim zdarzeniu.
Zadanie 2. ARR, RRR i NNT z przedziałami ufności
Treść zadania
Na danych z zadania 1 oblicz bezwzględną redukcję ryzyka (ARR), względną redukcję ryzyka (RRR) i liczbę pacjentów, których trzeba położyć na materacu zmiennociśnieniowym, aby zapobiec jednej odleżynie (NNT), z 95% przedziałami. Jakie byłoby NNT u pacjenta, którego ryzyko na zwykłym materacu wynosi 5%, jeśli RRR jest takie samo?
Rozwiązanie krok po kroku
Krok 1. ARR to różnica ryzyk: 0.200 − 0.075 = 0.125 (12.5 punktu procentowego).
95% CI (Wald) = 0.125 ± 1.96 × 0.044 = [0.039, 0.211].
Krok 2. RRR = 1 − RR = 1 − 0.375 = 62.5%. Granice dostajesz z przedziału dla RR: 1 − 0.77 i 1 − 0.18, czyli dokładniej [22.7%, 81.8%].
Krok 3. NNT = 1 / ARR = 1 / 0.125 = 8.00. NNT zaokrąglasz w górę do pełnego pacjenta. Przedział dla NNT to odwrotności granic przedziału dla ARR (Altman, 1998): 1 / 0.211 = 4.75 i 1 / 0.039 = 25.44, czyli od 5 do 26 pacjentów.
Krok 4. Inne ryzyko wyjściowe. Przy ryzyku 5% i tym samym RRR: ARR = 0.05 × 0.625 = 0.031, a NNT = 1 / 0.031 = 32.
Interpretacja
Trzeba położyć ok. 8 pacjentów na materacu zmiennociśnieniowym, żeby zapobiec jednej odleżynie. Cook i Sackett (1995) zwracają uwagę, że NNT pozwala przenieść wynik na pacjenta o innym ryzyku wyjściowym, jeśli względna redukcja ryzyka jest stała – stąd NNT = 32 u pacjenta o ryzyku 5%. Więcej: ARR i RRR, NNT.
Typowy błąd
Podanie samego RRR („62.5% mniej odleżyn”) bez ryzyka wyjściowego. To samo RRR przy ryzyku 5% oznacza tylko 3.1 punktu procentowego różnicy i NNT = 32.
Zadanie 3. Iloraz szans w badaniu kliniczno-kontrolnym
Treść zadania
W szpitalu wybrano 50 pacjentów z zakażeniem układu moczowego (ZUM, przypadki) i 100 pacjentów bez zakażenia z tych samych oddziałów (kontrole). Z dokumentacji sprawdzono, czy pacjent miał cewnik moczowy dłużej niż 3 dni: tak było u 30 przypadków i 25 kontroli. Oblicz iloraz szans z 95% przedziałem ufności. Czy możesz tu policzyć ryzyko względne?
Rozwiązanie krok po kroku
Krok 1. Tabela. Cewnik ponad 3 dni: a = 30 przypadków, b = 25 kontroli. Bez cewnika: c = 20 przypadków, d = 75 kontroli. Cewnik miało 60.0% przypadków i 25.0% kontroli.
Krok 2. Szanse ekspozycji. Przypadki: 30 / 20 = 1.50. Kontrole: 25 / 75 = 0.33.
Krok 3. Przedział. 95% CI = exp(ln 4.50 ± 1.96 × 0.370) = [2.18, 9.29]. Przedział nie obejmuje 1; test Walda z regresji logistycznej daje p < .001.
Interpretacja
Szansa długiego cewnikowania była w grupie z ZUM 4.5 raza większa niż w grupie bez zakażenia. Iloraz szans jest taki sam „po ekspozycji” i „po chorobie”, dlatego nadaje się do badania kliniczno-kontrolnego.
Typowy błąd
Liczenie „ryzyka ZUM” w wierszach tej tabeli: 30 / 55 = 54.5% wobec 20 / 95 = 21.1%. Te odsetki zależą od tego, ilu kontroli dobrał badacz (przy 200 kontrolach byłyby inne), więc w badaniu kliniczno-kontrolnym nie liczysz ryzyka ani RR.
Zadanie 4. Czułość, swoistość, PPV i NPV
Treść zadania
W izbie przyjęć u 300 pacjentów z objawami grypopodobnymi wykonano szybki test antygenowy i test PCR (standard referencyjny). PCR był dodatni u 80 osób; szybki test wykrył z nich 64. Wśród 220 osób z ujemnym PCR szybki test był ujemny u 209. Oblicz czułość i swoistość z 95% przedziałami Wilsona oraz PPV i NPV w tej próbie.
Rozwiązanie krok po kroku
Krok 1. Tabela. Prawdziwie dodatnie TP = 64, fałszywie ujemne FN = 16, fałszywie dodatnie FP = 220 − 209 = 11, prawdziwie ujemne TN = 209.
Krok 2. Przedziały Wilsona: czułość 95% CI [.700, .873], swoistość [.913, .972].
Krok 3. Wartości predykcyjne liczysz w kolumnie wyniku testu, a nie w grupie chorych: PPV = TP / (TP + FP) = 64 / 75 = .853; NPV = TN / (TN + FN) = 209 / 225 = .929. Rozpowszechnienie grypy w tej próbie to 80 / 300 = 26.7%.
Interpretacja
Test przeoczył co piątą osobę z grypą, ale rzadko dawał wynik dodatni u osoby zdrowej. Trevethan (2017) zaleca, by w badaniu testu przesiewowego podawać wszystkie cztery miary i opisać, jak je uzyskano. Więcej: czułość i swoistość; własne dane sprawdzisz w kalkulatorze testu diagnostycznego.
Typowy błąd
Podanie samej „trafności” – odsetka wyników zgodnych z PCR: (64 + 209) / 300 = .910. Ta liczba miesza czułość i swoistość i zależy od rozpowszechnienia, więc nie zastępuje żadnej z nich.
Zadanie 5. PPV i NPV przy dwóch rozpowszechnieniach
Treść zadania
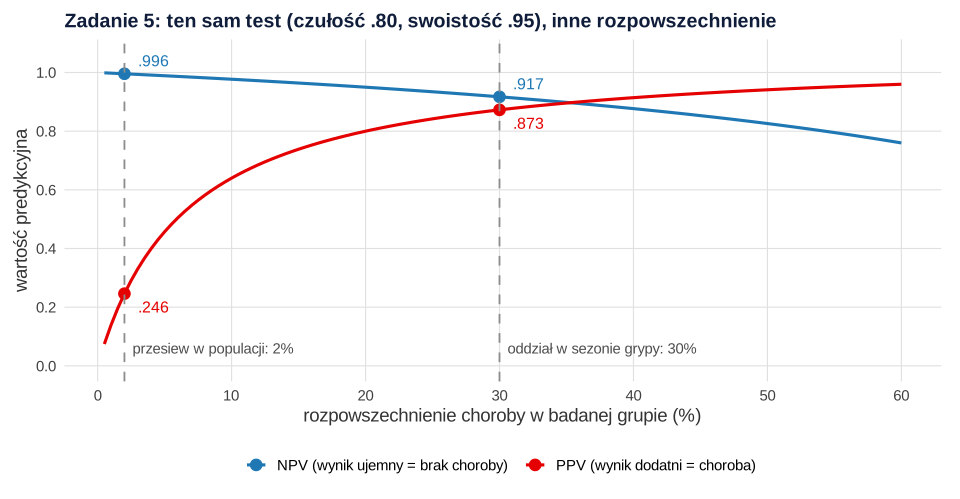
Ten sam szybki test (czułość .80, swoistość .95) zastosowano w dwóch sytuacjach: na oddziale zakaźnym w szczycie sezonu, gdzie grypę ma 30% badanych, i w przesiewie wśród pracowników szpitala, gdzie choruje 2%. Oblicz PPV i NPV w obu sytuacjach. Użyj tabeli dla 10 000 osób.
Rozwiązanie krok po kroku
Krok 1. Podziel 10 000 osób na chorych i zdrowych. Przy 30%: 3000 chorych i 7000 zdrowych. Przy 2%: 200 chorych i 9800 zdrowych.
Krok 2. Zastosuj czułość do chorych, a swoistość do zdrowych. Na przykład przy 2%: TP = 0.80 × 200 = 160, FN = 40; TN = 0.95 × 9800 = 9310, FP = 490.
| Rozpowszechnienie | TP | FN | FP | TN | PPV | NPV |
|---|---|---|---|---|---|---|
| 30% (oddział) | 2400 | 600 | 350 | 6650 | 2400 / 2750 = .873 | 6650 / 7250 = .917 |
| 2% (przesiew) | 160 | 40 | 490 | 9310 | 160 / 650 = .246 | 9310 / 9350 = .996 |
Krok 3. Porównaj. Przy 2% na jeden prawdziwie dodatni wynik przypada 490 / 160 = 3.06 wyniku fałszywie dodatniego.
Interpretacja
Na oddziale wynik dodatni oznacza grypę w ok. 87% przypadków, a w przesiewie tylko w ok. 25% – trzy na cztery dodatnie wyniki są fałszywe. Wynik ujemny w przesiewie jest za to bardzo pewny (NPV = .996). Więcej: wartość predykcyjna dodatnia i ujemna.
Typowy błąd
Przenoszenie PPV z artykułu do innej populacji („test ma PPV 87%”). Czułość i swoistość są cechą testu, a PPV i NPV zależą od tego, jak częsta jest choroba w grupie, w której test stosujesz.
Zadanie 6. Mała tabela 2 × 2: test dokładny Fishera
Treść zadania
Czterdziestu pacjentów z wkłuciem obwodowym losowo przydzielono do opatrunku z chlorheksydyną albo opatrunku standardowego (po 20 osób). Miejscowe zakażenie miejsca wkłucia wystąpiło u 1 pacjenta z chlorheksydyną i u 7 ze standardowym opatrunkiem. Czy odsetki zakażeń się różnią (α = .05)? Wybierz test.
Rozwiązanie krok po kroku
Krok 1. Liczności oczekiwane. Zakażeń jest 8 na 40 pacjentów, więc przy braku związku w każdej grupie oczekujesz E = 20 × 8 / 40 = 4 zakażeń. Dwie komórki mają E < 5 – to sygnał, żeby zamiast przybliżenia χ² użyć testu dokładnego Fishera.
Krok 2. Prawdopodobieństwa tabel. Przy ustalonych sumach (20 i 20 pacjentów, 8 zakażeń) liczba zakażeń w grupie z chlorheksydyną może wynosić od 0 do 8. Prawdopodobieństwa kolejnych tabel (rozkład hipergeometryczny) to: 0.0016, 0.0202, 0.0958, 0.2298, 0.3052, 0.2298, 0.0958, 0.0202, 0.0016.
Krok 3. Wartość p. Zsumuj prawdopodobieństwa tabel nie bardziej prawdopodobnych niż obserwowana (1 zakażenie, 0.0202): 0.0016 + 0.0202 + 0.0202 + 0.0016, czyli p = .044.
Interpretacja
Przy 40 pacjentach oszacowanie jest mało precyzyjne. O wyborze testu: chi-kwadrat czy test Fishera.
Typowy błąd
Policzenie zwykłego χ² bez sprawdzenia liczności oczekiwanych: χ²(1) = 5.62, p = .018 – wynik wyraźnie „lepszy” niż w teście Fishera, ale przy E = 4 przybliżenie jest wątpliwe.
Zadanie 7. Test McNemara: ta sama grupa przed edukacją i po niej
Treść zadania
Pielęgniarka oceniła technikę użycia inhalatora u 50 pacjentów z astmą przed sesją edukacyjną i tydzień po niej (poprawnie / błędnie). Poprawnie w obu pomiarach: 14 osób; poprawnie tylko przed: 3; poprawnie tylko po: 18; błędnie w obu: 15. Czy odsetek poprawnej techniki się zmienił?
Rozwiązanie krok po kroku
Krok 1. Odsetki. Poprawnie przed: (14 + 3) / 50 = 34.0%. Poprawnie po: (14 + 18) / 50 = 64.0%.
Krok 2. Pary niezgodne. Test McNemara korzysta tylko z osób, które zmieniły wynik: b = 3 (pogorszenie), c = 18 (poprawa). Pary zgodne (14 i 15) nic nie mówią o zmianie.
Krok 3. Decyzja. χ²kryt(1) = 3.84; 10.71 > 3.84, p = .001. Wersja z poprawką na ciągłość (domyślna w R) daje χ² = 9.33, p = .002; dokładny test dwumianowy i jego wersja mid-p – p = .001. Fagerland i in. (2013) pokazali, że wersja mid-p i wersja asymptotyczna bez poprawki sprawdzają się lepiej niż test dokładny warunkowy.
Interpretacja
Bez grupy kontrolnej nie wiesz, ile poprawy dałby sam drugi pomiar. Pełny przykład z przedziałem dla różnicy odsetków: test McNemara – przed i po dla tak/nie.
Typowy błąd
Policzenie χ² dla prób niezależnych z tabeli „przed: 17 tak, 33 nie; po: 32 tak, 18 nie”: χ² = 9.00. Ten test traktuje 50 osób jak 100 różnych pacjentów i pomija, kto się poprawił.
Zadanie 8. Chorobowość i zapadalność
Treść zadania
Do przychodni POZ 1 stycznia było zapisanych 2500 dorosłych pacjentów; 200 z nich miało rozpoznaną cukrzycę typu 2. W ciągu roku rozpoznano 46 nowych przypadków. Łączny czas obserwacji osób bez cukrzycy (do rozpoznania, wypisania z przychodni albo końca roku) wyniósł 2250 osobolat. Oblicz chorobowość punktową, zapadalność skumulowaną i współczynnik zapadalności.
Rozwiązanie krok po kroku
Krok 1. Chorobowość punktowa (wszystkie istniejące przypadki w danym dniu): 200 / 2500 = 8.0%.
Krok 2. Zapadalność skumulowana (nowe przypadki wśród osób zagrożonych): w mianowniku tylko osoby, które 1 stycznia nie miały cukrzycy, czyli 2500 − 200 = 2300. Zapadalność = 46 / 2300 = 2.0% w ciągu roku.
Interpretacja
1 stycznia cukrzycę miało 8 na 100 zapisanych pacjentów (8.0%), a w ciągu roku zachorowało 2.0% osób zagrożonych, czyli ok. 20 nowych przypadków na 1000 osobolat obserwacji. Chorobowość opisuje obciążenie chorobą, a zapadalność – tempo pojawiania się nowych przypadków (Noordzij i in., 2010). Więcej: chorobowość i zapadalność.
Typowy błąd
Wzięcie do mianownika zapadalności wszystkich zapisanych (46 / 2500 = 1.8%), także osób, które już chorowały i nie mogły „zachorować” ponownie.
Zadanie 9. Krzywa Kaplana–Meiera policzona ręcznie
Treść zadania
Dwunastu pacjentów z niewydolnością serca obserwowano przez 26 tygodni po wypisie. Czas (w tygodniach) do ponownej hospitalizacji: 2, 5, 5, 10, 14, 20. Pozostałych sześciu nie hospitalizowano do końca ich obserwacji (obserwacje ucięte, oznaczone „+”): 3+, 8+, 12+, 18+, 26+, 26+. Oblicz tabelę Kaplana–Meiera, medianę czasu do hospitalizacji i odsetek hospitalizowanych do 26. tygodnia.
Rozwiązanie krok po kroku
Krok 1. Uporządkuj czasy i w każdym momencie zdarzenia policz, ilu pacjentów było jeszcze w obserwacji (w ryzyku). Pacjent z obserwacją uciętą liczy się do ryzyka do chwili ucięcia, potem wypada z mianownika.
Krok 2. Estymator iloczynowy (Kaplan i Meier, 1958): S(t) = S(poprzednie) × (1 − d / n), gdzie d to liczba zdarzeń, a n – liczba osób w ryzyku.
| Tydzień | W ryzyku n | Zdarzenia d | 1 − d/n | S(t) |
|---|---|---|---|---|
| 2 | 12 | 1 | 11/12 | 0.917 |
| 5 | 10 | 2 | 8/10 | 0.917 × 0.8 = 0.733 |
| 10 | 7 | 1 | 6/7 | 0.629 |
| 14 | 5 | 1 | 4/5 | 0.503 |
| 20 | 3 | 1 | 2/3 | 0.335 |
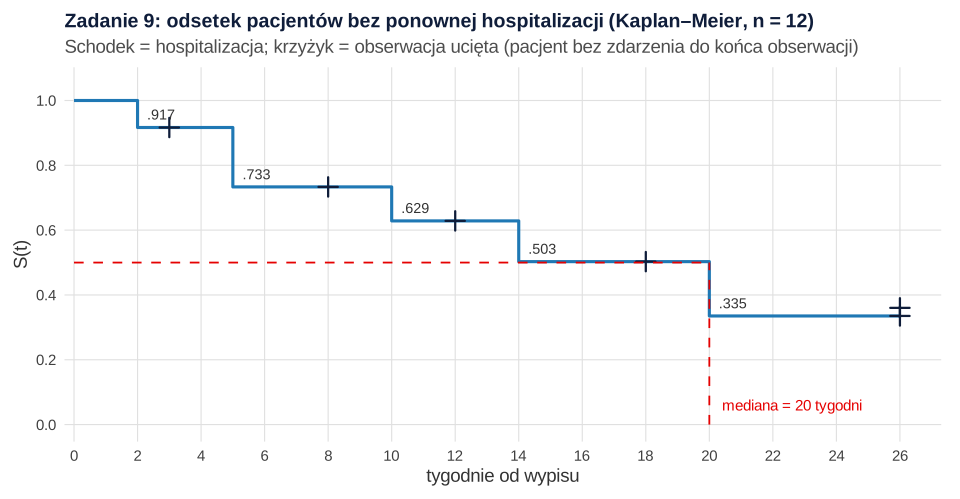
W 5. tygodniu w ryzyku jest 10 osób, a nie 11, bo pacjent z obserwacją uciętą w 3. tygodniu już wypadł; podobnie ucięcia w 8., 12. i 18. tygodniu zmniejszają kolejne mianowniki.
Krok 3. Mediana to pierwszy czas, w którym S(t) spada do 0.5 lub niżej: w 14. tygodniu S = 0.503 (jeszcze powyżej), w 20. – 0.335, więc mediana = 20 tygodni. Odsetek hospitalizowanych do 26. tygodnia = 1 − 0.335 = 66.5%.
Interpretacja
Mediana czasu do ponownej hospitalizacji wyniosła 20 tygodni, a do 26. tygodnia hospitalizowano szacunkowo 66.5% pacjentów. Przy 12 osobach przedział ufności jest szeroki: dla S(20) = 0.335 wynosi [0.120, 0.934]. Więcej: krzywa Kaplana–Meiera; porównanie dwóch grup testem log-rank i model Coxa opisujemy w poradniku Kaplan–Meier i model Coxa krok po kroku.
Typowy błąd
Liczenie zwykłego odsetka: 6 hospitalizacji na 12 pacjentów = 50.0% (zaniża, bo osoby ucięte wcześnie traktuje jak obserwowane do końca) albo usunięcie pacjentów uciętych przed 26. tygodniem: 6 / 8 = 75.0% (zawyża).
Zadanie 10. Ból w skali NRS przed i po: test Wilcoxona
Treść zadania
Dwunastu pacjentów z przewlekłym bólem krzyża oceniło ból w skali NRS (0–10) przed serią 10 zabiegów fizjoterapii i po niej. Przed: 7, 6, 8, 5, 7, 6, 9, 4, 6, 7, 8, 5. Po: 4, 5, 5, 6, 3, 6, 6, 3, 2, 4, 5, 4 (ta sama kolejność pacjentów). Czy ból się zmniejszył? Oblicz wielkość efektu r.
Rozwiązanie krok po kroku
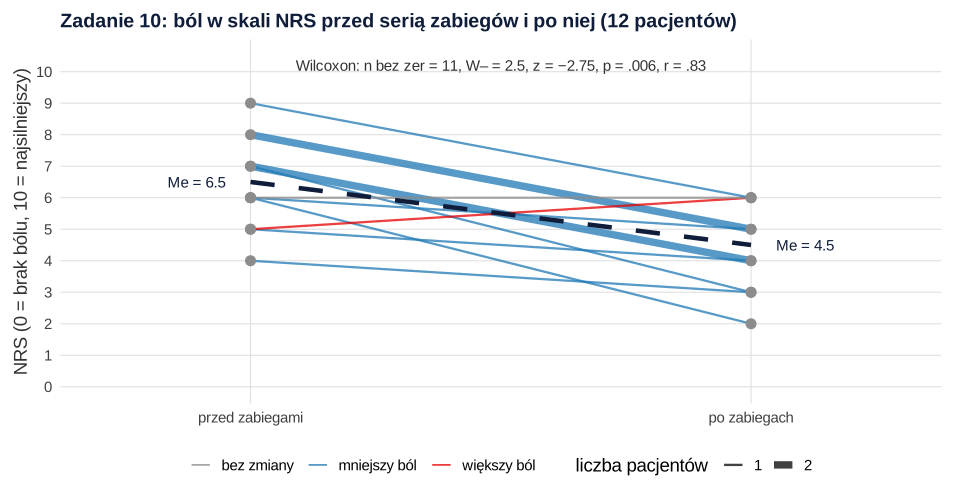
Krok 1. Różnice (przed − po): 3, 1, 3, −1, 4, 0, 3, 1, 4, 3, 3, 1. Mediany: przed 6.5, po 4.5. Jedna różnica wynosi 0 – w klasycznej wersji testu ją pomijasz, więc n = 11.
Krok 2. Rangi wartości bezwzględnych z wiązaniami. Cztery różnice o module 1 zajmują rangi 1–4, więc każda dostaje 2.5; pięć różnic o module 3 – rangi 5–9, czyli po 7; dwie o module 4 – rangi 10–11, czyli po 10.5.
Krok 3. Sumy rang. Ujemna jest tylko jedna różnica (−1), więc W− = 2.5, a W+ = 66 − 2.5 = 63.5 (suma wszystkich rang to 11 × 12 / 2 = 66).
Poprawka na wiązania: dla grup o liczebności t = 4, 5 i 2 suma t³ − t wynosi 60 + 120 + 6 = 186. W R domyślna wersja z poprawką na ciągłość daje p = .007.
Interpretacja
Napisz, z jakiego n liczysz r (tu z 11 par bez zera). Jak opisywać skale bólu, zmianę procentową i odsetek „responderów”, piszemy w poradniku jak analizować skale bólu NRS i VAS; więcej o samym teście: test Wilcoxona.
Typowy błąd
Uznanie spadku o 2 punkty mediany za dowód skuteczności zabiegów. Bez grupy kontrolnej nie oddzielisz efektu fizjoterapii od naturalnego przebiegu bólu i regresji do średniej.
Ściąga: jak wybrać miarę i test w zadaniu z medycyny
Zanim zaczniesz liczyć, ustal schemat badania, rodzaj wyniku (tak/nie, skala porządkowa, czas do zdarzenia) i to, czy porównujesz różne osoby, czy te same.
| Sytuacja w treści zadania | Miara lub test |
|---|---|
| Dwie grupy obserwowane do zdarzenia (losowy przydział lub kohorta) | ryzyko, RR, ARR, RRR, NNT; test χ² lub Fishera |
| Przypadki i kontrole dobrane według choroby | tylko OR (bez ryzyka i RR) |
| Nowy test porównany ze standardem referencyjnym | czułość, swoistość; PPV i NPV dla konkretnego rozpowszechnienia |
| Tabela 2 × 2, liczności oczekiwane < 5 | test dokładny Fishera |
| Te same osoby, wynik tak/nie przed i po | test McNemara |
| Te same osoby, skala porządkowa (NRS, VAS) przed i po | test Wilcoxona, r |
| Czas do zdarzenia z obserwacjami uciętymi | Kaplan–Meier, mediana czasu; dwie grupy – test log-rank |
| Ile osób choruje teraz / ile zachorowało w okresie | chorobowość / zapadalność |
Inne zbiory zadań
Pozostałe zbiory zadań z rozwiązaniami w tym samym układzie:
- zadania ze statystyki na psychologii,
- statystyka opisowa – zadania z rozwiązaniami,
- prawdopodobieństwo i rozkłady – zadania z rozwiązaniami,
- estymacja i testowanie hipotez – zadania z rozwiązaniami,
- korelacja i regresja – zadania z rozwiązaniami,
- testy nieparametryczne – zadania z rozwiązaniami.
Jeśli po zaliczeniu przychodzi czas na własne badanie do pracy dyplomowej, możesz skorzystać z konsultacji analizy statystycznej dla studentów – pomożemy dobrać metodę i wyjaśnimy wyniki tak, żebyś umiał(a) je samodzielnie opisać.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone najpierw wzorem, tak jak na kartce, a potem gotową funkcją R jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–5: ryzyko, RR, OR, ARR, RRR, NNT i test diagnostyczny
R
# B383 – zadania 1–5: ryzyko, RR, OR, ARR, RRR, NNT, czułość, swoistość, PPV i NPV
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))   # bez zera przed kropką
pz <- function(p) if (p < .001) "< .001" else paste("=", bz(p))   # zapis p w APA
proc <- function(x) paste0(formatC(100 * x, format = "f", digits = 1), "%")
z <- qnorm(0.975)

# Zadanie 1. Materac zmiennociśnieniowy a odleżyny w ciągu 14 dni (po 120 pacjentów)
a <- 9;  b <- 111   # materac: odleżyna tak / nie
c <- 24; d <- 96    # materac standardowy: odleżyna tak / nie
n1 <- a + b; n0 <- c + d
r1 <- a / n1; r0 <- c / n0
RR <- r1 / r0
se_lnRR <- sqrt(1 / a - 1 / n1 + 1 / c - 1 / n0)
OR <- (a * d) / (b * c)
se_lnOR <- sqrt(1 / a + 1 / b + 1 / c + 1 / d)
cat("Zadanie 1\n")
cat("Ryzyko: materac =", z3(r1), "; standard =", z3(r0), "\n")
cat("RR =", z3(RR), "; ln(RR) =", z3(log(RR)), "; SE ln(RR) =", z3(se_lnRR),
    "; 95% CI [", z2(exp(log(RR) - z * se_lnRR)), ",", z2(exp(log(RR) + z * se_lnRR)), "]\n")
cat("Szanse: materac =", z3(a / b), "; standard =", z3(c / d), "\n")
cat("OR =", z3(OR), "; ln(OR) =", z3(log(OR)), "; SE ln(OR) =", z3(se_lnOR),
    "; 95% CI [", z2(exp(log(OR) - z * se_lnOR)), ",", z2(exp(log(OR) + z * se_lnOR)), "]\n")
m1 <- glm(cbind(c(a, c), c(b, d)) ~ factor(c("materac", "standard"), levels = c("standard", "materac")),
          family = binomial)
cat("Kontrola glm(logit): OR =", z3(exp(coef(m1)[2])), "; SE ln(OR) =", z3(sqrt(vcov(m1)[2, 2])), "\n\n")

# Zadanie 2. ARR, RRR i NNT z przedziałami (te same dane)
ARR <- r0 - r1
se_ARR <- sqrt(r1 * (1 - r1) / n1 + r0 * (1 - r0) / n0)
ARR_ci <- ARR + c(-1, 1) * z * se_ARR
cat("Zadanie 2\n")
cat("ARR =", z3(ARR), "; SE =", z3(se_ARR), "; 95% CI [", z3(ARR_ci[1]), ",", z3(ARR_ci[2]), "]\n")
cat("RRR = 1 - RR =", proc(1 - RR), "; 95% CI [", proc(1 - exp(log(RR) + z * se_lnRR)), ",",
    proc(1 - exp(log(RR) - z * se_lnRR)), "]\n")
cat("NNT = 1 / ARR =", z2(1 / ARR), "-> zaokrąglone w górę:", ceiling(1 / ARR),
    "; 95% CI [", z2(1 / ARR_ci[2]), ",", z2(1 / ARR_ci[1]), "]\n")
cat("Kontrola prop.test(): różnica =", z3(-diff(prop.test(c(a, c), c(n1, n0), correct = FALSE)$estimate)),
    "; 95% CI [", z3(prop.test(c(c, a), c(n0, n1), correct = FALSE)$conf.int), "]\n")
r0_niski <- 0.05
cat("Pacjent o ryzyku wyjściowym 5%: ARR =", z3(r0_niski * (1 - RR)), "; NNT =", z2(1 / (r0_niski * (1 - RR))),
    "-> ", ceiling(1 / (r0_niski * (1 - RR))), "\n\n")

# Zadanie 3. Badanie kliniczno-kontrolne: cewnik moczowy > 3 dni a zakażenie układu moczowego
a3 <- 30; c3 <- 20   # 50 przypadków (ZUM): cewnik > 3 dni tak / nie
b3 <- 25; d3 <- 75   # 100 kontroli (bez ZUM): cewnik > 3 dni tak / nie
OR3 <- (a3 * d3) / (b3 * c3)
se3 <- sqrt(1 / a3 + 1 / b3 + 1 / c3 + 1 / d3)
cat("Zadanie 3\n")
cat("Odsetek z cewnikiem: przypadki =", proc(a3 / (a3 + c3)), "; kontrole =", proc(b3 / (b3 + d3)), "\n")
cat("Szanse ekspozycji: przypadki =", z2(a3 / c3), "; kontrole =", z2(b3 / d3), "\n")
cat("OR =", z2(OR3), "; SE ln(OR) =", z3(se3), "; 95% CI [", z2(exp(log(OR3) - z * se3)), ",",
    z2(exp(log(OR3) + z * se3)), "]\n")
m3 <- glm(cbind(c(a3, c3), c(b3, d3)) ~ factor(c("tak", "nie"), levels = c("nie", "tak")), family = binomial)
cat("Kontrola glm(logit): OR =", z2(exp(coef(m3)[2])), "; p (Wald)", pz(summary(m3)$coefficients[2, 4]), "\n")
cat("Błąd: 'ryzyko' ZUM z tej tabeli =", proc(a3 / (a3 + b3)), "vs", proc(c3 / (c3 + d3)),
    "(zależy od liczby dobranych kontroli)\n\n")

# Zadanie 4. Szybki test antygenowy na grypę a PCR (300 pacjentów izby przyjęć)
TP <- 64; FN <- 16   # PCR dodatni (80 osób)
FP <- 11; TN <- 209  # PCR ujemny (220 osób)
wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int
cat("Zadanie 4\n")
cat("Czułość =", bz(TP / (TP + FN)), "; 95% CI Wilsona [", bz(wilson(TP, TP + FN)[1]), ",", bz(wilson(TP, TP + FN)[2]), "]\n")
cat("Swoistość =", bz(TN / (TN + FP)), "; 95% CI Wilsona [", bz(wilson(TN, TN + FP)[1]), ",", bz(wilson(TN, TN + FP)[2]), "]\n")
cat("Rozpowszechnienie w próbie =", proc((TP + FN) / (TP + FN + FP + TN)), "\n")
cat("PPV =", bz(TP / (TP + FP)), "; NPV =", bz(TN / (TN + FN)), "\n")
cat("Błąd: odsetek wyników zgodnych z PCR (trafność ogólna) =", bz((TP + TN) / (TP + FN + FP + TN)), "\n\n")

# Zadanie 5. Ten sam test (czułość .80, swoistość .95) przy dwóch rozpowszechnieniach, 10 000 osób
sens <- TP / (TP + FN); spec <- TN / (TN + FP)
tab_naturalna <- function(prev, N = 10000) {
  chorzy <- N * prev; zdrowi <- N - chorzy
  tp <- sens * chorzy; fn <- chorzy - tp; tn <- spec * zdrowi; fp <- zdrowi - tn
  data.frame(rozpowszechnienie = proc(prev), chorzy, zdrowi, TP = tp, FN = fn, FP = fp, TN = tn,
             PPV = round(tp / (tp + fp), 3), NPV = round(tn / (tn + fn), 4))
}
cat("Zadanie 5 (czułość =", z2(sens), "; swoistość =", z2(spec), ")\n")
print(rbind(tab_naturalna(0.30), tab_naturalna(0.02)), row.names = FALSE)
ppv_wzor <- function(prev) sens * prev / (sens * prev + (1 - spec) * (1 - prev))
cat("Kontrola wzorem: PPV(30%) =", bz(ppv_wzor(0.30)), "; PPV(2%) =", bz(ppv_wzor(0.02)), "\n")
cat("Fałszywie dodatnie na 1 prawdziwie dodatni przy 2%:", z2((1 - spec) * 0.98 / (sens * 0.02)), "\n")
Wynik w R
Zadanie 1
Ryzyko: materac = 0.075 ; standard = 0.200
RR = 0.375 ; ln(RR) = -0.981 ; SE ln(RR) = 0.369 ; 95% CI [ 0.18 , 0.77 ]
Szanse: materac = 0.081 ; standard = 0.250
OR = 0.324 ; ln(OR) = -1.126 ; SE ln(OR) = 0.415 ; 95% CI [ 0.14 , 0.73 ]
Kontrola glm(logit): OR = 0.324 ; SE ln(OR) = 0.415

Zadanie 2
ARR = 0.125 ; SE = 0.044 ; 95% CI [ 0.039 , 0.211 ]
RRR = 1 - RR = 62.5% ; 95% CI [ 22.7% , 81.8% ]
NNT = 1 / ARR = 8.00 -> zaokrąglone w górę: 8 ; 95% CI [ 4.75 , 25.44 ]
Kontrola prop.test(): różnica = -0.125 ; 95% CI [ 0.039 0.211 ]
Pacjent o ryzyku wyjściowym 5%: ARR = 0.031 ; NNT = 32.00 ->  32

Zadanie 3
Odsetek z cewnikiem: przypadki = 60.0% ; kontrole = 25.0%
Szanse ekspozycji: przypadki = 1.50 ; kontrole = 0.33
OR = 4.50 ; SE ln(OR) = 0.370 ; 95% CI [ 2.18 , 9.29 ]
Kontrola glm(logit): OR = 4.50 ; p (Wald) < .001
Błąd: 'ryzyko' ZUM z tej tabeli = 54.5% vs 21.1% (zależy od liczby dobranych kontroli)

Zadanie 4
Czułość = .800 ; 95% CI Wilsona [ .700 , .873 ]
Swoistość = .950 ; 95% CI Wilsona [ .913 , .972 ]
Rozpowszechnienie w próbie = 26.7%
PPV = .853 ; NPV = .929
Błąd: odsetek wyników zgodnych z PCR (trafność ogólna) = .910

Zadanie 5 (czułość = 0.80 ; swoistość = 0.95 )
 rozpowszechnienie chorzy zdrowi   TP  FN  FP   TN   PPV    NPV
             30.0%   3000   7000 2400 600 350 6650 0.873 0.9172
              2.0%    200   9800  160  40 490 9310 0.246 0.9957
Kontrola wzorem: PPV(30%) = .873 ; PPV(2%) = .246
Fałszywie dodatnie na 1 prawdziwie dodatni przy 2%: 3.06
Zadania 6–10: Fisher, McNemar, zapadalność, Kaplan–Meier i Wilcoxon
R
# B383 – zadania 6–10: test Fishera, test McNemara, chorobowość i zapadalność, Kaplan–Meier, test Wilcoxona (NRS)
# Dane wpisane na sztywno – te same co w treści zadań. Funkcje bazowego R (stats) i pakietu survival.
library(survival)
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))
pz <- function(p) if (p < .001) "< .001" else paste("=", bz(p))
proc <- function(x) paste0(formatC(100 * x, format = "f", digits = 1), "%")

# Zadanie 6. Opatrunek z chlorheksydyną a zakażenie miejsca wkłucia obwodowego (po 20 pacjentów)
tab6 <- matrix(c(1, 7, 19, 13), nrow = 2,
               dimnames = list(opatrunek = c("chlorheksydyna", "standard"), zakazenie = c("tak", "nie")))
E6 <- outer(rowSums(tab6), colSums(tab6)) / sum(tab6)
cat("Zadanie 6\n"); print(tab6)
cat("Liczności oczekiwane:\n"); print(E6)
cat("Odsetek zakażeń: chlorheksydyna =", proc(tab6[1, 1] / 20), "; standard =", proc(tab6[2, 1] / 20), "\n")
# prawdopodobieństwa wszystkich tabel o tych samych sumach brzegowych (rozkład hipergeometryczny)
x <- 0:8
ph <- dhyper(x, m = 8, n = 32, k = 20)   # x = liczba zakażeń w grupie z chlorheksydyną
print(data.frame(zakazenia_chlorheksydyna = x, p_tabeli = round(ph, 4)), row.names = FALSE)
cat("p dwustronne Fishera = suma p tabel nie bardziej prawdopodobnych niż obserwowana =",
    bz(sum(ph[ph <= ph[x == 1] * (1 + 1e-7)])), "\n")
cat("Kontrola fisher.test(): p =", bz(fisher.test(tab6)$p.value), "\n")
ch6 <- suppressWarnings(chisq.test(tab6, correct = FALSE))
cat("Dla porównania chi^2 bez poprawki: chi^2(1) =", z2(ch6$statistic), "; p =", bz(ch6$p.value), "\n\n")

# Zadanie 7. Poprawna technika użycia inhalatora przed i po edukacji (te same 50 osób)
tab7 <- matrix(c(14, 18, 3, 15), nrow = 2,
               dimnames = list(przed = c("poprawnie", "błędnie"), po = c("poprawnie", "błędnie")))
cat("Zadanie 7\n"); print(tab7)
b7 <- tab7["poprawnie", "błędnie"]; c7 <- tab7["błędnie", "poprawnie"]
cat("Poprawnie przed =", proc(sum(tab7["poprawnie", ]) / 50), "; poprawnie po =", proc(sum(tab7[, "poprawnie"]) / 50), "\n")
chi7 <- (b7 - c7)^2 / (b7 + c7)
cat("b =", b7, "; c =", c7, "; chi^2 McNemara = (b - c)^2 / (b + c) =", z2(chi7), "; p =", bz(pchisq(chi7, 1, lower.tail = FALSE)),
    "; chi^2 krytyczne =", z2(qchisq(0.95, 1)), "\n")
cat("Kontrola mcnemar.test(correct = FALSE): chi^2 =", z2(mcnemar.test(tab7, correct = FALSE)$statistic), "\n")
cat("Z poprawką na ciągłość (domyślnie w R): chi^2 =", z2(mcnemar.test(tab7)$statistic), "; p =", bz(mcnemar.test(tab7)$p.value), "\n")
p_dokl <- binom.test(b7, b7 + c7)$p.value
p_mid <- p_dokl - dbinom(b7, b7 + c7, 0.5)
cat("Dokładny test dwumianowy: p =", bz(p_dokl), "; mid-p =", bz(p_mid), "\n")
cat("Błąd – chi^2 dla prób niezależnych na tych samych osobach: chi^2 =",
    z2(chisq.test(matrix(c(17, 32, 33, 18), 2), correct = FALSE)$statistic), "\n\n")

# Zadanie 8. Chorobowość i zapadalność cukrzycy typu 2 w przychodni POZ
zapisani <- 2500; chorzy_1_stycznia <- 200; nowe <- 46; osobolata <- 2250
zagrozeni <- zapisani - chorzy_1_stycznia
cat("Zadanie 8\n")
cat("Chorobowość punktowa 1 stycznia =", proc(chorzy_1_stycznia / zapisani), "\n")
cat("Zapadalność skumulowana w roku =", nowe, "/", zagrozeni, "=", proc(nowe / zagrozeni), "\n")
cat("Współczynnik zapadalności =", z2(1000 * nowe / osobolata), "na 1000 osobolat\n")
cat("Błąd: mianownik z wszystkimi zapisanymi =", proc(nowe / zapisani), "\n\n")

# Zadanie 9. Czas do ponownej hospitalizacji po wypisie (tygodnie; 0 = obserwacja ucięta)
czas  <- c(2, 3, 5, 5, 8, 10, 12, 14, 18, 20, 26, 26)
zdarz <- c(1, 0, 1, 1, 0,  1,  0,  1,  0,  1,  0,  0)
cat("Zadanie 9\n")
tz <- sort(unique(czas[zdarz == 1])); S <- 1; tabela9 <- NULL
for (t in tz) {
  n_ryz <- sum(czas >= t); d_t <- sum(czas == t & zdarz == 1)
  S <- S * (1 - d_t / n_ryz)
  tabela9 <- rbind(tabela9, data.frame(tydzien = t, w_ryzyku = n_ryz, zdarzenia = d_t,
                                       ulamek = paste0("(", n_ryz - d_t, "/", n_ryz, ")"), S = round(S, 3)))
}
print(tabela9, row.names = FALSE)
km <- survfit(Surv(czas, zdarz) ~ 1)
print(summary(km), digits = 3)
cat("Mediana czasu do ponownej hospitalizacji =", summary(km)$table["median"], "tygodni\n")
cat("Odsetek ponownie hospitalizowanych do 26. tygodnia wg K-M = 1 - S(26) =", proc(1 - min(km$surv)), "\n")
cat("Błąd – zdarzenia / wszyscy pacjenci =", proc(sum(zdarz) / length(zdarz)),
    "; po usunięciu uciętych przed 26. tyg. =", proc(sum(zdarz) / sum(zdarz == 1 | czas == 26)), "\n\n")

# Zadanie 10. Ból w skali NRS (0–10) przed serią zabiegów fizjoterapii i po niej (12 pacjentów)
przed <- c(7, 6, 8, 5, 7, 6, 9, 4, 6, 7, 8, 5)
po    <- c(4, 5, 5, 6, 3, 6, 6, 3, 2, 4, 5, 4)
roz <- przed - po
cat("Zadanie 10\n")
cat("Różnice przed - po:", roz, "\n")
cat("Mediana przed =", median(przed), "; mediana po =", median(po), "; mediana różnic =", median(roz), "\n")
r_niez <- roz[roz != 0]; n10 <- length(r_niez)
rangi <- rank(abs(r_niez))
cat("Bez zer: n =", n10, "\n")
print(data.frame(roznica = r_niez, modul = abs(r_niez), ranga = rangi))
Wplus <- sum(rangi[r_niez > 0]); Wminus <- sum(rangi[r_niez < 0])
wiazania <- table(abs(r_niez))
EW <- n10 * (n10 + 1) / 4
VarW <- n10 * (n10 + 1) * (2 * n10 + 1) / 24 - sum(wiazania^3 - wiazania) / 48
z10 <- (min(Wplus, Wminus) - EW) / sqrt(VarW)
cat("Suma rang =", sum(rangi), "; n(n + 1)(2n + 1) / 24 =", n10 * (n10 + 1) * (2 * n10 + 1) / 24,
    "; wiązania t:", wiazania, "; suma(t^3 - t) =", sum(wiazania^3 - wiazania), "\n")
cat("W+ =", Wplus, "; W- =", Wminus, "; E(W) =", EW, "; Var(W) z poprawką na wiązania =", z3(VarW), "; SD(W) =", z2(sqrt(VarW)), "\n")
cat("W- - E(W) =", Wminus - EW, "; z =", z2(z10), "; p (dwustronne) =", bz(2 * pnorm(-abs(z10))), "; r = |z| / sqrt(n) =", bz(abs(z10) / sqrt(n10), 2), "\n")
w10 <- wilcox.test(przed, po, paired = TRUE, exact = FALSE, correct = FALSE)
cat("Kontrola wilcox.test(exact = FALSE, correct = FALSE): V =", w10$statistic, "; p =", bz(w10$p.value), "\n")
cat("Z poprawką na ciągłość (domyślnie w R): p =", bz(suppressWarnings(wilcox.test(przed, po, paired = TRUE))$p.value), "\n")
cat("Pacjenci z mniejszym bólem po zabiegach:", sum(roz > 0), "z", length(roz), "; bez zmiany:", sum(roz == 0),
    "; z większym:", sum(roz < 0), "\n")
Wynik w R
Zadanie 6
                zakazenie
opatrunek        tak nie
  chlorheksydyna   1  19
  standard         7  13
Liczności oczekiwane:
               tak nie
chlorheksydyna   4  16
standard         4  16
Odsetek zakażeń: chlorheksydyna = 5.0% ; standard = 35.0%
 zakazenia_chlorheksydyna p_tabeli
                        0   0.0016
                        1   0.0202
                        2   0.0958
                        3   0.2298
                        4   0.3052
                        5   0.2298
                        6   0.0958
                        7   0.0202
                        8   0.0016
p dwustronne Fishera = suma p tabel nie bardziej prawdopodobnych niż obserwowana = .044
Kontrola fisher.test(): p = .044
Dla porównania chi^2 bez poprawki: chi^2(1) = 5.62 ; p = .018

Zadanie 7
           po
przed       poprawnie błędnie
  poprawnie        14       3
  błędnie          18      15
Poprawnie przed = 34.0% ; poprawnie po = 64.0%
b = 3 ; c = 18 ; chi^2 McNemara = (b - c)^2 / (b + c) = 10.71 ; p = .001 ; chi^2 krytyczne = 3.84
Kontrola mcnemar.test(correct = FALSE): chi^2 = 10.71
Z poprawką na ciągłość (domyślnie w R): chi^2 = 9.33 ; p = .002
Dokładny test dwumianowy: p = .001 ; mid-p = .001
Błąd – chi^2 dla prób niezależnych na tych samych osobach: chi^2 = 9.00

Zadanie 8
Chorobowość punktowa 1 stycznia = 8.0%
Zapadalność skumulowana w roku = 46 / 2300 = 2.0%
Współczynnik zapadalności = 20.44 na 1000 osobolat
Błąd: mianownik z wszystkimi zapisanymi = 1.8%

Zadanie 9
 tydzien w_ryzyku zdarzenia  ulamek     S
       2       12         1 (11/12) 0.917
       5       10         2  (8/10) 0.733
      10        7         1   (6/7) 0.629
      14        5         1   (4/5) 0.503
      20        3         1   (2/3) 0.335
Call: survfit(formula = Surv(czas, zdarz) ~ 1)

 time n.risk n.event survival std.err lower 95% CI upper 95% CI
    2     12       1    0.917  0.0798        0.773        1.000
    5     10       2    0.733  0.1324        0.515        1.000
   10      7       1    0.629  0.1493        0.395        1.000
   14      5       1    0.503  0.1640        0.265        0.953
   20      3       1    0.335  0.1752        0.120        0.934
Mediana czasu do ponownej hospitalizacji = 20 tygodni
Odsetek ponownie hospitalizowanych do 26. tygodnia wg K-M = 1 - S(26) = 66.5%
Błąd – zdarzenia / wszyscy pacjenci = 50.0% ; po usunięciu uciętych przed 26. tyg. = 75.0%

Zadanie 10
Różnice przed - po: 3 1 3 -1 4 0 3 1 4 3 3 1
Mediana przed = 6.5 ; mediana po = 4.5 ; mediana różnic = 3
Bez zer: n = 11
   roznica modul ranga
1        3     3   7.0
2        1     1   2.5
3        3     3   7.0
4       -1     1   2.5
5        4     4  10.5
6        3     3   7.0
7        1     1   2.5
8        4     4  10.5
9        3     3   7.0
10       3     3   7.0
11       1     1   2.5
Suma rang = 66 ; n(n + 1)(2n + 1) / 24 = 126.5 ; wiązania t: 4 5 2 ; suma(t^3 - t) = 186
W+ = 63.5 ; W- = 2.5 ; E(W) = 33 ; Var(W) z poprawką na wiązania = 122.625 ; SD(W) = 11.07
W- - E(W) = -30.5 ; z = -2.75 ; p (dwustronne) = .006 ; r = |z| / sqrt(n) = .83
Kontrola wilcox.test(exact = FALSE, correct = FALSE): V = 63.5 ; p = .006
Z poprawką na ciągłość (domyślnie w R): p = .007
Pacjenci z mniejszym bólem po zabiegach: 10 z 12 ; bez zmiany: 1 ; z większym: 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakietu survival); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jakie zadania ze statystyki są na kolokwium na pielęgniarstwie i ratownictwie medycznym?
Najczęściej tabela 2 × 2 (ryzyko, ryzyko względne, iloraz szans, NNT), ocena testu diagnostycznego (czułość, swoistość, PPV, NPV), test χ² lub Fishera, test McNemara dla pomiaru przed i po, miary częstości choroby (chorobowość, zapadalność), krzywa Kaplana–Meiera i test Wilcoxona dla skal bólu. Zakres zależy od uczelni, więc porównaj go z sylabusem przedmiotu.
Czy NNT zaokrągla się w górę, czy w dół?
W górę, do pełnego pacjenta – nie da się leczyć ułamka osoby. W zadaniu 2 NNT = 1 / 0.125 = 8.00, a granice przedziału 4.75 i 25.44 dają po zaokrągleniu w górę od 5 do 26 pacjentów. Zawsze podaj też ARR z przedziałem ufności.
Jak rozpoznać w treści zadania, czy to badanie kohortowe, czy kliniczno-kontrolne?
Sprawdź, od czego zaczął badacz. Jeśli wybrał osoby według ekspozycji lub leczenia i czekał na zdarzenie, to badanie kohortowe albo eksperyment – liczysz ryzyko, RR i NNT. Jeśli wybrał osoby według choroby (przypadki i kontrole) i sprawdzał ekspozycję wstecz, to badanie kliniczno-kontrolne – liczysz tylko iloraz szans.
Czym różni się zapadalność skumulowana od współczynnika zapadalności?
Zapadalność skumulowana to odsetek osób zagrożonych, które zachorowały w danym okresie (np. 46 / 2300 = 2.0% w roku). Współczynnik zapadalności dzieli nowe przypadki przez łączny czas obserwacji w osobolatach (np. 46 / 2250 × 1000 = 20.44 na 1000 osobolat) i lepiej nadaje się, gdy pacjenci są obserwowani przez różny czas.
Co zrobić w teście Wilcoxona, gdy u pacjenta różnica przed–po wynosi zero?
W klasycznej wersji testu pary z różnicą 0 pomijasz i zmniejszasz n (tak robi też R). W zadaniu 10 jedna z 12 par miała różnicę 0, więc rangi, z i r liczysz dla n = 11. W pracy napisz, ile par pominięto i z jakiego n liczysz wielkość efektu.
Powiązane hasła
Przeczytaj też
RR, OR i NNT w pracy dyplomowej
Która miara do którego schematu badania, dlaczego OR różni się od RR przy częstym zdarzeniu, przedziały ufności i NNT przez nieskończoność – z gotowymi zdaniami i przykładem w R.
Czytaj →PoradnikPorównanie skal Braden i Norton
Korelacja to nie zgodność: tabela krzyżowa, kappa i kappa ważona, McNemar i Bowker, czułość, swoistość i AUC z testem DeLonga – z przykładem w R i wzorem opisu.
Czytaj →PoradnikAnkieta wśród personelu jednego szpitala
Populacja czy próba, odsetek odpowiedzi w oddziałach, poprawka na skończoną populację w przedziale ufności, liczebność przy małej kadrze i anonimowość małych oddziałów – z przykładem w R.
Czytaj →PoradnikJak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikZadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikTest McNemara – przed i po dla tak/nie
Tabela par, wybór wersji testu (asymptotyczna, dokładna, mid-p) i 95% CI dla sparowanej różnicy odsetków – z przykładem w R i wzorem opisu.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →Piszesz pracę z pielęgniarstwa lub ratownictwa i nie wiesz, którą analizę wybrać?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G. (1998). Confidence intervals for the number needed to treat. BMJ, 317(7168), 1309–1312. https://doi.org/10.1136/bmj.317.7168.1309 ● Otwarty dostęp: pełny tekst
- Cook, R. J., & Sackett, D. L. (1995). The number needed to treat: A clinically useful measure of treatment effect. BMJ, 310(6977), 452–454. https://doi.org/10.1136/bmj.310.6977.452 ● Otwarty dostęp: pełny tekst
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13(1), Article 91. https://doi.org/10.1186/1471-2288-13-91 ● Otwarty dostęp
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Noordzij, M., Dekker, F. W., Zoccali, C., & Jager, K. J. (2010). Measures of disease frequency: Prevalence and incidence. Nephron Clinical Practice, 115(1), c17–c20. https://doi.org/10.1159/000286345
- Petrie, A., & Sabin, C. (2006). Statystyka medyczna w zarysie. Wydawnictwo Lekarskie PZWL.
- Trevethan, R. (2017). Sensitivity, specificity, and predictive values: Foundations, pliabilities, and pitfalls in research and practice. Frontiers in Public Health, 5, Article 307. https://doi.org/10.3389/fpubh.2017.00307 ● Otwarty dostęp
Cytowania BibTeX
@article{altman1998confidence, author={Altman, Douglas G.}, title={{Confidence intervals for the number needed to treat}}, journal={BMJ}, year={1998}, volume={317}, number={7168}, pages={1309--1312}, doi={10.1136/bmj.317.7168.1309}}@article{cook1995number, author={Cook, Richard J. and Sackett, David L.}, title={{The number needed to treat: A clinically useful measure of treatment effect}}, journal={BMJ}, year={1995}, volume={310}, number={6977}, pages={452--454}, doi={10.1136/bmj.310.6977.452}}@article{fagerland2013mcnemar, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={91}, doi={10.1186/1471-2288-13-91}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{noordzij2010measures, author={Noordzij, Marlies and Dekker, Friedo W. and Zoccali, Carmine and Jager, Kitty J.}, title={{Measures of disease frequency: Prevalence and incidence}}, journal={Nephron Clinical Practice}, year={2010}, volume={115}, number={1}, pages={c17--c20}, doi={10.1159/000286345}}@book{petrie2006statystyka, author={Petrie, Aviva and Sabin, Caroline}, title={{Statystyka medyczna w zarysie}}, year={2006}, publisher={Wydawnictwo Lekarskie PZWL}}@article{trevethan2017sensitivity, author={Trevethan, Robert}, title={{Sensitivity, specificity, and predictive values: Foundations, pliabilities, and pitfalls in research and practice}}, journal={Frontiers in Public Health}, year={2017}, volume={5}, eid={307}, doi={10.3389/fpubh.2017.00307}}