Cztery pytania zamiast jednego „która skala jest lepsza”
W pracy z pielęgniarstwa często pada pytanie: czy skala Bradena i skala Norton dają ten sam obraz ryzyka odleżyn u tych samych pacjentów i która z nich lepiej je przewiduje. Brzmi to jak jedno pytanie, ale kryją się za nim cztery różne problemy statystyczne. Każdy wymaga innej analizy:
- Czy skale klasyfikują pacjentów tak samo? To pytanie o zgodność kategorii: tabela krzyżowa, odsetek zgodności, kappa Cohena.
- Czy jedna skala systematycznie uznaje za zagrożonych więcej osób? To pytanie o różnicę odsetków w parach: test McNemara, a dla kilku kategorii test symetrii Bowkera.
- Która skala trafniej przewiduje odleżynę? To pytanie o trafność prognostyczną: czułość, swoistość, PPV i NPV przy przyjętych progach oraz pole pod krzywą ROC (AUC) porównane testem DeLonga.
- Czy dwie pielęgniarki oceniające tę samą skalą dostaną ten sam wynik? To pytanie o rzetelność oceny: ICC i kappa dla dwóch oceniających.
Korelacja wyników obu skal nie odpowiada na żadne z tych pytań wprost. Pokazujemy to na przykładzie. Jak policzyć sam wynik każdej skali, jakie progi podaje literatura i jak sprawdzić trafność jednej skali, opisują wpisy o skali Bradena i skali Norton. Tu zajmujemy się tylko porównaniem dwóch narzędzi u tych samych osób.
Projekt badania: obie skale u każdego pacjenta
Porównanie ma sens wtedy, gdy każdy pacjent jest oceniony obiema skalami w tym samym momencie, najlepiej przy przyjęciu, zanim pojawi się odleżyna. Dane są wtedy sparowane: każdy pacjent ma dwa wyniki. Testy dla grup niezależnych (chi-kwadrat dla tabeli „skala × wynik”, test z dla dwóch proporcji, porównanie dwóch AUC jak z dwóch prób) są tu błędne, bo pomijają tę zależność.
Z projektu wynikają trzy decyzje, które warto opisać w rozdziale metodologicznym:
- Progi i kategorie ustalone przed analizą, ze źródłem. W przykładzie za zagrożonych uznajemy pacjentów z wynikiem Bradena ≤ 18, czyli ogólnym punktem odcięcia z badania wieloośrodkowego Bergstrom i in. (1998), oraz z wynikiem Norton ≤ 14. Dla skali Norton Elli i in. (2022) opisują wynik ≤ 9 jako bardzo wysokie ryzyko, a 10–14 jako wysokie. W tym samym przykładzie sprawdzamy też progi z badania porównawczego Defloor i Grypdonck (2005): Braden < 17 i Norton < 12.
- Niezależność ocen. Jeśli ta sama pielęgniarka wypełnia obie skale jedna po drugiej, wynik pierwszej może wpływać na drugą. Lepiej, gdy skale wypełniają różne osoby albo gdy kolejność jest losowa. Osoba, która stwierdza odleżynę, nie powinna znać wyników skal.
- Definicja zdarzenia i czas obserwacji. Napisz, co liczysz jako nową odleżynę (np. dowolny stopień) i jak długo obserwujesz pacjentów. W przykładzie jest to 14 dni.
Pamiętaj też o profilaktyce. Pacjenci uznani za zagrożonych dostają zwykle więcej działań zapobiegawczych. Defloor i Grypdonck (2005) wskazują, że skuteczna profilaktyka obniża wartość prognostyczną skal, bo zapobiega części odleżyn w grupie ryzyka. W pracy dyplomowej nie da się tego usunąć, ale trzeba to wymienić wśród ograniczeń.
Przykład: 300 pacjentów ocenionych obiema skalami
Dane są symulowane i możesz je pobrać jako plik CSV. Każdy z 300 pacjentów bez odleżyny przy przyjęciu ma wynik w skali Bradena (kolumna braden, zakres 6–23) i w skali Norton (norton, zakres 5–20). W obu skalach niższy wynik oznacza większe ryzyko. Kolumna odlezyna to nowa odleżyna w ciągu 14 dni (0/1). U pierwszych 60 pacjentów druga pielęgniarka niezależnie oceniła skalę Bradena (braden_p2).
Średni wynik Bradena wyniósł 18.76 (SD = 2.93, Mdn = 19, zakres 9–23), a Norton 16.23 (SD = 2.92, Mdn = 17, zakres 7–20). Nowa odleżyna pojawiła się u 33 osób, czyli u 11.0% pacjentów.
Korelacja wyników: dlaczego to za mało
Najczęstszy pierwszy krok w pracach dyplomowych to korelacja obu wyników. Oba są porządkowe, a ich rozkłady mają efekt sufitu, więc wybieramy korelację Spearmana. W przykładzie wyniosła ρ = .66, p < .001. To silny związek i łatwo wyciągnąć z niego wniosek, że „skale są zgodne”. Tak nie jest.
Korelacja mówi tylko, że pacjenci z niższym wynikiem w jednej skali mają zwykle niższy wynik w drugiej. Nie mówi, czy obie skale uznają za zagrożonych tych samych pacjentów. Wysoka korelacja może iść w parze z tym, że jedna skala oznacza jako zagrożonych dwa razy więcej osób. Bland i Altman (1986) pokazali to dla dwóch metod pomiaru tej samej wielkości: współczynnik korelacji wprowadza w błąd, bo mierzy siłę związku, a nie zgodność.
Przy skalach ryzyka jest jeszcze jeden problem. Skale mają różne zakresy i nie mierzą w tych samych jednostkach. Punkt w skali Bradena nie jest punktem w skali Norton, więc nie da się policzyć różnicy wyników ani zrobić wykresu Blanda–Altmana. Takie metody pasują do dwóch pomiarów tej samej wielkości, np. dwóch ciśnieniomierzy, co opisuje wpis o zgodności dwóch metod pomiaru. Skale ryzyka porównujemy więc przez decyzje, które z nich wynikają, czyli przez kategorie ryzyka. Robimy to przy progach przyjętych w praktyce, a nie przez wynik liczbowy.
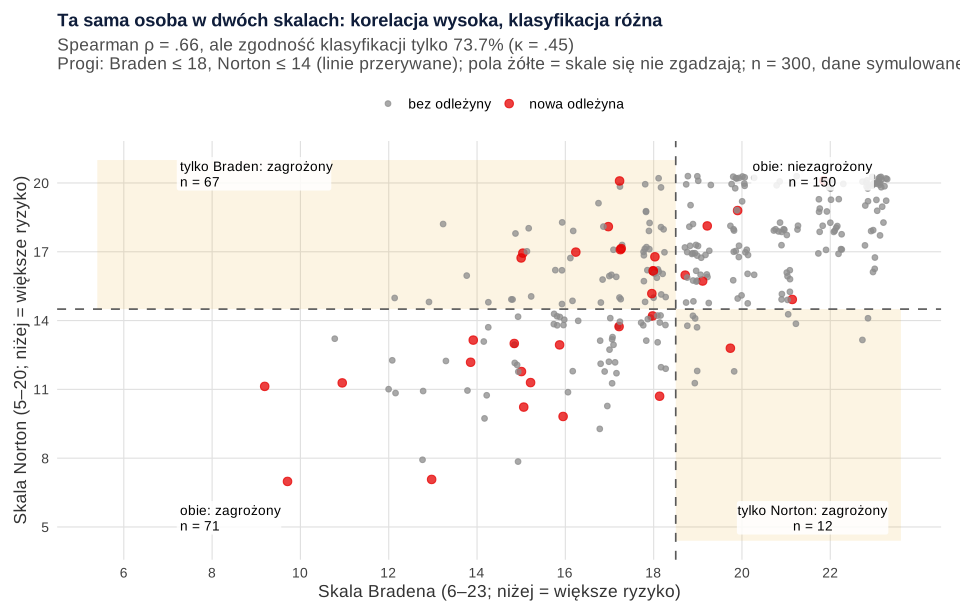
Rysunek 1 pokazuje, skąd bierze się rozbieżność. Punkty układają się wzdłuż przekątnej (stąd wysoka korelacja). Aż 67 pacjentów znalazło się jednak w polu „tylko Braden: zagrożony”, a tylko 12 w polu „tylko Norton: zagrożony”.
Zgodność klasyfikacji: kappa i test McNemara
Tabela krzyżowa z kategoriami obu skal to podstawa całej analizy. Wpisz ją do pracy, bo z niej czytelnik policzy każdą miarę.
| Skala Bradena | Norton: zagrożony | Norton: niezagrożony | Razem |
|---|---|---|---|
| Zagrożony | 71 | 67 | 138 (46.0%) |
| Niezagrożony | 12 | 150 | 162 |
| Razem | 83 (27.7%) | 217 | 300 |
Z tabeli wynikają dwie różne informacje:
- Ile jest zgodności. Skale zgodziły się u 71 + 150 = 221 pacjentów, czyli w 73.7% przypadków. Część tej zgodności byłaby jednak przypadkowa, bo obie skale uznają większość pacjentów za niezagrożonych. Kappa Cohena odejmuje zgodność oczekiwaną przy przypadku: κ = .45, 95% CI [.36, .55]. Taka zgodność jest umiarkowana, a nie „dobra”. Kappę liczysz także w kalkulatorze kappy i testu McNemara.
- W którą stronę idą rozbieżności. Test McNemara patrzy tylko na pary niezgodne: 67 pacjentów zagrożonych tylko według Bradena i 12 tylko według Norton. Gdyby skale różniły się losowo, obie liczby byłyby podobne. Wynik χ²(1, N = 300) = 38.29, p < .001 oznacza, że skala Bradena przy tym progu uznaje za zagrożonych istotnie więcej pacjentów (46.0%) niż skala Norton (27.7%).
Kappa i McNemar odpowiadają więc na różne pytania. Kappa mówi, jak często skale się zgadzają. McNemar mówi, czy jedna z nich systematycznie częściej daje wynik „zagrożony”. Możliwa jest niska kappa przy nieistotnym McNemarze (rozbieżności rozkładają się po równo w obie strony) i odwrotnie. Logikę testu dla par opisuje wpis o teście McNemara przed i po. Tutaj zamiast „przed” i „po” mamy dwie skale.
Uwaga na interpretację kappy. Jej wartość zależy od tego, jak często występuje kategoria „zagrożony”. Przy bardzo niezrównoważonych rozkładach wysoki odsetek zgodności może iść w parze z niską kappą (tzw. paradoksy kappy, omówione we wpisie o zgodności sędziów). Dlatego zawsze podawaj obok kappy odsetek zgodności i całą tabelę.
Trzy kategorie ryzyka: kappa ważona i test Bowkera
Wiele placówek używa więcej niż dwóch kategorii ryzyka. Każda skala ma jednak własny podział, a systemów kategorii jest kilka nawet dla jednej skali. Żeby zbudować kwadratową tabelę, trzeba więc najpierw przypisać kategorie obu skal do tych samych poziomów. W przykładzie przyjęliśmy trzy poziomy:
- Norton według Elli i in. (2022): ≤ 9 – wysokie (w źródle: bardzo wysokie), 10–14 – pośrednie (w źródle: wysokie), 15–20 – niskie;
- Braden według Yap i in. (2022), po połączeniu sąsiednich kategorii: ≤ 12 – wysokie (w źródle: ciężkie i wysokie), 13–18 – pośrednie (umiarkowane i łagodne), 19–23 – niskie.
To połączenie jest naszą decyzją. Źródła nie mówią, że „wysokie” w obu skalach to to samo ryzyko. Takie przypisanie musisz opisać i uzasadnić w pracy. Jeśli nie da się go obronić, zostań przy dwóch kategoriach z progami z literatury.
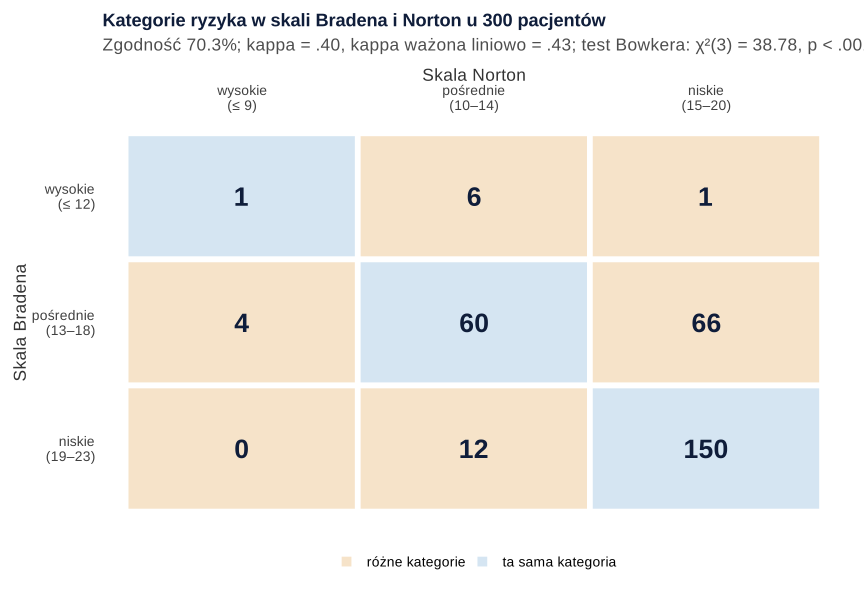
Tę samą kategorię przypisano 211 pacjentom (70.3%), a zwykła kappa wyniosła κ = .40, 95% CI [.31, .49]. Przy kategoriach uporządkowanych lepiej pasuje kappa ważona. Cohen (1968) zaproponował ją dla sytuacji, w których nie każda niezgodność jest tak samo poważna. Pomyłka „wysokie–niskie” waży więcej niż „wysokie–pośrednie”. Z wagami liniowymi κw = .43, 95% CI [.34, .52], a z kwadratowymi κw = .47, 95% CI [.38, .56]. Rodzaj wag wybierz przed analizą i podaj w metodach, bo wynik od nich zależy (tu wagi kwadratowe dały wartość wyższą niż liniowe).
Odpowiednikiem testu McNemara dla tabeli 3 × 3 jest test symetrii Bowkera. Sprawdza, czy pacjentów przesuniętych z kategorii A do B jest tyle samo co z B do A. W przykładzie χ²(3) = 38.79, p < .001. Główne źródło asymetrii widać na rysunku 2: 66 pacjentów ma ryzyko pośrednie według Bradena i niskie według Norton, a tylko 12 odwrotnie. W R ten test daje ta sama funkcja mcnemar.test() wywołana dla tabeli większej niż 2 × 2. Gdy obie komórki jakiejś pary są puste, test nie działa i trzeba połączyć kategorie.
Która skala lepiej przewiduje odleżyny: czułość i swoistość
Zgodność skal nie mówi, która z nich jest trafniejsza. Dwie skale mogą się świetnie zgadzać i obie źle przewidywać. Do oceny trafności potrzebny jest wynik, czyli nowa odleżyna w obserwacji. Dla każdej skali liczysz te same cztery miary względem odleżyny, z przedziałami Wilsona (zob. przedział ufności dla proporcji).
| Miara | Braden ≤ 18 | Norton ≤ 14 | Braden ≤ 16 | Norton ≤ 11 |
|---|---|---|---|---|
| Oznaczonych jako zagrożeni | 46.0% | 27.7% | 20.3% | 7.0% |
| Czułość | 78.8% [62.2, 89.3] | 48.5% [32.5, 64.8] | 45.5% [29.8, 62.0] | 24.2% [12.8, 41.0] |
| Swoistość | 58.1% [52.1, 63.8] | 74.9% [69.4, 79.7] | 82.8% [77.8, 86.8] | 95.1% [91.8, 97.1] |
| PPV | 18.8% [13.2, 26.2] | 19.3% [12.2, 29.0] | 24.6% [15.5, 36.7] | 38.1% [20.8, 59.1] |
| NPV | 95.7% [91.4, 97.9] | 92.2% [87.8, 95.1] | 92.5% [88.4, 95.2] | 91.0% [87.1, 93.9] |
Czułość i swoistość obu skal mierzone są u tych samych pacjentów, więc i tu stosujemy test dla par. Trajman i Luiz (2008) proponują test McNemara liczony osobno: dla czułości tylko u pacjentów z odleżyną, a dla swoistości tylko u pacjentów bez niej.
- Czułość (33 pacjentów z odleżyną): 11 osób wskazała tylko skala Bradena, a 1 tylko skala Norton. Przy tak małej liczbie par niezgodnych używamy wersji dokładnej (dwumianowej): p = .006.
- Swoistość (267 pacjentów bez odleżyny): 56 osób uznała za zagrożone tylko skala Bradena, a 11 tylko skala Norton; χ²(1, N = 267) = 30.22, p < .001.
Skala Bradena przy progu 18 jest więc czulsza, a skala Norton przy progu 14 – bardziej swoista. To nie znaczy, że któraś jest lepsza. Oba wyniki wynikają głównie z tego, że próg Bradena jest łagodniejszy i oznacza jako zagrożonych więcej pacjentów. Kiedy zmienisz progi na te z badania Defloor i Grypdonck (2005), obie skale tracą czułość i zyskują swoistość, a skala Norton przy progu < 12 oznacza jako zagrożonych tylko 7.0% pacjentów. Porównanie czułości przy jednym progu porównuje reguły decyzyjne, a nie same skale. Napisz to wprost w dyskusji.
Wartości predykcyjne zależą od tego, jak często występuje odleżyna. Przy zapadalności 11.0% PPV obu skal przy podstawowych progach wynosi niecałe 20%, czyli ponad cztery na pięć osób oznaczonych jako zagrożone nie będą miały odleżyny. Definicje wyjaśniają hasła czułość i swoistość oraz PPV i NPV.
Porównanie AUC: test DeLonga dla krzywych zależnych
Pole pod krzywą ROC opisuje zdolność skali do rozróżniania pacjentów we wszystkich progach naraz. Dlatego lepiej nadaje się do porównania samych narzędzi niż czułość przy jednym progu. W przykładzie AUC = .74, 95% CI [.66, .82] dla skali Bradena i AUC = .68, 95% CI [.58, .78] dla skali Norton.
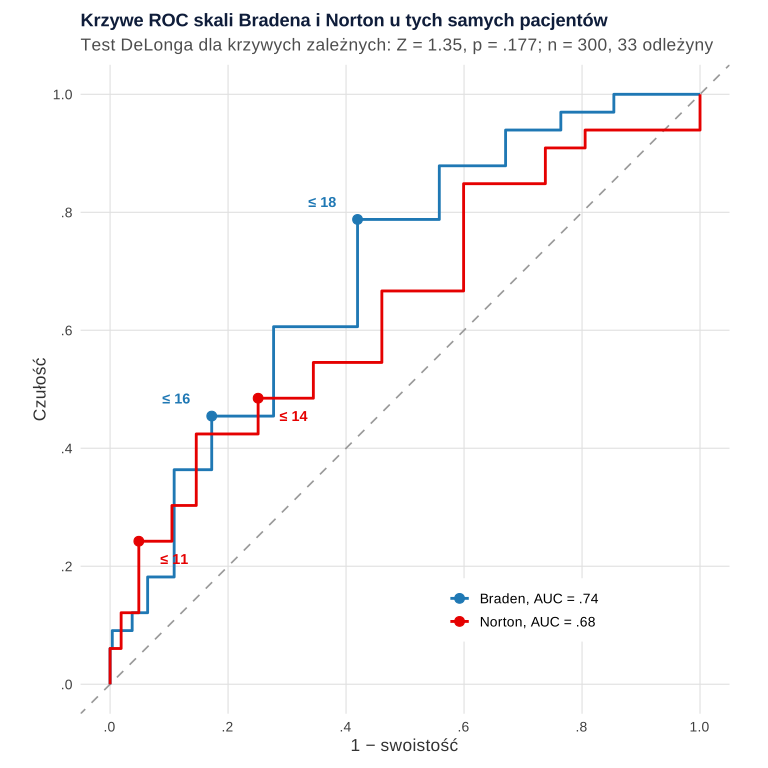
Obie krzywe pochodzą od tych samych pacjentów, więc pola są skorelowane. DeLong, DeLong i Clarke-Pearson (1988) zaproponowali nieparametryczną metodę, która tę korelację uwzględnia. Opisuje ją hasło test DeLonga. W pakiecie pROC wywołujesz ją przez roc.test(..., paired = TRUE). Wynik: różnica AUC = .06, 95% CI [−.03, .15], Z = 1.35, p = .177. Mimo wyraźnej różnicy czułości przy przyjętych progach dane nie pozwalają stwierdzić, że jedna skala ogólnie lepiej rozróżnia pacjentów.
Brak istotnej różnicy nie dowodzi, że skale są równoważne. Przedział ufności różnicy sięga od −.03 do .15, czyli zgadza się zarówno z niewielką przewagą Norton, jak i z wyraźną przewagą Bradena. Przy 33 zdarzeniach precyzja jest mała. Liczebność potrzebną do porównania AUC omawia wpis o liczebności w badaniu diagnostycznym. Wybór progu na podstawie krzywej opisuje wpis krzywa ROC i punkt odcięcia krok po kroku.
Wyniki literatury też nie dają jednej odpowiedzi. W przeglądzie systematycznym Pancorbo-Hidalgo i in. (2006) skala Bradena miała najlepszą równowagę czułości i swoistości (57.1% i 67.5%), a skala Norton miała czułość 46.8% i swoistość 61.8%. W badaniu 1772 starszych pacjentów Defloor i Grypdonck (2005) uzyskali podobną dokładność obu skal. To są średnie z innych populacji i innych progów. W Twoim badaniu wynik może być inny.
Zgodność dwóch pielęgniarek oceniających tę samą skalę
Porównanie dwóch skal i zgodność dwóch oceniających to dwa różne badania, choć w obu liczy się kappę. W drugim jedna skala jest wypełniana przez dwie osoby u tych samych pacjentów. Jeśli zgodność oceniających jest słaba, rozbieżność między skalami może wynikać po części z błędu oceny, a nie z różnic między narzędziami.
W przykładzie dwie pielęgniarki niezależnie oceniły skalą Bradena 60 pacjentów. Zgodność wyniku liczbowego wyniosła ICC(A,1) = .89, 95% CI [.82, .93], a druga pielęgniarka dawała średnio o 0.22 punktu więcej. Tę samą decyzję przy progu 18 podjęły w 81.7% przypadków, κ = .62, 95% CI [.41, .82]. Kategoria jest więc mniej zgodna niż wynik, bo pacjenci blisko progu łatwo przechodzą na drugą stronę. Wybór formy ICC i liczebność próby opisuje poradnik badanie rzetelności pomiaru klinicznego.
Jak opisać porównanie skal w pracy
Liczby pochodzą z przykładu. W nawiasach kwadratowych uzupełnij szczegóły własnego badania.
W rozdziale wyników daj tabelę krzyżową obu skal i tabelę trafności z obiema skalami w sąsiednich kolumnach. W dyskusji oddziel trzy wnioski: czy skale są zgodne, czy któraś częściej daje wynik „zagrożony” i czy któraś lepiej przewiduje odleżyny. Do raportowania badań trafności przydaje się lista STARD. Szerszy kontekst analiz w pracach z pielęgniarstwa daje wpis statystyka w pracy z pielęgniarstwa.
Porównanie dwóch skal w R: kod i wynik
Kod odtwarza wszystkie liczby z tekstu i zapisuje plik CSV z danymi. Kappę z przedziałem ufności i przedziały Wilsona daje pakiet DescTools, ICC – pakiet irr, a krzywe ROC i test DeLonga – pakiet pROC. Test Bowkera liczy funkcja mcnemar.test() z pakietu stats.
Zgodność, różnica klasyfikacji i trafność prognostyczna dwóch skal
R
# B436 – porównanie dwóch skal ryzyka odleżyn (Braden i Norton) u tych samych pacjentów
# (dane symulowane, set.seed(43601)). 300 pacjentów bez odleżyny przy przyjęciu, obie skale przy przyjęciu,
# nowa odleżyna w ciągu 14 dni; u pierwszych 60 pacjentów druga pielęgniarka niezależnie oceniła skalę Bradena.
# W obu skalach niższy wynik = większe ryzyko. Progi: Braden <= 18 (Bergstrom i in., 1998), Norton <= 14 (Elli i in., 2022).
suppressPackageStartupMessages({ library(DescTools); library(irr); library(pROC) })
set.seed(43601)
n <- 300
R <- rnorm(n)                                                    # ukryte ryzyko pacjenta
ogranicz <- function(x, od, do) pmin(pmax(round(x), od), do)
braden_stan <- 18.8 - 2.9 * R + rnorm(n, 0, 1.3)                 # „prawdziwy” stan w skali Bradena
braden <- ogranicz(braden_stan + rnorm(n, 0, 0.9), 6, 23)        # ocena pielęgniarki 1
norton <- ogranicz(16.4 - 2.6 * R + rnorm(n, 0, 2.0), 5, 20)     # ta sama osoba, skala Norton
odlezyna <- rbinom(n, 1, plogis(-2.6 + 1.15 * R))                # nowa odleżyna w ciągu 14 dni (0/1)
braden_p2 <- rep(NA, n)
braden_p2[1:60] <- ogranicz(braden_stan[1:60] + rnorm(60, 0.3, 0.9), 6, 23)   # pielęgniarka 2, ci sami pacjenci
dane <- data.frame(id = 1:n, braden, norton, odlezyna, braden_p2)
write.csv(dane, "../braden-norton-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania

# Krok 1. Opis obu wyników i zapadalność
all(braden %in% 6:23); all(norton %in% 5:20)
round(rbind(braden = c(M = mean(braden), SD = sd(braden), Me = median(braden), min = min(braden), max = max(braden)),
            norton = c(mean(norton), sd(norton), median(norton), min(norton), max(norton))), 2)
c(odlezyny = sum(odlezyna), zapadalnosc_proc = round(100 * mean(odlezyna), 1))

# Krok 2. Korelacja wyników (Spearman) – siła związku, nie zgodność
sp <- cor.test(braden, norton, method = "spearman", exact = FALSE)
round(c(rho = unname(sp$estimate), p = sp$p.value), 3)

# Krok 3. Zgodność klasyfikacji „zagrożony / niezagrożony”: tabela, odsetek zgodności, kappa, McNemar
b_ryz <- factor(braden <= 18, c(TRUE, FALSE), c("zagrozony", "niezagrozony"))
n_ryz <- factor(norton <= 14, c(TRUE, FALSE), c("zagrozony", "niezagrozony"))
t2 <- table(Braden = b_ryz, Norton = n_ryz); addmargins(t2)
round(c(zgodnosc_proc = 100 * sum(diag(t2)) / n, Braden_zagrozeni_proc = 100 * mean(braden <= 18),
        Norton_zagrozeni_proc = 100 * mean(norton <= 14)), 1)
round(CohenKappa(t2, conf.level = 0.95), 3)
mcnemar.test(t2, correct = FALSE)

# Krok 4. Trzy kategorie ryzyka: kappa zwykła i ważona, test symetrii Bowkera
# Braden: <= 12 wysokie, 13–18 pośrednie, 19–23 niskie (połączone kategorie z Yap i in., 2022)
# Norton: <= 9 wysokie (bardzo wysokie), 10–14 pośrednie (wysokie), 15–20 niskie (Elli i in., 2022)
poz <- c("wysokie", "posrednie", "niskie")
b_kat <- cut(braden, c(5, 12, 18, 23), labels = poz)
n_kat <- cut(norton, c(4, 9, 14, 20), labels = poz)
t3 <- table(Braden = b_kat, Norton = n_kat); addmargins(t3)
round(rbind(zwykla = CohenKappa(t3, conf.level = 0.95),
            wazona_liniowo = CohenKappa(t3, weights = "Equal-Spacing", conf.level = 0.95),
            wazona_kwadratowo = CohenKappa(t3, weights = "Fleiss-Cohen", conf.level = 0.95)), 3)
mcnemar.test(t3)                                                  # dla tabeli 3 × 3 to test symetrii Bowkera

# Krok 5. Trafność prognostyczna przy przyjętych progach (95% CI Wilsona)
miary <- function(test, y) { tp <- sum(test & y); fp <- sum(test & !y); fn <- sum(!test & y); tn <- sum(!test & !y)
  w <- function(a, b) 100 * BinomCI(a, a + b, method = "wilson")
  m <- rbind(w(tp, fn), w(tn, fp), w(tp, fp), w(tn, fn))
  dimnames(m) <- list(c("czulosc", "swoistosc", "PPV", "NPV"), c("proc", "lo", "hi")); round(m, 1) }
y <- odlezyna == 1
cbind(Braden = miary(braden <= 18, y), Norton = miary(norton <= 14, y))
# Te same dane przy progach z badania Defloor i Grypdonck (2005): Braden < 17, Norton < 12
cbind(Braden = miary(braden <= 16, y), Norton = miary(norton <= 11, y))
round(c(Braden_zagrozeni_proc = 100 * mean(braden <= 16), Norton_zagrozeni_proc = 100 * mean(norton <= 11)), 1)

# Krok 6. Porównanie czułości (tylko pacjenci z odleżyną) i swoistości (tylko bez odleżyny) testem McNemara
tc <- table(Braden = braden[y] <= 18, Norton = norton[y] <= 14); tc
binom.test(tc["TRUE", "FALSE"], tc["TRUE", "FALSE"] + tc["FALSE", "TRUE"])$p.value   # wersja dokładna (mało par niezgodnych)
ts <- table(Braden = braden[!y] > 18, Norton = norton[!y] > 14); ts
mcnemar.test(ts, correct = FALSE)

# Krok 7. Krzywe ROC obu skal na tych samych pacjentach i test DeLonga dla krzywych zależnych
roc_b <- roc(odlezyna, braden, levels = c(0, 1), direction = ">", quiet = TRUE)
roc_n <- roc(odlezyna, norton, levels = c(0, 1), direction = ">", quiet = TRUE)
auc_ci <- function(r) setNames(round(as.numeric(ci.auc(r, method = "delong"))[c(2, 1, 3)], 3), c("AUC", "lo", "hi"))
rbind(Braden = auc_ci(roc_b), Norton = auc_ci(roc_n))
dl <- roc.test(roc_b, roc_n, method = "delong", paired = TRUE)
round(c(Z = unname(dl$statistic), p = dl$p.value, roznica = unname(diff(rev(dl$estimate)))), 3)
round(as.numeric(dl$conf.int), 3)                                 # 95% CI różnicy AUC (Braden − Norton)

# Krok 8. Zgodność dwóch pielęgniarek oceniających skalę Bradena (60 pacjentów)
p2 <- na.omit(dane[, c("braden", "braden_p2")])
ic <- icc(p2, model = "twoway", type = "agreement", unit = "single")
round(c(ICC_A1 = ic$value, lo = ic$lbound, hi = ic$ubound), 2)
round(c(srednia_roznica = mean(p2$braden_p2 - p2$braden), zgodnosc_kat_proc = 100 * mean((p2$braden <= 18) == (p2$braden_p2 <= 18))), 2)
round(CohenKappa(table(p2$braden <= 18, p2$braden_p2 <= 18), conf.level = 0.95), 3)
Wynik w R
[1] TRUE
[1] TRUE
           M   SD Me min max
braden 18.76 2.93 19   9  23
norton 16.23 2.92 17   7  20
        odlezyny zapadalnosc_proc
              33               11
  rho     p
0.659 0.000
              Norton
Braden         zagrozony niezagrozony Sum
  zagrozony           71           67 138
  niezagrozony        12          150 162
  Sum                 83          217 300
        zgodnosc_proc Braden_zagrozeni_proc Norton_zagrozeni_proc
                 73.7                  46.0                  27.7
 kappa lwr.ci upr.ci
 0.454  0.359  0.549

	McNemar's Chi-squared test

data:  t2
McNemar's chi-squared = 38.291, df = 1, p-value = 6.094e-10

           Norton
Braden      wysokie posrednie niskie Sum
  wysokie         1         6      1   8
  posrednie       4        60     66 130
  niskie          0        12    150 162
  Sum             5        78    217 300
                  kappa lwr.ci upr.ci
zwykla            0.402  0.310  0.494
wazona_liniowo    0.428  0.340  0.516
wazona_kwadratowo 0.472  0.383  0.562

	McNemar's Chi-squared test

data:  t3
McNemar's chi-squared = 38.785, df = 3, p-value = 1.928e-08

          proc   lo   hi proc   lo   hi
czulosc   78.8 62.2 89.3 48.5 32.5 64.8
swoistosc 58.1 52.1 63.8 74.9 69.4 79.7
PPV       18.8 13.2 26.2 19.3 12.2 29.0
NPV       95.7 91.4 97.9 92.2 87.8 95.1
          proc   lo   hi proc   lo   hi
czulosc   45.5 29.8 62.0 24.2 12.8 41.0
swoistosc 82.8 77.8 86.8 95.1 91.8 97.1
PPV       24.6 15.5 36.7 38.1 20.8 59.1
NPV       92.5 88.4 95.2 91.0 87.1 93.9
Braden_zagrozeni_proc Norton_zagrozeni_proc
                 20.3                   7.0
       Norton
Braden  FALSE TRUE
  FALSE     6    1
  TRUE     11   15
[1] 0.006347656
       Norton
Braden  FALSE TRUE
  FALSE    56   56
  TRUE     11  144

	McNemar's Chi-squared test

data:  ts
McNemar's chi-squared = 30.224, df = 1, p-value = 3.849e-08

         AUC    lo    hi
Braden 0.742 0.661 0.824
Norton 0.681 0.582 0.780
      Z       p roznica
  1.351   0.177   0.061
[1] -0.027  0.149
ICC_A1     lo     hi
  0.89   0.82   0.93
  srednia_roznica zgodnosc_kat_proc
             0.22             81.67
 kappa lwr.ci upr.ci
 0.615  0.411  0.820
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakietów DescTools, irr i pROC); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- irr (wersja 0.85): Gamer, M., Lemon, J., Fellows, I., & Singh, P. (2026). irr: Various coefficients of interrater reliability and agreement (R package version 0.85) [Computer software]. https://doi.org/10.32614/CRAN.package.irr
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy przy porównaniu dwóch skal
- Korelacja jako dowód zgodności. ρ = .66 w przykładzie szło w parze z 79 pacjentami zaklasyfikowanymi różnie. Podaj tabelę krzyżową, odsetek zgodności i kappę.
- Testy dla grup niezależnych. Chi-kwadrat dla tabeli „skala × zagrożony” albo porównanie dwóch AUC jak z różnych prób pomija to, że każdy pacjent ma oba wyniki. Używaj testu McNemara, testu Bowkera i testu DeLonga dla krzywych zależnych.
- Kappa jako miara trafności. Kappa mówi, jak bardzo skale zgadzają się ze sobą, a nie z odleżyną. Trafność liczysz względem wyniku obserwacji.
- Wniosek „skala A jest lepsza”, bo ma wyższą czułość. Przy jednym progu porównujesz reguły decyzyjne. Pokaż obie miary, obie skale przy kilku progach i AUC.
- Brak istotnej różnicy AUC jako dowód równoważności. Podaj przedział ufności różnicy i zwróć uwagę na liczbę zdarzeń.
- Kategorie dobrane po obejrzeniu danych. Progi i przypisanie kategorii obu skal ustal przed analizą i podaj źródła.
Jeśli chcesz, żeby ktoś sprawdził porównanie skal w Twojej bazie, skorzystaj z oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy wysoka korelacja wyników skali Bradena i Norton oznacza, że skale są zgodne?
Nie. Korelacja Spearmana mierzy, czy wyniki rosną razem, a nie, czy obie skale zaliczają tych samych pacjentów do grupy ryzyka. W przykładzie ρ = .66, ale skale zaklasyfikowały różnie 79 z 300 pacjentów (κ = .45). Zgodność opisuj tabelą krzyżową kategorii, odsetkiem zgodności i kappą.
Czym różni się kappa od testu McNemara przy porównaniu dwóch skal?
Kappa mówi, jak często skale przypisują pacjentowi tę samą kategorię, po odjęciu zgodności przypadkowej. Test McNemara patrzy tylko na pary niezgodne i sprawdza, czy jedna skala systematycznie częściej daje wynik „zagrożony”. Podaj obie miary, bo odpowiadają na różne pytania.
Jak porównać czułość dwóch skal ocenianych u tych samych pacjentów?
Testem McNemara liczonym tylko u pacjentów, u których wystąpiła odleżyna (dla swoistości – tylko u pacjentów bez odleżyny), jak proponują Trajman i Luiz (2008). Przy małej liczbie par niezgodnych użyj wersji dokładnej. Pamiętaj, że przy jednym progu porównujesz reguły decyzyjne, a nie same skale.
Którym testem porównać pola pod krzywą ROC dwóch skal ryzyka?
Jeśli obie skale oceniono u tych samych pacjentów, użyj testu DeLonga dla krzywych zależnych, np. roc.test(..., paired = TRUE) w pakiecie pROC. Podaj obie wartości AUC z przedziałami ufności, różnicę z jej przedziałem i liczbę zdarzeń. Nieistotna różnica nie oznacza, że skale są równoważne.
Czy kappę ważoną można liczyć dla kategorii ryzyka dwóch różnych skal?
Tak, jeśli najpierw przypiszesz kategorie obu skal do tych samych uporządkowanych poziomów (np. wysokie, pośrednie, niskie) i uzasadnisz to przypisanie źródłami. Rodzaj wag (liniowe albo kwadratowe) wybierz przed analizą. Różnicę rozkładu kategorii sprawdzisz testem symetrii Bowkera.
Powiązane hasła
Przeczytaj też
Skala Bradena – jak policzyć i analizować wynik
Wynik 6–23 i jego kierunek, progi 16 i 18, kategorie ryzyka, ROC przy przyjęciu i po 48–72 godzinach oraz prawa autorskie – z przykładem w R i wzorem opisu w pracy.
Czytaj →PoradnikSkala Norton – jak policzyć wynik
Wynik 5–20, progi ze źródłami, czułość, swoistość, wartości predykcyjne, krzywa ROC i zgodność pielęgniarek – z przykładem w R i wzorem opisu.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikAnaliza dokumentacji medycznej – badanie retrospektywne
Pytanie, kryteria, karta zbierania danych, „brak wpisu” ≠ „nie”, kappa na podpróbie kart, braki, zgody, STROBE i RECORD – z przykładem w R.
Czytaj →Porównujesz dwie skale ryzyka w pracy z pielęgniarstwa?
Sprawdzimy przygotowanie danych, dobór miar zgodności i testów dla par, czułość, swoistość i porównanie krzywych ROC oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bergstrom, N., Braden, B., Kemp, M., Champagne, M., & Ruby, E. (1998). Predicting pressure ulcer risk: A multisite study of the predictive validity of the Braden Scale. Nursing Research, 47(5), 261–269. https://doi.org/10.1097/00006199-199809000-00005
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/s0140-6736(86)90837-8
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Defloor, T., & Grypdonck, M. F. H. (2005). Pressure ulcers: Validation of two risk assessment scales. Journal of Clinical Nursing, 14(3), 373–382. https://doi.org/10.1111/j.1365-2702.2004.01058.x
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Elli, C., Novella, A., Nobili, A., Ianes, A., & Pasina, L. (2022). Factors associated with a high-risk profile for developing pressure injuries in long-term residents of nursing homes. Medical Principles and Practice, 31(5), 433–438. https://doi.org/10.1159/000527063 ● Otwarty dostęp
- Pancorbo-Hidalgo, P. L., Garcia-Fernandez, F. P., Lopez-Medina, I. M., & Alvarez-Nieto, C. (2006). Risk assessment scales for pressure ulcer prevention: A systematic review. Journal of Advanced Nursing, 54(1), 94–110. https://doi.org/10.1111/j.1365-2648.2006.03794.x
- Trajman, A., & Luiz, R. R. (2008). McNemar χ2 test revisited: Comparing sensitivity and specificity of diagnostic examinations. Scandinavian Journal of Clinical and Laboratory Investigation, 68(1), 77–80. https://doi.org/10.1080/00365510701666031
- Yap, T. L., Horn, S. D., Sharkey, P. D., Zheng, T., Bergstrom, N., Colon-Emeric, C., Sabol, V. K., Alderden, J., Yap, W., & Kennerly, S. M. (2022). Effect of varying repositioning frequency on pressure injury prevention in nursing home residents: TEAM-UP trial results. Advances in Skin & Wound Care, 35(6), 315–325. https://doi.org/10.1097/01.asw.0000817840.68588.04 ● Otwarty dostęp
Cytowania BibTeX
@article{bergstrom1998predicting, author={Bergstrom, Nancy and Braden, Barbara and Kemp, Mildred and Champagne, Mary and Ruby, Elizabeth}, title={{Predicting pressure ulcer risk: A multisite study of the predictive validity of the Braden Scale}}, journal={Nursing Research}, year={1998}, volume={47}, number={5}, pages={261--269}, doi={10.1097/00006199-199809000-00005}}@article{bland1986statistical, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistical methods for assessing agreement between two methods of clinical measurement}}, journal={The Lancet}, year={1986}, volume={327}, number={8476}, pages={307--310}, doi={10.1016/s0140-6736(86)90837-8}}@article{cohen1968weighted, author={Cohen, Jacob}, title={{Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={4}, pages={213--220}, doi={10.1037/h0026256}}@article{defloor2005pressure, author={Defloor, Tom and Grypdonck, Maria F. H.}, title={{Pressure ulcers: Validation of two risk assessment scales}}, journal={Journal of Clinical Nursing}, year={2005}, volume={14}, number={3}, pages={373--382}, doi={10.1111/j.1365-2702.2004.01058.x}}@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{elli2022factors, author={Elli, Chiara and Novella, Alessio and Nobili, Alessandro and Ianes, Aladar and Pasina, Luca}, title={{Factors associated with a high-risk profile for developing pressure injuries in long-term residents of nursing homes}}, journal={Medical Principles and Practice}, year={2022}, volume={31}, number={5}, pages={433--438}, doi={10.1159/000527063}}@article{pancorbohidalgo2006risk, author={Pancorbo-Hidalgo, Pedro L. and Garcia-Fernandez, Francisco Pedro and Lopez-Medina, Isabel M. and Alvarez-Nieto, Carmen}, title={{Risk assessment scales for pressure ulcer prevention: A systematic review}}, journal={Journal of Advanced Nursing}, year={2006}, volume={54}, number={1}, pages={94--110}, doi={10.1111/j.1365-2648.2006.03794.x}}@article{trajman2008mcnemar, author={Trajman, Anete and Luiz, Ronir Raggio}, title={{McNemar χ2 test revisited: Comparing sensitivity and specificity of diagnostic examinations}}, journal={Scandinavian Journal of Clinical and Laboratory Investigation}, year={2008}, volume={68}, number={1}, pages={77--80}, doi={10.1080/00365510701666031}}@article{yap2022effect, author={Yap, Tracey L. and Horn, Susan D. and Sharkey, Phoebe D. and Zheng, Tianyu and Bergstrom, Nancy and Colon-Emeric, Cathleen and Sabol, Valerie K. and Alderden, Jenny and Yap, Winston and Kennerly, Susan M.}, title={{Effect of varying repositioning frequency on pressure injury prevention in nursing home residents: TEAM-UP trial results}}, journal={Advances in Skin \& Wound Care}, year={2022}, volume={35}, number={6}, pages={315--325}, doi={10.1097/01.asw.0000817840.68588.04}}