Dokumentacja medyczna jako źródło danych
W pracach z pielęgniarstwa, położnictwa, ratownictwa i zdrowia publicznego często nie trzeba rozdawać ankiet. Dane już są w historiach choroby, kartach obserwacji, kartach zleceń, zgłoszeniach zdarzeń niepożądanych i kartach wypisowych. Badanie, w którym zbierasz je wstecz z istniejącej dokumentacji, to retrospektywny przegląd dokumentacji medycznej (ang. retrospective chart review, medical record review). Najczęściej ma postać retrospektywnego badania kohortowego. Zdarzają się też badania przekrojowe, a czasem kliniczno-kontrolne.
To popularna metoda. Gilbert i in. (1996) przejrzeli 986 artykułów oryginalnych z trzech czasopism medycyny ratunkowej i stwierdzili, że 25% z nich opierało się na przeglądzie dokumentacji. Jednocześnie tylko 11% artykułów wspominało o standaryzowanym formularzu do zbierania danych, 18% o szkoleniu osób, które te dane wypisywały, a zgodność między nimi sprawdzono statystycznie w 0.4% prac. Worster i Haines (2004) zauważyli, że dla takich badań brakowało wtedy standardów raportowania i literatury o metodyce. Vassar i Holzmann (2013) omówili dziesięć częstych błędów metodologicznych w przeglądach dokumentacji i zebrali wskazówki dobrych praktyk. W pracy dyplomowej najłatwiej pominąć etapy, od których zależy jakość danych: precyzyjne pytanie, kryteria, kartę, szkolenie, sprawdzenie zgodności i opis braków.
Ten wpis prowadzi przez te etapy po kolei. Przykład przewodni jest wymyślony, a dane są symulowane. Studentka pielęgniarstwa chce sprawdzić w dokumentacji oddziału internistycznego z jednego roku, czy u pacjentów w wieku 65+ upadek w czasie hospitalizacji występował częściej u osób z udokumentowanymi zaburzeniami poznawczymi. Liczby w tekście pochodzą z kodu R na końcu wpisu i nie opisują żadnej rzeczywistej populacji. Wpis nie zawiera zaleceń klinicznych, tylko metodę.
Krok 1. Pytanie, na które dokumentacja może odpowiedzieć
Dokumentacja powstała po to, żeby leczyć i pielęgnować pacjentów, a nie żeby odpowiadać na Twoje pytanie. Zanim zaplanujesz badanie, sprawdź na kilku historiach choroby, czy potrzebne informacje w ogóle są zapisywane, gdzie i w jakiej formie. Dopiero potem formułuj pytanie badawcze.
| Pytanie | Czy dokumentacja na nie odpowie? | Dlaczego |
|---|---|---|
| Jak często dochodziło do upadku w czasie hospitalizacji? | Raczej tak | Upadek zwykle jest odnotowany w zgłoszeniu zdarzenia lub w raporcie pielęgniarskim. Pamiętaj jednak, że brak zgłoszenia nie dowodzi braku upadku. |
| Czy upadki częściej dotyczyły osób przyjmujących leki nasenne? | Tak | Karta zleceń jest zwykle kompletna, a podanie leku ma datę i godzinę. |
| Czy upadki częściej dotyczyły osób z zaburzeniami poznawczymi? | Częściowo | Wpis zależy od tego, czy ktoś ocenił stan poznawczy i go zapisał. Brak wpisu jest częsty i nie znaczy „brak zaburzeń”. |
| Czy pacjenci czuli się bezpiecznie na oddziale? | Nie | Takich danych w dokumentacji nie ma. Potrzebna jest ankieta albo inne badanie prospektywne. |
| Czy edukacja przy przyjęciu zmniejszyła liczbę upadków? | Raczej nie | Edukacja bywa odnotowana szablonowo, bez treści i czasu trwania, a porównanie nie ma losowego przydziału. |
Dobre pytanie do badania retrospektywnego dotyczy zmiennych, które są zapisywane rutynowo, w ustalonym miejscu i według jednej definicji. Oddziel też opis od związku. „Jaki odsetek pacjentów upadł?” to pytanie opisowe. „Czy zaburzenia poznawcze wiązały się z upadkiem po uwzględnieniu wieku i leków?” to pytanie o związek, a nie o przyczynę. Dokumentacja nie powie Ci, dlaczego lekarz zlecił lek. Gdy decyzja o leczeniu zależy od stanu pacjenta, porównanie leczonych z nieleczonymi grozi zakłóceniem przez wskazanie.
Krok 2. Populacja, okres i kryteria włączenia
Określ, skąd weźmiesz listę dokumentacji (np. księga główna oddziału, wykaz hospitalizacji z systemu, rejestr zabiegów), jaki okres obejmuje i jakie są kryteria włączenia i wyłączenia. Zapisz je przed otwarciem pierwszej karty. W przykładzie lista z systemu zawierała 364 hospitalizacje z jednego roku. Kryteria: wiek co najmniej 65 lat i pobyt co najmniej 48 godzin. Wyłączono 41 hospitalizacji osób młodszych, 17 krótszych pobytów i 6 hospitalizacji, których dokumentacji nie odnaleziono w archiwum. Do analizy weszło 300 hospitalizacji.
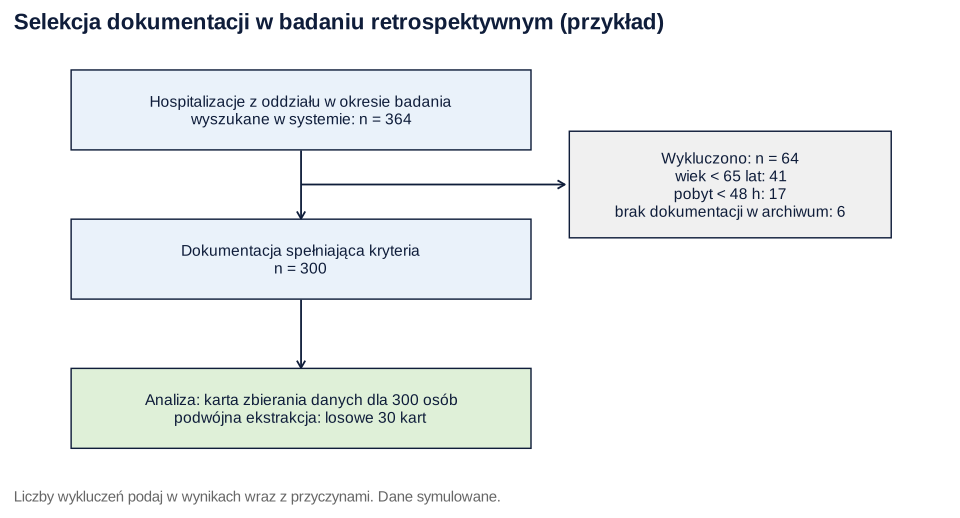
Trzy decyzje mają tu szczególne znaczenie.
- Wszystkie kolejne przypadki czy próba. Najbezpieczniej włączyć wszystkie hospitalizacje spełniające kryteria z ustalonego okresu. Jeśli jest ich za dużo, losuj je z listy (np. funkcją
sample()w R z zapisanym ziarnem). Nie wybieraj „ciekawych” albo „dobrze opisanych” historii choroby. - Jednostka analizy. Ten sam pacjent mógł być hospitalizowany dwa razy. Zdecyduj, czy analizujesz pacjentów (np. tylko pierwszą hospitalizację), czy hospitalizacje. W drugim przypadku obserwacje nie są niezależne.
- Brak dokumentacji to też wynik. Hospitalizacje bez odnalezionej dokumentacji wpisz do schematu z przyczyną. Nie usuwaj też kart „niekompletnych” w ramach kryteriów wyłączenia. Jeśli niekompletne są karty pacjentów w cięższym stanie, otrzymasz błąd selekcji. Braki opisuje się i analizuje na etapie analizy (krok 6), a nie przy kwalifikacji.
Krok 3. Karta zbierania danych: definicja, źródło i kod każdej zmiennej
Karta zbierania danych (formularz ekstrakcji, ang. data abstraction form) to najważniejsze narzędzie badania retrospektywnego. Pełni tę samą funkcję co kwestionariusz w ankiecie. Każda zmienna powinna mieć definicję, miejsce w dokumentacji, z którego ją pobierasz, i listę kodów. Ten opis to książka kodowa badania, a definicje są operacjonalizacją zmiennych.
| Zmienna | Definicja | Źródło w dokumentacji | Kody |
|---|---|---|---|
id | Numer karty nadany w badaniu (nie numer księgi) | – | K001–K300 |
wiek | Wiek w pełnych latach w dniu przyjęcia | Karta przyjęcia | liczba |
dni_pobytu | Data wypisu minus data przyjęcia | Karta informacyjna | liczba |
leki_nasenne | Co najmniej jedno podanie leku z ustalonej listy w czasie pobytu | Karta zleceń | 1 = tak, 0 = nie |
zab_poznawcze | Wpis o zaburzeniach poznawczych lub otępieniu w wywiadzie albo w ocenie przy przyjęciu | Wywiad lekarski, karta oceny pielęgniarskiej | tak / nie (wpis o braku zaburzeń) / brak wpisu |
ocena_ryzyka_upadku | Wynik skali ryzyka upadku z pierwszej oceny po przyjęciu | Karta oceny ryzyka | liczba; puste = brak oceny w dokumentacji |
upadek | Upadek w czasie pobytu odnotowany w zgłoszeniu zdarzenia lub raporcie pielęgniarskim | Zgłoszenia zdarzeń, raport pielęgniarski | 1 = odnotowany, 0 = brak zapisu o upadku |
Do karty dołącz instrukcję z regułami dla sytuacji niejednoznacznych. Co, jeśli dwa wpisy są sprzeczne? Który pomiar brać, gdy jest ich kilka? Czy „splątany” w raporcie nocnym liczy się jako zaburzenia poznawcze? Każdą taką decyzję zapisz z datą. Instrukcja to część metody, a nie notatki na marginesie.
„Brak wpisu” to nie „nie wystąpiło”
Najczęstszy błąd w badaniach retrospektywnych to traktowanie braku zapisu jak braku zjawiska. Jeśli w historii choroby nie ma słowa o zaburzeniach poznawczych, mogło być tak, że ich nie było. Mogło też być tak, że nikt ich nie ocenił albo ocenił i nie zapisał. Dlatego karta powinna odróżniać trzy sytuacje: udokumentowane „tak”, udokumentowane „nie” (np. „pacjent zorientowany auto- i allopsychicznie”) i brak wpisu. W danych liczbowych użyj osobnego kodu braku (np. 9) i opisz go w książce kodowej. Nie zostawiaj pustej komórki, bo nie odróżnisz wtedy braku wpisu od pominięcia pola przy wypełnianiu karty.
Przy zdarzeniach, takich jak upadek, trzecia kategoria zwykle nie istnieje. Koduje się „odnotowany” albo „brak zapisu”. Wtedy nazwij zmienną uczciwie: „upadek odnotowany w dokumentacji”, a w ograniczeniach napisz, że niezgłoszone upadki nie są w danych.
Krok 4. Pilotaż karty i szkolenie
Zanim zaczniesz zbierać dane z 300 historii choroby, wypełnij kartę dla 10–15 kart spoza próby albo z początku listy. Taki pilotaż karty pokazuje zwykle trzy rzeczy. Część zmiennych jest w innym miejscu, niż zakładałeś. Część definicji jest niejednoznaczna. Część zmiennych prawie nigdy nie jest zapisywana i trzeba z nich zrezygnować albo zmienić pytanie badawcze. Po pilotażu popraw kartę i instrukcję. Dane z pilotażu nie wchodzą do analizy, jeśli karta się zmieniła. Ogólne zasady pilotażu opisuje wpis badanie pilotażowe – po co, ile osób, co sprawdzić.
Jeśli dane zbiera więcej niż jedna osoba, przeszkól je na tych samych kartach pilotażowych i omów rozbieżności. Gilbert i in. (1996) wymieniają wśród standardów, które rzadko opisywano, m.in. szkolenie osób ekstrahujących dane, okresowe monitorowanie ich pracy i zaślepienie na hipotezy badania. W pracy dyplomowej zaślepienie bywa trudne, bo autorka zna swoje hipotezy. Można jednak poprosić drugą osobę o wypełnienie podpróby kart bez znajomości hipotez. Można też wypisywać zmienne z różnych części dokumentacji w osobnych przebiegach, np. najpierw wywiad, a dopiero później zgłoszenia zdarzeń.
Krok 5. Zgodność dwóch osób na podpróbie kart
Nawet przy dobrej karcie dwie osoby czytające tę samą historię choroby wypiszą czasem co innego. Sprawdź to na losowej podpróbie. W przykładzie druga osoba niezależnie wypełniła 30 losowo wybranych kart (10% próby), a zgodność policzono dla zmiennych kategorialnych kappą Cohena, a dla ilościowych współczynnikiem ICC. Wybór miary, interpretację i procedurę uzgadniania szczegółowo opisuje wpis zgodność sędziów: kappa, ICC i alfa Krippendorffa. Tu skupiamy się na tym, co jest specyficzne dla dokumentacji.
| Zmienna | Zgodność procentowa | Miara zgodności [95% CI] |
|---|---|---|
| Zaburzenia poznawcze (tak / nie / brak wpisu) | 86.7% | κ = .78 [.57, .98] |
| Leki nasenne | 96.7% | κ = .91 [.74, 1.00] |
| Upadek odnotowany | 96.7% | κ = .84 [.53, 1.00] |
| Długość pobytu (dni) | 24 z 30 identycznych | ICC(A,1) = .99 [.98, 1.00] |
| Wynik skali ryzyka upadku (n = 23 karty z oceną) | 15 z 23 identycznych | ICC(A,1) = .98 [.95, .99] |
Z tej tabeli płyną trzy wnioski typowe dla przeglądu dokumentacji.
- Najsłabiej wypada zmienna z „brakiem wpisu”. Spośród czterech rozbieżności przy zaburzeniach poznawczych trzy dotyczyły granicy między „nie” a „brak wpisu”. Jedna osoba uznała ogólny opis stanu pacjenta za udokumentowane „nie”, a druga nie. To sygnał, że definicję trzeba doprecyzować w instrukcji, np. przez listę sformułowań, które oznaczają „nie”.
- Przy rzadkim zdarzeniu kappa jest niepewna. Upadek wystąpił w 3–4 z 30 kart, więc jedna rozbieżność obniża kappę do .84, a dolna granica przedziału spada do .53. Cicchetti i Feinstein (1990) zalecają, by kappie towarzyszyły dwa osobne wskaźniki: zgodność w ocenach pozytywnych i negatywnych. Tu wynoszą .86 i .98.
- Wysoki ICC nie oznacza identycznych wartości. Długość pobytu różniła się o dzień w 6 z 30 kart, prawdopodobnie przez różne liczenie dnia przyjęcia. Rozwiązanie jest proste: jedna reguła liczenia w instrukcji.
Na 30 kartach przedziały ufności są szerokie, więc nie traktuj progów interpretacji kappy jak egzaminu do zdania. Ważniejsze jest, co zrobiłeś z rozbieżnościami: czy je omówiłeś, poprawiłeś instrukcję i ponownie sprawdziłeś wcześniej wypełnione karty. Jak policzyć te miary w SPSS, pokazuje wpis kappa Cohena i ICC w SPSS.
Krok 6. Kompletność danych i braki
Po zebraniu danych zacznij od tabeli kompletności: dla każdej zmiennej podaj, w ilu kartach jest wpis. W przykładzie zmienne administracyjne i z karty zleceń były kompletne. Ból w skali NRS przy przyjęciu odnotowano w 241 kartach (80.3%), wynik skali ryzyka upadku w 218 (72.7%), BMI w 182 (60.7%), a wpis o stanie poznawczym w 173 (57.7%). Wszystkie zmienne naraz miały tylko 63 karty (21.0%).
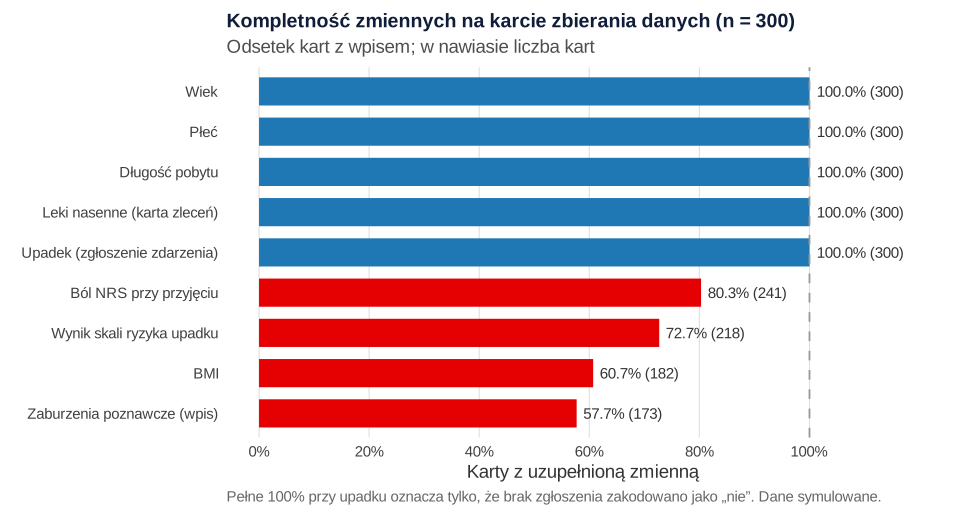
Z tej tabeli wynikają dwie decyzje. Po pierwsze, nie usuwaj kart z jakimkolwiek brakiem. Przy 21% kompletnych kart z 300 zostałoby 63, a te nie muszą być reprezentatywne. Po drugie, zastanów się, dlaczego wpisu brakuje. Ocena ryzyka upadku może być pomijana u pacjentów przyjętych w nocy albo w ciężkim stanie, a BMI – u osób leżących, których nie da się zważyć. Takie braki nie są losowe. Mechanizmy braków (MCAR, MAR, MNAR) wyjaśnia hasło braki danych, a imputację wielokrotną krok po kroku – wpis braki danych i imputacja wielokrotna w R. W rozdziale wyników tabela kompletności może być częścią tabeli 1 z charakterystyką próby, w której przy każdej zmiennej podajesz liczbę braków.
Opis próby z przykładu: średni wiek 77.0 roku (SD = 8.4), 191 kobiet (63.7%), mediana pobytu 7 dni (IQR 4–9), leki nasenne u 106 osób (35.3%). Upadek odnotowano u 35 z 300 pacjentów, czyli 11.7% (95% CI Wilsona [8.5, 15.8]).
Krok 7. Analiza: co zrobić z „brakiem wpisu”
Wpis o stanie poznawczym miały 173 karty: 38 z udokumentowanymi zaburzeniami i 135 z udokumentowanym brakiem zaburzeń. W 127 kartach wpisu nie było. Upadek odnotowano u 10 z 38 osób z wpisem „tak”, u 10 ze 135 z wpisem „nie” i u 15 ze 127 bez wpisu. Grupa „brak wpisu” nie wygląda więc jak grupa „nie”. Pytanie badawcze sprawdzono regresją logistyczną z lekami nasennymi i wiekiem jako zmiennymi kontrolnymi. Przy 35 upadkach i kilku parametrach modelu warto pamiętać o liczbie zdarzeń na predyktor. Model policzono czterema sposobami. Czwarty jest możliwy tylko w symulacji, bo zna prawdziwy stan każdego pacjenta.
| Sposób | n | OR [95% CI] dla zaburzeń poznawczych |
|---|---|---|
| A. „Brak wpisu” zakodowany jako „nie” | 300 | 3.59 [1.42, 8.71] |
| B. „Brak wpisu” jako osobna kategoria | 300 | „tak” vs „nie”: 4.62 [1.65, 13.02]; „brak wpisu” vs „nie”: 1.62 [0.70, 3.88] |
| C. Tylko karty z wpisem | 173 | 4.35 [1.51, 12.56] |
| D. Prawdziwy stan (tylko w symulacji) | 300 | 2.98 [1.28, 6.79] |
W tej jednej próbie wszystkie sposoby dają iloraz szans większy od 1, ale wartości różnią się wyraźnie. Pojedyncza próba nie powie jednak, który sposób jest obciążony. Dlatego symulację powtórzono 1000 razy przy prawdziwym OR = 3 i dwóch mechanizmach powstawania braku wpisu (rysunek 3).
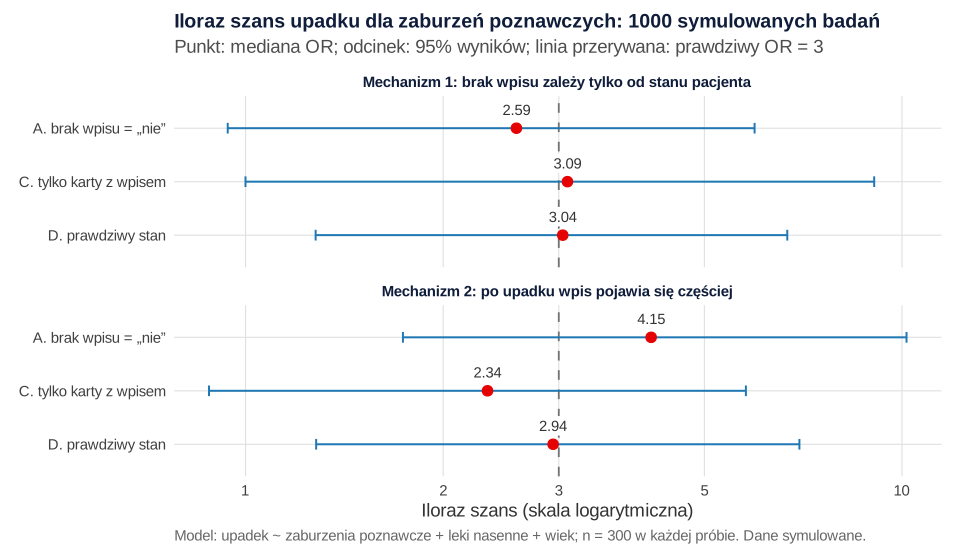
- Mechanizm 1: wpis zależy tylko od stanu pacjenta. U osób z zaburzeniami wpis jest częściej niż u pozostałych, ale nie zależy od tego, czy pacjent upadł. Kodowanie „brak wpisu = nie” wrzuca część osób z zaburzeniami do grupy „nie” i zaniża OR (mediana 2.59). Analiza samych kart z wpisem daje w tym scenariuszu wynik bliski prawdziwemu (3.09), choć mniej precyzyjny.
- Mechanizm 2: po upadku wpis pojawia się częściej. Po zdarzeniu personel ocenia i opisuje stan pacjenta, więc wpis zależy od wyniku. Wtedy kodowanie „brak wpisu = nie” zawyża OR (4.15), a analiza samych kart z wpisem go zaniża (2.34).
Nie ma więc jednego „bezpiecznego” kodowania. Wybór zależy od tego, jak powstaje brak wpisu, a tego dane same nie pokażą. Praktyczne wnioski:
- Ustal regułę przed analizą i zapisz ją w protokole. Analizą główną niech będzie sposób najlepiej uzasadniony merytorycznie, a pozostałe pokaż jako analizy wrażliwości. Jeśli wniosek zmienia się między sposobami, napisz to wprost.
- Sprawdź, czy wpis pojawiał się przed zdarzeniem, czy po nim. Jeśli w karcie zapisujesz datę wpisu, możesz uwzględnić tylko oceny sprzed upadku. Usuwa to mechanizm 2.
- Pokaż w tabeli wynik w grupie „brak wpisu” (sposób B). Czytelnik zobaczy, że ta grupa nie jest grupą „nie”.
Ta sama logika dotyczy każdej zmiennej, która „istnieje tylko wtedy, gdy ktoś ją zapisał”: wyników skal, objawów, edukacji pacjenta czy oceny bólu.
Błąd selekcji i błąd informacji w badaniu retrospektywnym
Dwa rodzaje błędów systematycznych opisz w ograniczeniach pracy. Nie wystarczy jedno zdanie „badanie retrospektywne ma ograniczenia”.
Błąd selekcji powstaje, gdy to, kto trafia do analizy, zależy jednocześnie od ekspozycji i wyniku. W dokumentacji źródłami są m.in. zaginione historie choroby (np. przekazane do innej placówki), wykluczanie kart niekompletnych, wybór okresu z nietypową organizacją pracy oddziału i włączanie tylko pacjentów, którzy przeżyli do wypisu. Mechanizm przyczynowy pokazuje wpis błąd selekcji i zmienna zderzeniowa w praktyce.
Błąd informacji (błędna klasyfikacja) to w przeglądzie dokumentacji główne zagrożenie. Althubaiti (2016) opisuje go jako jedno z najczęstszych źródeł błędu w badaniach nad zdrowiem, wynikające ze sposobu uzyskania lub potwierdzenia pomiaru. W dokumentacji przybiera trzy formy. Pierwsza to zdarzenia niezapisane, jak niezgłoszony upadek. Druga to różna jakość zapisów u różnych pacjentów, opisana w mechanizmie 2. Trzecia to rozbieżności między osobami wypisującymi dane, które mierzysz w kroku 5. Jeśli jakość zapisu zależy od wyniku, błędna klasyfikacja może zawyżyć związek, a nie tylko go osłabić. Pokazuje to rysunek 3.
Zgoda komisji bioetycznej, dostęp do dokumentacji i anonimizacja
Dokumentacja medyczna zawiera dane o zdrowiu, więc praca na niej wymaga formalnych zgód, zanim otworzysz pierwszą kartę. Wymagania zależą od przepisów, regulaminu uczelni i zasad placówki. Ten wpis nie zastępuje porady prawnej. Ustal z promotorem, czy i jaka opinia komisji bioetycznej jest potrzebna i kto w placówce wyraża zgodę na dostęp do dokumentacji. Zapytaj też, czy komisja wymaga zgody pacjentów, czy uznaje, że jej uzyskanie nie jest możliwe lub konieczne. Ogólne zasady opisuje hasło świadoma zgoda i RODO w badaniach.
Od strony metodycznej zasada jest prosta: na karcie zbierania danych nie powinno być imienia, nazwiska, numeru PESEL ani numeru księgi głównej. Karta ma tylko numer nadany w badaniu (K001, K002…). Jeśli musisz wrócić do historii choroby, np. po rozbieżności z drugą osobą, lista łącząca numer karty z dokumentacją powinna być przechowywana osobno, w placówce, i zniszczona po zakończeniu badania. To jest pseudonimizacja, a nie anonimizacja. Różnicę i identyfikatory pośrednie (rzadka diagnoza, dokładna data przyjęcia, mały oddział) wyjaśnia hasło anonimizacja i pseudonimizacja danych. W pracy nie podawaj nazwy szpitala ani oddziału, jeśli nie zgodziła się na to placówka. Wystarczy opis typu placówki.
Raportowanie: STROBE i RECORD
Badanie retrospektywne na dokumentacji to badanie obserwacyjne, więc strukturę opisu wyznacza lista STROBE. Ma ona 22 punkty, z czego 18 jest wspólnych dla badań kohortowych, kliniczno-kontrolnych i przekrojowych (von Elm i in., 2007). Ponieważ dane powstały rutynowo, do celów klinicznych, a nie badawczych, uzupełnia ją lista RECORD z 13 punktami (Benchimol i in., 2015). RECORD wymaga m.in. podania kodów i algorytmów, którymi zidentyfikowano pacjentów i sklasyfikowano zmienne, opisu dostępu do danych i sposobu ich czyszczenia. W pracy dyplomowej oznacza to: skąd była lista hospitalizacji, jakim kryterium ją wyszukano, kto miał dostęp do dokumentacji i jak sprawdzano dane. Którą listę wybrać i jak dołączyć ją do pracy, opisuje wpis STROBE, CONSORT i TRIPOD – która lista.
Minimum, które powinno się znaleźć w rozdziale metod badania retrospektywnego:
- źródło danych, okres, sposób wyszukania dokumentacji, kryteria włączenia i wyłączenia;
- schemat selekcji z liczbami (rysunek 1);
- opis karty zbierania danych z definicjami zmiennych i regułą dla braku wpisu (karta w załączniku);
- pilotaż karty, szkolenie, liczbę osób zbierających dane i zgodność na podpróbie;
- kompletność zmiennych i sposób postępowania z brakami;
- zgodę komisji i placówki oraz sposób ochrony danych.
Gotowe opisy do pracy
Wzór akapitu do rozdziału metod (uzupełnij nawiasy kwadratowe):
Wzór akapitu do rozdziału wyników:
Najczęstsze błędy w analizie dokumentacji medycznej
- Pytanie dopasowane do pomysłu, a nie do dokumentacji. Zmienna kluczowa okazuje się zapisywana w co trzeciej karcie.
- Brak karty zbierania danych. Dane wypisywane od razu do arkusza, bez definicji i kodów, a reguły ustalane w trakcie.
- „Brak wpisu” zakodowany jako „nie” bez uzasadnienia i bez analizy wrażliwości.
- Wykluczanie kart niekompletnych jako kryterium wyłączenia zamiast opisu i analizy braków.
- Wybór „dobrze opisanych” historii choroby zamiast wszystkich kolejnych albo losowo wybranych.
- Jedna osoba i brak sprawdzenia zgodności. Bez podpróby wypełnionej przez drugą osobę nie wiadomo, ile błędów wniosła sama ekstrakcja.
- Wnioski przyczynowe („zaburzenia poznawcze powodują upadki”) z danych obserwacyjnych bez kontroli zakłócaczy.
- Dane identyfikujące na karcie albo nazwa oddziału w pracy, która pozwala rozpoznać pacjentów.
- Zbieranie danych przed uzyskaniem zgód. Zgód nie uzyskuje się wstecz.
Więcej o analizach typowych dla prac pielęgniarskich znajdziesz we wpisie statystyka w pracy z pielęgniarstwa. Dokumentacja bywa też źródłem wyników skal klinicznych. Porównanie dwóch skal ryzyka opisuje wpis porównanie dwóch skal oceny ryzyka, a prospektywną obserwację z listą kontrolną – wpis obserwacja z listą kontrolną.
Analiza dokumentacji w R: karta, zgodność i brak wpisu
Trzy przepisy liczą wszystkie liczby z tekstu. Uruchamiaj je po kolei z folderu kod/. Pierwszy tworzy symulowaną kartę zbierania danych dla 300 hospitalizacji, zapisuje ją w pliku CSV w folderze nadrzędnym (../) i liczy kompletność zmiennych. Prawdziwy stan poznawczy, znany tylko w symulacji, trafia do osobnego pliku. Drugi symuluje drugą osobę wypełniającą 30 losowych kart i liczy zgodność. Trzeci porównuje sposoby potraktowania braku wpisu w regresji logistycznej i powtarza symulację 1000 razy. Rysunki powstały w osobnym skrypcie na tych samych danych. Kartę możesz pobrać: dokumentacja-medyczna-karta-300.csv (300 hospitalizacji × 10 zmiennych; „brak wpisu” zapisano słownie, w zmiennych ilościowych brak wpisu oznacza NA).
Karta zbierania danych: selekcja, kompletność i opis próby
R
# B434 – analiza dokumentacji medycznej: symulowana karta zbierania danych 300 pacjentów
# Selekcja dokumentacji, kompletność zmiennych i opis próby (dane symulowane, tylko bazowy R)
set.seed(4341)

# ---- 1. Selekcja: od listy z systemu do próby analizowanej ----
# Lista hospitalizacji z oddziału w okresie badania; kryteria: wiek >= 65 lat, pobyt >= 48 h,
# dostępna dokumentacja w archiwum. Liczby wykluczeń są częścią scenariusza.
wykl <- c("wiek < 65 lat" = 41, "pobyt < 48 h" = 17, "brak dokumentacji w archiwum" = 6)
n <- 300
cat("Wyszukano w systemie:", n + sum(wykl), "\n"); print(wykl)
cat("Włączono do analizy:", n, "\n")

# ---- 2. Karta zbierania danych (prawda znana tylko w symulacji) ----
wiek <- round(65 + rgamma(n, shape = 2.2, scale = 5.5))
dni <- 2 + rnbinom(n, size = 3, mu = 5)
plec <- sample(c("K", "M"), n, replace = TRUE, prob = c(.58, .42))
leki_nasenne <- rbinom(n, 1, .35)                            # karta zleceń – zawsze wypełniona
zab_prawda <- rbinom(n, 1, plogis(-1.6 + 0.07 * (wiek - 75)))   # zaburzenia poznawcze (prawda)
# Wpis w dokumentacji: u osób z zaburzeniami częściej jest, u pozostałych częściej go brak
wpis <- ifelse(zab_prawda == 1, rbinom(n, 1, .70), rbinom(n, 1, .55))
zab_karta <- ifelse(wpis == 1, ifelse(zab_prawda == 1, "tak", "nie"), "brak wpisu")
upadek <- rbinom(n, 1, plogis(-2.7 + 1.1 * zab_prawda + 0.6 * leki_nasenne +
                                0.03 * (wiek - 75) + 0.04 * (dni - 7)))
ryzyko_upadku <- ifelse(runif(n) < .72, sample(0:10, n, replace = TRUE), NA)  # wynik skali w karcie
bmi <- ifelse(runif(n) < .61, round(rnorm(n, 26.5, 4.5), 1), NA)
nrs <- ifelse(runif(n) < .83, pmin(10, rpois(n, 3)), NA)

karta <- data.frame(id = sprintf("K%03d", 1:n), wiek, plec, dni_pobytu = dni,
                    leki_nasenne, zab_poznawcze = zab_karta, ocena_ryzyka_upadku = ryzyko_upadku,
                    bmi, nrs_przyjecie = nrs, upadek)
write.csv(karta, "../dokumentacja-medyczna-karta-300.csv", row.names = FALSE)
write.csv(data.frame(id = karta$id, zab_prawda), "b434-prawda.csv", row.names = FALSE)

# ---- 3. Kompletność zmiennych ----
kompletnosc <- function(x) if (is.character(x)) sum(x != "brak wpisu") else sum(!is.na(x))
zm <- c("wiek", "plec", "dni_pobytu", "leki_nasenne", "zab_poznawcze",
        "ocena_ryzyka_upadku", "bmi", "nrs_przyjecie", "upadek")
tab <- data.frame(zmienna = zm, uzupelnione = sapply(karta[zm], kompletnosc))
tab$procent <- round(100 * tab$uzupelnione / n, 1)
tab <- tab[order(-tab$procent), ]
rownames(tab) <- NULL
cat("\nKompletność zmiennych (n =", n, ")\n"); print(tab)
write.csv(tab, "b434-kompletnosc.csv", row.names = FALSE)
cat("\nKarty kompletne we wszystkich zmiennych:", sum(complete.cases(karta[zm]) & karta$zab_poznawcze != "brak wpisu"),
    sprintf("(%.1f%%)\n", 100 * mean(complete.cases(karta[zm]) & karta$zab_poznawcze != "brak wpisu")))

# ---- 4. Opis próby ----
cat("\nWiek: M =", sprintf("%.1f", mean(wiek)), "SD =", sprintf("%.1f", sd(wiek)),
    "| Mdn dni pobytu =", median(dni), "IQR =", paste(quantile(dni, c(.25, .75)), collapse = "–"), "\n")
cat("Kobiety:", sum(plec == "K"), sprintf("(%.1f%%)", 100 * mean(plec == "K")),
    "| leki nasenne:", sum(leki_nasenne), sprintf("(%.1f%%)", 100 * mean(leki_nasenne)), "\n")
cat("Zaburzenia poznawcze w karcie:\n"); print(table(karta$zab_poznawcze))
up <- sum(upadek); w <- prop.test(up, n, correct = FALSE)$conf.int
cat(sprintf("Upadek w czasie pobytu: %d z %d (%.1f%%; 95%% CI Wilsona [%.1f, %.1f])\n",
            up, n, 100 * up / n, 100 * w[1], 100 * w[2]))
cat("Upadek a wpis o zaburzeniach (wiersze: karta):\n")
print(table(karta = karta$zab_poznawcze, upadek = upadek))
Wynik w R
Wyszukano w systemie: 364
               wiek < 65 lat                 pobyt < 48 h
                          41                           17
brak dokumentacji w archiwum
                           6
Włączono do analizy: 300

Kompletność zmiennych (n = 300 )
              zmienna uzupelnione procent
1                wiek         300   100.0
2                plec         300   100.0
3          dni_pobytu         300   100.0
4        leki_nasenne         300   100.0
5              upadek         300   100.0
6       nrs_przyjecie         241    80.3
7 ocena_ryzyka_upadku         218    72.7
8                 bmi         182    60.7
9       zab_poznawcze         173    57.7

Karty kompletne we wszystkich zmiennych: 63 (21.0%)

Wiek: M = 77.0 SD = 8.4 | Mdn dni pobytu = 7 IQR = 4–9
Kobiety: 191 (63.7%) | leki nasenne: 106 (35.3%)
Zaburzenia poznawcze w karcie:

brak wpisu        nie        tak
       127        135         38
Upadek w czasie pobytu: 35 z 300 (11.7%; 95% CI Wilsona [8.5, 15.8])
Upadek a wpis o zaburzeniach (wiersze: karta):
            upadek
karta          0   1
  brak wpisu 112  15
  nie        125  10
  tak         28  10
Zgodność dwóch osób na 30 losowych kartach
R
# B434 – zgodność dwóch osób ekstrahujących dane: 30 losowych kart wypełnionych ponownie
# Kappa Cohena z 95% CI (psych), zgodność pozytywna i negatywna, ICC (irr); dane symulowane
suppressPackageStartupMessages({ library(irr); library(psych) })
set.seed(4342)
karta <- read.csv("../dokumentacja-medyczna-karta-300.csv")
pod <- karta[sort(sample(nrow(karta), 30)), ]          # podpróba 30 kart (losowanie proste)
B <- pod                                                # druga osoba – kopia z błędami
zmien <- function(x, ile, poziomy) { i <- sample(length(x), ile)
  x[i] <- sapply(x[i], function(v) sample(setdiff(poziomy, v), 1)); x }
B$zab_poznawcze <- zmien(pod$zab_poznawcze, 4, c("tak", "nie", "brak wpisu"))
B$leki_nasenne  <- zmien(pod$leki_nasenne, 1, 0:1)
B$upadek        <- zmien(pod$upadek, 1, 0:1)
B$dni_pobytu    <- pod$dni_pobytu + sample(c(0, 0, 0, 0, 0, 0, 1, -1), 30, replace = TRUE)
i <- which(!is.na(pod$ocena_ryzyka_upadku))
B$ocena_ryzyka_upadku[i] <- pmin(10, pmax(0, pod$ocena_ryzyka_upadku[i] +
                                    sample(c(0, 0, 0, 1, -1, 2), length(i), replace = TRUE)))

kat <- function(nazwa) {
  a <- pod[[nazwa]]; b <- B[[nazwa]]
  k <- suppressWarnings(cohen.kappa(cbind(a, b)))   # granice CI powyżej 1 psych obcina do 1
  c(zgodnosc_proc = round(100 * mean(a == b), 1),
    kappa = round(k$kappa, 2), dolna = round(k$confid[1, 1], 2), gorna = round(k$confid[1, 3], 2))
}
cat("Zmienne kategorialne (n = 30 kart):\n")
wyn <- t(sapply(c("zab_poznawcze", "leki_nasenne", "upadek"), kat)); print(wyn)

# Rzadkie zdarzenie: zgodność pozytywna i negatywna (Cicchetti i Feinstein, 1990)
t2 <- table(A = pod$upadek, B = B$upadek); print(t2)
a <- t2["1", "1"]; d <- t2["0", "0"]; b <- t2["1", "0"]; c_ <- t2["0", "1"]
cat(sprintf("Upadek: zgodność pozytywna = %.2f, negatywna = %.2f\n",
            2 * a / (2 * a + b + c_), 2 * d / (2 * d + b + c_)))

cat("\nZmienne ilościowe – ICC(A,1), model dwuczynnikowy, zgodność bezwzględna:\n")
for (z in c("dni_pobytu", "ocena_ryzyka_upadku")) {
  m <- na.omit(cbind(pod[[z]], B[[z]]))
  r <- icc(m, model = "twoway", type = "agreement", unit = "single")
  cat(sprintf("%-20s n = %2d  ICC = %.2f, 95%% CI [%.2f, %.2f]; identyczne wartości: %d z %d\n",
              z, nrow(m), r$value, r$lbound, r$ubound, sum(m[, 1] == m[, 2]), nrow(m)))
}
cat("\nNiezgodności w zab_poznawcze (do omówienia i uzgodnienia):\n")
print(data.frame(id = pod$id, A = pod$zab_poznawcze, B = B$zab_poznawcze)[pod$zab_poznawcze != B$zab_poznawcze, ],
      row.names = FALSE)
Wynik w R
Zmienne kategorialne (n = 30 kart):
              zgodnosc_proc kappa dolna gorna
zab_poznawcze          86.7  0.78  0.57  0.98
leki_nasenne           96.7  0.91  0.74  1.00
upadek                 96.7  0.84  0.53  1.00
   B
A    0  1
  0 26  1
  1  0  3
Upadek: zgodność pozytywna = 0.86, negatywna = 0.98

Zmienne ilościowe – ICC(A,1), model dwuczynnikowy, zgodność bezwzględna:
dni_pobytu           n = 30  ICC = 0.99, 95% CI [0.98, 1.00]; identyczne wartości: 24 z 30
ocena_ryzyka_upadku  n = 23  ICC = 0.98, 95% CI [0.95, 0.99]; identyczne wartości: 15 z 23

Niezgodności w zab_poznawcze (do omówienia i uzgodnienia):
   id          A          B
 K090        tak        nie
 K107 brak wpisu        nie
 K112        nie brak wpisu
 K170        nie brak wpisu
Regresja logistyczna przy czterech sposobach potraktowania braku wpisu i 1000 powtórzeń
R
# B434 – prosta analiza: upadek a zaburzenia poznawcze przy różnym traktowaniu „brak wpisu”
# Regresja logistyczna (glm), OR z 95% CI (profilowe); 1000 powtórzeń symulacji; tylko bazowy R
set.seed(4343)
karta <- read.csv("../dokumentacja-medyczna-karta-300.csv")
prawda <- read.csv("b434-prawda.csv")
karta$zab_prawda <- prawda$zab_prawda          # znana tylko w symulacji

or_ci <- function(m, z) { e <- exp(c(coef(m)[z], suppressMessages(confint(m))[z, ]))
  sprintf("OR = %.2f, 95%% CI [%.2f, %.2f]", e[1], e[2], e[3]) }
fA <- upadek ~ zab + leki_nasenne + I((wiek - 75) / 10)

# A: „brak wpisu” zakodowany jako „nie”
dA <- transform(karta, zab = as.integer(zab_poznawcze == "tak"))
mA <- glm(fA, binomial, dA)
# B: „brak wpisu” jako osobna kategoria
dB <- transform(karta, zab = factor(zab_poznawcze, levels = c("nie", "tak", "brak wpisu")))
mB <- glm(fA, binomial, dB)
# C: tylko karty z wpisem (analiza kompletnych przypadków)
dC <- transform(subset(karta, zab_poznawcze != "brak wpisu"), zab = as.integer(zab_poznawcze == "tak"))
mC <- glm(fA, binomial, dC)
# D: prawdziwy stan (w realnym badaniu niedostępny)
mD <- glm(fA, binomial, transform(karta, zab = zab_prawda))

cat("Zaburzenia poznawcze a upadek (model z lekami nasennymi i wiekiem):\n")
cat("A. brak wpisu = nie        (n = 300):", or_ci(mA, "zab"), "\n")
cat("B. brak wpisu osobno       (n = 300): tak vs nie", or_ci(mB, "zabtak"),
    "| brak wpisu vs nie", or_ci(mB, "zabbrak wpisu"), "\n")
cat(sprintf("C. tylko karty z wpisem    (n = %d):", nrow(dC)), or_ci(mC, "zab"), "\n")
cat("D. prawdziwy stan          (n = 300):", or_ci(mD, "zab"), "\n")
cat("Leki nasenne (model A):", or_ci(mA, "leki_nasenne"), "\n")
cat("Wiek, na 10 lat (model A):", or_ci(mA, "I((wiek - 75)/10)"), "\n")

# ---- 1000 powtórzeń: dwa mechanizmy braku wpisu ----
# 1) brak wpisu zależy tylko od prawdziwego stanu; 2) po upadku wpis o stanie poznawczym robi się częściej
jedno <- function(roznicowy) {
  n <- 300; wiek <- round(65 + rgamma(n, 2.2, scale = 5.5)); dni <- 2 + rnbinom(n, size = 3, mu = 5)
  leki <- rbinom(n, 1, .35); zab <- rbinom(n, 1, plogis(-1.6 + 0.07 * (wiek - 75)))
  y <- rbinom(n, 1, plogis(-2.7 + 1.1 * zab + 0.6 * leki + 0.03 * (wiek - 75) + 0.04 * (dni - 7)))
  p_wpis <- ifelse(zab == 1, .70, .55)
  if (roznicowy) p_wpis <- ifelse(y == 1, .95, p_wpis)
  wpis <- rbinom(n, 1, p_wpis)
  d <- data.frame(y, leki, w = (wiek - 75) / 10, zab, wpis)
  c(A = coef(glm(y ~ I(zab * wpis) + leki + w, binomial, d))[2],
    C = coef(glm(y ~ zab + leki + w, binomial, subset(d, wpis == 1)))[2],
    D = coef(glm(y ~ zab + leki + w, binomial, d))[2])
}
for (r in c(FALSE, TRUE)) {
  s <- t(replicate(1000, jedno(r)))
  cat(sprintf("\nMechanizm %s: mediana OR z 1000 prób [2.5. i 97.5. percentyl]\n",
              if (r) "2 (wpis częstszy po upadku)" else "1 (wpis zależy tylko od stanu)"))
  for (k in 1:3) cat(sprintf("  %s: %.2f [%.2f, %.2f]\n", c("A. brak wpisu = nie", "C. tylko z wpisem", "D. prawda")[k],
                             exp(median(s[, k])), exp(quantile(s[, k], .025)), exp(quantile(s[, k], .975))))
  write.csv(exp(s), sprintf("b434-powtorzenia-mechanizm%d.csv", r + 1), row.names = FALSE)
}
cat("\nPrawdziwy OR w symulacji: exp(1.1) =", sprintf("%.2f", exp(1.1)), "\n")
Wynik w R
Zaburzenia poznawcze a upadek (model z lekami nasennymi i wiekiem):
A. brak wpisu = nie        (n = 300): OR = 3.59, 95% CI [1.42, 8.71]
B. brak wpisu osobno       (n = 300): tak vs nie OR = 4.62, 95% CI [1.65, 13.02] | brak wpisu vs nie OR = 1.62, 95% CI [0.70, 3.88]
C. tylko karty z wpisem    (n = 173): OR = 4.35, 95% CI [1.51, 12.56]
D. prawdziwy stan          (n = 300): OR = 2.98, 95% CI [1.28, 6.79]
Leki nasenne (model A): OR = 1.42, 95% CI [0.66, 2.97]
Wiek, na 10 lat (model A): OR = 0.99, 95% CI [0.64, 1.50]

Mechanizm 1 (wpis zależy tylko od stanu): mediana OR z 1000 prób [2.5. i 97.5. percentyl]
  A. brak wpisu = nie: 2.59 [0.94, 5.96]
  C. tylko z wpisem: 3.09 [1.00, 9.07]
  D. prawda: 3.04 [1.28, 6.69]

Mechanizm 2 (wpis częstszy po upadku): mediana OR z 1000 prób [2.5. i 97.5. percentyl]
  A. brak wpisu = nie: 4.15 [1.74, 10.16]
  C. tylko z wpisem: 2.34 [0.88, 5.78]
  D. prawda: 2.94 [1.28, 6.98]

Prawdziwy OR w symulacji: exp(1.1) = 3.00
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami irr i psych (zgodność); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- irr (wersja 0.85): Gamer, M., Lemon, J., Fellows, I., & Singh, P. (2026). irr: Various coefficients of interrater reliability and agreement (R package version 0.85) [Computer software]. https://doi.org/10.32614/CRAN.package.irr
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed zbieraniem danych z dokumentacji sprawdź…
- Czy pytanie badawcze dotyczy zmiennych, które są rutynowo zapisywane w ustalonym miejscu?
- Czy źródło listy, okres oraz kryteria włączenia i wyłączenia są zapisane, zanim otworzysz pierwszą kartę?
- Czy każda zmienna na karcie ma definicję, źródło w dokumentacji i kody, w tym osobny kod dla „brak wpisu”?
- Czy kartę i instrukcję sprawdzono w pilotażu i poprawiono?
- Czy druga osoba wypełni losową podpróbę kart i czy wiesz, jak policzysz zgodność?
- Czy reguła postępowania z brakiem wpisu i analizy wrażliwości są ustalone przed analizą?
- Czy masz zgodę komisji i placówki, a karta nie zawiera danych identyfikujących pacjentów?
- Czy wiesz, które punkty STROBE i RECORD opiszesz w pracy?
Najczęstsze pytania
Jakim rodzajem badania jest analiza dokumentacji medycznej?
To badanie obserwacyjne z danymi zebranymi wstecz. Najczęściej jest to retrospektywne badanie kohortowe: wybierasz pacjentów według okresu i kryteriów, a z dokumentacji odczytujesz ekspozycję (np. leki) i późniejszy wynik (np. upadek). Jeśli opisujesz tylko stan w jednym momencie, jest to badanie przekrojowe. Jeśli wybierasz osoby według wyniku i porównujesz je z kontrolami, jest to badanie kliniczno-kontrolne. Rodzaj badania wyznacza właściwą miarę związku i część listy STROBE.
Ile kart powinna niezależnie wypełnić druga osoba?
Nie ma jednej reguły. W przykładzie było to 30 losowo wybranych kart (10% z 300). Przy tak małej podpróbie przedziały ufności kappy są szerokie, np. .57–.98 dla zmiennej z kategorią „brak wpisu”. Ważniejsze od liczby jest losowanie kart, wypełnianie ich niezależnie i omówienie rozbieżności. Jeśli zgodność jest słaba, popraw instrukcję i sprawdź kolejne karty.
Czy brak wpisu w historii choroby mogę zakodować jako „nie”?
Tylko jeśli zmienna jest zapisywana zawsze, gdy zjawisko występuje (np. podanie leku w karcie zleceń). Przy objawach, ocenach i rozpoznaniach brak wpisu może oznaczać, że nikt nie ocenił pacjenta. Daj „brak wpisu” jako osobny kod, ustal regułę analizy przed zobaczeniem wyników, a inne sposoby pokaż jako analizy wrażliwości. W symulacji z tego wpisu kodowanie „brak wpisu = nie” zaniżało albo zawyżało iloraz szans zależnie od mechanizmu braku.
Czy mogę wykluczyć z badania historie choroby z brakującymi danymi?
Nie jako kryterium wyłączenia. Jeśli niekompletna dokumentacja dotyczy np. pacjentów w cięższym stanie, wykluczenie jej zniekształci próbę (błąd selekcji). Kryteria włączenia dotyczą populacji i okresu, a braki opisujesz w tabeli kompletności i uwzględniasz w analizie, np. analizą kompletnych przypadków z analizą wrażliwości albo imputacją wielokrotną. Wyjątkiem jest brak całej dokumentacji. Wtedy wpisz liczbę takich przypadków do schematu selekcji.
Czy w pracy mogę podać nazwę szpitala, z którego pochodzi dokumentacja?
Tylko jeśli placówka się na to zgodziła. Zwykle wystarczy opis typu placówki i oddziału (np. oddział internistyczny szpitala powiatowego). Przy małych oddziałach i rzadkich rozpoznaniach połączenie nazwy placówki, okresu i opisu przypadków może pozwolić rozpoznać pacjentów. Zasady ustal z promotorem, placówką i komisją bioetyczną.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z analityki medycznej
Porównanie analizatorów, precyzja w układzie dni i serii, przedział referencyjny, stabilność próbki, wyniki poniżej granicy oznaczalności i ROC: analizy, zdania i kod R.
Czytaj →PoradnikWniosek do komisji bioetycznej – jak opisać badanie
Metoda językiem zrozumiałym dla komisji: rekrutacja, procedura, liczebność, dane, wypełniony fikcyjny przykład i poprawione fragmenty.
Czytaj →PoradnikJak napisać pracę z medycyny i stomatologii
Materiał i metody, definicje rozpoznań i wyników, diagram włączenia, STROBE, Tabela 1, czas obserwacji, kalibracja badaczy oraz ząb a pacjent – na dwóch fikcyjnych przykładach klinicznych.
Czytaj →PoradnikSeria przypadków w pracy dyplomowej
Od definicji przypadku i kolejnych pacjentów do tabeli pacjent po pacjencie, przedziałów dla odsetków i reguły trójki – bez testów i wniosków przyczynowych, na przykładzie 14 pacjentów w R.
Czytaj →PoradnikBadanie kohortowe w pracy dyplomowej
Czas zero, czas obserwacji, osobolata, RR i IRR z regresji Poissona z offsetem oraz analiza utraty z obserwacji – na przykładzie 400 pacjentów w R.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikPorównanie skal Braden i Norton
Korelacja to nie zgodność: tabela krzyżowa, kappa i kappa ważona, McNemar i Bowker, czułość, swoistość i AUC z testem DeLonga – z przykładem w R i wzorem opisu.
Czytaj →PoradnikObserwacja z listą kontrolną
Audyt przestrzegania procedur (np. higieny rąk): okazja jako jednostka, CI uwzględniający osoby, zgodność obserwatorów, Hawthorne i przed–po – przykład w R.
Czytaj →Planujesz badanie na dokumentacji medycznej?
Pomożemy przygotować kartę zbierania danych i plan analizy, policzymy zgodność, kompletność i modele w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Althubaiti, A. (2016). Information bias in health research: Definition, pitfalls, and adjustment methods. Journal of Multidisciplinary Healthcare, 9, 211–217. https://doi.org/10.2147/jmdh.s104807 ● Otwarty dostęp
- Benchimol, E. I., Smeeth, L., Guttmann, A., Harron, K., Moher, D., Petersen, I., Sørensen, H. T., von Elm, E., Langan, S. M., & RECORD Working Committee. (2015). The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLOS Medicine, 12(10), Article e1001885. https://doi.org/10.1371/journal.pmed.1001885 ● Otwarty dostęp
- Cicchetti, D. V., & Feinstein, A. R. (1990). High agreement but low kappa: II. Resolving the paradoxes. Journal of Clinical Epidemiology, 43(6), 551–558. https://doi.org/10.1016/0895-4356(90)90159-m
- Gilbert, E. H., Lowenstein, S. R., Koziol-McLain, J., Barta, D. C., & Steiner, J. F. (1996). Chart reviews in emergency medicine research: Where are the methods? Annals of Emergency Medicine, 27(3), 305–308. https://doi.org/10.1016/s0196-0644(96)70264-0
- Vassar, M., & Holzmann, M. (2013). The retrospective chart review: Important methodological considerations. Journal of Educational Evaluation for Health Professions, 10, Article 12. https://doi.org/10.3352/jeehp.2013.10.12 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
- Worster, A., & Haines, T. (2004). Advanced statistics: Understanding medical record review (MRR) studies. Academic Emergency Medicine, 11(2), 187–192. https://doi.org/10.1111/j.1553-2712.2004.tb01433.x
Cytowania BibTeX
@article{althubaiti2016information, author={Althubaiti, Alaa}, title={{Information bias in health research: Definition, pitfalls, and adjustment methods}}, journal={Journal of Multidisciplinary Healthcare}, year={2016}, volume={9}, pages={211--217}, doi={10.2147/jmdh.s104807}}@article{benchimol2015reporting, author={Benchimol, Eric I. and Smeeth, Liam and Guttmann, Astrid and Harron, Katie and Moher, David and Petersen, Irene and Sørensen, Henrik T. and von Elm, Erik and Langan, Sinéad M. and {RECORD Working Committee}}, title={{The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement}}, journal={PLOS Medicine}, year={2015}, volume={12}, number={10}, eid={e1001885}, doi={10.1371/journal.pmed.1001885}}@article{cicchetti1990high, author={Cicchetti, Domenic V. and Feinstein, Alvan R.}, title={{High agreement but low kappa: II. Resolving the paradoxes}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={6}, pages={551--558}, doi={10.1016/0895-4356(90)90159-m}}@article{gilbert1996chart, author={Gilbert, Eric H. and Lowenstein, Steven R. and Koziol-McLain, Jane and Barta, Diane C. and Steiner, John F.}, title={{Chart reviews in emergency medicine research: Where are the methods?}}, journal={Annals of Emergency Medicine}, year={1996}, volume={27}, number={3}, pages={305--308}, doi={10.1016/s0196-0644(96)70264-0}}@article{vassar2013retrospective, author={Vassar, Matt and Holzmann, Matthew}, title={{The retrospective chart review: Important methodological considerations}}, journal={Journal of Educational Evaluation for Health Professions}, year={2013}, volume={10}, eid={12}, doi={10.3352/jeehp.2013.10.12}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}@article{worster2004advanced, author={Worster, Andrew and Haines, Ted}, title={{Advanced statistics: Understanding medical record review (MRR) studies}}, journal={Academic Emergency Medicine}, year={2004}, volume={11}, number={2}, pages={187--192}, doi={10.1111/j.1553-2712.2004.tb01433.x}}