Kilkunastu pacjentów i żadnej grupy porównawczej
Masz kilkunastu pacjentów z jednej poradni albo oddziału: rzadkie rozpoznanie, nowy sposób postępowania, krótki czas na zbieranie danych. Promotor mówi „zrób serię przypadków”, a Ty szukasz testu, który do tego pasuje. Najczęściej żaden nie pasuje. Seria przypadków to uporządkowany opis: kto trafił do serii, jak przebiegała obserwacja i co się wydarzyło. Dobra seria podaje liczby, ale nie porównuje grup i nie mówi, że coś zadziałało.
Taki opis ma swoją wartość. Vandenbroucke (2001) podkreśla, że opisy i serie przypadków są czułe na nowość: pozwalają wykryć nowe choroby i nieoczekiwane skutki. Carey i Boden (2003) definiują serię jako opis przebiegu u pacjentów w czasie i wyliczają, co może dać (definicję przypadku, obraz wyników, tropy co do przyczyn). Zastrzegają też, że nie wolno z niej wnioskować o efekcie leczenia.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa opisuje 14 kolejnych pacjentów z owrzodzeniem żylnym goleni, objętych w poradni leczenia ran jednym schematem opieki i obserwowanych przez 12 tygodni. Notuje wiek, płeć, czas trwania rany, jej powierzchnię na początku, zagojenie, zakażenie, hospitalizację z powodu rany i utratę z obserwacji. Wszystkie liczby poniżej pochodzą z kodu R na końcu wpisu.
Seria przypadków a podobne schematy
W pracach dyplomowych nazwy mieszają się najczęściej w tych pięciu miejscach:
| Schemat | Kogo obejmuje | Co jest wynikiem | Czym różni się od serii |
|---|---|---|---|
| Opis przypadku | 1 pacjent (czasem kilku) | narracja kliniczna | pojedyncza historia, bez liczb zbiorczych |
| Seria przypadków | kilku–kilkudziesięciu pacjentów z tą samą definicją przypadku | liczności, mediany, odsetki, przebieg | – |
| Studium przypadku | jeden ograniczony system (osoba, zespół, organizacja) z kontekstem | pogłębione rozumienie, wiele źródeł | podejście jakościowe; nie zlicza się w nim pacjentów |
| Badanie jednego przypadku (single-case) | 1 lub kilka osób, wiele pomiarów w fazach | zmiana poziomu i trendu między fazami | eksperyment: badacz planuje fazy i wprowadza interwencję; seria tylko opisuje |
| Badanie kohortowe | osoby dobrane według ekspozycji, śledzone w czasie | zapadalność, ryzyko, często porównanie grup | patrz niżej – granica jest cieńsza, niż się wydaje |
Na jakiej podstawie dobrano pacjentów?
Dekkers i in. (2012) proponują proste kryterium. W kohorcie pacjentów dobiera się według ekspozycji i śledzi, co się wydarzy; grupa porównawcza nie jest konieczna. W serii przypadków dobiera się według wyniku (samego albo razem z ekspozycją). Stąd praktyczna konsekwencja: w kohorcie można policzyć ryzyko, a w serii – w tym ścisłym sensie – nie, bo nie ma mianownika. Etykiety są tu często mylone. Esene i in. (2014) sprawdzili 64 artykuły neurochirurgiczne z „case series” w tytule: 46 (71.87%) miało błędną etykietę, a 35 (54.69%) stanowiły w istocie opisowe kohorty retrospektywne.
| Jak trafili do opisu | Przykład | Co wolno policzyć | Czego nie wolno |
|---|---|---|---|
| Według wyniku | wszyscy pacjenci z zakażeniem rany w 2025 r. | skład: ilu miało cukrzycę, jak długo trwało leczenie | „ryzyko zakażenia” – nie znasz liczby pacjentów, u których do niego nie doszło |
| Według rozpoznania i sposobu opieki, potem obserwacja | kolejni pacjenci objęci schematem opieki | odsetek zagojeń i powikłań w tej grupie, z przedziałem ufności | przypisanie odsetka schematowi; bez grupy porównawczej nie wiesz, co by się stało bez niego |
Nasz przykład należy do drugiego wiersza, więc w ścisłej terminologii to opisowa kohorta jednej grupy. W pracach klinicznych taki projekt powszechnie nazywa się serią przypadków i zapewne tak napisze też Twój promotor. Nazwa jest mniej ważna od opisu: napisz, według czego dobrano pacjentów, a czytelnik sam oceni, czy mianownik istnieje. Gdy chcesz porównać dwie grupy, przejdź do schematów z wpisów o badaniu kohortowym i badaniu kliniczno-kontrolnym.
Definicja przypadku, kolejne przypadki, kryteria
Wiarygodność serii zależy głównie od tego, jak zbudowałeś(-aś) listę pacjentów. Potrzebne są trzy decyzje, zapisane przed przeglądaniem wyników:
- Definicja przypadku. Sprawdzalna: rozpoznanie, kto je postawił, na jakiej podstawie, od kiedy liczysz obserwację. „Owrzodzenie żylne goleni rozpoznane przez lekarza poradni, pierwsza wizyta w okresie badania” jest lepsze niż „pacjenci z ranami”.
- Kolejne przypadki (consecutive). Włączasz każdego pacjenta spełniającego kryteria w ustalonym okresie, po kolei, bez wybierania ciekawszych. Podaj daty początku i końca oraz liczbę osób, które spełniły kryteria, a nie weszły do opisu. Jeśli wybierałeś(-aś) pacjentów, napisz to wprost: to dobór wygodny i odsetki nie mają wtedy jasnego znaczenia.
- Kryteria włączenia i wyłączenia. Liczbę osób odpadających na każdym etapie pokaż w tekście albo na diagramie (zasady liczenia etapów są we wpisie o diagramie przepływu).
Dane zwykle pochodzą z dokumentacji. Kartę zbierania danych i kompletność wpisów omawiamy w poradniku o analizie dokumentacji medycznej.
Tabela „pacjent po pacjencie”
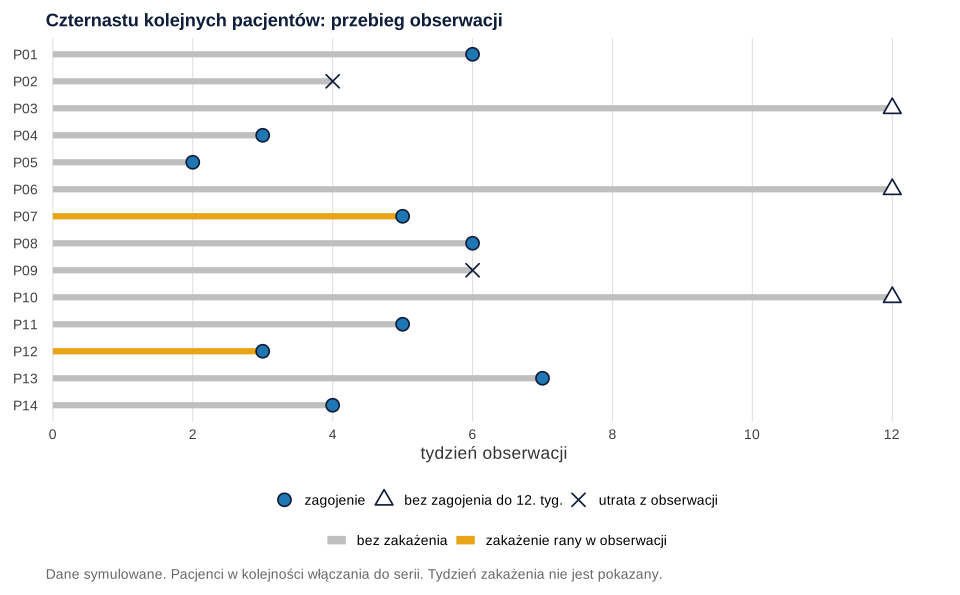
Przy kilkunastu osobach można pokazać wszystkich. To największa zaleta serii: czytelnik widzi każdy przebieg, a nie tylko podsumowanie. Wiersze ułóż w kolejności włączania albo według czasu obserwacji, a w ostatnich kolumnach podaj wynik.
| Pacjent | Wiek (lata) | Płeć | Czas trwania rany (mies.) | Powierzchnia (cm²) | Stan końcowy | Zakażenie | Hospitalizacja |
|---|---|---|---|---|---|---|---|
| P01 | 60–69 | M | 7 | 18.3 | zagojenie, tydz. 6 | nie | nie |
| P02 | 60–69 | M | 4 | 11.9 | utrata z obserwacji, tydz. 4 | nie | nie |
| P03 | 80–89 | K | 7 | 11.6 | bez zagojenia, koniec 12. tyg. | nie | nie |
| P04 | 50–59 | K | 7 | 9.7 | zagojenie, tydz. 3 | nie | nie |
| P05 | 70–79 | K | 20 | 4.8 | zagojenie, tydz. 2 | nie | nie |
| P06 | 40–49 | K | 8 | 4.7 | bez zagojenia, koniec 12. tyg. | nie | nie |
| P07 | 60–69 | K | 10 | 8.1 | zagojenie, tydz. 5 | tak | nie |
| P08 | 60–69 | K | 10 | 22.6 | zagojenie, tydz. 6 | nie | nie |
| P09 | 70–79 | K | 9 | 9.5 | utrata z obserwacji, tydz. 6 | nie | nie |
| P10 | 60–69 | K | 20 | 35.7 | bez zagojenia, koniec 12. tyg. | nie | nie |
| P11 | 80–89 | K | 9 | 14.1 | zagojenie, tydz. 5 | nie | nie |
| P12 | 70–79 | K | 6 | 5.7 | zagojenie, tydz. 3 | tak | nie |
| P13 | 80–89 | K | 8 | 32.7 | zagojenie, tydz. 7 | nie | nie |
| P14 | 60–69 | K | 37 | 6.3 | zagojenie, tydz. 4 | nie | nie |
Tabela 1. Charakterystyka i przebieg u 14 pacjentów (dane symulowane).
Uwaga na identyfikację. W małej serii rzadka kombinacja cech może wskazać konkretną osobę. Dlatego wiek podajemy w przedziałach, a tabela nie ma dat, inicjałów ani nazwy placówki. Zasady są w haśle anonimizacja i pseudonimizacja, a o wymaganą opinię komisji bioetycznej zapytaj na uczelni. Jeśli komórki wciąż identyfikują osoby, zostaw tabelę zbiorczą i rysunek bez cech.
Opis zmiennych: mediana, zakres i liczności
Zmienne ciągłe opisz medianą i zakresem (najmniejsza i największa wartość). Czas trwania rany ma medianę 8.5 miesiąca przy zakresie 4–37, a średnia wynosi 11.6 (SD = 8.7), bo kilku pacjentów z długo trwającą raną (do 37 miesięcy) ją podnosi. Przy 14 osobach kwartyle zależą od metody liczenia i bywają różne w różnych programach, dlatego zakres jest zwykle czytelniejszy. Ogólne zasady są w poradnikach o statystykach opisowych i tabeli 1.
Zmienne kategorialne podawaj jako liczności w ułamku: 9/14, a nie 64.3%. Jeden pacjent to przy tej próbie 7.1 punktu procentowego, więc miejsce po przecinku sugeruje dokładność, której nie ma. Jeśli promotor lub czasopismo wymaga procentów, podaj je w całości i zawsze przy liczności: „9/14 (64%)”. Pełny wynik wygląda tak:
| Cecha | Wynik |
|---|---|
| Wiek (lata), mediana (zakres) | 69 (48–89) |
| Kobiety | 12/14 |
| Czas trwania rany (mies.), mediana (zakres) | 8.5 (4–37) |
| Powierzchnia rany (cm²), mediana (zakres) | 10.6 (4.7–35.7) |
| Zagojenie do 12. tygodnia | 9/14 (64%), 95% CI [35, 87] |
| Zakażenie rany | 2/14 (14%), 95% CI [2, 43] |
| Hospitalizacja z powodu rany | 0/14, 95% CI [0, 23] |
| Utrata z obserwacji | 2/14 (14%), 95% CI [2, 43] |
Tabela 2. Podsumowanie serii; przedziały Cloppera–Pearsona.
Przedział ufności dla odsetka przy małym n
Gdy pacjenci weszli do serii kolejno i masz mianownik, odsetek warto pokazać z przedziałem. Przy małych liczbach podręcznikowy wzór Walda zawodzi – Brown i in. (2001) pokazują, że jego pokrycie jest niestabilne bardziej, niż się zwykle sądzi. W naszym przykładzie Wald daje dla zakażeń dolną granicę −4.0%, a dla 0/14 przedział [0, 0], co jest absurdem. Wybierz jedną z dwóch metod opisanych w haśle przedział ufności dla proporcji i podaj jej nazwę:
- Clopper–Pearson (dokładny) – nie schodzi poniżej nominalnych 95%, ale bywa szeroki. Dla 9/14 daje [35.1, 87.2].
- Wilson – węższy i zwykle zalecany przy małym n (Brown i in., 2001). Dla 9/14 daje [38.8, 83.7].
W tym wpisie używamy Cloppera–Pearsona, bo działa tak samo przy zerze zdarzeń. Metodę zapisz przed analizą i trzymaj się jej w całej pracy. Szybki wynik da też kalkulator przedziału ufności.
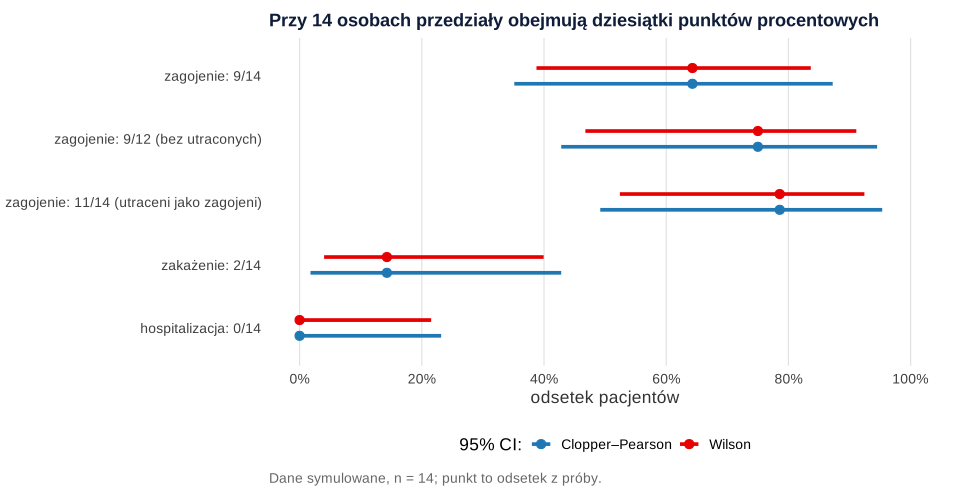
Co taki przedział znaczy? Pacjenci nie są próbą losową, więc formalnie przedział mówi o niepewności wynikającej z małej liczby osób, przy założeniu, że kolejni pacjenci tej poradni są podobni do opisanych. Nie obejmuje błędu doboru ani tego, że inna placówka może mieć innych pacjentów. Szeroki przedział to uczciwa informacja: 9/14 jest zgodne zarówno z 35%, jak i z 87%.
Który mianownik?
Dwie osoby utracono z obserwacji przed 12. tygodniem. Wynik zagojenia zależy więc od reguły: 9/14 (64%), gdy utraconych liczysz jako niezagojonych, 9/12 (75%), gdy ich pomijasz, i 11/14 (79%) w skrajnym wariancie, gdy wszyscy utraceni zagoili się później. Jako wynik główny podaj 9/14 („zagojenie potwierdzone do 12. tygodnia”), a dwa pozostałe jako analizę wrażliwości.
Pułapką jest też czas do zagojenia. Mediana z tylko 9 zagojonych wynosi 5 tygodni, ale pomija pięć osób, które do końca obserwacji się nie zagoiły albo zniknęły. Estymator Kaplana–Meiera, który uwzględnia te obserwacje jako ucięte, daje medianę 6 tygodni (95% CI: dolna granica 5, górnej nie da się oszacować). Przy 14 osobach to wciąż tylko opis, a szczegóły są w poradniku o analizie przeżycia.
Zero zdarzeń i reguła trójki
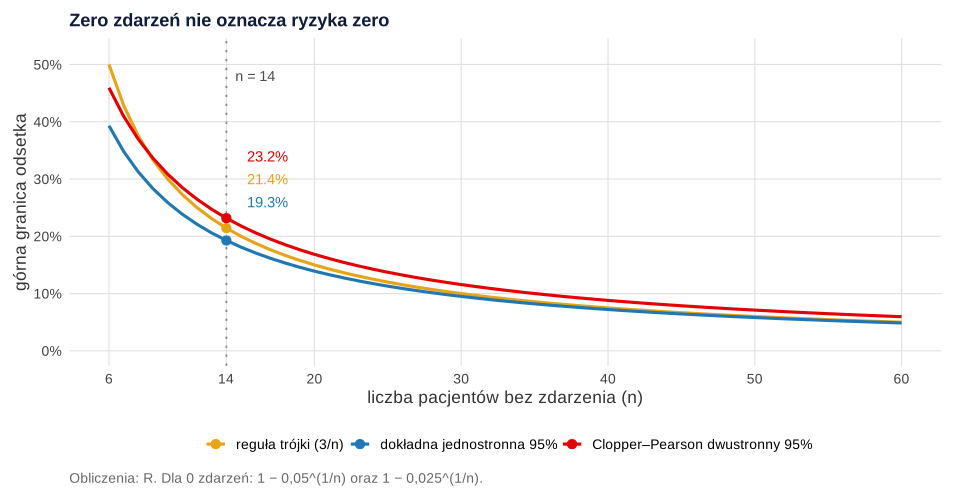
Żaden z 14 pacjentów nie trafił do szpitala z powodu rany. Zdanie „ryzyko hospitalizacji wyniosło 0%” jest błędne: 14 pacjentów nie wyklucza zdarzeń umiarkowanie częstych. Eypasch i in. (1995) przypominają prostą regułę Hanleya: gdy zdarzenie nie wystąpiło u żadnego z n pacjentów, górna granica 95% przedziału wynosi około 3/n, przy czym podają ją dla n > 30.
| n | Reguła trójki 3/n | Dokładna jednostronna 95%: 1 − 0.051/n | Clopper–Pearson dwustronny 95%: 1 − 0.0251/n |
|---|---|---|---|
| 14 | 21.4% | 19.3% | 23.2% |
| 30 | 10.0% | 9.5% | 11.6% |
| 100 | 3.0% | 3.0% | 3.6% |
Przy 14 osobach reguła trójki jest tylko przybliżeniem. Nasze 0/14 daje 21.4%, a wartość dokładna to 19.3%. Pamiętaj też, że reguła dotyczy granicy jednostronnej: jeśli wszystkie pozostałe przedziały są dwustronne, użyj dla spójności Cloppera–Pearsona i napisz: 0/14, 95% CI [0, 23.2]. Czytelnik wie wtedy, że prawdziwe ryzyko hospitalizacji mogło być i 20%.
Dlaczego bez testów
Nie ma tu grupy, z którą można by coś porównać (grupa kontrolna jest tym, czego seria z definicji nie ma). Dwie pokusy powracają jednak w każdej pracy.
Podgrupy w serii. Podział medianą powierzchni daje dwie siódemki: zagojenie 5/7 przy mniejszych ranach i 4/7 przy większych. Różnica wynosi 14.3 punktu procentowego, 95% CI [−30.4, 52.3] (przedział Newcombe’a), a test Fishera daje p > .99. To nie znaczy, że powierzchnia nie ma znaczenia. Przedział jest po prostu zgodny z bardzo dużą korzyścią i bardzo dużą stratą. Moc testu Fishera przy 7 + 7 osobach, gdy prawdziwe odsetki wynoszą 30% i 70%, to zaledwie 16.1%, a dla 20% i 80% – 44.8%. Do 80% mocy dla różnicy 30% i 70% potrzeba 29 osób w każdej grupie. Wynik nieistotny nie niesie tu więc informacji (zob. analiza podgrup – kiedy jej wierzyć).
Porównanie z literaturą i „przed–po”. Test odsetka względem wartości z artykułu formalnie da się policzyć, ale porównujesz wtedy inną populację, inne kryteria i inny okres. To kontrola historyczna, której wynik łatwo wyjaśnić różnicą pacjentów. Podobnie z pomiarem przed i po w jednej grupie: to schemat pretest–posttest bez grupy kontrolnej, a poprawa może wynikać z naturalnego przebiegu i regresji do średniej. Zmianę opisz liczbowo, bez nazywania jej efektem.
Bez wniosków przyczynowych
| Unikaj | Napisz |
|---|---|
| Schemat opieki skutecznie leczył owrzodzenia. | Zagojenie do 12. tygodnia stwierdzono u 9 z 14 pacjentów objętych schematem. |
| Metoda jest bezpieczna – nie odnotowano hospitalizacji. | Nie odnotowano hospitalizacji z powodu rany (0/14; 95% CI [0, 23]); zdarzeń o częstości poniżej około 20% seria nie wyklucza. |
| Pacjenci z mniejszymi ranami goili się lepiej. | Zagojenie wystąpiło u 5/7 pacjentów z mniejszymi i 4/7 z większymi ranami; próba nie pozwala ocenić różnicy. |
W dyskusji wymień te ograniczenia wprost (zob. ograniczenia badania).
Wytyczne raportowania
- PROCESS to lista dla serii przypadków w chirurgii, opracowana metodą delficką; wersja z 2020 r. uwzględnia poprawki po edycjach z 2016 i 2018 r. (Agha i in., 2020). Przy pracach niechirurgicznych potraktuj ją pomocniczo. Przed oddaniem pracy sprawdź, czy nie ma nowszej wersji.
- CARE dotyczy opisu przypadku, a nie serii. To 13 punktów, w tym oś czasu i informacje o pacjencie (Gagnier i in., 2014). Użyj jej, gdy opisujesz jednego pacjenta.
- STROBE ma zastosowanie, gdy Twój projekt jest w istocie opisową kohortą (zob. STROBE, CONSORT i TRIPOD).
- Lista JBI dla serii przypadków służy do oceny, a nie raportowania. Ma 10 pytań o trafność wewnętrzną i ryzyko błędu (Munn i in., 2020), a jej przejrzenie przed zbieraniem danych pomaga zauważyć luki. Zob. Newcastle–Ottawa i JBI.
Niezależnie od listy Carey i Boden (2003) wymieniają to, co powinno znaleźć się w dobrej serii: jasne pytanie, dobrze opisaną populację i interwencję, zwalidowane miary wyniku, odpowiednią analizę oraz wnioski oparte na danych.
Gotowy opis do pracy
Wzór na podstawie przykładu; dopasuj go do swojego badania.
Najczęstsze błędy
- Tytuł „seria przypadków” bez reguły doboru. Bez informacji, według czego dobrano pacjentów i czy kolejno, czytelnik nie wie, co oznaczają odsetki.
- Ryzyko policzone w grupie dobranej według wyniku. Nie masz mianownika, więc to nie ryzyko.
- Procenty z dziesiątymi przy n = 14 i procenty bez liczności.
- Średnia i SD dla silnie skośnych zmiennych.
- Przedział Walda albo brak przedziału przy 0 zdarzeń.
- Reguła trójki przy bardzo małym n bez zastrzeżeń i mieszanie granicy jednostronnej z dwustronną.
- Testy dla podgrup po siedem osób i odczytanie p > .05 jako braku różnicy.
- Mediana czasu tylko wśród osób, u których zdarzenie wystąpiło.
- Tabela z datami i rzadkimi cechami, która identyfikuje pacjenta.
- Zdania o skuteczności i bezpieczeństwie w serii bez grupy porównawczej.
Jeśli chcesz, żeby ktoś sprawdził z Tobą definicję przypadku, mianowniki i sposób opisu, zobacz pomoc w analizie dla studentów.
Seria 14 pacjentów w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy symulowane dane i zapisuje plik CSV w folderze nadrzędnym (../), więc uruchamiaj je po kolei z jednego folderu. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane do pobrania: seria-przypadkow-14-pacjentow.csv (14 pacjentów, dane fikcyjne).
Dane i opis pacjent po pacjencie
R
# B449 – seria 14 kolejnych pacjentów: dane i opis pacjent po pacjencie
# Dane symulowane (fikcyjna poradnia leczenia ran, 12 tygodni obserwacji).
set.seed(4491)
n <- 14
seria <- data.frame(id = sprintf("P%02d", 1:n))                    # kolejność włączania
seria$wiek <- round(rnorm(n, 68, 11))
seria$plec <- sample(c("K", "M"), n, replace = TRUE, prob = c(.6, .4))
seria$czas_rany_mies <- round(rlnorm(n, log(8), .9))               # silnie skośny
seria$pow_cm2 <- round(rlnorm(n, log(12), .8), 1)

# Wyniki: czas do zagojenia, utrata z obserwacji, zakażenie, hospitalizacja
t_gojenia <- rweibull(n, shape = 1.6, scale = 11)
t_utraty <- ifelse(runif(n) < .10, runif(n, 3, 10), Inf)
koniec <- pmin(t_gojenia, t_utraty, 12)
seria$tyg_obserwacji <- ceiling(koniec)
seria$zagojenie <- as.integer(t_gojenia <= pmin(t_utraty, 12))
seria$utrata <- as.integer(t_utraty < pmin(t_gojenia, 12))
seria$zakazenie <- rbinom(n, 1, .20)
seria$hospitalizacja <- rbinom(n, 1, .03)
write.csv(seria, "../seria-przypadkow-14-pacjentow.csv", row.names = FALSE, fileEncoding = "UTF-8")
options(width = 120)
print(seria, row.names = FALSE)

# Zmienne ciągłe: mediana i zakres (średnia i SD tylko dla porównania)
opis <- function(x) c(mediana = median(x), min = min(x), max = max(x),
                      Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)),
                      srednia = mean(x), SD = sd(x))
cat("\nOpis zmiennych ciągłych\n")
print(round(t(sapply(seria[c("wiek", "czas_rany_mies", "pow_cm2")], opis)), 1))

# Zmienne kategorialne: liczności n/14
cat("\nLiczności (n/14)\n")
for (v in c("zagojenie", "zakazenie", "hospitalizacja", "utrata"))
  cat(sprintf("%-15s %d/%d\n", v, sum(seria[[v]]), n))
cat(sprintf("Kobiety: %d/%d\n", sum(seria$plec == "K"), n))
cat(sprintf("Jeden pacjent to %.1f punktu procentowego\n", 100 / n))
Wynik w R
  id wiek plec czas_rany_mies pow_cm2 tyg_obserwacji zagojenie utrata zakazenie hospitalizacja
 P01   66    M              7    18.3              6         1      0         0              0
 P02   60    M              4    11.9              4         0      1         0              0
 P03   89    K              7    11.6             12         0      0         0              0
 P04   52    K              7     9.7              3         1      0         0              0
 P05   75    K             20     4.8              2         1      0         0              0
 P06   48    K              8     4.7             12         0      0         0              0
 P07   69    K             10     8.1              5         1      0         1              0
 P08   69    K             10    22.6              6         1      0         0              0
 P09   78    K              9     9.5              6         0      1         0              0
 P10   64    K             20    35.7             12         0      0         0              0
 P11   85    K              9    14.1              5         1      0         0              0
 P12   79    K              6     5.7              3         1      0         1              0
 P13   89    K              8    32.7              7         1      0         0              0
 P14   65    K             37     6.3              4         1      0         0              0

Opis zmiennych ciągłych
               mediana  min  max   Q1   Q3 srednia   SD
wiek              69.0 48.0 89.0 64.2 78.8    70.6 12.7
czas_rany_mies     8.5  4.0 37.0  7.0 10.0    11.6  8.7
pow_cm2           10.6  4.7 35.7  6.8 17.2    14.0 10.0

Liczności (n/14)
zagojenie       9/14
zakazenie       2/14
hospitalizacja  0/14
utrata          2/14
Kobiety: 12/14
Jeden pacjent to 7.1 punktu procentowego
Przedziały ufności, mianowniki, zero zdarzeń, czas do zagojenia
R
# B449 – przedziały ufności dla odsetków, 0 zdarzeń i czas do zagojenia
# Wymaga pliku z przepisu 1. Dane symulowane.
library(survival)
seria <- read.csv("../seria-przypadkow-14-pacjentow.csv", fileEncoding = "UTF-8")
n <- nrow(seria)
options(width = 120)

ci_prop <- function(x, n) {
  cp <- binom.test(x, n)$conf.int                    # dokładny Clopper–Pearson
  wi <- suppressWarnings(prop.test(x, n, correct = FALSE))$conf.int  # Wilson
  p <- x / n; se <- sqrt(p * (1 - p) / n)
  c(x = x, n = n, proc = 100 * p, CP_d = 100 * cp[1], CP_g = 100 * cp[2],
    W_d = 100 * wi[1], W_g = 100 * wi[2],
    Wald_d = 100 * (p - 1.96 * se), Wald_g = 100 * (p + 1.96 * se))
}
wyniki <- c(zagojenie = "zagojenie", zakazenie = "zakazenie", utrata = "utrata", hospitalizacja = "hospitalizacja")
tab <- t(sapply(wyniki, function(v) ci_prop(sum(seria[[v]]), n)))
cat("Odsetki z 95% CI (w %): Clopper–Pearson, Wilson i – dla przestrogi – Wald\n")
print(round(tab, 1))

# Jaki mianownik? Dwie osoby utracono z obserwacji przed 12. tygodniem
zag <- sum(seria$zagojenie); utr <- sum(seria$utrata)
cat("\nMianownik przy zagojeniu (95% CI Cloppera–Pearsona, w %)\n")
print(round(rbind(
  "wszyscy, utraceni = niezagojeni" = ci_prop(zag, n)[1:5],
  "tylko z pełną obserwacją"        = ci_prop(zag, n - utr)[1:5],
  "utraceni = zagojeni"             = ci_prop(zag + utr, n)[1:5]), 1))

# Zero zdarzeń: 0/14 hospitalizacji
gorna <- function(n) c("3/n" = 100 * 3 / n,
                       "dokładna jednostronna 95%" = 100 * (1 - .05^(1 / n)),
                       "Clopper–Pearson dwustronny 95%" = 100 * (1 - .025^(1 / n)))
cat("\nGórna granica dla 0 zdarzeń (w %)\n")
print(round(t(sapply(c("n = 14" = 14, "n = 30" = 30, "n = 100" = 100), gorna)), 1))

# Czas do zagojenia: mediana tylko wśród zagojonych a Kaplan–Meier
cat(sprintf("\nMediana czasu wśród %d zagojonych: %.0f tyg.\n", zag, median(seria$tyg_obserwacji[seria$zagojenie == 1])))
km <- survfit(Surv(tyg_obserwacji, zagojenie) ~ 1, data = seria)
print(km)
Wynik w R
Odsetki z 95% CI (w %): Clopper–Pearson, Wilson i – dla przestrogi – Wald
               x  n proc CP_d CP_g  W_d  W_g Wald_d Wald_g
zagojenie      9 14 64.3 35.1 87.2 38.8 83.7   39.2   89.4
zakazenie      2 14 14.3  1.8 42.8  4.0 39.9   -4.0   32.6
utrata         2 14 14.3  1.8 42.8  4.0 39.9   -4.0   32.6
hospitalizacja 0 14  0.0  0.0 23.2  0.0 21.5    0.0    0.0

Mianownik przy zagojeniu (95% CI Cloppera–Pearsona, w %)
                                 x  n proc CP_d CP_g
wszyscy, utraceni = niezagojeni  9 14 64.3 35.1 87.2
tylko z pełną obserwacją         9 12 75.0 42.8 94.5
utraceni = zagojeni             11 14 78.6 49.2 95.3

Górna granica dla 0 zdarzeń (w %)
         3/n dokładna jednostronna 95% Clopper–Pearson dwustronny 95%
n = 14  21.4                      19.3                           23.2
n = 30  10.0                       9.5                           11.6
n = 100  3.0                       3.0                            3.6

Mediana czasu wśród 9 zagojonych: 5 tyg.
Call: survfit(formula = Surv(tyg_obserwacji, zagojenie) ~ 1, data = seria)

      n events median 0.95LCL 0.95UCL
[1,] 14      9      6       5      NA
Dlaczego nie testować podgrup
R
# B449 – dlaczego nie testujemy podgrup w serii 14 pacjentów
# Wymaga pliku z przepisu 1. Moc liczona dokładnie, przez wyliczenie wszystkich wyników.
seria <- read.csv("../seria-przypadkow-14-pacjentow.csv", fileEncoding = "UTF-8")

# Pokusa: mniejsze a większe rany (podział medianą powierzchni)
seria$duza <- seria$pow_cm2 > median(seria$pow_cm2)
t2 <- table(duza = seria$duza, zagojenie = seria$zagojenie)[, 2:1]
print(t2)
x <- t2[, 1]; m <- rowSums(t2)
cat(sprintf("Zagojenie: małe rany %d/%d, duże rany %d/%d\n", x[1], m[1], x[2], m[2]))
cat(sprintf("Test dokładny Fishera: p = %.3f\n", fisher.test(t2)$p.value))

# Różnica odsetków z 95% CI Newcombe'a (hybryda przedziałów Wilsona)
wil <- function(x, n) suppressWarnings(prop.test(x, n, correct = FALSE))$conf.int
p <- x / m; d <- p[1] - p[2]; w1 <- wil(x[1], m[1]); w2 <- wil(x[2], m[2])
cat(sprintf("Różnica: %.1f pp., 95%% CI [%.1f, %.1f]\n", 100 * d,
            100 * (d - sqrt((p[1] - w1[1])^2 + (w2[2] - p[2])^2)),
            100 * (d + sqrt((w1[2] - p[1])^2 + (p[2] - w2[1])^2))))

# Moc dokładna testu Fishera (alfa = .05, dwustronnie) przy n osobach w każdej grupie
moc <- function(n, p1, p2) {
  s <- 0
  for (a in 0:n) for (b in 0:n)
    if (fisher.test(matrix(c(a, n - a, b, n - b), 2))$p.value < .05)
      s <- s + dbinom(a, n, p1) * dbinom(b, n, p2)
  s
}
cat(sprintf("\nMoc przy 7 + 7 osobach: 30%% a 70%%: %.3f; 20%% a 80%%: %.3f\n", moc(7, .3, .7), moc(7, .2, .8)))
for (k in 8:40) if (moc(k, .3, .7) >= .80) { cat(sprintf("Moc 80%% dla 30%% a 70%%: %d osób w grupie\n", k)); break }
Wynik w R
       zagojenie
duza    1 0
  FALSE 5 2
  TRUE  4 3
Zagojenie: małe rany 5/7, duże rany 4/7
Test dokładny Fishera: p = 1.000
Różnica: 14.3 pp., 95% CI [-30.4, 52.3]

Moc przy 7 + 7 osobach: 30% a 70%: 0.161; 20% a 80%: 0.448
Moc 80% dla 30% a 70%: 29 osób w grupie
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem survival; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem sprawdź…
- Czy definicja przypadku jest sprawdzalna, a okres włączania ma daty początku i końca?
- Czy wiesz, ilu pacjentów spełniło kryteria, a ilu weszło do opisu?
- Czy projekt jest serią (dobór według wyniku), czy opisową kohortą (dobór według ekspozycji) i czy napisano to wprost?
- Czy odsetki mają liczności, jedną metodę przedziału i wskazany mianownik?
- Czy utraconych z obserwacji opisano i uwzględniono w analizie wrażliwości?
- Czy tabela nie pozwala zidentyfikować pacjenta?
- Czy w całym tekście nie ma zdań o skuteczności ani bezpieczeństwie?
Najczęstsze pytania
Ilu pacjentów musi mieć seria przypadków?
Nie ma ustalonej minimalnej liczby: seria to opis, więc liczba wynika z okresu włączania i częstości rozpoznania. Liczebność trzeba jednak uczciwie uwzględnić w interpretacji. Przy 14 pacjentach odsetek 9/14 ma 95% przedział od 35% do 87%, a jeden pacjent zmienia wynik o 7.1 punktu procentowego. Zamiast celować w konkretną liczbę, opisz cały okres i wszystkich kolejnych pacjentów.
Czy serię przypadków można nazwać kohortą?
Tak, jeśli pacjenci byli dobrani według ekspozycji lub sposobu opieki i śledzeni w czasie, bo wtedy według Dekkersa i in. (2012) to opisowa kohorta, nawet bez grupy porównawczej. Gdy dobierasz według wyniku, np. wszystkich z danym powikłaniem, to seria w ścisłym sensie. W pracy opisz regułę doboru i używaj nazwy zgodnie z nią.
Co napisać, gdy w serii nie wystąpiło żadne powikłanie?
Podaj 0/n z górną granicą przedziału, np. 0/14, 95% CI [0, 23], i napisz, że seria nie wyklucza zdarzeń o umiarkowanej częstości. Reguła trójki (3/n) jest przybliżeniem podawanym dla większych prób; dla 14 osób dokładna granica jednostronna to 19.3%, a dwustronna Cloppera–Pearsona 23.2%. Nie pisz, że metoda jest bezpieczna.
Czy w serii przypadków można podać p?
Zwykle nie ma czego testować, bo nie ma grupy porównawczej. Testy w podgrupach mają przy kilkunastu osobach bardzo małą moc: przy 7 + 7 osobach i różnicy 30% do 70% tylko 16.1%. Wynik nieistotny nic wtedy nie mówi. Jeśli promotor prosi o porównanie, pokaż różnicę z przedziałem ufności i podkreśl, że analiza jest opisowa.
Czym różni się seria przypadków od studium przypadku?
Seria przypadków zlicza pacjentów o tej samej definicji i podaje liczności, mediany i odsetki. Studium przypadku jest pogłębionym badaniem jednego ograniczonego systemu w kontekście i zwykle ma charakter jakościowy. Eksperymentalne badanie jednego przypadku to jeszcze inny schemat: wiele pomiarów w planowanych fazach z interwencją.
Powiązane hasła
Przeczytaj też
Analiza dokumentacji medycznej – badanie retrospektywne
Pytanie, kryteria, karta zbierania danych, „brak wpisu” ≠ „nie”, kappa na podpróbie kart, braki, zgody, STROBE i RECORD – z przykładem w R.
Czytaj →PoradnikBadanie jednego przypadku (single-case)
Schematy ABAB i wielokrotnej linii bazowej, analiza wizualna w liczbach, NAP, Tau-U i jego pułapki, test randomizacyjny, SCRIBE i kod R.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →Opisujesz serię kolejnych pacjentów?
Ustalimy z Tobą definicję przypadku i mianowniki, policzymy mediany, odsetki z przedziałami i przygotujemy tabele w R lub SPSS, z wyjaśnieniem, które pozwoli Ci samodzielnie obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agha, R. A., Sohrabi, C., Mathew, G., Franchi, T., Kerwan, A., O'Neill, N., & PROCESS Group. (2020). The PROCESS 2020 guideline: Updating consensus Preferred Reporting Of CasE Series in Surgery (PROCESS) guidelines. International Journal of Surgery, 84, 231–235. https://doi.org/10.1016/j.ijsu.2020.11.005 ● Otwarty dostęp
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Carey, T. S., & Boden, S. D. (2003). A critical guide to case series reports. Spine, 28(15), 1631–1634. https://doi.org/10.1097/01.brs.0000083174.84050.e5
- Dekkers, O. M., Egger, M., Altman, D. G., & Vandenbroucke, J. P. (2012). Distinguishing case series from cohort studies. Annals of Internal Medicine, 156(1 Pt 1), 37–40. https://doi.org/10.7326/0003-4819-156-1-201201030-00006 ● Otwarty dostęp: pełny tekst
- Esene, I. N., Ngu, J., El Zoghby, M., Solaroglu, I., Sikod, A. M., Kotb, A., Dechambenoit, G., & El Husseiny, H. (2014). Case series and descriptive cohort studies in neurosurgery: The confusion and solution. Child's Nervous System, 30(8), 1321–1332. https://doi.org/10.1007/s00381-014-2460-1
- Eypasch, E., Lefering, R., Kum, C. K., & Troidl, H. (1995). Probability of adverse events that have not yet occurred: A statistical reminder. BMJ, 311(7005), 619–620. https://doi.org/10.1136/bmj.311.7005.619 ● Otwarty dostęp: pełny tekst
- Gagnier, J. J., Kienle, G., Altman, D. G., Moher, D., Sox, H., & Riley, D. (2014). The CARE guidelines: Consensus-based clinical case report guideline development. Journal of Clinical Epidemiology, 67(1), 46–51. https://doi.org/10.1016/j.jclinepi.2013.08.003
- Munn, Z., Barker, T. H., Moola, S., Tufanaru, C., Stern, C., McArthur, A., Stephenson, M., & Aromataris, E. (2020). Methodological quality of case series studies: An introduction to the JBI critical appraisal tool. JBI Evidence Synthesis, Publish Ahead of Print(10), 2127–2133. https://doi.org/10.11124/jbisrir-d-19-00099
- Vandenbroucke, J. P. (2001). In defense of case reports and case series. Annals of Internal Medicine, 134(4), 330–334. https://doi.org/10.7326/0003-4819-134-4-200102200-00017
Cytowania BibTeX
@article{agha2020process, author={Agha, Riaz A. and Sohrabi, Catrin and Mathew, Ginimol and Franchi, Thomas and Kerwan, Ahmed and O'Neill, Niamh and {PROCESS Group}}, title={{The PROCESS 2020 guideline: Updating consensus Preferred Reporting Of CasE Series in Surgery (PROCESS) guidelines}}, journal={International Journal of Surgery}, year={2020}, volume={84}, pages={231--235}, doi={10.1016/j.ijsu.2020.11.005}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{carey2003critical, author={Carey, Timothy S. and Boden, Scott D.}, title={{A critical guide to case series reports}}, journal={Spine}, year={2003}, volume={28}, number={15}, pages={1631--1634}, doi={10.1097/01.brs.0000083174.84050.e5}}@article{dekkers2012distinguishing, author={Dekkers, Olaf M. and Egger, Matthias and Altman, Douglas G. and Vandenbroucke, Jan P.}, title={{Distinguishing case series from cohort studies}}, journal={Annals of Internal Medicine}, year={2012}, volume={156}, number={1 Pt 1}, pages={37--40}, doi={10.7326/0003-4819-156-1-201201030-00006}}@article{esene2014case, author={Esene, Ignatius N. and Ngu, Julius and El Zoghby, Mohamed and Solaroglu, Ihsan and Sikod, Anna M. and Kotb, Ali and Dechambenoit, Gilbert and El Husseiny, Hossam}, title={{Case series and descriptive cohort studies in neurosurgery: The confusion and solution}}, journal={Child's Nervous System}, year={2014}, volume={30}, number={8}, pages={1321--1332}, doi={10.1007/s00381-014-2460-1}}@article{eypasch1995probability, author={Eypasch, Ernst and Lefering, Rolf and Kum, C. K. and Troidl, Hans}, title={{Probability of adverse events that have not yet occurred: A statistical reminder}}, journal={BMJ}, year={1995}, volume={311}, number={7005}, pages={619--620}, doi={10.1136/bmj.311.7005.619}}@article{gagnier2014care, author={Gagnier, Joel J. and Kienle, Gunver and Altman, Douglas G. and Moher, David and Sox, Harold and Riley, David}, title={{The CARE guidelines: Consensus-based clinical case report guideline development}}, journal={Journal of Clinical Epidemiology}, year={2014}, volume={67}, number={1}, pages={46--51}, doi={10.1016/j.jclinepi.2013.08.003}}@article{munn2020methodological, author={Munn, Zachary and Barker, Timothy Hugh and Moola, Sandeep and Tufanaru, Catalin and Stern, Cindy and McArthur, Alexa and Stephenson, Matthew and Aromataris, Edoardo}, title={{Methodological quality of case series studies: An introduction to the JBI critical appraisal tool}}, journal={JBI Evidence Synthesis}, year={2020}, volume={Publish Ahead of Print}, number={10}, pages={2127--2133}, doi={10.11124/jbisrir-d-19-00099}}@article{vandenbroucke2001defense, author={Vandenbroucke, Jan P.}, title={{In defense of case reports and case series}}, journal={Annals of Internal Medicine}, year={2001}, volume={134}, number={4}, pages={330--334}, doi={10.7326/0003-4819-134-4-200102200-00017}}