Kohorta w pracy dyplomowej: kłopot zaczyna się od czasu
Badanie kohortowe brzmi prosto: dwie grupy, obserwacja, zliczenie zdarzeń. W pracy dyplomowej problem pojawia się przy pierwszej tabeli. Pacjentów przyjmowano przez cały rok, więc jedni byli obserwowani 24 miesiące, a inni 12. Część zmarła, część przeniosła się do innej poradni. Jeśli podzielisz liczbę zdarzeń przez liczbę osób, porównasz grupy, które miały różną szansę, żeby zdarzenie w ogóle zaobserwować.
Ten wpis pokazuje, jak to policzyć: jak ustalić punkt startu, jak zapisać czas obserwacji, kiedy wystarczy odsetek, a kiedy potrzeba osobolat, jak uzyskać iloraz częstości i co zrobić z osobami utraconymi z obserwacji. Definicję i ogólny plan badania znajdziesz w haśle o badaniu kohortowym. Kartę zbierania danych i kompletność dokumentacji omawia poradnik o analizie dokumentacji medycznej, a wybór między RR, OR i NNT – wpis o miarach ryzyka w pracy.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa analizuje dokumentację domowej opieki pielęgniarskiej. Kohortę tworzy 400 pacjentów przyjętych do opieki w 2024 roku, bez odleżyny w dniu przyjęcia. Narażenie to brak stałego opiekuna w dniu przyjęcia (145 osób), a wynik to pierwsza rozpoznana odleżyna. Obserwacja kończy się najpóźniej 31 grudnia 2025 roku. Dane wygenerowano z założonym ilorazem częstości 1.60, więc można sprawdzić, która metoda jest blisko prawdy. Liczby nie opisują żadnej rzeczywistej populacji, a wpis dotyczy metody, nie postępowania z pacjentem. Dane do ćwiczeń: badanie-kohortowe-odlezyna-400-pacjentow.csv.
Prospektywne czy retrospektywne
Grimes i Schulz (2002) opisują dwie odmiany kohorty: prospektywną, która startuje teraz i idzie naprzód, oraz retrospektywną, która odtwarza grupy z istniejących danych. W obu kierunek myślenia jest ten sam: od narażenia do wyniku. Retrospektywna kohorta nie jest więc badaniem kliniczno-kontrolnym. Tam wybierasz osoby według wyniku, a tutaj – według narażenia.
| Cecha | Prospektywna | Retrospektywna |
|---|---|---|
| Kiedy powstają dane | W trakcie badania, według Twoich definicji | Wcześniej, do innych celów (leczenie, rozliczenia) |
| Definicja narażenia | Mierzysz sam(a), jednakowo u wszystkich | Zależy od tego, co i jak zapisano |
| Czas potrzebny na badanie | Tyle, ile trwa obserwacja – często więcej, niż trwają studia | Tyle, ile zajmie zebranie danych |
| Główne ryzyko | Utrata uczestników, zmiana zachowania pod obserwacją | Braki we wpisach, „brak wpisu” mylony z brakiem zdarzenia |
| Utrata z obserwacji | Wiesz, kiedy kontakt się urwał, i często dlaczego | Widzisz tylko, że wpisy się skończyły |
W pracy licencjackiej lub magisterskiej zwykle realna jest kohorta retrospektywna albo krótka prospektywna. Napisz wprost, którą prowadzisz. Samo słowo „kohorta” w tytule nie wystarczy, jeśli zmienne zmierzono raz: to wtedy schemat przekrojowy.
Punkt startu i definicja narażenia
Czas zero to dzień, od którego osoba jest obserwowana i może wystąpić u niej zdarzenie. Musi być wyznaczony tą samą regułą w obu grupach. W przykładzie to dzień przyjęcia do opieki. Cztery decyzje zapisz przed analizą:
| Decyzja | Pytanie kontrolne | W przykładzie |
|---|---|---|
| Czas zero | Jakie jedno zdarzenie uruchamia zegar u każdej osoby? | Data przyjęcia do opieki domowej |
| Kto jest zagrożony | Czy w czasie zero wynik jeszcze nie wystąpił? | Wykluczono osoby z odleżyną przy przyjęciu |
| Narażenie | Czy jest znane w czasie zero albo przed nim? Czy ma definicję operacyjną? | Brak osoby wpisanej w karcie przyjęcia jako stały opiekun |
| Wynik | Jakie zdarzenie i jaka data je wyznaczają? | Pierwsze rozpoznanie odleżyny w dokumentacji, data wpisu |
Drugi wiersz decyduje o tym, czy w ogóle liczysz nowe przypadki. Zapadalność dotyczy tylko osób, które na początku nie miały wyniku; po włączeniu osób już chorych mieszasz ją z chorobowością. Warunki te zapisz jako kryteria włączenia i wyłączenia. Jeden pacjent to jeden wiersz: przy kilku przyjęciach ustal, że liczy się pierwsze w okresie badania.
Na starcie zbierz też zmienne zakłócające. W przykładzie są to wiek i wynik indeksu Barthel z dnia przyjęcia. Listę takich zmiennych najlepiej uzasadnić grafem przyczynowym, a nie wybierać ich po wynikach. Wartość zmierzona po czasie zero może być już skutkiem narażenia.
Czas obserwacji: jedna data końca, jeden powód
Dla każdej osoby potrzebujesz trzech pól: daty czasu zero, daty końca obserwacji i powodu końca. Obserwacja kończy się przy tym, co nastąpi najwcześniej:
| Zakończenie | Brak opiekuna (n = 145) | Ma opiekuna (n = 255) | Czas liczysz do |
|---|---|---|---|
| Odleżyna | 55 (37.9%) | 80 (31.4%) | Dnia rozpoznania |
| Zgon przed odleżyną | 14 (9.7%) | 20 (7.8%) | Dnia zgonu |
| Utrata z obserwacji | 33 (22.8%) | 25 (9.8%) | Ostatniego potwierdzonego kontaktu |
| Koniec badania bez zdarzenia | 43 (29.7%) | 130 (51.0%) | 31 grudnia 2025 r. |
Czas w latach to różnica dat podzielona przez 365.25. W Excelu wystarczy =(C2-B2)/365.25, w R pokazuje to kod na końcu wpisu. Przed analizą sprawdź, czy nie ma czasów ujemnych, zerowych i zduplikowanych identyfikatorów. Osoba utracona nie jest obserwowana do końca badania: jej czas urywa się w dniu ostatniego kontaktu. Takie obserwacje nazywamy cenzurowanymi. Rysunek 1 pokazuje, jak to wygląda u czterdziestu losowych pacjentów.
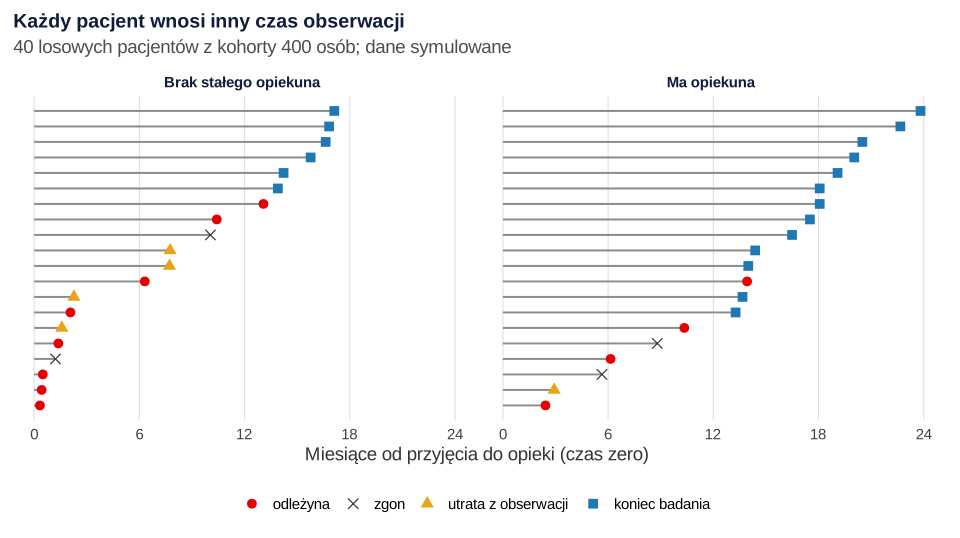
Mediana czasu obserwacji wyniosła 1.17 roku w grupie z opiekunem i 0.76 roku w grupie bez opiekuna. Podaj ją w tekście razem z sumą osobolat (tutaj 394.6). Pamiętaj, że taka mediana obejmuje też osoby, których obserwację zakończyło zdarzenie, więc opisuje faktyczny czas śledzenia, a nie to, jak długo można było kogoś obserwować.
Zgon to osobny problem, bo po nim odleżyna nie może się już pojawić. W analizie na osobolata czas zmarłego po prostu się kończy. Jeśli jednak pytasz o łączne ryzyko po określonym czasie i zgonów jest dużo, potrzebujesz metod dla ryzyk konkurencyjnych.
Zapadalność skumulowana a zapadalność na osobolata
Zapadalność można podać jako ryzyko albo jako współczynnik (Noordzij i in., 2010). To dwie różne miary:
częstość (współczynnik zapadalności) = nowe przypadki / suma osobolat
Ryzyko ma sens tylko z podanym horyzontem: „w ciągu 12 miesięcy”. Częstość ma jednostkę, np. „na 100 osobolat”, i uwzględnia, że każdy wnosi inny czas. Osobolata to suma lat obserwacji wszystkich osób, więc 2 osoby obserwowane po pół roku wnoszą razem 1 osoborok. Ważne jest, co dokładnie wchodzi do mianownika. Spronk i in. (2019) pokazali na danych z praktyk lekarzy rodzinnych, że różne mianowniki zapadalności dawały wyniki różniące się od −1.3 do 14.8%, i zalecają dokładne opisywanie licznika i mianownika.
| Grupa | Osoby | Odleżyna | Odsetek | Osobolata | Częstość na 100 osobolat, 95% CI |
|---|---|---|---|---|---|
| Brak stałego opiekuna | 145 | 55 | 37.9% | 113.8 | 48.3 [36.4, 62.9] |
| Ma opiekuna | 255 | 80 | 31.4% | 280.8 | 28.5 [22.6, 35.5] |
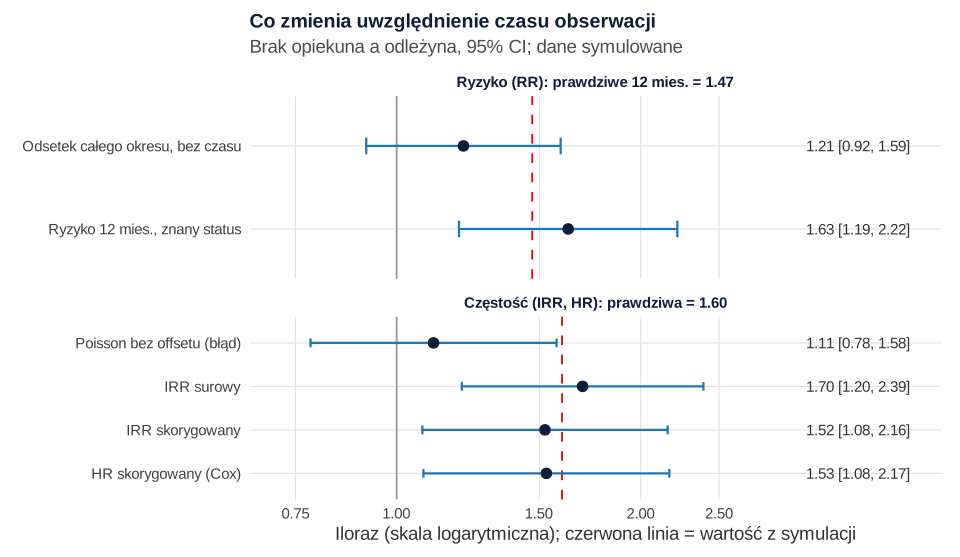
Odsetki różnią się niewiele, a częstości wyraźnie. Porównanie 37.9% z 31.4% daje RR = 1.21, 95% CI [0.92, 1.59], czyli wynik zgodny z brakiem związku. Osoby bez opiekuna były jednak obserwowane krócej: średnio 0.78 roku wobec 1.10 roku. Miały mniej czasu, żeby zdarzenie mogło zostać zapisane. Odsetek z całego okresu nie jest tu zapadalnością skumulowaną, bo nie ma jednego horyzontu. Różnica częstości wyniosła 19.8 na 100 osobolat, 95% CI [5.6, 34.1].
Stały horyzont: ryzyko po 12 miesiącach
Każdy pacjent miał co najmniej 365 dni możliwej obserwacji, więc można zapytać o ryzyko w ciągu roku. Przeszkodą jest utrata: przed upływem 12 miesięcy utracono 30 osób bez opiekuna (20.7%) i 16 z opiekunem (6.3%). Po usunięciu tych osób ryzyko wynosi 47/115 = 40.9% wobec 60/239 = 25.1%, RR = 1.63, 95% CI [1.19, 2.22]. Zmarłych przed odleżyną policzono tu jako osoby bez zdarzenia.
Prawdziwe ryzyka w tej symulacji, przy braku utraty i zgonów, to 35.4% i 24.1%, czyli RR = 1.47. Oba ryzyka są zawyżone, a w grupie bez opiekuna bardziej, bo z mianownika wypadły tylko osoby bez zdarzenia, a osoby, które zdążyły zachorować przed utratą, zostały. Przy znacznej utracie ryzyko po ustalonym czasie lepiej odczytać z krzywej Kaplana–Meiera. Zwróć też uwagę, że RR po roku (1.47) nie równa się ilorazowi częstości (1.60). To dwie różne wielkości, bo ryzyko nie może rosnąć bez końca.
RR i IRR: regresja Poissona z offsetem
Iloraz częstości (ang. incidence rate ratio, IRR) to częstość w grupie narażonej podzielona przez częstość w grupie nienarażonej. Surowo: 48.3 / 28.5 = 1.70. Żeby uwzględnić zakłócacze, użyj regresji Poissona z offsetem, czyli logarytmem czasu obserwacji. Frome (1983) zilustrował taki model analizy częstości na danych kohortowych w układzie tablic trwania życia.
W przykładzie IRR surowy wynosi 1.70, 95% CI [1.20, 2.39]. Po uwzględnieniu wieku i indeksu Barthel maleje do 1.52, 95% CI [1.08, 2.16], z = 2.37, p = .018. Osoby bez opiekuna były częściej starsze, a wiek sam wiązał się z wyższą częstością (IRR = 1.41 na 10 lat). Ten sam model bez offsetu daje 1.11, 95% CI [0.78, 1.58], i związek znika. Rysunek 2 zestawia te oszacowania.
Którą miarę wybrać, zależy od tego, jak wyglądała obserwacja:
| Sytuacja | Miara | Jak policzyć |
|---|---|---|
| Ten sam horyzont, znikoma utrata | Zapadalność skumulowana, RR, różnica ryzyk | Tabela 2×2; z korektą – zmodyfikowana regresja Poissona |
| Różny czas obserwacji, częstość w miarę stała | Częstość na osobolata, IRR, różnica częstości | Regresja Poissona z offsetem |
| Różny czas, częstość zmienia się w czasie albo ważne jest „kiedy” | Krzywa przeżycia, HR | Kaplan–Meier i model Coxa (dalej) |
| Zdarzenie może się powtarzać | Częstość zdarzeń na osobę | Poisson lub ujemny dwumianowy z offsetem |
Dwie uwagi praktyczne. Przy jednym zdarzeniu na osobę wynik ma wartości 0/1, więc nie sprawdzaj nadmiernej dyspersji ilorazem Pearsona – test ma sens przy zliczeniach. Podaj też oszacowania surowe i skorygowane, z 95% CI, oraz wyjaśnij, które zakłócacze uwzględniono i dlaczego (Vandenbroucke i in., 2007). IRR po korekcie nadal nie dowodzi przyczyny: niezmierzone różnice między grupami mogą pozostać, dlatego formułuj wniosek jako związek.
Utrata z obserwacji: ile, kto i co by było, gdyby
Ogólne zasady opisuje hasło o utracie uczestników. W kohorcie liczą się trzy dodatkowe rzeczy.
Podaj utratę osobno w grupach. Utracono 58 osób (14.5%): 22.8% bez opiekuna i 9.8% z opiekunem. Grimes i Schulz (2002) podkreślają, że właśnie różnicowa utrata obciąża wyniki. Przepływ osób pokaż na diagramie przepływu.
Porównaj utraconych z pozostałymi. Utraceni byli średnio starsi (M = 80.02 wobec 77.85 roku) i częściej nie mieli opiekuna (57% wobec 33%). Indeks Barthel był podobny (53.45 wobec 54.17).
Nie szukaj bezpiecznego progu. Kristman i in. (2004) zasymulowali kohortę z różnym poziomem utraty. Przy brakach MCAR i MAR nie stwierdzili ważnego obciążenia nawet przy utracie 60%, ale przy mechanizmie MNAR silne obciążenie pojawiało się już przy niskiej utracie. Ich rada brzmi: planując kohortę, zakładaj MNAR i walcz o jak najpełniejszą obserwację. Osobolata i cenzurowanie też nie są odporne na ten problem. Standardowe metody wymagają założeń o mechanizmie cenzurowania, a w badaniach obserwacyjnych jest on zwykle nieznany (Leung i in., 1997). Założenie brzmi tu: utrata nie zależy od ryzyka odleżyny, po uwzględnieniu zmiennych w modelu.
Założenia tego nie da się sprawdzić w danych, więc przeprowadź analizę wrażliwości. Dla horyzontu 12 miesięcy przypisz 46 utraconym osobom różne scenariusze ryzyka i policz RR ponownie (rysunek 3).
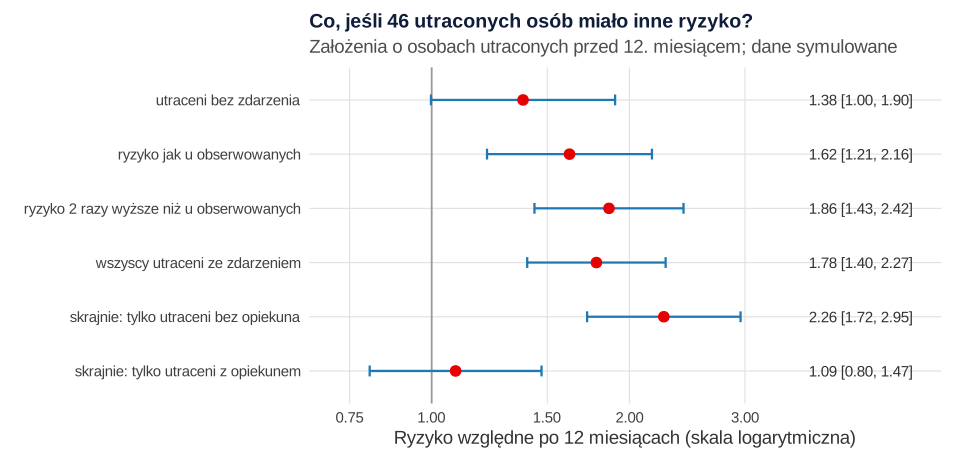
W czterech pierwszych scenariuszach RR wyniosło od 1.38 do 1.86, choć przy założeniu, że nikt z utraconych nie miał zdarzenia, dolna granica przedziału to 1.00. Związek zanikał dopiero w scenariuszu skrajnym, w którym zdarzenie miałaby każda utracona osoba z opiekunem i żadna bez opiekuna (RR = 1.09, 95% CI [0.80, 1.47]). Skrajność w drugą stronę dawała RR = 2.26, 95% CI [1.72, 2.95]. Taki wynik opisz wprost w ograniczeniach. Scenariusze ustal przed obliczeniami i podaj je wszystkie, także te niewygodne.
Błąd czasu nieśmiertelnego – krótko
Załóżmy, że „ma opiekuna” oznacza „kiedykolwiek w czasie obserwacji miał przyznanego opiekuna”. Kto dostał opiekuna w dziesiątym miesiącu, przez dziesięć miesięcy nie mógł wypaść z tej grupy, bo musiał dotrwać do tego dnia. Ten okres to czas nieśmiertelny. Suissa (2008) opisuje go jako fragment obserwacji, w którym z powodu definicji ekspozycji zdarzenie nie mogło wystąpić. Obciążenie rośnie z długością błędnie przypisanego czasu.
Najprościej uniknąć tego błędu, ustalając narażenie w czasie zero. Jeśli narażenie naprawdę zmienia się w trakcie, potrzebujesz zmiennych zależnych od czasu albo analizy landmark. Mechanizm z przykładem liczbowym pokazuje hasło o błędzie czasu nieśmiertelnego.
Kiedy przejść do Kaplana–Meiera i Coxa
Osobolata upraszczają obraz: zakładają, że częstość jest w przybliżeniu stała. Przejdź do analizy Kaplana–Meiera i modelu Coxa, gdy:
- pytanie brzmi „po jakim czasie”, a nie „jak często”;
- zdarzenia skupiają się w jednym okresie, np. w pierwszych tygodniach po przyjęciu;
- chcesz podać ryzyko po ustalonym czasie, a część osób cenzurowano wcześniej;
- promotor lub czasopismo oczekuje krzywych przeżycia.
W przykładzie model Coxa daje HR = 1.53, 95% CI [1.08, 2.17], prawie to samo co IRR. To nie przypadek: w symulacji częstość jest stała w czasie. Przy częstości zmiennej w czasie wyniki mogą się rozjechać, a interpretację i kontrolę założeń opisuje wspomniany poradnik.
Gotowy opis do pracy
W sekcji metod:
W sekcji wyników:
Całość przeprowadź przez listę STROBE dla badań kohortowych – pomoże w tym poradnik o wytycznych raportowania.
Najczęstsze błędy
- Dzielenie zdarzeń przez osoby przy różnym czasie obserwacji. W przykładzie zamienia to wynik 1.70 w 1.21.
- Poisson bez offsetu albo offset w postaci samego czasu zamiast jego logarytmu.
- Czas utraconej osoby liczony do końca badania. Nieobserwowane miesiące zawyżają mianownik.
- „Brak wpisu” jako brak zdarzenia. W badaniu retrospektywnym to dwie różne informacje.
- Włączenie osób, które miały już wynik w czasie zero.
- Narażenie ustalone po czasie zero bez zmiany sposobu liczenia czasu.
- Usunięcie utraconych bez opisu. Podaj, ilu ich było w każdej grupie, kiedy odpadli i czym się różnili.
- Nazywanie IRR „ryzykiem względnym”. RR dotyczy ryzyka w ustalonym czasie, a IRR – częstości na osobolata.
- Język przyczynowy („brak opiekuna powoduje odleżyny”) w badaniu obserwacyjnym.
Kohorta 400 pacjentów w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy dane i zapisuje je w pliku CSV w folderze nadrzędnym (../), drugi liczy czas obserwacji, osobolata i ryzyko po 12 miesiącach, trzeci – modele i analizę wrażliwości. Uruchamiaj je po kolei z jednego folderu. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane można pobrać: badanie-kohortowe-odlezyna-400-pacjentow.csv (400 wierszy: daty, powód końca obserwacji, wiek, indeks Barthel, narażenie 0/1).
Symulacja kohorty
R
# Dane symulowane: retrospektywna kohorta pacjentów domowej opieki pielęgniarskiej.
# Czas zero = dzień przyjęcia do opieki; narażenie = brak stałego opiekuna, ustalony tego dnia.
set.seed(4521)
n <- 400
wiek    <- round(pmin(99, pmax(60, rnorm(n, 78, 8))))
barthel <- 5 * round(pmin(95, pmax(10, rnorm(n, 55, 18))) / 5)
brak_opiekuna <- rbinom(n, 1, plogis(-.55 + .04 * (wiek - 78) - .008 * (barthel - 55)))

przyjecie <- as.Date("2024-01-01") + sample(0:365, n, replace = TRUE)
koniec_badania <- as.Date("2025-12-31")

# Częstości na osoborok. Prawdziwy iloraz częstości dla braku opiekuna = 1.6.
czest_odlezyna <- .26 * 1.6^brak_opiekuna * 1.03^(wiek - 78) * exp(-.015 * (barthel - 55))
czest_zgon     <- .09 * exp(.04 * (wiek - 78))
czest_utrata   <- ifelse(brak_opiekuna == 1, .30, .06)   # utrata częstsza bez opiekuna

dni <- cbind(odlezyna = ceiling(rexp(n, czest_odlezyna) * 365.25),
             zgon     = ceiling(rexp(n, czest_zgon) * 365.25),
             utrata   = ceiling(rexp(n, czest_utrata) * 365.25),
             koniec_badania = as.numeric(koniec_badania - przyjecie))
ktory <- max.col(-dni, ties.method = "first")

d <- data.frame(id = 1:n, data_przyjecia = przyjecie,
                data_konca = przyjecie + dni[cbind(1:n, ktory)],
                status = colnames(dni)[ktory], wiek, barthel, brak_opiekuna)
write.csv(d, "../badanie-kohortowe-odlezyna-400-pacjentow.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Prawda w symulacji: ryzyko 12-miesięczne przy braku utraty i zgonów (dla tych samych 400 osób)
h0 <- .26 * 1.03^(wiek - 78) * exp(-.015 * (barthel - 55))
cat(sprintf("Prawdziwe ryzyko 12 mies.: narażeni %.1f%%, nienarażeni %.1f%%, RR = %.2f; prawdziwy IRR = 1.60\n",
            100 * mean(1 - exp(-1.6 * h0)), 100 * mean(1 - exp(-h0)),
            mean(1 - exp(-1.6 * h0)) / mean(1 - exp(-h0))))
cat("Liczba wierszy:", nrow(d), "\n")
print(table(status = d$status, brak_opiekuna = d$brak_opiekuna))
Wynik w R
Prawdziwe ryzyko 12 mies.: narażeni 35.4%, nienarażeni 24.1%, RR = 1.47; prawdziwy IRR = 1.60
Liczba wierszy: 400
                brak_opiekuna
status             0   1
  koniec_badania 130  43
  odlezyna        80  55
  utrata          25  33
  zgon            20  14
Czas obserwacji, osobolata i ryzyko po 12 miesiącach
R
# Uruchom po b452-1-dane.R.
d <- read.csv("../badanie-kohortowe-odlezyna-400-pacjentow.csv", fileEncoding = "UTF-8")
d$dni  <- as.numeric(as.Date(d$data_konca) - as.Date(d$data_przyjecia))
d$lata <- d$dni / 365.25
d$odl  <- as.numeric(d$status == "odlezyna")
d$grupa <- factor(d$brak_opiekuna, 0:1, c("ma opiekuna", "brak opiekuna"))

# 1. Czas obserwacji i powody jej zakończenia
stopifnot(all(d$lata > 0), !anyNA(d$lata), !anyDuplicated(d$id))
cat("Czas obserwacji w latach (mediana, Q1, Q3):\n")
print(round(sapply(split(d$lata, d$grupa), quantile, c(.5, .25, .75)), 2))
cat("\nJak zakończyła się obserwacja (n, % w wierszu):\n")
tab <- table(d$grupa, d$status)[, c("odlezyna", "zgon", "utrata", "koniec_badania")]
print(tab); print(round(100 * prop.table(tab, 1), 1))

# 2. Zapadalność skumulowana „po prostu” i zapadalność na osobolata
a <- sum(d$odl[d$brak_opiekuna == 1]); n1 <- sum(d$brak_opiekuna == 1); T1 <- sum(d$lata[d$brak_opiekuna == 1])
c <- sum(d$odl[d$brak_opiekuna == 0]); n0 <- sum(d$brak_opiekuna == 0); T0 <- sum(d$lata[d$brak_opiekuna == 0])
cat(sprintf("\nBrak opiekuna: %d zdarzeń / %d osób = %.1f%%; %.1f osobolat; %.1f na 100 osobolat\n",
            a, n1, 100 * a / n1, T1, 100 * a / T1))
cat(sprintf("Ma opiekuna:   %d zdarzeń / %d osób = %.1f%%; %.1f osobolat; %.1f na 100 osobolat\n",
            c, n0, 100 * c / n0, T0, 100 * c / T0))
cat(sprintf("Łącznie %.1f osobolat, %d zdarzeń; utraceni z obserwacji %d (%.1f%%)\n",
            T1 + T0, a + c, sum(d$status == "utrata"), 100 * mean(d$status == "utrata")))
cat(sprintf("Średni czas obserwacji: brak opiekuna %.2f, ma opiekuna %.2f roku\n", T1 / n1, T0 / n0))

ci1 <- poisson.test(a, T1)$conf.int * 100; ci0 <- poisson.test(c, T0)$conf.int * 100
cat(sprintf("95%% CI częstości na 100 osobolat: brak [%.1f, %.1f], ma [%.1f, %.1f]\n",
            ci1[1], ci1[2], ci0[1], ci0[2]))

# 3. Ryzyko względne z odsetków (metoda log) i różnica częstości
rr <- (a / n1) / (c / n0); se <- sqrt(1/a - 1/n1 + 1/c - 1/n0)
cat(sprintf("\nRR z odsetków (bez czasu) = %.2f, 95%% CI [%.2f, %.2f]\n",
            rr, rr * exp(-1.96 * se), rr * exp(1.96 * se)))
ird <- 100 * (a / T1 - c / T0); se_ird <- 100 * sqrt(a / T1^2 + c / T0^2)
cat(sprintf("Różnica częstości = %.1f na 100 osobolat, 95%% CI [%.1f, %.1f]\n",
            ird, ird - 1.96 * se_ird, ird + 1.96 * se_ird))

# 4. Stały horyzont 12 miesięcy: każdy miał co najmniej 365 dni możliwej obserwacji
d$odl12 <- as.numeric(d$odl == 1 & d$dni <= 365)
d$utr12 <- as.numeric(d$status == "utrata" & d$dni < 365)
cat("\nUtraceni przed upływem 12 miesięcy:\n")
print(with(d, tapply(utr12, grupa, function(x) c(n = sum(x), proc = round(100 * mean(x), 1)))))
zn <- subset(d, utr12 == 0)
p <- with(zn, tapply(odl12, brak_opiekuna, mean)); m <- with(zn, tapply(odl12, brak_opiekuna, length))
x <- with(zn, tapply(odl12, brak_opiekuna, sum))
rr12 <- p[["1"]] / p[["0"]]; se12 <- sqrt(1/x[["1"]] - 1/m[["1"]] + 1/x[["0"]] - 1/m[["0"]])
cat(sprintf("12 mies., znany status: brak opiekuna %d/%d = %.1f%%, ma opiekuna %d/%d = %.1f%%, RR = %.2f [%.2f, %.2f]\n",
            x[["1"]], m[["1"]], 100 * p[["1"]], x[["0"]], m[["0"]], 100 * p[["0"]],
            rr12, rr12 * exp(-1.96 * se12), rr12 * exp(1.96 * se12)))
Wynik w R
Czas obserwacji w latach (mediana, Q1, Q3):
    ma opiekuna brak opiekuna
50%        1.17          0.76
25%        0.72          0.28
75%        1.49          1.19

Jak zakończyła się obserwacja (n, % w wierszu):

                odlezyna zgon utrata koniec_badania
  ma opiekuna         80   20     25            130
  brak opiekuna       55   14     33             43

                odlezyna zgon utrata koniec_badania
  ma opiekuna       31.4  7.8    9.8           51.0
  brak opiekuna     37.9  9.7   22.8           29.7

Brak opiekuna: 55 zdarzeń / 145 osób = 37.9%; 113.8 osobolat; 48.3 na 100 osobolat
Ma opiekuna:   80 zdarzeń / 255 osób = 31.4%; 280.8 osobolat; 28.5 na 100 osobolat
Łącznie 394.6 osobolat, 135 zdarzeń; utraceni z obserwacji 58 (14.5%)
Średni czas obserwacji: brak opiekuna 0.78, ma opiekuna 1.10 roku
95% CI częstości na 100 osobolat: brak [36.4, 62.9], ma [22.6, 35.5]

RR z odsetków (bez czasu) = 1.21, 95% CI [0.92, 1.59]
Różnica częstości = 19.8 na 100 osobolat, 95% CI [5.6, 34.1]

Utraceni przed upływem 12 miesięcy:
$`ma opiekuna`
   n proc
16.0  6.3

$`brak opiekuna`
   n proc
30.0 20.7

12 mies., znany status: brak opiekuna 47/115 = 40.9%, ma opiekuna 60/239 = 25.1%, RR = 1.63 [1.19, 2.22]
Regresja Poissona z offsetem, porównanie z modelem Coxa i analiza wrażliwości
R
# Uruchom po b452-1-dane.R.
suppressPackageStartupMessages(library(survival))
d <- read.csv("../badanie-kohortowe-odlezyna-400-pacjentow.csv", fileEncoding = "UTF-8")
d$dni  <- as.numeric(as.Date(d$data_konca) - as.Date(d$data_przyjecia))
d$lata <- d$dni / 365.25
d$odl  <- as.numeric(d$status == "odlezyna")
d$wiek10 <- (d$wiek - 78) / 10; d$barthel10 <- (d$barthel - 55) / 10
wiersz <- function(m, nazwa = "brak_opiekuna") {
  e <- coef(summary(m))[nazwa, ]
  c(est = exp(e[[1]]), lo = exp(e[[1]] - 1.96 * e[["Std. Error"]]), hi = exp(e[[1]] + 1.96 * e[["Std. Error"]]))
}

# 1. Regresja Poissona z offsetem: IRR surowy i skorygowany
m0 <- glm(odl ~ brak_opiekuna + offset(log(lata)), family = poisson, data = d)
m1 <- glm(odl ~ brak_opiekuna + wiek10 + barthel10 + offset(log(lata)), family = poisson, data = d)
p1 <- coef(summary(m1))["brak_opiekuna", "Pr(>|z|)"]
cat(sprintf("IRR surowy        = %.2f [%.2f, %.2f]\n", wiersz(m0)[1], wiersz(m0)[2], wiersz(m0)[3]))
cat(sprintf("IRR skorygowany   = %.2f [%.2f, %.2f], z = %.2f, p = %s\n",
            wiersz(m1)[1], wiersz(m1)[2], wiersz(m1)[3], coef(summary(m1))["brak_opiekuna", "z value"],
            sub("^0", "", sprintf("%.3f", p1))))
print(round(exp(cbind(IRR = coef(m1), confint.default(m1))), 2))

# 2. Ten sam model bez offsetu (błąd: pominięty czas obserwacji)
m_b <- glm(odl ~ brak_opiekuna + wiek10 + barthel10, family = poisson, data = d)
cat(sprintf("\nBez offsetu (błąd) = %.2f [%.2f, %.2f]\n", wiersz(m_b)[1], wiersz(m_b)[2], wiersz(m_b)[3]))

# 3. Porównanie z modelem Coxa: czy iloraz częstości mówi to samo co HR?
cx <- coxph(Surv(lata, odl) ~ brak_opiekuna + wiek10 + barthel10, data = d)
e <- summary(cx)$conf.int["brak_opiekuna", ]
cat(sprintf("HR (Cox)          = %.2f [%.2f, %.2f]\n", e[["exp(coef)"]], e[["lower .95"]], e[["upper .95"]]))

# 4. Czy osoby utracone różniły się na starcie od pozostałych?
d$utracony <- factor(d$status == "utrata", c(FALSE, TRUE), c("pozostali", "utraceni"))
cat("\nŚrednie na starcie:\n")
print(aggregate(cbind(wiek, barthel, brak_opiekuna) ~ utracony, d, function(x) round(mean(x), 2)))

# 5. Analiza wrażliwości: co, jeśli utraceni przed 12. miesiącem mieli inne ryzyko?
d$odl12 <- as.numeric(d$odl == 1 & d$dni <= 365)
d$utr12 <- as.numeric(d$status == "utrata" & d$dni < 365)
rr_sc <- function(y1, y0) {           # y1, y0: liczba zdarzeń przypisanych utraconym w grupach
  zn <- subset(d, utr12 == 0)
  a <- sum(zn$odl12[zn$brak_opiekuna == 1]) + y1; n1 <- sum(d$brak_opiekuna == 1)
  c <- sum(zn$odl12[zn$brak_opiekuna == 0]) + y0; n0 <- sum(d$brak_opiekuna == 0)
  se <- sqrt(1/a - 1/n1 + 1/c - 1/n0); r <- (a / n1) / (c / n0)
  c(zdarz1 = a, zdarz0 = c, RR = r, lo = r * exp(-1.96 * se), hi = r * exp(1.96 * se))
}
u1 <- sum(d$utr12[d$brak_opiekuna == 1]); u0 <- sum(d$utr12[d$brak_opiekuna == 0])
zn <- subset(d, utr12 == 0); q <- tapply(zn$odl12, zn$brak_opiekuna, mean)
sc <- rbind(
  "utraceni bez zdarzenia"                = rr_sc(0, 0),
  "ryzyko jak u obserwowanych"            = rr_sc(round(q[["1"]] * u1), round(q[["0"]] * u0)),
  "ryzyko 2 razy wyższe niż u obserwowanych" = rr_sc(round(2 * q[["1"]] * u1), round(2 * q[["0"]] * u0)),
  "wszyscy utraceni ze zdarzeniem"        = rr_sc(u1, u0),
  "skrajnie: tylko utraceni bez opiekuna" = rr_sc(u1, 0),
  "skrajnie: tylko utraceni z opiekunem"  = rr_sc(0, u0))
cat(sprintf("\nUtraceni przed 12. mies.: brak opiekuna %d, ma opiekuna %d\n", u1, u0))
print(round(sc, 2))
write.csv(data.frame(scenariusz = rownames(sc), sc), "b452-scenariusze.csv", row.names = FALSE, fileEncoding = "UTF-8")
Wynik w R
IRR surowy        = 1.70 [1.20, 2.39]
IRR skorygowany   = 1.52 [1.08, 2.16], z = 2.37, p = .018
               IRR 2.5 % 97.5 %
(Intercept)   0.28  0.23   0.35
brak_opiekuna 1.52  1.08   2.16
wiek10        1.41  1.12   1.78
barthel10     0.90  0.82   0.99

Bez offsetu (błąd) = 1.11 [0.78, 1.58]
HR (Cox)          = 1.53 [1.08, 2.17]

Średnie na starcie:
   utracony  wiek barthel brak_opiekuna
1 pozostali 77.85   54.17          0.33
2  utraceni 80.02   53.45          0.57

Utraceni przed 12. mies.: brak opiekuna 30, ma opiekuna 16
                                         zdarz1 zdarz0   RR   lo   hi
utraceni bez zdarzenia                       47     60 1.38 1.00 1.90
ryzyko jak u obserwowanych                   59     64 1.62 1.21 2.16
ryzyko 2 razy wyższe niż u obserwowanych     72     68 1.86 1.43 2.42
wszyscy utraceni ze zdarzeniem               77     76 1.78 1.40 2.27
skrajnie: tylko utraceni bez opiekuna        77     60 2.26 1.72 2.95
skrajnie: tylko utraceni z opiekunem         47     76 1.09 0.80 1.47
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem survival; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed analizą kohorty sprawdź…
- Czy czas zero wyznacza jedna reguła, taka sama w obu grupach?
- Czy nikt w czasie zero nie miał jeszcze wyniku?
- Czy narażenie jest ustalone w czasie zero albo wcześniej?
- Czy każda osoba ma datę końca i jeden powód końca?
- Czy utraceni mają datę ostatniego potwierdzonego kontaktu?
- Czy utrata jest policzona osobno w grupach i porównana z cechami na starcie?
- Czy wiesz, czy podajesz ryzyko z horyzontem, czy częstość na osobolata?
- Czy zakłócacze zostały wybrane przed analizą i podano wyniki surowe oraz skorygowane?
- Czy scenariusze analizy wrażliwości zostały opisane przed obliczeniami?
Najczęstsze pytania
Czym różni się retrospektywne badanie kohortowe od kliniczno-kontrolnego?
W kohorcie retrospektywnej grupy tworzysz według narażenia i na podstawie istniejących danych śledzisz, u kogo pojawił się wynik. W badaniu kliniczno-kontrolnym zaczynasz od wyniku: wybierasz przypadki i kontrole, a potem szukasz narażenia w przeszłości. Dlatego w kohorcie możesz policzyć zapadalność, a w typowym badaniu kliniczno-kontrolnym nie.
Jak policzyć osobolata w Excelu lub R?
Dla każdej osoby odejmij datę czasu zero od daty końca obserwacji i podziel przez 365.25, a następnie zsumuj wyniki w grupie. Datą końca jest zdarzenie, zgon, ostatni potwierdzony kontakt albo koniec badania – co nastąpi najwcześniej. Częstość to liczba zdarzeń podzielona przez tę sumę, zwykle podawana na 100 lub 1000 osobolat.
Czy w badaniu kohortowym wystarczy podać odsetek osób ze zdarzeniem?
Tylko wtedy, gdy wszyscy mieli ten sam horyzont obserwacji i utrata była znikoma. Przy różnym czasie odsetek zależy od długości śledzenia: w przykładzie na tej stronie dał RR = 1.21, podczas gdy IRR wyniósł 1.70, bo grupa narażona była obserwowana krócej.
Ile utraty z obserwacji to za dużo w badaniu kohortowym?
Nie ma bezpiecznego progu. W symulacji Kristman i in. (2004) utrata do 60% nie obciążała wyników przy brakach MCAR i MAR, ale przy MNAR silne obciążenie pojawiało się już przy niskiej utracie. Podaj utratę w każdej grupie, porównaj cechy osób utraconych i przeprowadź analizę wrażliwości.
Regresja Poissona czy model Coxa w badaniu kohortowym?
Regresja Poissona z offsetem dobrze działa, gdy częstość zdarzeń jest w przybliżeniu stała, a interesuje Cię liczba zdarzeń na osobolata. Model Coxa nie wymaga stałej częstości i jest naturalnym wyborem, gdy ważny jest czas do zdarzenia. Przy stałej częstości oba dają podobny wynik: w przykładzie IRR = 1.52 i HR = 1.53.
Powiązane hasła
Przeczytaj też
Kaplan–Meier i regresja Coxa w SPSS
Od kodowania statusu po opis APA: krzywe i mediany, log-rank, Breslow i Tarone–Ware, ilorazy hazardów z Cox Regression i sprawdzenie proporcjonalności hazardów – z plikiem .sav.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikAnaliza dokumentacji medycznej – badanie retrospektywne
Pytanie, kryteria, karta zbierania danych, „brak wpisu” ≠ „nie”, kappa na podpróbie kart, braki, zgody, STROBE i RECORD – z przykładem w R.
Czytaj →PoradnikRR, OR i NNT w pracy dyplomowej
Która miara do którego schematu badania, dlaczego OR różni się od RR przy częstym zdarzeniu, przedziały ufności i NNT przez nieskończoność – z gotowymi zdaniami i przykładem w R.
Czytaj →Analizujesz kohortę w pracy dyplomowej i nie wiesz, jak policzyć czas obserwacji?
Pomożemy ustalić czas zero, policzyć osobolata i iloraz częstości, ocenić wpływ utraty z obserwacji i opisać wyniki w R lub SPSS – tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Frome, E. L. (1983). The analysis of rates using Poisson regression models. Biometrics, 39(3), 665–674. https://doi.org/10.2307/2531094
- Grimes, D. A., & Schulz, K. F. (2002). Cohort studies: Marching towards outcomes. The Lancet, 359(9303), 341–345. https://doi.org/10.1016/s0140-6736(02)07500-1
- Kristman, V., Manno, M., & Côté, P. (2004). Loss to follow-up in cohort studies: How much is too much? European Journal of Epidemiology, 19(8), 751–760. https://doi.org/10.1023/b:ejep.0000036568.02655.f8
- Leung, K.-M., Elashoff, R. M., & Afifi, A. A. (1997). Censoring issues in survival analysis. Annual Review of Public Health, 18(1), 83–104. https://doi.org/10.1146/annurev.publhealth.18.1.83
- Noordzij, M., Dekker, F. W., Zoccali, C., & Jager, K. J. (2010). Measures of disease frequency: Prevalence and incidence. Nephron Clinical Practice, 115(1), c17–c20. https://doi.org/10.1159/000286345
- Spronk, I., Korevaar, J. C., Poos, R., Davids, R., Hilderink, H., Schellevis, F. G., Verheij, R. A., & Nielen, M. M. J. (2019). Calculating incidence rates and prevalence proportions: Not as simple as it seems. BMC Public Health, 19(1), Article 512. https://doi.org/10.1186/s12889-019-6820-3 ● Otwarty dostęp
- Suissa, S. (2008). Immortal time bias in pharmacoepidemiology. American Journal of Epidemiology, 167(4), 492–499. https://doi.org/10.1093/aje/kwm324
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
Cytowania BibTeX
@article{frome1983analysis, author={Frome, Edward L.}, title={{The analysis of rates using Poisson regression models}}, journal={Biometrics}, year={1983}, volume={39}, number={3}, pages={665--674}, doi={10.2307/2531094}}@article{grimes2002cohort, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Cohort studies: Marching towards outcomes}}, journal={The Lancet}, year={2002}, volume={359}, number={9303}, pages={341--345}, doi={10.1016/s0140-6736(02)07500-1}}@article{kristman2004loss, author={Kristman, Vicki and Manno, Michael and Côté, Pierre}, title={{Loss to follow-up in cohort studies: How much is too much?}}, journal={European Journal of Epidemiology}, year={2004}, volume={19}, number={8}, pages={751--760}, doi={10.1023/b:ejep.0000036568.02655.f8}}@article{leung1997censoring, author={Leung, Kwan-Moon and Elashoff, Robert M. and Afifi, Abdelmonem A.}, title={{Censoring issues in survival analysis}}, journal={Annual Review of Public Health}, year={1997}, volume={18}, number={1}, pages={83--104}, doi={10.1146/annurev.publhealth.18.1.83}}@article{noordzij2010measures, author={Noordzij, Marlies and Dekker, Friedo W. and Zoccali, Carmine and Jager, Kitty J.}, title={{Measures of disease frequency: Prevalence and incidence}}, journal={Nephron Clinical Practice}, year={2010}, volume={115}, number={1}, pages={c17--c20}, doi={10.1159/000286345}}@article{spronk2019calculating, author={Spronk, Inge and Korevaar, Joke C. and Poos, René and Davids, Rodrigo and Hilderink, Henk and Schellevis, François G. and Verheij, Robert A. and Nielen, Mark M. J.}, title={{Calculating incidence rates and prevalence proportions: Not as simple as it seems}}, journal={BMC Public Health}, year={2019}, volume={19}, number={1}, eid={512}, doi={10.1186/s12889-019-6820-3}}@article{suissa2008immortal, author={Suissa, S.}, title={{Immortal time bias in pharmacoepidemiology}}, journal={American Journal of Epidemiology}, year={2008}, volume={167}, number={4}, pages={492--499}, doi={10.1093/aje/kwm324}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}