Do czego służą te dwie procedury
Analiza przeżycia opisuje czas do zdarzenia: do zgonu, nawrotu, rezygnacji ze studiów albo podjęcia pracy. Kluczowe jest to, że części osób zdarzenie nie spotkało do końca obserwacji. Ich czas jest obserwacją cenzurowaną: wiemy tylko, że jest dłuższy niż okres, przez który je obserwowaliśmy. W SPSS służą do tego dwie procedury z menu Analyze → Survival. Kaplan-Meier opisuje i porównuje krzywe przeżycia grup. Cox Regression szacuje wpływ kilku predyktorów naraz jako ilorazy hazardów.
Teorię opisuje wpis Kaplan–Meier i model Coxa krok po kroku (przykład w R). Tutaj zajmujemy się tylko SPSS: oknami, tabelami i tym, co przepisać do pracy. Ścieżki menu, nazwy okien i opcji sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.-a, b.d.-b) i podajemy je po angielsku. Polska dokumentacja podaje Analiza → Przeżywalność → Kaplan-Meier oraz Regresja Cox, a w polskim interfejsie etykiety mogą brzmieć inaczej. Według dokumentacji obie procedury wymagają wersji Standard Edition albo modułu Advanced Statistics (IBM Corp., b.d.-a, b.d.-b). Zasady czytania wydruku: jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego fikcyjnego zbioru. 180 absolwentów obserwowano przez 365 dni od obrony, czyli w układzie badania kohortowego. Zdarzenie to podjęcie pierwszej pracy w zawodzie. Połowa osób odbyła staż w czasie studiów, połowa nie. Pytanie brzmi: czy osoby po stażu szybciej znajdują pracę, także po uwzględnieniu średniej ocen?
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS opisuje hasło plik .sav.
Czas i status: jak zakodować dane
Jeden wiersz to jedna osoba. Procedury potrzebują dwóch kolumn:
- czas (
dni) – liczba dni od wspólnego początku (obrony) do zdarzenia albo do końca obserwacji. Przypadki z ujemnym czasem SPSS pomija (IBM Corp., b.d.-b), więc ujemna wartość zwykle oznacza błąd w datach; - status (
status) – kod, czy zdarzenie zaszło. W przykładzie 1 = praca, 0 = koniec obserwacji bez pracy, 2 = utrata kontaktu.
W oknie Define Event podajesz wartość albo wartości oznaczające zdarzenie. Dokumentacja składni mówi wprost, że każdy przypadek z nieujemnym czasem i kodem spoza listy zdarzeń jest traktowany jako cenzurowany (IBM Corp., b.d.-c). Kody 0 i 2 nie wymagają więc rekodowania, ale kod braku danych, np. 9, też stanie się obserwacją cenzurowaną. Przed analizą sprawdź więc tabelę częstości statusu i zdefiniuj braki danych (zob. przygotowanie danych w SPSS).
Cenzurowanie musi być niezależne od rokowania. Dokumentacja IBM ostrzega, że wyniki będą obciążone, jeśli osoby cenzurowane różnią się systematycznie od pozostałych (IBM Corp., b.d.-a). Kaplan i Meier (1958) zaznaczali już, że założenie niezależności czasu zdarzenia od czasu utraty obserwacji trzeba starannie sprawdzić. W prawdziwym badaniu absolwenci bez pracy mogą częściej nie odpowiadać na maile.
Kaplan–Meier krok po kroku
- Analyze → Survival → Kaplan-Meier (IBM Corp., b.d.-a).
- Okno główne.
dniwybierz jako zmienną czasu,statusjako zmienną statusu i kliknij Define Event. Wpisz 1 jako pojedynczą wartość (Single value). Zmiennąstazwybierz jako czynnik (Factor). - Compare Factor. Zaznacz Log rank, Breslow i Tarone-Ware oraz zakres Pooled over strata, czyli jeden test dla wszystkich poziomów czynnika. Przy trzech i więcej grupach jest też Pairwise over strata (porównania par), a dla czynnika uporządkowanego – test trendu liniowego (IBM Corp., b.d.-a).
- Options. W grupie Statistics zaznacz Survival table(s), Mean and median survival i Quartiles, a w grupie Plots – Survival (IBM Corp., b.d.-a).
Tabele Kaplana–Meiera
Liczby w tabelach policzono w R tą samą metodą estymatora iloczynowego (Kaplan i Meier, 1958). Nazwy kolumn tabeli przeżycia pochodzą z przykładu IBM. Kolejne dwie tabele pokazujemy w zwykłym układzie APA, bo dokumentacja nie wymienia ich kolumn. Pogrubiono liczby, które trafią do pracy.
Case Processing Summary. W grupie bez stażu pracę podjęło 70 z 90 osób (22.2% obserwacji cenzurowanych), a w grupie ze stażem – 84 z 90 (6.7%). Razem 154 zdarzenia i 26 obserwacji cenzurowanych: 18 z utratą kontaktu i 8, które dotrwały do 365. dnia bez pracy.
| Time | Status | Cumulative Proportion Surviving at the Time | Std. Error | N of Cumulative Events | N of Remaining Cases |
|---|---|---|---|---|---|
| 2 | praca | .989 | .011 | 1 | 89 |
| 4 | praca | .978 | .016 | 2 | 88 |
| 7 | praca | .967 | .019 | 3 | 87 |
| 15 | praca | .956 | .022 | 4 | 86 |
| 20 | praca | .944 | .024 | 5 | 85 |
| 21 | praca | 6 | 84 | ||
| 21 | praca | .922 | .028 | 7 | 83 |
| 24 | praca | .889 | .033 | 8 | 82 |
Każdy wiersz to jedna osoba, a Cumulative Proportion Surviving at the Time to odsetek osób bez zdarzenia do danego dnia. Gdy kilka osób ma zdarzenie tego samego dnia (tu dzień 21), wartość jest drukowana raz (IBM Corp., b.d.-e). Do pracy przenosisz nie tę tabelę, lecz medianę, kwartyle i odsetki w wybranych dniach.
| Grupa | n | Zdarzenia | Q1 (dni) | Mediana [95% CI] | Q3 (dni) | Bez pracy po 90 dniach | po 180 dniach |
|---|---|---|---|---|---|---|---|
| bez stażu | 90 | 70 | 61 | 149 [119, 258] | 309 | .662 | .444 |
| ze stażem | 90 | 84 | 66 | 111 [94, 141] | 192 | .610 | .267 |
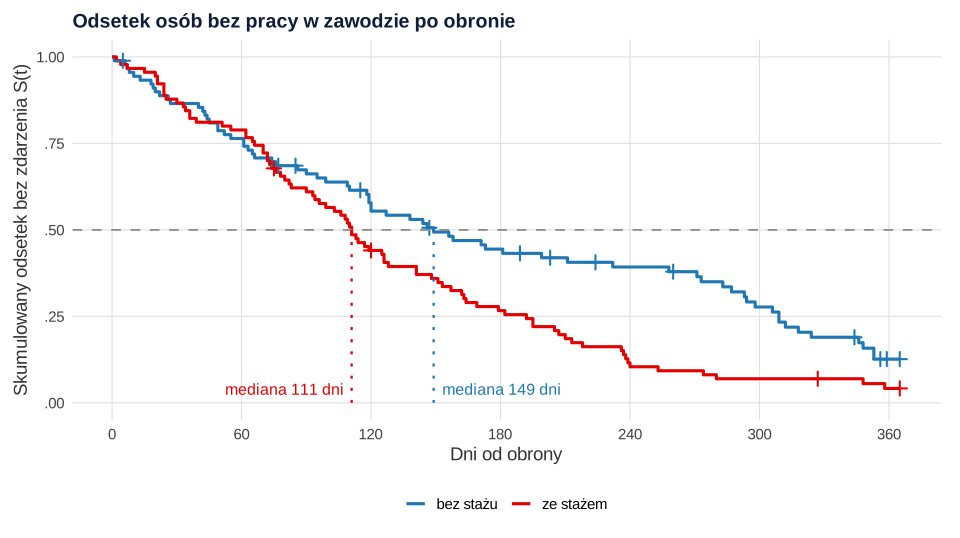
Mediana to dzień, w którym krzywa spada do .50: połowa osób ze stażem miała pracę po 111 dniach, a bez stażu – po 149 dniach (rysunek 1). SPSS w tabeli Means and Medians for Survival Time podaje też średnią i medianę z błędem standardowym i 95% przedziałem ufności (IBM Corp., b.d.-a). Przedział mediany policzono domyślną metodą R. Dokumentacja nie podaje wzoru SPSS, więc w pracy przepisz granice z własnego wydruku. Średnią traktuj ostrożnie: gdy najdłuższe czasy są cenzurowane, nie obejmuje ogona (zob. RMST).
Log-rank, Breslow i Tarone–Ware: który test
Tabela Overall Comparisons zawiera wybrane testy równości krzywych. Każdy porównuje liczby zdarzeń obserwowane i oczekiwane w kolejnych dniach zdarzeń. Różnią się wagami (IBM Corp., b.d.-a):
- Log rank (Mantel-Cox) – wszystkie punkty czasu mają tę samą wagę. To test domyślny w składni (IBM Corp., b.d.-c);
- Breslow (Generalized Wilcoxon) – waga to liczba osób zagrożonych w danym momencie, więc test silniej reaguje na różnice na początku obserwacji;
- Tarone-Ware – waga to pierwiastek z liczby zagrożonych, czyli rozwiązanie pośrednie.
| Test | χ² | df | p |
|---|---|---|---|
| Log Rank (Mantel-Cox) | 8.719 | 1 | .003 |
| Breslow (Generalized Wilcoxon) | 3.986 | 1 | .046 |
| Tarone-Ware | 6.391 | 1 | .011 |
Każda statystyka ma rozkład χ² z jednym stopniem swobody przy dwóch grupach. Wyniki się różnią, bo krzywe przez pierwsze 70 dni prawie się pokrywają, a rozchodzą się później. Breslow daje największą wagę wczesnym dniom, gdy zagrożonych jest najwięcej, więc ma najmniejsze χ². Test wybierz przed analizą. Zwykle jest to test log-rank, najmocniejszy przy proporcjonalnych hazardach. Nie raportuj tego z trzech, który „wyszedł najlepiej”. Gdy krzywe się przecinają, pokaż wykres i odsetki w wybranych dniach.
Regresja Coxa krok po kroku
Model Coxa zakłada, że hazard osoby to nieznany hazard bazowy zmienny w czasie pomnożony przez funkcję jej cech (Cox, 1972). Nie trzeba więc zakładać kształtu krzywej przeżycia.
- Analyze → Survival → Cox Regression (IBM Corp., b.d.-b).
- Okno główne.
dnijako zmienna czasu,statusjako zmienna statusu, Define Event → 1. Do listy Covariates przenieśstazisrednia. Metodę zostaw Enter – to ustawienie domyślne (IBM Corp., b.d.-d). Metod krokowych (np. Forward: LR) nie używaj do testowania hipotez. - Categorical. Zmienną 0/1 możesz wpisać bez tego okna: współczynnik dotyczy wtedy kodu 1 względem 0. Zmienne o trzech i więcej kategoriach oznacz tu jako kategorialne. Domyślne kodowanie to Indicator, a kategoria odniesienia w oknie to ostatnia (IBM Corp., b.d.-e). W składni słowo
INDICATORbez numeru oznacza pierwszą kategorię (IBM Corp., b.d.-d). Po zmianie Reference Category kliknij Change, inaczej zmiana nie zadziała (IBM Corp., b.d.-b), i sprawdź tabelę kodowania na wydruku. - Options. W grupie Model Statistics zaznacz przedziały ufności dla exp(B) (IBM Corp., b.d.-b). W składni ich domyślny poziom to 95% (IBM Corp., b.d.-d).
- Plots i Save – do sprawdzenia założeń (niżej).
Gdy staz trafi do Categorical z domyślną ostatnią kategorią odniesienia, odniesieniem stanie się „tak”. Exp(B) wyniesie wtedy 0.623 (95% CI [0.450, 0.862]) zamiast 1.605. To ten sam wynik odwrócony: zawsze opisz, co jest z czym porównywane.
Tabele regresji Coxa
Według dokumentacji SPSS podaje dla modelu −2LL, statystykę ilorazu wiarygodności i ogólne χ², a dla zmiennych w modelu – oszacowania, błędy standardowe i statystyki Walda (IBM Corp., b.d.-b). W przykładzie IBM tabele mają podpisy „Omnibus tests” i „Variables in the equation”, a efekt odczytuje się z kolumny Exp(B) (IBM Corp., b.d.-e). Dokładnych nagłówków pozostałych kolumn dokumentacja nie wypisuje, więc pokazujemy zwykłe tabele.
| −2LL modelu bez predyktorów | −2LL modelu | Ogólne χ² (score) | Zmiana −2LL (χ²) | df | p |
|---|---|---|---|---|---|
| 1357.311 | 1348.284 | 9.131 | 9.027 | 2 | .011 |
Model z dwoma predyktorami jest lepszy od modelu bez predyktorów: χ²(2) = 9.03, p = .011. Nie mówi to, który predyktor działa.
| Predyktor | B | SE | Wald | df | p | Exp(B) | 95% CI dla Exp(B) |
|---|---|---|---|---|---|---|---|
| staz (1 = tak) | 0.473 | 0.166 | 8.161 | 1 | .004 | 1.605 | [1.160, 2.220] |
| srednia (1 pkt) | 0.119 | 0.176 | 0.456 | 1 | .500 | 1.126 | [0.798, 1.589] |
Exp(B) to iloraz hazardów (HR): przewidywana zmiana hazardu przy wzroście predyktora o jednostkę (IBM Corp., b.d.-e). Osoby po stażu mają w każdym dniu hazard podjęcia pracy 1.61 raza wyższy niż osoby bez stażu o tej samej średniej ocen. Zdarzenie jest tu pożądane, więc HR > 1 oznacza szybsze znalezienie pracy; przy zgonie czy rezygnacji – gorsze rokowanie. Średnia ocen nie wiąże się istotnie z czasem: HR = 1.13 na 1 punkt, a przedział sięga od 0.80 do 1.59, czyli wynik jest niejednoznaczny, a nie „brak wpływu”. Wiązania czasów zdarzeń R obsłużył metodą Breslowa. Dokumentacja HTML nie opisuje, jak robi to SPSS, ale w przykładzie metoda Efrona daje prawie to samo (HR 1.606 i 1.125).
Założenie proporcjonalnych hazardów
Model zakłada, że iloraz hazardów jest stały w czasie (IBM Corp., b.d.-b). Dokumentacja IBM pokazuje dwa sposoby sprawdzenia (IBM Corp., b.d.-e):
- Reszty częściowe a czas. W oknie Save zaznacz Partial residuals. SPSS zapisze jedną zmienną dla każdego predyktora (IBM Corp., b.d.-b). Potem Graphs → Chart Builder, wykres Simple Scatter reszty dla stażu względem czasu, z linią dopasowania. Przy spełnionym założeniu wykres nie ma wzoru. Wyraźny trend oznacza efekt zmienny w czasie (IBM Corp., b.d.-e).
- Zmienna zależna od czasu. Analyze → Survival → Cox w/ Time-Dep Cov. W oknie Compute Time-Dependent Covariate wpisz wyrażenie
T_*staz, gdzieT_to czas. Kliknij Model i dodaj do kowariantstaz,sredniaiT_COV_(IBM Corp., b.d.-e). Istotny współczynnikT_COV_oznacza, że efekt stażu zmienia się w czasie. Więcej o takich zmiennych w haśle zmienne zależne od czasu w modelu Coxa.
W przykładzie T_COV_ ma B = 0.001341, SE = 0.001711, Wald = 0.615, p = .433. Współczynnik jest tak mały, bo czas liczono w dniach. W przeliczeniu na 100 dni HR stażu rósłby o czynnik 1.144, ale ten trend nie jest istotny. IBM radzi zwiększyć liczbę miejsc po przecinku w komórce (Format → Cell Properties) albo przeskalować czas (IBM Corp., b.d.-e). W tym modelu SPSS nie rysuje wykresów (IBM Corp., b.d.-d).
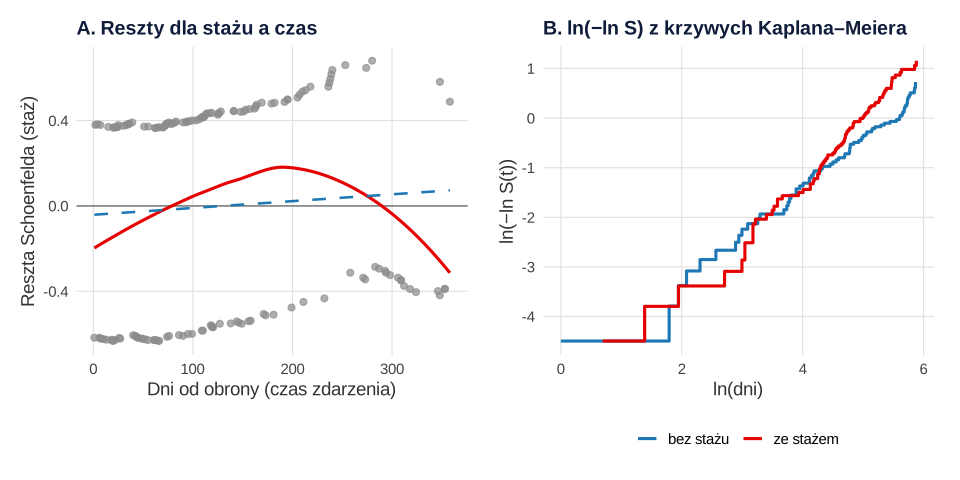
Panel A to odpowiednik wykresu z punktu 1. W R użyto reszt Schoenfelda. Dokumentacja IBM nie podaje wzoru reszt częściowych, więc nie twierdzimy, że wartości z SPSS będą identyczne. Grambsch i Therneau (1994) pokazali, że wygładzony wykres takich reszt pozwala zobaczyć efekt zmienny w czasie, a wiele testów proporcjonalności odpowiada prostej dopasowanej do tego wykresu. Prosta jest tu płaska. Test w R daje χ²(1) = 0.617, p = .43, prawie to samo co test T_COV_. Falowania krzywej wygładzonej na końcach, gdzie zdarzeń jest mało, nie nadinterpretuj.
Panel B to wykres ln(−ln S): przy proporcjonalnych hazardach linie grup biegną równolegle. Opcja Log minus log w oknie Plots rysuje tę funkcję z modelu Coxa (IBM Corp., b.d.-b). Gdy staż jest kowariantem modelu, linie jego kategorii są równoległe z definicji, więc taki wykres niczego nie sprawdza.
Zapis wyników w stylu APA
Podaj liczbę zdarzeń i obserwacji cenzurowanych, mediany z krzywych, test porównania krzywych, HR z przedziałem ufności i sposób sprawdzenia założenia. Wzór do dostosowania:
Wyniki modelu przedstaw w tabeli jak w tabeli regresji logistycznej w APA, z HR w miejscu OR. Pozostałe zdania przygotuje generator opisu wyników APA. Podobne okno Categorical omawia wpis regresja logistyczna w SPSS.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresów składni KM i COXREG w Command Syntax Reference (IBM Corp., b.d.-c, b.d.-d), ale nie uruchamialiśmy jej w SPSS. Przepisy 2 i 3 w R tworzą pliki do pobrania i liczą wszystkie liczby z tabel (pakiety survival i haven).
1. Składnia SPSS: KM i COXREG
SPSS
* Składnia zgodna z Command Syntax Reference (KM, COXREG); nie była uruchamiana w SPSS.
* Krok 1. Kaplan-Meier: status 1 = zdarzenie, pozostałe kody = cenzurowane.
KM dni BY staz
  /STATUS=status EVENT(1)
  /PERCENTILES
  /PLOT=SURVIVAL
  /TEST=LOGRANK BRESLOW TARONE
  /COMPARE=OVERALL POOLED.

* Krok 2. Regresja Coxa z przedziałami 95% dla Exp(B) i zapisem reszt częściowych.
COXREG dni WITH staz srednia
  /STATUS=status EVENT(1)
  /METHOD=ENTER staz srednia
  /PRINT=DEFAULT CI(95)
  /SAVE=PRESID.

* Krok 3. Zmienna zależna od czasu: staż razy czas (T_).
TIME PROGRAM.
COMPUTE staz_t=T_*staz.
COXREG dni WITH staz srednia staz_t
  /STATUS=status EVENT(1)
  /PRINT=DEFAULT CI(95).
2. Dane i Kaplan–Meier w R
R
# B534 – Kaplan–Meier w SPSS: dane do pobrania i liczby do tabel procedury Kaplan-Meier
# Dane symulowane (fikcyjne), set.seed(534): 180 absolwentów obserwowanych przez 365 dni od obrony.
# Zdarzenie: podjęcie pierwszej pracy w zawodzie. staz: staż w czasie studiów (0 = nie, 1 = tak).
# status: 1 = podjęcie pracy (zdarzenie), 0 = koniec obserwacji bez pracy, 2 = utrata kontaktu.
suppressPackageStartupMessages({ library(survival); library(haven) })
set.seed(534)
n <- 180
staz <- rep(0:1, each = n / 2)
srednia <- round(pmin(5, pmax(3, rnorm(n, 4.0, 0.45))), 2)            # średnia ocen ze studiów
# czas do pracy z rozkładu Weibulla; staż i wyższa średnia zwiększają hazard (parametry fikcyjne)
lp <- log(1.9) * staz + log(1.6) * (srednia - 4)
czas_pracy <- (-log(runif(n)) / (0.0016 * exp(lp)))^(1 / 1.15)
czas_kontakt <- rexp(n, rate = 1 / 1500)                                # utrata kontaktu
dni <- pmin(czas_pracy, czas_kontakt, 365)
status <- ifelse(dni == czas_pracy, 1, ifelse(dni == czas_kontakt, 2, 0))
dni <- pmax(1, ceiling(dni))
dane <- data.frame(id = 1:n, staz = staz, srednia = srednia, dni = dni, status = status)

# Plik .sav z etykietami zmiennych i wartości oraz ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$staz <- labelled(sav$staz, labels = c("nie" = 0, "tak" = 1), label = "Staż w czasie studiów")
sav$srednia <- labelled(sav$srednia, label = "Średnia ocen ze studiów")
sav$dni <- labelled(sav$dni, label = "Dni od obrony do pracy lub końca obserwacji")
sav$status <- labelled(sav$status, labels = c("koniec obserwacji" = 0, "praca" = 1, "utrata kontaktu" = 2),
                       label = "Status")
write_sav(sav, "kaplan-meier-cox-spss-dane.sav")
write.csv(dane, "kaplan-meier-cox-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Case Processing Summary: zdarzenia i obserwacje cenzurowane (kody 0 i 2) w grupach
zd <- as.integer(dane$status == 1)             # Define Event: pojedyncza wartość 1
tab <- t(sapply(split(zd, dane$staz), function(z) c(N = length(z), zdarzenia = sum(z),
                cenzurowane = sum(1 - z), proc_cenz = 100 * mean(1 - z))))
print(round(rbind(tab, Total = c(n, sum(zd), sum(1 - zd), 100 * mean(1 - zd))), 1))
cat("utrata kontaktu (status 2):", sum(dane$status == 2), "; koniec obserwacji (status 0):",
    sum(dane$status == 0), "\n")
cat("powtarzające się dni zdarzeń (wiązania):", sum(duplicated(dane$dni[zd == 1])), "\n")

# Krzywe Kaplana–Meiera: mediana i kwartyle czasu (opcja Quartiles), odsetek bez pracy w dniach 90, 180, 365
km <- survfit(Surv(dni, zd) ~ staz, data = dane)
print(km)
print(quantile(km, probs = c(.25, .5, .75), conf.int = FALSE))
s <- summary(km, times = c(90, 180, 365), extend = TRUE)
print(data.frame(staz = s$strata, dzien = s$time, bez_pracy = round(s$surv, 3),
                 SE = round(s$std.err, 3), zagrozeni = s$n.risk))

# Survival Table: pierwsze wiersze dla grupy ze stażem (jeden wiersz na osobę, zdarzenia przed
# obserwacjami cenzurowanymi w tym samym dniu; przy wiązaniach odsetek dotyczy ostatniego wiersza dnia)
g1 <- dane[dane$staz == 1, ]; z1 <- zd[dane$staz == 1]
o <- order(g1$dni, -z1); g1 <- g1[o, ]; z1 <- z1[o]
km1 <- survfit(Surv(g1$dni, z1) ~ 1)
st <- data.frame(dzien = g1$dni, status = g1$status,
                 S = ifelse(z1 == 1, round(summary(km1, times = g1$dni)$surv, 3), NA),
                 SE = ifelse(z1 == 1, round(summary(km1, times = g1$dni)$std.err, 3), NA),
                 zdarzenia_skum = cumsum(z1), pozostali = nrow(g1) - seq_len(nrow(g1)))
print(head(st, 8), row.names = FALSE)

# Overall Comparisons: log-rank (wagi 1), Breslow (wagi = liczba zagrożonych),
# Tarone–Ware (wagi = pierwiastek z liczby zagrożonych); chi-kwadrat z 1 df przy dwóch grupach
porownanie <- function(czas, zdarzenie, grupa) {
  t_zd <- sort(unique(czas[zdarzenie == 1]))
  wyniki <- sapply(t_zd, function(t) {
    ryz <- czas >= t
    n_j <- sum(ryz); n1 <- sum(ryz & grupa == 1)
    d_j <- sum(czas == t & zdarzenie == 1); d1 <- sum(czas == t & zdarzenie == 1 & grupa == 1)
    c(n = n_j, OmE = d1 - d_j * n1 / n_j,
      V = if (n_j > 1) d_j * (n1 / n_j) * (1 - n1 / n_j) * (n_j - d_j) / (n_j - 1) else 0)
  })
  w <- list("Log Rank (Mantel-Cox)" = rep(1, ncol(wyniki)), "Breslow (Generalized Wilcoxon)" = wyniki["n", ],
            "Tarone-Ware" = sqrt(wyniki["n", ]))
  do.call(rbind, lapply(names(w), function(k) {
    chi <- sum(w[[k]] * wyniki["OmE", ])^2 / sum(w[[k]]^2 * wyniki["V", ])
    data.frame(test = k, chi2 = round(chi, 3), df = 1, p = signif(pchisq(chi, 1, lower.tail = FALSE), 3))
  }))
}
print(porownanie(dane$dni, zd, dane$staz), row.names = FALSE)
# kontrola: log-rank z pakietu survival (ta sama statystyka co wiersz Log Rank)
cat(sprintf("survdiff: chi2 = %.3f\n", survdiff(Surv(dni, zd) ~ staz, data = dane)$chisq))
Wynik:
        N zdarzenia cenzurowane proc_cenz
0      90        70          20      22.2
1      90        84           6       6.7
Total 180       154          26      14.4
utrata kontaktu (status 2): 18 ; koniec obserwacji (status 0): 8
powtarzające się dni zdarzeń (wiązania): 30
Call: survfit(formula = Surv(dni, zd) ~ staz, data = dane)

        n events median 0.95LCL 0.95UCL
staz=0 90     70    149     119     258
staz=1 90     84    111      94     141
       25  50  75
staz=0 61 149 309
staz=1 66 111 192
    staz dzien bez_pracy    SE zagrozeni
1 staz=0    90     0.662 0.050        57
2 staz=0   180     0.444 0.054        36
3 staz=0   365     0.126 0.040         5
4 staz=1    90     0.610 0.052        55
5 staz=1   180     0.267 0.047        23
6 staz=1   365     0.042 0.022         3
 dzien status     S    SE zdarzenia_skum pozostali
     2      1 0.989 0.011              1        89
     4      1 0.978 0.016              2        88
     7      1 0.967 0.019              3        87
    15      1 0.956 0.022              4        86
    20      1 0.944 0.024              5        85
    21      1 0.922 0.028              6        84
    21      1 0.922 0.028              7        83
    24      1 0.889 0.033              8        82
                           test  chi2 df       p
          Log Rank (Mantel-Cox) 8.719  1 0.00315
 Breslow (Generalized Wilcoxon) 3.986  1 0.04590
                    Tarone-Ware 6.391  1 0.01150
survdiff: chi2 = 8.719
3. Regresja Coxa i proporcjonalność hazardów w R
R
# B534 – regresja Coxa w SPSS: liczby do tabel procedury Cox Regression i sprawdzenie
# proporcjonalności hazardów (dane z pliku kaplan-meier-cox-spss-dane.csv, fikcyjne).
# Wiązania czasów zdarzeń: metoda Breslowa (ties = "breslow"); dla porównania metoda Efrona.
suppressPackageStartupMessages(library(survival))
dane <- read.csv("kaplan-meier-cox-spss-dane.csv")
dane$zd <- as.integer(dane$status == 1)        # Define Event: wartość 1; kody 0 i 2 = cenzurowane

# Model 0 (bez predyktorów) i model z covariates staz (0/1) i srednia, metoda Enter
m <- coxph(Surv(dni, zd) ~ staz + srednia, data = dane, ties = "breslow")
ll0 <- m$loglik[1]; ll1 <- m$loglik[2]
cat(sprintf("-2LL bez predyktorów = %.3f; -2LL modelu = %.3f\n", -2 * ll0, -2 * ll1))
p_apa <- function(p) sub("^0\\.", ".", formatC(p, format = "f", digits = 3))
cat(sprintf("Overall (score) chi2 = %.3f, df = 2, p = %s\n", m$score, p_apa(pchisq(m$score, 2, lower.tail = FALSE))))
lr <- -2 * (ll0 - ll1)
cat(sprintf("Zmiana -2LL (iloraz wiarygodności) chi2 = %.3f, df = 2, p = %s\n", lr, p_apa(pchisq(lr, 2, lower.tail = FALSE))))

# Variables in the Equation: B, SE, Wald (= z^2), df, Sig., Exp(B), 95% CI for Exp(B)
b <- coef(m); se <- sqrt(diag(vcov(m)))
vie <- data.frame(B = b, SE = se, Wald = (b / se)^2, df = 1, Sig = pchisq((b / se)^2, 1, lower.tail = FALSE),
                  ExpB = exp(b), dolna = exp(b - qnorm(.975) * se), gorna = exp(b + qnorm(.975) * se))
print(round(vie, 3))
cat("Efron dla porównania (Exp(B)):", round(exp(coef(coxph(Surv(dni, zd) ~ staz + srednia,
    data = dane, ties = "efron"))), 3), "\n")
# Gdy kategorią odniesienia jest staż = tak (1): odwrotność Exp(B) i granic przedziału
cat("Exp(B) dla 'nie' względem 'tak':", round(1 / unlist(vie["staz", c("ExpB", "gorna", "dolna")]), 3), "\n")
cat("Exp(B) dla średniej o 0.5 pkt wyższej:", round(exp(0.5 * b[["srednia"]]), 3), "\n")

# Proporcjonalność hazardów 1: zmienna zależna od czasu T_*staz (Cox w/ Time-Dep Cov),
# T_ = czas w dniach, tak jak T_ w SPSS przyjmuje wartości zmiennej czasu
m_t <- coxph(Surv(dni, zd) ~ staz + srednia + tt(staz), data = dane, ties = "breslow",
             tt = function(x, t, ...) x * t)
bt <- coef(m_t)[["tt(staz)"]]; set_ <- sqrt(vcov(m_t)["tt(staz)", "tt(staz)"])
cat(sprintf("T_COV_ (T_*staz): B = %.6f, SE = %.6f, Wald = %.3f, p = %s; Exp(B) na 100 dni = %.3f\n",
            bt, set_, (bt / set_)^2, p_apa(pchisq((bt / set_)^2, 1, lower.tail = FALSE)), exp(100 * bt)))

# Proporcjonalność hazardów 2: reszty Schoenfelda względem czasu (rysunek) i test w R
print(cox.zph(m, transform = "identity", terms = FALSE))
Wynik:
-2LL bez predyktorów = 1357.311; -2LL modelu = 1348.284
Overall (score) chi2 = 9.131, df = 2, p = .010
Zmiana -2LL (iloraz wiarygodności) chi2 = 9.027, df = 2, p = .011
            B    SE  Wald df   Sig  ExpB dolna gorna
staz    0.473 0.166 8.161  1 0.004 1.605 1.160 2.220
srednia 0.119 0.176 0.456  1 0.500 1.126 0.798 1.589
Efron dla porównania (Exp(B)): 1.606 1.125
Exp(B) dla 'nie' względem 'tak': 0.623 0.45 0.862
Exp(B) dla średniej o 0.5 pkt wyższej: 1.061
T_COV_ (T_*staz): B = 0.001341, SE = 0.001711, Wald = 0.615, p = .433; Exp(B) na 100 dni = 1.144
        chisq df    p
staz    0.617  1 0.43
srednia 1.175  1 0.28
GLOBAL  1.854  2 0.40
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2, patchwork i svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Kod braku danych w zmiennej statusu. Każdy kod spoza listy zdarzeń SPSS potraktuje jako cenzurowanie.
- Osoby cenzurowane usunięte z analizy albo czas liczony tylko dla osób ze zdarzeniem. Wtedy mediana jest zaniżona.
- Wybór testu po wynikach spośród log-rank, Breslowa i Tarone–Ware.
- Brak sprawdzenia proporcjonalności hazardów albo „sprawdzenie” wykresem LML z modelu, który to założenie już zawiera.
- Zdarzenie konkurujące traktowane jak cenzurowanie, np. wyjazd za granicę w badaniu pracy w kraju. Zob. ryzyka konkurencyjne.
- „Sig. = .000” przepisane dosłownie. Pisz p < .001.
Analizę dobierzesz w kreatorze doboru testu.
Najczęstsze pytania
Jak w SPSS zakodować obserwacje cenzurowane w zmiennej statusu?
W oknie Define Event podajesz tylko kod zdarzenia, np. 1. Każdy przypadek z nieujemnym czasem i innym kodem SPSS traktuje jako cenzurowany (IBM Corp., b.d.-c), więc 0 (koniec obserwacji) i 2 (utrata kontaktu) nie wymagają rekodowania. Uważaj na kody braków danych, np. 9 – też zostaną potraktowane jako cenzurowanie, jeśli nie zdefiniujesz ich jako braki.
Który test wybrać w Compare Factor: log-rank, Breslow czy Tarone–Ware?
Testy różnią się wagami: log-rank waży wszystkie punkty czasu równo, Breslow – liczbą zagrożonych, Tarone–Ware – jej pierwiastkiem (IBM Corp., b.d.-a). Breslow silniej reaguje na różnice na początku obserwacji. Wybierz test przed analizą, zwykle log-rank, i nie raportuj tego, który dał najmniejsze p. W przykładzie log-rank χ²(1) = 8.72, a Breslow 3.99, bo krzywe rozchodzą się dopiero po około 70 dniach.
Jak czytać Exp(B) w regresji Coxa w SPSS?
Exp(B) to iloraz hazardów: przewidywana zmiana hazardu przy wzroście predyktora o jednostkę (IBM Corp., b.d.-e). HR = 1.61 dla stażu oznacza, że w każdym dniu osoby po stażu miały 1.61 raza wyższy hazard podjęcia pracy niż osoby bez stażu o tej samej średniej ocen. Sprawdź kategorię odniesienia: w oknie Categorical domyślnie jest nią ostatnia kategoria, a wtedy ten sam wynik wyjdzie jako 0.62.
Jak w SPSS sprawdzić założenie proporcjonalnych hazardów?
Dokumentacja IBM pokazuje dwa sposoby: zapis Partial residuals w oknie Save i wykres rozrzutu reszt względem czasu (brak trendu = założenie spełnione) oraz model w Analyze → Survival → Cox w/ Time-Dep Cov z wyrażeniem T_*predyktor (IBM Corp., b.d.-e). Istotny współczynnik T_COV_ oznacza efekt zmienny w czasie. Wykres Log minus log z modelu, w którym predyktor jest kowariantem, ma linie równoległe z założenia i niczego nie sprawdza.
Dlaczego współczynnik T_COV_ w SPSS jest prawie zerowy?
Bo T_ przyjmuje wartości zmiennej czasu, a iloczyn z predyktorem bywa duży, gdy czas liczysz w dniach (IBM Corp., b.d.-e). W przykładzie B = 0.001341, czyli HR stażu zmieniałby się o czynnik 1.144 na każde 100 dni, i ta zmiana nie jest istotna (p = .433). Zwiększ liczbę miejsc po przecinku w komórce albo przeskaluj czas na miesiące.
Powiązane hasła
Przeczytaj też
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →Masz dane o czasie do zdarzenia i wydruk z SPSS, którego nie umiesz opisać?
Sprawdzimy kodowanie statusu, krzywe, test log-rank, model Coxa i założenie proporcjonalnych hazardów oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Grambsch, P. M., & Therneau, T. M. (1994). Proportional hazards tests and diagnostics based on weighted residuals. Biometrika, 81(3), 515–526. https://doi.org/10.1093/biomet/81.3.515
- IBM Corp. (b.d.-a). Kaplan-Meier Survival Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_kmei.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Cox Regression Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_coxr.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). KM. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_km.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). COXREG. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_coxreg.html ● Otwarty dostęp
- IBM Corp. (b.d.-e). Cox Regression (case studies). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/coxregression_table.html ● Otwarty dostęp
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
Cytowania BibTeX
@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{grambsch1994proportional, author={Grambsch, Patricia M. and Therneau, Terry M.}, title={{Proportional hazards tests and diagnostics based on weighted residuals}}, journal={Biometrika}, year={1994}, volume={81}, number={3}, pages={515--526}, doi={10.1093/biomet/81.3.515}}@misc{ibmndkaplanmeier31, author={{IBM Corp.}}, title={{Kaplan-Meier Survival Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_kmei.html}}@misc{ibmndcoxregression31, author={{IBM Corp.}}, title={{Cox Regression Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_coxr.html}}@misc{ibmndkmsyntax31, author={{IBM Corp.}}, title={{KM}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_km.html}}@misc{ibmndcoxregsyntax31, author={{IBM Corp.}}, title={{COXREG}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_coxreg.html}}@misc{ibmndcoxcasestudies31, author={{IBM Corp.}}, title={{Cox Regression (case studies)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/coxregression_table.html}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}