Zdarzenie konkurujące: gdy jedno zdarzenie wyklucza drugie
W klasycznej analizie przeżycia każda osoba albo doświadcza badanego zdarzenia, albo jej obserwacja zostaje ucięta. Często istnieje jednak trzecia możliwość. Ryzyko konkurujące to zdarzenie, które uniemożliwia wystąpienie zdarzenia badanego (Austin i in., 2016). Typowe przykłady:
- zgon przed nawrotem choroby – po przeszczepieniu komórek krwiotwórczych analizuje się nawrót i zgon bez nawrotu (Andersen i in., 2012);
- przeszczep przed zgonem – u osoby na liście oczekujących przeszczep kończy okres, w którym mogła umrzeć „na liście”;
- zgon przed rozpoznaniem otępienia, ponowną hospitalizacją albo powrotem do pracy.
Różnica wobec obserwacji cenzurowanej jest zasadnicza. Osoba utracona z obserwacji mogłaby jeszcze doświadczyć zdarzenia, tylko tego nie widzimy. Osoba zmarła już go nie doświadczy. Koller i in. (2012) w przeglądzie 50 badań klinicznych z czołowych czasopism znaleźli problemy z ryzykami konkurującymi w 70% artykułów.
Ten wpis rozwija krótki krok 6 z poradnika Kaplan–Meier i model Coxa krok po kroku. Tam znajdziesz przygotowanie danych, krzywe Kaplana–Meiera, test log-rank i sprawdzanie proporcjonalności hazardów. Tu skupiamy się na tym, co zmienia zdarzenie konkurujące: na szacowaniu częstości, wyborze modelu regresji i interpretacji wyników. Definicję w skrócie podaje hasło ryzyko konkurencyjne i CIF.
Przykład: otępienie i zgon u osób z MCI
W przykładzie (dane symulowane, set.seed(2204)) obserwowano kohortę 800 osób w wieku 65–85 lat z łagodnymi zaburzeniami poznawczymi (MCI). Zdarzeniem badanym jest rozpoznanie otępienia, a zdarzeniem konkurującym zgon przed tym rozpoznaniem. Predyktory to nosicielstwo allelu APOE ε4, zespół kruchości (frailty) i wiek. Dane zbudowano tak, żeby APOE ε4 zwiększało tylko hazard otępienia, a kruchość przede wszystkim hazard zgonu. Plik możesz pobrać jako CSV (kolumny id, czas w latach, zdarzenie: 0 = cenzurowanie, 1 = otępienie, 2 = zgon, apoe4, kruchosc, wiek).
| Grupa | n | Otępienie | Zgon przed otępieniem | Cenzurowanie |
|---|---|---|---|---|
| Bez zespołu kruchości | 619 | 184 | 74 | 361 |
| Zespół kruchości | 181 | 36 | 96 | 49 |
| Razem | 800 | 220 | 170 | 410 |
Mediana czasu obserwacji osób bez zdarzenia wyniosła 5.62 roku. U osób kruchych zgon zdarzał się częściej niż otępienie i tam naiwna analiza myli się najbardziej.
Dlaczego 1 − Kaplan–Meier zawyża ryzyko
Najczęstszy błąd to kodowanie zgonu jako cenzurowania i podawanie 1 − KM jako „skumulowanego ryzyka otępienia”. Estymator Kaplana–Meiera zakłada, że osoby ucięte przypominają te, które pozostają w obserwacji, i że ich zdarzenie wystąpi później. 1 − KM szacuje więc ryzyko w hipotetycznym świecie, w którym nikt nie umiera. Austin i in. (2016) podkreślają, że takie dopełnienie krzywej zawyża częstość zdarzenia niezależnie od tego, czy oba zdarzenia są od siebie niezależne. Andersen i in. (2012) wyjaśniają przyczynę: przy ryzykach konkurujących tempo zdarzeń (hazard) i ryzyko (skumulowana częstość) przestają być powiązane jednoznacznie, jak w analizie samej śmiertelności.
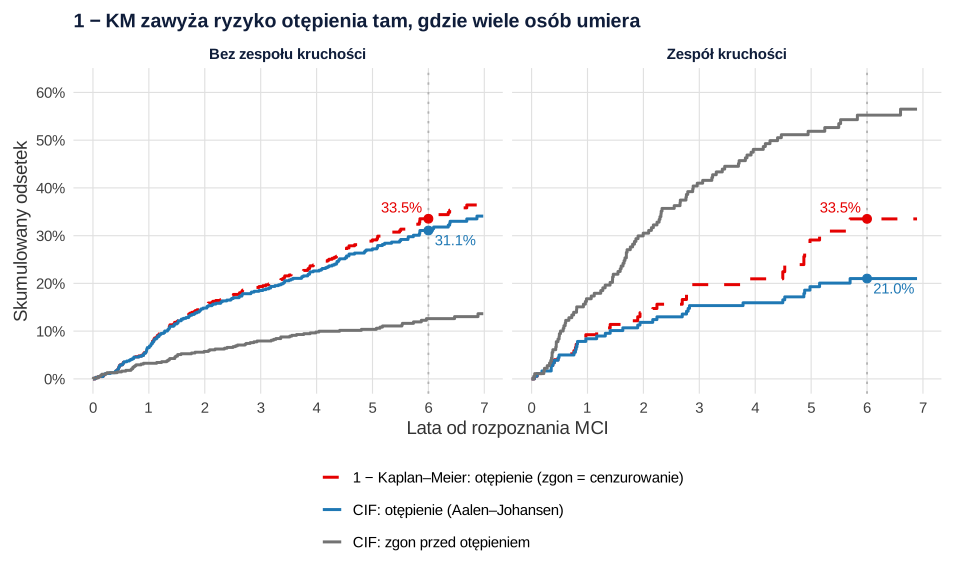
Rozbieżność rośnie z liczbą zgonów. Po 6 latach u osób bez zespołu kruchości 1 − KM daje 33.5%, a CIF 31.1%. W grupie z zespołem kruchości, gdzie przed otępieniem zmarło 55.2% osób, 1 − KM daje 33.5%, a CIF tylko 21.0%, 95% CI [15.6, 28.3]. Naiwna analiza „wyrównuje” więc ryzyko obu grup, choć w rzeczywistości otępienie rozpoznano u wyraźnie mniejszego odsetka osób kruchych.
Prosty test spójności: dodaj naiwne 1 − KM obu zdarzeń. W całej kohorcie po 6 latach to 33.5% dla otępienia i 26.5% dla zgonu, razem 60.0%. Tymczasem jakiekolwiek zdarzenie wystąpiło u 51.1% osób. Wartości CIF (28.8% i 22.3%) sumują się poprawnie. Podobny efekt w modelach predykcyjnych opisali Wolbers i in. (2009): standardowy model Coxa, który ignorował zgony z innych przyczyn, wyraźnie zawyżał 10-letnie ryzyko choroby wieńcowej u starszych kobiet.
Funkcja skumulowanej częstości (estymator Aalena–Johansena)
Funkcja skumulowanej częstości (ang. cumulative incidence function, CIF) to prawdopodobieństwo, że do czasu t wystąpi zdarzenie typu k, i to jako pierwsze. Estymator nieparametryczny, w przypadku ryzyk konkurujących równoważny estymatorowi Aalena–Johansena, sumuje w kolejnych momentach zdarzeń iloczyn dwóch części:
Tu S(tj−1) to prawdopodobieństwo uniknięcia wszystkich zdarzeń do poprzedniego momentu, dkj to liczba zdarzeń typu k w chwili tj, a nj to liczba osób w ryzyku. Zgon zmniejsza S i dlatego obniża przyszłe przyrosty CIF otępienia. CIF wszystkich zdarzeń i odsetek osób bez zdarzenia sumują się do 1.
Poza pakietem survival nie potrzebujesz niczego. Wystarczy, że status jest czynnikiem, którego pierwszy poziom oznacza cenzurowanie: survfit(Surv(czas, status) ~ kruchosc) zwraca wtedy macierz prawdopodobieństw stanów (pstate) z przedziałami ufności. Putter i in. (2007) pokazują, że takie analizy da się wykonać w standardowym oprogramowaniu, jeśli starannie przygotujesz dane.
Do porównania CIF między grupami służy test Graya (1988). Porównuje on ważone średnie hazardów podrozkładu badanego zdarzenia, czyli jest odpowiednikiem testu log-rank dla skumulowanej częstości. Test log-rank na danych ze zgonem kodowanym jako cenzurowanie porównuje coś innego: hazardy przyczynowo-specyficzne. W R test Graya liczy funkcja cuminc() z pakietu cmprsk, którego nie używamy w tym przykładzie. Zamiast testu przedstawiamy model Fine’a–Graya z przedziałami ufności.
Hazard przyczynowo-specyficzny a hazard subdystrybucyjny
W regresji masz dwie rodziny modeli, które odpowiadają na różne pytania (Austin i in., 2016; Lau i in., 2009).
Hazard przyczynowo-specyficzny (ang. cause-specific hazard) to chwilowe tempo zdarzenia typu k u osób, które jeszcze nie doświadczyły żadnego zdarzenia. Modelujesz go zwykłym modelem Coxa, w którym zdarzenie konkurujące traktujesz jako cenzurowanie: coxph(Surv(czas, zdarzenie == 1) ~ …). Zbiór ryzyka obejmuje tylko osoby żyjące i bez otępienia. Wynik to csHR, czyli iloraz hazardów w zwykłym rozumieniu.
Hazard subdystrybucyjny (ang. subdistribution hazard) zaproponowali Fine i Gray (1999), ponieważ hazard przyczynowo-specyficzny nie przekłada się bezpośrednio na prawdopodobieństwo zdarzenia. W ich modelu osoby, które doświadczyły zdarzenia konkurującego, pozostają w zbiorze ryzyka, choć badanego zdarzenia już mieć nie mogą. Dzięki temu proporcjonalne hazardy podrozkładu odpowiadają bezpośrednio przesunięciom CIF. Lau i in. (2009) pokazują, że to właśnie różna struktura zbiorów ryzyka sprawia, że parametry obu modeli interpretuje się inaczej.
W pakiecie survival model Fine’a–Graya liczysz w dwóch krokach. Funkcja finegray() przekształca dane: osoby po zgonie pozostają w nich jako kolejne przedziały czasu z wagami malejącymi według rozkładu cenzurowania. Następnie coxph() z weights = fgwt dopasowuje do nich zwykły model Coxa. W przykładzie z 800 wierszy powstało 10005, a wagi przedziałów niepełnych wynosiły od 0.09 do 1. Przy wagach niecałkowitych coxph() sam liczy odporny błąd standardowy. Dodaj cluster = id, żeby kolejne wiersze jednej osoby były traktowane jako jedna obserwacja.
Wyniki: ten sam predyktor, dwa różne ilorazy
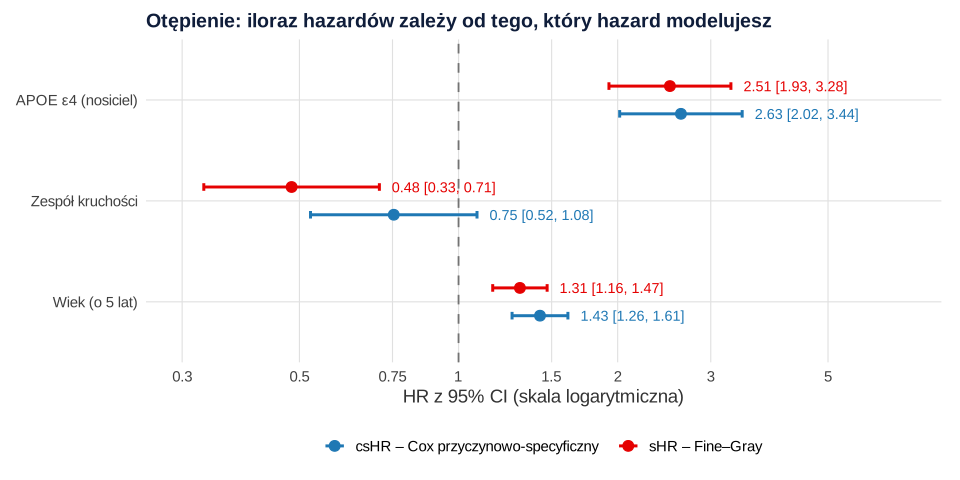
Dla APOE ε4 oba modele dają podobny wynik: csHR = 2.63, 95% CI [2.02, 3.44], i sHR = 2.51, 95% CI [1.93, 3.28]. Allel nie wiąże się ze zgonem (csHR = 1.02, 95% CI [0.73, 1.43], p = .919), więc zdarzenie konkurujące nie zmienia obrazu.
Zespół kruchości to przypadek pouczający. W modelu przyczynowo-specyficznym jego związek z otępieniem jest niepewny i obejmuje brak efektu: csHR = 0.75, 95% CI [0.52, 1.08], p = .127. W modelu Fine’a–Graya sHR = 0.48, 95% CI [0.33, 0.71], p < .001. Czy kruchość chroni przed otępieniem? Nie. Kruchość pięciokrotnie zwiększa hazard zgonu (csHR = 5.05, 95% CI [3.70, 6.90]), więc osoby kruche częściej umierają, zanim otępienie zdąży się rozwinąć. Niższa skumulowana częstość otępienia w tej grupie jest prawdziwa, ale wynika ze zgonów, a nie z ochrony. Andersen i in. (2012) opisują właśnie taką sytuację: związek zmiennej z hazardem przyczynowo-specyficznym może nie pokrywać się z jej związkiem ze skumulowaną częstością. Dlatego Latouche i in. (2013) zalecają analizować obok siebie wszystkie hazardy przyczynowo-specyficzne i wszystkie CIF.
Wiek zwiększał oba hazardy, dlatego jego sHR dla otępienia (1.31, 95% CI [1.16, 1.47]) jest niższy niż csHR (1.43, 95% CI [1.26, 1.61]). W tych danych test reszt Schoenfelda nie wskazał naruszenia proporcjonalności w modelu przyczynowo-specyficznym (globalnie p = .792), ale wskazał je w modelu Fine’a–Graya dla kruchości (p = .031) i wieku (p = .020). Przy proporcjonalnych hazardach przyczynowo-specyficznych hazardy subdystrybucyjne na ogół nie są proporcjonalne, więc sHR traktuj jako uśrednienie w okresie obserwacji.
Który model wybrać: etiologia czy predykcja
Wybór zależy od pytania, nie od „lepszego” wyniku. Austin i in. (2016) zalecają hazard przyczynowo-specyficzny do pytań etiologicznych, a model dla skumulowanej częstości do rokowania. Koller i in. (2012) uznają zgodność metody z celem badania za kluczową, zwłaszcza rozróżnienie pytań etiologicznych i prognostycznych.
| Cecha | Cox przyczynowo-specyficzny (csHR) | Fine–Gray (sHR) |
|---|---|---|
| Pytanie | Czy czynnik zmienia tempo zdarzenia u osób, które jeszcze go nie miały i żyją? | Czy czynnik zmienia odsetek osób, u których zdarzenie wystąpi do czasu t? |
| Zbiór ryzyka | osoby bez żadnego zdarzenia | osoby bez zdarzenia badanego, także po zdarzeniu konkurującym |
| Typowe zastosowanie | etiologia, mechanizm, przyczynowość | rokowanie, planowanie opieki, modele predykcyjne |
| Kiedy wynik myli | gdy z csHR wnioskujesz o bezwzględnym ryzyku | gdy sHR traktujesz jak wpływ na tempo choroby |
W badaniu etiologicznym pytanie o otępienie brzmi: czy kruchość przyspiesza neurodegenerację? Odpowiedź daje csHR. Lekarz planujący opiekę pyta inaczej: jaki odsetek kruchych pacjentów będzie wymagał opieki z powodu otępienia w ciągu 6 lat? Na to odpowiada CIF i model Fine’a–Graya. W modelach predykcyjnych Wolbers i in. (2009) pokazali, że model Fine’a–Graya i połączenie modeli przyczynowo-specyficznych dawały podobne przewidywania. Pokazali też, jak dostosować miary kalibracji i dyskryminacji do ryzyk konkurujących. W pracy etiologicznej pamiętaj ponadto o zmiennych zakłócających. Ich dobór pomaga uporządkować wpis grafy przyczynowe (DAG).
Najbezpieczniejsza praktyka to pokazać oba modele dla obu zdarzeń i wskazać, który odpowiada na główne pytanie. Liczbę predyktorów planuj według liczby zdarzeń każdego typu (zob. EPV). W przykładzie na 3 predyktory przypadało 73.3 rozpoznania otępienia.
Jak opisać analizę w stylu APA
Austin i Fine (2017) przejrzeli artykuły medyczne z 2015 roku. W wielu z nich współczynniki modelu Fine’a–Graya interpretowano niejasno albo błędnie. Wyjaśniają, że sHR opisuje względny wpływ na hazard podrozkładu, a współczynniki tego modelu można też interpretować jako wpływ na skumulowaną częstość. Praktyczna rada: wielkość efektu pokaż na CIF w wybranych punktach czasu, a nie przez zdanie „o 52% niższe ryzyko”. Wymagania wobec raportu badania obserwacyjnego omawia wpis o wytycznych STROBE, CONSORT i TRIPOD.
Tabela 1
Model hazardu przyczynowo-specyficznego i model Fine’a–Graya dla rozpoznania otępienia
| Predyktor | b | SE | HR | 95% CI | p |
|---|---|---|---|---|---|
| Hazard przyczynowo-specyficzny (csHR) | |||||
| APOE ε4 (nosiciel) | 0.97 | 0.14 | 2.63 | [2.02, 3.44] | < .001 |
| Zespół kruchości | −0.28 | 0.19 | 0.75 | [0.52, 1.08] | .127 |
| Wiek (o 5 lat) | 0.35 | 0.06 | 1.43 | [1.26, 1.61] | < .001 |
| Hazard subdystrybucyjny, Fine–Gray (sHR) | |||||
| APOE ε4 (nosiciel) | 0.92 | 0.14 | 2.51 | [1.93, 3.28] | < .001 |
| Zespół kruchości | −0.73 | 0.20 | 0.48 | [0.33, 0.71] | < .001 |
| Wiek (o 5 lat) | 0.27 | 0.06 | 1.31 | [1.16, 1.47] | < .001 |
Uwaga. N = 800, 220 rozpoznań otępienia, 170 zgonów przed otępieniem (dane symulowane). W modelu przyczynowo-specyficznym zgon traktowano jako cenzurowanie; w modelu Fine’a–Graya podano odporne błędy standardowe. Wiek wyśrodkowano na 75 latach. csHR dla zgonu: zespół kruchości 5.05, 95% CI [3.70, 6.90]. HR = iloraz hazardów.
Wzór opisu metod i wyników:
Gotowe układy innych tabel znajdziesz we wpisie tabele APA – wzory, a wymagania czasopism klinicznych w poradniku statystyka w publikacji medycznej. Jeśli recenzent pyta, dlaczego nie użyłeś(-aś) modelu Fine’a–Graya, albo wyniki obu modeli się rozchodzą, możemy wspólnie przejrzeć analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Jeden przepis tworzy dane, zapisuje plik ryzyka-konkurencyjne-dane.csv (możesz go pobrać tutaj) i liczy wszystkie wyniki z tekstu. Wystarcza pakiet survival; pakiet cmprsk nie jest potrzebny.
1. CIF, 1 − KM, model przyczynowo-specyficzny i Fine–Gray
R
# Dane symulowane: kohorta 800 osób po 65. roku życia z łagodnymi zaburzeniami poznawczymi (MCI)
# Zdarzenie badane: rozpoznanie otępienia; zdarzenie konkurujące: zgon przed rozpoznaniem otępienia
library(survival)
set.seed(2204)
n <- 800
wiek <- round(runif(n, 65, 85))
apoe4 <- rbinom(n, 1, .30)                         # nosicielstwo allelu APOE ε4
kruchosc <- rbinom(n, 1, plogis(-1.1 + 0.08 * (wiek - 75)))   # zespół kruchości (frailty)
wiek5 <- (wiek - 75) / 5                           # wiek w jednostkach 5 lat, wyśrodkowany na 75 latach
# hazardy przyczynowo-specyficzne (na rok): APOE ε4 zwiększa tylko hazard otępienia, kruchość – głównie hazard zgonu
h_otep <- 0.055 * exp(log(2.0) * apoe4 + log(1.1) * kruchosc + log(1.35) * wiek5)
h_zgon <- 0.030 * exp(log(1.0) * apoe4 + log(4) * kruchosc + log(1.6) * wiek5)
t_otep <- rexp(n, h_otep); t_zgon <- rexp(n, h_zgon)
t_cenz <- pmin(runif(n, 4, 8), rexp(n, 0.02))      # koniec badania po 4–8 latach albo utrata z obserwacji
czas <- pmin(t_otep, t_zgon, t_cenz)
zdarzenie <- ifelse(czas == t_cenz, 0, ifelse(czas == t_otep, 1, 2))
dane <- data.frame(id = 1:n, czas = round(czas, 3), zdarzenie, apoe4, kruchosc, wiek)
dane$status <- factor(dane$zdarzenie, 0:2, c("cenzurowanie", "otepienie", "zgon"))   # pierwszy poziom = cenzurowanie
dane$wiek5 <- (dane$wiek - 75) / 5
write.csv(dane[, c("id", "czas", "zdarzenie", "apoe4", "kruchosc", "wiek")], "ryzyka-konkurencyjne-dane.csv", row.names = FALSE)

# Liczba zdarzeń ogółem i według kruchości
table(dane$status)
table(kruchosc = dane$kruchosc, dane$status)
round(median(dane$czas[dane$zdarzenie == 0]), 2)

# 1. Naiwne 1 − KM (zgon = cenzurowanie) a skumulowana częstość (Aalen–Johansen)
km_otep <- survfit(Surv(czas, zdarzenie == 1) ~ kruchosc, data = dane)
aj <- survfit(Surv(czas, status) ~ kruchosc, data = dane)   # czynnik w Surv() = estymator Aalena–Johansena
lata <- c(2, 4, 6)
s_km <- summary(km_otep, times = lata)
s_aj <- summary(aj, times = lata)
porownanie <- data.frame(kruchosc = rep(0:1, each = 3), lata = rep(lata, 2),
                         km_1_minus = 1 - s_km$surv,
                         cif_otep = s_aj$pstate[, "otepienie"],
                         cif_otep_lo = s_aj$lower[, "otepienie"], cif_otep_hi = s_aj$upper[, "otepienie"],
                         cif_zgon = s_aj$pstate[, "zgon"])
porownanie$zawyzenie <- porownanie$km_1_minus - porownanie$cif_otep
print(round(porownanie, 3), row.names = FALSE)

# Suma naiwnych 1 − KM dla obu przyczyn przekracza odsetek osób z jakimkolwiek zdarzeniem (cała kohorta, 6 lat)
km_o <- summary(survfit(Surv(czas, zdarzenie == 1) ~ 1, data = dane), times = 6)$surv
km_z <- summary(survfit(Surv(czas, zdarzenie == 2) ~ 1, data = dane), times = 6)$surv
km_dowolne <- summary(survfit(Surv(czas, zdarzenie > 0) ~ 1, data = dane), times = 6)$surv
aj_cala <- summary(survfit(Surv(czas, status) ~ 1, data = dane), times = 6)$pstate
round(c(km_otep = 1 - km_o, km_zgon = 1 - km_z, suma_km = 2 - km_o - km_z,
        dowolne_zdarzenie = 1 - km_dowolne, cif_otep = aj_cala[, 2], cif_zgon = aj_cala[, 3]), 3)

# 2. Hazard przyczynowo-specyficzny: Cox dla otępienia (zgon = cenzurowanie) i dla zgonu (otępienie = cenzurowanie)
cs_otep <- coxph(Surv(czas, zdarzenie == 1) ~ apoe4 + kruchosc + wiek5, data = dane)
cs_zgon <- coxph(Surv(czas, zdarzenie == 2) ~ apoe4 + kruchosc + wiek5, data = dane)

# 3. Hazard subdystrybucyjny (Fine–Gray): finegray() tworzy dane z wagami, coxph() je modeluje
fg_dane <- finegray(Surv(czas, status) ~ ., data = dane, etype = "otepienie", id = id)
fg_otep <- coxph(Surv(fgstart, fgstop, fgstatus) ~ apoe4 + kruchosc + wiek5, weights = fgwt, cluster = id, data = fg_dane)
fg_dane_z <- finegray(Surv(czas, status) ~ ., data = dane, etype = "zgon", id = id)
fg_zgon <- coxph(Surv(fgstart, fgstop, fgstatus) ~ apoe4 + kruchosc + wiek5, weights = fgwt, cluster = id, data = fg_dane_z)
c(wiersze_dane = nrow(dane), wiersze_finegray = nrow(fg_dane))

tabela_hr <- function(m, model) {
  s <- summary(m)$coefficients; ci <- summary(m)$conf.int
  data.frame(model = model, zmienna = rownames(s), b = s[, "coef"], SE = s[, ncol(s) - 2],
             HR = ci[, "exp(coef)"], dolny = ci[, "lower .95"], gorny = ci[, "upper .95"], p = s[, ncol(s)])
}
wyniki <- rbind(tabela_hr(cs_otep, "csHR otepienie"), tabela_hr(fg_otep, "sHR otepienie"),
                tabela_hr(cs_zgon, "csHR zgon"), tabela_hr(fg_zgon, "sHR zgon"))
print(cbind(wyniki[1:2], round(wyniki[3:8], 3)), row.names = FALSE)

# Zdarzenia na predyktor i proporcjonalność hazardów w obu modelach dla otępienia
sum(dane$zdarzenie == 1) / 3
cox.zph(cs_otep)$table[, "p"]
cox.zph(fg_otep)$table[, "p"]
Wynik w R
cenzurowanie    otepienie         zgon
         410          220          170

kruchosc cenzurowanie otepienie zgon
       0          361       184   74
       1           49        36   96
[1] 5.62
 kruchosc lata km_1_minus cif_otep cif_otep_lo cif_otep_hi cif_zgon zawyzenie
        0    2      0.154    0.148       0.123       0.179    0.058     0.005
        0    4      0.239    0.226       0.195       0.262    0.098     0.013
        0    6      0.335    0.311       0.274       0.353    0.126     0.025
        1    2      0.139    0.118       0.079       0.177    0.305     0.020
        1    4      0.210    0.159       0.113       0.224    0.481     0.050
        1    6      0.335    0.210       0.156       0.283    0.552     0.125
           km_otep            km_zgon            suma_km  dowolne_zdarzenie
             0.335              0.265              0.600              0.511
cif_otep.otepienie      cif_zgon.zgon
             0.288              0.223
    wiersze_dane wiersze_finegray
             800            10005
          model  zmienna      b    SE    HR dolny gorny     p
 csHR otepienie    apoe4  0.969 0.136 2.635 2.018 3.440 0.000
 csHR otepienie kruchosc -0.282 0.185 0.754 0.525 1.084 0.127
 csHR otepienie    wiek5  0.355 0.062 1.426 1.263 1.610 0.000
  sHR otepienie    apoe4  0.921 0.136 2.511 1.925 3.275 0.000
  sHR otepienie kruchosc -0.727 0.195 0.483 0.330 0.708 0.000
  sHR otepienie    wiek5  0.267 0.060 1.306 1.160 1.471 0.000
      csHR zgon    apoe4  0.018 0.173 1.018 0.725 1.428 0.919
      csHR zgon kruchosc  1.620 0.159 5.053 3.701 6.899 0.000
      csHR zgon    wiek5  0.528 0.078 1.696 1.457 1.974 0.000
       sHR zgon    apoe4 -0.125 0.172 0.882 0.630 1.236 0.466
       sHR zgon kruchosc  1.609 0.159 4.999 3.659 6.830 0.000
       sHR zgon    wiek5  0.414 0.077 1.513 1.302 1.758 0.000
[1] 73.33333
    apoe4  kruchosc     wiek5    GLOBAL
0.8895072 0.8881160 0.3105383 0.7915688
     apoe4   kruchosc      wiek5     GLOBAL
0.97371794 0.03090158 0.01951826 0.03721205
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: survfit(), coxph(), finegray(), cox.zph()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- 1 − KM jako ryzyko zdarzenia przy zdarzeniu konkurującym. Zawyża częstość, tym bardziej, im więcej zgonów. Podawaj CIF.
- „Kruchość chroni przed otępieniem”. sHR < 1 może wynikać wyłącznie z częstszego zdarzenia konkurującego. Sprawdź csHR obu zdarzeń, zanim napiszesz zdanie o mechanizmie.
- Interpretacja sHR jak ryzyka względnego. sHR = 0.48 nie oznacza o połowę mniejszego odsetka. Odsetki odczytaj z CIF.
- Tylko jeden model dla jednego zdarzenia. Bez wyników dla zdarzenia konkurującego czytelnik nie odróżni efektu od „podkradania” osób przez zgon (Latouche i in., 2013).
- Test log-rank jako porównanie CIF. Log-rank przy zgonie kodowanym jako cenzurowanie porównuje hazardy przyczynowo-specyficzne. Do CIF służy test Graya.
- Utrata z obserwacji kodowana jak zgon albo zgon jak utrata. To dwa różne kody. Wpisz je do planu analizy przed obejrzeniem danych.
- Brak analizy wrażliwości przy niepewnej przyczynie zgonu albo różnych definicjach zdarzenia konkurującego.
Najczęstsze pytania
Czym różni się zdarzenie konkurujące od obserwacji cenzurowanej?
Osoba z obserwacją cenzurowaną mogłaby jeszcze doświadczyć zdarzenia – po prostu nie widzimy jej dalszych losów. Po zdarzeniu konkurującym, np. zgonie przed nawrotem, zdarzenie badane nie może już wystąpić. Traktowanie zgonu jak cenzurowania jest dopuszczalne w modelu przyczynowo-specyficznym, ale nie przy szacowaniu skumulowanego ryzyka, bo 1 − Kaplan–Meier je wtedy zawyża.
Kiedy użyć modelu Fine’a–Graya, a kiedy modelu Coxa przyczynowo-specyficznego?
Model Coxa dla hazardu przyczynowo-specyficznego odpowiada na pytanie etiologiczne: czy czynnik zmienia tempo zdarzenia u osób, które żyją i jeszcze go nie miały. Model Fine’a–Graya odpowiada na pytanie prognostyczne: czy czynnik zmienia odsetek osób, u których zdarzenie wystąpi do danego czasu. W artykule najlepiej pokazać oba modele dla zdarzenia badanego i konkurującego.
Jak policzyć model Fine’a–Graya w R bez pakietu cmprsk?
W pakiecie survival najpierw przekształć dane funkcją finegray(Surv(czas, status) ~ ., data, etype = "zdarzenie"), gdzie status jest czynnikiem z cenzurowaniem jako pierwszym poziomem. Potem dopasuj coxph(Surv(fgstart, fgstop, fgstatus) ~ predyktory, weights = fgwt, cluster = id). Skumulowaną częstość policzysz funkcją survfit() na tym samym czynniku statusu.
Jak interpretować subdystrybucyjny iloraz hazardów (sHR)?
sHR opisuje względny wpływ zmiennej na hazard podrozkładu, a jego kierunek mówi, czy skumulowana częstość zdarzenia jest wyższa, czy niższa. Nie jest to ryzyko względne ani miara wpływu na tempo choroby. sHR < 1 może wynikać wyłącznie z tego, że czynnik zwiększa ryzyko zdarzenia konkurującego, dlatego zawsze sprawdź csHR obu zdarzeń i podaj odsetki z CIF.
Czy skumulowaną częstość można porównać testem log-rank?
Nie. Test log-rank przy zdarzeniu konkurującym kodowanym jako cenzurowanie porównuje hazardy przyczynowo-specyficzne, a nie skumulowaną częstość. Do porównania CIF między grupami służy test Graya (funkcja cuminc() w pakiecie cmprsk). Bez tego pakietu możesz podać sHR z modelu Fine’a–Graya z przedziałem ufności.
Powiązane hasła
Przeczytaj też
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →Masz zdarzenie konkurujące i nie wiesz, który model wybrać?
Pomożemy zakodować zdarzenia, policzyć CIF, model przyczynowo-specyficzny i Fine–Gray oraz wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Andersen, P. K., Geskus, R. B., de Witte, T., & Putter, H. (2012). Competing risks in epidemiology: Possibilities and pitfalls. International Journal of Epidemiology, 41(3), 861–870. https://doi.org/10.1093/ije/dyr213 ● Otwarty dostęp
- Austin, P. C., & Fine, J. P. (2017). Practical recommendations for reporting Fine-Gray model analyses for competing risk data. Statistics in Medicine, 36(27), 4391–4400. https://doi.org/10.1002/sim.7501 ● Otwarty dostęp
- Austin, P. C., Lee, D. S., & Fine, J. P. (2016). Introduction to the analysis of survival data in the presence of competing risks. Circulation, 133(6), 601–609. https://doi.org/10.1161/circulationaha.115.017719 ● Otwarty dostęp: pełny tekst
- Fine, J. P., & Gray, R. J. (1999). A proportional hazards model for the subdistribution of a competing risk. Journal of the American Statistical Association, 94(446), 496–509. https://doi.org/10.1080/01621459.1999.10474144
- Gray, R. J. (1988). A class of K-sample tests for comparing the cumulative incidence of a competing risk. The Annals of Statistics, 16(3), 1141–1154. https://doi.org/10.1214/aos/1176350951 ● Otwarty dostęp
- Koller, M. T., Raatz, H., Steyerberg, E. W., & Wolbers, M. (2012). Competing risks and the clinical community: Irrelevance or ignorance? Statistics in Medicine, 31(11–12), 1089–1097. https://doi.org/10.1002/sim.4384 ● Otwarty dostęp
- Latouche, A., Allignol, A., Beyersmann, J., Labopin, M., & Fine, J. P. (2013). A competing risks analysis should report results on all cause-specific hazards and cumulative incidence functions. Journal of Clinical Epidemiology, 66(6), 648–653. https://doi.org/10.1016/j.jclinepi.2012.09.017 ● Otwarty dostęp: pełny tekst
- Lau, B., Cole, S. R., & Gange, S. J. (2009). Competing risk regression models for epidemiologic data. American Journal of Epidemiology, 170(2), 244–256. https://doi.org/10.1093/aje/kwp107 ● Otwarty dostęp
- Putter, H., Fiocco, M., & Geskus, R. B. (2007). Tutorial in biostatistics: Competing risks and multi-state models. Statistics in Medicine, 26(11), 2389–2430. https://doi.org/10.1002/sim.2712
- Wolbers, M., Koller, M. T., Witteman, J. C. M., & Steyerberg, E. W. (2009). Prognostic models with competing risks: Methods and application to coronary risk prediction. Epidemiology, 20(4), 555–561. https://doi.org/10.1097/ede.0b013e3181a39056
Cytowania BibTeX
@article{andersen2012competing, author={Andersen, Per Kragh and Geskus, Ronald B. and de Witte, Theo and Putter, Hein}, title={{Competing risks in epidemiology: Possibilities and pitfalls}}, journal={International Journal of Epidemiology}, year={2012}, volume={41}, number={3}, pages={861--870}, doi={10.1093/ije/dyr213}}@article{austin2017practical, author={Austin, Peter C. and Fine, Jason P.}, title={{Practical recommendations for reporting Fine-Gray model analyses for competing risk data}}, journal={Statistics in Medicine}, year={2017}, volume={36}, number={27}, pages={4391--4400}, doi={10.1002/sim.7501}}@article{austin2016introduction, author={Austin, Peter C. and Lee, Douglas S. and Fine, Jason P.}, title={{Introduction to the analysis of survival data in the presence of competing risks}}, journal={Circulation}, year={2016}, volume={133}, number={6}, pages={601--609}, doi={10.1161/circulationaha.115.017719}}@article{fine1999proportional, author={Fine, Jason P. and Gray, Robert J.}, title={{A proportional hazards model for the subdistribution of a competing risk}}, journal={Journal of the American Statistical Association}, year={1999}, volume={94}, number={446}, pages={496--509}, doi={10.1080/01621459.1999.10474144}}@article{gray1988class, author={Gray, Robert J.}, title={{A class of K-sample tests for comparing the cumulative incidence of a competing risk}}, journal={The Annals of Statistics}, year={1988}, volume={16}, number={3}, pages={1141--1154}, doi={10.1214/aos/1176350951}}@article{koller2012competing, author={Koller, Michael T. and Raatz, Heike and Steyerberg, Ewout W. and Wolbers, Marcel}, title={{Competing risks and the clinical community: Irrelevance or ignorance?}}, journal={Statistics in Medicine}, year={2012}, volume={31}, number={11–12}, pages={1089--1097}, doi={10.1002/sim.4384}}@article{latouche2013competing, author={Latouche, Aurélien and Allignol, Arthur and Beyersmann, Jan and Labopin, Myriam and Fine, Jason P.}, title={{A competing risks analysis should report results on all cause-specific hazards and cumulative incidence functions}}, journal={Journal of Clinical Epidemiology}, year={2013}, volume={66}, number={6}, pages={648--653}, doi={10.1016/j.jclinepi.2012.09.017}}@article{lau2009competing, author={Lau, Bryan and Cole, Stephen R. and Gange, Stephen J.}, title={{Competing risk regression models for epidemiologic data}}, journal={American Journal of Epidemiology}, year={2009}, volume={170}, number={2}, pages={244--256}, doi={10.1093/aje/kwp107}}@article{putter2007tutorial, author={Putter, Hein and Fiocco, Marta and Geskus, Ronald B.}, title={{Tutorial in biostatistics: Competing risks and multi-state models}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={11}, pages={2389--2430}, doi={10.1002/sim.2712}}@article{wolbers2009prognostic, author={Wolbers, Marcel and Koller, Michael T. and Witteman, Jacqueline C. M. and Steyerberg, Ewout W.}, title={{Prognostic models with competing risks: Methods and application to coronary risk prediction}}, journal={Epidemiology}, year={2009}, volume={20}, number={4}, pages={555--561}, doi={10.1097/ede.0b013e3181a39056}}