Co to jest błąd czasu nieśmiertelnego?
Błąd czasu nieśmiertelnego (ang. immortal time bias) powstaje w badaniu kohortowym, gdy część czasu obserwacji to okres, w którym badane zdarzenie z definicji nie mogło wystąpić. Typowy przykład: za „leczonych” uznajemy osoby, które kiedykolwiek wykupiły receptę, i liczymy ich czas od wejścia do kohorty. Aby wykupić receptę, trzeba dożyć tego dnia, więc czas przed receptą jest „nieśmiertelny”. Suissa (2008) pokazał, że w badaniach leków daje to pozornie skrajną skuteczność, a obciążenie rośnie z długością błędnie przypisanego czasu.
Przykład w R
W symulacji 5000 osób lek nie ma żadnego wpływu na zgon (prawdziwe HR = 1), a 42.5% osób dostaje receptę w ciągu 5 lat. Gdy ekspozycję przypiszemy od początku obserwacji, model Coxa daje HR = 0.40 – lek „zmniejsza” ryzyko zgonu o 60%. Gdy czas przed receptą liczymy jako nieleczony, HR = 1.01 (95% CI 0.91–1.12), czyli brak efektu.
Na rysunku
Rysunek pokazuje dane z przykładu (5000 osób, lek bez żadnego wpływu na zgon) z dwóch stron: jak wygląda czas obserwacji pojedynczych osób i ile zgonów przypada na osobolata leczonych i nieleczonych przy obu sposobach liczenia czasu.
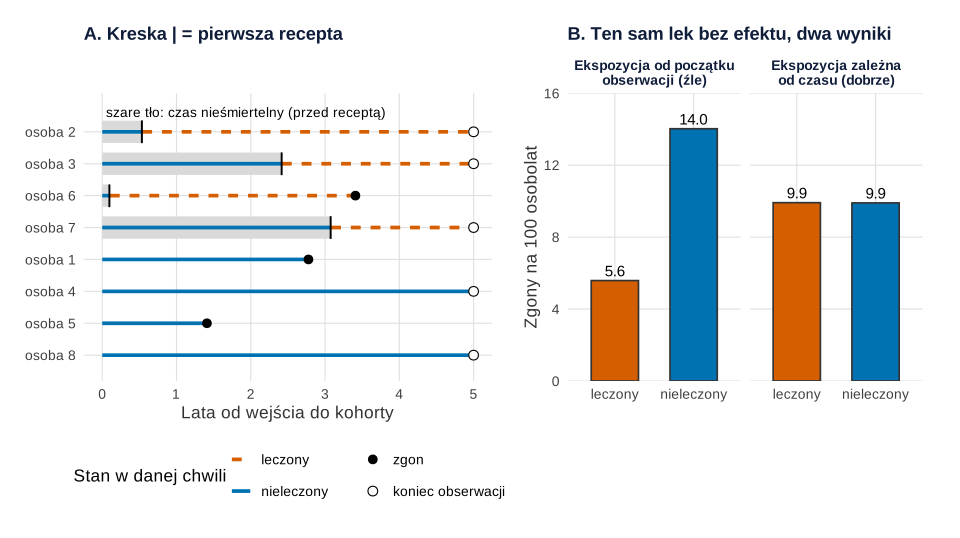
set.seed(533)).Co widać. W panelu A pokazano pierwsze cztery osoby leczone i pierwsze cztery nieleczone według numeru w zbiorze, bez wybierania. Szare tło to czas od wejścia do kohorty do pierwszej recepty: nikt nie mógł w nim umrzeć jako „leczony”, bo zgon przed receptą oznaczałby przejście do grupy nieleczonych. Przy ekspozycji przypisanej od początku obserwacji ten okres trafia do leczonych, którzy mają wtedy 9618 osobolat i 537 zgonów, czyli 5.6 zgonu na 100 osobolat, wobec 14.0 u nieleczonych (iloraz 0.4, tyle co HR = 0.40 z przykładu). Gdy czas przed receptą przypisać nieleczonym, osobolata leczonych spadają do 5416, a częstość zgonów w obu stanach wynosi 9.9 na 100 osobolat (iloraz 1.0). Liczba zgonów się nie zmienia – przesuwa się tylko mianownik.
Na co uważać. Iloraz częstości z panelu B jest tu bliski HR z modelu Coxa, bo hazard w symulacji jest stały w czasie; przy hazardzie zmiennym liczbę podaje dopiero model ze zmienną zależną od czasu. Osiem osób z panelu A to ilustracja mechanizmu, a nie próba do wnioskowania. Rysunek nie pokazuje też innych źródeł obciążenia w danych obserwacyjnych, np. tego, że lek dostają osoby zdrowsze albo bardziej chore – to zakłócanie, którego zmienna zależna od czasu nie usuwa.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Czas nieśmiertelny: oś czasu ośmiu osób i częstość zgonów przy dwóch sposobach liczenia czasu
library(ggplot2)
library(patchwork)

kol <- c(nieleczony = "#0072B2", leczony = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(533)                                   # te same dane co w przykładzie w haśle
n <- 5000
t_zgon <- rexp(n, rate = 0.10)                  # czas do zgonu (lata), niezależny od leku
t_recepta <- rexp(n, rate = 0.15)               # czas do pierwszej recepty
koniec <- pmin(t_zgon, 5)                       # obserwacja do 5 lat
zgon <- as.numeric(t_zgon <= 5)
lek <- as.numeric(t_recepta < koniec)           # "kiedykolwiek leczeni"

# A: pierwsze 4 osoby leczone i pierwsze 4 nieleczone (kolejność numerów, bez wybierania)
ktore <- c(head(which(lek == 1), 4), head(which(lek == 0), 4))
os <- data.frame(id = ktore, wiersz = 8:1, koniec = koniec[ktore], zgon = zgon[ktore],
                 rec = ifelse(lek[ktore] == 1, t_recepta[ktore], NA))
odc <- rbind(
  data.frame(wiersz = os$wiersz, od = 0, do = ifelse(is.na(os$rec), os$koniec, os$rec), stan = "nieleczony"),
  data.frame(wiersz = os$wiersz, od = os$rec, do = os$koniec, stan = "leczony")[!is.na(os$rec), ])
konce <- data.frame(wiersz = os$wiersz, x = os$koniec,
                    typ = factor(ifelse(os$zgon == 1, "zgon", "koniec obserwacji"), c("zgon", "koniec obserwacji")))
pA <- ggplot() +
  annotate("rect", xmin = 0, xmax = os$rec[1:4], ymin = os$wiersz[1:4] - 0.35, ymax = os$wiersz[1:4] + 0.35,
           fill = "grey85") +
  geom_segment(data = odc, aes(x = od, xend = do, y = wiersz, yend = wiersz, colour = stan, linetype = stan),
               linewidth = 1.3) +
  geom_point(data = os[!is.na(os$rec), ], aes(rec, wiersz), shape = 124, size = 6) +
  geom_point(data = konce, aes(x, wiersz, shape = typ), size = 3, fill = "white") +
  annotate("text", x = 0.05, y = 8.62, label = "szare tło: czas nieśmiertelny (przed receptą)", hjust = 0, size = 3.6) +
  scale_colour_manual("Stan w danej chwili", values = kol) +
  scale_linetype_manual("Stan w danej chwili", values = c(nieleczony = "solid", leczony = "22")) +
  scale_shape_manual(NULL, values = c(zgon = 16, "koniec obserwacji" = 21)) +
  scale_y_continuous(NULL, breaks = os$wiersz, labels = paste("osoba", os$id), limits = c(0.6, 8.8)) +
  scale_x_continuous("Lata od wejścia do kohorty", limits = c(0, 5)) +
  labs(title = "A. Kreska | = pierwsza recepta") +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))

# B: zgony na 100 osobolat – czas przed receptą przypisany leczonym (źle) albo nieleczonym (dobrze)
osobolata <- function(czas, zd) c(zgony = sum(zd), osobolata = sum(czas))
zle_l <- osobolata(koniec[lek == 1], zgon[lek == 1])
zle_n <- osobolata(koniec[lek == 0], zgon[lek == 0])
dobrze_l <- osobolata(koniec[lek == 1] - t_recepta[lek == 1], zgon[lek == 1])
dobrze_n <- osobolata(c(koniec[lek == 0], t_recepta[lek == 1]), c(zgon[lek == 0], rep(0, sum(lek))))
tab <- data.frame(analiza = rep(c("Ekspozycja od początku\nobserwacji (źle)", "Ekspozycja zależna\nod czasu (dobrze)"), each = 2),
                  stan = rep(c("leczony", "nieleczony"), 2),
                  rbind(zle_l, zle_n, dobrze_l, dobrze_n), row.names = NULL)
tab$na_100 <- 100 * tab$zgony / tab$osobolata
tab$analiza <- factor(tab$analiza, unique(tab$analiza))
print(transform(tab, osobolata = round(osobolata), na_100 = round(na_100, 2)))
round(c(iloraz_zle = tab$na_100[1] / tab$na_100[2], iloraz_dobrze = tab$na_100[3] / tab$na_100[4]), 2)

pB <- ggplot(tab, aes(stan, na_100, fill = stan)) +
  geom_col(width = 0.6, colour = "grey20") +
  geom_text(aes(label = sprintf("%.1f", na_100)), vjust = -0.4, size = 4) +
  facet_wrap(~ analiza) +
  scale_fill_manual(NULL, values = kol, guide = "none") +
  scale_y_continuous("Zgony na 100 osobolat", limits = c(0, 16), expand = c(0, 0)) +
  labs(x = NULL, title = "B. Ten sam lek bez efektu, dwa wyniki")

p1 <- (pA | pB) + plot_layout(widths = c(1.15, 1)) & motyw
p1
Wynik w R
                                   analiza       stan zgony osobolata na_100
1 Ekspozycja od początku\nobserwacji (źle)    leczony   537      9618   5.58
2 Ekspozycja od początku\nobserwacji (źle) nieleczony  1415     10089  14.03
3    Ekspozycja zależna\nod czasu (dobrze)    leczony   537      5416   9.91
4    Ekspozycja zależna\nod czasu (dobrze) nieleczony  1415     14290   9.90
   iloraz_zle iloraz_dobrze
          0.4           1.0
Jak go uniknąć
- Traktuj leczenie jako zmienną zależną od czasu: osoba jest nieleczona do dnia rozpoczęcia leczenia.
- Albo użyj analizy landmark: ekspozycję ustal w wybranym punkcie, a obserwację zacznij od niego.
- Zrównaj początek obserwacji, kwalifikację i przypisanie leczenia jak w badaniu randomizowanym. Hernán i in. (2016) pokazują, że opisanie docelowego badania (target trial) zapobiega temu błędowi.
Lévesque i in. (2010) podkreślają, że błąd ten zawyża korzyść leczenia, ale łatwo go rozpoznać i uniknąć.
Czym różni się od błędu przeżywalności
Błąd przeżywalności dotyczy tego, kogo widzimy w danych: analizujemy tylko tych, którzy przetrwali selekcję. Błąd czasu nieśmiertelnego dotyczy tego, jak liczymy czas osób już obecnych w kohorcie – pomylone jest przypisanie okresu obserwacji do grup, a nie skład próby. Praktyczny przegląd modeli przeżycia znajdziesz we wpisie Kaplan–Meier i model Coxa krok po kroku.
Jak opisać w pracy
Na co uważać
Błąd pojawia się też przy wykluczeniu czasu przed ekspozycją z analizy oraz przy definicjach typu „co najmniej dwie recepty”. Sprawdź, czy od grupy leczonej nie wymaga się warunku (np. dożycia do recepty), którego nie stawia się grupie porównawczej.
Błąd czasu nieśmiertelnego w R
Kod symuluje kohortę, w której lek nie wpływa na zgon, i porównuje model Coxa z ekspozycją przypisaną od początku obserwacji z modelem, w którym leczenie zmienia się w czasie (tmerge(), tdc()).
Ekspozycja stała a zależna od czasu
R
# Błąd czasu nieśmiertelnego: lek bez żadnego efektu (prawdziwe HR = 1)
library(survival)
set.seed(533)
n <- 5000
t_zgon <- rexp(n, rate = 0.10)          # czas do zgonu (lata), niezależny od leku
t_recepta <- rexp(n, rate = 0.15)       # czas do pierwszej recepty
koniec <- pmin(t_zgon, 5)               # obserwacja do 5 lat
zgon <- as.numeric(t_zgon <= 5)
lek <- as.numeric(t_recepta < koniec)   # "kiedykolwiek leczeni" w okresie obserwacji
d <- data.frame(id = 1:n, koniec, zgon, lek, t_recepta)
# Źle: ekspozycja przypisana od początku obserwacji
zle <- coxph(Surv(koniec, zgon) ~ lek, data = d)
# Dobrze: czas przed receptą liczony jako nieleczony (ekspozycja zależna od czasu)
d2 <- tmerge(d[, c("id", "koniec", "zgon")], d[, c("id", "koniec", "zgon")],
             id = id, smierc = event(koniec, zgon))
d2 <- tmerge(d2, d, id = id, leczony = tdc(ifelse(lek == 1, t_recepta, NA)))
dobrze <- coxph(Surv(tstart, tstop, smierc) ~ leczony, data = d2)
round(c(odsetek_leczonych = mean(lek),
        HR_zle = unname(exp(coef(zle))), HR_dobrze = unname(exp(coef(dobrze)))), 3)
round(exp(confint(dobrze)), 3)
Wynik w R
odsetek_leczonych            HR_zle         HR_dobrze
            0.425             0.397             1.007
        2.5 % 97.5 %
leczony 0.906   1.12
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: coxph(), tmerge(); rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego błąd czasu nieśmiertelnego zawsze faworyzuje leczenie?
Grupa leczona dostaje „gratis” okres, w którym nikt nie mógł umrzeć, bo musiał dożyć rozpoczęcia leczenia. Zdarzeń jest w niej mniej na osobę-czas, więc HR spada poniżej rzeczywistego.
Czy wykluczenie czasu przed receptą rozwiązuje problem czasu nieśmiertelnego?
Nie. Usunięcie tego okresu tylko z grupy leczonej nadal zaburza porównanie. Poprawnie jest przypisać go grupie nieleczonej (ekspozycja zależna od czasu) albo zacząć obserwację wszystkich od wspólnego punktu.
Jak sprawdzić, czy moje badanie kohortowe ma czas nieśmiertelny?
Zapytaj, czy przynależność do grupy leczonej wymaga przeżycia lub pozostania w obserwacji przez jakiś czas od jej początku. Jeśli tak, a obserwacja zaczyna się wcześniej, czas nieśmiertelny istnieje.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikEmulacja badania docelowego krok po kroku
Tabela protokołu, punkt zero, klonowanie–cenzurowanie–ważenie i ważone krzywe przeżycia w R – na kohorcie, w której znamy prawdziwy efekt.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hernán, M. A., Sauer, B. C., Hernández-Díaz, S., Platt, R., & Shrier, I. (2016). Specifying a target trial prevents immortal time bias and other self-inflicted injuries in observational analyses. Journal of Clinical Epidemiology, 79, 70–75. https://doi.org/10.1016/j.jclinepi.2016.04.014 ● Otwarty dostęp: pełny tekst
- Lévesque, L. E., Hanley, J. A., Kezouh, A., & Suissa, S. (2010). Problem of immortal time bias in cohort studies: Example using statins for preventing progression of diabetes. BMJ, 340, Article b5087. https://doi.org/10.1136/bmj.b5087
- Suissa, S. (2008). Immortal time bias in pharmacoepidemiology. American Journal of Epidemiology, 167(4), 492–499. https://doi.org/10.1093/aje/kwm324
Cytowania BibTeX
@article{hernan2016specifying, author={Hernán, Miguel A. and Sauer, Brian C. and Hernández-Díaz, Sonia and Platt, Robert and Shrier, Ian}, title={{Specifying a target trial prevents immortal time bias and other self-inflicted injuries in observational analyses}}, journal={Journal of Clinical Epidemiology}, year={2016}, volume={79}, pages={70--75}, doi={10.1016/j.jclinepi.2016.04.014}}@article{levesque2010problem, author={Lévesque, L. E. and Hanley, J. A. and Kezouh, A. and Suissa, S.}, title={{Problem of immortal time bias in cohort studies: Example using statins for preventing progression of diabetes}}, journal={BMJ}, year={2010}, volume={340}, eid={b5087}, doi={10.1136/bmj.b5087}}@article{suissa2008immortal, author={Suissa, S.}, title={{Immortal time bias in pharmacoepidemiology}}, journal={American Journal of Epidemiology}, year={2008}, volume={167}, number={4}, pages={492--499}, doi={10.1093/aje/kwm324}}