Co to jest błąd przeżywalności?
Błąd przeżywalności (ang. survivorship bias) to zniekształcenie wniosków, które powstaje, gdy analizuje się tylko jednostki, które „przetrwały” jakiś proces – firmy wciąż działające, fundusze nadal notowane, pacjentów, którzy dożyli zabiegu – i pomija te, które po drodze odpadły. Ponieważ odpadają zwykle jednostki słabsze, obraz ocalałych jest systematycznie zbyt optymistyczny.
Klasyczny przykład to praca Abrahama Walda nad samolotami z czasów II wojny światowej. Mangel i Samaniego (1984) opisują, jak Wald szacował podatność maszyn na trafienia na podstawie danych z samolotów, które wróciły. Sedno problemu: miejsca rzadko trafione u ocalałych mogą być właśnie tymi, których trafienie kończyło się utratą maszyny, więc nie wolno ich uznać za mniej ważne.
Czym różni się od podobnych błędów
- Błąd selekcji to szersza kategoria: próba różni się systematycznie od populacji z powodu sposobu doboru. Błąd przeżywalności to jego szczególny przypadek, w którym kryterium wejścia do danych jest „przetrwanie”.
- Błąd braku odpowiedzi dotyczy osób, które mogły odpowiedzieć, ale tego nie zrobiły; tu jednostki zniknęły, zanim mogły trafić do badania.
- Błąd przypominania to błąd pomiaru: badani są w próbie, ale różnie pamiętają przeszłość.
Przykład
Elton i in. (1996) śledzili wszystkie fundusze inwestycyjne istniejące pod koniec 1976 roku. Fundusze znikały głównie z powodu słabych wyników, więc analiza tylko tych, które przetrwały, zawyżała ocenę zarządzania. W naszej symulacji w R 1000 firm miało prawdziwą średnią roczną stopę zwrotu równą 0. Spośród 557 firm, które nie straciły ponad 30% kapitału, średnia wyniosła 3.3% rocznie, a w całej populacji – 0.2%.
W badaniach kohortowych pokrewnym problemem jest immortal time bias. Suissa (2008) pokazał, że gdy definicja ekspozycji wymaga przeżycia pewnego okresu, leki wydają się skrajnie skuteczne. Obciążenie rośnie wraz z długością tego okresu.
Na rysunku
Ta sama symulacja co w przykładzie, ale w nowej wersji: 500 firm różni się ryzykiem strategii (roczna zmienność stopy zwrotu od 5% do 30%), a prawdziwa średnia stopa zwrotu każdej z nich wynosi 0. Zakres zmienności i próg upadku (utrata ponad 30% kapitału) ustawiono ręcznie; ziarna nie zmieniano.
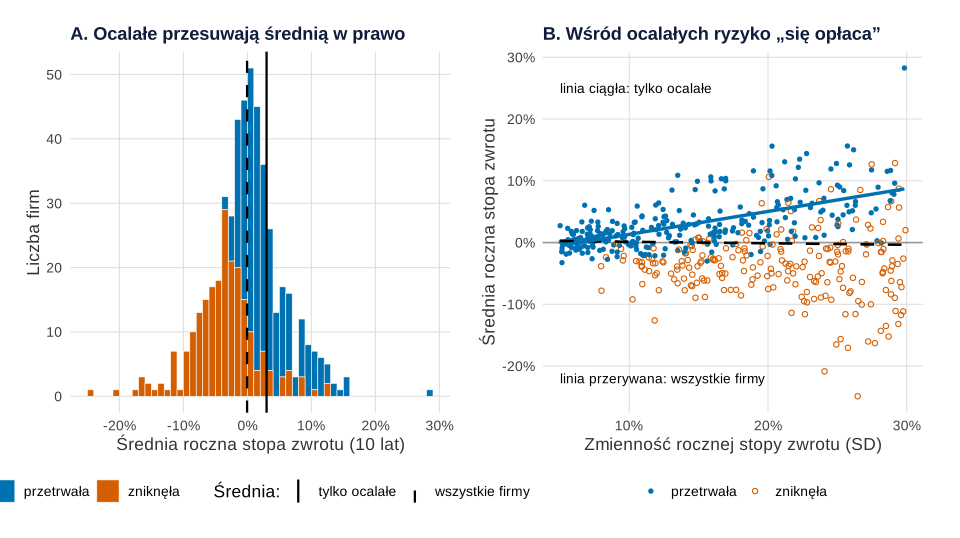
set.seed(470)).Co widać. Przetrwało 277 z 500 firm. Średnia stopa zwrotu wszystkich firm wynosi −0.1% rocznie, a ocalałych 3.0% (panel A): odcięcie lewego ogona przesuwa średnią w prawo, choć żadna firma nie miała przewagi. Panel B pokazuje coś groźniejszego. W całej populacji zmienność nie wiąże się ze zwrotem (r = −.03), a wśród ocalałych korelacja wynosi .60, a nachylenie 0.37. Ryzykowne strategie częściej kończą się upadkiem (przetrwało 32.9% firm z najwyższego tercyla zmienności wobec 83.2% z najniższego), więc wśród ocalałych zostają tylko te, którym się poszczęściło. Analiza samych ocalałych „odkrywa”, że ryzyko się opłaca.
Na co uważać. Na prawdziwych danych nie zobaczysz pomarańczowych punktów – właśnie ich brak jest problemem. Wykres pokazuje skutek selekcji, gdy zarówno cecha (zmienność), jak i wynik wpływają na przetrwanie; to ten sam mechanizm co dobór próby według zmiennej zderzeniowej, pokazany na innych przykładach we wpisie Zmienna zakłócająca i collider – wizualizacja. Rysunek nie mówi, jak duże jest obciążenie w Twoich danych: zależy ono od tego, jak ostra była selekcja i od czego zależała.
Podpis do pracy:
Kod rysunku jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Średnia stopa zwrotu wszystkich firm i tylko ocalałych (A) oraz zmienność a zwrot (B)
library(ggplot2)
library(patchwork)

kol <- c("przetrwała" = "#0072B2", "zniknęła" = "#D55E00")   # Okabe–Ito, czytelne przy deuteranopii
ksz <- c("przetrwała" = 16, "zniknęła" = 1)                    # kształt niesie tę samą informację co kolor
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(470)
n_firm <- 500; lata <- 10
zmiennosc <- runif(n_firm, 0.05, 0.30)          # SD rocznej stopy zwrotu firmy (ryzyko strategii)
r <- matrix(rnorm(n_firm * lata, mean = 0, sd = rep(zmiennosc, lata)), n_firm)  # prawdziwa średnia 0
wartosc <- t(apply(1 + r, 1, cumprod))           # skumulowana wartość kapitału
przetrwala <- apply(wartosc, 1, min) > 0.7       # firma znika, gdy straci ponad 30% kapitału
firmy <- data.frame(zmiennosc, zwrot = rowMeans(r),
                    status = factor(ifelse(przetrwala, "przetrwała", "zniknęła"), names(kol)))

nach <- function(d) unname(coef(lm(zwrot ~ zmiennosc, data = d))[2])
ocalale <- subset(firmy, status == "przetrwała")
print(round(c(przetrwalo = sum(przetrwala), srednia_wszystkie = mean(firmy$zwrot),
              srednia_ocalale = mean(ocalale$zwrot),
              r_wszystkie = cor(firmy$zmiennosc, firmy$zwrot), r_ocalale = cor(ocalale$zmiennosc, ocalale$zwrot),
              nachylenie_wszystkie = nach(firmy), nachylenie_ocalale = nach(ocalale)), 3))
# odsetek ocalałych w tercylach zmienności
print(round(tapply(przetrwala, cut(zmiennosc, quantile(zmiennosc, 0:3 / 3), include.lowest = TRUE,
                                   labels = c("niska", "średnia", "wysoka")), mean), 3))

# A: histogram średnich stóp zwrotu – słupki złożone z firm, które przetrwały, i tych, które zniknęły
srednie <- data.frame(grupa = c("wszystkie firmy", "tylko ocalałe"),
                      x = c(mean(firmy$zwrot), mean(ocalale$zwrot)))
pA <- ggplot(firmy, aes(zwrot, fill = status)) +
  geom_histogram(binwidth = 0.01, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(data = srednie, aes(xintercept = x, linetype = grupa), linewidth = 0.8) +
  scale_fill_manual(NULL, values = kol) +
  scale_linetype_manual("Średnia:", values = c("wszystkie firmy" = "dashed", "tylko ocalałe" = "solid")) +
  scale_x_continuous(labels = function(v) paste0(100 * v, "%")) +
  guides(fill = guide_legend(order = 1), linetype = guide_legend(order = 2)) +
  labs(x = "Średnia roczna stopa zwrotu (10 lat)", y = "Liczba firm",
       title = "A. Ocalałe przesuwają średnią w prawo")

# B: zmienność a średni zwrot – linia dla wszystkich firm i tylko dla ocalałych
pB <- ggplot(firmy, aes(zmiennosc, zwrot)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_point(aes(colour = status, shape = status), size = 1.5) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "black",
              linetype = "dashed", linewidth = 0.9) +
  geom_smooth(data = ocalale, method = "lm", formula = y ~ x, se = FALSE,
              colour = kol[["przetrwała"]], linewidth = 1.2) +
  annotate("text", x = 0.05, y = c(0.25, -0.22), hjust = 0, size = 3.6,
           label = c("linia ciągła: tylko ocalałe", "linia przerywana: wszystkie firmy")) +
  scale_colour_manual(NULL, values = kol) +
  scale_shape_manual(NULL, values = ksz) +
  scale_x_continuous(labels = function(v) paste0(100 * v, "%")) +
  scale_y_continuous(labels = function(v) paste0(100 * v, "%")) +
  labs(x = "Zmienność rocznej stopy zwrotu (SD)", y = "Średnia roczna stopa zwrotu",
       title = "B. Wśród ocalałych ryzyko „się opłaca”")
p1 <- (pA | pB) & motyw
p1
Wynik w R
          przetrwalo    srednia_wszystkie      srednia_ocalale
             277.000               -0.001                0.030
         r_wszystkie            r_ocalale nachylenie_wszystkie
              -0.030                0.600               -0.024
  nachylenie_ocalale
               0.371
  niska średnia  wysoka
  0.832   0.500   0.329
Jak opisać w pracy
Na co uważać
- Bazy z bieżącą listą jednostek. Zapytaj, kto wypadł z rejestru i dlaczego; szukaj danych historycznych.
- Odpadanie w trakcie badania. Porównaj osoby, które ukończyły badanie, z tymi, które odpadły (zob. utrata uczestników i obserwacja cenzurowana).
- Literatura. Do przeglądu trafiają głównie badania „udane” – to błąd publikacji.
Błąd przeżywalności w R
Kod symuluje dziesięcioletnie stopy zwrotu 1000 firm o prawdziwej średniej równej 0 i porównuje średnią w całej populacji ze średnią tylko w firmach, które przetrwały.
Średnia stopa zwrotu w populacji i wśród ocalałych
R
set.seed(4701)
n_firm <- 1000; lata <- 10
r <- matrix(rnorm(n_firm * lata, mean = 0, sd = 0.15), n_firm)  # roczne stopy zwrotu, prawdziwa średnia 0
wartosc <- t(apply(1 + r, 1, cumprod))           # skumulowana wartość kapitału
przetrwala <- apply(wartosc, 1, min) > 0.7       # firma znika, gdy straci ponad 30% kapitału
round(c(przetrwalo = sum(przetrwala),
        srednia_wszystkie = mean(r),             # cała populacja
        srednia_ocalale = mean(r[przetrwala, ])), 4)  # tylko firmy, które przetrwały
Wynik w R
       przetrwalo srednia_wszystkie   srednia_ocalale
         557.0000            0.0022            0.0330
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Symulacja w tej sekcji nie wymaga dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy błąd przeżywalności to to samo co błąd selekcji?
Jest jego szczególnym przypadkiem. Błąd selekcji obejmuje każdy dobór, przez który próba różni się od populacji, a błąd przeżywalności – sytuację, w której do danych trafiają tylko jednostki, które przetrwały.
Jak wykryć błąd przeżywalności we własnych danych?
Sprawdź, jak powstała lista jednostek: czy obejmuje też te, które zniknęły (zamknięte firmy, zmarłych pacjentów, osoby, które odpadły). Porównaj wyniki z analizą na danych historycznych lub na pełnej kohorcie.
Czy błąd przeżywalności dotyczy ankiet wśród studentów?
Tak. Badanie tylko studentów ostatniego roku pomija osoby, które zrezygnowały ze studiów, więc np. satysfakcja ze studiów będzie zawyżona. Opisz to ograniczenie lub dotrzyj także do osób, które odeszły.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Elton, E. J., Gruber, M. J., & Blake, C. R. (1996). Survivor bias and mutual fund performance. Review of Financial Studies, 9(4), 1097–1120. https://doi.org/10.1093/rfs/9.4.1097
- Mangel, M., & Samaniego, F. J. (1984). Abraham Wald's work on aircraft survivability. Journal of the American Statistical Association, 79(386), 259–267. https://doi.org/10.1080/01621459.1984.10478038
- Suissa, S. (2008). Immortal time bias in pharmacoepidemiology. American Journal of Epidemiology, 167(4), 492–499. https://doi.org/10.1093/aje/kwm324
Cytowania BibTeX
@article{elton1996survivor, author={Elton, Edwin J. and Gruber, Martin J. and Blake, Christopher R.}, title={{Survivor bias and mutual fund performance}}, journal={Review of Financial Studies}, year={1996}, volume={9}, number={4}, pages={1097--1120}, doi={10.1093/rfs/9.4.1097}}@article{mangel1984abraham, author={Mangel, Marc and Samaniego, Francisco J.}, title={{Abraham Wald's work on aircraft survivability}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={386}, pages={259--267}, doi={10.1080/01621459.1984.10478038}}@article{suissa2008immortal, author={Suissa, S.}, title={{Immortal time bias in pharmacoepidemiology}}, journal={American Journal of Epidemiology}, year={2008}, volume={167}, number={4}, pages={492--499}, doi={10.1093/aje/kwm324}}