Co to jest analiza landmark?
Analiza od punktu orientacyjnego (ang. landmark analysis) to sposób porównania czasu do zdarzenia między grupami, których skład ustala się dopiero w trakcie obserwacji, np. między pacjentami, którzy odpowiedzieli na leczenie, i tymi, którzy nie odpowiedzieli. Badacz wybiera z góry punkt czasowy L, bierze do analizy tylko osoby, które do tego momentu przeżyły i pozostały w obserwacji, przypisuje im grupę według stanu w chwili L i od tego momentu liczy czas – krzywą Kaplana–Meiera albo modelem Coxa.
Po co ten zabieg?
Anderson, Cain i Gelber (1983) wykazali, że zwykłe porównanie przeżycia osób z odpowiedzią i bez odpowiedzi na chemioterapię faworyzuje te pierwsze: żeby odpowiedzieć na leczenie, trzeba najpierw dożyć odpowiedzi. Osoby zmarłe wcześnie trafiają więc automatycznie do grupy bez odpowiedzi. To odmiana błędu czasu nieśmiertelnego. Autorzy podkreślali, że porównanie według odpowiedzi może służyć opisowi, ale nie wnioskowaniu o skuteczności leczenia.
Przykład
W symulacji 500 pacjentów odpowiedź nie wpływa na przeżycie. Naiwny model Coxa z odpowiedzią „kiedykolwiek” daje HR = 0.39, 95% CI [0.30, 0.51] – pozornie silny efekt ochronny. Analiza od 6. miesiąca obejmuje 393 osoby żyjące i obserwowane w tym punkcie (296 z odpowiedzią, 97 bez) i daje HR = 0.88 [0.68, 1.15], zgodnie z brakiem efektu.
Na rysunku
Oba rysunki korzystają z danych z przykładu, w których odpowiedź nie zmienia ryzyka zgonu.
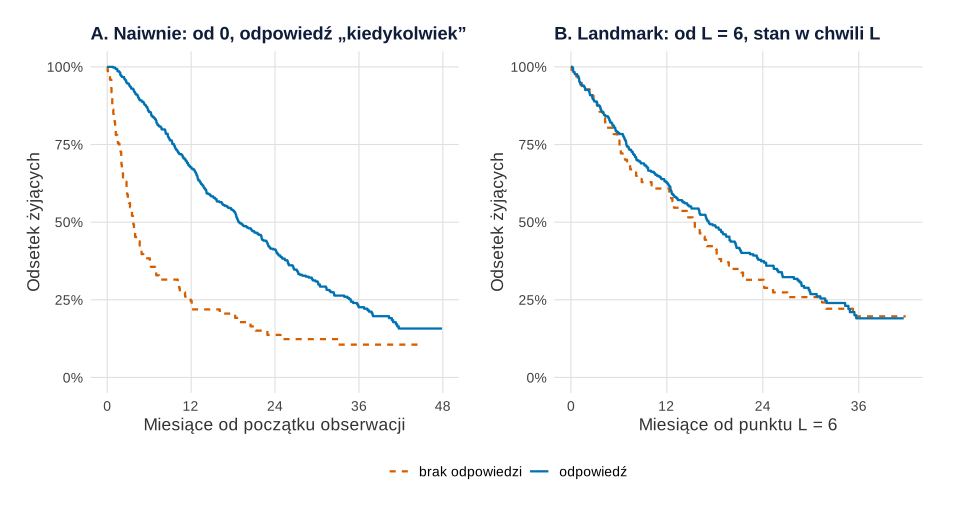
set.seed(573)).Co widać. W panelu A krzywa osób bez odpowiedzi spada stromo już w pierwszych miesiącach: trafiają do niej wszyscy, którzy zmarli, zanim zdążyli odpowiedzieć. Grupa z odpowiedzią ma za to „gwarantowany” czas przeżycia do chwili odpowiedzi – to czas nieśmiertelny. Stąd naiwny HR = 0.39. W panelu B 393 osoby żyjące w 6. miesiącu podzielono według stanu w tym momencie i czas liczono od L: krzywe prawie się pokrywają, HR = 0.88 [0.68, 1.15].
Na co uważać. Panel B nie pokazuje 107 osób, które zmarły albo wypadły z obserwacji przed L – podaj ich liczbę w tekście. Osoba, która odpowie po 6. miesiącu, zostaje w grupie „brak odpowiedzi”.
Podpis do pracy:
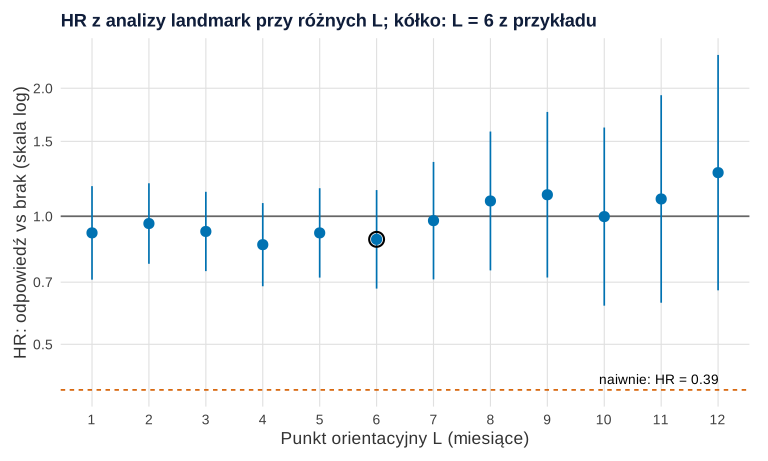
set.seed(573)).Co widać. Przy każdym L od 1 do 12 miesięcy przedział ufności obejmuje 1, a HR waha się od 0.86 (L = 4) do 1.27 (L = 12). Wynik naiwny 0.39 leży daleko poza wszystkimi przedziałami. Im późniejszy L, tym mniej osób (od 487 do 307) i szerszy przedział.
Na co uważać. To analiza wrażliwości, a nie sposób wyboru L: dwanaście analiz tych samych danych zawsze da jakiś „najlepszy” wynik. Punkt L ustal przed analizą, a taki wykres pokaż w aneksie.
Podpis do pracy:
Kod obu rysunków jest samowystarczalny. Rysunki na stronie powstały z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1 i 2
# Rysunki 1–2. Naiwne porównanie od początku obserwacji a analiza od punktu orientacyjnego
library(survival)
library(ggplot2)
library(patchwork)

kol <- c("odpowiedź" = "#0072B2", "brak odpowiedzi" = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(573)                                      # dane z przykładu w haśle; odpowiedź NIE wpływa na przeżycie
n <- 500
zgon <- rexp(n, rate = 1 / 24)
t_odp <- rexp(n, rate = 1 / 4)
odp <- as.numeric(t_odp < zgon & t_odp < 12)
cenz <- runif(n, 24, 48)
czas <- pmin(zgon, cenz); zd <- as.numeric(zgon <= cenz)

# Krzywa KM jako schodki dla danych w podziale na grupę 0/1
schodki <- function(t, d, g) {
  f <- survfit(Surv(t, d) ~ g)
  do.call(rbind, lapply(1:2, function(i) {
    fi <- f[i]; data.frame(czas = c(0, fi$time), S = c(1, fi$surv),
                           grupa = c("brak odpowiedzi", "odpowiedź")[i])
  }))
}
etyk_y <- function(x) paste0(100 * x, "%")

# Rysunek 1. A: naiwnie od 0 według odpowiedzi „kiedykolwiek”; B: od L = 6 według stanu w chwili L
L <- 6
lm6 <- czas > L
odp6 <- as.numeric(t_odp <= L & odp == 1)
c(w_punkcie_L = sum(lm6), odpadli_przed_L = sum(!lm6))
pA <- ggplot(schodki(czas, zd, odp), aes(czas, S, colour = grupa, linetype = grupa)) +
  geom_step(linewidth = 0.8) +
  scale_x_continuous("Miesiące od początku obserwacji", breaks = seq(0, 48, 12)) +
  labs(title = "A. Naiwnie: od 0, odpowiedź „kiedykolwiek”")
pB <- ggplot(schodki(czas[lm6] - L, zd[lm6], odp6[lm6]), aes(czas, S, colour = grupa, linetype = grupa)) +
  geom_step(linewidth = 0.8) +
  scale_x_continuous("Miesiące od punktu L = 6", breaks = seq(0, 42, 12)) +
  labs(title = "B. Landmark: od L = 6, stan w chwili L")
p1 <- (pA | pB) + plot_layout(guides = "collect") &
  scale_colour_manual(NULL, values = kol) & scale_linetype_manual(NULL, values = c("22", "solid")) &
  scale_y_continuous("Odsetek żyjących", limits = c(0, 1), labels = etyk_y) & motyw
p1

# Rysunek 2. HR (odpowiedź vs brak) w zależności od wyboru punktu L, na tle wyniku naiwnego
hr_wiersz <- function(fit) summary(fit)$conf.int[1, c(1, 3, 4)]
naiwny <- hr_wiersz(coxph(Surv(czas, zd) ~ odp))
wg_L <- do.call(rbind, lapply(1:12, function(l) {
  w <- czas > l; o <- as.numeric(t_odp <= l & odp == 1)
  h <- hr_wiersz(coxph(Surv(czas - l, zd) ~ o, subset = w))
  data.frame(L = l, w_punkcie_L = sum(w), odp_w_L = sum(o[w]), HR = h[1], dolna = h[2], gorna = h[3])
}))
round(naiwny, 2)
print(transform(wg_L, HR = round(HR, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)
p2 <- ggplot(wg_L, aes(L, HR)) +
  geom_hline(yintercept = 1, colour = "grey40") +
  geom_hline(yintercept = naiwny[1], linetype = "22", colour = kol[["brak odpowiedzi"]]) +
  annotate("text", x = 12, y = naiwny[1], hjust = 1, vjust = -0.6, size = 3.6,
           label = sprintf("naiwnie: HR = %.2f", naiwny[1])) +
  geom_pointrange(aes(ymin = dolna, ymax = gorna), colour = kol[["odpowiedź"]]) +
  geom_point(data = subset(wg_L, L == 6), shape = 21, size = 4.5, stroke = 1.1) +
  scale_x_continuous("Punkt orientacyjny L (miesiące)", breaks = 1:12) +
  scale_y_log10("HR: odpowiedź vs brak (skala log)", breaks = c(0.3, 0.5, 0.7, 1, 1.5, 2)) +
  labs(title = "HR z analizy landmark przy różnych L; kółko: L = 6 z przykładu") + motyw
p2
Wynik w R
    w_punkcie_L odpadli_przed_L
            393             107
exp(coef) lower .95 upper .95
     0.39      0.30      0.51
  L w_punkcie_L odp_w_L   HR dolna gorna
  1         487     103 0.91  0.71  1.18
  2         468     169 0.96  0.77  1.20
  3         446     228 0.92  0.74  1.14
  4         425     261 0.86  0.68  1.07
  5         408     280 0.91  0.72  1.16
  6         393     296 0.88  0.68  1.15
  7         378     314 0.98  0.71  1.34
  8         364     318 1.09  0.75  1.58
  9         349     316 1.12  0.72  1.76
 10         335     307 1.00  0.62  1.62
 11         321     300 1.10  0.63  1.93
 12         307     289 1.27  0.67  2.39
Jak interpretować wynik
Wynik jest warunkowy: dotyczy osób, które dożyły punktu L, z grupą ustaloną w chwili L (Dafni, 2011). Odpowiedź po L nie zmienia grupy, a zdarzenia i cenzurowania przed L wypadają z analizy. Alternatywą, która wykorzystuje całą obserwację, są zmienne zależne od czasu w modelu Coxa. Van Houwelingen (2007) rozwinął to podejście w narzędzie dynamicznej predykcji: modele dopasowuje się do osób pozostających w ryzyku w kolejnych punktach orientacyjnych.
Na co uważać
- Punkt L dobrany po obejrzeniu wyników. Ustal go w planie analizy i uzasadnij klinicznie.
- Brak informacji o wykluczonych. Podaj, ile osób miało zdarzenie lub zostało ocenzurowanych przed L.
- Wniosek przyczynowy. Usunięcie czasu nieśmiertelnego nie usuwa zakłócenia: osoby z odpowiedzią mogą mieć lepsze rokowanie z innych powodów.
Pełną analizę przeżycia w R pokazuje wpis Kaplan–Meier i model Coxa krok po kroku.
Analiza landmark w R
Kod symuluje kohortę, w której odpowiedź na leczenie nie zmienia ryzyka zgonu, i porównuje naiwny model Coxa (odpowiedź „kiedykolwiek”) z analizą od punktu orientacyjnego L = 6 miesięcy. Liczby w tekście pochodzą z tego kodu.
Naiwne porównanie a punkt orientacyjny
R
library(survival)
set.seed(573)                                      # 500 pacjentów, odpowiedź NIE wpływa na przeżycie
n <- 500
zgon <- rexp(n, rate = 1 / 24)                     # czas do zgonu (miesiące), wspólny dla wszystkich
t_odp <- rexp(n, rate = 1 / 4)                     # czas do odpowiedzi na leczenie
odp <- as.numeric(t_odp < zgon & t_odp < 12)       # odpowiedź tylko, jeśli nastąpi przed zgonem i do 12. mies.
cenz <- runif(n, 24, 48)                           # koniec obserwacji
czas <- pmin(zgon, cenz); zd <- as.numeric(zgon <= cenz)
naiwny <- coxph(Surv(czas, zd) ~ odp)              # podział według odpowiedzi „kiedykolwiek”
L <- 6                                             # punkt orientacyjny: 6 miesięcy
lm6 <- czas > L                                    # tylko osoby żyjące i obserwowane w punkcie L
odp6 <- as.numeric(t_odp <= L & odp == 1)          # status odpowiedzi ustalony w punkcie L
landm <- coxph(Surv(czas - L, zd) ~ odp6, subset = lm6)
c(w_punkcie_L = sum(lm6), odp_w_L = sum(odp6[lm6]), brak_odp_w_L = sum(!odp6[lm6]))
round(rbind(naiwny = summary(naiwny)$conf.int[, c(1, 3, 4)],
            landmark_6 = summary(landm)$conf.int[, c(1, 3, 4)]), 2)
Wynik w R
 w_punkcie_L      odp_w_L brak_odp_w_L
         393          296           97
           exp(coef) lower .95 upper .95
naiwny          0.39      0.30      0.51
landmark_6      0.88      0.68      1.15
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival; rysunki 1 i 2 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak wybrać punkt orientacyjny w analizie landmark?
Przed analizą i z uzasadnieniem klinicznym, np. jako czas, do którego zwykle następuje odpowiedź na leczenie (w przykładzie 6 miesięcy). Kilka innych punktów sprawdź w analizie wrażliwości i podaj, ile osób wypadło przed L.
Czym analiza landmark różni się od zmiennej zależnej od czasu?
Analiza landmark zamraża grupę w punkcie L i pomija wcześniejsze zdarzenia. Zmienna zależna od czasu w modelu Coxa pozwala zmienić status w dowolnym momencie i wykorzystuje całą obserwację. Oba podejścia usuwają czas nieśmiertelny.
Czy analiza landmark dowodzi, że odpowiedź na leczenie wydłuża życie?
Nie. Usuwa błąd czasu nieśmiertelnego, ale osoby z odpowiedzią i bez mogą różnić się rokowaniem z innych powodów, więc nadal jest to porównanie obserwacyjne, podatne na zakłócenie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, J. R., Cain, K. C., & Gelber, R. D. (1983). Analysis of survival by tumor response. Journal of Clinical Oncology, 1(11), 710–719. https://doi.org/10.1200/jco.1983.1.11.710
- Dafni, U. (2011). Landmark analysis at the 25-year landmark point. Circulation: Cardiovascular Quality and Outcomes, 4(3), 363–371. https://doi.org/10.1161/circoutcomes.110.957951
- van Houwelingen, H. C. (2007). Dynamic prediction by landmarking in event history analysis. Scandinavian Journal of Statistics, 34(1), 70–85. https://doi.org/10.1111/j.1467-9469.2006.00529.x
Cytowania BibTeX
@article{anderson1983analysis, author={Anderson, J. R. and Cain, K. C. and Gelber, R. D.}, title={{Analysis of survival by tumor response}}, journal={Journal of Clinical Oncology}, year={1983}, volume={1}, number={11}, pages={710--719}, doi={10.1200/jco.1983.1.11.710}}@article{dafni2011landmark, author={Dafni, Urania}, title={{Landmark analysis at the 25-year landmark point}}, journal={Circulation: Cardiovascular Quality and Outcomes}, year={2011}, volume={4}, number={3}, pages={363--371}, doi={10.1161/circoutcomes.110.957951}}@article{vanhouwelingen2007dynamic, author={van Houwelingen, Hans C.}, title={{Dynamic prediction by landmarking in event history analysis}}, journal={Scandinavian Journal of Statistics}, year={2007}, volume={34}, number={1}, pages={70--85}, doi={10.1111/j.1467-9469.2006.00529.x}}