Po co oceniać jakość włączonych badań
W przeglądzie systematycznym nie wystarczy zebrać badania i streścić ich wyniki. Promotor zapyta: na ile można ufać tym wynikom? Dziesięć zgodnych badań nie przekona nikogo, jeśli w każdym połowa osób odpadła przed drugim pomiarem. Ocena jakości (ang. critical appraisal) pozwala opisać te słabości jawnie i według stałych reguł, zamiast „na oko”.
W nowszej literaturze mówi się raczej o ocenie ryzyka błędu niż o „jakości”. Chodzi o pytanie, czy wynik badania może systematycznie odbiegać od prawdy. Różnicę między tymi pojęciami i zasady RoB 2 oraz ROBINS-I opisuje wpis ocena ryzyka błędu: RoB 2, ROBINS-I. Ten wpis dotyczy narzędzi, po które student(ka) sięga najczęściej przy badaniach obserwacyjnych: skali Newcastle–Ottawa (NOS) i list kontrolnych JBI. Pokazuje też, jak ocenę przeprowadzić w dwie osoby, policzyć zgodność, narysować wykres „traffic light” i opisać wszystko w pracy.
Jeśli Twój przegląd ma tylko zmapować literaturę, ocena jakości nie jest obowiązkowa (zob. przegląd zakresu krok po kroku). Ogólne zasady pisania przeglądu znajdziesz we wpisie jak napisać przegląd literatury.
Które narzędzie do jakiego schematu badania
Narzędzie dobierasz do schematu każdego włączonego badania, a nie do całego przeglądu. Jeśli włączasz badania kohortowe i przekrojowe, potrzebujesz dwóch narzędzi. Decyzję zapisz w protokole, zanim zaczniesz czytać badania.
| Schemat włączonego badania | Typowe narzędzie | Co dostajesz |
|---|---|---|
| badanie kohortowe (czynnik ryzyka, ekspozycja) | NOS dla badań kohortowych; lista JBI dla badań kohortowych; ROBINS-E | gwiazdki w trzech domenach; odpowiedzi na pytania listy; oceny domen |
| badanie kliniczno-kontrolne | NOS dla badań kliniczno-kontrolnych; lista JBI | gwiazdki; odpowiedzi na pytania listy |
| analityczne badanie przekrojowe | lista JBI dla analitycznych badań przekrojowych; adaptacja NOS tylko z cytowanym źródłem | odpowiedzi na pytania listy |
| badanie częstości (np. odsetek objawów w populacji) | lista JBI dla badań częstości | odpowiedzi na pytania listy |
| badanie z randomizacją | RoB 2 (lista JBI dla RCT to alternatywa) | niskie ryzyko, pewne zastrzeżenia, wysokie ryzyko |
| nierandomizowane badanie interwencji | ROBINS-I | od niskiego do krytycznego ryzyka |
| przegląd systematyczny (w przeglądzie przeglądów) | AMSTAR 2; lista JBI dla przeglądów | ocena przeglądu |
Skala Newcastle–Ottawa: domeny i gwiazdki
NOS powstała we współpracy uniwersytetów w Newcastle (Australia) i Ottawie do oceny jakości badań nierandomizowanych, które mają trafić do metaanalizy. Oficjalna strona opisuje „system gwiazdek”: badanie ocenia się w trzech obszarach – doborze grup, ich porównywalności oraz ustaleniu ekspozycji (w badaniach kliniczno-kontrolnych) albo wyniku (w kohortowych) (Wells i in., b.d.). Skala ma dwie wersje: dla badań kohortowych i dla kliniczno-kontrolnych. Badanie może otrzymać najwyżej dziewięć gwiazdek: cztery za dobór, dwie za porównywalność i trzy za ekspozycję lub wynik (Lo i in., 2014). Treści pozycji tu nie przytaczamy. Pobierz formularz i instrukcję z oficjalnej strony Ottawa Hospital Research Institute.
W wersji dla badań kohortowych pozycje dotyczą w skrócie (Lo i in., 2014):
- dobór (do 4 gwiazdek): czy osoby narażone są reprezentatywne, czy nienarażonych dobrano z tej samej populacji, jak ustalono ekspozycję i czy wykazano, że na początku badania nikt nie miał jeszcze badanego wyniku;
- porównywalność (do 2 gwiazdek): czy schemat albo analiza uwzględniają najważniejsze zmienne zakłócające;
- wynik (do 3 gwiazdek): jak zmierzono wynik, czy obserwacja trwała wystarczająco długo i czy utrata uczestników z obserwacji była mała.
W wersji dla badań kliniczno-kontrolnych dobór dotyczy definicji i reprezentatywności przypadków oraz doboru i definicji kontroli. Trzecia domena dotyczy ustalenia ekspozycji, tego, czy u przypadków i kontroli zmierzono ją tą samą metodą, oraz odsetka odmów udziału (Herzog i in., 2013).
Najważniejszą decyzję podejmujesz przed oceną. Wpisz do protokołu, które czynniki zakłócające dają gwiazdki za porównywalność (np. wcześniejsze objawy depresji i wiek) i jaki czas obserwacji uznajesz za wystarczający. Bez tych reguł każda osoba oceniająca przyzna gwiazdki inaczej.
Badania przekrojowe: adaptacje NOS i lista JBI
Oryginalna NOS nie ma wersji dla badań przekrojowych, a w psychologii to najczęstszy schemat. Część autorów przeglądów tworzy więc własne adaptacje. Często cytowany przykład to przegląd Herzoga i in. (2013), w którym 14 z 15 włączonych badań było przekrojowych. Autorzy ocenili je wersją zmodyfikowaną z NOS dla badań kohortowych i opublikowali ją jako plik dodatkowy do artykułu. W ich adaptacji dobór obejmuje reprezentatywność próby, liczebność, osoby, które nie wzięły udziału, i ustalenie ekspozycji. Porównywalność oceniają na podstawie schematu i analizy, a domena wyniku obejmuje sposób pomiaru wyniku i dobór testu statystycznego.
Jeśli użyjesz takiej adaptacji, zacytuj jej źródło, a nie samą NOS, i nie łącz jej punktów z punktami oryginalnej skali. Bezpieczniejsza droga to narzędzie zaprojektowane dla tego schematu. JBI ma osobną listę dla analitycznych badań przekrojowych, czyli takich, które badają związek ekspozycji z wynikiem, a nie tylko odsetek. Narzędzie to zrewidowano niedawno pod kątem oceny ryzyka błędu (Barker i in., 2026).
Narzędzia JBI: listy kontrolne dla różnych schematów
JBI (dawniej Joanna Briggs Institute) udostępnia bezpłatnie zestaw narzędzi oceny krytycznej. Każde z nich to lista pytań dopasowana do jednego schematu badania. W tej formie istnieją od około 20 lat, a niedawno zespół JBI zaktualizował narzędzia dla badań ilościowych, żeby odpowiadały współczesnym zasadom oceny ryzyka błędu (Barker i in., 2023). Oficjalna strona wymienia listy m.in. dla badań z randomizacją, quasi-eksperymentów, badań kohortowych, kliniczno-kontrolnych, analitycznych badań przekrojowych, badań częstości, serii przypadków, opisów przypadków, badań dokładności diagnostycznej, badań jakościowych i przeglądów systematycznych (JBI, b.d.).
Praktyczne wskazówki:
- Pobierz aktualną wersję ze strony JBI i podaj w pracy, której używasz. Strona zaznacza, że poprzednie wersje są dostępne tylko na prośbę, więc stare formularze z prac innych osób mogą się różnić od obecnych.
- Zacytuj publikację podaną przy danej liście (zalecenie cytowania jest na stronie JBI), a nie ogólnie „JBI”.
- Nie zamieniaj odpowiedzi w punkty bez uzasadnienia. Listy JBI służą do oceny poszczególnych aspektów badania, a nie do liczenia wyniku. Przy każdym pytaniu zapisz, na jakiej podstawie odpowiedziałeś(-aś).
Dlaczego nie sumować gwiazdek
Najczęstszy błąd w pracach dyplomowych to zdanie: „badania uzyskały od 5 do 8 gwiazdek, więc są dobrej jakości”. Suma traktuje wszystkie słabości jak wymienne. Jedna gwiazdka za reprezentatywność próby „waży” tyle samo co gwiazdka za kontrolę najważniejszego czynnika zakłócającego.
Problem jest znany od dawna. Jüni i in. (1999) ocenili te same 17 badań 25 różnymi skalami jakości. W zależności od skali badania „wysokiej jakości” pokazywały brak efektu, efekt albo wynik podobny jak badania „niskiej jakości”. Sumaryczne wyniki skal nie wiązały się istotnie z wielkością efektu, a z efektem wiązał się jeden konkretny aspekt: jawna ocena wyniku zawyżała efekt średnio o 35%. Autorzy zalecają więc oceniać istotne aspekty metodologiczne osobno. Samą NOS krytycznie ocenił Stang (2010). Lo i in. (2014) porównali oceny NOS wystawione przez recenzentów przeglądu z ocenami autorów 65 badań kohortowych i uzyskali dla sumy gwiazdek κ = −.004.
Oficjalna strona NOS nie podaje progów „dobra – słaba jakość” (Wells i in., b.d.). Progi typu „co najmniej 7 gwiazdek” ustalają autorzy przeglądów. Jeśli już ich używasz, podaj w protokole, skąd się wzięły, i zawsze pokaż obok nich profil domen. Przykład niżej pokazuje, co gubi sama suma.
Kiedy zamiast tego RoB 2, ROBINS-I albo ROBINS-E
- Badania z randomizacją oceniaj narzędziem RoB 2, a nie NOS.
- Nierandomizowane badania interwencji, np. porównanie dwóch oddziałów stosujących różne terapie, oceniaj narzędziem ROBINS-I. Szczegóły obu narzędzi są we wpisie o RoB 2 i ROBINS-I.
- Badania kohortowe nad wpływem ekspozycji (np. czynnika środowiskowego albo zachowania) możesz ocenić narzędziem ROBINS-E. Ocenia ono ryzyko błędu w konkretnym oszacowaniu efektu ekspozycji w siedmiu domenach z pytaniami sygnalizacyjnymi, a ocenę ogólną uzupełnia kierunkiem błędu (Higgins i in., 2024). Wymaga więcej pracy niż NOS, ale nie sumuje punktów.
Oceny każdego z tych narzędzi wykorzystasz później przy ocenie pewności dowodów (GRADE; zob. GRADE krok po kroku).
Dwie osoby oceniające i zgodność
Ocenę prowadzą niezależnie dwie osoby, a rozbieżności rozstrzygają w dyskusji albo z udziałem trzeciej osoby. Tak postąpili m.in. Herzog i in. (2013). W pracy magisterskiej drugą osobą bywa promotor, inna osoba z seminarium albo współautor(ka) przeglądu. Zanim zaczniesz, oceńcie wspólnie 2–3 badania na próbę i doprecyzujcie reguły z protokołu.
Zgodność przed konsensusem opisz kappą Cohena (Cohen, 1960) dla decyzji „gwiazdka tak/nie”. Dla porównywalności, która ma trzy uporządkowane wartości (0–2), lepiej pasuje kappa ważona, jeśli masz dość badań. Wybór miary zgodności omawia wpis zgodność sędziów: kappa, ICC i alfa Krippendorffa.
Przykład: 10 badań kohortowych i wykres traffic light
Fikcyjny przegląd dotyczy związku doświadczania cyberprzemocy z objawami depresji rok później u nastolatków. Włączono 10 badań kohortowych, a dwie osoby (A i B) oceniły każde z nich ośmioma pozycjami NOS. Reguły z protokołu: gwiazdka za porównywalność za uwzględnienie wyjściowych objawów depresji, druga za płeć i wiek; gwiazdka za ustalenie ekspozycji tylko przy zwalidowanym kwestionariuszu cyberprzemocy. Wszystkie oceny są w pliku CSV.
Zgodność. Przy 70 decyzjach „gwiazdka tak/nie” (7 pozycji × 10 badań) osoby zgodziły się 55 razy, czyli w 78.6% przypadków. Kappa wyniosła κ = .54, 95% CI [.33, .74]. Najmniej zgodne były pozycje „utrata z obserwacji” (60%) i „dobór nienarażonych” (70%). Ocenę porównywalności (0–2) osoby wystawiły tak samo w 8 z 10 badań. Sumy gwiazdek osób A i B różniły się w 7 z 10 badań.
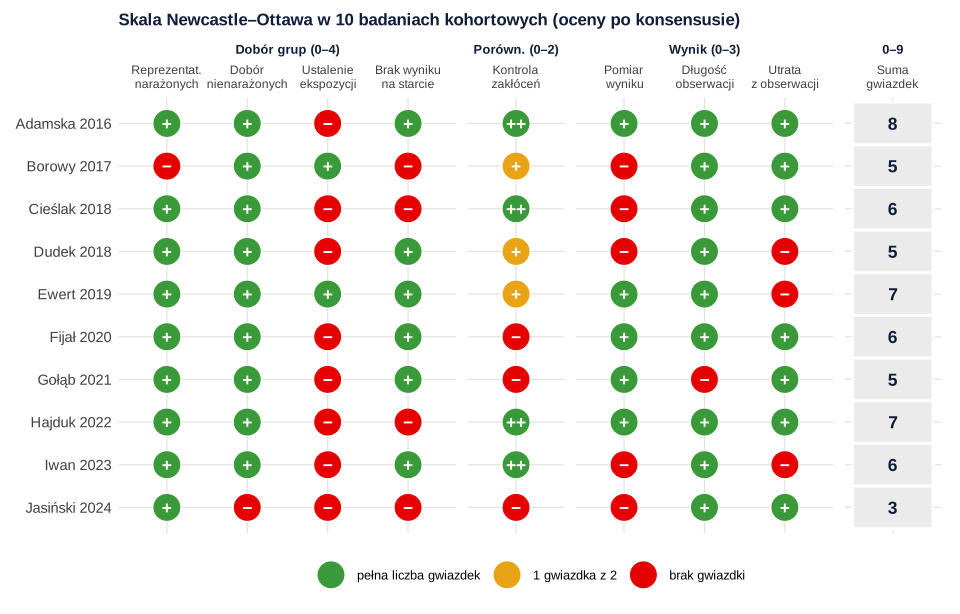
Co widać na rysunku. Najsłabszy punkt całego zbioru to ustalenie ekspozycji: gwiazdkę dostały tylko 2 z 10 badań, bo większość mierzyła cyberprzemoc jednym pytaniem. Pomiar wyniku oceniono dobrze w 5 badaniach. Sama suma by to ukryła.
Ta sama suma, różne problemy. Badania Cieślak 2018, Fijał 2020 i Iwan 2023 mają po 6 gwiazdek. Fijał 2020 nie kontroluje żadnego czynnika zakłócającego (0 gwiazdek za porównywalność), a Iwan 2023 kontroluje oba, ale ma słabszy pomiar wyniku i dużą utratę uczestników. To zupełnie różne zagrożenia dla wniosku.
Próg zmienia kategorię. Przy progu „co najmniej 7 gwiazdek” badanie Ewert 2019 osoba A oceniła na 6 gwiazdek („niska jakość”), a osoba B na 8 („dobra”). Po konsensusie ma 7 i trafia do „dobrej jakości”, choć nie dostało gwiazdki za utratę uczestników z obserwacji. Jedna gwiazdka różnicy przesuwa badanie między kategoriami.
Uproszczoną wersję wykresu w ggplot2 znajdziesz w kodzie niżej. Jeśli łączysz wyniki w metaanalizie, oceny wykorzystaj w analizie wrażliwości zaplanowanej w protokole, np. bez badań bez kontroli zakłóceń (zob. metaanaliza krok po kroku).
Jak opisać ocenę jakości w pracy
W rozdziale metod podaj narzędzie i jego wersję, liczbę osób oceniających, sposób rozstrzygania rozbieżności, reguły dla porównywalności i miarę zgodności. W wynikach pokaż ocenę każdego badania: tabelę albo wykres traffic light. Wytyczne PRISMA, STROBE i inne listy, które warto znać przy pisaniu przeglądu, omawia wpis wytyczne raportowania STROBE, CONSORT i TRIPOD. Formatowanie tabel opisuje wpis tabele APA w pracy.
Tabela 1
Ocena jakości włączonych badań kohortowych w Skali Newcastle–Ottawa (oceny po konsensusie)
| Badanie | Dobór (0–4) | Porównywalność (0–2) | Wynik (0–3) | Pozycje bez gwiazdki |
|---|---|---|---|---|
| Adamska (2016) | 3 | 2 | 3 | ustalenie ekspozycji |
| Borowy (2017) | 2 | 1 | 2 | reprezentatywność, wynik na starcie, pomiar wyniku |
| Cieślak (2018) | 2 | 2 | 2 | ustalenie ekspozycji, wynik na starcie, pomiar wyniku |
| Dudek (2018) | 3 | 1 | 1 | ustalenie ekspozycji, pomiar wyniku, utrata z obserwacji |
| Ewert (2019) | 4 | 1 | 2 | utrata z obserwacji |
| Fijał (2020) | 3 | 0 | 3 | ustalenie ekspozycji, brak kontroli zakłóceń |
| Gołąb (2021) | 3 | 0 | 2 | ustalenie ekspozycji, brak kontroli zakłóceń, długość obserwacji |
| Hajduk (2022) | 2 | 2 | 3 | ustalenie ekspozycji, wynik na starcie |
| Iwan (2023) | 3 | 2 | 1 | ustalenie ekspozycji, pomiar wyniku, utrata z obserwacji |
| Jasiński (2024) | 1 | 0 | 2 | dobór nienarażonych, ekspozycja, wynik na starcie, brak kontroli zakłóceń, pomiar wyniku |
Uwaga. Liczby to gwiazdki przyznane w każdej domenie; więcej gwiazdek oznacza mniej zastrzeżeń. Porównywalność: jedna gwiazdka za uwzględnienie wyjściowych objawów depresji, druga za płeć i wiek. Badania i oceny są fikcyjne.
Ocena NOS w R: zgodność, domeny i wykres
Kod tworzy fikcyjne oceny dwóch osób i oceny po konsensusie, zapisuje plik CSV do pobrania, liczy zgodność (kappa z pakietu psych), gwiazdki w domenach, porównuje sumy osób A i B przy progu 7 gwiazdek i rysuje uproszczony wykres traffic light w ggplot2. Przy własnym przeglądzie wczytaj arkusz ocen funkcją read.csv() i zacznij od kroku 1.
NOS w przeglądzie 10 badań kohortowych
R
# B215 – ocena jakości badań kohortowych skalą Newcastle–Ottawa (NOS) w przeglądzie (dane fikcyjne, set.seed(2150)).
# Pytanie przeglądu: doświadczanie cyberprzemocy a objawy depresji rok później u nastolatków; 10 badań kohortowych.
# Dwie osoby (A i B) niezależnie oceniły 8 pozycji NOS dla badań kohortowych: 7 pozycji 0/1 gwiazdka,
# porównywalność 0–2 gwiazdki. Treści pozycji nie przytaczamy – kolumny mają skrócone nazwy.
suppressPackageStartupMessages(library(psych))
set.seed(2150)
badania <- c("Adamska 2016", "Borowy 2017", "Cieślak 2018", "Dudek 2018", "Ewert 2019",
             "Fijał 2020", "Gołąb 2021", "Hajduk 2022", "Iwan 2023", "Jasiński 2024")
poz01 <- c("S1_reprezent", "S2_nienarazeni", "S3_ekspozycja", "S4_brak_wyniku_na_starcie",
           "W1_pomiar_wyniku", "W2_dlugosc_obserwacji", "W3_utrata_z_obserwacji")
p_gw <- c(.55, .90, .45, .60, .50, .80, .55)            # szansa gwiazdki w każdej pozycji
k <- length(badania)
# Oceny po konsensusie (fikcyjne)
kons <- sapply(p_gw, function(p) rbinom(k, 1, p)); colnames(kons) <- poz01
kons <- data.frame(badanie = badania, kons, P_porownywalnosc = sample(0:2, k, TRUE, c(.25, .40, .35)))
# Oceny osób A i B: każda z nich czasem odchodzi od oceny po konsensusie
zmien01 <- function(x, p) ifelse(runif(length(x)) < p, 1 - x, x)
zmienP <- function(x, p) ifelse(runif(length(x)) < p, pmin(2, pmax(0, x + sample(c(-1, 1), length(x), TRUE))), x)
A <- kons; B <- kons
A[poz01] <- lapply(kons[poz01], zmien01, p = .08); B[poz01] <- lapply(kons[poz01], zmien01, p = .10)
A$P_porownywalnosc <- zmienP(kons$P_porownywalnosc, .20); B$P_porownywalnosc <- zmienP(kons$P_porownywalnosc, .25)
write.csv(rbind(cbind(osoba = "A", A), cbind(osoba = "B", B), cbind(osoba = "konsensus", kons)),
          "../nos-oceny-przyklad.csv", row.names = FALSE)

# Krok 1. Zgodność A i B dla 70 decyzji „gwiazdka tak/nie” (7 pozycji × 10 badań)
a <- unlist(A[poz01]); b <- unlist(B[poz01])
c(decyzji = length(a), zgodnych = sum(a == b), procent = round(100 * mean(a == b), 1))
table(A = a, B = b)
ck <- cohen.kappa(cbind(a, b))
round(ck$confid[1, ], 2)                                # kappa z 95% CI
# Zgodność dla porównywalności (0–2) i zgodność w każdej pozycji
c(porownywalnosc_zgodnych = sum(A$P_porownywalnosc == B$P_porownywalnosc), z = k)
round(100 * colMeans(A[poz01] == B[poz01]), 0)

# Krok 2. Gwiazdki w domenach (po konsensusie): dobór 0–4, porównywalność 0–2, wynik 0–3
kons$Dobor <- rowSums(kons[, poz01[1:4]])
kons$Porown <- kons$P_porownywalnosc
kons$Wynik <- rowSums(kons[, poz01[5:7]])
kons$Suma <- kons$Dobor + kons$Porown + kons$Wynik
kons[, c("badanie", "Dobor", "Porown", "Wynik", "Suma")]
colSums(kons[poz01])                                    # ile badań dostało gwiazdkę w każdej pozycji
table(porownywalnosc = kons$Porown)

# Krok 3. Ta sama suma, inny profil: badania z jednakową sumą gwiazdek
tab <- table(kons$Suma); tab
s <- as.numeric(names(tab)[tab >= 2 & as.numeric(names(tab)) >= 6][1])
kons[kons$Suma == s, c("badanie", poz01, "P_porownywalnosc")]

# Krok 4. Próg „co najmniej 7 gwiazdek = dobra jakość” (próg autorów przeglądu, nie część NOS)
sumaA <- rowSums(A[poz01]) + A$P_porownywalnosc
sumaB <- rowSums(B[poz01]) + B$P_porownywalnosc
data.frame(badanie = badania, sumaA, sumaB, kons = kons$Suma,
           kat_A = ifelse(sumaA >= 7, "dobra", "niska"), kat_B = ifelse(sumaB >= 7, "dobra", "niska"))
c(roznica_sum_badan = sum(sumaA != sumaB), inna_kategoria = sum((sumaA >= 7) != (sumaB >= 7)))
# Ile badań bez gwiazdki w pozycji „utrata z obserwacji” ma mimo to sumę >= 7?
kons$badanie[kons$W3_utrata_z_obserwacji == 0 & kons$Suma >= 7]

# Krok 5. Wykres „traffic light” w ggplot2 (wersja uproszczona rysunku 1)
suppressPackageStartupMessages(library(ggplot2))
kolumny <- c(poz01[1:4], "P_porownywalnosc", poz01[5:7])
dl <- data.frame(badanie = rep(kons$badanie, length(kolumny)),
                 pozycja = factor(rep(kolumny, each = k), levels = kolumny),
                 gwiazdki = unlist(kons[kolumny]))
dl$ocena <- ifelse(dl$gwiazdki == 0, "brak gwiazdki",
                   ifelse(dl$pozycja == "P_porownywalnosc" & dl$gwiazdki == 1, "1 z 2 gwiazdek", "gwiazdka"))
dl$badanie <- factor(dl$badanie, levels = rev(badania))
p <- ggplot(dl, aes(pozycja, badanie, fill = ocena)) +
  geom_point(shape = 21, size = 8, colour = "white") +
  scale_fill_manual(values = c("gwiazdka" = "#3a9a3a", "1 z 2 gwiazdek" = "#E8A317", "brak gwiazdki" = "#e50101")) +
  scale_x_discrete(position = "top") +
  labs(x = NULL, y = NULL, fill = NULL) +
  theme_minimal() + theme(axis.text.x = element_text(angle = 30, hjust = 0), legend.position = "bottom")
table(dl$ocena)
ggsave(file.path(tempdir(), "traffic-light.png"), p, width = 10, height = 6, dpi = 150)
Wynik w R
 decyzji zgodnych  procent
    70.0     55.0     78.6
   B
A    0  1
  0 18  6
  1  9 37
   lower estimate    upper
    0.33     0.54     0.74
porownywalnosc_zgodnych                       z
                      8                      10
             S1_reprezent            S2_nienarazeni             S3_ekspozycja
                       90                        70                        80
S4_brak_wyniku_na_starcie          W1_pomiar_wyniku     W2_dlugosc_obserwacji
                       80                        90                        80
   W3_utrata_z_obserwacji
                       60
         badanie Dobor Porown Wynik Suma
1   Adamska 2016     3      2     3    8
2    Borowy 2017     2      1     2    5
3   Cieślak 2018     2      2     2    6
4     Dudek 2018     3      1     1    5
5     Ewert 2019     4      1     2    7
6     Fijał 2020     3      0     3    6
7     Gołąb 2021     3      0     2    5
8    Hajduk 2022     2      2     3    7
9      Iwan 2023     3      2     1    6
10 Jasiński 2024     1      0     2    3
             S1_reprezent            S2_nienarazeni             S3_ekspozycja
                        9                         9                         2
S4_brak_wyniku_na_starcie          W1_pomiar_wyniku     W2_dlugosc_obserwacji
                        6                         5                         9
   W3_utrata_z_obserwacji
                        7
porownywalnosc
0 1 2
3 3 4

3 5 6 7 8
1 3 3 2 1
       badanie S1_reprezent S2_nienarazeni S3_ekspozycja S4_brak_wyniku_na_starcie W1_pomiar_wyniku
3 Cieślak 2018            1              1             0                         0                0
6   Fijał 2020            1              1             0                         1                1
9    Iwan 2023            1              1             0                         1                0
  W2_dlugosc_obserwacji W3_utrata_z_obserwacji P_porownywalnosc
3                     1                      1                2
6                     1                      1                0
9                     1                      0                2
         badanie sumaA sumaB kons kat_A kat_B
1   Adamska 2016     7     7    8 dobra dobra
2    Borowy 2017     6     4    5 niska niska
3   Cieślak 2018     6     4    6 niska niska
4     Dudek 2018     6     3    5 niska niska
5     Ewert 2019     6     8    7 niska dobra
6     Fijał 2020     5     6    6 niska niska
7     Gołąb 2021     5     4    5 niska niska
8    Hajduk 2022     7     8    7 dobra dobra
9      Iwan 2023     6     6    6 niska niska
10 Jasiński 2024     3     3    3 niska niska
roznica_sum_badan    inna_kategoria
                7                 1
[1] "Ewert 2019"

1 z 2 gwiazdek  brak gwiazdki       gwiazdka
             3             26             51
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- NOS użyta do badań z randomizacją albo przekrojowych bez cytowanej adaptacji. Dobierz narzędzie do schematu.
- „Jakość dobra, bo 7 gwiazdek”. Pokaż profil domen, a próg, jeśli go używasz, uzasadnij w protokole.
- Brak reguł dla porównywalności. Bez listy czynników zakłócających ustalonej przed oceną ta domena jest dowolna.
- Ocena w jedną osobę albo podanie tylko zgodności po konsensusie, która z definicji wynosi 100%.
- Ocena bez skutków. Jeśli słabości badań nie pojawiają się w dyskusji ani w analizie wrażliwości, ocena była tylko formalnością.
- Stara wersja listy JBI skopiowana z cudzej pracy zamiast aktualnej ze strony JBI.
Jeśli potrzebujesz kogoś, kto sprawdzi protokół oceny, policzy zgodność i pomoże zinterpretować oceny w metaanalizie, zajrzyj do oferty analizy statystyczne dla studentów. Oceny i wnioski musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Do jakich badań używa się skali Newcastle–Ottawa?
Do nierandomizowanych badań kohortowych i kliniczno-kontrolnych włączanych do przeglądów i metaanaliz; skala ma osobne wersje dla obu schematów (Wells i in., b.d.). Do badań z randomizacją użyj RoB 2, a do badań przekrojowych listy JBI albo adaptacji NOS, której źródło zacytujesz.
Ile gwiazdek można dostać w skali Newcastle–Ottawa?
Najwięcej dziewięć: do czterech za dobór grup, do dwóch za porównywalność i do trzech za ustalenie ekspozycji albo wyniku (Lo i in., 2014). Nie traktuj jednak sumy jako miary jakości, bo różne braki dają tę samą liczbę gwiazdek.
Czy można użyć skali Newcastle–Ottawa do badań przekrojowych?
Oryginalna skala nie ma takiej wersji. Autorzy przeglądów tworzą adaptacje, np. Herzog i in. (2013) zmodyfikowali wersję dla badań kohortowych. Jeśli jej używasz, zacytuj źródło adaptacji. Alternatywą jest lista JBI dla analitycznych badań przekrojowych.
Czym różnią się narzędzia JBI od skali Newcastle–Ottawa?
JBI ma osobną listę pytań dla każdego schematu badania, m.in. RCT, quasi-eksperymentów, badań kohortowych, przekrojowych, częstości i jakościowych (JBI, b.d.). NOS obejmuje tylko badania kohortowe i kliniczno-kontrolne i przyznaje gwiazdki. Listy JBI zrewidowano niedawno pod kątem oceny ryzyka błędu.
Jak pokazać ocenę jakości badań w pracy magisterskiej?
Podaj w metodach narzędzie, liczbę osób oceniających, sposób rozstrzygania rozbieżności i zgodność (np. kappę Cohena). W wynikach pokaż ocenę każdego badania w domenach – w tabeli albo na wykresie traffic light – i opisz najczęstsze słabości zbioru badań.
Powiązane hasła
Przeczytaj też
Ocena ryzyka błędu: RoB 2, ROBINS-I
Które narzędzie do jakiego badania, domeny i ocena ogólna RoB 2 i ROBINS-I, skala NOS, zgodność oceniających i analiza wrażliwości – z kodem R.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →Piszesz przegląd systematyczny i nie wiesz, jak ocenić włączone badania?
Pomożemy dobrać narzędzie do schematów badań, ustalić reguły oceny, policzyć zgodność i wykorzystać oceny w syntezie, a wyniki wyjaśnimy tak, żebyś umiał(a) je samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barker, T. H., Hasanoff, S., Aromataris, E., Stone, J. C., Leonardi-Bee, J., Sears, K., Klugar, M., Tufanaru, C., Moola, S., Liu, X.-L., & Munn, Z. (2026). The revised JBI critical appraisal tool for the assessment of risk of bias for analytical cross-sectional studies. JBI Evidence Synthesis, 24(3), 401–408. https://doi.org/10.11124/jbies-24-00523 ● Otwarty dostęp
- Barker, T. H., Stone, J. C., Sears, K., Klugar, M., Leonardi-Bee, J., Tufanaru, C., Aromataris, E., & Munn, Z. (2023). Revising the JBI quantitative critical appraisal tools to improve their applicability: An overview of methods and the development process. JBI Evidence Synthesis, 21(3), 478–493. https://doi.org/10.11124/jbies-22-00125
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Herzog, R., Álvarez-Pasquin, M. J., Díaz, C., Del Barrio, J. L., Estrada, J. M., & Gil, Á. (2013). Are healthcare workers' intentions to vaccinate related to their knowledge, beliefs and attitudes? A systematic review. BMC Public Health, 13(1), Article 154. https://doi.org/10.1186/1471-2458-13-154 ● Otwarty dostęp
- Higgins, J. P. T., Morgan, R. L., Rooney, A. A., Taylor, K. W., Thayer, K. A., Silva, R. A., Lemeris, C., Akl, E. A., Bateson, T. F., Berkman, N. D., Glenn, B. S., Hróbjartsson, A., LaKind, J. S., McAleenan, A., Meerpohl, J. J., Nachman, R. M., Obbagy, J. E., O'Connor, A., Radke, E. G., . . . Sterne, J. A. C. (2024). A tool to assess risk of bias in non-randomized follow-up studies of exposure effects (ROBINS-E). Environment International, 186, Article 108602. https://doi.org/10.1016/j.envint.2024.108602 ● Otwarty dostęp
- JBI. (b.d.). Critical appraisal tools. https://jbi.global/critical-appraisal-tools ● Otwarty dostęp
- Jüni, P., Witschi, A., Bloch, R., & Egger, M. (1999). The hazards of scoring the quality of clinical trials for meta-analysis. JAMA, 282(11), 1054–1060. https://doi.org/10.1001/jama.282.11.1054
- Lo, C. K.-L., Mertz, D., & Loeb, M. (2014). Newcastle-Ottawa Scale: Comparing reviewers' to authors' assessments. BMC Medical Research Methodology, 14(1), Article 45. https://doi.org/10.1186/1471-2288-14-45 ● Otwarty dostęp
- Stang, A. (2010). Critical evaluation of the Newcastle-Ottawa scale for the assessment of the quality of nonrandomized studies in meta-analyses. European Journal of Epidemiology, 25(9), 603–605. https://doi.org/10.1007/s10654-010-9491-z ● Otwarty dostęp: pełny tekst
- Wells, G. A., Shea, B., O'Connell, D., Peterson, J., Welch, V., Losos, M., & Tugwell, P. (b.d.). The Newcastle-Ottawa Scale (NOS) for assessing the quality of nonrandomised studies in meta-analyses. Ottawa Hospital Research Institute. https://www.ohri.ca/en/who-we-are/core-facilities-and-platforms/ottawa-methods-centre/newcastle-ottawa-scale ● Otwarty dostęp
Cytowania BibTeX
@article{barker2026analytical, author={Barker, Timothy H. and Hasanoff, Sabira and Aromataris, Edoardo and Stone, Jennifer C. and Leonardi-Bee, Jo and Sears, Kim and Klugar, Miloslav and Tufanaru, Catalin and Moola, Sandeep and Liu, Xian-Liang and Munn, Zachary}, title={{The revised JBI critical appraisal tool for the assessment of risk of bias for analytical cross-sectional studies}}, journal={JBI Evidence Synthesis}, year={2026}, volume={24}, number={3}, pages={401--408}, doi={10.11124/jbies-24-00523}}@article{barker2023revising, author={Barker, Timothy Hugh and Stone, Jennifer C. and Sears, Kim and Klugar, Miloslav and Leonardi-Bee, Jo and Tufanaru, Catalin and Aromataris, Edoardo and Munn, Zachary}, title={{Revising the JBI quantitative critical appraisal tools to improve their applicability: An overview of methods and the development process}}, journal={JBI Evidence Synthesis}, year={2023}, volume={21}, number={3}, pages={478--493}, doi={10.11124/jbies-22-00125}}@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{herzog2013healthcare, author={Herzog, Raúl and Álvarez-Pasquin, Mª José and Díaz, Camino and Del Barrio, José Luis and Estrada, José Manuel and Gil, Ángel}, title={{Are healthcare workers' intentions to vaccinate related to their knowledge, beliefs and attitudes? A systematic review}}, journal={BMC Public Health}, year={2013}, volume={13}, number={1}, eid={154}, doi={10.1186/1471-2458-13-154}}@article{higgins2024robinse, author={Higgins, Julian P. T. and Morgan, Rebecca L. and Rooney, Andrew A. and Taylor, Kyla W. and Thayer, Kristina A. and Silva, Raquel A. and Lemeris, Courtney and Akl, Elie A. and Bateson, Thomas F. and Berkman, Nancy D. and Glenn, Barbara S. and Hróbjartsson, Asbjørn and LaKind, Judy S. and McAleenan, Alexandra and Meerpohl, Joerg J. and Nachman, Rebecca M. and Obbagy, Julie E. and O'Connor, Annette and Radke, Elizabeth G. and Savović, Jelena and Schünemann, Holger J. and Shea, Beverley and Tilling, Kate and Verbeek, Jos and Viswanathan, Meera and Sterne, Jonathan A. C.}, title={{A tool to assess risk of bias in non-randomized follow-up studies of exposure effects (ROBINS-E)}}, journal={Environment International}, year={2024}, volume={186}, eid={108602}, doi={10.1016/j.envint.2024.108602}}@misc{jbindcritical, author={{JBI}}, title={{Critical appraisal tools}}, howpublished={JBI}, year={b.d.}, url={https://jbi.global/critical-appraisal-tools}}@article{juni1999hazards, author={Jüni, Peter and Witschi, Anne and Bloch, Ralph and Egger, Matthias}, title={{The hazards of scoring the quality of clinical trials for meta-analysis}}, journal={JAMA}, year={1999}, volume={282}, number={11}, pages={1054--1060}, doi={10.1001/jama.282.11.1054}}@article{lo2014newcastle, author={Lo, Carson Ka-Lok and Mertz, Dominik and Loeb, Mark}, title={{Newcastle-Ottawa Scale: Comparing reviewers' to authors' assessments}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={45}, doi={10.1186/1471-2288-14-45}}@article{stang2010critical, author={Stang, Andreas}, title={{Critical evaluation of the Newcastle-Ottawa scale for the assessment of the quality of nonrandomized studies in meta-analyses}}, journal={European Journal of Epidemiology}, year={2010}, volume={25}, number={9}, pages={603--605}, doi={10.1007/s10654-010-9491-z}}@misc{wellsndnos, author={Wells, G. A. and Shea, B. and O'Connell, D. and Peterson, J. and Welch, V. and Losos, M. and Tugwell, P.}, title={{The Newcastle-Ottawa Scale (NOS) for assessing the quality of nonrandomised studies in meta-analyses}}, howpublished={Ottawa Hospital Research Institute}, year={b.d.}, url={https://www.ohri.ca/en/who-we-are/core-facilities-and-platforms/ottawa-methods-centre/newcastle-ottawa-scale}}