Po co jest przegląd literatury w pracy dyplomowej?
Większość rozdziałów teoretycznych w pracach dyplomowych powstaje tak samo: kilkadziesiąt PDF-ów, a potem akapit po akapicie „Autor A (rok) zbadał… Autor B (rok) wykazał…”. Taki tekst dowodzi, że coś przeczytałeś, ale nie odpowiada na żadne pytanie. Snyder (2019) zauważa, że tradycyjne przeglądy literatury często powstają ad hoc i bez rygoru – i właśnie to odróżnia je od przeglądu, który ma wartość naukową.
Dobry przegląd literatury tworzy fundament dla dalszych badań: ułatwia budowanie teorii, „zamyka” obszary już dobrze zbadane i odsłania te, które wymagają badań (Webster i Watson, 2002). W pracy dyplomowej przekłada się to na trzy zadania rozdziału teoretycznego:
- uporządkować pojęcia – jak definiuje się i mierzy zmienne, które badasz (operacjonalizacja);
- pokazać stan wiedzy – co wiadomo na pewno, co jest sporne, a czego nie zbadano;
- uzasadnić Twoje badanie – z luki w literaturze wynikają pytania badawcze i hipotezy.
W tym poradniku przechodzimy przez cały proces: od wyboru rodzaju przeglądu, przez pytanie, wyszukiwanie w bazach, selekcję i tabelę ekstrakcji, po syntezę i strukturę rozdziału. Na końcu omawiamy, w których krokach narzędzia AI realnie pomagają, a w których ich użycie jest ryzykowne lub niedopuszczalne.
Rodzaje przeglądów literatury
„Przegląd literatury” to nazwa wielu różnych metod. Grant i Booth (2009) przeanalizowali 14 typów przeglądów w schemacie SALSA – wyszukiwanie (Search), ocena (AppraisaL), synteza (Synthesis) i analiza (Analysis) – i stwierdzili, że tylko nieliczne mają jasno określoną metodologię, a wiele typów nie jest wzajemnie rozłącznych. W pracach z psychologii najczęściej spotkasz pięć z nich:
| Rodzaj | Cel | Wyszukiwanie i selekcja | Kiedy w pracy dyplomowej |
|---|---|---|---|
| Przegląd narracyjny | Szeroka synteza teorii i wyników, często z własną interpretacją autora | Dobór literatury przez autora, zwykle bez pełnej dokumentacji | Standardowy rozdział teoretyczny pracy licencjackiej i magisterskiej |
| Przegląd z elementami metodologii systematycznej | Synteza z jawnie opisanym wyszukiwaniem i kryteriami | Opisane bazy, słowa kluczowe, kryteria; selekcja zwykle przez jedną osobę | Gdy chcesz wzmocnić rozdział teoretyczny albo promotor oczekuje opisu metody przeglądu |
| Przegląd systematyczny | Odpowiedź na wąskie pytanie na podstawie wszystkich spełniających kryteria badań | Protokół, kilka baz, selekcja w dwóch etapach (najlepiej przez dwie osoby), ocena ryzyka błędu | Gdy przegląd jest głównym celem pracy |
| Przegląd zakresu (scoping review) | Zmapowanie literatury, pojęć i luk w wiedzy | Jak w przeglądzie systematycznym, zwykle bez oceny wielkości efektu | Gdy temat jest nowy lub rozproszony |
| Metaanaliza | Statystyczne połączenie wielkości efektów | Przegląd systematyczny plus ekstrakcja efektów | Rzadko w licencjacie; możliwa w magisterce przy wąskim pytaniu |
Przegląd narracyjny nie jest „gorszą wersją” systematycznego. Baumeister i Leary (1997) pokazują, że może podejmować szersze i bardziej abstrakcyjne pytania niż pojedynczy raport empiryczny – na przykład porównywać teorie. Przegląd systematyczny jest natomiast niezbędny, gdy pytasz o konkretny efekt: Siddaway, Wood i Hedges (2019) w przewodniku dla psychologów podkreślają wyczerpujące wyszukiwanie, także prac niepublikowanych, i krytyczną ocenę jakości dowodów. Przegląd zakresu wybiera się, gdy celem jest identyfikacja luk w wiedzy, zmapowanie literatury lub wyjaśnienie pojęć (Munn i in., 2018). Szczegóły standardu raportowania znajdziesz w haśle przegląd systematyczny i PRISMA, a o łączeniu wyników piszemy w haśle metaanaliza i w poradniku metaanaliza krok po kroku. Przeglądy wyższego rzędu – syntezy istniejących metaanaliz – opisujemy w tekście o umbrella review i PRISMA 2020.
Praktyczna rada: w typowej pracy magisterskiej z psychologii najlepiej sprawdza się przegląd narracyjny z elementami metodologii systematycznej – opisanym wyszukiwaniem, kryteriami i tabelą badań. Nie nazywaj go jednak przeglądem systematycznym, jeśli nie miał protokołu i podwójnej selekcji.
Krok 1. Pytanie przeglądu i kryteria włączenia
Przegląd zaczyna się od pytania, a nie od wpisania tematu w wyszukiwarkę. Pytanie przeglądu wynika z problemu badawczego Twojej pracy i powinno określać populację, zjawisko i wynik. Pomaga w tym schemat PICO (populacja, interwencja lub ekspozycja, porównanie, wynik), który w badaniach korelacyjnych upraszcza się do populacji, ekspozycji i wyniku. Przykład, który prowadzimy przez cały poradnik:
Populacja: studenci studiów wyższych (każdy kierunek, każdy kraj).
Ekspozycja: spostrzegane lub otrzymywane wsparcie społeczne (rodzina, rówieśnicy, wykładowcy).
Wynik: wypalenie akademickie lub jego wymiary (wyczerpanie, cynizm, obniżone poczucie skuteczności).
Typ badań: badania ilościowe – przekrojowe, podłużne, eksperymentalne.
Kryteria wykluczenia: próby niestudenckie (np. pracownicy), badania jakościowe, brak pomiaru wypalenia, brak danych pozwalających opisać związek.
Język i lata: angielski i polski, publikacje od 2010 r.
Zapisz kryteria zanim zaczniesz czytać wyniki badań. Jeśli dobierasz literaturę dopiero po analizie własnych danych, łatwo wpaść w pułapkę, którą Rubin (2017) opisuje jako jedną z form HARKingu: „dobieranie” hipotez z literatury po fakcie, tak by pasowały do uzyskanych wyników. Więcej o przechodzeniu od teorii do hipotez piszemy w poradniku pytania badawcze i hipotezy.
Krok 2. Strategia wyszukiwania: bazy, słowa kluczowe i operatory Boole’a
Gdzie szukać
W psychologii podstawową bazą jest APA PsycInfo; uzupełniają ją Scopus i Web of Science, przy tematach zdrowotnych – PubMed, a przy literaturze polskiej – BazHum i CEJSH. Dostęp do płatnych baz zwykle daje biblioteka uczelni. Google Scholar przydaje się do sprawdzania cytowań i szukania pełnych tekstów, ale jego wyników nie da się dokładnie powtórzyć, więc nie powinien być jedynym źródłem. Szukaj też poza czasopismami – w repozytoriach preprintów, rozprawach i bibliografiach przeczytanych prac – bo wyniki nieistotne rzadziej trafiają do druku (efekt szuflady).
Jak zbudować zapytanie
Rozbij pytanie na 2–3 bloki pojęciowe (np. wsparcie, wypalenie, studenci). W każdym bloku połącz synonimy operatorem OR, a bloki między sobą – operatorem AND.
| Operator | Działanie | Przykład |
|---|---|---|
| AND | Oba pojęcia muszą wystąpić – zawęża wyniki | burnout AND "social support" |
| OR | Wystarczy jedno z pojęć – poszerza wyniki; łączy synonimy | burnout OR exhaustion |
| NOT | Wyklucza pojęcie – używaj ostrożnie, bo odrzuca też prace, w których pojęcie pojawia się obok | burnout NOT nurses |
| "…" | Dokładna fraza | "academic burnout" |
| * | Dowolne zakończenie wyrazu | student* (student, students) |
| ( ) | Grupowanie – najpierw wykonywane są działania w nawiasie | (burnout OR exhaustion) AND student* |
| NEAR/n, W/n | Wyrazy w odległości najwyżej n słów; składnia zależy od bazy (np. NEAR/3 w Web of Science, W/3 w Scopusie) | social NEAR/2 support |
Zapytanie dla przykładu z kroku 1 – w wersji ogólnej i w składni Scopusa (pole TITLE-ABS-KEY przeszukuje tytuł, abstrakt i słowa kluczowe):
("social support" OR "perceived support" OR "peer support" OR "family support") AND ("academic burnout" OR "student burnout" OR "school burnout" OR "study burnout") AND (student* OR undergraduate* OR "higher education")
Scopus:
TITLE-ABS-KEY(("social support" OR "perceived support" OR "peer support" OR "family support") AND ("academic burnout" OR "student burnout" OR "school burnout" OR "study burnout") AND (student* OR undergraduate* OR "higher education")) AND PUBYEAR > 2009
Literatura polska (BazHum, CEJSH, Google Scholar):
("wsparcie społeczne" OR "spostrzegane wsparcie") AND ("wypalenie akademickie" OR "wypalenie szkolne" OR "wypalenie studentów")
Zanim uznasz zapytanie za gotowe, sprawdź je na kilku pracach, które na pewno powinny się znaleźć. Jeśli którejś brakuje, dodaj synonimy. Każde wyszukiwanie zapisz w dzienniku: baza, data, pełne zapytanie, filtry, liczba wyników. PRISMA 2020 wymaga podania wszystkich źródeł z datą ostatniego wyszukiwania i pełnych strategii wyszukiwania dla każdej bazy (Page i in., 2021) – nawet jeśli nie piszesz przeglądu systematycznego, ten zapis pozwoli Ci opisać metodę w dwóch zdaniach.
Krok 3. Selekcja badań: od setek rekordów do kilkunastu prac
Wyniki ze wszystkich baz zaimportuj do jednego menedżera bibliografii (np. Zotero) i usuń duplikaty. Selekcja przebiega w dwóch etapach:
- tytuły i abstrakty – odrzucasz rekordy, które na pewno nie spełniają kryteriów; w razie wątpliwości przepuszczasz dalej;
- pełne teksty – czytasz prace, które przeszły pierwszy etap, i przy każdym wykluczeniu zapisujesz powód (np. inna populacja, brak pomiaru wypalenia).
W przeglądzie systematycznym selekcję prowadzą dwie osoby niezależnie, a ich zgodność opisuje się np. współczynnikiem kappa Cohena. W pracy dyplomowej zwykle nie ma drugiej osoby – poproś wtedy promotora lub koleżankę o niezależną ocenę losowej części rekordów i opisz to w metodzie. Przebieg selekcji najlepiej pokazać na diagramie przepływu PRISMA 2020; przykładowy diagram z liczbami i objaśnieniem pól znajdziesz w haśle PRISMA.
Krok 4. Tabela ekstrakcji danych
Tabela ekstrakcji to arkusz, w którym każde włączone badanie ma jeden wiersz, a kolumny opisują to, czego potrzebujesz do syntezy. Zaprojektuj ją przed czytaniem pełnych tekstów i przetestuj na 2–3 pracach. Nagłówek do skopiowania (separator: średnik):
Kilka zasad, które oszczędzą Ci pracy przy pisaniu:
- notuj wielkość efektu, a nie tylko „istotny/nieistotny” – liczenie badań „za” i „przeciw” na podstawie wartości p wprowadza w błąd (zob. wartość p i wielkość efektu); zapisuj siłę efektu z przedziałem ufności, jeśli autorzy go podali;
- zapisuj schemat badania – wynik badania korelacyjnego nie uprawnia do wniosków przyczynowych, a schemat podłużny mówi więcej o kolejności zmian niż przekrojowy;
- zapisuj narzędzia pomiaru i ich rzetelność – różne kwestionariusze tego samego konstruktu często tłumaczą różnice wyników;
- oznacz cytat i stronę przy każdym kluczowym zdaniu – nie będziesz szukać go drugi raz.
Tabela ekstrakcji przyda się jeszcze raz: wielkości efektów z podobnych badań to najlepsza podstawa analizy mocy a priori przy planowaniu własnej próby.
Krok 5. Synteza: macierz pojęć zamiast streszczeń po kolei
Synteza to moment, w którym przegląd przestaje być listą streszczeń. Najprostsze narzędzie to macierz pojęć (ang. concept matrix): wiersze to badania, kolumny to pojęcia, wątki lub cechy metody, a w komórkach zaznaczasz, co dane badanie wnosi do każdego wątku.
| Badanie (przykład) | Wsparcie rówieśników | Wsparcie rodziny | Wyczerpanie | Cynizm | Schemat podłużny | Próba polska |
|---|---|---|---|---|---|---|
| Badanie 1 | ✓ | ✓ | ✓ | ✓ | ||
| Badanie 2 | ✓ | ✓ | ✓ | |||
| Badanie 3 | ✓ | ✓ | ✓ | ✓ | ||
| Badanie 4 | ✓ | ✓ | ✓ | |||
| Badanie 5 | ✓ | ✓ | ✓ | ✓ | ✓ |
Już tak prosta macierz pokazuje strukturę rozdziału (osobne podrozdziały o wsparciu rówieśników i rodziny), wątki dobrze zbadane (wyczerpanie) i luki (mało badań podłużnych, mało prób polskich). Porównaj dwa sposoby pisania o tych samych pracach:
| Źle: streszczenia po kolei | Dobrze: synteza wokół wątku |
|---|---|
| „Autor A (rok) przebadał studentów medycyny i stwierdził związek wsparcia z wyczerpaniem. Autor B (rok) zbadał studentów psychologii. Autor C (rok) również wykazał związek wsparcia z wypaleniem.” | „Związek wsparcia rówieśników z wyczerpaniem jest najlepiej udokumentowanym wątkiem: wskazują na niego badania z różnych kierunków studiów [Badania 1, 2, 4, 5], w tym dwa podłużne, które pozwalają ocenić kolejność zmian [Badania 2, 5]. Żadne z badań podłużnych nie objęło jednak studentów w Polsce – polskie próby pochodzą wyłącznie z badań przekrojowych [Badania 3, 4].” |
Przy każdym wątku sformułuj wniosek wprost. Baumeister i Leary (1997) wskazują, że przegląd może zakończyć się jedną z czterech konkluzji: hipoteza jest prawdziwa, jest najlepszym obecnym przypuszczeniem, jest fałszywa albo dowody nie pozwalają jej rozstrzygnąć. Taki „werdykt” porządkuje rozdział i od razu pokazuje, gdzie jest miejsce na Twoje badanie. Przy ocenie siły dowodów bierz pod uwagę liczebność prób, schemat badań i to, czy wyniki się replikowały – po doświadczeniach kryzysu replikacyjnego pojedynczy efekt z małej próby to za mało na „pewny” wniosek. Gdy porównujesz teorie, zapytaj, jaki wynik byłby z nimi sprzeczny: teoria, której nie da się obalić żadnym wynikiem, nie jest falsyfikowalna. Wyniki pojedynczych badań przytaczaj w spójnym zapisie statystycznym – gotowe formuły znajdziesz w poradniku jak opisać wyniki w stylu APA.
Krok 6. Struktura rozdziału i opis metody przeglądu
Rozdział teoretyczny pracy empirycznej ma zwykle taki układ:
- Wprowadzenie – cel i zakres przeglądu (co obejmuje, czego nie).
- Metoda przeglądu – bazy, daty, słowa kluczowe, kryteria (przy przeglądzie systematycznym: osobny podrozdział z diagramem PRISMA).
- Pojęcia i ich pomiar – definicje i operacjonalizacje kluczowych zmiennych.
- Teorie – modele wyjaśniające związek, z ich przewidywaniami.
- Wyniki badań według wątków – kolejne podrozdziały z macierzy pojęć, każdy zakończony wnioskiem.
- Podsumowanie i luka – co wiadomo, czego nie wiadomo i dlaczego Twoje badanie to uzupełnia.
- Pytania badawcze i hipotezy – bezpośrednio wyprowadzone z luki.
Hipotezy na końcu rozdziału teoretycznego są punktem wyjścia dla rozdziału metodologicznego. Opis metody przeglądu może być krótki – wystarczy jeden akapit:
Cytuj według stylu APA i tylko prace, które przeczytałeś – przynajmniej w postaci abstraktu, a przy kluczowych tezach w całości.
AI w przeglądzie literatury: co mówią badania
Narzędzia AI mogą przyspieszać poszczególne etapy przeglądu, ale ich ocena naukowa jest wciąż na wczesnym etapie. Przegląd zakresu 37 prac pokazał, że modele językowe (w 89% z rodziny GPT) testowano w 10 z 13 etapów przeglądu systematycznego – najczęściej przy wyszukiwaniu, selekcji badań i ekstrakcji danych – ale w pełni zwalidowanych zastosowań wciąż brakuje (Lieberum i in., 2025). Wyniki poniżej dotyczą konkretnych modeli i zbiorów danych, więc traktuj je jako przykłady, a nie ogólną „skuteczność AI”.
Selekcja z aktywnym uczeniem
Najlepiej udokumentowane jest wsparcie selekcji tytułów i abstraktów. ASReview to otwartoźródłowe narzędzie z aktywnym uczeniem maszynowym: model uczy się na Twoich decyzjach i podsuwa najpierw rekordy, które najprawdopodobniej są trafne. W symulacjach pozwalało przesiewać znacznie wydajniej niż ręcznie, przy zachowaniu wysokiej jakości (van de Schoot i in., 2021). Zasadę działania – i jej główny haczyk – pokazuje rysunek 1.
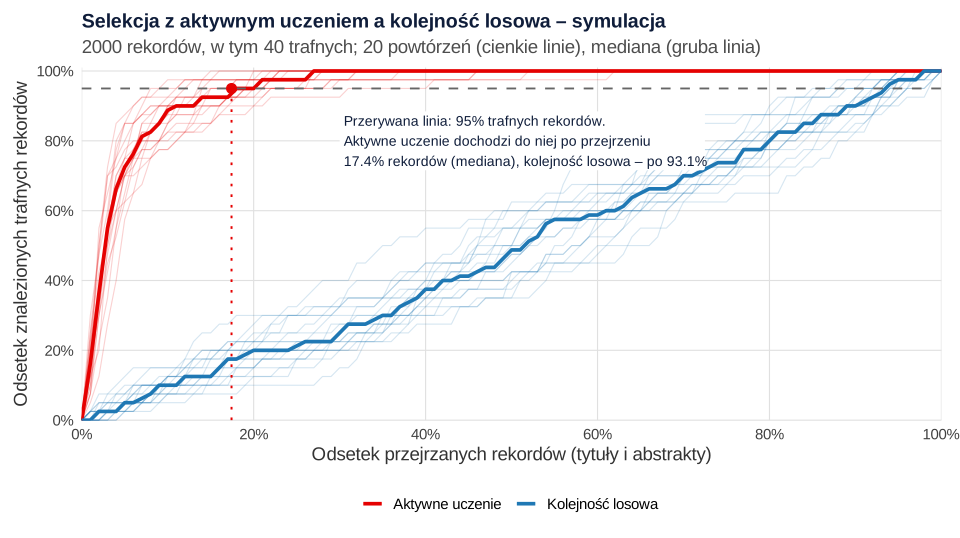
W tej symulacji aktywne uczenie znajdowało 95% trafnych rekordów po przejrzeniu 17.4% wszystkich (mediana z 20 powtórzeń), a selekcja w kolejności losowej – dopiero po 93.1%. Po przejrzeniu 10% rekordów aktywne uczenie znajdowało już 88.8% trafnych (mediana). Haczyk tkwi w końcówce: ostatnie trafne rekordy pojawiają się późno, a Ty nie wiesz, ile ich jeszcze zostało. Prosta reguła zatrzymania „przerwij po 100 nietrafnych rekordach z rzędu” kończyła pracę po 18.6% rekordów, ale w 17 z 20 powtórzeń pomijała co najmniej jeden trafny rekord (mediana znalezionych: 96.2%). Jeśli używasz takiego narzędzia, z góry ustal regułę zatrzymania i opisz ją w metodzie – na przykład jako ograniczenie przeglądu.
Modele językowe w selekcji i ekstrakcji
- W prospektywnym badaniu GPT-4 Turbo przesiewał tytuły i abstrakty z czułością 75% (91% po modyfikacji promptu) i swoistością ok. 98–99%, skracając czas przesiewu 100 rekordów z 17.2 do 1.3 minuty (Oami i in., 2024). Czułość 75% oznacza jednak, że co czwarty trafny rekord zostałby odrzucony.
- W prerejestrowanym badaniu GPT-4 dorównywał ludziom w niektórych zadaniach, ale po korekcie na zgodność przypadkową wyniki spadały: przy ekstrakcji danych do umiarkowanej zgodności, przy przesiewaniu – od braku do umiarkowanej. Autorzy zalecają dużą ostrożność w używaniu modeli językowych w przeglądach systematycznych (Khraisha i in., 2024).
- Gdy model odpowiada „z pamięci”, zmyśla cytowania: w benchmarku ScholarQABench GPT-4o halucynował cytowania w 78–90% przypadków, a OpenScholar – model przeszukujący 45 mln artykułów open access – osiągał trafność cytowań porównywalną z ekspertami (Asai i in., 2026). Więcej o tym zjawisku w haśle halucynacje AI w bibliografii.
Organizacje, które wyznaczają standardy przeglądów – Cochrane, Campbell Collaboration, JBI i Collaboration for Environmental Evidence – dopuszczają AI w syntezie dowodów pod nadzorem człowieka, jeśli autorzy wykażą, że nie obniża to rygoru. Każde użycie AI, które podejmuje lub sugeruje decyzje, musi być w pełni opisane w raporcie, zgodnie z zaleceniami RAISE dotyczącymi odpowiedzialnego użycia AI w syntezie dowodów (Flemyng i in., 2025).
| Etap | W czym AI może pomóc | Na co uważać |
|---|---|---|
| Pytanie i słowa kluczowe | Synonimy, angielskie odpowiedniki pojęć, pomysły na bloki zapytania | Model nie zna literatury Twojej dziedziny – „luki w wiedzy” z czatu sprawdź w bazach |
| Wyszukiwanie | Zapis zapytania z operatorami Boole’a | Składnia baz się różni; przetestuj zapytanie w bazie |
| Selekcja | Priorytetyzacja rekordów (aktywne uczenie) | Decyzje podejmujesz Ty; ustal i opisz regułę zatrzymania |
| Ekstrakcja | Wstępne wypełnienie tabeli z tekstu, który masz | Pominięcia i błędy w liczbach – sprawdź każdą wartość w źródle |
| Synteza i pisanie | Porządkowanie notatek, redakcja językowa własnego tekstu | Interpretacja i wnioski muszą być Twoje; zmyślone cytowania |
| Bibliografia | Formatowanie rekordów pobranych z baz | Nigdy nie generuj listy źródeł – sprawdź każdą pozycję |
Co AI może, a czego nie powinno robić w Twojej pracy
Granica nie przebiega między „z AI” a „bez AI”, lecz między wsparciem a zastąpieniem Twojej pracy intelektualnej. Zasady zależą od uczelni – sprawdź regulamin i uzgodnij zakres z promotorem.
| Zwykle dopuszczalne (z opisem w pracy) | Niedopuszczalne |
|---|---|
| Szukanie synonimów i budowa zapytania do baz | Lista literatury wygenerowana przez czat zamiast wyszukiwania |
| Priorytetyzacja rekordów w narzędziu typu ASReview, przy Twoich decyzjach | Cytowanie prac, których nie przeczytałeś |
| Tłumaczenie fragmentów anglojęzycznych prac na własny użytek | Cytowanie odpowiedzi czatu jako źródła wiedzy naukowej |
| Korekta językowa tekstu, który napisałeś | Rozdział lub synteza wygenerowane przez AI i przedstawione jako własne |
| Pomoc w uporządkowaniu własnych notatek | Wklejanie danych osobowych lub niepublikowanych materiałów do publicznych narzędzi |
Każde użycie AI opisz w pracy – gotowe warianty deklaracji znajdziesz w poradniku jak opisać użycie AI w pracy dyplomowej, a szersze tło etyczne w tekście o AI w pisaniu publikacji naukowych. Każdą pozycję bibliografii, przy której pomagało AI, sprawdź według procedury z poradnika jak sprawdzić, czy AI nie zmyśliło bibliografii.
W projektach naukowych poza pracą dyplomową – artykułach, grantach, rozprawach – coraz częściej korzysta się z systemów, które wyszukują i czytają setki publikacji, a odwołania biorą z przeczytanych tekstów. Tak działają nasze evidence-based drafty AI, oddawane z pełnym zestawem źródeł i notatek do weryfikacji. W pracy dyplomowej taki materiał może być co najwyżej punktem wyjścia do własnej lektury – za zgodą promotora i z ujawnieniem w deklaracji. Tekst rozdziału i wnioski muszą być Twoje.
Checklista przed oddaniem rozdziału
[ ] Przeszukano co najmniej dwie bazy; zapisano daty, pełne zapytania i liczby wyników.
[ ] Szukano także poza czasopismami (bibliografie prac, preprinty, rozprawy).
[ ] Przy pełnych tekstach zapisano powód każdego wykluczenia.
[ ] Każde włączone badanie ma wiersz w tabeli ekstrakcji z wielkością efektu, schematem i narzędziami pomiaru.
[ ] Rozdział jest zorganizowany wokół wątków z macierzy pojęć, a nie wokół kolejnych autorów.
[ ] Każdy wątek kończy się wnioskiem o sile dowodów.
[ ] Z luki w literaturze wynikają pytania badawcze i hipotezy.
[ ] Wnioski przyczynowe formułowano tylko na podstawie odpowiednich schematów badań.
[ ] Każde odwołanie sprawdzono w bazie, a cytowane prace przeczytano.
[ ] Użycie AI opisano w deklaracji zgodnie z zasadami uczelni.
Najczęstsze błędy w przeglądzie literatury
- Streszczanie autor po autorze – czytelnik musi sam wykonać syntezę. Organizuj tekst wokół wątków, a nie nazwisk.
- Liczenie badań „istotnych” i „nieistotnych” – małe badanie bez istotnego wyniku nie przeczy dużemu badaniu z wynikiem istotnym. Porównuj wielkości efektów.
- Cytowanie z drugiej ręki bez lektury – jeśli znasz pracę tylko z cudzego przeglądu, napisz to („cyt. za”) albo dotrzyj do oryginału.
- Dobieranie literatury pod wyniki – rozdział teoretyczny pisany po analizie danych kusi, by pominąć prace, które do nich nie pasują (Rubin, 2017).
- Brak opisu wyszukiwania – bez baz, dat i słów kluczowych nie da się ocenić, czy przegląd jest kompletny.
- Nazywanie przeglądu narracyjnego systematycznym – opisz metodę uczciwie; przegląd z elementami metodologii systematycznej to w pracy dyplomowej mocna strona, a nie słabość.
- Wnioski przyczynowe z badań korelacyjnych – „wsparcie chroni przed wypaleniem” to inna teza niż „wsparcie wiąże się z niższym wypaleniem”.
- Niezweryfikowane odwołania od AI – jedna nieistniejąca praca w bibliografii podważa wiarygodność całego rozdziału.
Najczęstsze pytania
Ile źródeł powinien mieć przegląd literatury w pracy magisterskiej?
Nie ma jednej liczby. Ważniejsze od liczby pozycji jest to, czy przegląd obejmuje kluczowe badania i najnowsze przeglądy lub metaanalizy dla Twojego pytania. W przeglądzie z opisaną metodą liczbę prac wyznacza wynik wyszukiwania i kryteria włączenia; oczekiwania co do zakresu uzgodnij z promotorem.
Czym różni się przegląd systematyczny od narracyjnego?
Przegląd narracyjny to synteza literatury dobranej przez autora, często szersza i bardziej interpretacyjna. Przegląd systematyczny ma protokół, udokumentowane wyszukiwanie w kilku bazach, kryteria włączenia, selekcję w dwóch etapach i ocenę jakości badań, a raportuje się go według PRISMA 2020.
Czy mogę użyć ChatGPT do napisania przeglądu literatury?
Do pomocy przy słowach kluczowych, tłumaczeniu czy korekcie językowej – zwykle tak, jeśli pozwalają na to zasady uczelni i opiszesz to w pracy. Nie używaj go jako źródła listy literatury ani do pisania syntezy za Ciebie: modele językowe zmyślają odwołania, a rozdział przedstawiony jako własny musi być Twój.
Jak opisać metodę przeglądu literatury w pracy?
Podaj bazy, daty wyszukiwania, słowa kluczowe i operatory, kryteria włączenia i wykluczenia, sposób selekcji oraz liczbę zidentyfikowanych i włączonych prac. W pracy dyplomowej zwykle wystarcza jeden akapit, a pełne zapytania możesz umieścić w aneksie.
Jakie bazy przeszukać w psychologii?
Podstawą jest APA PsycInfo; uzupełnij ją o Scopus lub Web of Science, przy tematach zdrowotnych o PubMed, a przy literaturze polskiej o BazHum i CEJSH. Google Scholar przydaje się do sprawdzania cytowań i szukania pełnych tekstów, ale nie powinien być jedyną bazą.
Co to jest macierz pojęć w przeglądzie literatury?
To tabela, w której wiersze są badaniami, a kolumny pojęciami, wątkami lub cechami metody. Pokazuje, które wątki są dobrze zbadane, gdzie są luki i jak podzielić rozdział na podrozdziały – dzięki niej piszesz syntezę wokół wątków zamiast streszczeń kolejnych prac.
Powiązane hasła
Przeczytaj też
Jak sprawdzić, czy AI nie zmyśliło bibliografii
Ile odwołań zmyślają modele językowe i jak w sześciu krokach sprawdzić każdą pozycję: DOI, Crossref, OpenAlex, abstrakt. Z przykładem, kodem R i checklistą.
Czytaj →PoradnikJak opisać użycie AI w pracy dyplomowej – wzór deklaracji
Sześć gotowych wariantów deklaracji, tabela „kiedy i gdzie”, cytowanie AI w APA, dziennik promptów i przykładowe zasady uczelni.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Asai, A., He, J., Shao, R., Shi, W., Singh, A., Chang, J. C., Lo, K., Soldaini, L., Feldman, S., D'Arcy, M., Wadden, D., Latzke, M., Sparks, J., Hwang, J. D., Kishore, V., Tian, M., Ji, P., Liu, S., Tong, H., . . . Hajishirzi, H. (2026). Synthesizing scientific literature with retrieval-augmented language models. Nature, 650(8103), 857–863. https://doi.org/10.1038/s41586-025-10072-4 ● Otwarty dostęp
- Baumeister, R. F., & Leary, M. R. (1997). Writing narrative literature reviews. Review of General Psychology, 1(3), 311–320. https://doi.org/10.1037/1089-2680.1.3.311
- Flemyng, E., Noel-Storr, A., Macura, B., Gartlehner, G., Thomas, J., Meerpohl, J. J., Jordan, Z., Minx, J., Eisele-Metzger, A., Hamel, C., Jemioło, P., Porritt, K., & Grainger, M. (2025). Position statement on artificial intelligence (AI) use in evidence synthesis across Cochrane, the Campbell Collaboration, JBI, and the Collaboration for Environmental Evidence 2025. Campbell Systematic Reviews, 21(4), Article e70074. https://doi.org/10.1002/cl2.70074 ● Otwarty dostęp
- Grant, M. J., & Booth, A. (2009). A typology of reviews: An analysis of 14 review types and associated methodologies. Health Information & Libraries Journal, 26(2), 91–108. https://doi.org/10.1111/j.1471-1842.2009.00848.x ● Otwarty dostęp: pełny tekst
- Khraisha, Q., Put, S., Kappenberg, J., Warraitch, A., & Hadfield, K. (2024). Can large language models replace humans in systematic reviews? Evaluating GPT-4's efficacy in screening and extracting data from peer-reviewed and grey literature in multiple languages. Research Synthesis Methods, 15(4), 616–626. https://doi.org/10.1002/jrsm.1715 ● Otwarty dostęp
- Lieberum, J.-L., Toews, M., Metzendorf, M.-I., Heilmeyer, F., Siemens, W., Haverkamp, C., Böhringer, D., Meerpohl, J. J., & Eisele-Metzger, A. (2025). Large language models for conducting systematic reviews: On the rise, but not yet ready for use—a scoping review. Journal of Clinical Epidemiology, 181, Article 111746. https://doi.org/10.1016/j.jclinepi.2025.111746 ● Otwarty dostęp
- Munn, Z., Peters, M. D. J., Stern, C., Tufanaru, C., McArthur, A., & Aromataris, E. (2018). Systematic review or scoping review? Guidance for authors when choosing between a systematic or scoping review approach. BMC Medical Research Methodology, 18(1), Article 143. https://doi.org/10.1186/s12874-018-0611-x ● Otwarty dostęp
- Oami, T., Okada, Y., & Nakada, T.-a. (2024). Performance of a large language model in screening citations. JAMA Network Open, 7(7), Article e2420496. https://doi.org/10.1001/jamanetworkopen.2024.20496 ● Otwarty dostęp
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., . . . Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71 ● Otwarty dostęp
- Rubin, M. (2017). When does HARKing hurt? Identifying when different types of undisclosed post hoc hypothesizing harm scientific progress. Review of General Psychology, 21(4), 308–320. https://doi.org/10.1037/gpr0000128 ● Otwarty dostęp
- Siddaway, A. P., Wood, A. M., & Hedges, L. V. (2019). How to do a systematic review: A best practice guide for conducting and reporting narrative reviews, meta-analyses, and meta-syntheses. Annual Review of Psychology, 70(1), 747–770. https://doi.org/10.1146/annurev-psych-010418-102803
- Snyder, H. (2019). Literature review as a research methodology: An overview and guidelines. Journal of Business Research, 104, 333–339. https://doi.org/10.1016/j.jbusres.2019.07.039 ● Otwarty dostęp
- van de Schoot, R., de Bruin, J., Schram, R., Zahedi, P., de Boer, J., Weijdema, F., Kramer, B., Huijts, M., Hoogerwerf, M., Ferdinands, G., Harkema, A., Willemsen, J., Ma, Y., Fang, Q., Hindriks, S., Tummers, L., & Oberski, D. L. (2021). An open source machine learning framework for efficient and transparent systematic reviews. Nature Machine Intelligence, 3(2), 125–133. https://doi.org/10.1038/s42256-020-00287-7 ● Otwarty dostęp
- Webster, J., & Watson, R. T. (2002). Analyzing the past to prepare for the future: Writing a literature review. MIS Quarterly, 26(2), xiii–xxiii. https://doi.org/10.2307/4132319 ● Otwarty dostęp
Cytowania BibTeX
@article{asai2026synthesizing, author={Asai, Akari and He, Jacqueline and Shao, Rulin and Shi, Weijia and Singh, Amanpreet and Chang, Joseph Chee and Lo, Kyle and Soldaini, Luca and Feldman, Sergey and D'Arcy, Mike and Wadden, David and Latzke, Matt and Sparks, Jenna and Hwang, Jena D. and Kishore, Varsha and Tian, Minyang and Ji, Pan and Liu, Shengyan and Tong, Hao and Wu, Bohao and Xiong, Yanyu and Zettlemoyer, Luke and Neubig, Graham and Weld, Daniel S. and Downey, Doug and Yih, Wen-tau and Koh, Pang Wei and Hajishirzi, Hannaneh}, title={{Synthesizing scientific literature with retrieval-augmented language models}}, journal={Nature}, year={2026}, volume={650}, number={8103}, pages={857--863}, doi={10.1038/s41586-025-10072-4}}@article{baumeister1997writing, author={Baumeister, Roy F. and Leary, Mark R.}, title={{Writing narrative literature reviews}}, journal={Review of General Psychology}, year={1997}, volume={1}, number={3}, pages={311--320}, doi={10.1037/1089-2680.1.3.311}}@article{flemyng2025position, author={Flemyng, Ella and Noel-Storr, Anna and Macura, Biljana and Gartlehner, Gerald and Thomas, James and Meerpohl, Joerg J. and Jordan, Zoe and Minx, Jan and Eisele-Metzger, Angelika and Hamel, Candyce and Jemioło, Paweł and Porritt, Kylie and Grainger, Matthew}, title={{Position statement on artificial intelligence (AI) use in evidence synthesis across Cochrane, the Campbell Collaboration, JBI, and the Collaboration for Environmental Evidence 2025}}, journal={Campbell Systematic Reviews}, year={2025}, volume={21}, number={4}, eid={e70074}, doi={10.1002/cl2.70074}}@article{grant2009typology, author={Grant, Maria J. and Booth, Andrew}, title={{A typology of reviews: An analysis of 14 review types and associated methodologies}}, journal={Health Information \& Libraries Journal}, year={2009}, volume={26}, number={2}, pages={91--108}, doi={10.1111/j.1471-1842.2009.00848.x}}@article{khraisha2024can, author={Khraisha, Qusai and Put, Sophie and Kappenberg, Johanna and Warraitch, Azza and Hadfield, Kristin}, title={{Can large language models replace humans in systematic reviews? Evaluating GPT-4's efficacy in screening and extracting data from peer-reviewed and grey literature in multiple languages}}, journal={Research Synthesis Methods}, year={2024}, volume={15}, number={4}, pages={616--626}, doi={10.1002/jrsm.1715}}@article{lieberum2025large, author={Lieberum, Judith-Lisa and Toews, Markus and Metzendorf, Maria-Inti and Heilmeyer, Felix and Siemens, Waldemar and Haverkamp, Christian and Böhringer, Daniel and Meerpohl, Joerg J. and Eisele-Metzger, Angelika}, title={{Large language models for conducting systematic reviews: On the rise, but not yet ready for use—a scoping review}}, journal={Journal of Clinical Epidemiology}, year={2025}, volume={181}, eid={111746}, doi={10.1016/j.jclinepi.2025.111746}}@article{munn2018systematic, author={Munn, Zachary and Peters, Micah D. J. and Stern, Cindy and Tufanaru, Catalin and McArthur, Alexa and Aromataris, Edoardo}, title={{Systematic review or scoping review? Guidance for authors when choosing between a systematic or scoping review approach}}, journal={BMC Medical Research Methodology}, year={2018}, volume={18}, number={1}, eid={143}, doi={10.1186/s12874-018-0611-x}}@article{oami2024performance, author={Oami, Takehiko and Okada, Yohei and Nakada, Taka-aki}, title={{Performance of a large language model in screening citations}}, journal={JAMA Network Open}, year={2024}, volume={7}, number={7}, eid={e2420496}, doi={10.1001/jamanetworkopen.2024.20496}}@article{page2021prisma, author={Page, Matthew J and McKenzie, Joanne E and Bossuyt, Patrick M and Boutron, Isabelle and Hoffmann, Tammy C and Mulrow, Cynthia D and Shamseer, Larissa and Tetzlaff, Jennifer M and Akl, Elie A and Brennan, Sue E and Chou, Roger and Glanville, Julie and Grimshaw, Jeremy M and Hróbjartsson, Asbjørn and Lalu, Manoj M and Li, Tianjing and Loder, Elizabeth W and Mayo-Wilson, Evan and McDonald, Steve and McGuinness, Luke A and Stewart, Lesley A and Thomas, James and Tricco, Andrea C and Welch, Vivian A and Whiting, Penny and Moher, David}, title={{The PRISMA 2020 statement: An updated guideline for reporting systematic reviews}}, journal={BMJ}, year={2021}, volume={372}, eid={n71}, doi={10.1136/bmj.n71}}@article{rubin2017when, author={Rubin, Mark}, title={{When does HARKing hurt? Identifying when different types of undisclosed post hoc hypothesizing harm scientific progress}}, journal={Review of General Psychology}, year={2017}, volume={21}, number={4}, pages={308--320}, doi={10.1037/gpr0000128}}@article{siddaway2019how, author={Siddaway, Andy P. and Wood, Alex M. and Hedges, Larry V.}, title={{How to do a systematic review: A best practice guide for conducting and reporting narrative reviews, meta-analyses, and meta-syntheses}}, journal={Annual Review of Psychology}, year={2019}, volume={70}, number={1}, pages={747--770}, doi={10.1146/annurev-psych-010418-102803}}@article{snyder2019literature, author={Snyder, Hannah}, title={{Literature review as a research methodology: An overview and guidelines}}, journal={Journal of Business Research}, year={2019}, volume={104}, pages={333--339}, doi={10.1016/j.jbusres.2019.07.039}}@article{vandeschoot2021open, author={van de Schoot, Rens and de Bruin, Jonathan and Schram, Raoul and Zahedi, Parisa and de Boer, Jan and Weijdema, Felix and Kramer, Bianca and Huijts, Martijn and Hoogerwerf, Maarten and Ferdinands, Gerbrich and Harkema, Albert and Willemsen, Joukje and Ma, Yongchao and Fang, Qixiang and Hindriks, Sybren and Tummers, Lars and Oberski, Daniel L.}, title={{An open source machine learning framework for efficient and transparent systematic reviews}}, journal={Nature Machine Intelligence}, year={2021}, volume={3}, number={2}, pages={125--133}, doi={10.1038/s42256-020-00287-7}}@article{webster2002analyzing, author={Webster, Jane and Watson, Richard T.}, title={{Analyzing the past to prepare for the future: Writing a literature review}}, journal={MIS Quarterly}, year={2002}, volume={26}, number={2}, pages={xiii--xxiii}, doi={10.2307/4132319}}