„Dużo tu nazwisk, ale co z tego wynika?”
Promotor oddaje rozdział z takim pytaniem na marginesie. Akapit wygląda poprawnie: osiem badań, każde z rokiem i wynikiem. Czytelnik wie jednak tylko, co zrobił każdy z autorów. Nie wie, co z tego razem wynika. Tak działa streszczanie autor po autorze: spis przeczytanych prac zamiast argumentu.
Cały proces przeglądu – pytanie, bazy, selekcję, tabelę ekstrakcji, układ rozdziału – opisuje poradnik jak napisać przegląd literatury. Tu zajmujemy się jednym etapem: momentem, gdy masz już przeczytane artykuły i piszesz o nich zdania. Zaczynamy od tabeli, kończymy na gotowym akapicie, po drodze omawiając sprzeczne wyniki, czasowniki, cytowanie z drugiej ręki i parafrazę. Wpis uzupełniają teksty o wyprowadzaniu hipotezy z teorii i o luce badawczej – to do nich prowadzi dobra synteza.
Przykład przewodni (w całości fikcyjny). Studentka pisze o związku korzystania z mediów społecznościowych z samotnością młodych dorosłych. Ma osiem badań, oznaczonych tu literami. Nie opisują one żadnych rzeczywistych prac ani stanu wiedzy na ten temat, a wyniki pochodzą z symulacji w kodzie na końcu wpisu.
Streszczenie a synteza: kto jest podmiotem zdania
Najprostszy test: podkreśl podmioty w swoim akapicie. Jeśli są to „Kowalski”, „Nowak” i „autorzy”, streszczasz. Jeśli „związek”, „wyniki badań podłużnych” albo „pomiar czasu korzystania”, syntetyzujesz. Autorzy nie znikają, przenoszą się do nawiasu.
Synteza dodaje coś, czego nie ma w żadnym pojedynczym artykule: porównanie. To od niej zależy, czy przegląd spełni zadania, które Webster i Watson (2002) mu przypisują: stworzy podstawę dla dalszej wiedzy i pokaże obszary wymagające badań. Rysunek 1 pokazuje drogę od notatek do akapitu.
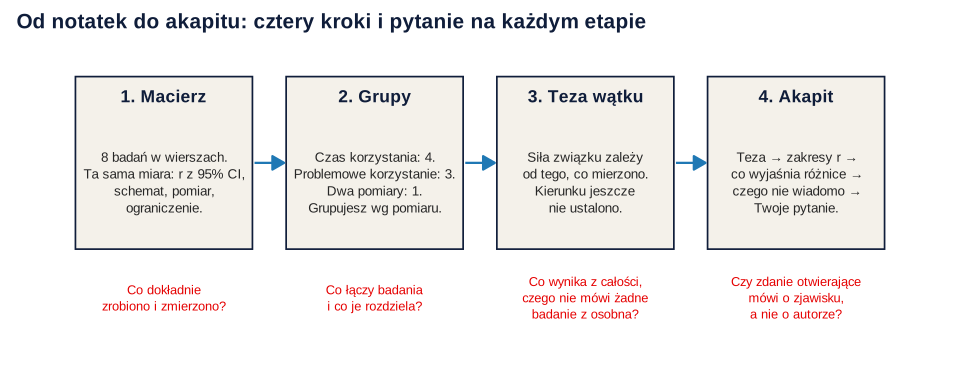
Macierz literatury: każde badanie w jednym wierszu
Macierz literatury to tabela, w której wiersz odpowiada badaniu, a kolumny cechom, po których chcesz je porównywać. Przeglądowy poradnik pokazuje prostą macierz pojęć z „ptaszkami”, która podpowiada układ rozdziału. Do pisania akapitów potrzeba więcej: liczb i słabych stron.
Plik do pobrania: macierz-literatury-szablon.xlsx – pusta macierz z 18 kolumnami i listami wyboru, wypełniony fikcyjny przykład oraz arkusz „synteza” na tezy wątków. Tabela poniżej to jego skrócona wersja.
| Źródło | n, próba | Schemat | Pomiar korzystania | r [95% CI] | p | Główne ograniczenie |
|---|---|---|---|---|---|---|
| Badanie A | 412, studenci | przekrojowy | czas: samoopis | .05 [−.05, .14] | .320 | dobór wygodny, jedna uczelnia |
| Badanie B | 86, studenci | przekrojowy | czas: samoopis | −.02 [−.23, .19] | .844 | mała próba, szeroki przedział |
| Badanie C | 1240, panel 18–29 lat | przekrojowy | czas: samoopis | .13 [.08, .19] | < .001 | jedno pytanie o czas |
| Badanie D | 118, studenci | przekrojowy | czas: dane z telefonu | .18 [−.00, .35] | .051 | bez rozróżnienia aplikacji |
| Badanie E | 356, młodzi dorośli | przekrojowy | problemowe korzystanie: skala | .29 [.19, .38] | < .001 | samoopis obu zmiennych |
| Badanie F | 204, studenci | przekrojowy | problemowe korzystanie: skala | .47 [.35, .57] | < .001 | rekrutacja przez media społecznościowe |
| Badanie G | 95, studenci | przekrojowy | problemowe korzystanie: skala | .39 [.20, .55] | < .001 | mała próba, jedna uczelnia |
| Badanie H | 278, młodzi dorośli | podłużny, 2 pomiary | problemowe korzystanie: skala | .14 [.02, .25]* | .024 | dwa pomiary nie ustalają mechanizmu |
* Korelacja cząstkowa: korzystanie w pierwszym pomiarze a samotność w drugim, po uwzględnieniu samotności w pierwszym. Pozostałe wartości to korelacje z jednego pomiaru. Badania i liczby są fikcyjne (dane symulowane).
Cztery zasady, dzięki którym tabela przyda się przy pisaniu:
- Jedna miara efektu w jednej kolumnie. Tu korelacja Pearsona z przedziałem ufności. Gdy artykuły podają różne miary, sprawdź, czy i jak je przeliczyć (porównanie wyników z literaturą).
- Ograniczenie wpisuj własnymi słowami. Najważniejsze dla Twojego pytania, nie to, które autorzy wymienili jako pierwsze.
- Kolumna „wątek”. Jeśli badania nie da się przypisać do żadnego wątku, być może nie jest potrzebne w tekście.
- Kolumna „czy przeczytano oryginał”. Ma wartości „tak, całość”, „tylko abstrakt”, „nie, cytat za innym źródłem”. Przy pisaniu od razu widzisz, o czym możesz wypowiadać się pewnie.
Jak pogrupować badania
Posortuj macierz po kolejnych kolumnach i szukaj układu, w którym różnice w wynikach pokrywają się z jakąś cechą badań. Grupowanie jest decyzją, którą trzeba uzasadnić. W wytycznych SWiM dla przeglądów interwencji bez metaanalizy opisanie grup i podanie ich uzasadnienia jest pierwszym z dziewięciu punktów raportowania, a kolejne dotyczą m.in. wspólnej miary, badania niejednorodności i ograniczeń syntezy (Campbell i in., 2020). Praca dyplomowa zwykle nie musi spełniać tych wytycznych, ale warto zadać sobie te same pytania.
| Grupuj według | Kiedy to działa | Zdanie otwierające (wzór) |
|---|---|---|
| Zgodności wyników | Większość badań mówi to samo, a kilka odstaje | „Większość badań wskazuje na […], wyjątkiem są prace, w których […]” |
| Populacji | Efekt może zależeć od wieku, kraju, stanu zdrowia | „Związek ten opisano głównie u […], natomiast u […] jest on słabszy” |
| Pomiaru | Tę samą nazwę zmiennej mierzono różnymi metodami (operacjonalizacja) | „Wyniki zależą od tego, czy mierzono […], czy […]” |
| Schematu | Są obok siebie badania z jednym pomiarem, podłużne i eksperymenty | „Dane przekrojowe wskazują na […], lecz nieliczne badania podłużne […]” |
| Teorii | Wyniki rozstrzygają między wyjaśnieniami (zob. jak wyprowadzić hipotezę z teorii) | „Teoria X przewiduje […], Y – […]; dostępne wyniki są bliższe […]” |
Wybierz taki podział, który prowadzi do Twojego pytania badawczego. W przykładzie najwięcej wyjaśnia pomiar, więc jest główną osią wątku. Grupuj według z góry widocznej cechy badań, nie według tego, czy wynik pasuje do Twojej hipotezy.
Jak opisać sprzeczne wyniki
Pokusa jest duża: pięć badań „za”, trzy „przeciw”, więc „wyniki są niejednoznaczne”. Hedges i Olkin (1980) opisują to podejście: efekt uznaje się za obecny, gdy duża część badań daje wynik istotny statystycznie. Problem w tym, że o istotności decyduje nie tylko siła związku, lecz także liczebność.
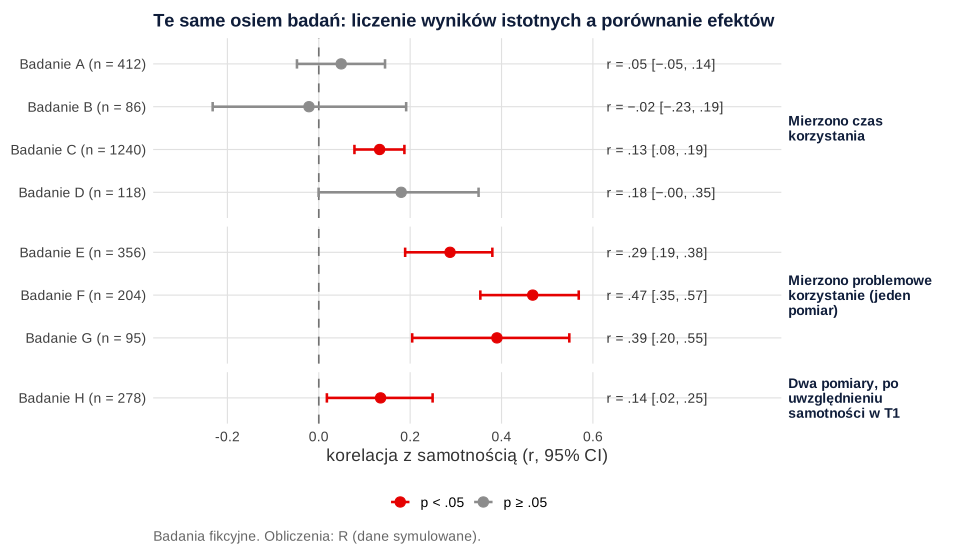
Licząc głosy, dostajesz 5 wyników istotnych na 8 (rysunek 2). Popatrz jednak na badania C i D. W C związek jest słabszy (r = .13, n = 1240, p < .001) niż w D (r = .18, n = 118, p = .051), a to właśnie C jest istotne. Te dwa wyniki nie są sprzeczne: test różnicy dwóch korelacji daje z = 0.50, p = .619. Gdyby prawdziwa korelacja wynosiła .13, badanie o liczebności 118 osiągnęłoby wynik istotny tylko w około 30% przypadków (moc testu .30), a badanie o liczebności 1240 – niemal zawsze. Wynik nieistotny w małym badaniu nie jest dowodem przeciw wynikowi istotnemu w dużym. Z tych samych powodów nie pisz, że badanie „nie wykazało związku”, jak gdyby związek wykluczyło (jak opisać wynik nieistotny).
Prawdziwa rozbieżność jest gdzie indziej: korelacje w grupie „czas” wynoszą od −.02 do .18, a w grupie „problemowe korzystanie” od .29 do .47. Żadne badanie z pierwszej grupy nie przekracza .18, a żadne z drugiej nie schodzi poniżej .29. Gdy widzisz taki układ, opisz niezgodność w czterech ruchach:
- Nazwij ją precyzyjnie. Na czym polega: kierunek, siła, a może tylko istotność?
- Pokaż skalę. Podaj zakres efektów i liczebności, a nie liczbę prac „za” i „przeciw”.
- Sprawdź wyjaśnienia: próba, pomiar, schemat, zmienne kontrolne, czas badania, efekt szuflady. Dla kilkunastu badań formalnym sprawdzeniem jest metaregresja, w pracy dyplomowej zwykle wystarczy opis.
- Oddziel ustalenie od przypuszczenia. Grupy różnią się pomiarem, ale mogą różnić się też czymś innym. Porównanie gotowych badań nie pokazuje, co jest przyczyną różnicy.
Wielkości efektów zamiast „wykazali”
Zdanie „Badanie C wykazało związek” nie mówi, jak silny był związek. „Związek był słaby (r = .13, 95% CI [.08, .19])” mówi. Oto proste reguły:
- Podawaj liczby tam, gdzie porównujesz. Nie przepisuj każdego wyniku. W akapicie zwykle wystarczy zakres dla grupy i liczby dla jednego lub dwóch kluczowych badań. Reszta zostaje w tabeli, którą możesz dać w załączniku.
- Nie oceniaj siły z pamięci. „Słaby” i „umiarkowany” zależą od dziedziny (wielkość efektu – interpretacja, czy korelacja .30 to dużo?).
- Gdy artykuł nie podaje efektu, policz go z dostępnych danych, jeśli to uprawnione. W przeciwnym razie napisz, że wyniku nie podano w formie umożliwiającej porównanie.
- Nie mieszaj miar bez przeliczenia. r = .30 i d = 0.30 to różne wielkości.
Czasowniki raportujące i ich siła
Wybór czasownika to decyzja o tym, jak bardzo popierasz cudze twierdzenie. Thompson i Ye (1991), analizując czasowniki w cytowaniach, pokazują, że piszący w różnym stopniu wiąże się z przytaczanym twierdzeniem albo się od niego dystansuje. Zwyczaje różnią się też między dyscyplinami: w materiale Hylanda (1999) autorzy z nauk humanistycznych i społecznych częściej niż przedstawiciele nauk ścisłych i technicznych przedstawiali cytowanych autorów jako zajmujących stanowisko wobec omawianego materiału. Poniższa tabela to praktyczne zestawienie, a nie norma – polskie odcienie tych słów są częściowo kwestią wyczucia, a Twój promotor może mieć własne preferencje.
| Czasowniki | Co komunikują | Kiedy pasują | Uwaga |
|---|---|---|---|
| badali, analizowali, porównywali | Sam fakt działania, nic o wyniku | Opis procedury | Nie zastępują informacji, co wyszło |
| odnotowali, stwierdzili, zaobserwowali | Wynik w tym badaniu, bez uogólnienia | Pojedyncze badanie, także korelacyjne, z liczbą | Najbezpieczniejszy domyślny wybór przy konkretnym wyniku |
| sugerują, wskazują | Ostrożny wniosek z wyniku | Jedno badanie lub niejednoznaczny zestaw, wnioski wykraczające poza dane | Nie przesadzaj z asekuracją: „mogą sugerować” przy pięciu zgodnych badaniach osłabia tekst bez powodu |
| wykazali, potwierdzili | Sprawa uznana przez Ciebie za ustaloną | Mocny schemat, replikacje, spójny obraz wielu prac | Przy „wykazali” bierzesz odpowiedzialność za wniosek razem z autorami |
| twierdzą, przyjmują, postulują | Stanowisko autorów, bez Twojego poparcia | Teorie, założenia, tezy sporne | „Twierdzą” brzmi zdystansowanie; używaj, gdy dystans jest zamierzony |
| udowodnili, dowiedli | Pewność, której pojedyncze badanie empiryczne nie daje | Właściwie nigdy w opisie badań empirycznych | Zamień na „wykazali” albo „stwierdzili” |
Dobierając czasownik, spójrz w kolumnę „schemat” w macierzy. Badanie z jednym pomiarem może „wskazywać na związek”, ale nie „wykazać wpływu” – to już kwestia korelacji a przyczynowości i schematu przekrojowego. Więcej zamienników zebraliśmy we wpisie język pracy naukowej.
Rozpisany akapit: z wersji źródło po źródle do syntezy
Jak bywa napisane (wszystkie dane fikcyjne):
„Badanie A przeprowadzono wśród 412 studentów i nie wykazano związku korzystania z mediów społecznościowych z samotnością. Podobnie w Badaniu B. Badanie C wykazało natomiast, że osoby korzystające dłużej są bardziej samotne. Badanie D nie wykazało związku. Badania E, F i G wykazały, że problemowe korzystanie powoduje samotność. Badanie H potwierdziło wpływ korzystania na samotność w czasie. Jak widać, wyniki badań są niespójne.”
Co jest nie tak. Podmiotami są badania, więc czytelnik musi sam je porównać. „Nie wykazano” miesza brak istotności z brakiem związku. Nie ma ani jednej wielkości efektu, więc C i D wyglądają na sprzeczne, choć nie są. „Powoduje” i „wpływ” nie mają podstawy w badaniach przekrojowych, a jedno badanie podłużne z dwoma pomiarami nie „potwierdza” przyczynowości. Ostatnie zdanie zamyka temat zamiast prowadzić do pytania.
Poprawiona wersja (nawiasy zastąp prawdziwymi cytowaniami):
Tekst jest krótszy niż osiem streszczeń, a mówi więcej. Tak pracuje każde zdanie:
| Zdanie | Funkcja | Co zastąpiło |
|---|---|---|
| 1 | Teza o zjawisku, a nie o autorze | „Badanie A przeprowadzono…” |
| 2 | Grupa czasu: zakres r, łączna liczebność | Cztery osobne streszczenia |
| 3 | Dlaczego jeden wynik był istotny: rola liczebności | „Badanie C wykazało, a D nie wykazało” |
| 4 | Druga grupa: skala problemowego korzystania | Trzy powtórzenia „wykazano” |
| 5 | Możliwe wyjaśnienie różnicy, oznaczone jako możliwe | Nic – w pierwszej wersji go nie było |
| 6 | Jedyne badanie z dwoma pomiarami i granica wniosku | „Badanie H potwierdziło wpływ” |
| 7–8 | Przejście do luki i pytania własnej pracy | „Jak widać, badania są niespójne” |
Ostatnie zdania to przejście do pytań i hipotez, które rozwija wpis o luce badawczej, a wstęp pracy tylko zapowiada (wstęp i cel pracy). Z tą samą tabelą wrócisz do dyskusji wyników, kiedy porównasz własny wynik z literaturą. Badania i liczby w akapicie są fikcyjne; w pracy zastąp je rzeczywistymi, które przeczytałeś.
Cytowanie z drugiej ręki
Natrafiasz na ciekawy wynik w przeglądzie, ale oryginału nie masz. Zgodnie z zasadami APA oryginał należy odnaleźć i przeczytać, jeśli to możliwe, a cytowania wtórnego używać oszczędnie. W tekście podajesz obie prace, a w bibliografii tylko tę, którą przeczytałeś (American Psychological Association, b.d.). Polski odpowiednik zapisu „as cited in” to najczęściej „za:” lub „cyt. za:”; formę sprawdź w wytycznych uczelni.
W bibliografii: tylko [Autor pracy, którą przeczytałeś].
Sprawa nie jest tylko formalna. W metaanalizie 28 badań nad cytowaniami w czasopismach medycznych błąd miał 25.4% cytowań, a poważny – 11.9% (Jergas i Baethge, 2015). Oznacza to, że nawet praca przywołana w artykule nie musi mówić tego, co się jej przypisuje. Z tego samego przeglądu wynika, że cytowania pośrednie stanowiły mniej niż jedną szóstą problemów, więc lektura samego oryginału też nie chroni przed błędem – trzeba jeszcze sprawdzić, czy twierdzenie w nim jest. Greenberg (2009), analizując sieć 242 prac wokół jednego twierdzenia biomedycznego, opisał, jak przez cytowania hipoteza może zamienić się w „fakt”, a prace podważające twierdzenie są pomijane.
Reguła praktyczna: o wynikach, na których opierasz hipotezę, pisz tylko po przeczytaniu oryginału. „Za:” zostaw dla informacji pobocznych i prac rzeczywiście niedostępnych. Nie przepisuj też sformułowań z cudzego przeglądu tak, jakby były Twoją lekturą.
Parafraza a kopiowanie
Parafraza to oddanie cudzej myśli własnymi słowami i własnym układem zdania, z podaniem źródła. Podmiana kilku wyrazów w cudzym zdaniu nie jest parafrazą – to wciąż zapożyczenie struktury. Roig (2010) omawia różne postacie plagiatu i autoplagiatu, ze szczególnym uwzględnieniem trudności autorów piszących w obcym języku. Podobny kłopot ma tłumaczenie angielskich zdań słowo w słowo: polski tekst może przejść kontrolę systemu antyplagiatowego, a mimo to pozostaje cudzą konstrukcją.
Fikcyjne zdanie ze źródła: „Czas spędzany w mediach społecznościowych okazał się słabym predyktorem samotności, podczas gdy kompulsywny charakter korzystania wiązał się z nią znacznie silniej.”
Podmiana słów (nie rób tak): „Czas korzystania z mediów społecznościowych był słabym predyktorem osamotnienia, natomiast kompulsywny charakter używania łączył się z nim dużo silniej [Badanie X, rok].” Układ i tok myśli są te same, zmieniły się synonimy.
Parafraza: „Liczba godzin w mediach społecznościowych niewiele mówiła o samotności; znaczenie miało raczej to, czy korzystanie wymykało się spod kontroli [Badanie X, rok].”
Technika jest prosta. Przeczytaj fragment, zamknij artykuł, zapisz myśl w macierzy (kolumna „notatka własnymi słowami”) i dopiero z niej pisz akapit. Cytat dosłowny, w cudzysłowie i ze stroną, zachowaj na definicje i sformułowania, które są przedmiotem Twojej analizy. Jak działają systemy kontroli, opisujemy we wpisie analiza statystyczna a system antyplagiatowy; szczegółowe zasady określa uczelnia.
Najczęstsze błędy
- Każdy akapit zaczyna się nazwiskiem. Zacznij od tezy, nazwisko przenieś do nawiasu.
- „Badania są niespójne” bez szczegółów. Podaj, w czym, jak bardzo i co może to wyjaśniać.
- Liczenie istotnych wyników. Porównuj efekty i przedziały, nie liczbę gwiazdek.
- „Nie wykazano związku” przy małej próbie. Podaj efekt z przedziałem albo napisz, że badanie nie pozwala tego rozstrzygnąć.
- Ten sam czasownik wszędzie. „Wykazali” przy badaniu z jednym pomiarem i przy metaanalizie to dwie różne deklaracje.
- Grupowanie po wyniku zgodnym z hipotezą. Grupuj według cech badań, a niewygodne prace omów.
- Cytat za przeglądem bez adnotacji. Czytelnik sądzi, że znasz oryginał.
- Podmiana synonimów zamiast parafrazy. Zamknij źródło, zanim zaczniesz pisać.
- Przenoszenie wniosków autorów bez oceny schematu. Sprawdź, czy dane je uzasadniają.
Lista kontrolna przed oddaniem
[ ] Wiem, po jakiej cesze grupuję badania i dlaczego.
[ ] Pierwsze zdanie akapitu jest tezą o zjawisku.
[ ] Przy porównaniach podaję wielkości efektów, a nie tylko „istotne” i „nieistotne”.
[ ] Sprzeczność opisuję precyzyjnie: co się różni, jak bardzo, co może to wyjaśniać.
[ ] Czasownik pasuje do schematu i liczby badań; nie ma „udowodnili”.
[ ] Słowa przyczynowe występują tylko przy badaniach, które je uzasadniają.
[ ] Cytowania wtórne są oznaczone, a podstawy hipotez znane z oryginałów.
[ ] Żaden fragment nie jest podmianą synonimów w cudzym zdaniu.
[ ] Każdy wątek kończy się wnioskiem albo przejściem do pytania.
Macierz literatury w R
Kod tworzy osiem fikcyjnych badań metodą symulacji, liczy korelacje z przedziałami ufności, wartości p i porównania z tekstu oraz zapisuje szablon macierz-literatury-szablon.xlsx w folderze nadrzędnym (../). Rysunki powstały w osobnym skrypcie na tych samych danych.
Fikcyjne badania i szablon XLSX
R
# B478 – macierz literatury: fikcyjne badania, przedziały ufności dla r i szablon XLSX
# Wszystkie badania są fikcyjne.
suppressPackageStartupMessages(library(openxlsx))
set.seed(478)

symuluj_r <- function(n, rho) {
  x <- rnorm(n)
  y <- rho * x + sqrt(1 - rho^2) * rnorm(n)
  cor(x, y)
}

badania <- data.frame(
  zrodlo = paste("Badanie", LETTERS[1:8]),
  n = c(412, 86, 1240, 118, 356, 204, 95, 278),
  pomiar = c("czas: samoopis", "czas: samoopis", "czas: samoopis", "czas: dane z telefonu",
             "problemowe korzystanie: skala", "problemowe korzystanie: skala",
             "problemowe korzystanie: skala", "problemowe korzystanie: skala"),
  schemat = c(rep("przekrojowy", 7), "podłużny, 2 pomiary"),
  rho = c(.10, .10, .10, .05, .35, .35, .35, .08)
)

# Badania A–G: korelacja z jednego pomiaru.
badania$r <- mapply(symuluj_r, badania$n, badania$rho)

# Badanie H: korzystanie w T1 a samotność w T2 po uwzględnieniu samotności w T1 (korelacja cząstkowa, 1 zmienna kontrolna).
n_h <- badania$n[8]
korzystanie_t1 <- rnorm(n_h)
samotnosc_t1 <- .35 * korzystanie_t1 + sqrt(1 - .35^2) * rnorm(n_h)
samotnosc_t2 <- .60 * samotnosc_t1 + .06 * korzystanie_t1 + sqrt(1 - .60^2 - .06^2) * rnorm(n_h)
reszta_x <- resid(lm(korzystanie_t1 ~ samotnosc_t1))
reszta_y <- resid(lm(samotnosc_t2 ~ samotnosc_t1))
badania$r[8] <- cor(reszta_x, reszta_y)

# Liczba zmiennych kontrolnych, przedział z transformacji Fishera, wartość p z rozkładu t.
badania$k <- c(rep(0, 7), 1)
z <- atanh(badania$r)
se <- 1 / sqrt(badania$n - 3 - badania$k)
badania$dolna <- tanh(z - qnorm(.975) * se)
badania$gorna <- tanh(z + qnorm(.975) * se)
df <- badania$n - 2 - badania$k
t_stat <- badania$r * sqrt(df / (1 - badania$r^2))
badania$p <- 2 * pt(-abs(t_stat), df)
badania$istotny <- badania$p < .05

wynik <- transform(badania, r = round(r, 2), dolna = round(dolna, 2), gorna = round(gorna, 2), p = round(p, 3))
print(wynik[, c("zrodlo", "n", "pomiar", "r", "dolna", "gorna", "p", "istotny")], row.names = FALSE)

cat(sprintf("\nDolna granica CI w badaniu D (więcej miejsc): %.4f\n", badania$dolna[4]))
cat("\nLiczba wyników istotnych:", sum(badania$istotny), "z", nrow(badania), "\n")

badania$grupa <- ifelse(grepl("^czas", badania$pomiar), "czas", "problemowe")
przekroj <- badania[badania$schemat == "przekrojowy", ]
for (g in c("czas", "problemowe")) {
  w <- przekroj[przekroj$grupa == g, ]
  cat(sprintf("%s (przekrojowe): k = %d, suma n = %d, r od %.2f do %.2f, istotne: %d\n",
              g, nrow(w), sum(w$n), min(w$r), max(w$r), sum(w$istotny)))
}

# Dwa badania, w których mniejsze r jest istotne, a większe nie: czy wyniki są „sprzeczne”?
para <- badania[badania$zrodlo %in% c("Badanie C", "Badanie D"), c("zrodlo", "n", "r", "dolna", "gorna", "p")]
print(transform(para, r = round(r, 2), dolna = round(dolna, 2), gorna = round(gorna, 2), p = round(p, 3)), row.names = FALSE)
roz_z <- diff(atanh(para$r)) / sqrt(sum(1 / (para$n - 3)))
bez_zera <- function(x, m) sub("^0", "", sprintf(paste0("%.", m, "f"), x))
cat(sprintf("Różnica C i D (test z dla dwóch korelacji): z = %.2f, p = %s\n", roz_z, bez_zera(2 * pnorm(-abs(roz_z)), 3)))

# Szansa na wynik istotny, gdyby prawdziwa korelacja była równa r z badania C (przybliżenie Fishera).
moc_r <- function(rho, n) {
  d <- atanh(rho) * sqrt(n - 3)
  pnorm(d - qnorm(.975)) + pnorm(-d - qnorm(.975))
}
r_c <- para$r[para$zrodlo == "Badanie C"]
cat(sprintf("Moc przy r = %s: n = 118: %s; n = 1240: %.2f\n", bez_zera(r_c, 2), bez_zera(moc_r(r_c, 118), 2), moc_r(r_c, 1240)))

# Szablon XLSX do pobrania (bez metadanych osobowych)
kolumny <- c("id", "zrodlo_autorzy_rok", "populacja_i_dobor", "n", "schemat", "predyktor_jak_zmierzono",
             "wynik_jak_zmierzono", "miara_efektu", "wartosc_efektu", "ci_dolna", "ci_gorna", "p",
             "zmienne_kontrolne", "ograniczenie_najwazniejsze", "watek_grupa", "zgodne_czy_sprzeczne",
             "czy_przeczytano_oryginal", "strona_notatka_wlasnymi_slowami")
wb <- createWorkbook(creator = "Metodolog.pl", title = "Macierz literatury - szablon")
addWorksheet(wb, "macierz")
pusta <- as.data.frame(matrix(NA_character_, nrow = 30, ncol = length(kolumny), dimnames = list(NULL, kolumny)))
pusta$id <- sprintf("S%02d", 1:30)
naglowek <- createStyle(fontColour = "#FFFFFF", fgFill = "#0F1D3A", textDecoration = "bold",
                        wrapText = TRUE, valign = "top")
writeData(wb, "macierz", pusta, headerStyle = naglowek)
freezePane(wb, "macierz", firstActiveRow = 2, firstActiveCol = 3)
setColWidths(wb, "macierz", cols = seq_along(kolumny), widths = 20)
dataValidation(wb, "macierz", cols = which(kolumny == "schemat"), rows = 2:31, type = "list",
               value = "'listy'!$A$2:$A$7")
dataValidation(wb, "macierz", cols = which(kolumny == "zgodne_czy_sprzeczne"), rows = 2:31, type = "list",
               value = "'listy'!$B$2:$B$5")
dataValidation(wb, "macierz", cols = which(kolumny == "czy_przeczytano_oryginal"), rows = 2:31, type = "list",
               value = "'listy'!$C$2:$C$4")

addWorksheet(wb, "listy")
writeData(wb, "listy", data.frame(
  schemat = c("eksperyment losowy", "quasi-eksperyment", "podłużny", "przekrojowy", "przed-po bez kontroli", "przegląd/metaanaliza"),
  zgodnosc = c("zgodne z tezą", "częściowo", "sprzeczne", "niejasne", NA, NA),
  oryginal = c("tak, całość", "tylko abstrakt", "nie, cytat za innym źródłem", NA, NA, NA)
), headerStyle = naglowek)

addWorksheet(wb, "przyklad_fikcyjny")
przyklad <- wynik[, c("zrodlo", "n", "schemat", "pomiar", "r", "dolna", "gorna", "p")]
przyklad$p <- ifelse(badania$p < .001, "<.001", bez_zera(badania$p, 3))
przyklad$uwaga <- "dane i badanie fikcyjne"
writeData(wb, "przyklad_fikcyjny", przyklad, headerStyle = naglowek)
setColWidths(wb, "przyklad_fikcyjny", cols = 1:9, widths = "auto")

addWorksheet(wb, "synteza")
synteza <- data.frame(watek_teza = rep(NA_character_, 8), ktore_badania = NA_character_, zakres_efektow = NA_character_,
                      co_wyjasnia_roznice = NA_character_, sila_dowodow = NA_character_, czego_brakuje = NA_character_)
writeData(wb, "synteza", synteza, headerStyle = naglowek)
setColWidths(wb, "synteza", cols = 1:6, widths = 30)
saveWorkbook(wb, "macierz-literatury-szablon.xlsx", overwrite = TRUE)

cat("\nArkusze:", getSheetNames("macierz-literatury-szablon.xlsx"), "\n")
cat("Kolumny w arkuszu macierz:", length(kolumny), "\n")
Wynik w R
    zrodlo    n                        pomiar     r dolna gorna     p istotny
 Badanie A  412                czas: samoopis  0.05 -0.05  0.14 0.320   FALSE
 Badanie B   86                czas: samoopis -0.02 -0.23  0.19 0.844   FALSE
 Badanie C 1240                czas: samoopis  0.13  0.08  0.19 0.000    TRUE
 Badanie D  118         czas: dane z telefonu  0.18  0.00  0.35 0.051   FALSE
 Badanie E  356 problemowe korzystanie: skala  0.29  0.19  0.38 0.000    TRUE
 Badanie F  204 problemowe korzystanie: skala  0.47  0.35  0.57 0.000    TRUE
 Badanie G   95 problemowe korzystanie: skala  0.39  0.20  0.55 0.000    TRUE
 Badanie H  278 problemowe korzystanie: skala  0.14  0.02  0.25 0.024    TRUE

Dolna granica CI w badaniu D (więcej miejsc): -0.0004

Liczba wyników istotnych: 5 z 8
czas (przekrojowe): k = 4, suma n = 1856, r od -0.02 do 0.18, istotne: 1
problemowe (przekrojowe): k = 3, suma n = 655, r od 0.29 do 0.47, istotne: 3
    zrodlo    n    r dolna gorna     p
 Badanie C 1240 0.13  0.08  0.19 0.000
 Badanie D  118 0.18  0.00  0.35 0.051
Różnica C i D (test z dla dwóch korelacji): z = 0.50, p = .619
Moc przy r = .13: n = 118: .30; n = 1240: 1.00

Arkusze: macierz listy przyklad_fikcyjny synteza
Kolumny w arkuszu macierz: 18
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem openxlsx; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An SVG graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się synteza literatury od streszczenia?
Streszczenie opisuje każde badanie osobno, a synteza porównuje badania wokół jednej tezy: co się powtarza, co się różni i z czego to może wynikać. Praktyczny test to podmiot zdania. Jeśli akapit zaczyna się od nazwiska, zwykle streszczasz; jeśli od zjawiska lub wyniku, syntetyzujesz.
Co wpisać do macierzy literatury?
Co najmniej źródło, próbę z liczebnością, schemat, sposób pomiaru, wielkość efektu z przedziałem ufności i najważniejsze ograniczenie. Przydają się też kolumny „wątek” oraz „czy przeczytano oryginał”. Na tej stronie jest gotowy szablon XLSX.
Jak opisać w pracy sprzeczne wyniki badań?
Nazwij, na czym polega rozbieżność: kierunek, siła czy tylko istotność. Podaj zakresy efektów i liczebności, wskaż cechy badań, które mogą ją wyjaśniać, i oddziel ustalenia od przypuszczeń. Wynik nieistotny z małej próby sam w sobie nie przeczy wynikowi istotnemu z dużej.
Kiedy można napisać „wykazali”, a kiedy lepiej „stwierdzili” lub „sugerują”?
„Stwierdzili” pasuje do konkretnego wyniku pojedynczego badania, a „sugerują” lub „wskazują” do ostrożnego wniosku. „Wykazali” zarezerwuj dla sytuacji, w których schemat i kolejne badania naprawdę uzasadniają mocne twierdzenie. To praktyczna wskazówka, nie norma, więc uwzględnij zwyczaje swojej dyscypliny i promotora.
Czy mogę zacytować pracę, której nie czytałem, tylko znalazłem w innym artykule?
Najpierw spróbuj dotrzeć do oryginału. Jeśli to niemożliwe, zaznacz cytowanie wtórne, na przykład zapisem „za:”, i w bibliografii podaj tylko pracę, którą przeczytałeś (American Psychological Association, b.d.). Sprawdź też format wymagany przez uczelnię. Podstaw hipotez nie opieraj na cudzych streszczeniach.
Powiązane hasła
Przeczytaj też
Jak czytać artykuł przed zacytowaniem
Kolejność czytania, dziesięć pytań o próbę, pomiar i efekt, karta oceny do skopiowania i rozłożony na części fikcyjny artykuł.
Czytaj →PoradnikJak napisać przegląd literatury – z AI i bez
Rodzaje przeglądów, zapytania z operatorami Boole’a, selekcja, tabela ekstrakcji i macierz pojęć – oraz to, w czym AI pomaga, a w czym szkodzi.
Czytaj →PoradnikLuka badawcza i uzasadnienie problemu
Sześć rodzajów luk, jak je znaleźć, replikacja zamiast nowatorstwa i akapit uzasadnienia źle i dobrze z czterech dziedzin.
Czytaj →PoradnikPorównanie wyników z literaturą
Jak przeliczyć średnie i SD, t, F, r i OR z artykułów na g Hedgesa z przedziałem ufności, zestawić je z własnym wynikiem na jednym wykresie i napisać o tym w dyskusji – z przykładem w R.
Czytaj →Porównujesz wyniki badań i nie wiesz, czy są sprzeczne?
Pomożemy przeliczyć efekty z artykułów, policzymy własne analizy w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (b.d.). Secondary sources. APA Style. https://apastyle.apa.org/style-grammar-guidelines/citations/secondary-sources ● Otwarty dostęp
- Campbell, M., McKenzie, J. E., Sowden, A., Katikireddi, S. V., Brennan, S. E., Ellis, S., Hartmann-Boyce, J., Ryan, R., Shepperd, S., Thomas, J., Welch, V., & Thomson, H. (2020). Synthesis without meta-analysis (SWiM) in systematic reviews: Reporting guideline. BMJ, 368, Article l6890. https://doi.org/10.1136/bmj.l6890 ● Otwarty dostęp
- Greenberg, S. A. (2009). How citation distortions create unfounded authority: Analysis of a citation network. BMJ, 339, Article b2680. https://doi.org/10.1136/bmj.b2680 ● Otwarty dostęp
- Hedges, L. V., & Olkin, I. (1980). Vote-counting methods in research synthesis. Psychological Bulletin, 88(2), 359–369. https://doi.org/10.1037/0033-2909.88.2.359
- Hyland, K. (1999). Academic attribution: Citation and the construction of disciplinary knowledge. Applied Linguistics, 20(3), 341–367. https://doi.org/10.1093/applin/20.3.341
- Jergas, H., & Baethge, C. (2015). Quotation accuracy in medical journal articles—a systematic review and meta-analysis. PeerJ, 3, Article e1364. https://doi.org/10.7717/peerj.1364 ● Otwarty dostęp
- Roig, M. (2010). Plagiarism and self-plagiarism: What every author should know. Biochemia Medica, 20(3), 295–300. https://doi.org/10.11613/bm.2010.037 ● Otwarty dostęp
- Thompson, G., & Ye, Y. (1991). Evaluation in the reporting verbs used in academic papers. Applied Linguistics, 12(4), 365–382. https://doi.org/10.1093/applin/12.4.365
- Webster, J., & Watson, R. T. (2002). Analyzing the past to prepare for the future: Writing a literature review. MIS Quarterly, 26(2), xiii–xxiii. https://doi.org/10.2307/4132319 ● Otwarty dostęp
Cytowania BibTeX
@misc{apasecondarysources, author={{American Psychological Association}}, title={{Secondary sources}}, howpublished={APA Style}, year={b.d.}, url={https://apastyle.apa.org/style-grammar-guidelines/citations/secondary-sources}}@article{campbell2020synthesis, author={Campbell, Mhairi and McKenzie, Joanne E. and Sowden, Amanda and Katikireddi, Srinivasa Vittal and Brennan, Sue E. and Ellis, Simon and Hartmann-Boyce, Jamie and Ryan, Rebecca and Shepperd, Sasha and Thomas, James and Welch, Vivian and Thomson, Hilary}, title={{Synthesis without meta-analysis (SWiM) in systematic reviews: Reporting guideline}}, journal={BMJ}, year={2020}, volume={368}, eid={l6890}, doi={10.1136/bmj.l6890}}@article{greenberg2009how, author={Greenberg, Steven A.}, title={{How citation distortions create unfounded authority: Analysis of a citation network}}, journal={BMJ}, year={2009}, volume={339}, eid={b2680}, doi={10.1136/bmj.b2680}}@article{hedges1980vote, author={Hedges, Larry V. and Olkin, Ingram}, title={{Vote-counting methods in research synthesis}}, journal={Psychological Bulletin}, year={1980}, volume={88}, number={2}, pages={359--369}, doi={10.1037/0033-2909.88.2.359}}@article{hyland1999academic, author={Hyland, Ken}, title={{Academic attribution: Citation and the construction of disciplinary knowledge}}, journal={Applied Linguistics}, year={1999}, volume={20}, number={3}, pages={341--367}, doi={10.1093/applin/20.3.341}}@article{jergas2015quotation, author={Jergas, Hannah and Baethge, Christopher}, title={{Quotation accuracy in medical journal articles—a systematic review and meta-analysis}}, journal={PeerJ}, year={2015}, volume={3}, eid={e1364}, doi={10.7717/peerj.1364}}@article{roig2010plagiarism, author={Roig, Miguel}, title={{Plagiarism and self-plagiarism: What every author should know}}, journal={Biochemia Medica}, year={2010}, volume={20}, number={3}, pages={295--300}, doi={10.11613/bm.2010.037}}@article{thompson1991evaluation, author={Thompson, Geoff and Ye, Yiyun}, title={{Evaluation in the reporting verbs used in academic papers}}, journal={Applied Linguistics}, year={1991}, volume={12}, number={4}, pages={365--382}, doi={10.1093/applin/12.4.365}}@article{webster2002analyzing, author={Webster, Jane and Watson, Richard T.}, title={{Analyzing the past to prepare for the future: Writing a literature review}}, journal={MIS Quarterly}, year={2002}, volume={26}, number={2}, pages={xiii--xxiii}, doi={10.2307/4132319}}