„Porównaj z literaturą” – ale jak?
W poradniku jak napisać dyskusję wyników radzimy, by przy każdej hipotezie napisać, w czym Twój wynik jest zgodny z wcześniejszymi badaniami: kierunek, populacja i wielkość efektu. Na tym ostatnim punkcie wielu studentów utyka: masz d Cohena z własnych danych, a artykuły podają średnie i SD, statystykę F, iloraz szans albo t dla pomiarów przed i po. Żeby napisać „mój efekt był podobny”, trzeba je sprowadzić do wspólnej miary.
Pokazujemy, jakie wzory zastosować i przy jakich założeniach, jak dodać przedziały ufności, jak narysować własny wynik na tle literatury i czego nie porównywać. Co oznaczają same miary efektu, wyjaśniamy w poradniku wielkość efektu – interpretacja, a pojedyncze przeliczenie zrobisz w konwerterze wielkości efektu. Tutaj chodzi o cały proces: od wyników z kilku artykułów do akapitu w pracy.
Przykład przewodni (dane symulowane, badania z literatury fikcyjne). Studentka pielęgniarstwa sprawdza, czy ośmiotygodniowy trening uważności obniża stres u studentów. Losowo przydziela 86 osób do treningu (n = 44) albo do grupy kontrolnej z listy oczekujących (n = 42). Po ośmiu tygodniach mierzy stres na skali 0–40. W przeglądzie literatury ma pięć badań o podobnym pytaniu. Nazywamy je A–E. Te badania i ich wyniki są wymyślone na potrzeby przykładu – nie szukaj ich w bazach.
Co zwykle znajdziesz w artykule i na co to przeliczyć
Najpierw wybierz wspólną miarę. Najprościej przyjąć tę, w której raportujesz własny wynik. Przy porównaniu dwóch grup na zmiennej ilościowej będzie to standaryzowana różnica średnich, najlepiej w wersji g Hedgesa. Hedges (1981) pokazał, że zwykłe d jest w małych próbach obciążone w górę, i podał poprawkę. Gdy Twój wynik to korelacja, sprowadzaj wszystko do r. Gdy to wynik dwuwartościowy (np. wystąpienie powikłania), wspólną miarą może być iloraz szans. Wzory przejścia między tymi rodzinami opisują Borenstein i in. (2009) w rozdziale o zamianie wielkości efektu. Tabela zbiera przypadki, które spotkasz najczęściej.
| Co podaje artykuł | Jak przeliczyć na d | Warunek, który musi być spełniony |
|---|---|---|
| Średnie, SD i n w dwóch grupach | d = (M1 − M2) / SDpoł | Ta sama zmienna w obu grupach; SD to odchylenia standardowe, a nie błędy standardowe |
| t dla grup niezależnych i n grup | d = t × √(1/n1 + 1/n2) | Test t Studenta lub Welcha bez zmiennych towarzyszących |
| F(1, df) z porównania dwóch grup | t = √F, dalej jak wyżej | Tylko 1 stopień swobody w liczniku i brak kowariantów; znak bierzesz z opisu wyników |
| F(2, df) lub więcej | Nie przeliczaj całego F | Szukaj średnich i SD dwóch grup, które chcesz porównać |
| Korelacja punktowo-dwuseryjna r (grupa × wynik) | d = 2r / √(1 − r²) (równe grupy) | Jedna zmienna to przynależność do grupy; przy nierównych grupach wzór ma czynnik z n |
| Korelacja dwóch zmiennych ilościowych | Nie przeliczaj na d | To inne pytanie (związek, a nie różnica grup); porównuj z korelacjami |
| OR albo tabela 2×2 | d = ln(OR) × √3 / π | Wynik dwuwartościowy jest „pocięciem” cechy ciągłej o podobnej zmienności w grupach (Chinn, 2000) |
| χ²(1) i liczebności | Odtwórz tabelę 2×2, policz OR, dalej jak wyżej | Jak przy OR; samo χ² bez liczebności nie wystarcza |
| t dla prób zależnych (przed i po) | dz = t / √n, ale do porównań dav lub drm | Inny schemat i inny mianownik – patrz niżej |
Pierwsza reguła: przeliczasz dopiero wtedy, gdy oba wyniki odpowiadają na to samo pytanie. Morris i DeShon (2002) wymieniają trzy warunki łączenia wyników z różnych schematów: wspólną metrykę, ten sam szacowany efekt i wariancję błędu właściwą dla danego schematu. Choć piszą o metaanalizie, te same warunki obowiązują przy zwykłym zestawieniu w dyskusji.
Przykład: własny wynik i pięć badań z literatury
Najpierw własny wynik. W grupie kontrolnej średni stres wyniósł M = 21.36 (SD = 7.58), w grupie treningu M = 16.20 (SD = 5.19). Różnica to 5.15 punktu, 95% CI [2.38, 7.93], t(84) = 3.69, p < .001. Pakiet effectsize daje d = 0.80, 95% CI [0.35, 1.23], i g = 0.79, 95% CI [0.35, 1.22]. Ten sam wynik ze wzoru, którym niżej liczymy badania z literatury, to g = 0.790, 95% CI [0.35, 1.22]. Na wszystkich liczbach przyjmujemy jeden kierunek: wartość dodatnia oznacza niższy stres po treningu. Kierunek ustal na początku i pilnuj go przy każdym badaniu. Odwrócony znak to jeden z najczęstszych błędów w takich zestawieniach.
Teraz literatura. Pięć fikcyjnych badań podaje wyniki tak, jak robią to prawdziwe artykuły – każde inaczej:
- Badanie A (ta sama skala 0–40): kontrola M = 18.9 (SD = 6.3), n = 33; trening M = 15.8 (SD = 5.9), n = 35.
- Badanie B (inna skala, 1–5): korelacja punktowo-dwuseryjna przynależności do grupy z wynikiem r = .30, po 30 osób w grupie.
- Badanie C: jednoczynnikowa ANOVA dla dwóch grup, F(1, 118) = 9.61, po 60 osób; w tekście: „niższy stres w grupie treningu”.
- Badanie D: odsetek osób z wysokim stresem (powyżej progu skali): 14 z 50 (28%) po treningu wobec 25 z 50 (50%) w kontroli, χ²(1, N = 100) = 5.09.
- Badanie E: jedna grupa 40 osób, pomiar przed i po treningu, bez grupy kontrolnej: M = 22.4 (SD = 6.8) i 19.0 (SD = 7.1), t(39) = 4.60.
Przeliczenia krok po kroku
Badanie A: średnie i odchylenia standardowe
Najpierw połączone odchylenie standardowe, potem różnica średnich podzielona przez nie:
To samo d dostaniesz z testu t: z tych średnich wychodzi t(66) = 2.10, a 2.10 × √(1/33 + 1/35) = 0.51. Uważaj na tabele, które podają błąd standardowy (SE) zamiast SD – bywa to zaznaczone tylko w nocie. Podzielenie różnicy przez SE daje efekt kilka razy za duży.
Badanie B: korelacja punktowo-dwuseryjna
Badanie B podaje korelację punktowo-dwuseryjną przynależności do grupy z wynikiem. Przy równych grupach d = 2r / √(1 − r²) = 2 × .30 / √(1 − .09) = 0.63; funkcja r_to_d() z effectsize daje to samo. Inna skala (1–5 zamiast 0–40) nie przeszkadza, bo d jest wyrażone w odchyleniach standardowych – o ile obie skale mierzą to samo.
Badanie C: F z jednym stopniem swobody
Dla dwóch grup F(1, df) jest kwadratem t, więc t = √9.61 = 3.10, a d = 3.10 × √(1/60 + 1/60) = 0.57. F nie ma znaku, więc kierunek bierzesz z opisu wyników. Funkcja F_to_d() daje 0.57, 95% CI [0.20, 0.94] (przybliżenie 2t/√df).
Jeśli F pochodzi z ANCOVA z pomiarem wyjściowym albo innymi kowariantami, jego mianownikiem jest wariancja resztowa, a tak policzone d bywa wyraźnie większe niż d z surowych średnich – szukaj wtedy średnich i SD w tabeli opisowej.
Badanie D: tabela 2×2, χ² i iloraz szans
Z odsetków i liczebności odtwarzasz tabelę 2×2: kontrola 25 osób z wysokim i 25 z niskim stresem, trening 14 i 36. Szansa wysokiego stresu w kontroli w stosunku do treningu: OR = (25 × 36) / (25 × 14) = 2.57, 95% CI [1.12, 5.90]. Kontrola: z tej tabeli χ²(1, N = 100) = 5.09, jak w artykule. Potem przeliczasz logarytm ilorazu szans na d:
Chinn (2000) zaokrągla tę samą zamianę do dzielenia ln(OR) przez 1.81 i zastrzega, że wymaga ona porównywalnej zmienności w porównywanych badaniach. Kryje się za nią założenie, że „wysoki stres” to próg położony na ciągłej cesze o rozkładzie logistycznym. Przy wyniku z natury dwuwartościowym takie d jest tylko umowne. O stracie informacji przy dzieleniu zmiennej progiem piszemy w poradniku dychotomizacja zmiennych ciągłych.
Badanie E: przed i po w jednej grupie
Tu najłatwiej o pomyłkę. Z t dla prób zależnych najprościej policzyć dz = t / √n = 4.60 / √40 = 0.73. To jednak średnia różnic podzielona przez SD różnic, a nie przez SD wyników. Dunlap i in. (1996) pokazali, że d liczone wprost z t w planach z pomiarami powtarzanymi jest zawyżone. Im wyższa korelacja pomiarów, tym mniejszy błąd testu, ale sama różnica się przecież nie zwiększa. Lakens (2013) opisuje dwie miary porównywalne z d dla grup niezależnych: dav (różnica średnich przez średnie SD obu pomiarów) i drm (z poprawką na korelację). Szczegóły i wzory są w haśle wielkość efektu dla prób zależnych.
Artykuł rzadko podaje korelację pomiarów, ale można ją odtworzyć z t, średnich i SD. SD różnic = 3.4 × √40 / 4.60 = 4.67, a stąd r = (6.8² + 7.1² − 4.67²) / (2 × 6.8 × 7.1) = .77. Wtedy dav = 3.4 / 6.95 = 0.49 i drm = 0.49 – o jedną trzecią mniej niż dz. Funkcja t_to_d(4.60, 39, paired = TRUE) zwraca 0.74, czyli przybliżenie dz (t/√df), a nie miarę porównywalną z Twoją. Rysunek 1 pokazuje, jak dz rośnie z korelacją przy tej samej różnicy średnich.
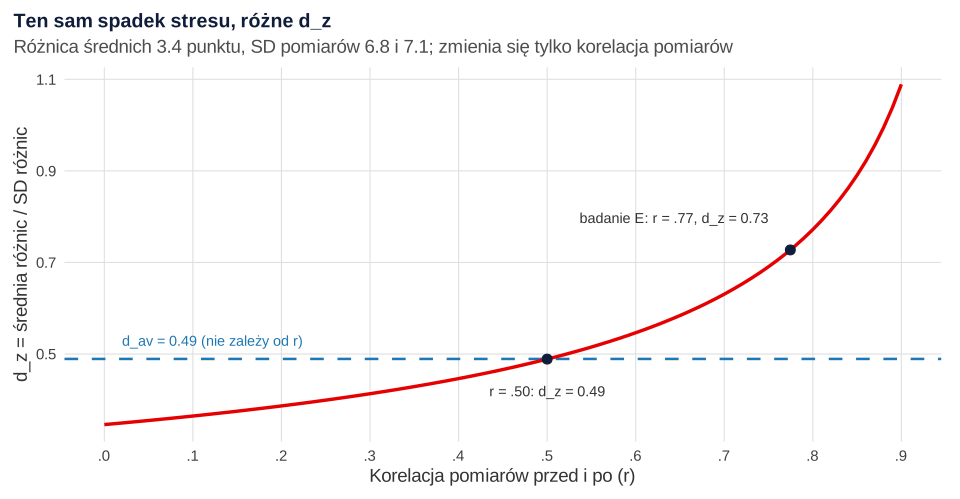
Nawet poprawnie przeliczone, badanie E i tak odpowiada na inne pytanie niż Twoje. Bez grupy kontrolnej spadek stresu obejmuje efekt treningu, ale też upływ czasu (np. koniec sesji), regresję do średniej i efekt ponownego pomiaru. W zestawieniu pokaż je osobno i opisz jako badanie o słabszym schemacie, a nie jako „kolejne potwierdzenie”.
Zestawienie na jednym wykresie
Po przeliczeniu wszystkie wyniki są w jednej mierze. Każde d zamieniamy na g mnożnikiem Hedgesa J = 1 − 3 / (4df − 1) i dodajemy 95% przedział ufności. Wariancję d dla grup niezależnych liczymy jako (n1 + n2) / (n1n2) + d² / [2(n1 + n2)] – to standardowy wzór stosowany w metaanalizie. Przedziały ufności pokazują, jak dokładnie oszacowano każdy efekt. To podejście estymacyjne, za którym opowiada się Cumming (2014): pytasz nie „czy też wyszło istotnie?”, ale „jak duży był efekt i jak dokładnie go oszacowano?”.
| Badanie | Co podano | n | d | g [95% CI] | p w artykule |
|---|---|---|---|---|---|
| Własne | dane surowe | 86 | 0.80 | 0.79 [0.35, 1.22] | < .001 |
| A | M i SD | 68 | 0.51 | 0.50 [0.02, 0.98] | .040 |
| B | r punktowo-dwuseryjne | 60 | 0.63 | 0.62 [0.11, 1.13] | .020 |
| C | F(1, 118) | 120 | 0.57 | 0.56 [0.20, 0.92] | .002 |
| D | OR z tabeli 2×2 | 100 | 0.52 | 0.52 [0.06, 0.97] | .024 |
| E (przed–po, bez kontroli) | t dla prób zależnych | 40 | 0.49 (dav) | 0.48 [0.26, 0.70] | – |
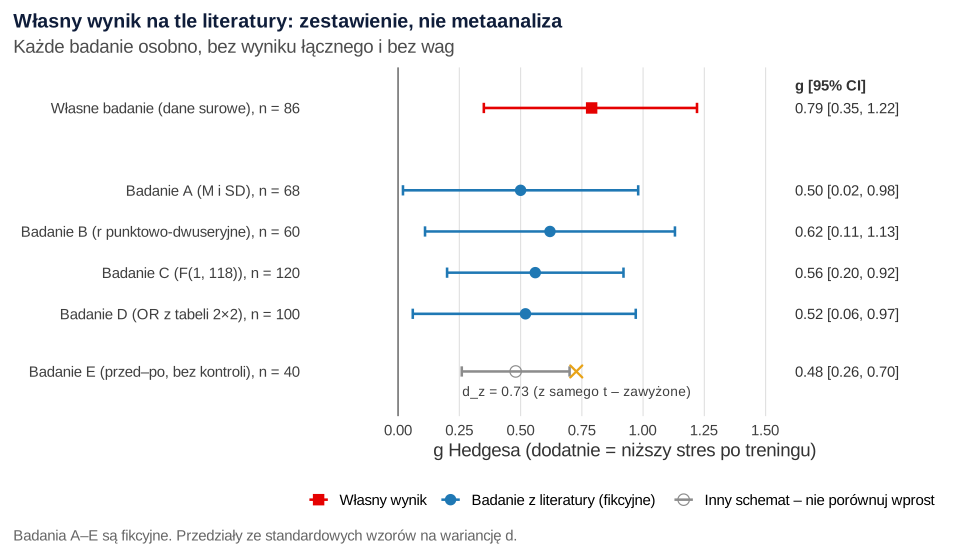
Wykres przypomina wykres lasu (forest plot), ale celowo nie ma na nim wag ani rombu z wynikiem łącznym. To nie jest metaanaliza. Badania nie zostały wyszukane systematycznie, więc ich średnia odzwierciedlałaby Twój wybór literatury, a nie stan wiedzy. Jeśli promotor albo temat pracy wymaga oszacowania łącznego, potrzebujesz pełnej procedury: protokołu, systematycznego wyszukiwania i oceny heterogeniczności (zob. metaanaliza krok po kroku). Do samych obliczeń przyda się kalkulator metaanalizy.
Co widać na rysunku? Badania A–D dały efekty od 0.50 do 0.62, a Twój wynik (0.79) jest od nich większy. Przedziały są jednak szerokie i mocno się nakładają. Jedyne, co da się uczciwie napisać, to że wynik jest zgodny co do kierunku i rzędu wielkości z wcześniejszymi badaniami. Twierdzenie „efekt był większy niż w literaturze” wymaga osobnego sprawdzenia.
Pułapki: czego nie porównywać wprost
Nie porównuj wartości p
Badanie C ma p = .002, a badanie A p = .040. Kusi zdanie „w badaniu C efekt był wyraźniejszy”. Tymczasem ich efekty prawie się nie różnią (0.56 i 0.50). C ma po prostu dwa razy więcej osób. Wartość p łączy wielkość efektu z liczebnością próby, więc nie nadaje się do porównywania efektów (zob. wartość p – interpretacja). Gelman i Stern (2006) pokazali też odwrotną stronę tej pułapki. Różnica między wynikiem „istotnym” a „nieistotnym” sama zwykle nie jest istotna, dlatego dwa efekty trzeba porównać bezpośrednio.
„Mój efekt był większy” – sprawdź różnicę, a nie nakładanie się przedziałów
Jeśli chcesz napisać, że Twój efekt różnił się od efektu z konkretnego badania, policz różnicę dwóch niezależnych oszacowań i jej błąd: z = (g1 − g2) / √(SE1² + SE2²). W przykładzie różnica z badaniem A wynosi 0.29 (z = 0.87, p = .384), a z badaniem C – 0.23 (z = 0.79, p = .432). Przy takich próbach nie da się odróżnić efektu 0.79 od 0.50. To ten sam problem co w poradniku jak porównać dwie korelacje. Dlaczego samo nakładanie się dwóch przedziałów nie jest testem, wyjaśniamy we wpisie przedziały ufności w pracy. Pamiętaj też, że taki test zakłada, że oba badania mierzą ten sam efekt, czyli wraca do warunków z następnego akapitu.
Różne narzędzia, populacje i zróżnicowanie próby
Standaryzowana różnica średnich zależy od SD w mianowniku. Ta sama różnica 3 punktów da większe d w jednorodnej próbie (studenci jednego rocznika) niż w zróżnicowanej (pracownicy w wieku 20–65 lat). Gdy narzędzie jest to samo, pokaż też różnicę w punktach skali – w badaniu A 3.1 punktu, u Ciebie 5.15. Przeliczenie nie usuwa różnic w rzetelności narzędzi (mniej rzetelna skala zaniża efekt) ani w treści konstruktu („stres akademicki” a „wypalenie”).
Różne schematy i wyniki skorygowane
Nie zestawiaj bez komentarza efektu z eksperymentu, różnicy przed–po bez kontroli i ilorazu szans skorygowanego o kilka zmiennych – skorygowany OR odpowiada na inne pytanie niż surowy, a jego przeliczenie na d tę różnicę dziedziczy. Morris i DeShon (2002) wymagają, by przed połączeniem schematów sprawdzić, czy szacują one ten sam efekt. W pracy dyplomowej wystarczy, że takie badania oznaczysz osobno, jak badanie E na rysunku 2.
Gotowe zdania do dyskusji
Poniższy akapit opisuje przykład. W kwadratowych nawiasach są miejsca na Twoje dane. Ogólną kolejność dyskusji i zdania do pozostałych elementów znajdziesz w poradniku jak napisać dyskusję wyników.
W metodzie albo w nocie pod tabelą napisz, skąd wzięły się liczby z literatury. Bez tego recenzent nie sprawdzi Twoich przeliczeń (zob. zarzuty recenzentów do statystyki):
Wyniki zapisuj zgodnie z zasadami APA: miara, wartość, przedział ufności. Przy wyniku nieistotnym porównanie z literaturą jest szczególnie cenne – przedział pokaże, czy efekty z innych badań są zgodne z Twoimi danymi (zob. jak opisać wynik nieistotny i hipoteza się nie potwierdziła). Nie licz w tym celu mocy z uzyskanego efektu (zob. moc po fakcie). Rozbieżności, których nie umiesz wyjaśnić, opisz ostrożnie – Docherty i Smith (1999) radzą nie udawać, że zna się ich przyczynę. Te, które wynikają ze słabości Twojego badania, przenieś do ograniczeń.
Najczęstsze błędy
- Porównywanie wartości p zamiast efektów. „U nas p = .001, w badaniu X p = .04, więc efekt był silniejszy” – nie, różnią się liczebności.
- dz z badania przed–po obok d z grup niezależnych. Przy wysokiej korelacji pomiarów dz zawyża efekt. W przykładzie dał 0.73 zamiast 0.49.
- SE wzięte za SD. Daje kilkukrotnie zawyżone d; sprawdź nagłówek i notę tabeli.
- Przeliczanie F z więcej niż jednym stopniem swobody w liczniku albo F z ANCOVA tak, jakby było zwykłym porównaniem dwóch grup.
- Zamiana korelacji dwóch zmiennych ilościowych na d. Wzór r → d dotyczy tylko korelacji z przynależnością do grupy.
- Odwrócony znak. W jednym artykule wyższy wynik oznacza więcej stresu, w innym lepsze samopoczucie. Ustal kierunek raz i pilnuj go przy każdym badaniu.
- Średnia z kilku cytowanych badań podana jako „efekt w literaturze”. Bez systematycznego wyszukiwania to nie jest metaanaliza.
- „Efekt był większy niż w literaturze” bez testu różnicy. Przy szerokich przedziałach różnica 0.2–0.3 może być przypadkowa.
Przeliczanie efektów w R
Dwa przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy dane własnego badania (symulowane) i zapisuje je w pliku CSV w folderze nadrzędnym (../), drugi przelicza wyniki pięciu fikcyjnych badań na g Hedgesa i zapisuje zestawienie. Uruchamiaj je po kolei z jednego folderu. Rysunki powstały w osobnym skrypcie na tych samych danych. Pliki do pobrania: porownanie-z-literatura-wlasne-badanie.csv (86 osób: grupa, wynik skali stresu 0–40) i porownanie-z-literatura-zestawienie.csv (zestawienie sześciu wyników: d, g, SE i 95% CI).
Własny wynik: d i g z danych surowych
R
# B439 – własny wynik: trening uważności a stres u studentów pielęgniarstwa (dane symulowane)
# Zapisuje dane do ../porownanie-z-literatura-wlasne-badanie.csv (folder nadrzędny).
library(effectsize)
set.seed(4391)
n_i <- 44; n_k <- 42
stres <- c(rnorm(n_i, mean = 18.0, sd = 6.5), rnorm(n_k, mean = 21.5, sd = 6.5))
stres <- pmin(pmax(round(stres), 0), 40)          # skala 0–40, liczby całkowite
dane <- data.frame(id = 1:(n_i + n_k),
                   grupa = rep(c("interwencja", "kontrola"), c(n_i, n_k)),
                   stres = stres)
write.csv(dane, "../porownanie-z-literatura-wlasne-badanie.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Kolejność poziomów: kontrola – interwencja, więc dodatnie d = niższy stres po treningu (korzyść)
dane$grupa <- factor(dane$grupa, levels = c("kontrola", "interwencja"))
opis <- aggregate(stres ~ grupa, dane, function(x) c(n = length(x), M = mean(x), SD = sd(x)))
opis <- do.call(data.frame, opis); names(opis) <- c("grupa", "n", "M", "SD")
print(transform(opis, M = round(M, 2), SD = round(SD, 2)), row.names = FALSE)

tt <- t.test(stres ~ grupa, data = dane, var.equal = TRUE)   # różnica: kontrola − interwencja
cat(sprintf("\nt(%d) = %.2f, p %s; różnica średnich = %.2f punktu, 95%% CI [%.2f, %.2f]\n",
            tt$parameter, tt$statistic, if (tt$p.value < .001) "< .001" else paste("=", sub("^0", "", sprintf("%.3f", tt$p.value))),
            tt$estimate[1] - tt$estimate[2], tt$conf.int[1], tt$conf.int[2]))

# Wielkość efektu z danych surowych (effectsize): d Cohena i g Hedgesa z 95% CI
print(cohens_d(stres ~ grupa, data = dane)); cat("\n")
print(hedges_g(stres ~ grupa, data = dane)); cat("\n")

# Ten sam wynik ze wzoru, którym w przepisie 2 liczymy badania z literatury
sp <- sqrt(((opis$n[1] - 1) * opis$SD[1]^2 + (opis$n[2] - 1) * opis$SD[2]^2) / (sum(opis$n) - 2))
d <- (opis$M[1] - opis$M[2]) / sp
J <- 1 - 3 / (4 * (sum(opis$n) - 2) - 1)
se_g <- J * sqrt(sum(opis$n) / prod(opis$n) + d^2 / (2 * sum(opis$n)))
cat(sprintf("Ze wzoru: SD połączone = %.2f, d = %.3f, J = %.4f, g = %.3f, 95%% CI [%.2f, %.2f]\n",
            sp, d, J, J * d, J * d - 1.96 * se_g, J * d + 1.96 * se_g))
Wynik w R
       grupa  n     M   SD
    kontrola 42 21.36 7.58
 interwencja 44 16.20 5.19

t(84) = 3.69, p < .001; różnica średnich = 5.15 punktu, 95% CI [2.38, 7.93]
Cohen's d |       95% CI
------------------------
0.80      | [0.35, 1.23]

- Estimated using pooled SD.
Hedges' g |       95% CI
------------------------
0.79      | [0.35, 1.22]

- Estimated using pooled SD.
Ze wzoru: SD połączone = 6.47, d = 0.797, J = 0.9910, g = 0.790, 95% CI [0.35, 1.22]
Badania A–E: przeliczenie na g Hedgesa, wartości p i różnice efektów
R
# B439 – przeliczenie wyników z pięciu FIKCYJNYCH badań na wspólną miarę (g Hedgesa) i porównanie z własnym wynikiem
# Uruchom po b439-1-wlasny-wynik.R. Badania A–E są wymyślone na potrzeby przykładu.
library(effectsize)
options(width = 110)
fp <- function(p) ifelse(p < .001, "< .001", sub("^0", "", sprintf("%.3f", p)))
J     <- function(df) 1 - 3 / (4 * df - 1)                               # poprawka Hedgesa
var_d <- function(d, n1, n2) (n1 + n2) / (n1 * n2) + d^2 / (2 * (n1 + n2)) # wariancja d (grupy niezależne)
wiersz <- function(badanie, raport, d, v, n1, n2, schemat = "dwie grupy") {
  g <- J(n1 + n2 - 2) * d; se <- J(n1 + n2 - 2) * sqrt(v)
  data.frame(badanie, raport, schemat, n = n1 + n2, d = d, g = g, se = se, dolna = g - 1.96 * se, gorna = g + 1.96 * se)
}

# Własne badanie (dane z przepisu 1)
w <- read.csv("../porownanie-z-literatura-wlasne-badanie.csv", fileEncoding = "UTF-8")
mk <- mean(w$stres[w$grupa == "kontrola"]); mi <- mean(w$stres[w$grupa == "interwencja"])
sk <- sd(w$stres[w$grupa == "kontrola"]);  si <- sd(w$stres[w$grupa == "interwencja"])
nk <- sum(w$grupa == "kontrola");          ni <- sum(w$grupa == "interwencja")
sp <- sqrt(((nk - 1) * sk^2 + (ni - 1) * si^2) / (nk + ni - 2))
d0 <- (mk - mi) / sp
tab <- wiersz("Własne badanie", "dane surowe", d0, var_d(d0, nk, ni), nk, ni)

# A: średnie i SD (ta sama skala 0–40). Kontrola M = 18.9 (SD = 6.3), n = 33; trening M = 15.8 (SD = 5.9), n = 35
spA <- sqrt((32 * 6.3^2 + 34 * 5.9^2) / 66)
dA <- (18.9 - 15.8) / spA
tA <- dA / sqrt(1 / 33 + 1 / 35)
tab <- rbind(tab, wiersz("A", "M i SD", dA, var_d(dA, 33, 35), 33, 35))
cat(sprintf("A: SD połączone = %.2f, d = %.3f (to samo co t(66) = %.2f)\n", spA, dA, tA))

# B: korelacja punktowo-dwuseryjna r = .30 (przynależność do grupy × wynik), po 30 osób
dB <- 2 * 0.30 / sqrt(1 - 0.30^2)
tab <- rbind(tab, wiersz("B", "r punktowo-dwuseryjne", dB, var_d(dB, 30, 30), 30, 30))
cat(sprintf("B: d = 2r / sqrt(1 - r^2) = %.3f; effectsize::r_to_d(.30) = %.3f\n", dB, r_to_d(0.30)))

# C: ANOVA dla dwóch grup F(1, 118) = 9.61, po 60 osób (bez zmiennych towarzyszących) – t = sqrt(F)
tC <- sqrt(9.61)
dC <- tC * sqrt(1 / 60 + 1 / 60)
tab <- rbind(tab, wiersz("C", "F(1, df)", dC, var_d(dC, 60, 60), 60, 60))
cat(sprintf("C: t = sqrt(F) = %.2f, d = t * sqrt(1/n1 + 1/n2) = %.3f\n", tC, dC))
print(F_to_d(9.61, 1, 118)); cat("\n")

# D: wynik dwuwartościowy (wysoki stres): trening 14/50, kontrola 25/50; artykuł podaje chi^2 i odsetki
m <- matrix(c(25, 25, 14, 36), 2, byrow = TRUE, dimnames = list(c("kontrola", "trening"), c("wysoki", "niski")))
ch <- chisq.test(m, correct = FALSE)
OR <- (m[1, 1] * m[2, 2]) / (m[1, 2] * m[2, 1])         # szansa wysokiego stresu: kontrola vs trening
v_lnOR <- sum(1 / m)
dD <- log(OR) * sqrt(3) / pi
cat(sprintf("D: chi^2(1, N = %d) = %.2f; OR = %.2f, 95%% CI [%.2f, %.2f]; d = ln(OR) * sqrt(3)/pi = %.3f\n",
            sum(m), ch$statistic, OR, exp(log(OR) - 1.96 * sqrt(v_lnOR)), exp(log(OR) + 1.96 * sqrt(v_lnOR)), dD))
cat(sprintf("   effectsize::oddsratio_to_d(%.2f) = %.3f\n", OR, oddsratio_to_d(OR)))
tab <- rbind(tab, wiersz("D", "OR z tabeli 2×2", dD, v_lnOR * 3 / pi^2, 50, 50))

# E: jedna grupa, przed i po treningu (bez kontroli): M = 22.4 (SD = 6.8) i 19.0 (SD = 7.1), n = 40, t(39) = 4.60
n <- 40; md <- 22.4 - 19.0; s1 <- 6.8; s2 <- 7.1; tE <- 4.60
sd_diff <- md * sqrt(n) / tE
r <- (s1^2 + s2^2 - sd_diff^2) / (2 * s1 * s2)            # korelacja pomiarów odtworzona z t, M i SD
dz <- tE / sqrt(n); dav <- md / ((s1 + s2) / 2); drm <- dz * sqrt(2 * (1 - r))
cat(sprintf("E: SD różnic = %.2f, odtworzone r = %s; d_z = %.3f, d_av = %.3f, d_rm = %.3f\n", sd_diff, sub("^0", "", sprintf("%.2f", r)), dz, dav, drm))
print(t_to_d(4.60, 39, paired = TRUE)); cat("\n")
vE <- (1 / n + dav^2 / (2 * n)) * 2 * (1 - r)              # wariancja d dla prób zależnych
gE <- J(n - 1) * dav
tab <- rbind(tab, data.frame(badanie = "E", raport = "t dla prób zależnych", schemat = "przed–po, bez kontroli",
                             n = n, d = dav, g = gE, se = J(n - 1) * sqrt(vE),
                             dolna = gE - 1.96 * J(n - 1) * sqrt(vE), gorna = gE + 1.96 * J(n - 1) * sqrt(vE)))

wyn <- transform(tab, d = round(d, 2), g = round(g, 2), se = round(se, 3), dolna = round(dolna, 2), gorna = round(gorna, 2))
cat("Wspólna miara: g Hedgesa (dodatnie = niższy stres po treningu)\n")
print(wyn, row.names = FALSE)
write.csv(wyn, "../porownanie-z-literatura-zestawienie.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Wartości p w artykułach – nie mówią, czy efekty się różnią
p <- c(2 * pt(-abs(d0 / sqrt(1 / nk + 1 / ni)), nk + ni - 2), 2 * pt(-abs(tA), 66),
       2 * pt(-abs(0.30 * sqrt(58 / (1 - 0.30^2))), 58), pf(9.61, 1, 118, lower.tail = FALSE), ch$p.value)
cat("\nWartości p:", paste(sprintf("%s %s", c("własne", "A", "B", "C", "D"), fp(p)), collapse = "; "), "\n")

# Czy własny efekt różni się od efektu z badania X? Test z dla różnicy dwóch niezależnych g
z <- (tab$g[1] - tab$g[2:5]) / sqrt(tab$se[1]^2 + tab$se[2:5]^2)
roznice <- data.frame(badanie = tab$badanie[2:5], roznica_g = round(tab$g[1] - tab$g[2:5], 2),
                      z = round(z, 2), p = fp(2 * pnorm(-abs(z))))
cat("\nRóżnica: własne g minus g z badania\n"); print(roznice, row.names = FALSE)
cat(sprintf("\nZakres g w badaniach A–D: od %.2f do %.2f\n", min(tab$g[2:5]), max(tab$g[2:5])))
Wynik w R
A: SD połączone = 6.10, d = 0.508 (to samo co t(66) = 2.10)
B: d = 2r / sqrt(1 - r^2) = 0.629; effectsize::r_to_d(.30) = 0.629
C: t = sqrt(F) = 3.10, d = t * sqrt(1/n1 + 1/n2) = 0.566
d    |       95% CI
-------------------
0.57 | [0.20, 0.94]

D: chi^2(1, N = 100) = 5.09; OR = 2.57, 95% CI [1.12, 5.90]; d = ln(OR) * sqrt(3)/pi = 0.521
   effectsize::oddsratio_to_d(2.57) = 0.521
E: SD różnic = 4.67, odtworzone r = .77; d_z = 0.727, d_av = 0.489, d_rm = 0.488
d    |       95% CI
-------------------
0.74 | [0.38, 1.09]

Wspólna miara: g Hedgesa (dodatnie = niższy stres po treningu)
        badanie                raport                schemat   n    d    g    se dolna gorna
 Własne badanie           dane surowe             dwie grupy  86 0.80 0.79 0.222  0.35  1.22
              A                M i SD             dwie grupy  68 0.51 0.50 0.244  0.02  0.98
              B r punktowo-dwuseryjne             dwie grupy  60 0.63 0.62 0.261  0.11  1.13
              C              F(1, df)             dwie grupy 120 0.57 0.56 0.185  0.20  0.92
              D       OR z tabeli 2×2             dwie grupy 100 0.52 0.52 0.232  0.06  0.97
              E  t dla prób zależnych przed–po, bez kontroli  40 0.49 0.48 0.110  0.26  0.70

Wartości p: własne < .001; A .040; B .020; C .002; D .024

Różnica: własne g minus g z badania
 badanie roznica_g    z    p
       A      0.29 0.87 .384
       B      0.17 0.49 .622
       C      0.23 0.79 .432
       D      0.27 0.85 .395

Zakres g w badaniach A–D: od 0.50 do 0.62
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem effectsize; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim wstawisz porównanie do dyskusji, sprawdź…
- Czy wszystkie cytowane badania odpowiadają na to samo pytanie (ta sama interwencja lub zmienna, podobna populacja, porównywalna grupa kontrolna)?
- Czy wybrałeś(-aś) jedną wspólną miarę i jeden kierunek znaku?
- Czy w tabelach artykułów są SD, a nie SE?
- Czy F ma 1 stopień swobody w liczniku i nie pochodzi z ANCOVA?
- Czy badania przed–po przeliczono na dav lub drm i oznaczono osobno?
- Czy zdanie „większy/mniejszy niż w literaturze” ma za sobą test różnicy?
- Czy w nocie lub metodzie opisano przeliczenia i zaznaczono, że to nie metaanaliza?
Najczęstsze pytania
Jak porównać wielkość efektu z mojej pracy z wynikami innych badań?
Wybierz jedną miarę (przy dwóch grupach zwykle g Hedgesa) i jeden kierunek znaku. Przelicz na nią wyniki z artykułów, dodaj do każdego 95% przedział ufności i pokaż wszystko w tabeli lub na wykresie punktowym. W dyskusji porównuj kierunek i rząd wielkości efektów, a nie to, czy wyszły istotne. Przy każdym badaniu zapisz, z jakiej statystyki i jakim wzorem policzono efekt.
Czy mogę policzyć d Cohena, jeśli artykuł podaje tylko F z ANOVA?
Tak, jeśli F ma jeden stopień swobody w liczniku, czyli porównuje dwie grupy, i nie pochodzi z ANCOVA. Wtedy t = √F, a d = t × √(1/n₁ + 1/n₂); znak bierzesz z opisu wyników. W przykładzie F(1, 118) = 9.61 dało d = 0.57. Przy F z większą liczbą stopni swobody szukaj średnich i SD dwóch grup, które chcesz porównać.
Mój efekt jest większy niż w literaturze – czy mogę tak napisać?
Dopiero wtedy, gdy sprawdzisz różnicę. Policz z = (g₁ − g₂) / √(SE₁² + SE₂²). W przykładzie własne g = 0.79 i g = 0.50 z badania A różniły się o 0.29, ale z = 0.87, p = .384 – tej różnicy nie da się odróżnić od przypadku. Bezpieczniej napisać, że wynik jest zgodny co do kierunku i rzędu wielkości, a oszacowanie było nieco wyższe.
Czy wolno uśrednić efekty z kilku cytowanych badań?
W dyskusji pracy dyplomowej lepiej tego nie robić. Średnia z badań, które akurat cytujesz, nie jest metaanalizą: brakuje systematycznego wyszukiwania, wag i oceny heterogeniczności, więc wynik zależy od Twojego wyboru literatury. Podaj zakres efektów (np. od 0.50 do 0.62). Jeśli potrzebujesz efektu łącznego, przeprowadź metaanalizę zgodnie z jej procedurą.
Dlaczego efekt z badania przed–po wychodzi większy niż z badania z grupą kontrolną?
Często dlatego, że policzono d_z, czyli średnią różnic podzieloną przez SD różnic. Przy wysokiej korelacji pomiarów SD różnic jest małe, więc d_z rośnie, choć sama różnica się nie zmienia. W przykładzie d_z wyniosło 0.73, a d_av – 0.49. Do porównań z grupami niezależnymi używaj d_av lub d_rm. Pamiętaj też, że bez grupy kontrolnej spadek obejmuje także upływ czasu i regresję do średniej.
Powiązane hasła
Przeczytaj też
Jak czytać artykuł przed zacytowaniem
Kolejność czytania, dziesięć pytań o próbę, pomiar i efekt, karta oceny do skopiowania i rozłożony na części fikcyjny artykuł.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikKonwerter wielkości efektu
Przelicz t na d Cohena, d na r i iloraz szans, η² na f albo d na NNT. Wzory ze źródłami, przykład w R i gotowe zdania do pracy.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikPrzedziały ufności w pracy dyplomowej
Zapis APA, wybór przedziału dla średniej, odsetka, różnicy, korelacji i OR, poprawne i błędne zdania, nakładanie się przedziałów i słupki błędów – z tabelą wyników w R.
Czytaj →Porównujesz swoje wyniki z literaturą w dyskusji?
Pomożemy przeliczyć wyniki z artykułów na wspólną miarę, przygotować wykres z przedziałami ufności i napisać porównanie, które obronisz przed promotorem i recenzentem – w R lub SPSS, z wyjaśnieniem każdego kroku.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2009). Introduction to meta-analysis. Wiley. https://doi.org/10.1002/9780470743386
- Chinn, S. (2000). A simple method for converting an odds ratio to effect size for use in meta-analysis. Statistics in Medicine, 19(22), 3127–3131. https://doi.org/10.1002/1097-0258(20001130)19:22<3127::aid-sim784>3.0.co;2-m
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Docherty, M., & Smith, R. (1999). The case for structuring the discussion of scientific papers. BMJ, 318(7193), 1224–1225. https://doi.org/10.1136/bmj.318.7193.1224 ● Otwarty dostęp: pełny tekst
- Dunlap, W. P., Cortina, J. M., Vaslow, J. B., & Burke, M. J. (1996). Meta-analysis of experiments with matched groups or repeated measures designs. Psychological Methods, 1(2), 170–177. https://doi.org/10.1037/1082-989x.1.2.170
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Morris, S. B., & DeShon, R. P. (2002). Combining effect size estimates in meta-analysis with repeated measures and independent-groups designs. Psychological Methods, 7(1), 105–125. https://doi.org/10.1037/1082-989x.7.1.105
Cytowania BibTeX
@book{borenstein2009introduction, author={Borenstein, Michael and Hedges, Larry V. and Higgins, Julian P. T. and Rothstein, Hannah R.}, title={{Introduction to meta-analysis}}, year={2009}, publisher={Wiley}, doi={10.1002/9780470743386}}@article{chinn2000simple, author={Chinn, Susan}, title={{A simple method for converting an odds ratio to effect size for use in meta-analysis}}, journal={Statistics in Medicine}, year={2000}, volume={19}, number={22}, pages={3127--3131}, doi={10.1002/1097-0258(20001130)19:22<3127::aid-sim784>3.0.co;2-m}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{docherty1999case, author={Docherty, Michael and Smith, Richard}, title={{The case for structuring the discussion of scientific papers}}, journal={BMJ}, year={1999}, volume={318}, number={7193}, pages={1224--1225}, doi={10.1136/bmj.318.7193.1224}}@article{dunlap1996metaanalysis, author={Dunlap, William P. and Cortina, Jose M. and Vaslow, Joel B. and Burke, Michael J.}, title={{Meta-analysis of experiments with matched groups or repeated measures designs}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={170--177}, doi={10.1037/1082-989x.1.2.170}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{hedges1981distribution, author={Hedges, Larry V.}, title={{Distribution theory for Glass’s estimator of effect size and related estimators}}, journal={Journal of Educational Statistics}, year={1981}, volume={6}, number={2}, pages={107--128}, doi={10.3102/10769986006002107}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{morris2002combining, author={Morris, Scott B. and DeShon, Richard P.}, title={{Combining effect size estimates in meta-analysis with repeated measures and independent-groups designs}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={105--125}, doi={10.1037/1082-989x.7.1.105}}