Czy wystarczy przeczytać streszczenie?
W rozdziale teoretycznym brakuje źródła do jednego zdania. Znajdujesz artykuł, w streszczeniu stoi „program skutecznie obniżył stres”, więc przepisujesz wniosek. Tu mogą zawieść dwie rzeczy. Po pierwsze, streszczenie: w przeglądzie 17 badań porównujących abstrakty z pełnymi raportami z biomedycyny mediana niezgodności wyniosła 39%, a poważnych niezgodności 19% (Li i in., 2017). Po drugie, cytujący: w metaanalizie 28 badań artykułów medycznych błędy cytowania oszacowano na 25.4%, w tym 11.9% poważnych (Jergas i Baethge, 2015). Greenhalgh (1997) zaczyna swoją serię o czytaniu artykułów od przypomnienia, które zwykle zaskakuje studentów: części publikacji, być może większości, nie należy traktować jako podstawy działania.
Ten wpis jest dla kogoś, kto ma jeden artykuł, kilkanaście minut i jedną decyzję: czy to cytować, na poparcie czego i jakim czasownikiem. Nie jest instrukcją przeglądu systematycznego. Formalną ocenę opisują wpisy o RoB 2 i ROBINS-I oraz GRADE. Szukanie źródeł omawia poradnik o przeglądzie literatury, a pisanie akapitu z przeczytanych prac – wpis o syntezie literatury. Tu zajmujemy się tym, co dzieje się między znalezieniem artykułu a zdaniem w Twojej pracy.
W jakiej kolejności czytać
Układ artykułu IMRAD służy autorom, którzy prowadzą Cię do wniosku. Czytając od streszczenia przez wstęp do dyskusji, znasz wniosek, zanim zobaczysz dowód, i potem już tylko szukasz jego potwierdzenia. Odwróć to (rysunek 1). Streszczenie przeczytaj raz, by ustalić, czy artykuł jest na temat, a potem odłóż je na bok.
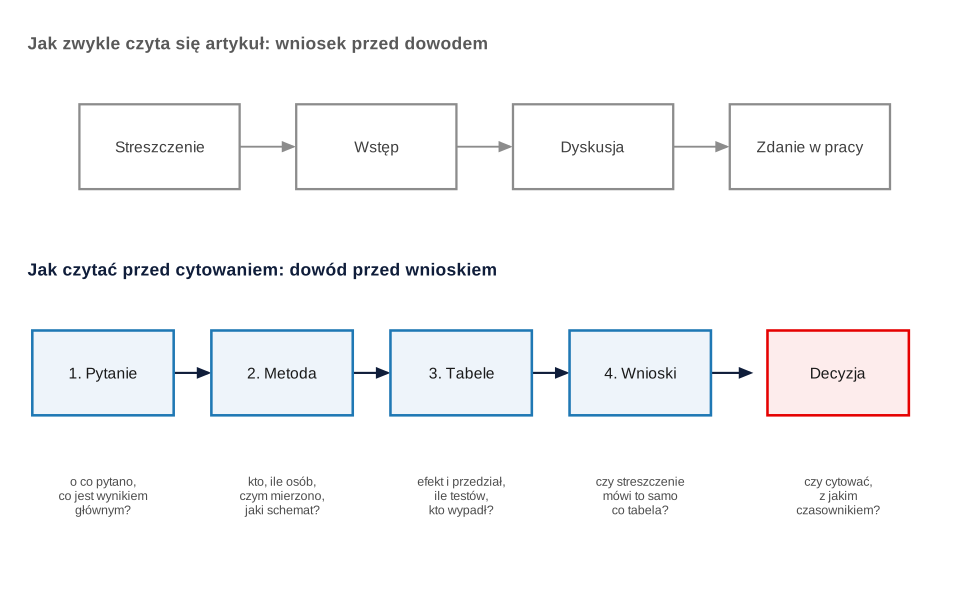
- Pytanie. Koniec wstępu: cel i hipotezy. Zapisz jednym zdaniem, o co pytano i co miało być wynikiem głównym.
- Metoda. Kto, ile osób, czym mierzono, jaki schemat. Zanim zobaczysz wynik, odpowiedz sobie: jaki wniosek ten plan w ogóle dopuszcza?
- Tabele i rysunki. Liczby przed tekstem Wyników. Znajdź wynik główny, zanotuj wielkość efektu i przedział.
- Wnioski. Dopiero teraz Dyskusja i ponownie streszczenie. Porównaj je ze swoją notatką.
Dziesięć pytań do artykułu
Pytania są ułożone w kolejności czytania. Nie każda słabość dyskwalifikuje artykuł. Chodzi o to, by wiedzieć, ile uniesie Twoje zdanie.
- Kto był badany i jak go dobrano? Populacja, miejsce, kryteria, sposób rekrutacji. Ochotnicy z jednego wydziału (dobór wygodny) nie mówią o „studentach w Polsce”. Sprawdź, czy ta próba w ogóle przypomina osoby, o których piszesz (trafność zewnętrzna).
- Ile osób i ile wypadło? N bierz z Wyników, nie ze streszczenia, a obok zapisz, ilu włączono. Nie ma jednego progu, od którego utrata uczestników staje się problemem. Liczy się m.in. to, czy odsetki różnią się między grupami i czy osoby utracone różnią się od pozostałych (Dumville i in., 2006).
- Czym mierzono i czy wiadomo, że to działa? Nazwa i pochodzenie narzędzia, rzetelność w tej próbie, dowody trafności. Flake i Fried (2020) pokazują, że gdy pomiar opisano nieprzejrzyście, zagrożeń dla trafności wniosków nie da się ocenić. Zanotuj skale autorskie, jedno pytanie w miejsce skali i brak jakichkolwiek danych o narzędziu.
- Jaki schemat i czy pozwala na taki język? Losowy przydział, grupy nierównoważne czy jeden pomiar? Bez losowania zostają zmienne zakłócające, a korelacja nie jest dowodem przyczynowości. Działa to też w drugą stronę: Hernán (2018) zwraca uwagę, że autorzy często przedstawiają oszacowania przyczynowe jako „związki”. Czytaj więc także rekomendacje. „Związek”, po którym następuje „należy wdrożyć”, jest wnioskiem przyczynowym.
- Jak duży efekt i jak niepewny? Szukaj wielkości efektu w jednostkach skali lub standaryzowanej oraz przedziału ufności, a nie samego p (interpretacja efektu, interpretacja p). Przedział obejmujący i brak efektu, i efekt znaczący oznacza, że sprawa jest nierozstrzygnięta. Jeśli autorzy go nie podali, policzysz go z tabeli (kod niżej). Do porównania z własnym wynikiem służy przeliczanie efektów.
- Ile porównań wykonano? Policz testy w tabelach, nie tylko te omówione. Przy wielu testach pojedyncze p tuż poniżej .05 znaczy niewiele. Simmons i in. (2011) pokazali, że elastyczność w zbieraniu, analizie i raportowaniu danych silnie zwiększa odsetek wyników fałszywie pozytywnych (p-hacking). Sprawdź też, czy autorzy zastosowali poprawkę albo przynajmniej zaznaczyli, że analizy są eksploracyjne.
- Co było wynikiem głównym i czy zapisano to z góry? Szukaj numeru w rejestrze lub adresu prerejestracji i porównaj: data rejestracji a początek zbierania danych, zapisany wynik główny a opisany. Chan i in. (2004) w kohorcie 102 badań randomizowanych stwierdzili, że w 62% co najmniej jeden pierwszorzędowy wynik zmieniono, dodano lub pominięto względem protokołu. Brak rejestracji jest w wielu dziedzinach nadal częsty, więc sam niczego nie przesądza. Oznacza tylko, że nie masz jak odróżnić planu od hipotezy dopisanej po wynikach.
- Czy streszczenie mówi to samo co tabela? N, wynik główny, kierunek, wniosek. Boutron i in. (2010) opisali 72 raporty badań randomizowanych z nieistotnym wynikiem pierwszorzędowym. We wnioskach abstraktu 58.3% zawierało spin, czyli sposób opisu podkreślający korzyść mimo braku różnicy. Formy tego zjawiska omawia wpis o abstrakcie. Jedna z nich jest szczególnie łatwa do przeoczenia: wynik istotny w jednej grupie i nieistotny w drugiej nie jest testem różnicy między nimi (Nieuwenhuis i in., 2011).
- Kto za to zapłacił i kto na tym zyska? Końcowe sekcje o finansowaniu i konflikcie interesów. W przeglądzie 75 prac o badaniach leków i wyrobów medycznych badania sponsorowane przez przemysł częściej miały korzystne wyniki skuteczności (RR = 1.27, 95% CI [1.17, 1.37]; Lundh i in., 2017). Sponsor nie czyni wyniku błędnym. To powód, by dokładniej odpowiedzieć na pytania 6–8.
- Gdzie to opublikowano i czy nadal obowiązuje? Sprawdź, czy czasopismo ma recenzję i przejrzyste zasady (jak rozpoznać czasopismo drapieżne). Na stronie artykułu poszukaj erraty albo noty o wycofaniu. Prestiż tytułu nie zastępuje pytań 1–8, a słabe czasopismo nie unieważnia dobrze opisanych danych, ale każe sprawdzić je dokładniej.
Fikcyjne streszczenie rozłożone na części
Artykuł poniżej nie istnieje, a jego autorzy, czasopismo i liczby są wymyślone. Wejściowe średnie, odchylenia i liczebności wpisano ręcznie, a wszystko, co z nich wyliczono, policzył kod na końcu wpisu.
Cel. Zbadano skuteczność 8-tygodniowego programu uważności w aplikacji mobilnej w redukcji stresu u studentów.
Metoda. W badaniu wzięło udział 96 studentów (program: 48, grupa porównawcza: 48). Mierzono stres oraz wskaźniki dobrostanu.
Wyniki. W grupie programu odnotowano istotny spadek stresu (p = .009) oraz istotnie lepszą jakość snu niż w grupie porównawczej (p = .032).
Wnioski. Program skutecznie redukuje stres i poprawia sen, dlatego może być rekomendowany studentom.
Brzmi dobrze. Oto, co widać po przejściu dziesięciu pytań przez cały tekst.
| Pytanie | Co jest w tekście (fikcyjnie) | Co z tego wynika |
|---|---|---|
| 1. Dobór | Ogłoszenie na jednym wydziale. Grupa programu to osoby, które same pobrały aplikację, porównawcza – te, które nie chciały. Wcześniej medytowało 41.7% w grupie programu i 16.7% w porównawczej (p = .013) | Samoselekcja: grupy różniły się już na starcie |
| 2. Ubytek | Włączono 148 osób (88 i 60), ukończyło 96 (64.9%). Ubytek 45.5% wobec 20.0% (p = .002). Analiza tylko osób kompletnych | Streszczenie podaje jedynie 96. W grupie programu wypadła niemal połowa osób, być może te, którym program nie pomagał |
| 3. Pomiar | Stres: sześć pytań autorskich, α = .58. Sen: jedno pytanie | Główny wynik mierzono słabo, bez dowodów trafności |
| 4. Schemat | Bez losowania, dwa pomiary | „Skuteczność” i „redukuje” są nieuprawnione |
| 5. Efekt | Stres, różnica zmian: −1.10 punktu, 95% CI [−3.23, 1.03], t(93.97) = −1.03, p = .307, d = −0.21, 95% CI [−0.61, 0.19] | Wynik główny nie rozstrzyga niczego |
| 6. Porównania | 12 wyników bez poprawki, jeden z p < .05 (sen). Próg Bonferroniego: .0042 | Przy 12 niezależnych testach bez efektu szansa choć jednego p < .05 wynosi .46. Sen (p = .032) progu nie przekracza |
| 7. Wynik główny, rejestracja | W Metodzie głównym wynikiem jest stres. Brak numeru rejestru | Nie wiadomo, czy tak planowano. Zapis w Metodzie i tak każe oceniać stres, a nie sen |
| 8. Streszczenie a tabela | Spadek stresu o 2.10 punktu w grupie programu (t(47) = −2.75, p = .009) i o 1.00 w porównawczej (t(47) = −1.33, p = .189) | Streszczenie podaje zmianę w jednej grupie, pomija test różnicy między grupami |
| 9. Finansowanie | Badanie sfinansował producent aplikacji, jeden z autorów jest jego konsultantem. Informacja w przypisie | Powód do większej uwagi przy punktach 6–8 |
| 10. Czasopismo | Od zgłoszenia do przyjęcia 9 dni, brak opisu recenzji | Sprawdź czasopismo, zanim na nim oprzesz twierdzenie |
Rysunek 2 pokazuje tabelę wyników z tego artykułu. Dla stresu przedział obejmuje zero. Czerwony wynik to ten, który trafił do streszczenia jako główna wiadomość obok spadku w jednej grupie, ale pochodzi z jednego pytania i jest jednym z dwunastu.
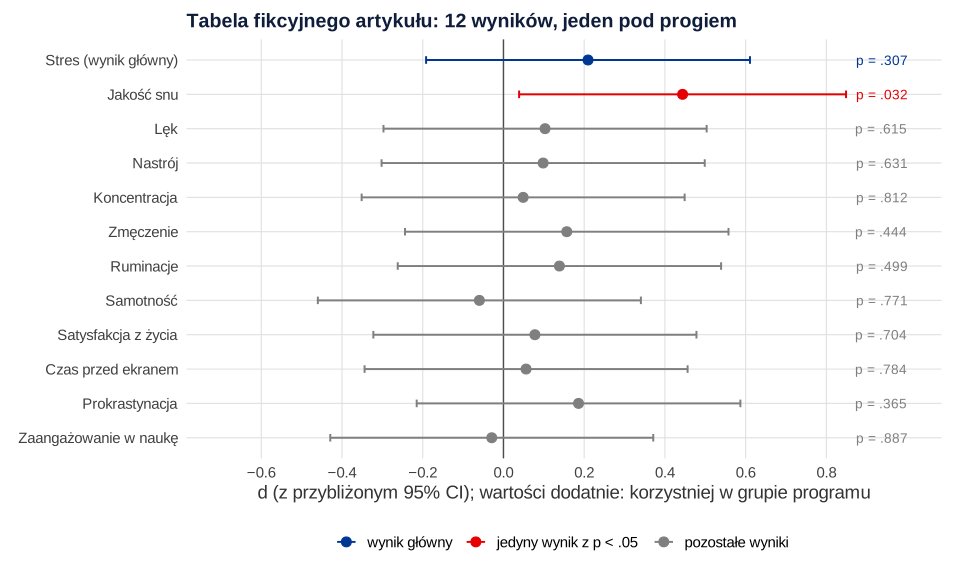
Ocena. Ten artykuł nie może być dowodem skuteczności programu. Możesz go przywołać jako badanie wstępne, nierandomizowane, które nie pokazało przewagi w wyniku głównym. Jeśli masz badania z losowym przydziałem, nie potrzebujesz go wcale. A jeśli ciekawi Cię, czy efekt się powtórzy, to materiał na replikację, a nie na zdanie „wykazano”.
Od oceny do zdania w pracy
Różnicę między „wykazali” a „zaobserwowali związek” rozstrzyga schemat i wynik, a nie styl. Pełną skalę czasowników znajdziesz w syntezie literatury, a zamienniki w języku pracy naukowej. Tu jedynie przełożenie wyniku Twojej karty na siłę zdania.
| Wynik oceny | Jak mocno możesz napisać |
|---|---|
| Losowy przydział, wynik główny, przedział wyklucza brak efektu, mały ubytek | „W badaniu randomizowanym stwierdzono, że…”; „wykazali” tylko przy zgodnych replikacjach |
| Jeden pomiar lub grupy nielosowe | „Zaobserwowano związek…”, „osoby z… miały wyższe…”, bez „wpływu” |
| Wynik nieistotny, szeroki przedział | „Wynik nie rozstrzyga, czy…”; nie „nie ma związku” (wynik nieistotny) |
| Wynik dodatkowy, jeden z wielu, bez poprawki | „W analizie eksploracyjnej…” albo wcale |
| Poważne usterki pomiaru, doboru lub rozbieżność z tabelą | Nie jako dowód. Ewentualnie jako przykład badania wymagającego potwierdzenia, z nazwaną słabością |
Trzy zdania o naszym fikcyjnym artykule. „[autorzy, rok]” zastępuje cytowanie.
Jak bywa napisane: „Program uważności w aplikacji skutecznie redukuje stres u studentów [autorzy, rok].”
Co jest nie tak: przepisany wniosek ze streszczenia, brak losowania, a wynik główny nie różni grup.
Poprawione: „W nierandomizowanym badaniu 96 studentów zmiana stresu nie różniła się wyraźnie między osobami korzystającymi z aplikacji a grupą porównawczą (różnica = −1.10 punktu, 95% CI [−3.23, 1.03]) [autorzy, rok].”
Jak bywa napisane: „Wykazano, że aplikacja poprawia jakość snu [autorzy, rok].”
Co jest nie tak: jedno pytanie, jeden wynik z dwunastu, brak poprawki, „wykazano” i „poprawia”.
Poprawione: „Spośród 12 analizowanych wyników różnicę na korzyść programu odnotowano tylko dla jakości snu, mierzonej jednym pytaniem (d = 0.44, 95% CI [0.04, 0.85]), bez korekty na wielokrotne porównania, dlatego wynik ten należy traktować jako eksploracyjny [autorzy, rok].”
Jak bywa napisane: „Badania potwierdzają skuteczność aplikacji do uważności [autorzy, rok].”
Co jest nie tak: liczba mnoga przy jednym źródle i wniosek, którego źródło nie uzasadnia.
Poprawione: „Dotychczasowe dane są nierozstrzygające. W jedynym znalezionym badaniu grupy nie różniły się wyraźnie pod względem stresu, a przydział do grup nie był losowy [autorzy, rok].”
Zanim powtórzysz sformułowanie autorów z ich Dyskusji, sprawdź, czy zdanie opisuje wynik badania, czy tylko ich interpretację. W drugim przypadku napisz to wprost: „autorzy interpretują to jako…”.
Karta oceny do skopiowania
Wypełnij jedną kartę na artykuł i dopisz ją do macierzy literatury. Dzięki temu, pisząc rozdział po miesiącu, nie musisz czytać wszystkiego od nowa.
Źródło: [autorzy, rok, DOI]. Przeczytano: [całość / tylko abstrakt]. Twierdzenie, które ma poprzeć: [zdanie z mojej pracy].
Pytanie badania i wynik główny: [jedno zdanie].
1. Kto i jak dobrany: [populacja, rekrutacja]. Czy pasuje do mojej populacji: [tak / częściowo / nie].
2. N i ubytek: włączono [ ], analizowano [ ], ubytek w grupach [ ]; analiza [wszystkich / kompletnych].
3. Pomiar: [narzędzie, rzetelność w tej próbie, dowody trafności].
4. Schemat i język: [losowy / nielosowy / przekrojowy]; czy wnioski odpowiadają schematowi: [tak / nie].
5. Efekt: [miara i wartość], 95% CI [ , ]; znaczenie praktyczne: [ ].
6. Liczba porównań: [ ]; poprawka: [tak / nie / eksploracyjne].
7. Wynik główny w rejestrze: [numer, data, zgodność z artykułem / brak].
8. Streszczenie a tabela: [zgodne / rozbieżność: jaka].
9. Finansowanie i konflikt interesów: [ ].
10. Czasopismo, errata, wycofanie: [ ].
Decyzja: [cytuję jako dowód / cytuję z zastrzeżeniem / nie cytuję]. Czasownik: [ ]. Moje zdanie: [ ].
Co policzyć z tabeli artykułu w R
Gdy artykuł podaje tylko M, SD i n, możesz sam dojść do różnicy z przedziałem i d. Kod liczy wszystkie wielkości z tabeli i rysunku 2. Nie ma tu elementu losowego: dane wejściowe to fikcyjne statystyki wpisane ręcznie. Przedział dla d jest przybliżony.
Przeliczenie fikcyjnej tabeli
R
# Co policzyć z tabeli artykułu, zanim go zacytujesz (artykuł i wszystkie liczby wejściowe są fikcyjne)
# Wejście: zmiana przed–po (M, SD) w obu grupach, liczebności, przepływ uczestników.
options(width = 130)
n1 <- 48; n2 <- 48                                     # program, porównanie (ukończyli badanie)
tab <- data.frame(
  wynik = c("Stres (wynik główny)", "Jakość snu", "Lęk", "Nastrój", "Koncentracja", "Zmęczenie",
            "Ruminacje", "Samotność", "Satysfakcja z życia", "Czas przed ekranem", "Prokrastynacja",
            "Zaangażowanie w naukę"),
  m1 = c(-2.1, 0.9, -1.2, 0.6, 0.3, -0.5, -1.0, -0.2, 0.4, -8, -0.7, 0.5),
  s1 = c(5.3, 1.7, 4.8, 3.1, 2.0, 2.6, 5.0, 3.4, 3.9, 55, 4.2, 3.5),
  m2 = c(-1.0, 0.1, -0.7, 0.3, 0.2, -0.1, -0.3, -0.4, 0.1, -5, 0.1, 0.6),
  s2 = c(5.2, 1.9, 4.9, 3.0, 2.1, 2.5, 5.1, 3.3, 3.8, 52, 4.4, 3.4),
  lepiej = c(-1, 1, -1, 1, 1, -1, -1, -1, 1, -1, -1, 1))  # -1: mniej znaczy lepiej

# Różnica średnich z przedziałem (Welch) i d z przybliżonym przedziałem, liczone z M, SD i n
z_tabeli <- function(m1, s1, n1, m2, s2, n2) {
  se <- sqrt(s1^2 / n1 + s2^2 / n2)
  df <- se^4 / ((s1^2 / n1)^2 / (n1 - 1) + (s2^2 / n2)^2 / (n2 - 1))
  roz <- m1 - m2
  sp <- sqrt(((n1 - 1) * s1^2 + (n2 - 1) * s2^2) / (n1 + n2 - 2))
  d <- roz / sp
  se_d <- sqrt((n1 + n2) / (n1 * n2) + d^2 / (2 * (n1 + n2)))
  c(roznica = roz, dolna = roz - qt(.975, df) * se, gorna = roz + qt(.975, df) * se,
    t = roz / se, df = df, p = 2 * pt(-abs(roz / se), df),
    d = d, d_dolna = d - 1.96 * se_d, d_gorna = d + 1.96 * se_d)
}
wyn <- t(mapply(z_tabeli, tab$m1, tab$s1, n1, tab$m2, tab$s2, n2))
wynik <- data.frame(wynik = tab$wynik, round(wyn, 3))
print(wynik, row.names = FALSE)

cat("\nLiczba wyników p < .05:", sum(wyn[, "p"] < .05), "z", nrow(wyn), "\n")
cat("Próg po poprawce Bonferroniego:", round(.05 / nrow(wyn), 4), "\n")
cat("Szansa co najmniej jednego p < .05 przy 12 niezależnych testach bez efektu:",
    round(1 - .95^12, 3), "\n")

# Zmiana w każdej grupie osobno (to bywa w streszczeniu) a różnica między grupami
jedna <- function(m, s, n) {
  t <- m / (s / sqrt(n))
  c(t = round(t, 2), p = round(2 * pt(-abs(t), n - 1), 3))
}
cat("\nStres, zmiana w grupie programu:   "); print(jedna(-2.1, 5.3, n1))
cat("Stres, zmiana w grupie porównawczej:"); print(jedna(-1.0, 5.2, n2))

# Przepływ uczestników i różnica między grupami na starcie
wlaczeni <- c(program = 88, porownanie = 60)
ukonczyli <- c(program = 48, porownanie = 48)
cat("\nUbytek (%):", round(100 * (1 - ukonczyli / wlaczeni), 1),
    "| razem ukończyło:", sum(ukonczyli), "z", sum(wlaczeni),
    paste0("(", round(100 * sum(ukonczyli) / sum(wlaczeni), 1), "%)"), "\n")
cat("Test Fishera, ubytek a grupa, wartość p:", round(fisher.test(cbind(wlaczeni - ukonczyli, ukonczyli))$p.value, 3), "\n")

medytacja <- c(program = 20, porownanie = 8)           # wcześniejsze doświadczenie z medytacją
cat("Medytowali wcześniej (%):", round(100 * medytacja / c(n1, n2), 1), "\n")
cat("Test Fishera, medytacja a grupa, wartość p:", round(fisher.test(cbind(medytacja, c(n1, n2) - medytacja))$p.value, 3), "\n")
Wynik
                 wynik roznica   dolna  gorna      t     df     p      d d_dolna d_gorna
  Stres (wynik główny)    -1.1  -3.228  1.028 -1.026 93.966 0.307 -0.210  -0.611   0.192
            Jakość snu     0.8   0.069  1.531  2.174 92.861 0.032  0.444   0.039   0.849
                   Lęk    -0.5  -2.466  1.466 -0.505 93.960 0.615 -0.103  -0.503   0.297
               Nastrój     0.3  -0.936  1.536  0.482 93.899 0.631  0.098  -0.302   0.499
          Koncentracja     0.1  -0.731  0.931  0.239 93.777 0.812  0.049  -0.351   0.449
             Zmęczenie    -0.4  -1.434  0.634 -0.768 93.856 0.444 -0.157  -0.558   0.244
             Ruminacje    -0.7  -2.747  1.347 -0.679 93.963 0.499 -0.139  -0.539   0.262
             Samotność     0.2  -1.158  1.558  0.292 93.916 0.771  0.060  -0.340   0.460
   Satysfakcja z życia     0.3  -1.261  1.861  0.382 93.937 0.704  0.078  -0.322   0.478
    Czas przed ekranem    -3.0 -24.693 18.693 -0.275 93.706 0.784 -0.056  -0.456   0.344
        Prokrastynacja    -0.8  -2.543  0.943 -0.911 93.797 0.365 -0.186  -0.587   0.215
 Zaangażowanie w naukę    -0.1  -1.498  1.298 -0.142 93.921 0.887 -0.029  -0.429   0.371

Liczba wyników p < .05: 1 z 12
Próg po poprawce Bonferroniego: 0.0042
Szansa co najmniej jednego p < .05 przy 12 niezależnych testach bez efektu: 0.46

Stres, zmiana w grupie programu:        t      p
-2.750  0.009
Stres, zmiana w grupie porównawczej:     t      p
-1.330  0.189

Ubytek (%): 45.5 20 | razem ukończyło: 96 z 148 (64.9%)
Test Fishera, ubytek a grupa, wartość p: 0.002
Medytowali wcześniej (%): 41.7 16.7
Test Fishera, medytacja a grupa, wartość p: 0.013
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Cytowanie po samym streszczeniu. Pierwsze pytanie o wielkość próby lub narzędzie zostaje wtedy bez odpowiedzi.
- Przepisywanie zdania z Dyskusji jako wyniku. Dyskusja zawiera interpretacje i ostrożność autorów, która znika przy skracaniu.
- Ocena tylko po p albo tylko po tytule czasopisma. Żadne z nich nie mówi, jak duży był efekt, u kogo i czym mierzony. Weź też pod uwagę efekt szuflady: opublikowanie wyniku nie mówi, ile podobnych badań nie wyszło.
- Odrzucanie wszystkiego, co ma ograniczenia. Każde badanie je ma. Celem jest dopasowanie zdania do dowodu, a nie zbiór idealnych prac.
- Zmiana wyniku w trakcie parafrazy. „Związek” staje się „wpływem”, „u studentek” znika, a „w jednym badaniu” zamienia się w „badania”.
- Cytowanie liczby z cudzego artykułu bez zajrzenia do tabeli. Ta sama liczba może być SD albo SE; sprawdź też, czy zgadza się z n (kontrola spójności liczb).
Zanim wstawisz cytowanie
- Czy znasz Metodę i tabelę z wynikiem, który przywołujesz?
- Czy twierdzenie w Twoim zdaniu pochodzi z wyników tego badania, a nie z jego wstępu, gdzie autorzy cytują kogoś innego?
- Czy czasownik pasuje do schematu i do wyniku głównego?
- Czy podajesz populację, gdy ma znaczenie, a przy kluczowych twierdzeniach wielkość efektu z przedziałem?
- Czy słabość ważna dla Twojego wniosku jest nazwana w tekście, skoro nie wynika z samego cytowania?
- Czy wiesz, czego w artykule brakuje? Podpowie to właściwa lista raportowania (STROBE, CONSORT).
Najczęstsze pytania
Czy można zacytować artykuł po przeczytaniu samego abstraktu?
Lepiej nie opierać się na samym abstrakcie, gdy cytowanie popiera ważne twierdzenie, bo streszczenie bywa niezgodne z tekstem. Jeśli pełny tekst jest niedostępny, spróbuj przez bibliotekę uczelni, a w macierzy literatury zaznacz „tylko abstrakt”. Twierdzenie sformułuj wtedy ogólnie.
Od czego zacząć czytanie artykułu naukowego?
Przeczytaj streszczenie raz, by ustalić, czy artykuł jest na temat. Potem przejdź do końca wstępu, do Metody i do tabel, a Dyskusję zostaw na koniec. Dzięki temu najpierw widzisz dowód, a dopiero potem interpretację autorów.
Jak sprawdzić, czy badanie jest wiarygodne, jeśli nie znam statystyki?
Nie musisz liczyć. Odpowiedz na pytania o dobór osób, ubytek, narzędzie, schemat i to, czy wniosek dotyczy wyniku głównego. Większość poważnych usterek widać w opisie procedury i w porównaniu streszczenia z tabelą.
Czy wolno cytować badanie z ograniczeniami lub słabe metodologicznie?
Tak, jeśli zdanie nie obiecuje więcej, niż badanie pokazało, i jeśli ważna słabość jest nazwana. Słabe badanie nie powinno jednak służyć jako dowód skuteczności czy przyczyny. Przy poważnych usterkach, np. rozbieżności między streszczeniem a tabelą, poszukaj lepszego źródła.
Czy promotor sprawdza, czy cytowane artykuły są naprawdę przeczytane?
Tego nie da się powiedzieć ogólnie, bo zależy to od promotora i uczelni. Bezpieczniej zakładać, że pytanie może paść na konsultacji lub na obronie. Karta oceny z próbą, efektem i ograniczeniem pozwala odpowiedzieć bez wracania do tekstu.
Powiązane hasła
Przeczytaj też
Jak pisać o cudzych badaniach
Od macierzy literatury do akapitu z tezą: sprzeczne wyniki, czasowniki raportujące, cytowanie z drugiej ręki, parafraza i szablon XLSX.
Czytaj →PoradnikJęzyk pracy naukowej
Ponad 40 zamienników dla „wpływa”, „udowodniono”, „tendencja do istotności” i „brak różnic” oraz forma osobowa, czasy, skróty i nazwy zmiennych.
Czytaj →PoradnikJak napisać przegląd literatury – z AI i bez
Rodzaje przeglądów, zapytania z operatorami Boole’a, selekcja, tabela ekstrakcji i macierz pojęć – oraz to, w czym AI pomaga, a w czym szkodzi.
Czytaj →Nie wiesz, czy badanie, na którym opierasz pracę, wytrzyma krytykę?
Pomożemy ocenić metodę i wyniki kluczowych artykułów oraz wyjaśnimy, co z nich wynika dla Twojego planu badania, tak żebyś umiał(a) samodzielnie to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Boutron, I., Dutton, S., Ravaud, P., & Altman, D. G. (2010). Reporting and interpretation of randomized controlled trials with statistically nonsignificant results for primary outcomes. JAMA, 303(20), 2058–2064. https://doi.org/10.1001/jama.2010.651
- Chan, A.-W., Hróbjartsson, A., Haahr, M. T., Gøtzsche, P. C., & Altman, D. G. (2004). Empirical evidence for selective reporting of outcomes in randomized trials. JAMA, 291(20), 2457–2465. https://doi.org/10.1001/jama.291.20.2457
- Dumville, J. C., Torgerson, D. J., & Hewitt, C. E. (2006). Reporting attrition in randomised controlled trials. BMJ, 332(7547), 969–971. https://doi.org/10.1136/bmj.332.7547.969 ● Otwarty dostęp: pełny tekst
- Flake, J. K., & Fried, E. I. (2020). Measurement schmeasurement: Questionable measurement practices and how to avoid them. Advances in Methods and Practices in Psychological Science, 3(4), 456–465. https://doi.org/10.1177/2515245920952393 ● Otwarty dostęp: pełny tekst
- Greenhalgh, T. (1997). How to read a paper: Getting your bearings (deciding what the paper is about). BMJ, 315(7102), 243–246. https://doi.org/10.1136/bmj.315.7102.243 ● Otwarty dostęp: pełny tekst
- Hernán, M. A. (2018). The C-word: Scientific euphemisms do not improve causal inference from observational data. American Journal of Public Health, 108(5), 616–619. https://doi.org/10.2105/ajph.2018.304337 ● Otwarty dostęp: pełny tekst
- Jergas, H., & Baethge, C. (2015). Quotation accuracy in medical journal articles—a systematic review and meta-analysis. PeerJ, 3, Article e1364. https://doi.org/10.7717/peerj.1364 ● Otwarty dostęp
- Li, G., Abbade, L. P. F., Nwosu, I., Jin, Y., Leenus, A., Maaz, M., Wang, M., Bhatt, M., Zielinski, L., Sanger, N., Bantoto, B., Luo, C., Shams, I., Shahid, H., Chang, Y., Sun, G., Mbuagbaw, L., Samaan, Z., Levine, M. A. H., . . . Thabane, L. (2017). A scoping review of comparisons between abstracts and full reports in primary biomedical research. BMC Medical Research Methodology, 17(1), Article 181. https://doi.org/10.1186/s12874-017-0459-5 ● Otwarty dostęp
- Lundh, A., Lexchin, J., Mintzes, B., Schroll, J. B., & Bero, L. (2017). Industry sponsorship and research outcome. Cochrane Database of Systematic Reviews, 2017(2), Article MR000033. https://doi.org/10.1002/14651858.mr000033.pub3 ● Otwarty dostęp
- Nieuwenhuis, S., Forstmann, B. U., & Wagenmakers, E.-J. (2011). Erroneous analyses of interactions in neuroscience: A problem of significance. Nature Neuroscience, 14(9), 1105–1107. https://doi.org/10.1038/nn.2886
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{boutron2010reporting, author={Boutron, Isabelle and Dutton, Susan and Ravaud, Philippe and Altman, Douglas G.}, title={{Reporting and interpretation of randomized controlled trials with statistically nonsignificant results for primary outcomes}}, journal={JAMA}, year={2010}, volume={303}, number={20}, pages={2058--2064}, doi={10.1001/jama.2010.651}}@article{chan2004empirical, author={Chan, An-Wen and Hróbjartsson, Asbjørn and Haahr, Mette T. and Gøtzsche, Peter C. and Altman, Douglas G.}, title={{Empirical evidence for selective reporting of outcomes in randomized trials}}, journal={JAMA}, year={2004}, volume={291}, number={20}, pages={2457--2465}, doi={10.1001/jama.291.20.2457}}@article{dumville2006reporting, author={Dumville, Jo C. and Torgerson, David J. and Hewitt, Catherine E.}, title={{Reporting attrition in randomised controlled trials}}, journal={BMJ}, year={2006}, volume={332}, number={7547}, pages={969--971}, doi={10.1136/bmj.332.7547.969}}@article{flake2020measurement, author={Flake, Jessica Kay and Fried, Eiko I.}, title={{Measurement schmeasurement: Questionable measurement practices and how to avoid them}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={456--465}, doi={10.1177/2515245920952393}}@article{greenhalgh1997how, author={Greenhalgh, Trisha}, title={{How to read a paper: Getting your bearings (deciding what the paper is about)}}, journal={BMJ}, year={1997}, volume={315}, number={7102}, pages={243--246}, doi={10.1136/bmj.315.7102.243}}@article{hernan2018cword, author={Hernán, Miguel A.}, title={{The C-word: Scientific euphemisms do not improve causal inference from observational data}}, journal={American Journal of Public Health}, year={2018}, volume={108}, number={5}, pages={616--619}, doi={10.2105/ajph.2018.304337}}@article{jergas2015quotation, author={Jergas, Hannah and Baethge, Christopher}, title={{Quotation accuracy in medical journal articles—a systematic review and meta-analysis}}, journal={PeerJ}, year={2015}, volume={3}, eid={e1364}, doi={10.7717/peerj.1364}}@article{li2017scoping, author={Li, Guowei and Abbade, Luciana P. F. and Nwosu, Ikunna and Jin, Yanling and Leenus, Alvin and Maaz, Muhammad and Wang, Mei and Bhatt, Meha and Zielinski, Laura and Sanger, Nitika and Bantoto, Bianca and Luo, Candice and Shams, Ieta and Shahid, Hamnah and Chang, Yaping and Sun, Guangwen and Mbuagbaw, Lawrence and Samaan, Zainab and Levine, Mitchell A. H. and Adachi, Jonathan D. and Thabane, Lehana}, title={{A scoping review of comparisons between abstracts and full reports in primary biomedical research}}, journal={BMC Medical Research Methodology}, year={2017}, volume={17}, number={1}, eid={181}, doi={10.1186/s12874-017-0459-5}}@article{lundh2017industry, author={Lundh, Andreas and Lexchin, Joel and Mintzes, Barbara and Schroll, Jeppe B. and Bero, Lisa}, title={{Industry sponsorship and research outcome}}, journal={Cochrane Database of Systematic Reviews}, year={2017}, volume={2017}, number={2}, eid={MR000033}, doi={10.1002/14651858.mr000033.pub3}}@article{nieuwenhuis2011erroneous, author={Nieuwenhuis, Sander and Forstmann, Birte U. and Wagenmakers, Eric-Jan}, title={{Erroneous analyses of interactions in neuroscience: A problem of significance}}, journal={Nature Neuroscience}, year={2011}, volume={14}, number={9}, pages={1105--1107}, doi={10.1038/nn.2886}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}