Po co przedziały ufności w rozdziale wyników
Promotor dopisuje na marginesie „brak przedziałów ufności”, a recenzent pyta, „jak precyzyjne są te oszacowania”. Sama wartość p nie mówi, jak duży jest efekt i jak dokładnie go oszacowano. Odpowiedzią jest przedział ufności (ang. confidence interval, CI) podany przy każdym ważnym wyniku.
Definicję przedziału, symulację „co znaczy 95%” i ogólną różnicę między CI a wartością p znajdziesz w haśle słownika i w poradniku wartość p – interpretacja. Ten wpis odpowiada na praktyczne pytania:
- jak zapisać przedział w tekście i w tabeli;
- który przedział policzyć dla średniej, różnicy średnich, odsetka, różnicy odsetków, korelacji i ilorazu szans;
- jakie zdania o przedziałach są poprawne, a jakie promotor słusznie skreśli;
- dlaczego nachodzenie dwóch przedziałów nie jest testem;
- co pokazują „wąsy” na wykresie i jak to podpisać.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa bada 160 osób z własnego roku: 68 pracuje zarobkowo w trakcie studiów, 92 nie pracuje. Mierzy stres skalą od 0 do 40 punktów, pyta o zaburzenia snu (tak/nie) i o średnią liczbę godzin snu. Wszystkie liczby we wpisie pochodzą z kodu R na końcu, a dane możesz pobrać jako plik CSV.
Jak zapisać przedział ufności (APA)
Podręcznik APA (American Psychological Association, 2020) w rozdziale o liczbach i statystykach podaje zapis z poziomem ufności, skrótem CI i granicami w nawiasie kwadratowym, oddzielonymi przecinkiem. Na metodolog.pl stosujemy tę samą konwencję, z kropką dziesiętną w wynikach statystycznych:
Kilka zasad, o które najczęściej pytają promotorzy:
- Przedział stoi zaraz po oszacowaniu, którego dotyczy: „różnica średnich wyniosła 3.26 punktu, 95% CI [1.51, 5.02]”. Nie wrzucaj przedziałów zbiorczo na koniec akapitu.
- Granice mają tyle samo miejsc po przecinku co oszacowanie. Średnia 18.46 i przedział [17.6, 19.4] wyglądają na dwa różne wyniki.
- Odsetki w przedziale też zapisuj w procentach: 26.2%, 95% CI [20.0%, 33.6%]. Dla różnicy odsetków podaj jednostkę – punkty procentowe (pp).
- Granice ujemne zapisuj ze znakiem minus: [−0.53, 0.13]. Zapis „[−0.53–0.13]” czyta się jak zakres od −0.53 do −0.13.
- Nie zamieniaj przedziału na „±”, jeśli nie jest symetryczny. Przedziały dla odsetka, korelacji i ilorazu szans zwykle nie są symetryczne wokół oszacowania.
- Poziom ufności podaj raz w metodzie („podano 95% przedziały ufności”) i przy każdym wyniku w tekście. W tabeli wystarczy nagłówek kolumny „95% CI”.
Możesz pisać „95% przedział ufności” albo „95% CI” – wybierz jedną formę i objaśnij skrót w metodzie.
Który przedział do jakiego wyniku
Dla każdego rodzaju wyniku istnieje kilka metod liczenia przedziału. Poniższa tabela pokazuje metody bezpieczne w pracy dyplomowej i wartość, która oznacza „brak efektu”. Ta druga kolumna ma znaczenie przy interpretacji: dla różnic jest to 0, dla ilorazu szans – 1.
| Wynik | Metoda przedziału | „Brak efektu” | Na co uważać |
|---|---|---|---|
| Średnia | Przedział t: M ± t × SE | – | Przedział dotyczy średniej, nie wyników osób |
| Różnica dwóch średnich | Przedział z testu Welcha | 0 | Dla pomiarów powtarzanych – przedział różnic w parach |
| d Cohena | Przedział z rozkładu niecentralnego t (np. pakiet effectsize) | 0 | Przy małych grupach przedział jest bardzo szeroki |
| Odsetek | Wilsona (przedział dla proporcji) | – | Przedział Walda zawodzi przy małych n i skrajnych odsetkach |
| Różnica odsetków | Newcombe’a (z przedziałów Wilsona) | 0 pp | Podaj jednostkę: punkty procentowe |
| Korelacja r | Transformacja Fishera z | 0 | Przedział niesymetryczny, ściśnięty przy ±1 |
| Iloraz szans (OR) | Na skali logarytmu, potem exp (Woolf lub regresja logistyczna) | 1 | Przedział niesymetryczny; nigdy „obejmuje 0” |
Dla odsetka Brown, Cai i DasGupta (2001) pokazali, że pokrycie podręcznikowego przedziału Walda jest chaotyczne i bywa wyraźnie niższe niż 95%, także przy umiarkowanie dużych próbach. Polecają przedział Wilsona. Dla różnicy dwóch odsetków Newcombe (1998) porównał jedenaście metod i wskazał metodę łączącą przedziały Wilsona obu grup jako dobrą i prostą. Gdy masz tylko liczby z tabeli, użyj kalkulatora przedziału ufności. Ogólny przepis opisuje hasło estymacja przedziałowa.
Przykład: kompletna tabela wyników z przedziałami
Tabela 1 zbiera wszystkie wyniki z przykładu: oszacowanie, przedział i – przy hipotezach – test i p. Możesz skopiować układ i podmienić liczby.
Tabela 1
Stres, sen i zaburzenia snu u studentów pielęgniarstwa pracujących i niepracujących zarobkowo (N = 160)
| Wynik | Pracujący (n = 68) | Niepracujący (n = 92) | Różnica lub OR [95% CI] | Test | p |
|---|---|---|---|---|---|
| Stres (0–40), M [95% CI] | 20.34 [18.96, 21.72] | 17.08 [15.96, 18.19] | 3.26 [1.51, 5.02] | t(139.7) = 3.67 | < .001 |
| Stres, d Cohena | – | – | 0.59 [0.27, 0.91] | – | – |
| Sen (godziny), M [95% CI] | 5.91 | 6.11 | −0.20 [−0.53, 0.13] | t(150.2) = −1.19 | .236 |
| Zaburzenia snu, % [95% CI] | 36.8 [26.3, 48.6] | 18.5 [11.9, 27.6] | 18.3 pp [4.4, 31.9] | χ²(1) = 6.75 | .009 |
| Zaburzenia snu, OR | – | – | 2.56 [1.25, 5.28] | – | – |
Uwaga. Różnice: pracujący minus niepracujący. CI – przedział ufności; dla średnich przedział t, dla różnicy średnich test Welcha, dla odsetków przedział Wilsona, dla różnicy odsetków przedział Newcombe’a (pp – punkty procentowe), dla ilorazu szans (OR) przedział na skali logarytmu. W całej próbie: stres M = 18.46, 95% CI [17.57, 19.36]; zaburzenia snu 26.2%, 95% CI [20.0%, 33.6%]; korelacja stresu z liczbą godzin snu r = −.48, 95% CI [−.59, −.35]. Dane symulowane.
Zwróć uwagę na trzy szczegóły. Po pierwsze, iloraz szans 2.56 ma przedział [1.25, 5.28]: dolna granica leży 1.32 poniżej oszacowania, a górna 2.71 powyżej. To nie błąd, tylko skutek liczenia na skali logarytmu, gdzie przedział jest symetryczny (0.94 ± 0.72). Bland i Altman (2000) przypominają, że iloraz szans opisuje związek dwóch zmiennych dychotomicznych właśnie razem z przedziałem ufności. Regresja logistyczna daje ten sam przedział Walda, a przedział z profilu wiarygodności jest bardzo podobny: [1.26, 5.35]. Po drugie, przedział Wilsona dla odsetka zaburzeń snu w całej próbie [20.0%, 33.6%] różni się od przedziału Walda [19.4%, 33.1%]. Przy małych grupach różnica byłaby wyraźna. Po trzecie, różnica w długości snu ma przedział obejmujący zero. To jedyny wiersz, w którym p > .05 – i to nie przypadek, o czym dalej.
Jak interpretować: zdania poprawne i błędne
Hoekstra, Morey, Rouder i Wagenmakers (2014) poprosili 120 badaczy i 442 studentów psychologii o ocenę sześciu fałszywych stwierdzeń o przedziale ufności. Badani akceptowali średnio ponad trzy z nich, a doświadczenie statystyczne badaczy nie wiązało się z lepszymi odpowiedziami. Poniżej zdania, które często pojawiają się w pracach, i ich poprawione wersje.
| Źle | Dlaczego | Dobrze |
|---|---|---|
| „Z prawdopodobieństwem 95% różnica stresu wynosi od 1.51 do 5.02” | 95% dotyczy metody liczenia w powtarzanych badaniach, a nie tego jednego przedziału | „Dane są zgodne z różnicą od 1.51 do 5.02 punktu na korzyść osób niepracujących” |
| „95% studentów ma stres między 17.57 a 19.36” | Przedział dotyczy średniej; rozrzut wyników osób opisuje SD (5.72) | „Średni poziom stresu oszacowano na 18.46 punktu, 95% CI [17.57, 19.36]” |
| „Przedział dla snu obejmuje 0, więc praca nie wpływa na sen” | Przedział obejmuje też różnice do 32 minut krócej snu u pracujących | „Wynik nie rozstrzyga – dane są zgodne zarówno z brakiem różnicy, jak i z różnicą rzędu pół godziny” |
| „Iloraz szans jest istotny, bo przedział nie obejmuje 0” | Dla OR „brak efektu” to 1, nie 0 | „Przedział dla OR [1.25, 5.28] nie obejmuje 1” |
| „Przedziały odsetków się nakładają, więc grupy się nie różnią” | Nakładanie się przedziałów grup nie jest testem (następne sekcje) | „Różnica wyniosła 18.3 pp, 95% CI [4.4, 31.9]” |
| „Wynik jest istotny, więc efekt jest duży” | Istotność nie mówi o wielkości; o wielkości mówią granice przedziału | „Efekt może być od małego (d = 0.27) do dużego (d = 0.91)” |
Najważniejsze pytanie: czy obie granice prowadzą do tego samego wniosku praktycznego? Dla stresu tak – nawet 1.51 punktu na skali 0–40 to różnica, którą można opisać. Dla snu nie – od 32 minut krócej do 8 minut dłużej. Wtedy uczciwy wniosek brzmi: „badanie nie było wystarczająco precyzyjne, żeby to rozstrzygnąć”. Jak to opisać w rozdziale, pokazuje wpis jak opisać wynik nieistotny. Jeśli chcesz wykazać, że różnicy praktycznie nie ma, potrzebujesz zaplanowanego testu równoważności, a nie samego braku istotności.
Przedział zastępuje też „moc po fakcie”: granice pokazują, jakich efektów badanie nie wykluczyło (zob. moc po fakcie – dlaczego jej nie liczyć). Jak ocenić, czy efekt jest duży, opisuje poradnik wielkość efektu – interpretacja i hasło d Cohena.
Szerokość przedziału a liczebność próby
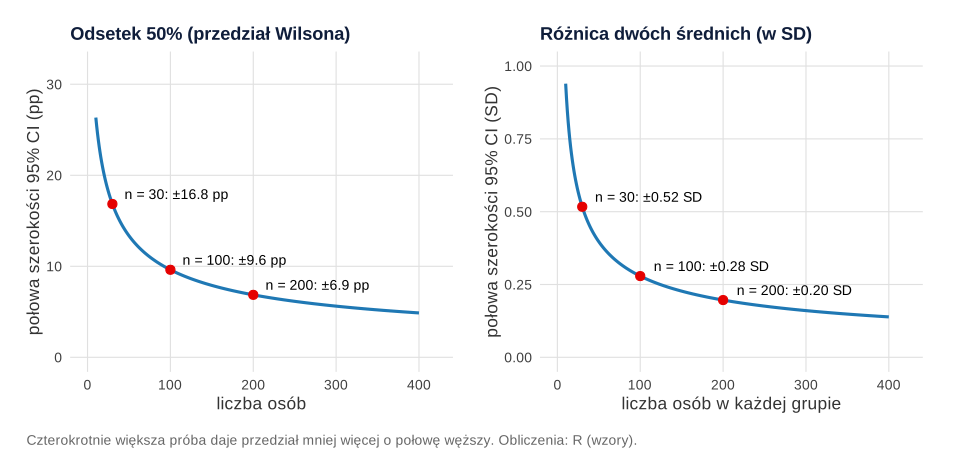
Szerokość przedziału zależy głównie od błędu standardowego, a ten maleje z pierwiastkiem z liczby osób. Praktyczna reguła: żeby przedział był dwa razy węższy, potrzebujesz mniej więcej cztery razy więcej osób. W kodzie przy przejściu ze 100 do 400 osób margines dla średniej zmalał z 1.19 do 0.59 punktu (stosunek 0.50).
| n | Średnia (SD = 6) | Odsetek 50% | Odsetek 20% | Różnica średnich (w SD; n w grupie) | r = .30 |
|---|---|---|---|---|---|
| 20 | ±2.81 | ±20.1 pp | ±16.8 pp | ±0.64 | ±.41 |
| 30 | ±2.24 | ±16.9 pp | ±13.9 pp | ±0.52 | ±.33 |
| 50 | ±1.71 | ±13.4 pp | ±10.9 pp | ±0.40 | ±.26 |
| 100 | ±1.19 | ±9.6 pp | ±7.8 pp | ±0.28 | ±.18 |
| 200 | ±0.84 | ±6.9 pp | ±5.5 pp | ±0.20 | ±.13 |
| 400 | ±0.59 | ±4.9 pp | ±3.9 pp | ±0.14 | ±.09 |
Dla odsetka i korelacji przedział nie jest symetryczny, więc w tabeli podano połowę jego szerokości. Wniosek dla typowej pracy licencjackiej z 30 osobami w grupie: różnica dwóch średnich ma margines około ±0.52 SD, czyli przedział obejmuje jednocześnie efekty bliskie zeru i średnie. To informacja do ograniczeń badania. Żeby zejść do ±0.20 SD, potrzeba około 194 osób w każdej grupie. Planowanie liczebności pod docelową szerokość przedziału opisuje wpis liczebność próby z precyzji (AIPE).
Przedział a istotność: kiedy CI dla różnicy obejmuje 0
Przedział dla różnicy i test istotności to dwie strony tej samej procedury. Jeśli 95% CI dla różnicy średnich z testu Welcha nie obejmuje 0, to ten sam test Welcha daje p < .05 – i odwrotnie. W tabeli 1 widać to w każdym wierszu: stres [1.51, 5.02] i p < .001, sen [−0.53, 0.13] i p = .236. Dla ilorazu szans tą samą rolę pełni wartość 1.
Zgodność jest pełna tylko wtedy, gdy przedział i test pochodzą z tej samej metody. Przedział Newcombe’a i test χ² bez poprawki liczą niepewność trochę inaczej, więc przy wyniku na granicy (p blisko .05) mogą dać różne rozstrzygnięcia. Wtedy nie wybieraj tego, który „wyszedł”, tylko opisz wynik jako graniczny. W przykładzie oba wskazują to samo.
Ta zgodność dotyczy przedziału dla różnicy. Z przedziałów policzonych osobno dla każdej grupy nie da się tak wprost odczytać istotności – i to jest najczęstszy błąd na wykresach w pracach dyplomowych.
Dlaczego nakładanie się dwóch przedziałów nie jest testem
W tabeli 1 przedziały odsetka zaburzeń snu u pracujących [26.3%, 48.6%] i niepracujących [11.9%, 27.6%] nachodzą na siebie. Mimo to różnica jest istotna (p = .009), a jej przedział [4.4, 31.9] pp nie obejmuje zera.
Schenker i Gentleman (2001) pokazali, że reguła „przedziały się nie nakładają, więc różnica jest istotna” działa tylko w jedną stronę. Brak nakładania się rzeczywiście oznacza istotną różnicę. Nakładanie się nie oznacza jej braku – metoda „na oko” jest zbyt zachowawcza i przeocza prawdziwe różnice. Cumming i Finch (2005) zaproponowali reguły odczytywania takich rycin dla grup niezależnych. Ich zastosowanie z przykładem liczbowym omawia hasło przedział ufności.
W symulacji wylosowano 10 000 badań z dwiema niezależnymi grupami po 40 osób i prawdziwą różnicą od 0 do 0.8 SD. W 4562 badaniach test Welcha dał p < .05. W 46.5% z nich przedziały obu grup nachodziły na siebie. Wśród wszystkich badań z nachodzącymi przedziałami istotną różnicę miało 28.0%. Gdy przedziały się nie nakładały, wynik był istotny zawsze (największe p = .0064). Przy przedziałach, które tylko się stykają, mediana p wynosiła .006, a przy zachodzeniu na mniej więcej połowę marginesu błędu – .036.
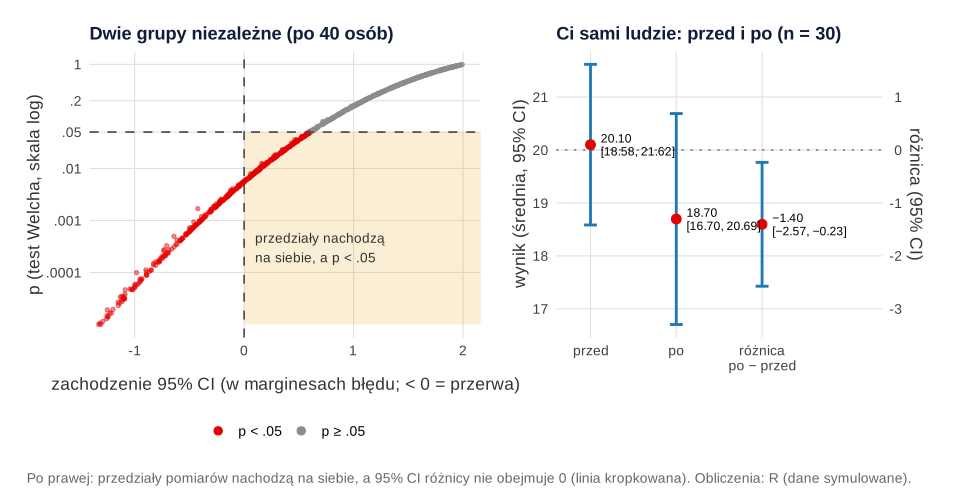
W pomiarach powtarzanych problem jest jeszcze większy. Prawy panel rysunku 2 pokazuje 30 osób zbadanych przed i po szkoleniu. Przedziały obu pomiarów prawie całe się pokrywają, a różnica wynosi −1.40 punktu, 95% CI [−2.57, −0.23], t(29) = −2.46, p = .020. Osobne przedziały zawierają zmienność między osobami, która przy porównaniu tych samych ludzi się znosi (r = .81). Gdyby błędnie policzyć test jak dla grup niezależnych, przedział różnicy wyniósłby [−3.86, 1.05], a p = .256. Belia, Fidler, Williams i Cumming (2005) pokazali, że wielu autorów artykułów nie odróżnia przedziałów ufności od słupków SE i nie bierze pod uwagę, czy średnie pochodzą z grup niezależnych, czy z pomiarów powtarzanych. Przy pomiarach powtarzanych pokazuj przedział różnicy albo przedziały skorygowane dla schematu wewnątrzosobowego (opis w poradniku ANOVA z powtarzanymi pomiarami).
Wniosek do pracy: porównując grupy, zawsze podawaj przedział dla różnicy (albo dla ilorazu szans), a nie tylko przedziały w grupach. Jak porównać odsetki w dwóch grupach od strony testu, opisuje wpis jak porównać odsetki w dwóch grupach.
Przedziały w tabelach i na wykresach: SD, SE czy CI
Ten sam punkt na wykresie można otoczyć trzema rodzajami „wąsów”: ±1 SD, ±1 SE albo 95% CI. Cumming, Fidler i Vaux (2007) podkreślają, że każdy z nich niesie inną informację, więc podpis ryciny musi mówić, co pokazują słupki. Porównanie wszystkich trzech na jednych danych znajdziesz w haśle błąd standardowy. W pracy zastosuj trzy proste zasady:
- Chcesz pokazać rozrzut wyników osób – użyj ±1 SD albo wykresu z punktami danych. Takie słupki nie służą do porównywania grup.
- Chcesz pokazać precyzję oszacowania i porównać grupy – użyj 95% CI, a najlepiej dodaj panel z różnicą i jej przedziałem.
- Unikaj ±1 SE. Słupki SE są około dwa razy węższe od 95% CI i sugerują większą precyzję. W symulacji z poprzedniej sekcji wśród badań, w których słupki ±1 SE się nie nakładały, 25.4% miało p ≥ .05.
W podpisie rysunku napisz wprost, co oznaczają słupki i ile osób jest w każdej grupie. Przy wykresie słupkowym dla odsetków (wykres słupkowy) zaznacz też metodę przedziału. W tabeli wybierz jeden z dwóch układów: kolumna „95% CI” z nawiasem kwadratowym (jak w tabeli 1) albo dwie kolumny LL i UL (dolna i górna granica) z objaśnieniem w nocie.
Gotowe zdania do metody i wyników
Zdania na liczbach z przykładu. Podmień wartości i usuń to, czego nie liczysz. Więcej wzorów dla innych testów zebraliśmy we wpisie jak opisać wyniki w stylu APA.
Metoda – analiza statystyczna:
Wyniki – różnica średnich i wynik nierozstrzygnięty:
Wyniki – odsetki, iloraz szans i korelacja:
Przedziały warto wykorzystać też w dyskusji: porównanie własnego przedziału z wynikami innych badań opisuje wpis porównanie wyników z literaturą, a strukturę samej dyskusji – jak napisać dyskusję wyników.
Najczęstsze błędy
- Przedział bez poziomu ufności. „CI [1.51, 5.02]” – czytelnik nie wie, czy to 90%, 95% czy 99%.
- „±” przy przedziale niesymetrycznym. OR = 2.56 ± 2.0 to inny przedział niż [1.25, 5.28].
- „Przedział OR obejmuje 0”. Dla ilorazu szans i ryzyka względnego granicą „braku efektu” jest 1.
- Wnioskowanie z nakładania się przedziałów grup. Podaj przedział dla różnicy.
- Słupki bez podpisu albo słupki SE opisane jak przedziały. Podpis ryciny musi mówić, co pokazują wąsy.
- Interpretacja tylko jednej granicy („przedział nie obejmuje 0, więc efekt jest ważny”). Sprawdź, czy dolna granica też jest praktycznie istotna.
- Różne przedziały dla tego samego wyniku w tabeli, tekście i streszczeniu. Liczby muszą się zgadzać – listę kontrolną znajdziesz we wpisie kontrola spójności liczb przed oddaniem.
Jeśli promotor zwrócił rozdział z uwagą o brakujących przedziałach, zobacz też poprawki promotora w rozdziale wyników. Gdy chcesz, żeby ktoś policzył z Tobą przedziały i sprawdził ich interpretację, zobacz pomoc w analizie dla studentów.
Przedziały ufności w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy dane przykładowe i zapisuje je w pliku CSV w folderze nadrzędnym (../), drugi liczy szerokość przedziałów, trzeci – symulację nakładania się przedziałów. Rysunki powstały w osobnym skrypcie na tych samych wynikach. Dane z przykładu możesz pobrać: przedzialy-ufnosci-studenci-pielegniarstwa.csv (160 osób: praca zarobkowa, stres, godziny snu, zaburzenia snu 0/1).
Kompletna tabela wyników: średnie, różnice, odsetki, OR i korelacja
R
# B443 – kompletna tabela wyników z 95% przedziałami ufności (dane symulowane)
# Badanie: 160 studentów pielęgniarstwa; praca zarobkowa (tak/nie), stres (PSS-10, 0–40),
# zaburzenia snu (tak/nie), średnia liczba godzin snu.
set.seed(4431)
n <- 160
praca <- rbinom(n, 1, .45)                                   # 1 = pracuje zarobkowo
stres <- round(pmin(40, pmax(0, rnorm(n, 18 + 2.4 * praca, 6.2))))
sen_h <- round(pmin(10, pmax(4, rnorm(n, 7.6 - .09 * stres, .9))), 1)
zab_snu <- rbinom(n, 1, plogis(-1.2 + .45 * praca + .06 * (stres - 18)))
d <- data.frame(id = 1:n, praca = factor(praca, 0:1, c("nie", "tak")), stres, sen_h, zab_snu)
write.csv(d, "../przedzialy-ufnosci-studenci-pielegniarstwa.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat(sprintf("N = %d; pracuje: %d, nie pracuje: %d\n", n, sum(d$praca == "tak"), sum(d$praca == "nie")))

f2 <- function(x) formatC(x, format = "f", digits = 2)
p_txt <- function(p) if (p < .001) "< .001" else paste("=", sub("^0", "", formatC(p, format = "f", digits = 3)))
ci_txt <- function(lo, hi, d = 2) sprintf("[%s, %s]", formatC(lo, format = "f", digits = d), formatC(hi, format = "f", digits = d))

# 1. Średnia w całej próbie (przedział t)
t1 <- t.test(d$stres)
cat(sprintf("\n1. Stres w próbie: M = %s, SD = %s, 95%% CI %s\n", f2(mean(d$stres)), f2(sd(d$stres)),
            ci_txt(t1$conf.int[1], t1$conf.int[2])))

# 2. Średnie w grupach i różnica średnich (Welch)
for (g in c("tak", "nie")) {
  tg <- t.test(d$stres[d$praca == g])
  cat(sprintf("   praca = %s: n = %d, M = %s, SD = %s, 95%% CI %s\n", g, sum(d$praca == g),
              f2(tg$estimate), f2(sd(d$stres[d$praca == g])), ci_txt(tg$conf.int[1], tg$conf.int[2])))
}
tw <- t.test(stres ~ relevel(praca, "tak"), data = d)       # różnica: pracujący − niepracujący
cat(sprintf("2. Różnica średnich (tak − nie) = %s, 95%% CI %s, t(%.1f) = %s, p %s\n",
            f2(diff(rev(tw$estimate))), ci_txt(tw$conf.int[1], tw$conf.int[2]), tw$parameter,
            f2(tw$statistic), p_txt(tw$p.value)))
dc <- effectsize::cohens_d(stres ~ relevel(praca, "tak"), data = d, verbose = FALSE)
cat(sprintf("   d Cohena (SD połączone) = %s, 95%% CI %s\n", f2(dc$Cohens_d), ci_txt(dc$CI_low, dc$CI_high)))

# 3. Proporcja: zaburzenia snu – przedział Wilsona (prop.test bez poprawki) i Walda dla porównania
x <- sum(d$zab_snu); p <- x / n
w <- prop.test(x, n, correct = FALSE)$conf.int
wald <- p + c(-1, 1) * qnorm(.975) * sqrt(p * (1 - p) / n)
cat(sprintf("\n3. Zaburzenia snu: %d z %d = %.1f%%, Wilson 95%% CI [%.1f%%, %.1f%%], Wald [%.1f%%, %.1f%%]\n",
            x, n, 100 * p, 100 * w[1], 100 * w[2], 100 * wald[1], 100 * wald[2]))

# 4. Różnica proporcji: przedział Newcombe'a (metoda 10 – z przedziałów Wilsona obu grup)
wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int
x1 <- sum(d$zab_snu[d$praca == "tak"]); n1 <- sum(d$praca == "tak")
x0 <- sum(d$zab_snu[d$praca == "nie"]); n0 <- sum(d$praca == "nie")
p1 <- x1 / n1; p0 <- x0 / n0; l1 <- wilson(x1, n1); l0 <- wilson(x0, n0)
dp <- p1 - p0
nc <- c(dp - sqrt((p1 - l1[1])^2 + (l0[2] - p0)^2), dp + sqrt((l1[2] - p1)^2 + (p0 - l0[1])^2))
cat(sprintf("   pracujący: %d z %d = %.1f%%, Wilson [%.1f%%, %.1f%%]\n", x1, n1, 100 * p1, 100 * l1[1], 100 * l1[2]))
cat(sprintf("   niepracujący: %d z %d = %.1f%%, Wilson [%.1f%%, %.1f%%]\n", x0, n0, 100 * p0, 100 * l0[1], 100 * l0[2]))
cat(sprintf("4. Różnica proporcji = %.1f pp, Newcombe 95%% CI [%.1f, %.1f] pp\n", 100 * dp, 100 * nc[1], 100 * nc[2]))
ch <- chisq.test(table(d$praca, d$zab_snu), correct = FALSE)
cat(sprintf("   chi^2(1, N = %d) = %s, p %s\n", n, f2(ch$statistic), p_txt(ch$p.value)))

# 5. Iloraz szans: przedział na skali logarytmu (metoda Woolfa) i z regresji logistycznej
a <- x1; b <- n1 - x1; c0 <- x0; dd <- n0 - x0
or <- (a * dd) / (b * c0); se_log <- sqrt(1 / a + 1 / b + 1 / c0 + 1 / dd)
or_ci <- exp(log(or) + c(-1, 1) * qnorm(.975) * se_log)
cat(sprintf("5. OR (pracujący vs niepracujący) = %s, 95%% CI %s (log OR = %s ± %s)\n",
            f2(or), ci_txt(or_ci[1], or_ci[2]), f2(log(or)), f2(qnorm(.975) * se_log)))
m <- glm(zab_snu ~ relevel(praca, "nie"), family = binomial, data = d)
cw <- exp(confint.default(m)[2, ]); cp <- exp(suppressMessages(confint(m))[2, ])
cat(sprintf("   regresja logistyczna: OR = %s, 95%% CI Walda %s, profilowy %s\n",
            f2(exp(coef(m)[2])), ci_txt(cw[1], cw[2]), ci_txt(cp[1], cp[2])))
cat(sprintf("   odległość granic od OR: w dół %s, w górę %s (przedział niesymetryczny)\n",
            f2(or - or_ci[1]), f2(or_ci[2] - or)))

# 6. Korelacja: stres a godziny snu – przedział z transformacji Fishera
ct <- cor.test(d$stres, d$sen_h)
cat(sprintf("\n6. r(stres, sen) = %s, 95%% CI %s, p %s\n", f2(ct$estimate), ci_txt(ct$conf.int[1], ct$conf.int[2]), p_txt(ct$p.value)))
z <- atanh(ct$estimate); se_z <- 1 / sqrt(n - 3)
cat(sprintf("   ręcznie: tanh(%.3f ± 1.96 × %.4f) = %s\n", z, se_z, ci_txt(tanh(z - 1.96 * se_z), tanh(z + 1.96 * se_z))))

# 7. Różnica, której przedział obejmuje 0: godziny snu (tak − nie)
ts <- t.test(sen_h ~ relevel(praca, "tak"), data = d)
ds <- effectsize::cohens_d(sen_h ~ relevel(praca, "tak"), data = d, verbose = FALSE)
cat(sprintf("\n7. Sen: M(tak) = %s, M(nie) = %s, różnica = %s h, 95%% CI %s, t(%.1f) = %s, p %s; d = %s, 95%% CI %s\n",
            f2(ts$estimate[1]), f2(ts$estimate[2]), f2(diff(rev(ts$estimate))), ci_txt(ts$conf.int[1], ts$conf.int[2]),
            ts$parameter, f2(ts$statistic), p_txt(ts$p.value), f2(ds$Cohens_d), ci_txt(ds$CI_low, ds$CI_high)))
cat(sprintf("   w minutach: %.0f min, 95%% CI [%.0f, %.0f] min\n", 60 * diff(rev(ts$estimate)), 60 * ts$conf.int[1], 60 * ts$conf.int[2]))
Wynik w R
N = 160; pracuje: 68, nie pracuje: 92

1. Stres w próbie: M = 18.46, SD = 5.72, 95% CI [17.57, 19.36]
   praca = tak: n = 68, M = 20.34, SD = 5.69, 95% CI [18.96, 21.72]
   praca = nie: n = 92, M = 17.08, SD = 5.37, 95% CI [15.96, 18.19]
2. Różnica średnich (tak − nie) = 3.26, 95% CI [1.51, 5.02], t(139.7) = 3.67, p < .001
   d Cohena (SD połączone) = 0.59, 95% CI [0.27, 0.91]

3. Zaburzenia snu: 42 z 160 = 26.2%, Wilson 95% CI [20.0%, 33.6%], Wald [19.4%, 33.1%]
   pracujący: 25 z 68 = 36.8%, Wilson [26.3%, 48.6%]
   niepracujący: 17 z 92 = 18.5%, Wilson [11.9%, 27.6%]
4. Różnica proporcji = 18.3 pp, Newcombe 95% CI [4.4, 31.9] pp
   chi^2(1, N = 160) = 6.75, p = .009
5. OR (pracujący vs niepracujący) = 2.56, 95% CI [1.25, 5.28] (log OR = 0.94 ± 0.72)
   regresja logistyczna: OR = 2.56, 95% CI Walda [1.25, 5.28], profilowy [1.26, 5.35]
   odległość granic od OR: w dół 1.32, w górę 2.71 (przedział niesymetryczny)

6. r(stres, sen) = -0.48, 95% CI [-0.59, -0.35], p < .001
   ręcznie: tanh(-0.520 ± 1.96 × 0.0798) = [-0.59, -0.35]

7. Sen: M(tak) = 5.91, M(nie) = 6.11, różnica = -0.20 h, 95% CI [-0.53, 0.13], t(150.2) = -1.19, p = .236; d = -0.19, 95% CI [-0.50, 0.13]
   w minutach: -12 min, 95% CI [-32, 8] min
Szerokość przedziału a liczebność
R
# B443 – szerokość 95% przedziału ufności a liczebność (wzory, bez losowania)
# Połowa szerokości (margines) dla: średniej (SD = 6), odsetka 50% i 20% (Wilson),
# różnicy dwóch średnich w jednostkach d (n osób w każdej grupie), korelacji r = .30 (Fisher z).
ns <- c(20, 30, 50, 100, 200, 400)
pol <- function(lo, hi) (hi - lo) / 2
wyn <- t(sapply(ns, function(n) {
  sr  <- qt(.975, n - 1) * 6 / sqrt(n)
  w50 <- 100 * diff(prop.test(round(.5 * n), n, correct = FALSE)$conf.int) / 2
  w20 <- 100 * diff(prop.test(round(.2 * n), n, correct = FALSE)$conf.int) / 2
  dd  <- qt(.975, 2 * n - 2) * sqrt(2 / n)          # margines dla różnicy średnich wyrażonej w SD (d ≈ 0)
  z <- atanh(.30); rr <- pol(tanh(z - qnorm(.975) / sqrt(n - 3)), tanh(z + qnorm(.975) / sqrt(n - 3)))
  c(n = n, srednia_SD6 = sr, odsetek50_pp = w50, odsetek20_pp = w20, roznica_d = dd, r30 = rr)
}))
wyn <- as.data.frame(wyn)
wyn[-1] <- round(wyn[-1], 2)
print(wyn, row.names = FALSE)
cat(sprintf("\nCzterokrotnie więcej osób (100 -> 400): margines średniej %.2f -> %.2f (stosunek %.2f)\n",
            wyn$srednia_SD6[wyn$n == 100], wyn$srednia_SD6[wyn$n == 400],
            wyn$srednia_SD6[wyn$n == 400] / wyn$srednia_SD6[wyn$n == 100]))
# Ile osób w każdej grupie, żeby margines różnicy średnich wynosił ±0.20 SD?
n_d <- uniroot(function(n) qt(.975, 2 * n - 2) * sqrt(2 / n) - .20, c(10, 5000))$root
cat(sprintf("Margines ±0.20 SD dla różnicy dwóch średnich: ok. %d osób w każdej grupie\n", ceiling(n_d)))
# Dane do rysunku: margines w funkcji n (siatka gęsta)
siatka <- data.frame(n = 10:400)
siatka$odsetek50 <- sapply(siatka$n, function(n) 100 * diff(prop.test(n / 2, n, correct = FALSE)$conf.int) / 2)
siatka$roznica_d <- qt(.975, 2 * siatka$n - 2) * sqrt(2 / siatka$n)
write.csv(siatka, "b443-szerokosc-n.csv", row.names = FALSE)
Wynik w R
   n srednia_SD6 odsetek50_pp odsetek20_pp roznica_d  r30
  20        2.81        20.07        16.77      0.64 0.41
  30        2.24        16.85        13.90      0.52 0.33
  50        1.71        13.36        10.90      0.40 0.26
 100        1.19         9.62         7.77      0.28 0.18
 200        0.84         6.86         5.52      0.20 0.13
 400        0.59         4.88         3.91      0.14 0.09

Czterokrotnie więcej osób (100 -> 400): margines średniej 1.19 -> 0.59 (stosunek 0.50)
Margines ±0.20 SD dla różnicy dwóch średnich: ok. 194 osób w każdej grupie
Nakładanie się przedziałów a istotność – symulacja
R
# B443 – dlaczego nakładanie się dwóch przedziałów ufności nie jest testem (symulacja)
# Dwie niezależne grupy po 40 osób, SD = 1, prawdziwa różnica losowana z zakresu 0–0.8 SD; 10 000 badań.
set.seed(4433)
R <- 10000; n <- 40
sym <- t(replicate(R, {
  delta <- runif(1, 0, .8)
  a <- rnorm(n, delta); b <- rnorm(n, 0)
  ca <- t.test(a)$conf.int; cb <- t.test(b)$conf.int
  se_a <- sd(a) / sqrt(n); se_b <- sd(b) / sqrt(n)
  lo_hi <- if (mean(a) >= mean(b)) c(ca[1], cb[2]) else c(cb[1], ca[2])   # dolna granica wyższej, górna niższej
  c(p = t.test(a, b)$p.value,
    nachodza_ci = lo_hi[1] < lo_hi[2],
    nachodza_se = abs(mean(a) - mean(b)) < se_a + se_b,
    zachodzenie = (lo_hi[2] - lo_hi[1]) / mean(c(diff(ca), diff(cb)) / 2))   # w jednostkach marginesu błędu
}))
sym <- as.data.frame(sym)
istotne <- sym$p < .05
cat(sprintf("Badania z p < .05: %d z %d\n", sum(istotne), R))
cat(sprintf("Wśród nich 95%% CI grup nachodzą na siebie: %.1f%%\n", 100 * mean(sym$nachodza_ci[istotne])))
cat(sprintf("Wśród badań z nachodzącymi 95%% CI różnica była istotna (p < .05): %.1f%%\n",
            100 * mean(istotne[sym$nachodza_ci == 1])))
cat(sprintf("Gdy 95%% CI się nie nakładają, p < .05 zawsze? %s (największe p = %s)\n",
            all(istotne[sym$nachodza_ci == 0]), sub("^0", "", sprintf("%.4f", max(sym$p[sym$nachodza_ci == 0])))))
cat(sprintf("Słupki ±1 SE się nie nakładają, a p >= .05: %.1f%% takich badań\n",
            100 * mean(sym$p[sym$nachodza_se == 0] >= .05)))
cat(sprintf("Mediana p, gdy 95%% CI tylko się stykają (zachodzenie od -0.05 do 0.05 marginesu): %s\n",
            sub("^0", "", sprintf("%.3f", median(sym$p[abs(sym$zachodzenie) < .05])))))
cat(sprintf("Mediana p, gdy 95%% CI zachodzą na ok. połowę marginesu (0.45–0.55): %s\n",
            sub("^0", "", sprintf("%.3f", median(sym$p[sym$zachodzenie > .45 & sym$zachodzenie < .55])))))
write.csv(sym[sample(R, 2000), ], "b443-nakladanie-sym.csv", row.names = FALSE)

# Pomiar powtarzany: 30 osób przed i po (korelacja pomiarów ok. .85)
set.seed(4434)
m <- 30
przed <- rnorm(m, 20, 5)
po <- przed - 1.5 + rnorm(m, 0, 2.7)
c_przed <- t.test(przed)$conf.int; c_po <- t.test(po)$conf.int
tp <- t.test(po, przed, paired = TRUE)
cat(sprintf("\nPrzed: M = %.2f, 95%% CI [%.2f, %.2f]; po: M = %.2f, 95%% CI [%.2f, %.2f]; r = %s\n",
            mean(przed), c_przed[1], c_przed[2], mean(po), c_po[1], c_po[2], sub("^0", "", sprintf("%.2f", cor(przed, po)))))
cat(sprintf("Różnica (po − przed) = %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, p %s\n", tp$estimate,
            tp$conf.int[1], tp$conf.int[2], tp$parameter, tp$statistic,
            if (tp$p.value < .001) "< .001" else sprintf("= %s", sub("^0", "", sprintf("%.3f", tp$p.value)))))
tn <- t.test(po, przed)   # błędnie: jak dla grup niezależnych
cat(sprintf("Błędnie jak dla grup niezależnych: 95%% CI [%.2f, %.2f], p = %s\n", tn$conf.int[1], tn$conf.int[2],
            sub("^0", "", sprintf("%.3f", tn$p.value))))
write.csv(data.frame(id = 1:m, przed, po), "b443-przed-po.csv", row.names = FALSE)
Wynik w R
Badania z p < .05: 4562 z 10000
Wśród nich 95% CI grup nachodzą na siebie: 46.5%
Wśród badań z nachodzącymi 95% CI różnica była istotna (p < .05): 28.0%
Gdy 95% CI się nie nakładają, p < .05 zawsze? TRUE (największe p = .0064)
Słupki ±1 SE się nie nakładają, a p >= .05: 25.4% takich badań
Mediana p, gdy 95% CI tylko się stykają (zachodzenie od -0.05 do 0.05 marginesu): .006
Mediana p, gdy 95% CI zachodzą na ok. połowę marginesu (0.45–0.55): .036

Przed: M = 20.10, 95% CI [18.58, 21.62]; po: M = 18.70, 95% CI [16.70, 20.69]; r = .81
Różnica (po − przed) = -1.40, 95% CI [-2.57, -0.23], t(29) = -2.46, p = .020
Błędnie jak dla grup niezależnych: 95% CI [-3.86, 1.05], p = .256
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem effectsize; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem rozdziału sprawdź…
- Czy każdy główny wynik (średnia, różnica, odsetek, korelacja, OR, wielkość efektu) ma 95% CI?
- Czy metoda przedziału jest opisana w metodzie (Wilson, Newcombe, Fisher z, skala logarytmu)?
- Czy przy porównaniach grup podano przedział dla różnicy, a nie tylko przedziały w grupach?
- Czy przy OR sprawdzasz, czy przedział obejmuje 1, a przy różnicach – 0?
- Czy interpretujesz obie granice i opisujesz wynik nierozstrzygnięty jako nierozstrzygnięty?
- Czy każdy wykres ma w podpisie informację, czy słupki to SD, SE czy 95% CI?
- Czy przedziały w tabelach, tekście i streszczeniu są identyczne?
Najczęstsze pytania
Czy w pracy licencjackiej trzeba podawać przedziały ufności?
Wiele uczelni tego nie wymaga wprost, ale zalecenia APA i coraz więcej promotorów oczekują przedziałów przy głównych wynikach. Podanie 95% CI przy średnich, różnicach, odsetkach i wielkościach efektu to kilka dodatkowych liczb, które pokazują precyzję oszacowań i chronią przed zarzutem, że opierasz wnioski tylko na wartości p.
Jak zapisać przedział ufności dla odsetka w pracy?
Podaj odsetek, poziom ufności i granice w procentach w nawiasie kwadratowym, np. 26.2%, 95% CI [20.0%, 33.6%]. W metodzie napisz, że użyto przedziału Wilsona. Dla różnicy dwóch odsetków podaj wynik w punktach procentowych, np. 18.3 pp, 95% CI [4.4, 31.9].
Dlaczego przedział ufności dla ilorazu szans nie jest symetryczny?
Przedział liczy się na skali logarytmu ilorazu szans, gdzie jest symetryczny, a potem zamienia z powrotem funkcją wykładniczą. Dlatego OR = 2.56 ma przedział [1.25, 5.28]: dolna granica leży 1.32 poniżej, a górna 2.71 powyżej oszacowania. Nie zapisuj go jako „±”.
Czy jeśli przedziały ufności dwóch grup na siebie nachodzą, różnica jest nieistotna?
Nie. Nachodzące przedziały grup są zgodne zarówno z różnicą istotną, jak i nieistotną. W przykładzie przedziały odsetków [26.3%, 48.6%] i [11.9%, 27.6%] nachodzą na siebie, a różnica jest istotna (p = .009). O istotności decyduje przedział dla różnicy, a nie przedziały w grupach.
Co napisać, gdy przedział ufności jest bardzo szeroki?
Napisz wprost, że oszacowanie jest mało precyzyjne, i podaj, z jakimi wartościami dane są zgodne, np. „od 32 minut krótszego do 8 minut dłuższego snu”. W ograniczeniach połącz to z liczebnością próby: żeby przedział był dwa razy węższy, potrzeba mniej więcej cztery razy więcej osób.
Powiązane hasła
Przeczytaj też
Wykresy w Excelu do pracy dyplomowej
Słupki błędów z UFNOŚĆ.T, histogram, linia trendu i R², Likert 100% skumulowany i wykres przed–po – krok po kroku, z plikiem XLSX i przenoszeniem do Worda.
Czytaj →PoradnikKalkulator przedziału ufności
Średnia (t), proporcja (Wilson i Wald), korelacja (Fisher) i różnica średnich (Welch): kalkulator online, wzory, przykład w R i zapis APA.
Czytaj →PoradnikWartość p – interpretacja
Błędne odczytania p na jednym przykładzie, symulacja p pod H0 i H1, replikacje, p a przedział ufności i wielkość efektu – z kodem R.
Czytaj →PoradnikJak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →PoradnikMoc po fakcie – co podać zamiast
Dlaczego moc post hoc to inny zapis p, co zrobić z kolumną Observed Power w SPSS i co podać zamiast: przedział ufności, analizę wrażliwości i odpowiedź dla promotora – z R.
Czytaj →PoradnikKontrola spójności liczb przed oddaniem pracy
Osiem kontroli: N i sumy w tabelach, procenty, p a statystyka testu, df, przedziały ufności, GRIM i te same liczby w całej pracy – z kodem w R.
Czytaj →Promotor prosi o przedziały ufności przy wynikach?
Policzymy przedziały dla Twoich średnich, odsetków, różnic i ilorazów szans w R lub SPSS, ułożymy tabelę w APA i wyjaśnimy interpretację tak, żebyś umiał(a) samodzielnie ją obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Belia, S., Fidler, F., Williams, J., & Cumming, G. (2005). Researchers misunderstand confidence intervals and standard error bars. Psychological Methods, 10(4), 389–396. https://doi.org/10.1037/1082-989x.10.4.389
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141 ● Otwarty dostęp
- Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3 ● Otwarty dostęp: pełny tekst
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Schenker, N., & Gentleman, J. F. (2001). On judging the significance of differences by examining the overlap between confidence intervals. The American Statistician, 55(3), 182–186. https://doi.org/10.1198/000313001317097960
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{belia2005researchers, author={Belia, Sarah and Fidler, Fiona and Williams, Jennifer and Cumming, Geoff}, title={{Researchers misunderstand confidence intervals and standard error bars}}, journal={Psychological Methods}, year={2005}, volume={10}, number={4}, pages={389--396}, doi={10.1037/1082-989x.10.4.389}}@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{cumming2005inference, author={Cumming, Geoff and Finch, Sue}, title={{Inference by eye: Confidence intervals and how to read pictures of data}}, journal={American Psychologist}, year={2005}, volume={60}, number={2}, pages={170--180}, doi={10.1037/0003-066x.60.2.170}}@article{cumming2007error, author={Cumming, Geoff and Fidler, Fiona and Vaux, David L.}, title={{Error bars in experimental biology}}, journal={Journal of Cell Biology}, year={2007}, volume={177}, number={1}, pages={7--11}, doi={10.1083/jcb.200611141}}@article{hoekstra2014robust, author={Hoekstra, Rink and Morey, Richard D. and Rouder, Jeffrey N. and Wagenmakers, Eric-Jan}, title={{Robust misinterpretation of confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2014}, volume={21}, number={5}, pages={1157--1164}, doi={10.3758/s13423-013-0572-3}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{schenker2001judging, author={Schenker, Nathaniel and Gentleman, Jane F.}, title={{On judging the significance of differences by examining the overlap between confidence intervals}}, journal={The American Statistician}, year={2001}, volume={55}, number={3}, pages={182--186}, doi={10.1198/000313001317097960}}