Czym jest metaregresja
Gdy efekty w metaanalizie wyraźnie się różnią, pytasz, od czego zależą. Odpowiada na to metaregresja (ang. meta-regression), czyli regresja, w której jednostką analizy jest badanie, a nie osoba. Zmienną zależną jest wielkość efektu z każdego badania, np. g Hedgesa, a predyktorami są cechy badań, nazywane moderatorami: czas trwania interwencji, forma jej prowadzenia, rodzaj grupy kontrolnej, średni wiek uczestników.
Standardem jest model efektów mieszanych. Efekt w badaniu i to wartość przewidziana przez moderatory plus dwa składniki losowe: błąd próbkowania o znanej wariancji vi i odchylenie prawdziwego efektu tego badania od linii regresji, czyli heterogeniczność resztowa τ²:
Thompson i Higgins (2002) podkreślają, że wagi muszą uwzględniać obie wariancje. Metaregresja z efektem stałym, która pomija τ², przy heterogeniczności daje wyraźnie zawyżoną liczbę fałszywie istotnych wyników (Higgins i Thompson, 2004). Różnicę między obydwoma modelami opisuje hasło efekty stałe i losowe.
Jeden moderator kategoryczny pokazujemy w kroku 9b poradnika metaanaliza krok po kroku; tu idziemy dalej. Przy kilku efektach z jednego badania moderatory dodaje się do modelu trójpoziomowego (zob. metaanaliza wielopoziomowa). Moderację na poziomie osób w pojedynczym badaniu opisuje wpis analiza moderacji krok po kroku.
Przykład: 36 badań programów radzenia sobie ze stresem
Mamy 36 badań randomizowanych porównujących program radzenia sobie ze stresem w pracy z grupą kontrolną. Efektem jest g Hedgesa dla stresu po programie; wartość dodatnia oznacza mniej stresu w grupie programu. Z każdego badania wypisano dwa moderatory zaplanowane w protokole: czas trwania programu (4–16 tygodni) i formę (stacjonarna: 20 badań, online: 16). Dane są symulowane (set.seed(2191)); możesz je pobrać jako plik CSV (36 wierszy: badanie, n_grupa, tygodnie, forma, yi, vi).
Model efektów losowych bez moderatorów (REML, poprawka Knappa–Hartunga) dał średni efekt g = 0.43, 95% CI [0.33, 0.54]. Heterogeniczność była wyraźna: τ² = 0.059, I² = 62.6%, Q(35) = 93.79, p < .001. (zob. I² i τ²).
Moderator ciągły, Knapp–Hartung, QM i QE
W metafor moderator dodajesz argumentem mods (Viechtbauer, 2010). Czas trwania wycentrowaliśmy na 8 tygodniach, więc wyraz wolny to przewidywany efekt programu 8-tygodniowego:
Każdy dodatkowy tydzień wiązał się z efektem większym o b = 0.041, 95% CI [0.013, 0.070], a program 8-tygodniowy miał przewidywany efekt 0.39, 95% CI [0.29, 0.49]. Wydruk zawiera dwa testy, które łatwo pomylić:
- Test moderatorów (QM) pyta, czy moderatory razem wyjaśniają cokolwiek. Z poprawką Knappa–Hartunga ma postać testu F: F(1, 34) = 8.53, p = .006. Bez poprawki metafor podaje statystykę χ² o nazwie QM.
- Test heterogeniczności resztowej (QE) pyta, czy po uwzględnieniu moderatorów zostaje zmienność większa niż błąd próbkowania: QE(34) = 74.13, p < .001. Moderator wyjaśnia więc część, ale nie całość różnic.
Poprawka Knappa–Hartunga zastępuje test z testem t lub F z poprawionym błędem standardowym i lepiej utrzymuje nominalny poziom istotności (Knapp i Hartung, 2003). W symulacjach Viechtbauera i in. (2015) standardowy test Walda zwykle zawyżał błąd I rodzaju, a dobrą kontrolę dawały tylko ta poprawka i test permutacyjny. Autorzy zalecają ją w większości metaanaliz.
Ile heterogeniczności wyjaśnia moderator? Pseudo-R² porównuje τ² z modelu bez moderatorów i τ² resztowe:
To odsetek heterogeniczności między badaniami, a nie wariancji efektów. Bywa niestabilny, bo oba τ² szacuje się niezależnie. W symulacji López-Lópeza i in. (2014) precyzyjne oszacowania τ² wymagały co najmniej 20 badań, a R² modelu co najmniej 40. Przy 36 badaniach podaj R² jako przybliżenie, a wniosek opieraj na współczynniku z przedziałem ufności.
Moderator kategoryczny: metaregresja czy podgrupy?
Forma programu to moderator kategoryczny. W metaregresji staje się zmienną zero-jedynkową (dummy coding) z kategorią odniesienia „stacjonarna”. Programy online miały efekt mniejszy o 0.26, 95% CI [−0.45, −0.06], F(1, 34) = 6.79, p = .014, R² = 26.9%. Ten sam moderator możesz przeanalizować jako podgrupy, dopasowując osobny model w każdej z nich:
| Forma | k | g [95% CI] | τ² |
|---|---|---|---|
| Stacjonarna | 20 | 0.54 [0.41, 0.67] | 0.047 |
| Online | 16 | 0.28 [0.12, 0.44] | 0.036 |
| Różnica (metaregresja, wspólne τ² = 0.043) | 36 | −0.26 [−0.45, −0.06] | – |
Różnica polega na τ². Osobne modele szacują własne τ² w każdej podgrupie, a metaregresja jedno wspólne τ² resztowe na pełnym zbiorze badań. Przy małych podgrupach to stabilniejsze, ale wymaga założenia podobnej heterogeniczności w obu formach. Metaregresja jest jedyną drogą, gdy moderator jest ciągły albo gdy moderatorów jest kilka (Thompson i Higgins, 2002).
Niezależnie od podejścia nie porównuj istotności podgrup. O tym, czy efekty się różnią, rozstrzyga test różnicy, a nie to, że efekt jest istotny w jednej podgrupie i nieistotny w drugiej. Podręcznik Cochrane nazywa takie porównanie bardzo mylącym (Higgins i in., 2024). Ten sam błąd w pojedynczym badaniu opisuje hasło analiza podgrup.
Dwa moderatory naraz: gdy moderatory są ze sobą powiązane
Oba moderatory osobno „działają”, ale programy online były krótsze: trwały średnio 6.6 tygodnia (od 4 do 9), a stacjonarne 10.5 tygodnia (od 6 do 16). Model z oboma moderatorami:
- moderatory razem są istotne, F(2, 33) = 4.91, p = .014, R² = 31.6%;
- czas trwania: b = 0.029 na tydzień, 95% CI [−0.007, 0.066], p = .113;
- forma online: b = −0.13, 95% CI [−0.38, 0.11], p = .277;
- współczynnik VIF wynosi 1.61 dla obu moderatorów.
Żaden moderator nie jest istotny po kontroli drugiego, choć razem wyjaśniają podobną część heterogeniczności co każdy z osobna. Dane nie rozstrzygają, czy liczy się czas trwania, czy forma, bo obie cechy w dużej mierze się pokrywają. Uczciwy wniosek brzmi: „dłuższe i stacjonarne programy miały większe efekty; nie da się rozdzielić obu wyjaśnień”.
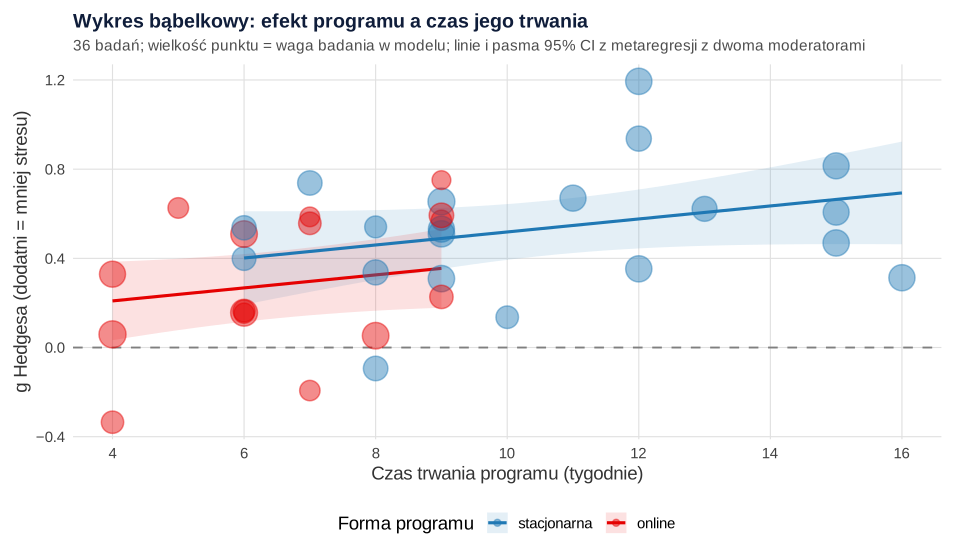
Wykres bąbelkowy (ang. bubble plot) uzupełnia wykres lasu: pokazuje, czy zależność nie wynika z jednego dużego badania i gdzie kończą się dane. Dla 6-tygodniowego programu model przewiduje g = 0.40, 95% CI [0.19, 0.61], w formie stacjonarnej i 0.27, 95% CI [0.12, 0.42], online. Przedział predykcji dla programu online, [−0.17, 0.70], pokazuje jednak, że w nowym badaniu efekt może być bliski zeru (zob. przedział predykcji).
Test permutacyjny przy niewielu badaniach
Higgins i Thompson (2004) zaproponowali, by istotność moderatora sprawdzać testem permutacyjnym. Wartości moderatorów tasuje się losowo między badaniami i sprawdza, jak często statystyka jest co najmniej tak duża jak obserwowana. Autorzy zalecają go, zanim ogłosisz istotny związek, zwłaszcza przy niewielu badaniach i dużej heterogeniczności.
W metafor wystarczy permutest(model, iter = 5000). W naszym modelu z dwoma moderatorami permutacyjne p dla testu łącznego wyniosło .015, dla czasu trwania .121, a dla formy .289. Wyniki są bliskie testom Knappa–Hartunga (.014, .113 i .277), co zgadza się z symulacjami, w których obie metody dobrze kontrolują błąd I rodzaju (Viechtbauer i in., 2015).
Liczba badań na moderator i fałszywe alarmy
Podręcznik Cochrane zaleca, by nie prowadzić metaregresji przy mniej niż 10 badaniach w metaanalizie i mieć co najmniej 10 badań na każdą badaną cechę. Zastrzega też, że to za mało, gdy cecha jest rozłożona nierówno między badaniami (Higgins i in., 2024). Każdy kolejny moderator zwiększa też szansę fałszywego alarmu, tak jak w problemie wielokrotnych porównań.
Skalę problemu pokazuje symulacja w duchu Higginsa i Thompsona (2004): po 1000 metaanaliz z τ² = 0.04 i pięcioma moderatorami bez związku z efektem, każdy testowany osobno trzema metodami.
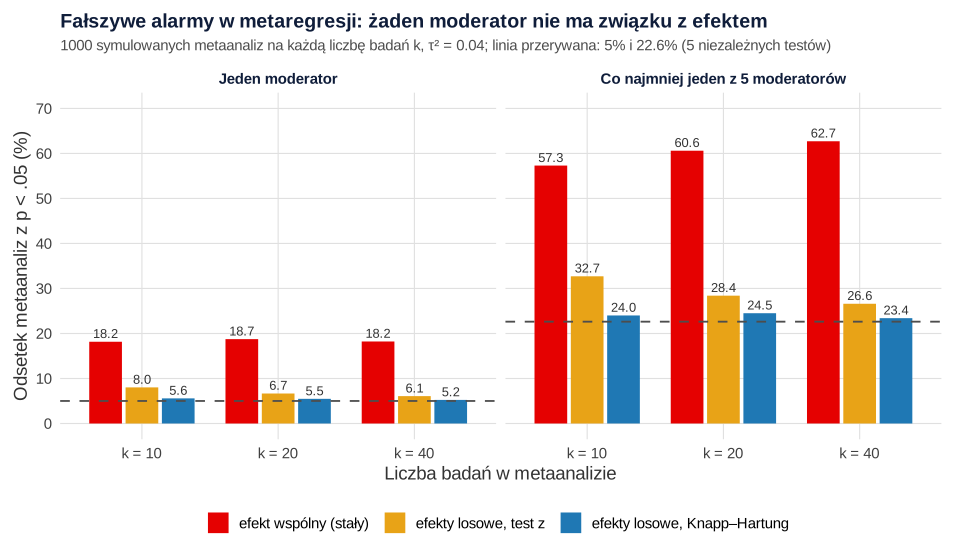
Model efektu wspólnego dawał fałszywe alarmy w 18.2–18.7% pojedynczych testów. Test z w modelu efektów losowych zawyżał ten odsetek głównie przy 10 badaniach (8.0%), a poprawka Knappa–Hartunga trzymała go blisko 5% (5.2–5.6%). Nawet ona nie chroni jednak przed wielością testów: przy pięciu moderatorach co najmniej jeden fałszywie istotny pojawiał się w 23.4–24.5% metaanaliz.
Lekarstwo jest proceduralne. Thompson i Higgins (2002) wskazują, że przed przeszukiwaniem danych chroni tylko wcześniejsze określenie moderatorów. Wpisz je do protokołu razem z oczekiwanym kierunkiem (zob. prerejestracja badań), ogranicz ich liczbę i oznacz analizy dodane później jako eksploracyjne. Testowanie kolejnych moderatorów aż do istotnego wyniku to p-hacking na poziomie metaanalizy. Gdy rozsądnych decyzji analitycznych jest wiele, pokaż je wszystkie, np. w analizie opisanej we wpisie multiverse i krzywa specyfikacji.
Błąd ekologiczny i obserwacyjny charakter wyniku
Związki z metaregresji są obserwacyjne, nawet gdy każde badanie było randomizowane. Losowo przydzielano osoby do programu i kontroli, ale nie badania do długości programu (Thompson i Higgins, 2002). Dłuższe programy mogą różnić się też populacją albo jakością, a takie cechy działają jak zmienne zakłócające.
Szczególnie ostrożnie traktuj moderatory będące średnimi cech uczestników (średni wiek, odsetek kobiet). Zależność efektu od średniego wieku w badaniach nie oznacza, że program działa lepiej u osób starszych. Przeniesienie wniosku z poziomu badań na osoby to błąd ekologiczny, a w metaanalizie mówi się o obciążeniu agregacji (zob. agregacja danych). Berlin i in. (2002) porównali analizę danych zagregowanych i indywidualnych z tych samych pięciu badań. Dane indywidualne wykazały, że terapia działa lepiej w małej podgrupie pacjentów, a metaregresja na poziomie badań tego nie wykryła. Do pytań o cechy osób potrzebujesz danych indywidualnych albo efektów z podgrup wewnątrz badań.
Jak opisać metaregresję (APA)
W metodach podaj: moderatory i to, czy były zaplanowane w protokole, ich kodowanie (centrowanie, kategoria odniesienia), estymator τ² (np. REML), metodę testowania (Knapp–Hartung, test permutacyjny z liczbą permutacji), minimalną liczbę badań na moderator i oprogramowanie. W wynikach podaj tabelę modeli ze współczynnikami i 95% CI, test moderatorów, τ² resztowe, QE i pseudo-R². Zasady tabel: tabele APA.
Tabela 1
Metaregresja efektów programów radzenia sobie ze stresem w pracy: czas trwania i forma programu (k = 36)
| Model i moderator | b [95% CI] | p | Test moderatorów | τ² | QE | R² (%) |
|---|---|---|---|---|---|---|
| Model 1. Czas trwania programu | ||||||
| Czas trwania (tygodnie, centrowany na 8) | 0.041 [0.013, 0.070] | .006 | F(1, 34) = 8.53, p = .006 | 0.042 | 74.13*** | 28.9 |
| Model 2. Forma programu | ||||||
| Online (vs stacjonarna) | −0.26 [−0.45, −0.06] | .014 | F(1, 34) = 6.79, p = .014 | 0.043 | 75.15*** | 26.9 |
| Model 3. Oba moderatory | ||||||
| Czas trwania (tygodnie, centrowany na 8) | 0.029 [−0.007, 0.066] | .113 | F(2, 33) = 4.91, p = .014 | 0.040 | 70.37*** | 31.6 |
| Online (vs stacjonarna) | −0.13 [−0.38, 0.11] | .277 | ||||
Uwaga. Model efektów mieszanych, estymator REML, testy i przedziały ufności z poprawką Knappa–Hartunga. Efekt: g Hedgesa, wartości dodatnie oznaczają mniej stresu w grupie programu. Model bez moderatorów: g = 0.43, 95% CI [0.33, 0.54], τ² = 0.059, I² = 62.6%. QE – test heterogeniczności resztowej (df = 34 w modelach 1–2 i 33 w modelu 3); R² – odsetek heterogeniczności wyjaśniony przez moderatory. Test permutacyjny (5000 permutacji) w modelu 3: p = .015 dla testu łącznego, .121 dla czasu trwania i .289 dla formy. Dane symulowane.
*** p < .001.
Model i opis możemy przejrzeć wspólnie w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy w pakiecie metafor. Pierwszy tworzy dane, zapisuje plik metaregresja-dane.csv (możesz go pobrać tutaj) i liczy wszystkie modele z tekstu. Drugi to symulacja fałszywych alarmów; trwa kilka minut.
1. Metaregresja z moderatorem ciągłym i kategorycznym
R
# Dane symulowane na poziomie badań: 36 badań programów radzenia sobie ze stresem w pracy.
# yi = g Hedgesa (dodatni = mniej stresu po programie niż w grupie kontrolnej), vi = wariancja g.
# Moderatory: czas trwania programu (tygodnie) i forma (stacjonarna / online).
suppressPackageStartupMessages(library(metafor))
set.seed(2191)
k <- 36
forma <- factor(sample(c("stacjonarna", "online"), k, replace = TRUE, prob = c(.6, .4)),
                levels = c("stacjonarna", "online"))
# programy online są zwykle krótsze, więc forma i czas trwania są ze sobą powiązane
tygodnie <- ifelse(forma == "online", sample(4:10, k, replace = TRUE), sample(6:16, k, replace = TRUE))
n_grupa <- round(runif(k, 20, 90))
theta <- 0.40 + 0.03 * (tygodnie - 8) - 0.05 * (forma == "online") + rnorm(k, 0, 0.12)
vi <- 2 / n_grupa + theta^2 / (4 * n_grupa)
yi <- rnorm(k, theta, sqrt(vi))
dane <- data.frame(badanie = sprintf("B%02d", 1:k), n_grupa, tygodnie, forma,
                   yi = round(yi, 3), vi = round(vi, 4))
write.csv(dane, "metaregresja-dane.csv", row.names = FALSE)
dane$tyg8 <- dane$tygodnie - 8        # centrowanie: wyraz wolny = efekt programu 8-tygodniowego

# 1. Model efektów losowych bez moderatorów (REML, Knapp–Hartung)
m0 <- rma(yi, vi, data = dane, test = "knha")
table(dane$forma)
round(c(g = coef(m0)[[1]], ci.lb = m0$ci.lb, ci.ub = m0$ci.ub, tau2 = m0$tau2, I2 = m0$I2,
        QE = m0$QE, p_QE = m0$QEp), 3)

# 2. Moderator ciągły: czas trwania programu
m1 <- rma(yi, vi, mods = ~ tyg8, data = dane, test = "knha")
m1

# 3. Moderator kategoryczny: forma programu – metaregresja i osobne modele w podgrupach
m2 <- rma(yi, vi, mods = ~ forma, data = dane, test = "knha")
round(c(b = coef(m2)[[2]], ci.lb = m2$ci.lb[2], ci.ub = m2$ci.ub[2], F = m2$QM, df2 = m2$QMdf[2],
        p = m2$QMp, tau2 = m2$tau2, R2 = m2$R2, QE = m2$QE, p_QE = m2$QEp), 3)
podgr <- lapply(split(dane, dane$forma), function(d) rma(yi, vi, data = d, test = "knha"))
round(sapply(podgr, function(m) c(k = m$k, g = coef(m)[[1]], ci.lb = m$ci.lb, ci.ub = m$ci.ub, tau2 = m$tau2)), 3)

# 4. Dwa moderatory naraz
m3 <- rma(yi, vi, mods = ~ tyg8 + forma, data = dane, test = "knha")
m3
predict(m3, newmods = rbind(c(-2, 0), c(-2, 1), c(4, 0)), digits = 2)  # 6 tyg. stacjonarnie, 6 tyg. online, 12 tyg. stacjonarnie
round(vif(m3)$vifs, 2)                                         # współliniowość moderatorów (VIF)

# 5. Test permutacyjny dla modelu z dwoma moderatorami
set.seed(2192)
pm3 <- permutest(m3, iter = 5000, progbar = FALSE)
round(c(p_QM_perm = pm3$QMp, p_tyg8_perm = pm3$pval[2], p_online_perm = pm3$pval[3]), 4)

# 6. Czas trwania a forma: moderatory powiązane ze sobą
aggregate(tygodnie ~ forma, data = dane, FUN = function(x) round(c(M = mean(x), min = min(x), max = max(x)), 1))
Wynik w R
stacjonarna      online
         20          16
     g  ci.lb  ci.ub   tau2     I2     QE   p_QE
 0.434  0.329  0.539  0.059 62.581 93.787  0.000

Mixed-Effects Model (k = 36; tau^2 estimator: REML)

tau^2 (estimated amount of residual heterogeneity):     0.0420 (SE = 0.0192)
tau (square root of estimated tau^2 value):             0.2050
I^2 (residual heterogeneity / unaccounted variability): 54.18%
H^2 (unaccounted variability / sampling variability):   2.18
R^2 (amount of heterogeneity accounted for):            28.85%

Test for Residual Heterogeneity:
QE(df = 34) = 74.1336, p-val < .0001

Test of Moderators (coefficient 2):
F(df1 = 1, df2 = 34) = 8.5345, p-val = 0.0062

Model Results:

         estimate      se    tval  df    pval   ci.lb   ci.ub
intrcpt    0.3944  0.0490  8.0447  34  <.0001  0.2947  0.4940  ***
tyg8       0.0414  0.0142  2.9214  34  0.0062  0.0126  0.0702   **

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

     b  ci.lb  ci.ub      F    df2      p   tau2     R2     QE   p_QE
-0.255 -0.454 -0.056  6.787 34.000  0.014  0.043 26.939 75.149  0.000
      stacjonarna online
k          20.000 16.000
g           0.537  0.281
ci.lb       0.405  0.123
ci.ub       0.668  0.438
tau2        0.047  0.036

Mixed-Effects Model (k = 36; tau^2 estimator: REML)

tau^2 (estimated amount of residual heterogeneity):     0.0404 (SE = 0.0190)
tau (square root of estimated tau^2 value):             0.2010
I^2 (residual heterogeneity / unaccounted variability): 53.18%
H^2 (unaccounted variability / sampling variability):   2.14
R^2 (amount of heterogeneity accounted for):            31.60%

Test for Residual Heterogeneity:
QE(df = 33) = 70.3691, p-val = 0.0002

Test of Moderators (coefficients 2:3):
F(df1 = 2, df2 = 33) = 4.9100, p-val = 0.0136

Model Results:

             estimate      se     tval  df    pval    ci.lb   ci.ub
intrcpt        0.4600  0.0769   5.9840  33  <.0001   0.3036  0.6163  ***
tyg8           0.0292  0.0179   1.6284  33  0.1129  -0.0073  0.0657
formaonline   -0.1342  0.1214  -1.1051  33  0.2771  -0.3811  0.1128

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


  pred   se ci.lb ci.ub pi.lb pi.ub
1 0.40 0.10  0.19  0.61 -0.06  0.86
2 0.27 0.07  0.12  0.42 -0.17  0.70
3 0.58 0.06  0.44  0.71  0.15  1.01

       tyg8 formaonline
       1.61        1.61
    p_QM_perm   p_tyg8_perm p_online_perm
       0.0146        0.1214        0.2886
        forma tygodnie.M tygodnie.min tygodnie.max
1 stacjonarna       10.5          6.0         16.0
2      online        6.6          4.0          9.0
2. Symulacja fałszywych alarmów
R
# Symulacja w duchu Higginsa i Thompsona (2004): ile metaanaliz da choć jeden "istotny" moderator,
# gdy żaden z 5 sprawdzanych moderatorów nie ma związku z efektem, a heterogeniczność jest umiarkowana (tau² = 0.04)
suppressPackageStartupMessages(library(metafor))
jedna_metaanaliza <- function(k, n_mod = 5, tau2 = 0.04) {
  n <- round(runif(k, 20, 90))
  vi <- 2 / n + 0.16 / (4 * n)
  yi <- rnorm(k, 0.40 + rnorm(k, 0, sqrt(tau2)), sqrt(vi))
  X <- matrix(rnorm(k * n_mod), k, n_mod)                     # moderatory bez związku z efektem
  p <- sapply(1:n_mod, function(j) {
    fe <- rma(yi, vi, mods = ~ X[, j], method = "EE")          # model efektu wspólnego (stałego)
    re <- rma(yi, vi, mods = ~ X[, j])                         # efekty losowe, test z (Walda)
    kh <- rma(yi, vi, mods = ~ X[, j], test = "knha")          # efekty losowe, Knapp–Hartung
    c(fe = fe$pval[2], re = re$pval[2], kh = kh$pval[2])
  })
  c(rowMeans(p < .05), apply(p < .05, 1, any))                 # pojedynczy test i "choć jeden z 5"
}
set.seed(2193)
wyniki <- t(sapply(c(10, 20, 40), function(k) rowMeans(replicate(1000, jedna_metaanaliza(k)))))
dimnames(wyniki) <- list(paste0("k = ", c(10, 20, 40)),
                         c("EE_jeden", "RE_z_jeden", "RE_KH_jeden", "EE_choc1z5", "RE_z_choc1z5", "RE_KH_choc1z5"))
round(100 * wyniki, 1)
round(100 * (1 - .95^5), 1)                                  # oczekiwany odsetek przy 5 niezależnych testach
Wynik w R
       EE_jeden RE_z_jeden RE_KH_jeden EE_choc1z5 RE_z_choc1z5 RE_KH_choc1z5
k = 10     18.2        8.0         5.6       57.3         32.7          24.0
k = 20     18.7        6.7         5.5       60.6         28.4          24.5
k = 40     18.2        6.1         5.2       62.7         26.6          23.4
[1] 22.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje rma(), predict(), vif() i permutest() z pakietu metafor); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Metaregresja z efektem stałym albo test Walda bez poprawki. Model efektu wspólnego dał fałszywy alarm w prawie co piątym teście; używaj efektów losowych z
test = "knha". - Dziesięć moderatorów przy dwudziestu badaniach. Licz co najmniej 10 badań na moderator i planuj je w protokole.
- Ogłaszanie „właściwego” moderatora, gdy moderatory są ze sobą powiązane.
- Przewidywanie poza zakresem danych. Linia na wykresie bąbelkowym nie mówi nic o długich programach online, jeśli żadne badanie ich nie sprawdzało.
- Wnioski o osobach z moderatorów zagregowanych, np. „program działa lepiej u kobiet”, bo badania z większym odsetkiem kobiet miały większe efekty.
Najczęstsze pytania
Ile moderatorów można sprawdzić w metaregresji?
Niewiele. Podręcznik Cochrane zaleca co najmniej 10 badań na każdy moderator i odradza metaregresję przy mniej niż 10 badaniach w metaanalizie (Higgins i in., 2024). Przy 30 badaniach to najwyżej trzy moderatory, a mniej, gdy są rozłożone nierówno, np. 26 badań stacjonarnych i 4 online. Każdy kolejny moderator zwiększa też ryzyko fałszywego alarmu, więc wybierz je w protokole.
Kiedy wybrać analizę podgrup, a kiedy metaregresję w metaanalizie?
Analiza podgrup wystarczy przy jednym moderatorze kategorycznym, zwłaszcza gdy heterogeniczność może się różnić między podgrupami, bo każda dostaje własne τ². Metaregresję wybierz przy moderatorze ciągłym, kilku moderatorach naraz albo małych podgrupach, w których osobne τ² byłoby bardzo niepewne (Thompson i Higgins, 2002). Przy wspólnym τ² oba podejścia dają ten sam test różnicy.
Dlaczego R² w metaregresji wynosi 0%, choć moderator jest istotny?
Pseudo-R² liczy się z różnicy τ² w modelu bez moderatorów i z moderatorami, a oba τ² są szacowane niezależnie i niezbyt precyzyjnie. Gdy τ² resztowe wyjdzie większe niż wyjściowe, różnica jest ujemna, a metafor przycina ją do zera. Przy małej liczbie badań traktuj R² jako przybliżenie i opieraj wniosek na oszacowaniu współczynnika z 95% CI.
Kiedy użyć testu permutacyjnego w metaregresji?
Gdy badań jest niewiele, heterogeniczność jest duża albo sprawdzasz kilka moderatorów. Higgins i Thompson (2004) zalecają go przed ogłoszeniem istotnego związku, a w symulacjach razem z poprawką Knappa–Hartunga dobrze kontroluje błąd I rodzaju (Viechtbauer i in., 2015). W metafor wywołasz go funkcją permutest(); podaj liczbę permutacji i ziarno losowania.
Czy istotny moderator w metaregresji oznacza związek przyczynowy?
Nie. Badań nie przydzielono losowo do poziomów moderatora, więc badania z dłuższymi programami mogą różnić się też populacją, jakością albo rokiem. Wynik metaregresji to zależność obserwacyjna na poziomie badań (Thompson i Higgins, 2002). Do wniosków o osobach potrzebujesz danych indywidualnych albo porównań wewnątrz badań.
Powiązane hasła
Przeczytaj też
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikMetaanaliza wielopoziomowa, umbrella review i PRISMA 2020
Wielkość efektu i przeliczanie danych, modele efektów losowych, metaanaliza trójpoziomowa, umbrella review z klasami dowodów, PRISMA 2020 i kod R.
Czytaj →PoradnikAnaliza multiverse i krzywa specyfikacji
Wybór uzasadnionych decyzji, wszystkie specyfikacje pętlą w R, dwupanelowy wykres w ggplot2, test permutacyjny przy H0 i wzór opisu.
Czytaj →Masz heterogeniczną metaanalizę i recenzenta, który pyta o moderatory?
Pomożemy zaplanować moderatory, dopasować metaregresję w metafor, sprawdzić wyniki testem permutacyjnym i opisać je ostrożnie, tak żebyś mógł(a) samodzielnie obronić każdą decyzję.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Berlin, J. A., Santanna, J., Schmid, C. H., Szczech, L. A., & Feldman, H. I. (2002). Individual patient- versus group-level data meta-regressions for the investigation of treatment effect modifiers: Ecological bias rears its ugly head. Statistics in Medicine, 21(3), 371–387. https://doi.org/10.1002/sim.1023
- Higgins, J. P. T., & Thompson, S. G. (2004). Controlling the risk of spurious findings from meta-regression. Statistics in Medicine, 23(11), 1663–1682. https://doi.org/10.1002/sim.1752
- Higgins, J. P. T., Thomas, J., Chandler, J., Cumpston, M., Li, T., Page, M. J., & Welch, V. A. (Eds.). (2024). Cochrane handbook for systematic reviews of interventions (Version 6.5, updated August 2024). Cochrane. https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current ● Otwarty dostęp
- Knapp, G., & Hartung, J. (2003). Improved tests for a random effects meta-regression with a single covariate. Statistics in Medicine, 22(17), 2693–2710. https://doi.org/10.1002/sim.1482
- López-López, J. A., Marín-Martínez, F., Sánchez-Meca, J., Van den Noortgate, W., & Viechtbauer, W. (2014). Estimation of the predictive power of the model in mixed-effects meta-regression: A simulation study. British Journal of Mathematical and Statistical Psychology, 67(1), 30–48. https://doi.org/10.1111/bmsp.12002 ● Otwarty dostęp
- Thompson, S. G., & Higgins, J. P. T. (2002). How should meta-regression analyses be undertaken and interpreted? Statistics in Medicine, 21(11), 1559–1573. https://doi.org/10.1002/sim.1187
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
- Viechtbauer, W., López-López, J. A., Sánchez-Meca, J., & Marín-Martínez, F. (2015). A comparison of procedures to test for moderators in mixed-effects meta-regression models. Psychological Methods, 20(3), 360–374. https://doi.org/10.1037/met0000023 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{berlin2002individual, author={Berlin, Jesse A. and Santanna, Jill and Schmid, Christopher H. and Szczech, Lynda A. and Feldman, Harold I.}, title={{Individual patient- versus group-level data meta-regressions for the investigation of treatment effect modifiers: Ecological bias rears its ugly head}}, journal={Statistics in Medicine}, year={2002}, volume={21}, number={3}, pages={371--387}, doi={10.1002/sim.1023}}@article{higgins2004controlling, author={Higgins, Julian P. T. and Thompson, Simon G.}, title={{Controlling the risk of spurious findings from meta-regression}}, journal={Statistics in Medicine}, year={2004}, volume={23}, number={11}, pages={1663--1682}, doi={10.1002/sim.1752}}@misc{higgins2024cochrane, author={Higgins, Julian P. T. and Thomas, James and Chandler, Jacqueline and Cumpston, Miranda and Li, Tianjing and Page, Matthew J. and Welch, Vivian A.}, title={{Cochrane handbook for systematic reviews of interventions (Version 6.5, updated August 2024)}}, year={2024}, publisher={Cochrane}, url={https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current}}@article{knapp2003improved, author={Knapp, Guido and Hartung, Joachim}, title={{Improved tests for a random effects meta-regression with a single covariate}}, journal={Statistics in Medicine}, year={2003}, volume={22}, number={17}, pages={2693--2710}, doi={10.1002/sim.1482}}@article{lopezlopez2014estimation, author={López-López, José Antonio and Marín-Martínez, Fulgencio and Sánchez-Meca, Julio and Van den Noortgate, Wim and Viechtbauer, Wolfgang}, title={{Estimation of the predictive power of the model in mixed-effects meta-regression: A simulation study}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2014}, volume={67}, number={1}, pages={30--48}, doi={10.1111/bmsp.12002}}@article{thompson2002how, author={Thompson, Simon G. and Higgins, Julian P. T.}, title={{How should meta-regression analyses be undertaken and interpreted?}}, journal={Statistics in Medicine}, year={2002}, volume={21}, number={11}, pages={1559--1573}, doi={10.1002/sim.1187}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={{Conducting meta-analyses in R with the metafor package}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}@article{viechtbauer2015comparison, author={Viechtbauer, Wolfgang and López-López, José Antonio and Sánchez-Meca, Julio and Marín-Martínez, Fulgencio}, title={{A comparison of procedures to test for moderators in mixed-effects meta-regression models}}, journal={Psychological Methods}, year={2015}, volume={20}, number={3}, pages={360--374}, doi={10.1037/met0000023}}