Co to jest falsyfikowalność?
Falsyfikowalność (ang. falsifiability) to cecha hipotezy lub teorii, która polega na tym, że da się wskazać możliwe wyniki obserwacji sprzeczne z nią – takie, które, gdyby wystąpiły, pokazałyby, że jest fałszywa. Klasyczne ujęcie tego kryterium przedstawił Karl Popper w Logice odkrycia naukowego (Popper, 2002): o naukowości twierdzenia nie świadczy to, ile obserwacji je potwierdza, lecz to, czy cokolwiek mogłoby je obalić.
Za tym kryterium stoi prosta asymetria. Żadna liczba potwierdzeń nie dowodzi twierdzenia ogólnego – kolejne badanie zawsze może przynieść wynik sprzeczny. Jeden dobrze udokumentowany wynik sprzeczny może natomiast twierdzenie podważyć. Dlatego dobra hipoteza naukowa „ryzykuje”: zakazuje pewnych wyników. Im więcej zakazuje, tym więcej mówi o świecie i tym łatwiej ją sprawdzić.
Warto odróżnić falsyfikowalność (możliwość obalenia) od falsyfikacji (faktycznego obalenia przez dane). Hipoteza może być w pełni falsyfikowalna i mimo to przejść wszystkie dotychczasowe testy. Relację hipotez z teorią, z której je wyprowadzamy, omawiamy szerzej we wpisie jaka jest relacja między hipotezą a teorią.
Falsyfikowalność w psychologii
Meehl (1978) argumentował, że teorie w „miękkich” obszarach psychologii rzadko są obalane albo potwierdzane – z czasem po prostu tracą popularność. Jedną z przyczyn widział w nadmiernym poleganiu na testach istotności. Hipoteza „grupy się różnią” jest testem bardzo łagodnym: przy wystarczająco dużej próbie niemal każda różnica stanie się istotna, a teoria zostanie „potwierdzona” bez względu na to, czy jest trafna. Meehl postulował więc – w zmodyfikowanym duchu Poppera – ryzykowne testy, w których teoria przewiduje konkretne wartości liczbowe, a nie tylko kierunek.
W praktyce pracy dyplomowej oznacza to, że hipoteza powinna precyzować:
- konstrukty i ich pomiar – bez operacjonalizacji nie wiadomo, jaki wynik przeczyłby hipotezie;
- kierunek – hipoteza kierunkowa zakazuje wyników w przeciwną stronę (zob. test jednostronny i dwustronny);
- minimalną wielkość efektu, która ma znaczenie – dopiero wtedy da się wykazać, że efektu ważnego praktycznie nie ma (zob. wielkość efektu);
- warunki – populację i sytuację, w których przewidywanie ma obowiązywać.
Co zakazuje hipoteza? Przykład z jednym wynikiem
Załóżmy badanie, w którym 100 osób przeszło trening, a 100 stanowiło grupę kontrolną (dane symulowane, bez prawdziwego efektu). Średni stres wyniósł 3.15 w grupie kontrolnej i 3.11 po treningu, czyli d = 0.04, 90% CI [−0.19, 0.27]; klasyczny test różnicy dał t(198) = 0.29, p = .773. Rysunek 1 zestawia ten jeden wynik z trzema hipotezami o różnej precyzji.
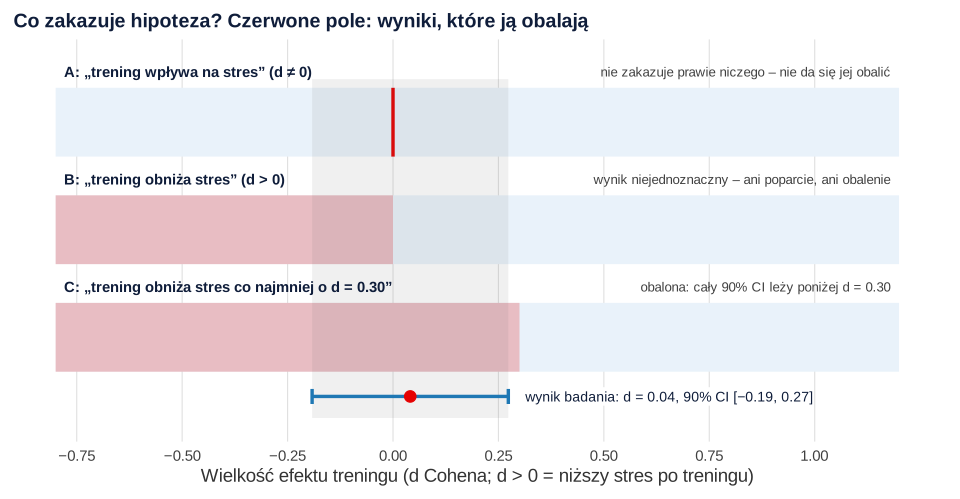
- Hipoteza A („trening wpływa na stres”, d ≠ 0) zakazuje tylko jednej wartości: dokładnie zera. Żaden przedział ufności nie wykluczy wszystkich wartości różnych od zera, więc żaden wynik nie może jej obalić.
- Hipoteza B („trening obniża stres”, d > 0) zakazuje efektów zerowych i ujemnych. Nasz przedział obejmuje zarówno wartości ujemne, jak i dodatnie, więc wynik jest niejednoznaczny: hipoteza nie została ani poparta, ani obalona.
- Hipoteza C („trening obniża stres co najmniej o d = 0.30”) zakazuje efektów mniejszych niż 0.30 – najmniejszego efektu, który uznano za istotny praktycznie. Cały 90% przedział leży poniżej 0.30, a jednostronny test względem tej granicy daje t(198) = −1.83, p = .034. Hipoteza C została sfalsyfikowana.
Test, który pozwala wykazać, że efekt jest mniejszy od najmniejszej interesującej wielkości, to test równoważności. Lakens i in. (2018) opisują go jako procedurę dwóch testów jednostronnych (TOST): pozwala ona odrzucić obecność efektów co najmniej tak dużych jak najmniejszy interesujący efekt i w ten sposób stwierdzić brak efektu o praktycznym znaczeniu. Dla hipotezy kierunkowej, takiej jak C, wystarcza jeden z tych testów. Bez określenia minimalnego efektu wartość p większa niż .05 nie obala niczego – pokazuje tylko, że nie wykazano różnicy (por. hipoteza zerowa i alternatywna).
Hipotezy pomocnicze: jak teorie unikają obalenia
Żadna hipoteza nie jest testowana w izolacji. Aby z teorii wyprowadzić przewidywanie, trzeba przyjąć wiele założeń pomocniczych: że manipulacja zadziałała, że kwestionariusz mierzy to, co miał mierzyć, że próba była odpowiednia. Uygun Tunç i Tunç (2023) zwracają uwagę, że takie hipotezy pomocnicze są niezbędne, ale mogą też służyć do „ratowania” teorii przed falsyfikacją: wynik sprzeczny z przewidywaniem tłumaczy się wtedy słabą manipulacją albo nietrafnym pomiarem, a sama teoria pozostaje nietknięta.
Lakatos (1970) rozwinął ideę falsyfikacji w metodologii naukowych programów badawczych, rozróżniając zmiany teorii postępowe od degeneracyjnych. Uygun Tunç i Tunç (2023) proponują, by to rozróżnienie oceniać za pomocą systematycznych replikacji – bliskich i konceptualnych. Poprawka teorii jest postępowa, jeśli prowadzi do nowych, sprawdzalnych przewidywań, które się potwierdzają; degeneracyjna – jeśli tylko tłumaczy porażkę po fakcie. Dlatego ważne jest, by kontrolę manipulacji i trafność pomiaru zaplanować przed badaniem (zob. manipulacja eksperymentalna), a nie dopiero po niepomyślnym wyniku.
Jak pisać falsyfikowalne hipotezy w pracy
Poniższa tabela pokazuje typowe sformułowania z prac dyplomowych i ich falsyfikowalne wersje. Wzory dla poszczególnych typów hipotez znajdziesz też w haśle hipoteza badawcza i w poradniku pytania badawcze i hipotezy.
| Słabo falsyfikowalna | Dlaczego | Falsyfikowalna wersja |
|---|---|---|
| „Wsparcie społeczne może mieć związek ze stresem.” | „Może” pasuje do każdego wyniku | „Wyższe wsparcie społeczne (MSPSS) będzie związane z niższym stresem (PSS-10); oczekujemy korelacji nie słabszej niż r = −.20.” |
| „Trening wpłynie na samopoczucie.” | Brak kierunku i pomiaru; potwierdzi ją każda różnica | „Po 4 tygodniach treningu stres będzie niższy niż w grupie kontrolnej co najmniej o d = 0.30.” |
| „Związek osobowości z zachowaniem zależy od sytuacji.” | Każdy wzorzec wyników da się uznać za „zależny od sytuacji” | „Neurotyczność będzie silniej związana z lękiem przed egzaminem niż przed zwykłymi zajęciami (porównanie dwóch korelacji).” |
| „Jeśli efekt nie wystąpi, oznacza to, że uczestnicy nie zrozumieli instrukcji.” | Ratowanie hipotezy po fakcie | „Zrozumienie instrukcji sprawdzimy pytaniem kontrolnym; osoby, które na nie źle odpowiedzą, wykluczymy według kryterium ustalonego przed badaniem.” |
Lakens i DeBruine (2021) idą krok dalej: proponują zapisywanie testów hipotez w postaci odczytywalnej maszynowo, tak by komputer mógł ocenić, czy predykcja została potwierdzona. Taki zapis wymusza określenie z góry testu, poziomu α i warunków, w których hipoteza zostanie uznana za potwierdzoną albo sfalsyfikowaną, co według autorów czyni testy bardziej przejrzystymi, falsyfikowalnymi i rygorystycznymi. Nawet jeśli nie piszesz kodu, możesz zastosować tę logikę w tekście:
Taki zapis warto umieścić w prerejestracji lub w planie przesłanym promotorowi przed zebraniem danych. Do planu dołącz analizę mocy a priori – bez wystarczającej mocy wynik będzie najczęściej niejednoznaczny. Alternatywą jest podejście bayesowskie, w którym czynnik Bayesa może wskazać dowody na rzecz hipotezy zerowej.
Sprawdzenie kryterium falsyfikacji w R
Kod liczy wielkość efektu z 90% przedziałem ufności, klasyczny test różnicy oraz jednostronny test względem najmniejszego interesującego efektu d = 0.30. Liczby w haśle i na rysunku pochodzą z tego kodu.
Test hipotezy C: czy efekt jest mniejszy niż d = 0.30?
R
# Badanie symulowane: trening (n = 100) i kontrola (n = 100), prawdziwy efekt d = 0.
set.seed(16)
kontrola <- rnorm(100, mean = 3.1, sd = 0.8)   # stres (1–5) w grupie kontrolnej
trening  <- rnorm(100, mean = 3.1, sd = 0.8)   # stres po treningu
wynik <- effectsize::cohens_d(kontrola, trening, ci = 0.90)   # d > 0 oznacza niższy stres po treningu
wynik
t.test(kontrola, trening, var.equal = TRUE)    # klasyczny test różnicy (dwustronny)
# kryterium falsyfikacji hipotezy C: czy efekt jest mniejszy niż d = 0.30?
sd_laczne <- sqrt((var(kontrola) + var(trening)) / 2)
t.test(kontrola, trening, var.equal = TRUE, mu = 0.30 * sd_laczne, alternative = "less")
Wynik w R
Cohen's d |        90% CI
-------------------------
0.04      | [-0.19, 0.27]

- Estimated using pooled SD.

	Two Sample t-test

data:  kontrola and trening
t = 0.289, df = 198, p-value = 0.7729
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -0.1911930  0.2568538
sample estimates:
mean of x mean of y
 3.147666  3.114836


	Two Sample t-test

data:  kontrola and trening
t = -1.8323, df = 198, p-value = 0.0342
alternative hypothesis: true difference in means is less than 0.2409844
95 percent confidence interval:
     -Inf 0.220566
sample estimates:
mean of x mean of y
 3.147666  3.114836
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Mylenie wyniku nieistotnego z falsyfikacją – p > .05 w badaniu o małej mocy nie obala hipotezy, tylko jej nie wspiera. Do obalenia potrzebne jest kryterium falsyfikacji ustalone z góry.
- Hipotezy z „może”, „ma znaczenie”, „wpływa” – bez kierunku i wielkości efektu każdy wynik da się uznać za zgodny z hipotezą.
- Ratowanie hipotezy po fakcie – tłumaczenie porażki słabą manipulacją albo specyfiką próby bez wcześniej zaplanowanej kontroli (Uygun Tunç i Tunç, 2023).
- Dopasowywanie hipotezy do wyników – hipoteza zapisana po poznaniu danych zawsze się „potwierdza”, więc niczego nie testuje (zob. HARKing).
- Utożsamianie istotności z potwierdzeniem teorii – w dużej próbie istotna staje się nawet znikoma różnica; Meehl (1978) uważał takie łagodne testy za jedną z przyczyn powolnego postępu psychologii.
- Brak kryterium „sukcesu” – w planie badania zapisz, jaki wynik potwierdzi hipotezę, jaki ją obali, a jaki będzie niejednoznaczny.
Najczęstsze pytania
Co to jest falsyfikowalność?
To możliwość wskazania wyników, które – gdyby wystąpiły – pokazałyby, że hipoteza jest fałszywa. Klasyczne ujęcie tego kryterium naukowości przedstawił Karl Popper w Logice odkrycia naukowego. Hipoteza, która pasuje do każdego wyniku, nie jest falsyfikowalna.
Czym różni się falsyfikowalność od falsyfikacji?
Falsyfikowalność to możliwość obalenia hipotezy, a falsyfikacja – jej faktyczne obalenie przez dane. Hipoteza może być w pełni falsyfikowalna i mimo to przejść wszystkie dotychczasowe testy.
Jak napisać falsyfikowalną hipotezę?
Określ konstrukty i sposób ich pomiaru, kierunek związku lub różnicy oraz najmniejszą wielkość efektu, która ma znaczenie, np. „stres po treningu będzie niższy niż w grupie kontrolnej co najmniej o d = 0.30”. Zapisz też z góry, jaki wynik uznasz za potwierdzenie, a jaki za obalenie hipotezy.
Czy nieistotny wynik obala hipotezę?
Nie. Wynik p > .05 oznacza tylko, że nie wykazano efektu – zwłaszcza w małej próbie. Aby obalić hipotezę, trzeba pokazać, że efekt jest mniejszy od najmniejszej interesującej wielkości, np. testem równoważności, albo użyć czynnika Bayesa.
Co to są hipotezy pomocnicze?
To założenia potrzebne do wyprowadzenia przewidywań z teorii, np. że manipulacja zadziałała, a kwestionariusz mierzy to, co miał mierzyć. Mogą one jednak posłużyć do „ratowania” teorii po niepomyślnym wyniku, dlatego kontrolę manipulacji i trafność pomiaru planuje się przed badaniem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jaka jest relacja między hipotezą a teorią?
Definicje i różnice, dedukcja i indukcja, hipoteza a przewidywanie, falsyfikacja, wkład teoretyczny, przykład krok po kroku i wzór do pracy.
Czytaj →PoradnikPytania badawcze i hipotezy: jak przejść od teorii do analizy
Jak formułować pytania badawcze i hipotezy? Od teorii i operacjonalizacji przez kierunek efektu po plan analizy i prerejestrację.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lakatos, I. (1970). Falsification and the methodology of scientific research programmes. In I. Lakatos & A. Musgrave (Eds.), Criticism and the growth of knowledge (pp. 91–196). Cambridge University Press. https://doi.org/10.1017/CBO9781139171434.009
- Lakens, D., & DeBruine, L. M. (2021). Improving transparency, falsifiability, and rigor by making hypothesis tests machine-readable. Advances in Methods and Practices in Psychological Science, 4(2), Article 2515245920970949. https://doi.org/10.1177/2515245920970949 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Meehl, P. E. (1978). Theoretical risks and tabular asterisks: Sir Karl, Sir Ronald, and the slow progress of soft psychology. Journal of Consulting and Clinical Psychology, 46(4), 806–834. https://doi.org/10.1037/0022-006X.46.4.806
- Popper, K. R. (2002). Logika odkrycia naukowego (U. Niklas, Tłum.; Wyd. 2). Wydawnictwo Naukowe PWN.
- Uygun Tunç, D., & Tunç, M. N. (2023). Falsificationist treatment of auxiliary hypotheses in social and behavioral sciences: Systematic replications framework. Meta-Psychology, 7. https://doi.org/10.15626/mp.2021.2756 ● Otwarty dostęp
Cytowania BibTeX
@incollection{lakatos1970falsification, author={Lakatos, Imre}, title={{Falsification and the methodology of scientific research programmes}}, booktitle={Criticism and the growth of knowledge}, year={1970}, pages={91--196}, publisher={Cambridge University Press}, doi={10.1017/cbo9781139171434.009}}@article{lakens2021improving, author={Lakens, Daniël and DeBruine, Lisa M.}, title={{Improving transparency, falsifiability, and rigor by making hypothesis tests machine-readable}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={2}, eid={2515245920970949}, doi={10.1177/2515245920970949}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{meehl1978theoretical, author={Meehl, Paul E.}, title={{Theoretical risks and tabular asterisks: Sir Karl, Sir Ronald, and the slow progress of soft psychology}}, journal={Journal of Consulting and Clinical Psychology}, year={1978}, volume={46}, number={4}, pages={806--834}, doi={10.1037/0022-006x.46.4.806}}@book{popper2002logika, author={Popper, Karl R.}, title={{Logika odkrycia naukowego}}, year={2002}, edition={Wyd. 2}, publisher={Wydawnictwo Naukowe PWN}}@article{uygun2023falsificationist, author={Uygun Tunç, Duygu and Tunç, Mehmet Necip}, title={{Falsificationist treatment of auxiliary hypotheses in social and behavioral sciences: Systematic replications framework}}, journal={Meta-Psychology}, year={2023}, volume={7}, doi={10.15626/mp.2021.2756}}