Co to jest czynnik Bayesa?
Czynnik Bayesa (ang. Bayes factor, BF) mówi, ile razy bardziej prawdopodobne są uzyskane dane przy jednej hipotezie niż przy drugiej. Najczęściej porównuje się hipotezę alternatywną H1 z hipotezą zerową H0 – ten sam układ co w klasycznym teście istotności (zob. hipoteza zerowa i alternatywna). Wynik BF10 = 5 oznacza, że dane są pięć razy bardziej prawdopodobne przy H1 niż przy H0.
- D – zebrane dane,
- p(D | H) – prawdopodobieństwo danych przy danej hipotezie, uśrednione po wszystkich wartościach parametru dopuszczanych przez tę hipotezę (tzw. wiarygodność brzegowa); wagi w tym uśrednianiu wyznacza rozkład a priori parametru (Kass i Raftery, 1995),
- BF01 = 1 / BF10 – ten sam wynik zapisany na korzyść H0.
Kass i Raftery (1995) pokazują też, jak czynnik Bayesa zmienia przekonania: szanse a posteriori = czynnik Bayesa × szanse a priori. Czynnik Bayesa nie jest więc prawdopodobieństwem, że hipoteza jest prawdziwa. Mówi, o ile dane powinny przesunąć nasze przekonanie – niezależnie od tego, w co wierzyliśmy przed badaniem.
Czynnik Bayesa a wartość p
W podejściu częstościowym (NHST) wartość p mówi, jak nietypowe byłyby dane, gdyby prawdziwa była H0. Nieistotny wynik nie odróżnia jednak „braku dowodu” od „dowodu braku”. Czynnik Bayesa ocenia obie hipotezy jednocześnie, więc może wskazać dowody także na rzecz H0 (Kass i Raftery, 1995). Wagenmakers, Marsman i in. (2018) wymieniają tę cechę wśród głównych zalet testowania bayesowskiego, obok możliwości monitorowania siły dowodów w miarę napływu danych. Szerzej o tym, co mówi, a czego nie mówi p, piszemy w poradniku wartość p – interpretacja.
| Cecha | Wartość p (NHST) | Czynnik Bayesa |
|---|---|---|
| Na jakie pytanie odpowiada | Jak nietypowe są dane przy założeniu H0? | Przy której hipotezie dane są bardziej prawdopodobne i ile razy? |
| Dowody na rzecz H0 | Nie da się ich wyrazić | Tak: BF01 > 1 |
| Wymaga rozkładu a priori | Nie | Tak, dla parametru przy H1 |
| Wynik | Decyzja względem progu α | Ciągła miara siły dowodów |
Jak interpretować czynnik Bayesa?
Czynnik Bayesa to liczba na skali ciągłej, ale dla ułatwienia komunikacji stosuje się opisowe kategorie. Program JASP używa schematu, który Wagenmakers, Love i in. (2018) zaczerpnęli z prac Jeffreysa w wersji Lee i Wagenmakersa:
| BF10 | BF01 | Dowody |
|---|---|---|
| > 100 | < 1/100 | skrajne na rzecz H1 |
| 30–100 | 1/100–1/30 | bardzo silne na rzecz H1 |
| 10–30 | 1/30–1/10 | silne na rzecz H1 |
| 3–10 | 1/10–1/3 | umiarkowane na rzecz H1 |
| 1–3 | 1/3–1 | anegdotyczne (słabe) na rzecz H1 |
| 1 | 1 | brak dowodów w żadną stronę |
| 1/3–1 | 1–3 | anegdotyczne na rzecz H0 |
| 1/10–1/3 | 3–10 | umiarkowane na rzecz H0 |
| < 1/10 | > 10 | silne i mocniejsze na rzecz H0 (dalej symetrycznie) |
Kass i Raftery (1995) proponują nieco inną skalę: 1–3 – dowody „niewarte więcej niż wzmianki”, 3–20 – pozytywne, 20–150 – silne, powyżej 150 – bardzo silne. Obie grupy autorów podkreślają, że kategorie są tylko przybliżonym opisem, a nie kalibracją. BF10 = 2.9 i 3.1 niosą praktycznie tę samą informację, choć wypadają w różnych przedziałach – progi traktuj jako pomoc w komunikacji, a nie granice decyzji (van Doorn i in., 2021).
Rozkład a priori i analiza odporności
Żeby policzyć p(D | H1), trzeba określić, jakich wielkości efektu oczekujemy, jeśli H1 jest prawdziwa. W bayesowskim teście t standaryzowana wielkość efektu δ ma przy H1 rozkład Cauchy’ego o skali r. Pakiet BayesFactor w R domyślnie przyjmuje r = √2/2 ≈ 0.707, a JASP przejął tę wartość – opisują to Wagenmakers, Love i in. (2018). Skala mówi, że połowa prawdopodobieństwa a priori przypada na efekty od −0.707 do 0.707.
Wybór rozkładu a priori wpływa na wynik, zwłaszcza w małych próbach. Dlatego van Doorn i in. (2021) zalecają podawać ustawienia rozkładu a priori, uzasadniać je i sprawdzać odporność wniosku na inne rozsądne ustawienia (w JASP: wykres Bayes factor robustness check). Szerszy rozkład przypisuje więcej prawdopodobieństwa dużym efektom, więc przy umiarkowanym efekcie w danych BF10 zwykle maleje – widać to w przykładzie poniżej.
Przykład: bayesowski test t dla dwóch grup
Badanie A. Pięćdziesiąt osób przeszło trening uważności, pięćdziesiąt stanowiło grupę kontrolną (dane symulowane). Po treningu poziom lęku (skala 20–80) wynosił M = 39.98 (SD = 10.92), a w grupie kontrolnej M = 44.86 (SD = 8.05). Klasyczny test t dla prób niezależnych daje t(98) = 2.54, p = .013, d = 0.51, 95% CI [0.11, 0.91]. Bayesowski test t z domyślnym rozkładem a priori daje BF10 = 3.55: dane są 3.55 razy bardziej prawdopodobne przy H1 niż przy H0, co według skali z JASP oznacza dowody umiarkowane. Wynik istotny statystycznie przy α = .05 nie oznacza więc przytłaczających dowodów.
Mediana rozkładu a posteriori wielkości efektu wynosi δ = 0.46, a 95% przedział wiarygodności (ang. credible interval, CrI) – [0.07, 0.86]. W odróżnieniu od przedziału ufności ten przedział można czytać wprost: przy założeniu, że efekt istnieje, i przy przyjętym modelu prawdziwa wartość δ leży w nim z prawdopodobieństwem 95% (van Doorn i in., 2021). Analiza odporności pokazuje, że przy szerszych rozkładach a priori (skala 1 i √2 ≈ 1.414) BF10 spada do 2.97 i 2.34, czyli do dowodów anegdotycznych. Wniosek o umiarkowanych dowodach zależy więc od wyboru rozkładu a priori – to informacja, którą trzeba podać w pracy.
Badanie B. W drugim badaniu (również 50 + 50 osób) prawdziwego efektu nie było: M = 47.28 i 46.14, t(98) = 0.55, p = .582. Wartość p mówi tylko, że różnicy nie wykazano. Czynnik Bayesa idzie dalej: BF10 = 0.24, czyli BF01 = 4.14 – dane są ponad czterokrotnie bardziej prawdopodobne przy H0, co oznacza umiarkowane dowody na brak różnicy. Przy 50 osobach w grupie i domyślnym rozkładzie a priori BF01 nie może przekroczyć 4.74 (tyle wynosi przy t = 0), więc do silnych dowodów na rzecz H0 potrzeba większych prób.
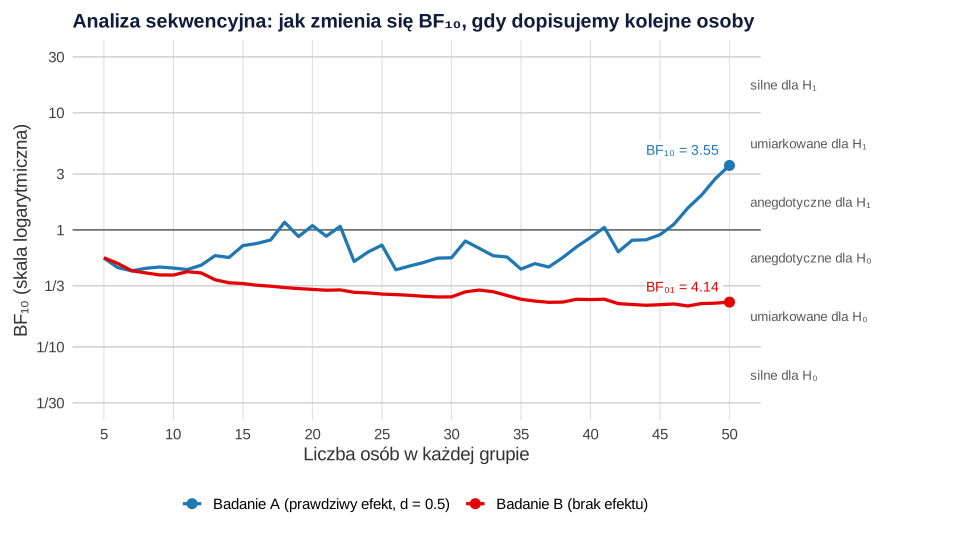
Rysunek 1 pokazuje, jak zmieniała się siła dowodów w miarę zbierania danych. W badaniu A czynnik Bayesa długo krążył wokół 1 – przy 40 osobach w grupie wynosił 0.86 – i przekroczył próg 3 dopiero przy ostatnich uczestnikach. W badaniu B systematycznie spadał. Takie monitorowanie jest w podejściu bayesowskim dozwolone – Wagenmakers, Marsman i in. (2018) zaliczają je do zalet czynnika Bayesa – ale regułę zatrzymania (np. „zbieramy dane, aż BF10 > 10 albo BF01 > 10, najwyżej do 100 osób w grupie”) ustal przed badaniem i opisz w pracy.
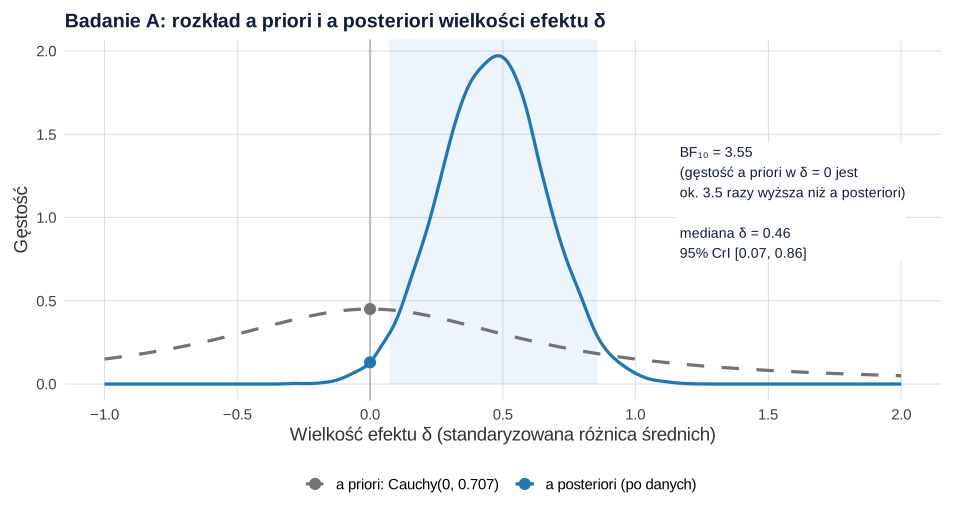
Rysunek 2 przypomina wykres „Prior and posterior” z JASP. Dane przesunęły prawdopodobieństwo w stronę dodatnich efektów, a gęstość w punkcie δ = 0 spadła z 0.45 do 0.13. Stosunek tych gęstości (około 3.5, przy przybliżonym oszacowaniu gęstości a posteriori) odpowiada czynnikowi Bayesa, który dokładnie wynosi 3.55. To tzw. stosunek Savage’a–Dickeya: im bardziej dane „odpychają” rozkład od zera, tym większy BF10.
Na koniec porównanie, które często zaskakuje. Weźmy ten sam wynik p = .04 w trzech badaniach o różnej liczebności i policzmy dla niego czynnik Bayesa:
| Osób w każdej grupie | 20 | 50 | 200 |
|---|---|---|---|
| BF10 przy p = .04 | 1.77 | 1.42 | 0.85 |
Wynik „istotny” przy p = .04 odpowiada co najwyżej anegdotycznym dowodom na rzecz H1, a w dużej próbie – nawet słabym dowodom na rzecz H0. Dlatego warto raportować wielkość efektu i niepewność oszacowania, a nie tylko przekroczenie progu α.
Jak opisać czynnik Bayesa w pracy (APA)
Jarosz i Wiley (2014) proponują szablon raportowania czynnika Bayesa, a van Doorn i in. (2021) – listę elementów, które powinien zawierać opis analizy bayesowskiej: czynnik Bayesa z indeksem (BF10 albo BF01), ustawienia rozkładu a priori i ich uzasadnienie, medianę rozkładu a posteriori z przedziałem wiarygodności, ocenę odporności wyniku oraz program, w którym liczono. Przykład dla badania A:
Wynik na rzecz hipotezy zerowej zapisz z BF01:
W JASP te same analizy przeprowadzisz bez programowania – Wagenmakers, Love i in. (2018) pokazują bayesowskie odpowiedniki testu t, ANOVA, korelacji, regresji i tabel kontyngencji. Bayesowską analizę mocy i plan zbierania danych opisz w metodzie tak samo starannie jak analizę mocy a priori w podejściu klasycznym.
Przykład w R
Kod generuje dane obu badań, liczy klasyczny test t, czynnik Bayesa (ttestBF() z pakietu BayesFactor), rozkład a posteriori i analizę odporności. Liczby w haśle i na rysunkach pochodzą z tego kodu.
Badanie A: test t i czynnik Bayesa
R
library(BayesFactor)
set.seed(70)
n <- 50
kontrola <- round(rnorm(n, mean = 46, sd = 10))   # lęk (skala 20–80) w grupie kontrolnej
trening  <- round(rnorm(n, mean = 41, sd = 10))   # lęk po treningu uważności
round(c(M_kontrola = mean(kontrola), SD_kontrola = sd(kontrola),
        M_trening = mean(trening), SD_trening = sd(trening)), 2)
t.test(kontrola, trening, var.equal = TRUE)       # klasyczny test t – dla porównania
effectsize::cohens_d(kontrola, trening)
bf <- ttestBF(x = kontrola, y = trening, rscale = "medium")   # H1: δ ~ Cauchy(0, √2/2)
bf10 <- extractBF(bf, onlybf = TRUE)
round(c(BF10 = bf10, BF01 = 1 / bf10), 2)
post <- posterior(bf, iterations = 20000)
round(quantile(post[, "delta"], c(0.025, 0.5, 0.975)), 2)   # mediana i 95% przedział wiarygodności δ
sapply(c(r_0.707 = sqrt(2) / 2, r_1 = 1, r_1.414 = sqrt(2)), function(r)
  round(extractBF(ttestBF(x = kontrola, y = trening, rscale = r), onlybf = TRUE), 2))   # analiza odporności
Wynik w R
 M_kontrola SD_kontrola   M_trening  SD_trening
      44.86        8.05       39.98       10.92

	Two Sample t-test

data:  kontrola and trening
t = 2.5432, df = 98, p-value = 0.01255
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 1.072076 8.687924
sample estimates:
mean of x mean of y
    44.86     39.98

Cohen's d |       95% CI
------------------------
0.51      | [0.11, 0.91]

- Estimated using pooled SD.
BF10 BF01
3.55 0.28
 2.5%   50% 97.5%
 0.07  0.46  0.86
r_0.707     r_1 r_1.414
   3.55    2.97    2.34
Badanie B: dowody na rzecz hipotezy zerowej
R
set.seed(21)
kontrola_b <- round(rnorm(n, mean = 46, sd = 10))
trening_b  <- round(rnorm(n, mean = 46, sd = 10))
t.test(kontrola_b, trening_b, var.equal = TRUE)
bf_b <- extractBF(ttestBF(x = kontrola_b, y = trening_b, rscale = "medium"), onlybf = TRUE)
round(c(BF10 = bf_b, BF01 = 1 / bf_b), 2)
1 / exp(ttest.tstat(t = 0, n1 = 50, n2 = 50, rscale = "medium")$bf)   # największy możliwy BF01 przy 50 + 50 osobach
Wynik w R
	Two Sample t-test

data:  kontrola_b and trening_b
t = 0.55304, df = 98, p-value = 0.5815
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -2.950613  5.230613
sample estimates:
mean of x mean of y
    47.28     46.14

BF10 BF01
0.24 4.14
[1] 4.74369
Ta sama wartość p, różne czynniki Bayesa
R
sapply(c(n_20 = 20, n_50 = 50, n_200 = 200), function(n) {
  t <- qt(1 - 0.04 / 2, df = 2 * n - 2)            # statystyka t dająca dwustronne p = .04
  round(exp(ttest.tstat(t, n1 = n, n2 = n, rscale = "medium")$bf), 2)
})
Wynik w R
 n_20  n_50 n_200
 1.77  1.42  0.85
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()) albo wersję JASP.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- BayesFactor (wersja 0.9.12-4.8): Morey, R. D., & Rouder, J. N. (2026). BayesFactor: Computation of Bayes factors for common designs (R package version 0.9.12-4.8) [Computer software]. https://doi.org/10.32614/CRAN.package.BayesFactor
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Traktowanie BF10 jak prawdopodobieństwa hipotezy – BF10 = 3.55 nie oznacza, że H1 jest prawdziwa z prawdopodobieństwem 78% czy 355%. To stosunek prawdopodobieństw danych; prawdopodobieństwo hipotezy zależy jeszcze od szans a priori (Kass i Raftery, 1995).
- Brak informacji o rozkładzie a priori – bez skali rozkładu Cauchy’ego (albo innego rozkładu) wyniku nie da się powtórzyć ani ocenić. Dołącz analizę odporności (van Doorn i in., 2021).
- Mylenie BF10 i BF01 – zawsze pisz indeks. BF = 0.24 bez indeksu może znaczyć słabe dowody na rzecz H1 albo czterokrotną przewagę H0.
- „Nieistotny” czynnik Bayesa – czynnik Bayesa nie ma progu istotności. BF10 = 1.4 to dowody anegdotyczne, a nie „brak efektu”; do wniosku o braku efektu potrzebujesz BF01 wyraźnie większego od 1.
- Kategorie jako sztywne progi – BF10 = 2.9 i 3.1 to niemal ten sam wynik. Opisuj liczbę, a etykietę traktuj pomocniczo.
- Monitorowanie danych bez planu – możesz sprawdzać BF w trakcie zbierania danych, ale regułę zatrzymania i maksymalną liczebność zapisz z góry, najlepiej w prerejestracji.
Najczęstsze pytania
Co to jest czynnik Bayesa?
To stosunek prawdopodobieństwa danych przy hipotezie alternatywnej do prawdopodobieństwa danych przy hipotezie zerowej: BF10 = p(D | H1) / p(D | H0). Na przykład BF10 = 5 oznacza, że dane są pięć razy bardziej prawdopodobne przy H1 niż przy H0. Odwrotność, BF01, wyraża ten sam wynik na korzyść H0.
Jak interpretować BF10 i BF01?
BF10 większy od 1 przemawia za H1, mniejszy od 1 – za H0; BF01 to jego odwrotność. W skali stosowanej w JASP wartości 1–3 to dowody anegdotyczne, 3–10 – umiarkowane, 10–30 – silne, 30–100 – bardzo silne, a powyżej 100 – skrajne. Kategorie są tylko przybliżonym opisem, a nie sztywnymi progami.
Czym różni się czynnik Bayesa od wartości p?
Wartość p mówi, jak nietypowe byłyby dane przy prawdziwej H0, i nie potrafi wyrazić dowodów na rzecz H0. Czynnik Bayesa porównuje obie hipotezy, więc odróżnia „brak dowodów” od „dowodów na brak efektu”. W przykładzie z hasła wynik p = .013 odpowiadał tylko umiarkowanym dowodom (BF10 = 3.55).
Jaki rozkład a priori wybrać w bayesowskim teście t?
JASP i pakiet BayesFactor przyjmują domyślnie dla wielkości efektu rozkład Cauchy’ego o skali √2/2 ≈ 0.707. Jeśli masz uzasadnione oczekiwania co do wielkości efektu, możesz użyć innego rozkładu, ale go uzasadnij. Zawsze sprawdź, czy wniosek zmienia się przy innych skalach (analiza odporności).
Jak policzyć czynnik Bayesa w JASP albo w R?
W JASP wybierz T-Tests → Bayesian Independent Samples T-Test; program poda BF10, wykres rozkładu a priori i a posteriori oraz analizę odporności. W R użyj funkcji ttestBF() z pakietu BayesFactor, a samą wartość odczytasz funkcją extractBF().
Jak zapisać czynnik Bayesa w APA?
Podaj nazwę testu, rozkład a priori, czynnik Bayesa z indeksem i opis siły dowodów, np. „BF10 = 3.55, dowody umiarkowane”, a przy estymacji – medianę rozkładu a posteriori z 95% przedziałem wiarygodności. Dodaj wynik analizy odporności i nazwę programu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikBezpłatne programy do analizy statystycznej dla studentów i badaczy
Porównanie jamovi, JASP, R i PSPP według rodzaju analiz, powtarzalności, progu wejścia i możliwości oddania kompletnego raportu.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jarosz, A. F., & Wiley, J. (2014). What are the odds? A practical guide to computing and reporting Bayes factors. The Journal of Problem Solving, 7(1), Article 2. https://doi.org/10.7771/1932-6246.1167 ● Otwarty dostęp
- Kass, R. E., & Raftery, A. E. (1995). Bayes factors. Journal of the American Statistical Association, 90(430), 773–795. https://doi.org/10.1080/01621459.1995.10476572
- van Doorn, J., van den Bergh, D., Böhm, U., Dablander, F., Derks, K., Draws, T., Etz, A., Evans, N. J., Gronau, Q. F., Haaf, J. M., Hinne, M., Kucharský, Š., Ly, A., Marsman, M., Matzke, D., Komarlu Narendra Gupta, A. R., Sarafoglou, A., Stefan, A., Voelkel, J. G., & Wagenmakers, E.-J. (2021). The JASP guidelines for conducting and reporting a Bayesian analysis. Psychonomic Bulletin & Review, 28(3), 813–826. https://doi.org/10.3758/s13423-020-01798-5 ● Otwarty dostęp
- Wagenmakers, E.-J., Love, J., Marsman, M., Jamil, T., Ly, A., Verhagen, J., Selker, R., Gronau, Q. F., Dropmann, D., Boutin, B., Meerhoff, F., Knight, P., Raj, A., van Kesteren, E.-J., van Doorn, J., Šmíra, M., Epskamp, S., Etz, A., Matzke, D., . . . Morey, R. D. (2018). Bayesian inference for psychology. Part II: Example applications with JASP. Psychonomic Bulletin & Review, 25(1), 58–76. https://doi.org/10.3758/s13423-017-1323-7 ● Otwarty dostęp
- Wagenmakers, E.-J., Marsman, M., Jamil, T., Ly, A., Verhagen, J., Love, J., Selker, R., Gronau, Q. F., Šmíra, M., Epskamp, S., Matzke, D., Rouder, J. N., & Morey, R. D. (2018). Bayesian inference for psychology. Part I: Theoretical advantages and practical ramifications. Psychonomic Bulletin & Review, 25(1), 35–57. https://doi.org/10.3758/s13423-017-1343-3 ● Otwarty dostęp
Cytowania BibTeX
@article{jarosz2014what, author={Jarosz, Andrew F. and Wiley, Jennifer}, title={{What are the odds? A practical guide to computing and reporting Bayes factors}}, journal={The Journal of Problem Solving}, year={2014}, volume={7}, number={1}, eid={2}, doi={10.7771/1932-6246.1167}}@article{kass1995bayes, author={Kass, Robert E. and Raftery, Adrian E.}, title={{Bayes factors}}, journal={Journal of the American Statistical Association}, year={1995}, volume={90}, number={430}, pages={773--795}, doi={10.1080/01621459.1995.10476572}}@article{vandoorn2021jasp, author={van Doorn, Johnny and van den Bergh, Don and Böhm, Udo and Dablander, Fabian and Derks, Koen and Draws, Tim and Etz, Alexander and Evans, Nathan J. and Gronau, Quentin F. and Haaf, Julia M. and Hinne, Max and Kucharský, Šimon and Ly, Alexander and Marsman, Maarten and Matzke, Dora and Komarlu Narendra Gupta, Akash R. and Sarafoglou, Alexandra and Stefan, Angelika and Voelkel, Jan G. and Wagenmakers, Eric-Jan}, title={{The JASP guidelines for conducting and reporting a Bayesian analysis}}, journal={Psychonomic Bulletin \& Review}, year={2021}, volume={28}, number={3}, pages={813--826}, doi={10.3758/s13423-020-01798-5}}@article{wagenmakers2018bayesianii, author={Wagenmakers, Eric-Jan and Love, Jonathon and Marsman, Maarten and Jamil, Tahira and Ly, Alexander and Verhagen, Josine and Selker, Ravi and Gronau, Quentin F. and Dropmann, Damian and Boutin, Bruno and Meerhoff, Frans and Knight, Patrick and Raj, Akash and van Kesteren, Erik-Jan and van Doorn, Johnny and Šmíra, Martin and Epskamp, Sacha and Etz, Alexander and Matzke, Dora and de Jong, Tim and van den Bergh, Don and Sarafoglou, Alexandra and Steingroever, Helen and Derks, Koen and Rouder, Jeffrey N. and Morey, Richard D.}, title={{Bayesian inference for psychology. Part II: Example applications with JASP}}, journal={Psychonomic Bulletin \& Review}, year={2018}, volume={25}, number={1}, pages={58--76}, doi={10.3758/s13423-017-1323-7}}@article{wagenmakers2018bayesiani, author={Wagenmakers, Eric-Jan and Marsman, Maarten and Jamil, Tahira and Ly, Alexander and Verhagen, Josine and Love, Jonathon and Selker, Ravi and Gronau, Quentin F. and Šmíra, Martin and Epskamp, Sacha and Matzke, Dora and Rouder, Jeffrey N. and Morey, Richard D.}, title={{Bayesian inference for psychology. Part I: Theoretical advantages and practical ramifications}}, journal={Psychonomic Bulletin \& Review}, year={2018}, volume={25}, number={1}, pages={35--57}, doi={10.3758/s13423-017-1343-3}}