Która miara i które okno w SPSS
Gdy dwie osoby kodują te same odpowiedzi albo kilka osób punktuje te same prace, recenzent zapyta o zgodność oceniających. Wybór miary, paradoksy kappy i alfę Krippendorffa omawia poradnik zgodność sędziów: kappa, ICC i alfa, a R – jego przykład. Tutaj zostajemy przy SPSS: które okno, co zaznaczyć i co przepisać z wydruku.
| Oceny | Miara | Okno | Składnia |
|---|---|---|---|
| 2 oceniających, kategorie nominalne | kappa Cohena | Analyze → Descriptive Statistics → Crosstabs → Statistics → Kappa | CROSSTABS /STATISTICS=KAPPA |
| 2 oceniających, kategorie uporządkowane | kappa ważona | Analyze → Scale → Weighted Kappa (od wersji 27) | WEIGHTED KAPPA |
| 3+ oceniających, kategorie nominalne | kappa Fleissa | Analyze → Scale → Reliability Analysis → Statistics | – |
| 2+ oceniających, oceny ilościowe | ICC | Analyze → Scale → Reliability Analysis → Statistics | RELIABILITY /ICC=… |
Ścieżki, nazwy opcji i składnię sprawdziliśmy w dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-d, b.d.-e, b.d.-f). Podajemy je po angielsku, a polskie nazwy – tylko tam, gdzie znaleźliśmy je w polskiej dokumentacji IBM; w polskim interfejsie mogą wyglądać inaczej. Dokumentacja nie wymienia wszystkich nazw kolumn w tabelach wynikowych (np. Asymptotic Standard Error, Approximate T). Odtwarzamy je z typowego wydruku, więc w Twojej wersji mogą się nieco różnić. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego zbioru symulowanego. Troje prowadzących (A, B i C) niezależnie oceniło 80 raportów z ćwiczeń laboratoryjnych:
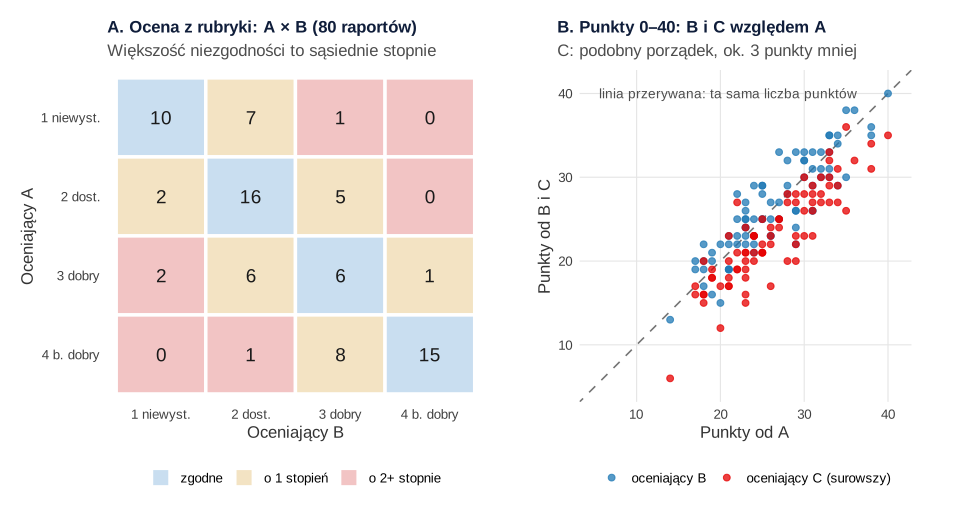
kat_A,kat_B– główny problem raportu według A i B: 1 = metoda, 2 = analiza danych, 3 = wnioski (kategorie nominalne);poz_A,poz_B– ogólna ocena z rubryki: 1 = niewystarczający, 2 = dostateczny, 3 = dobry, 4 = bardzo dobry (kategorie uporządkowane);pkt_A,pkt_B,pkt_C– punkty 0–40 od każdego z trojga oceniających.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS wyjaśnia hasło plik .sav.
Przygotowanie danych
- Jeden wiersz = jeden oceniany obiekt, a każdy oceniający w osobnej kolumnie (format szeroki, zob. format długi i szeroki danych). Oceny jednego raportu od A i B muszą stać w tym samym wierszu.
- Te same kody u obu oceniających. Kappa opiera się na tabeli kwadratowej, w której wiersze i kolumny wyrażają tę samą skalę (IBM Corp., b.d.-a). Jeśli A zapisał „metodę” jako 1, a B jako 3, SPSS policzy kappę z błędnej tabeli i nie ostrzeże.
- Ten sam typ zmiennych. Kappa nie jest liczona, gdy jedna zmienna jest tekstowa, a druga liczbowa; zmienne tekstowe muszą mieć tę samą długość (IBM Corp., b.d.-d). Okno Weighted Kappa też wymaga zmiennych wyłącznie tekstowych albo wyłącznie liczbowych (IBM Corp., b.d.-e). Najprościej zakodować kategorie liczbami z etykietami wartości – zob. przygotowanie danych w SPSS.
- Kategoria, której jeden oceniający nie użył, nie psuje tabeli: komórki z wartością obserwowaną tylko dla jednej zmiennej dostają liczebność 0 (IBM Corp., b.d.-a).
Kappa Cohena w Crosstabs krok po kroku
Pytanie: czy A i B tak samo wskazują główny problem raportu?
- Analyze → Descriptive Statistics → Crosstabs. Przenieś
kat_Ado Row(s), akat_Bdo Column(s). - Statistics: zaznacz Kappa (tak samo w polskiej dokumentacji). Chi-kwadrat nie jest tu potrzebny – sprawdza związek, a nie zgodność.
- Cells: liczebności obserwowane i procent od ogółu (Total). Potem Paste zamiast OK.
| kat_A \ kat_B | metoda | analiza danych | wnioski | Total |
|---|---|---|---|---|
| metoda | 18 | 4 | 5 | 27 |
| analiza danych | 4 | 21 | 4 | 29 |
| wnioski | 7 | 4 | 13 | 24 |
| Total | 29 | 29 | 22 | 80 |
| Value | Asymptotic Standard Error | Approximate T | Approximate Significance | |
|---|---|---|---|---|
| Measure of Agreement – Kappa | .473 | .080 | 5.970 | .000 |
| N of Valid Cases | 80 |
Najpierw sprawdź N i przekątną: A i B zgodzili się w 18 + 21 + 13 = 52 raportach, czyli w 65.0%. Przy takich rozkładach brzegowych przypadek dałby 33.6% zgodności, więc kappa = (.650 − .336)/(1 − .336) = .473 (Cohen, 1960). Approximate T to kappa podzielona przez błąd standardowy liczony przy założeniu hipotezy zerowej, a Sig. = .000 zapisz jako p < .001. Ten test mówi tylko, że zgodność przewyższa przypadkową – do pracy ważniejszy jest przedział ufności. W sprawdzonej dokumentacji okna Crosstabs go nie znaleźliśmy, więc policz go z błędu asymptotycznego: .473 ± 1.96 × .080 = [.316, .629]. Ten sam wzór na błąd (Fleiss i in., 1969) stosuje kalkulator kappy Cohena i testu McNemara – wpisz tam tabelę i porównaj wynik.
Kappa w Crosstabs jest zawsze nieważona: pomyłka „metoda” zamiast „wnioski” waży tyle samo co każda inna. Dla kategorii nominalnych tak ma być. Dla trojga i więcej oceniających użyj kappy Fleissa w oknie Reliability Analysis (IBM Corp., b.d.-c), a nie średniej z kapp dla par.
Kappa ważona – osobne okno od wersji 27
Rubryka 1–4 jest porządkowa: różnica „dobry” – „bardzo dobry” to mniejszy błąd niż „niewystarczający” – „bardzo dobry”. Tę różnicę uwzględnia kappa ważona (Cohen, 1968). Polecenie CROSSTABS jej nie liczy – opis podkomendy STATISTICS jej nie wymienia (IBM Corp., b.d.-d). Służy do tego osobna procedura Analyze → Scale → Weighted Kappa (w polskiej dokumentacji: Analiza → Skala → Ważony współczynnik Kappa). Opis polecenia WEIGHTED KAPPA wskazuje w historii wydań wersję 27.0 (IBM Corp., b.d.-f), a sama procedura zastąpiła wcześniejsze rozszerzenie STATS WEIGHTED KAPPA (IBM Corp., b.d.-e). W starszej wersji SPSS policz kappę ważoną w kalkulatorze albo w R.
- Analyze → Scale → Weighted Kappa. Przenieś
poz_Aipoz_Bdo Pairwise raters (pol. Zmienne oceniające parami). Oceniających w wierszach i kolumnach możesz też wskazać osobno opcją Specify raters for rows and columns (IBM Corp., b.d.-e). - Criteria: wagi liniowe (Cicchetti–Allison) są domyślne, kwadratowe wybierasz sam; poziom asymptotycznego przedziału ufności domyślnie 95% (IBM Corp., b.d.-e).
- Print: zaznacz Display the crosstabulation of rating variables – tabela ocen jest domyślnie wyłączona.
| Wagi | Kappa | Asymptotic Std. Error | z | Sig. | 95% CI Lower | 95% CI Upper |
|---|---|---|---|---|---|---|
| brak (Crosstabs) | .447 | .072 | 7.011 | .000 | .305 | .589 |
| liniowe (domyślne) | .615 | .060 | 7.852 | .000 | .498 | .731 |
| kwadratowe | .756 | .051 | 6.840 | .000 | .657 | .855 |
A i B dali identyczną ocenę tylko w 47 z 80 raportów (58.8%), ale 29 z 33 niezgodności to sąsiednie stopnie (rysunek 1A). Dlatego kappa ważona jest wyższa od nieważonej, a kwadratowa – od liniowej: kwadrat odległości karze bliskie pomyłki jeszcze łagodniej. Wagi wybierz przed analizą i nazwij w opisie. W Criteria wybierasz jeden rodzaj wag, więc drugi wymaga ponownego uruchomienia. Wzory wag i ich wybór omawia hasło kappa ważona.
ICC w Reliability Analysis krok po kroku
Pytanie: czy troje oceniających przyznaje raportom tyle samo punktów? Średnie: A – 26.41, B – 26.55, C – 23.21. C jest surowszy, ale porządek raportów ma podobny (rysunek 1B).
- Analyze → Scale → Reliability Analysis (pol. Analiza → Skala → Analiza rzetelności). Przenieś
pkt_A,pkt_Bipkt_Cdo Items – tu „pozycjami” są oceniający. - Statistics (pol. Statystyki): zaznacz Intraclass correlation coefficient (pol. Współczynnik korelacji wewnątrzklasowej).
- Model: Two-Way Random, gdy oceniający są próbą z szerszej grupy, na którą uogólniasz wynik; Two-Way Mixed, gdy interesują Cię tylko ci konkretni oceniający; One-Way Random, gdy każdy obiekt oceniali inni oceniający (IBM Corp., b.d.-c).
- Type: Absolute Agreement (pol. Bezwzględna zgodność), gdy liczy się ta sama liczba punktów; Consistency (pol. Spójność), gdy wystarczy ten sam porządek. Zostaw Confidence interval 95% i Test value 0, potem Paste.
Uwaga na ustawienia domyślne: według opisu składni bez jawnego wyboru SPSS liczy model mieszany i typ spójności (IBM Corp., b.d.-b). Przy ocenach punktowych zwykle to nie jest to, o co pyta recenzent. Tak samo ustawiony ICC we wpisie alfa Cronbacha w SPSS służy do rzetelności skali, a nie do zgodności oceniających.
| Model i typ w oknie | Składnia /ICC= | McGraw i Wong: miara pojedyncza / średnia | Shrout i Fleiss |
|---|---|---|---|
| One-Way Random | MODEL(ONEWAY) | ICC(1) / ICC(k) | ICC(1,1) / ICC(1,k) |
| Two-Way Random, Absolute Agreement | MODEL(RANDOM) TYPE(ABSOLUTE) | ICC(A,1) / ICC(A,k) | ICC(2,1) / ICC(2,k) |
| Two-Way Random, Consistency | MODEL(RANDOM) TYPE(CONSISTENCY) | ICC(C,1) / ICC(C,k) | brak odpowiednika |
| Two-Way Mixed, Consistency | MODEL(MIXED) TYPE(CONSISTENCY) | ICC(C,1) / ICC(C,k) | ICC(3,1) / ICC(3,k) |
| Two-Way Mixed, Absolute Agreement | MODEL(MIXED) TYPE(ABSOLUTE) | ICC(A,1) / ICC(A,k) | brak odpowiednika |
Shrout i Fleiss (1979) opisali sześć form, McGraw i Wong (1996) – dziesięć, i to ich rozróżnienie modelu i typu odpowiada oknu SPSS. Modele losowy i mieszany dają tę samą liczbę; różni je to, na kogo wolno uogólnić wynik. W wierszu z „brakiem odpowiednika” w pracy podaj nazwę według McGrawa i Wonga. Formy i wzory ze średnich kwadratów wyjaśnia hasło ICC.
| Intraclass Correlation | 95% CI Lower Bound | 95% CI Upper Bound | F Test with True Value 0: Value | df1 | df2 | Sig | |
|---|---|---|---|---|---|---|---|
| Single Measures | .797 | .508 | .901 | 23.589 | 79 | 158 | .000 |
| Average Measures | .922 | .756 | .965 | 23.589 | 79 | 158 | .000 |
Single Measures to rzetelność oceny jednego oceniającego, Average Measures – średniej z trojga. Do pracy weź wiersz zgodny z tym, jak wynik będzie używany: jeśli dalej każdy raport oceni jedna osoba, raportuj miarę pojedynczą (Koo i Li, 2016). Test F sprawdza tylko, czy ICC różni się od 0, więc ważniejszy jest przedział ufności. Jego dolna granica (.508) jest tu niska, bo C systematycznie zaniża punkty.
| Ustawienia | Single Measures [95% CI] | Average Measures [95% CI] | F (df1, df2) |
|---|---|---|---|
| Two-Way Random, Absolute Agreement | .797 [.508, .901] | .922 [.756, .965] | 23.589 (79, 158) |
| Two-Way Mixed, Consistency | .883 [.836, .919] | .958 [.939, .971] | 23.589 (79, 158) |
| One-Way Random | .790 [.714, .852] | .919 [.882, .945] | 12.284 (79, 160) |
| Tylko A i B: Two-Way Random, Absolute Agreement | .882 [.822, .923] | .937 [.902, .960] | 15.770 (79, 79) |
Spójność (.883) pomija przesunięcie oceniającego C, a zgodność bezwzględna (.797) je karze. Bez C zgodność bezwzględna rośnie do .882. Różnica między typami to wskazówka, że któryś oceniający punktuje systematycznie inaczej – sprawdź średnie w kolumnach. Taki oceniający wymaga ponownego szkolenia, a nie innego ICC. Plan badania powtarzalności, SEM i wykres Blanda–Altmana opisuje wpis badanie rzetelności pomiaru klinicznego, a formy ICC dla innych danych przeliczysz w kalkulatorze ICC.
Zapis wyników w stylu APA
Podaj liczbę obiektów i oceniających, procent zgodności, rodzaj wag albo pełną nazwę formy ICC i przedział ufności. Wzory:
Opisy innych analiz przygotuje generator opisu wyników APA, a test do hipotezy podpowie kreator doboru testu.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu poleceń CROSSTABS, WEIGHTED KAPPA i RELIABILITY w Command Syntax Reference (IBM Corp., b.d.-b, b.d.-d, b.d.-f), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel: kappę i kappę ważoną z błędami Fleissa, Cohena i Everitta oraz ICC ze średnich kwadratów ANOVA z przedziałami McGrawa i Wonga, z kontrolą w pakietach DescTools i psych.
1. Składnia SPSS: CROSSTABS, WEIGHTED KAPPA i RELIABILITY
SPSS
* Zgodność oceniających: 80 raportów, oceniający A, B i C.
* Składnia zgodna z opisem CROSSTABS, WEIGHTED KAPPA i RELIABILITY w Command Syntax Reference; nie była uruchamiana w SPSS.

* 1. Kappa Cohena: główny problem raportu (kategorie nominalne).
CROSSTABS
  /TABLES=kat_A BY kat_B
  /STATISTICS=KAPPA
  /CELLS=COUNT TOTAL.

* 2. Kappa ważona: ocena z rubryki 1–4 (SPSS 27 lub nowszy), wagi liniowe i kwadratowe.
WEIGHTED KAPPA poz_A BY poz_B
  /CRITERIA ASYMPTOTICCILEVEL=95 WEIGHTING=LINEAR
  /PRINT TABULATION(ALL).
WEIGHTED KAPPA poz_A BY poz_B
  /CRITERIA ASYMPTOTICCILEVEL=95 WEIGHTING=QUADRATIC.

* 3. ICC: punkty 0–40, model dwuczynnikowy losowy, zgodność bezwzględna.
RELIABILITY
  /VARIABLES=pkt_A pkt_B pkt_C
  /SCALE(PUNKTY)=ALL
  /MODEL=ALPHA
  /ICC=MODEL(RANDOM) TYPE(ABSOLUTE) CIN=95 TESTVAL=0.

* Dla porównania: model mieszany, spójność.
RELIABILITY
  /VARIABLES=pkt_A pkt_B pkt_C
  /SCALE(PUNKTY)=ALL
  /MODEL=ALPHA
  /ICC=MODEL(MIXED) TYPE(CONSISTENCY) CIN=95 TESTVAL=0.
2. Te same liczby w R i pliki .sav oraz CSV
R
# B311 – kappa Cohena, kappa ważona i ICC w SPSS: liczby do tabel w układzie SPSS
# Dane symulowane, set.seed(3110): 80 raportów z ćwiczeń laboratoryjnych oceniło niezależnie troje
# prowadzących (A, B, C). A i B przypisali raportowi główny problem (kategorie nominalne) i ogólną ocenę
# z rubryki 1–4 (kategorie porządkowe); A, B i C przyznali punkty 0–40. Oceniający C punktuje surowiej.
# Metody jak w SPSS: kappa z tabeli kwadratowej z asymptotycznym błędem standardowym
# (Fleiss i in., 1969) i T = kappa / błąd przy H0; kappa ważona z wagami liniowymi (domyślne) i kwadratowymi;
# ICC ze średnich kwadratów dwuczynnikowej ANOVA (raport × oceniający) z testem F i przedziałami
# McGrawa i Wonga (1996); kontrola: psych::ICC() i DescTools::CohenKappa().
suppressPackageStartupMessages({ library(haven); library(psych); library(DescTools) })
set.seed(3110)
n <- 80
# 1. główny problem raportu: 1 = metoda, 2 = analiza danych, 3 = wnioski
prawda <- sample(1:3, n, replace = TRUE, prob = c(.40, .35, .25))
ocen_kat <- function(traf) ifelse(runif(n) < traf, prawda, sapply(prawda, function(k) sample(setdiff(1:3, k), 1)))
kat_A <- ocen_kat(.85); kat_B <- ocen_kat(.80)
# 2. ogólna ocena z rubryki: 1 = niewystarczający, 2 = dostateczny, 3 = dobry, 4 = bardzo dobry
jakosc <- rnorm(n)
progi <- c(-Inf, -0.9, 0.1, 1.0, Inf)
poz_A <- as.integer(cut(jakosc + rnorm(n, 0, .45), progi))
poz_B <- as.integer(cut(jakosc + rnorm(n, 0, .45), progi))
# 3. punkty 0–40 od trojga oceniających; C przyznaje średnio ok. 3 punkty mniej
wynik <- 26 + 5 * jakosc
ogr <- function(x) pmin(40, pmax(0, round(x)))
pkt_A <- ogr(wynik + rnorm(n, 0, 2)); pkt_B <- ogr(wynik + 0.5 + rnorm(n, 0, 2)); pkt_C <- ogr(wynik - 3 + rnorm(n, 0, 2))
dane <- data.frame(id = 1:n, kat_A, kat_B, poz_A, poz_B, pkt_A, pkt_B, pkt_C)

# Krok 1. Plik .sav z etykietami zmiennych i wartości – i ten sam zbiór w CSV
sav <- dane
et_kat <- c("metoda" = 1, "analiza danych" = 2, "wnioski" = 3)
et_poz <- c("niewystarczający" = 1, "dostateczny" = 2, "dobry" = 3, "bardzo dobry" = 4)
for (v in c("kat_A", "kat_B")) sav[[v]] <- labelled(sav[[v]], labels = et_kat)
for (v in c("poz_A", "poz_B")) sav[[v]] <- labelled(sav[[v]], labels = et_poz)
etykiety <- c(id = "Numer raportu", kat_A = "Główny problem – oceniający A", kat_B = "Główny problem – oceniający B",
              poz_A = "Ocena z rubryki 1–4 – oceniający A", poz_B = "Ocena z rubryki 1–4 – oceniający B",
              pkt_A = "Punkty 0–40 – oceniający A", pkt_B = "Punkty 0–40 – oceniający B", pkt_C = "Punkty 0–40 – oceniający C")
for (v in names(etykiety)) attr(sav[[v]], "label") <- etykiety[[v]]
for (v in names(sav)) attr(sav[[v]], "format.spss") <- "F2.0"
write_sav(sav, "../kappa-icc-spss-dane.sav")
write.csv(dane, "../kappa-icc-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
sapply(read_sav("../kappa-icc-spss-dane.sav"), function(x) names(attributes(x)))   # tylko etykiety i format

# Funkcja: kappa (ważona albo nie) z błędami standardowymi Fleissa, Cohena i Everitta (1969)
kappa_spss <- function(a, b, k, wagi = c("brak", "liniowe", "kwadratowe")) {
  wagi <- match.arg(wagi)
  tab <- table(factor(a, 1:k), factor(b, 1:k)); N <- sum(tab); p <- tab / N
  w <- switch(wagi, brak = diag(k),
              liniowe = 1 - abs(outer(1:k, 1:k, "-")) / (k - 1),
              kwadratowe = 1 - (outer(1:k, 1:k, "-"))^2 / (k - 1)^2)
  pr <- rowSums(p); pc <- colSums(p)
  po <- sum(w * p); pe <- sum(w * outer(pr, pc)); kap <- (po - pe) / (1 - pe)
  wr <- as.vector(w %*% pc); wc <- as.vector(t(w) %*% pr)      # średnie wagi wiersza i kolumny
  sk <- outer(wr, wc, "+")
  var1 <- (sum(p * (w * (1 - pe) - sk * (1 - po))^2) - (po * pe - 2 * pe + po)^2) / (N * (1 - pe)^4)
  var0 <- (sum(outer(pr, pc) * (w - sk)^2) - pe^2) / (N * (1 - pe)^2)
  se <- sqrt(var1); se0 <- sqrt(var0); z <- kap / se0
  c(N = N, po = po, pe = pe, kappa = kap, ase = se, T_z = z, p = 2 * pnorm(-abs(z)),
    ci_dol = kap - qnorm(.975) * se, ci_gor = kap + qnorm(.975) * se)
}

# Krok 2. Crosstabs: kat_A × kat_B – tabela krzyżowa i Symmetric Measures (Kappa)
table(kat_A = dane$kat_A, kat_B = dane$kat_B)
k1 <- kappa_spss(dane$kat_A, dane$kat_B, 3)
round(k1, 3)
format.pval(k1[["p"]], digits = 3)
print(CohenKappa(dane$kat_A, dane$kat_B, conf.level = .95), digits = 4)   # kontrola: ten sam błąd standardowy

# Krok 3. Weighted Kappa: poz_A i poz_B, wagi liniowe (domyślne w SPSS) i kwadratowe
table(poz_A = dane$poz_A, poz_B = dane$poz_B)
kw <- rbind(nieważona = kappa_spss(dane$poz_A, dane$poz_B, 4),
            liniowe = kappa_spss(dane$poz_A, dane$poz_B, 4, "liniowe"),
            kwadratowe = kappa_spss(dane$poz_A, dane$poz_B, 4, "kwadratowe"))
round(kw, 3)
format.pval(kw[, "p"], digits = 3)
tab_poz <- table(factor(dane$poz_A, 1:4), factor(dane$poz_B, 1:4))
print(CohenKappa(tab_poz, weights = "Equal-Spacing", conf.level = .95), digits = 4)   # kontrola: wagi liniowe
print(CohenKappa(tab_poz, weights = "Fleiss-Cohen", conf.level = .95), digits = 4)    # kontrola: wagi kwadratowe

# Krok 4. ICC: średnie kwadraty z ANOVA raport × oceniający (pkt_A, pkt_B, pkt_C)
X <- as.matrix(dane[, c("pkt_A", "pkt_B", "pkt_C")]); k <- ncol(X)
round(colMeans(X), 2)
sr <- mean(X)
SSR <- k * sum((rowMeans(X) - sr)^2); SSC <- n * sum((colMeans(X) - sr)^2)
SST <- sum((X - sr)^2); SSE <- SST - SSR - SSC; SSW <- SST - SSR
MSR <- SSR / (n - 1); MSC <- SSC / (k - 1); MSE <- SSE / ((n - 1) * (k - 1)); MSW <- SSW / (n * (k - 1))
round(c(MSR = MSR, MSC = MSC, MSE = MSE, MSW = MSW), 3)

# Wzory McGrawa i Wonga (1996) – miara pojedyncza i średnia, przedziały 95%, test F przy wartości testowej 0
icc_spss <- function(model = c("ONEWAY", "RANDOM", "MIXED"), typ = c("CONSISTENCY", "ABSOLUTE"), alfa = .05) {
  model <- match.arg(model); typ <- match.arg(typ)
  if (model == "ONEWAY") {
    F0 <- MSR / MSW; df1 <- n - 1; df2 <- n * (k - 1)
    FL <- F0 / qf(1 - alfa / 2, df1, df2); FU <- F0 * qf(1 - alfa / 2, df2, df1)
    poj <- c((MSR - MSW) / (MSR + (k - 1) * MSW), (FL - 1) / (FL + k - 1), (FU - 1) / (FU + k - 1))
    sre <- c((MSR - MSW) / MSR, 1 - 1 / FL, 1 - 1 / FU)
  } else if (typ == "CONSISTENCY") {
    F0 <- MSR / MSE; df1 <- n - 1; df2 <- (n - 1) * (k - 1)
    FL <- F0 / qf(1 - alfa / 2, df1, df2); FU <- F0 * qf(1 - alfa / 2, df2, df1)
    poj <- c((MSR - MSE) / (MSR + (k - 1) * MSE), (FL - 1) / (FL + k - 1), (FU - 1) / (FU + k - 1))
    sre <- c((MSR - MSE) / MSR, 1 - 1 / FL, 1 - 1 / FU)
  } else {
    F0 <- MSR / MSE; df1 <- n - 1; df2 <- (n - 1) * (k - 1)
    r1 <- (MSR - MSE) / (MSR + (k - 1) * MSE + k * (MSC - MSE) / n)
    a <- k * r1 / (n * (1 - r1)); b <- 1 + k * r1 * (n - 1) / (n * (1 - r1))
    v <- (a * MSC + b * MSE)^2 / ((a * MSC)^2 / (k - 1) + (b * MSE)^2 / ((n - 1) * (k - 1)))
    Fs <- qf(1 - alfa / 2, n - 1, v); Fs2 <- qf(1 - alfa / 2, v, n - 1)
    lo <- n * (MSR - Fs * MSE) / (Fs * (k * MSC + (k * n - k - n) * MSE) + n * MSR)
    up <- n * (Fs2 * MSR - MSE) / (k * MSC + (k * n - k - n) * MSE + n * Fs2 * MSR)
    poj <- c(r1, lo, up)
    sre <- c((MSR - MSE) / (MSR + (MSC - MSE) / n), k * lo / (1 + (k - 1) * lo), k * up / (1 + (k - 1) * up))
  }
  out <- rbind(single = c(poj, F0, df1, df2), average = c(sre, F0, df1, df2))
  colnames(out) <- c("ICC", "lower", "upper", "F", "df1", "df2")
  cbind(round(out, 3), p = signif(pf(F0, df1, df2, lower.tail = FALSE), 3))
}
cat("\nTwo-Way Random, Absolute Agreement\n"); print(icc_spss("RANDOM", "ABSOLUTE"))
cat("\nTwo-Way Mixed, Consistency\n");        print(icc_spss("MIXED", "CONSISTENCY"))
cat("\nOne-Way Random\n");                    print(icc_spss("ONEWAY"))
# kontrola: psych::ICC (ICC1 = One-Way, ICC2 = absolutna zgodność, ICC3 = spójność; k = miara średnia)
print(psych::ICC(X, lmer = FALSE)$results[, c("type", "ICC", "F", "df1", "df2", "p", "lower bound", "upper bound")], digits = 3)

# Krok 5. Te same oceny bez oceniającego C: przesunięcie C obniżało zgodność bezwzględną
X <- X[, 1:2]; k <- 2; sr <- mean(X)
SSR <- k * sum((rowMeans(X) - sr)^2); SSC <- n * sum((colMeans(X) - sr)^2)
SSE <- sum((X - sr)^2) - SSR - SSC
MSR <- SSR / (n - 1); MSC <- SSC / (k - 1); MSE <- SSE / ((n - 1) * (k - 1))
cat("\nA i B: Two-Way Random, Absolute Agreement\n"); print(icc_spss("RANDOM", "ABSOLUTE"))
Wynik w R
$id
[1] "label"       "format.spss"

$kat_A
[1] "label"       "format.spss" "class"       "labels"

$kat_B
[1] "label"       "format.spss" "class"       "labels"

$poz_A
[1] "label"       "format.spss" "class"       "labels"

$poz_B
[1] "label"       "format.spss" "class"       "labels"

$pkt_A
[1] "label"       "format.spss"

$pkt_B
[1] "label"       "format.spss"

$pkt_C
[1] "label"       "format.spss"

     kat_B
kat_A  1  2  3
    1 18  4  5
    2  4 21  4
    3  7  4 13
     N     po     pe  kappa    ase    T_z      p ci_dol ci_gor
80.000  0.650  0.336  0.473  0.080  5.970  0.000  0.316  0.629
[1] "2.37e-09"
 kappa lwr.ci upr.ci
0.4727 0.3164 0.6289
     poz_B
poz_A  1  2  3  4
    1 10  7  1  0
    2  2 16  5  0
    3  2  6  6  1
    4  0  1  8 15
            N    po    pe kappa   ase   T_z p ci_dol ci_gor
nieważona  80 0.588 0.254 0.447 0.072 7.011 0  0.305  0.589
liniowe    80 0.846 0.600 0.615 0.060 7.852 0  0.498  0.731
kwadratowe 80 0.937 0.744 0.756 0.051 6.840 0  0.657  0.855
[1] "2.36e-12" "4.09e-15" "7.94e-12"
 kappa lwr.ci upr.ci
0.6146 0.4978 0.7313
 kappa lwr.ci upr.ci
0.7558 0.6567 0.8548
pkt_A pkt_B pkt_C
26.41 26.55 23.21
    MSR     MSC     MSE     MSW
 90.184 285.304   3.823   7.342

Two-Way Random, Absolute Agreement
          ICC lower upper      F df1 df2        p
single  0.797 0.508 0.901 23.589  79 158 2.36e-58
average 0.922 0.756 0.965 23.589  79 158 2.36e-58

Two-Way Mixed, Consistency
          ICC lower upper      F df1 df2        p
single  0.883 0.836 0.919 23.589  79 158 2.36e-58
average 0.958 0.939 0.971 23.589  79 158 2.36e-58

One-Way Random
          ICC lower upper      F df1 df2        p
single  0.790 0.714 0.852 12.284  79 160 7.84e-40
average 0.919 0.882 0.945 12.284  79 160 7.84e-40
                         type   ICC    F df1 df2        p lower bound upper bound
Single_raters_absolute   ICC1 0.790 12.3  79 160 7.84e-40       0.714       0.852
Single_random_raters     ICC2 0.797 23.6  79 158 2.36e-58       0.508       0.901
Single_fixed_raters      ICC3 0.883 23.6  79 158 2.36e-58       0.836       0.919
Average_raters_absolute ICC1k 0.919 12.3  79 160 7.84e-40       0.882       0.945
Average_random_raters   ICC2k 0.922 23.6  79 158 2.36e-58       0.756       0.965
Average_fixed_raters    ICC3k 0.958 23.6  79 158 2.36e-58       0.939       0.971

A i B: Two-Way Random, Absolute Agreement
          ICC lower upper     F df1 df2        p
single  0.882 0.822 0.923 15.77  79  79 1.15e-27
average 0.937 0.902 0.960 15.77  79  79 1.15e-27
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. Składni SPSS nie uruchamialiśmy. W pracy podaj wersję programu, którego faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Typowe błędy
- Chi-kwadrat zamiast kappy. Silny związek w tabeli krzyżowej nie oznacza zgodności – oceniający może konsekwentnie mylić dwie kategorie.
- Zwykła kappa dla skali porządkowej albo kappa ważona bez podania wag. W wersji 27 i nowszej użyj Weighted Kappa i napisz, czy wagi były liniowe, czy kwadratowe.
- ICC z ustawień domyślnych (model mieszany, spójność) przy pytaniu o tę samą liczbę punktów – i „ICC = .96” bez nazwy formy. Podaj model, typ i to, czy to miara pojedyncza, czy średnia.
- Same oceny bez przedziału ufności. Przy 80 obiektach przedział ICC(A,1) sięgał od .51 do .90 – to inny wniosek niż sama wartość .80.
- „Sig. = .000” jako dowód dobrej zgodności. Test sprawdza tylko różnicę od zera (zob. wartość p).
Z serii SPSS zob. też chi-kwadrat w SPSS (to samo okno Crosstabs), testy nieparametryczne w SPSS i korelację i regresję w SPSS.
Najczęstsze pytania
Gdzie w SPSS jest kappa Cohena?
W oknie Analyze → Descriptive Statistics → Crosstabs: oceny pierwszego oceniającego w Row(s), drugiego w Column(s), a w Statistics zaznacz Kappa. Wynik jest w tabeli Symmetric Measures. Kody kategorii i typ zmiennych muszą być u obu oceniających takie same, bo kappa wymaga tabeli kwadratowej z tą samą skalą w wierszach i kolumnach.
Czy SPSS liczy kappę ważoną?
Tak, od wersji 27 w osobnym oknie Analyze → Scale → Weighted Kappa (polecenie WEIGHTED KAPPA), z wagami liniowymi (domyślnie) albo kwadratowymi i asymptotycznym przedziałem ufności. Kappa w Crosstabs jest zawsze nieważona. W starszej wersji policz kappę ważoną w kalkulatorze albo w R.
Jaki model i typ ICC wybrać w SPSS przy ocenach kilku sędziów?
Two-Way Random, gdy oceniający są próbą z szerszej grupy, Two-Way Mixed, gdy interesują Cię tylko ci konkretni, i One-Way Random, gdy każdy obiekt oceniali inni ludzie. Typ Absolute Agreement wybierz, gdy liczy się ta sama liczba punktów, a Consistency – gdy wystarczy ten sam porządek. Domyślne ustawienia składni to model mieszany i spójność.
Single Measures czy Average Measures – który wiersz ICC przepisać?
Single Measures opisuje rzetelność oceny jednego oceniającego, a Average Measures – średniej z wszystkich oceniających. Raportuj ten wiersz, który odpowiada temu, jak wynik będzie używany: jeśli w badaniu właściwym każdy obiekt oceni jedna osoba, podaj miarę pojedynczą. W przykładzie było to .80 wobec .92 dla średniej z trojga.
Jak nazwać ICC z SPSS w pracy?
Podaj model, typ i rodzaj miary, np. dwuczynnikowy model losowy, zgodność bezwzględna, pojedynczy oceniający – ICC(A,1) według McGrawa i Wonga, czyli ICC(2,1) według Shrouta i Fleissa. Model mieszany ze spójnością to ICC(C,1) albo ICC(3,1). Dopisz 95% przedział ufności, a test F względem zera traktuj jako informację dodatkową.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikKalkulator kappy Cohena i testu McNemara
Kappa Cohena i kappa ważona z przedziałem ufności dla dwóch oceniających oraz test McNemara w czterech wersjach z przedziałem dla różnicy odsetków.
Czytaj →PoradnikKalkulator ICC i efektu schematu
ICC z modelu pustego, ANOVA lub wyniku binarnego, efekt schematu z poprawką na nierówne grupy i liczba grup potrzebna w badaniu klastrowym.
Czytaj →Masz oceny kilku sędziów w SPSS i nie wiesz, którą miarę zgodności podać?
Sprawdzimy układ danych, wybór kappy albo formy ICC, ustawienia w SPSS i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Fleiss, J. L., Cohen, J., & Everitt, B. S. (1969). Large sample standard errors of kappa and weighted kappa. Psychological Bulletin, 72(5), 323–327. https://doi.org/10.1037/h0028106
- IBM Corp. (b.d.-a). Crosstabs statistics. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=crosstabs-statistics ● Otwarty dostęp
- IBM Corp. (b.d.-b). ICC subcommand (RELIABILITY command). IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/base/syn_reliability_icc.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Reliability Analysis statistics. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=analysis-reliability-statistics ● Otwarty dostęp
- IBM Corp. (b.d.-d). STATISTICS subcommand (CROSSTABS command). IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/base/syn_crosstabs_statistics.html ● Otwarty dostęp
- IBM Corp. (b.d.-e). Weighted Kappa. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-weighted-kappa ● Otwarty dostęp
- IBM Corp. (b.d.-f). WEIGHTED KAPPA. IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-weighted-kappa ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- McGraw, K. O., & Wong, S. P. (1996). Forming inferences about some intraclass correlation coefficients. Psychological Methods, 1(1), 30–46. https://doi.org/10.1037/1082-989X.1.1.30
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
Cytowania BibTeX
@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{cohen1968weighted, author={Cohen, Jacob}, title={{Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={4}, pages={213--220}, doi={10.1037/h0026256}}@article{fleiss1969large, author={Fleiss, Joseph L. and Cohen, Jacob and Everitt, B. S.}, title={{Large sample standard errors of kappa and weighted kappa}}, journal={Psychological Bulletin}, year={1969}, volume={72}, number={5}, pages={323--327}, doi={10.1037/h0028106}}@misc{ibmndcrosstabsstat32kappa, author={{IBM Corp.}}, title={{Crosstabs statistics}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=crosstabs-statistics}}@misc{ibmndreliabilityicc32, author={{IBM Corp.}}, title={{ICC subcommand (RELIABILITY command)}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/base/syn_reliability_icc.html}}@misc{ibmndreliabilitystat32, author={{IBM Corp.}}, title={{Reliability Analysis statistics}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=analysis-reliability-statistics}}@misc{ibmndcrosstabsstatsyntax32, author={{IBM Corp.}}, title={{STATISTICS subcommand (CROSSTABS command)}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/base/syn_crosstabs_statistics.html}}@misc{ibmndweightedkappa32, author={{IBM Corp.}}, title={{Weighted Kappa}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-weighted-kappa}}@misc{ibmndweightedkappasyntax32, author={{IBM Corp.}}, title={{WEIGHTED KAPPA}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-f}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-weighted-kappa}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{mcgraw1996forming, author={McGraw, Kenneth O. and Wong, S. P.}, title={{Forming inferences about some intraclass correlation coefficients}}, journal={Psychological Methods}, year={1996}, volume={1}, number={1}, pages={30--46}, doi={10.1037/1082-989x.1.1.30}}@article{shrout1979intraclass, author={Shrout, Patrick E. and Fleiss, Joseph L.}, title={{Intraclass correlations: Uses in assessing rater reliability}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={2}, pages={420--428}, doi={10.1037/0033-2909.86.2.420}}