Lista kontrolna: co dokładnie zapisujesz
Czy personel przestrzega procedury? Ankietą trudno to rzetelnie zbadać. Haas i Larson (2007) w przeglądzie metod pomiaru przestrzegania higieny rąk wymieniają trzy podejścia: obserwację bezpośrednią, samoopis personelu i pomiar pośredni, np. zużycia środka do dezynfekcji. Żadne nie jest standardem. Ten wpis dotyczy pierwszego: obserwatorka z listą kontrolną przy każdej sytuacji, która wymaga procedury, zaznacza, czy ją wykonano.
Ogólne zasady obserwacji systematycznej (kategorie, próbkowanie, szkolenie obserwatorów, reaktywność) opisuje wpis obserwacja jako metoda badawcza. Tu skupiamy się na tym, co specyficzne dla list kontrolnych: jednostce obserwacji, przedziale ufności dla odsetka, efekcie Hawthorne'a, zgodności obserwatorów i porównaniu przed–po.
Przykładem jest higiena rąk. Sax i in. (2007) opisali koncepcję „pięciu momentów higieny rąk”. Wyznacza ona w przebiegu opieki punkty, w których higiena rąk jest wymagana, i ma dawać wspólny obraz szkolącym, obserwatorom i personelowi. W skrócie są to momenty przed kontaktem z pacjentem, przed czynnością aseptyczną, po kontakcie z płynami ustrojowymi, po kontakcie z pacjentem i po kontakcie z jego otoczeniem. Dokładne definicje i formularz obserwacji weź z oficjalnych materiałów, na których opiera się Twój szpital lub promotor. Nie układaj ich sam z pamięci. Ta sama logika działa dla innych procedur, np. identyfikacji pacjenta przed podaniem leku.
Najważniejsze pojęcie to okazja (ang. opportunity): sytuacja, w której procedura powinna zostać wykonana. Lista kontrolna ma wtedy prostą strukturę. Jeden wiersz to jedna okazja, a kolumny opisują, kto, gdzie, który moment i czy wykonano. To operacjonalizacja „przestrzegania” na poziomie zachowania.
| Kolumna | Co wpisujesz | Uwagi |
|---|---|---|
| sesja, data, godzina, obserwator | np. S07, 2026-03-12, 10:20–10:40, A | pozwala sprawdzić porę dnia, dzień tygodnia i obserwatora |
| oddział | kod oddziału | poziom skupienia (klaster wyższego rzędu) |
| osoba | kod osoby i grupa zawodowa, bez nazwiska | poziom skupienia; bez kodu osoby nie policzysz poprawnego CI |
| moment | M1–M5 według definicji z instrukcji | gdy kilka momentów zbiega się w jednej chwili, reguła z instrukcji mówi, jak to liczyć |
| działanie | dezynfekcja / mycie / brak | wynik do analizy: wykonano (1) albo nie (0) |
| uwagi | np. widoczność ograniczona, sytuacja nagła | reguły wykluczeń ustal przed audytem |
W arkuszu wpisuj kody osób, a listę kodów przechowuj osobno (świadoma zgoda i RODO). Przed audytem właściwym przeprowadź badanie pilotażowe arkusza: kilka sesji, w których sprawdzasz, czy definicje momentów dają się stosować w praktyce.
Jednostka obserwacji: okazja w osobie, osoba w oddziale
Wynik audytu to zwykle odsetek przestrzegania: liczba okazji, w których wykonano procedurę, podzielona przez liczbę wszystkich zaobserwowanych okazji. Mianownikiem są okazje, nie osoby. Problem w tym, że okazje nie są niezależne. Dziesięć okazji jednej pielęgniarki to dziesięć obserwacji tej samej osoby z jej nawykami. Osoby z jednego oddziału dzielą zespół, obciążenie pracą i dostęp do dozowników. Dane mają więc strukturę zagnieżdżoną: okazja w osobie, osoba w oddziale.
Jeśli policzysz przedział ufności tak, jakby 400 okazji pochodziło od 400 różnych osób, przedział wyjdzie za wąski. To ten sam błąd, który w badaniach eksperymentalnych nazywa się pseudoreplikacją. Skalę problemu opisuje efekt schematu (ang. design effect, deff), czyli iloraz wariancji oszacowania przy danych skupionych do wariancji przy próbie prostej o tej samej liczebności. Przy klastrach równej wielkości:
Tu m to liczba okazji na osobę, a ρ to korelacja wewnątrzklasowa (ICC), czyli to, jak bardzo okazje tej samej osoby są do siebie podobne. Killip i in. (2004) pokazują, że to ρ razem z wielkością i liczbą klastrów wyznacza efektywną liczebność próby. Pokazują też, że więcej klastrów podnosi precyzję skuteczniej niż więcej obserwacji w klastrze. Dla audytu wynika z tego praktyczna rada: lepiej obserwować więcej osób po kilka okazji niż kilka osób po wiele okazji. Wzór dla klastrów różnej wielkości jest bardziej złożony, a nierówne klastry zwiększają deff. Dlatego w przykładzie liczymy deff wprost z błędów standardowych.
Przykład: 400 okazji, 40 osób, 4 oddziały
Studentka pielęgniarstwa przeprowadziła audyt na czterech oddziałach (internistycznym, chirurgicznym, pediatrycznym i geriatrycznym), po 10 osób personelu na każdym. Zaobserwowała 400 okazji, od 3 do 19 na osobę (mediana 10). Dane są symulowane, a liczby niżej pochodzą z przepisu 1 w sekcji z kodem. W 220 okazjach procedurę wykonano, więc odsetek przestrzegania wynosi 55.0%.
- Naiwny 95% CI Wilsona (400 niezależnych okazji): [50.1%, 59.8%].
- 95% CI uwzględniający skupienie okazji w osobach: [45.9%, 63.8%].
Drugi przedział jest prawie dwa razy szerszy. Efekt schematu wynosi deff = 3.17, więc 400 okazji niesie tyle informacji o odsetku przestrzegania, ile około 126 niezależnych okazji. W modelu mieszanym odchylenie standardowe „nawyku” osoby na skali logitu wyniosło 0.979, a ICC na skali latentnej .226. To wystarczy, żeby naiwny przedział wprowadzał w błąd.
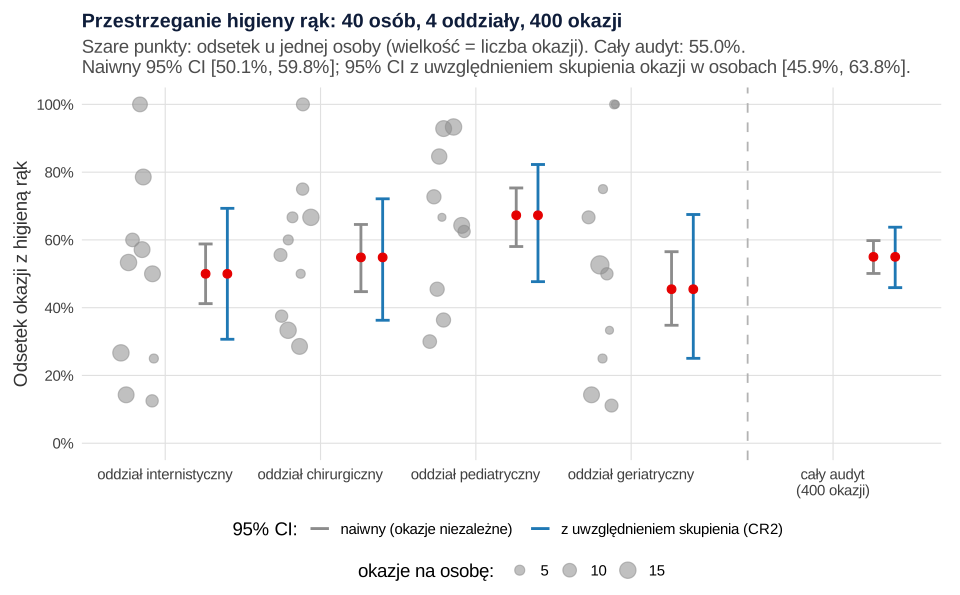
W każdym oddziale są osoby, które wykonują procedurę prawie zawsze, i takie, które robią to rzadko (rysunek 1). Odsetek oddziału zależy więc od tego, kogo obserwowałaś i ile razy. Przy 10 osobach na oddział przedziały są szerokie:
| Oddział | Okazje | Osoby | Odsetek | 95% CI naiwny | 95% CI z uwzględnieniem skupienia |
|---|---|---|---|---|---|
| internistyczny | 120 | 10 | 50.0% | [41.2, 58.8] | [30.7, 69.3] |
| chirurgiczny | 93 | 10 | 54.8% | [44.7, 64.6] | [36.3, 72.1] |
| pediatryczny | 110 | 10 | 67.3% | [58.1, 75.3] | [47.7, 82.3] |
| geriatryczny | 77 | 10 | 45.5% | [34.8, 56.5] | [25.1, 67.5] |
Naiwne przedziały oddziału pediatrycznego i geriatrycznego się nie nakładają, co kusi, by napisać o „istotnie lepszym” oddziale. Przedziały uwzględniające skupienie nakładają się w dużej części. Różnicę między oddziałami testuj w modelu (niżej), a nie przez porównywanie przedziałów. Pamiętaj też, że cztery oddziały to nie próba oddziałów. Wnioski dotyczą tych czterech oddziałów, a nie całego szpitala.
Jak policzyć CI uwzględniający skupienie
Masz trzy rozsądne drogi. Każda odpowiada na nieco inne pytanie, więc wybierz ją przed analizą i nazwij w pracy.
| Sposób | Co szacuje | Kiedy |
|---|---|---|
| Model brzegowy (GEE) z błędem odpornym na klastrowanie | odsetek wszystkich okazji w populacji okazji, z SE uwzględniającym osoby | domyślnie: odpowiada na pytanie „jaki odsetek okazji kończy się higieną rąk” |
| Model mieszany (GLMM) z losowym wyrazem wolnym osoby | szanse dla „typowej” osoby, ICC, różnice między oddziałami przy kontroli osoby | gdy interesuje Cię zmienność między osobami albo porównanie oddziałów |
| Odsetek liczony najpierw dla każdej osoby, potem średnia z CI | średni odsetek osoby (każda osoba waży tyle samo) | gdy jednostką wniosku jest osoba, np. „przeciętny pracownik” |
W przykładzie używamy pierwszej drogi. GEE to metoda Lianga i Zegera (1986), która daje zgodne oszacowania parametrów i ich wariancji bez określania pełnego rozkładu obserwacji z jednego klastra. Z macierzą roboczą niezależności GEE daje ten sam odsetek co zwykła regresja logistyczna. Zmienia się tylko błąd standardowy odporny na klastrowanie, liczony z sum reszt w obrębie osoby. W przykładzie używamy jego wersji z poprawką dla małej liczby klastrów CR2 i stopniami swobody Satterthwaite'a, bo w oddziale jest tylko 10 osób, a w całym audycie 40. Pustejovsky i Tipton (2018) pokazali, że bez niej odporny estymator wariancji bywa przy małej liczbie klastrów obciążony w dół. Różnice między GEE a modelem mieszanym, w tym to, dlaczego ilorazy szans z obu modeli się różnią, omawia wpis GEE czy model mieszany. Model mieszany dla wyniku 0/1 krok po kroku pokazuje wielopoziomowa regresja logistyczna.
Co z oddziałami? Cztery klastry to za mało, żeby oszacować wariancję między nimi, więc nie klastruj po oddziale i nie dawaj mu efektu losowego. Traktuj oddziały jak warstwy (efekt stały) i klastruj po osobie. Losowy efekt oddziału ma sens dopiero przy kilkunastu lub kilkudziesięciu oddziałach, jak w badaniach z randomizacją klastrową.
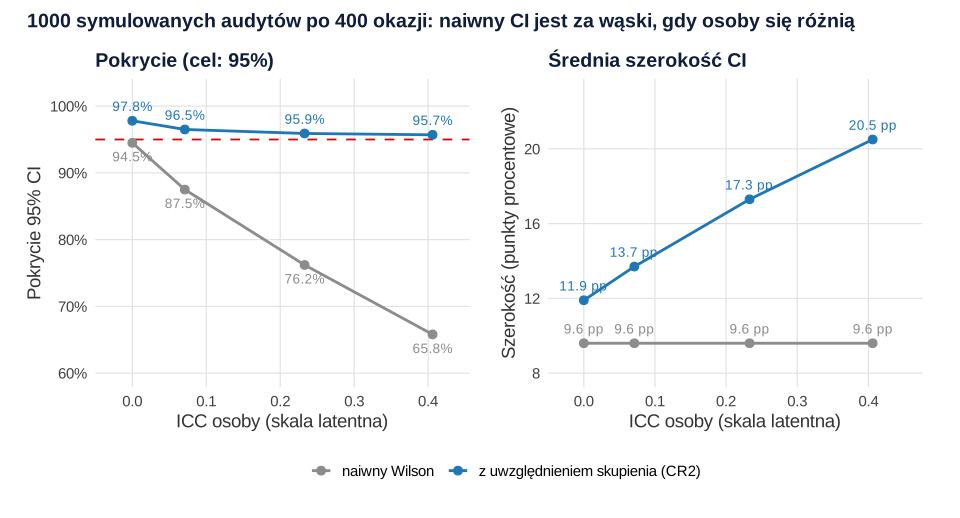
Czy to naprawdę ma znaczenie? Przepis 4 powtarza ten sam audyt 1000 razy przy coraz większych różnicach między osobami. Gdy osoby się nie różnią (ICC = 0), naiwny przedział obejmuje prawdziwy odsetek w 94.5% powtórzeń, czyli tak, jak powinien. Przy ICC = .071 już tylko w 87.5%, przy .233 w 76.2%, a przy .406 w 65.8%. Przedział uwzględniający skupienie trzyma pokrycie 95.7–97.8% we wszystkich scenariuszach. Płaci za to szerokością: średnio 11.9–20.5 punktu procentowego wobec 9.6 punktu w wersji naiwnej.
Efekt Hawthorne'a: jawna obserwacja zawyża wynik
Efekt Hawthorne'a to zmiana zachowania wywołana świadomością bycia obserwowanym. W audytach higieny rąk opisywano go wielokrotnie. Eckmanns i in. (2006) obserwowali personel pięciu oddziałów intensywnej terapii w dwóch okresach. Gdy personel nie wiedział o obserwacji, przestrzeganie wynosiło 29%, a po jej zapowiedzeniu 45%. Srigley i in. (2014) użyli systemu elektronicznego, który rejestrował użycie dozowników i ruch audytorów. Na korytarzach w zasięgu wzroku audytora zdarzeń higieny rąk było około trzy razy więcej niż przy dozownikach poza jego zasięgiem. W przeglądzie systematycznym Purssell i in. (2020) efekt Hawthorne'a w higienie rąk wahał się w dziewięciu badaniach od −6.9% do 65.3%, różnił się między oddziałami i w dwóch badaniach okazał się przejściowy.
Co to oznacza dla Twojej pracy?
- Jawny audyt może zawyżać przestrzeganie. Napisz to w ograniczeniach i nie porównuj go wprost z wynikami z pomiarów elektronicznych albo z audytów ukrytych.
- Warunki obserwacji muszą być takie same w każdym pomiarze. Jeśli audyt przed szkoleniem był niezapowiedziany, a audyt po szkoleniu zapowiedziany, różnica może wynikać z samej zapowiedzi.
- Zapisz porę i minutę sesji. Pozwoli to sprawdzić, czy odsetek jest wyższy na początku sesji niż pod jej koniec. Ogólne sposoby ograniczania reaktywności, np. sesje adaptacyjne, opisuje wpis o obserwacji jako metodzie badawczej.
Obserwacja ukryta może dawać trafniejszy obraz, ale rodzi pytania o zgodę obserwowanych. Purssell i in. (2020) zauważają, że okazjonalny audyt ukryty mógłby lepiej oszacować rzeczywiste przestrzeganie, ale jego akceptowalność dla personelu dopiero trzeba zbadać. Czy i w jakiej formie jest dopuszczalny w Twoim badaniu, rozstrzyga komisja bioetyczna razem z kierownictwem placówki, nie Ty sam(a).
Zgodność dwóch obserwatorów: wykrycie, moment i wynik
W audycie z listą kontrolną obserwatorzy mogą się różnić na trzech poziomach. Po pierwsze, czy w ogóle zauważyli okazję. Po drugie, który to był moment. Po trzecie, czy procedurę wykonano. Zwykle sprawdza się tylko trzeci poziom, a to za mało.
W przykładzie (przepis 2) studentka (A) i osoba prowadząca audyt (B) obserwowały jednocześnie ten sam personel w sześciu sesjach. B zapisała 64 okazje, z czego A zauważyła 61 (95.3%). Przeoczone okazje to głównie momenty po kontakcie z otoczeniem pacjenta: A wykryła 78% z nich. Na 61 wspólnych okazjach zgodność co do momentu wyniosła 82.0%, a kappa Cohena κ = .741, 95% CI [.609, .873]. Tabela zgodności pokazała, gdzie leży problem: A pięć razy zapisała moment „przed czynnością aseptyczną” tam, gdzie B widziała „przed kontaktem z pacjentem”, a cztery razy zapisała kontakt z otoczeniem pacjenta tam, gdzie B widziała kontakt z pacjentem. Co do wykonania procedury obserwatorki zgadzały się w 91.8% okazji, κ = .830, 95% CI [.687, .973].
Odsetek przestrzegania według obu osób był przy tym prawie taki sam: 60.7% i 60.9%. Zgodny wynik końcowy nie oznacza zgodnego zapisu. Pomyłki w obie strony mogą się znosić, a przeoczone okazje zmieniają mianownik. Dlatego w raporcie podaj odsetek wykrytych okazji, kappę dla momentu i kappę dla wykonania. Gdy jakiś moment wypada słabo, popraw jego definicję w instrukcji, zanim zaczniesz audyt właściwy. Dobór miary i paradoksy kappy przy rzadkich kategoriach omawia wpis zgodność sędziów: kappa, ICC i alfa. Kappę z własnej tabeli policzysz w kalkulatorze kappy.
Plan obserwacji w czasie
Lista kontrolna rejestruje zdarzenia: każdą okazję w czasie sesji. W czasie dobierasz natomiast same sesje. Jeśli obserwujesz tylko w dni powszednie przed południem, wynik dotyczy tylko tej pory. Kilka zasad:
- Sesje o stałej długości (np. 20 minut), rozłożone na różne dni tygodnia, zmiany i pory dnia, najlepiej według harmonogramu wylosowanego przed audytem. To ta sama idea co próbkowanie czasowe, tylko zastosowana do wyboru sesji, a nie interwałów w sesji.
- Więcej osób, mniej okazji na osobę. Ogranicz liczbę okazji od jednej osoby w sesji. Kilkadziesiąt okazji od trzech najbardziej „widocznych” pielęgniarek zawyży deff i zniekształci wynik.
- Kod osoby przy każdej okazji. Bez niego nie policzysz przedziału uwzględniającego skupienie i nie porównasz tych samych osób przed szkoleniem i po nim.
Liczebność planuj od precyzji: wybierz akceptowalną szerokość przedziału dla odsetka, policz potrzebną liczbę okazji jak dla próby prostej i pomnóż ją przez przewidywany deff. Przewidywany deff weź z pilotażu, z literatury albo z kalkulatora ICC i efektu schematu.
Porównanie przed szkoleniem i po nim
Typowy schemat pracy: audyt, szkolenie personelu, drugi audyt. W przykładzie (przepis 3) te same 40 osób obserwowano po szkoleniu w kolejnych 400 okazjach. Odsetek przestrzegania wzrósł z 55.0% do 63.0%, czyli o 8.0 punktu procentowego.
- Naiwnie, jak dla dwóch niezależnych prób okazji: różnica 8.0 pp, 95% CI [1.2, 14.8], p = .021.
- Z błędem uwzględniającym skupienie okazji w osobach (CR2): 8.0 pp, 95% CI [1.1, 14.9], p = .023.
- GEE z wymienną macierzą roboczą: OR = 1.415, 95% CI [1.113, 1.800], p = .005.
Tym razem naiwny przedział prawie nie różni się od klastrowego. W obu audytach obserwowano te same osoby, więc różnice między nimi w porównaniu przed–po częściowo się znoszą. GEE z wymienną macierzą korzysta z tego jeszcze lepiej i daje węższy przedział. Nie wyciągaj stąd wniosku, że skupienie można pominąć. Gdyby po szkoleniu obserwowano inne osoby albo gdyby szkolenie działało różnie u różnych osób, naiwny przedział byłby znowu za wąski. Licz zawsze wersję uwzględniającą osoby.
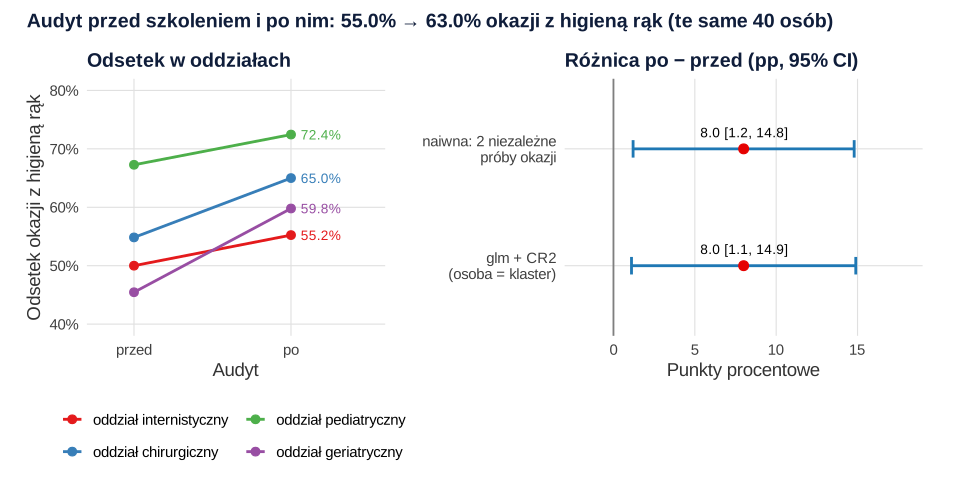
Statystyka nie rozwiąże jednak głównego problemu tego schematu. To schemat pretest–posttest bez grupy kontrolnej, więc wzrost może wynikać z innych przyczyn niż szkolenie:
- efekt Hawthorne'a: personel po szkoleniu wie, że będzie drugi audyt, i lepiej rozpoznaje obserwatorkę;
- regresja do średniej: jeśli do szkolenia wybrano oddziały z najniższym wynikiem pierwszego audytu, ich wynik i tak by się poprawił;
- trend i zdarzenia w tle: kampania szpitalna, nowe dozowniki, zmiana obsady.
Lepszym rozwiązaniem jest oddział porównawczy bez szkolenia, obserwowany tak samo, albo seria audytów przed szkoleniem i po nim. Pittet i in. (2000) opisali taką serię: siedem ogólnoszpitalnych badań obserwacyjnych prowadzonych dwa razy w roku przed wdrożeniem i w trakcie programu promocji higieny rąk. Przestrzeganie wzrosło w nich z 48% do 66%. Z kilku punktów w czasie da się oddzielić trend od zmiany po interwencji. Służy do tego przerwany szereg czasowy. Pomiar wiedzy przed szkoleniem i po nim, który często towarzyszy takiemu audytowi, opisuje wpis o badaniu wiedzy przed i po szkoleniu. Test McNemara stosuje się tam do odpowiedzi tych samych osób. Nie stosuj go do okazji, bo okazje przed i po szkoleniu to różne zdarzenia, a nie pary.
Jak opisać audyt w pracy
W metodzie podaj: listę kontrolną i źródło definicji, sposób doboru sesji, liczbę sesji, osób i okazji, informację, czy obserwacja była jawna, sposób szkolenia obserwatorów i wynik zgodności oraz metodę liczenia przedziałów. Gdzie ten akapit stoi w rozdziale, pokazuje wpis o statystyce w pracy z pielęgniarstwa. Wzór na podstawie przykładu:
Jeśli chcesz, żeby ktoś sprawdził plan audytu albo obliczenia, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (przepisy 3 i 4 korzystają z obiektów z przepisu 1). Przepis 1 zapisuje dane pierwszego audytu do pliku obserwacja-higiena-rak-audyt.csv (pobierz), a przepis 3 dane obu audytów do pliku obserwacja-higiena-rak-przed-po.csv (pobierz). Jeden wiersz to jedna okazja.
1. Odsetek przestrzegania: naiwny CI i CI uwzględniający skupienie
R
# Dane symulowane: audyt higieny rąk metodą obserwacji z listą kontrolną.
# 4 oddziały × 10 osób z personelu; łącznie 400 okazji (momentów) do higieny rąk, od 3 do 19 na osobę.
# Każdy wiersz = jedna okazja: kto (osoba), gdzie (oddział), który moment z listy (M1–M5), czy wykonano (1/0).
suppressPackageStartupMessages({library(sandwich); library(clubSandwich); library(lme4)})
set.seed(4351)
oddzialy <- c("internistyczny", "chirurgiczny", "pediatryczny", "geriatryczny")
osoby <- data.frame(osoba = sprintf("os%02d", 1:40), oddzial = rep(oddzialy, each = 10),
                    u = rnorm(40, 0, 1.1))                    # nawyk osoby (losowy efekt na skali logitu, SD = 1.1)
n_okazji <- sample(4:18, 40, replace = TRUE)
n_okazji <- round(n_okazji / sum(n_okazji) * 400)
n_okazji[40] <- 400 - sum(n_okazji[-40])                     # dokładnie 400 okazji
dane <- osoby[rep(1:40, n_okazji), ]
momenty <- c("M1 przed kontaktem z pacjentem", "M2 przed czynnością aseptyczną", "M3 po kontakcie z płynami ustrojowymi",
             "M4 po kontakcie z pacjentem", "M5 po kontakcie z otoczeniem pacjenta")
dane$moment <- sample(momenty, nrow(dane), replace = TRUE, prob = c(.30, .10, .10, .30, .20))
efekt_oddz <- c(internistyczny = 0.3, chirurgiczny = 0.6, pediatryczny = 0.9, geriatryczny = -0.2)
efekt_mom <- c(-0.4, 0.2, 0.5, 0.4, -0.5)                     # założenie symulacji, nie dane z literatury
names(efekt_mom) <- momenty
eta <- efekt_oddz[dane$oddzial] + efekt_mom[dane$moment] + dane$u
dane$wykonano <- rbinom(nrow(dane), 1, plogis(eta))
dane$u <- NULL; rownames(dane) <- NULL
dane$oddzial <- factor(dane$oddzial, levels = oddzialy)
write.csv(dane, "obserwacja-higiena-rak-audyt.csv", row.names = FALSE)

# Opis: okazje, osoby i odsetek przestrzegania w oddziałach
x <- sum(dane$wykonano); n <- nrow(dane)
c(okazje = n, osoby = length(unique(dane$osoba)), wykonano = x, odsetek = round(x / n, 3))
summary(as.vector(table(dane$osoba)))                         # liczba okazji na osobę

# 1. Naiwny 95% CI Wilsona: traktuje 400 okazji jak 400 niezależnych obserwacji
naiwny <- prop.test(x, n, correct = FALSE)$conf.int
round(c(dolny = naiwny[1], gorny = naiwny[2]), 3)

# 2. CI uwzględniający skupienie okazji w osobach: model brzegowy (GEE z macierzą niezależności = glm)
#    z błędem odpornym na klastrowanie CR2 i stopniami swobody Satterthwaite'a; przedział na skali logitu
m0 <- glm(wykonano ~ 1, data = dane, family = binomial)
ci_klaster <- conf_int(m0, vcov = "CR2", cluster = dane$osoba, test = "Satterthwaite")
round(c(odsetek = plogis(unname(coef(m0))), dolny = plogis(ci_klaster$CI_L), gorny = plogis(ci_klaster$CI_U),
        df = ci_klaster$df), 3)

# Ile „naprawdę niezależnych” okazji: efekt schematu (deff) i efektywna liczebność
se_naiwny <- sqrt(unname(diag(vcov(m0)))); se_klaster <- ci_klaster$SE
deff <- (se_klaster / se_naiwny)^2
round(c(deff = deff, n_efektywne = n / deff), 2)

# 3. Model mieszany (GLMM): losowy wyraz wolny osoby, oddział jako efekt stały (4 oddziały to za mało na efekt losowy)
m_glmm <- glmer(wykonano ~ oddzial + (1 | osoba), data = dane, family = binomial, nAGQ = 10)
tau2 <- as.numeric(VarCorr(m_glmm)$osoba)
round(c(SD_osoby = sqrt(tau2), ICC_latentne = tau2 / (tau2 + pi^2 / 3)), 3)

# 4. Odsetek w oddziałach: naiwny Wilson a CR2 (10 osób = 10 klastrów w oddziale)
m_odd <- glm(wykonano ~ 0 + oddzial, data = dane, family = binomial)
ci_odd <- conf_int(m_odd, vcov = "CR2", cluster = dane$osoba, test = "Satterthwaite")
tab <- do.call(rbind, lapply(oddzialy, function(o) {
  d <- dane[dane$oddzial == o, ]; w <- prop.test(sum(d$wykonano), nrow(d), correct = FALSE)$conf.int
  k <- ci_odd[ci_odd$Coef == paste0("oddzial", o), ]
  data.frame(oddzial = o, okazje = nrow(d), osoby = length(unique(d$osoba)), odsetek = mean(d$wykonano),
             naiwny_dol = w[1], naiwny_gor = w[2], klaster_dol = plogis(k$CI_L), klaster_gor = plogis(k$CI_U))
}))
print(cbind(tab[, 1:3], round(tab[, -(1:3)], 3)), row.names = FALSE, width = 120)

# 5. Odsetek przestrzegania według momentu z listy kontrolnej
tm <- aggregate(wykonano ~ moment, data = dane, FUN = function(v) c(okazje = length(v), odsetek = round(mean(v), 3)))
print(do.call(data.frame, tm), row.names = FALSE)
Wynik w R
  okazje    osoby wykonano  odsetek
  400.00    40.00   220.00     0.55
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
    3.0     7.5    10.0    10.0    14.0    19.0
dolny gorny
0.501 0.598
odsetek   dolny   gorny      df
  0.550   0.459   0.638  32.744
       deff n_efektywne
       3.17      126.17
    SD_osoby ICC_latentne
       0.979        0.226
        oddzial okazje osoby odsetek naiwny_dol naiwny_gor klaster_dol klaster_gor
 internistyczny    120    10   0.500      0.412      0.588       0.307       0.693
   chirurgiczny     93    10   0.548      0.447      0.646       0.363       0.721
   pediatryczny    110    10   0.673      0.581      0.753       0.477       0.823
   geriatryczny     77    10   0.455      0.348      0.565       0.251       0.675
                                moment wykonano.okazje wykonano.odsetek
        M1 przed kontaktem z pacjentem             110            0.455
        M2 przed czynnością aseptyczną              34            0.647
 M3 po kontakcie z płynami ustrojowymi              44            0.705
           M4 po kontakcie z pacjentem             121            0.620
 M5 po kontakcie z otoczeniem pacjenta              91            0.462
2. Zgodność dwóch obserwatorów
R
# Zgodność dwóch obserwatorów (dane symulowane): w 6 sesjach po 20 min obie osoby obserwują jednocześnie ten sam personel.
# Obserwator B (osoba prowadząca audyt) zapisał 64 okazje; obserwator A (student) część z nich przeoczył.
# Dla okazji zapisanych przez oboje porównujemy: który moment z listy (M1–M5) i czy higiena rąk była wykonana.
suppressPackageStartupMessages(library(psych))
set.seed(4352)
K <- 64
prawda_mom <- sample(paste0("M", 1:5), K, replace = TRUE, prob = c(.30, .10, .10, .30, .20))
prawda_wyk <- rbinom(K, 1, .55)
pomyl_mom <- function(m, p) ifelse(runif(length(m)) < p,       # pomyłka: najczęściej M4 ↔ M5 i M1 ↔ M2
  c(M1 = "M2", M2 = "M1", M3 = "M4", M4 = "M5", M5 = "M4")[m], m)
B_mom <- pomyl_mom(prawda_mom, .05); A_mom <- pomyl_mom(prawda_mom, .15)
B_wyk <- ifelse(runif(K) < .03, 1 - prawda_wyk, prawda_wyk); A_wyk <- ifelse(runif(K) < .07, 1 - prawda_wyk, prawda_wyk)
A_zauwazyl <- runif(K) > ifelse(prawda_mom %in% c("M5", "M3"), .20, .05)   # A częściej przeocza M5 i M3

# Wykrycie okazji: ile okazji zapisanych przez B zapisał też A
c(okazje_B = K, okazje_A_i_B = sum(A_zauwazyl), wykrycie = round(mean(A_zauwazyl), 3))
round(tapply(A_zauwazyl, B_mom, mean), 2)                      # odsetek wykrytych według momentu (wg B)

# Zgodność dla okazji zapisanych przez oboje
z <- A_zauwazyl
tab_mom <- table(A = factor(A_mom[z], paste0("M", 1:5)), B = factor(B_mom[z], paste0("M", 1:5)))
tab_mom
k_mom <- cohen.kappa(cbind(A_mom[z], B_mom[z]))
round(c(zgodnosc = sum(diag(tab_mom)) / sum(tab_mom), kappa = k_mom$kappa, k_mom$confid[1, c(1, 3)]), 3)

tab_wyk <- table(A = A_wyk[z], B = B_wyk[z])
tab_wyk
k_wyk <- cohen.kappa(cbind(A_wyk[z], B_wyk[z]))
round(c(zgodnosc = sum(diag(tab_wyk)) / sum(tab_wyk), kappa = k_wyk$kappa, k_wyk$confid[1, c(1, 3)]), 3)

# Wynik audytu według każdego obserwatora (na okazjach, które zapisał)
round(c(odsetek_A = mean(A_wyk[z]), odsetek_B = mean(B_wyk)), 3)
Wynik w R
    okazje_B okazje_A_i_B     wykrycie
      64.000       61.000        0.953
  M1   M2   M3   M4   M5
1.00 1.00 1.00 0.96 0.78
    B
A    M1 M2 M3 M4 M5
  M1 18  0  0  0  0
  M2  5  2  0  0  0
  M3  0  0  2  0  0
  M4  0  0  1 22  1
  M5  0  0  0  4  6
zgodnosc    kappa    lower    upper
   0.820    0.741    0.609    0.873
   B
A    0  1
  0 22  2
  1  3 34
zgodnosc    kappa    lower    upper
   0.918    0.830    0.687    0.973
odsetek_A odsetek_B
    0.607     0.609
3. Audyt przed szkoleniem i po nim
R
# Audyt po szkoleniu (wymaga obiektów z przepisu 1): te same 40 osób, kolejne 400 okazji.
# W symulacji szkolenie podnosi logit przestrzegania o 0.6 u każdej osoby; nawyk osoby (u) zostaje ten sam.
suppressPackageStartupMessages({library(marginaleffects); library(geepack)})
set.seed(4353)
u_os <- setNames(osoby$u, osoby$osoba)                         # nawyki osób z przepisu 1
po <- osoby[rep(1:40, sample(n_okazji)), c("osoba", "oddzial")]
po$moment <- sample(momenty, nrow(po), replace = TRUE, prob = c(.30, .10, .10, .30, .20))
po$wykonano <- rbinom(nrow(po), 1, plogis(efekt_oddz[po$oddzial] + efekt_mom[po$moment] + u_os[po$osoba] + 0.6))
po$oddzial <- factor(po$oddzial, levels = oddzialy)
oba <- rbind(cbind(dane, okres = "przed"), cbind(po, okres = "po"))
oba$okres <- factor(oba$okres, levels = c("przed", "po"))
oba <- oba[order(oba$osoba), ]; rownames(oba) <- NULL
write.csv(oba, "obserwacja-higiena-rak-przed-po.csv", row.names = FALSE)
round(tapply(oba$wykonano, oba$okres, mean), 3)

# 1. Naiwnie: dwie niezależne próby okazji (test dla dwóch proporcji i CI różnicy z prop.test)
pt <- prop.test(tapply(oba$wykonano, oba$okres, sum)[2:1], table(oba$okres)[2:1], correct = FALSE)
round(c(roznica = unname(pt$estimate[1] - pt$estimate[2]), dolny = pt$conf.int[1], gorny = pt$conf.int[2],
        p = pt$p.value), 3)

# 2. Różnica odsetków z modelu brzegowego z błędem odpornym na skupienie okazji w osobach (te same osoby w obu okresach)
m_pp <- glm(wykonano ~ okres, data = oba, family = binomial)
V_cr2 <- as.matrix(clubSandwich::vcovCR(m_pp, cluster = oba$osoba, type = "CR2"))
r <- avg_comparisons(m_pp, variables = "okres", vcov = V_cr2)
round(c(roznica = r$estimate, dolny = r$conf.low, gorny = r$conf.high, p = r$p.value), 3)

# 3. To samo jako GEE z wymienną macierzą roboczą (geepack); OR po/przed z 95% CI
m_gee <- geeglm(wykonano ~ okres, id = factor(osoba), data = oba, family = binomial, corstr = "exchangeable")
s <- summary(m_gee)$coefficients["okrespo", ]
round(c(OR = exp(s$Estimate), dolny = exp(s$Estimate - 1.96 * s$Std.err), gorny = exp(s$Estimate + 1.96 * s$Std.err),
        p = s$`Pr(>|W|)`, rho = summary(m_gee)$corr$Estimate), 3)

# 4. Odsetek w oddziałach przed i po (do rysunku 3)
round(tapply(oba$wykonano, list(oba$oddzial, oba$okres), mean), 3)
Wynik w R
przed    po
 0.55  0.63
roznica   dolny   gorny       p
  0.080   0.012   0.148   0.021
roznica   dolny   gorny       p
  0.080   0.011   0.149   0.023
   OR dolny gorny     p   rho
1.415 1.113 1.800 0.005 0.173
               przed    po
internistyczny 0.500 0.552
chirurgiczny   0.548 0.650
pediatryczny   0.673 0.724
geriatryczny   0.455 0.598
4. Pokrycie przedziałów w 1000 powtórzeniach
R
# Jak często 95% CI obejmuje prawdziwy odsetek przestrzegania? (wymaga obiektów z przepisu 1)
# 1000 powtórzeń audytu (40 osób, 4 oddziały, 400 okazji) dla czterech poziomów różnic między osobami (SD nawyku).
set.seed(4354)
p_mom <- c(.30, .10, .10, .30, .20)
u_siatka <- qnorm(ppoints(20000))
prawdziwy <- function(sd_u)                                    # odsetek w populacji okazji (średnia po oddziałach, momentach i osobach)
  mean(sapply(efekt_oddz, function(a) sum(p_mom * sapply(efekt_mom, function(b) mean(plogis(a + b + sd_u * u_siatka))))))
jeden_audyt <- function(sd_u) {
  m <- tabulate(sample(1:40, 400, replace = TRUE, prob = runif(40, 4, 18)), 40)   # nierówna liczba okazji na osobę
  os <- rep(1:40, m); odd <- rep(rep(names(efekt_oddz), each = 10), m)
  y <- rbinom(400, 1, plogis(efekt_oddz[odd] + efekt_mom[sample(1:5, 400, TRUE, p_mom)] + rnorm(40, 0, sd_u)[os]))
  w <- prop.test(sum(y), 400, correct = FALSE)$conf.int
  k <- clubSandwich::conf_int(glm(y ~ 1, family = binomial), vcov = "CR2", cluster = os, test = "Satterthwaite")
  c(w, plogis(c(k$CI_L, k$CI_U)))
}
wyniki <- do.call(rbind, lapply(c(0, 0.5, 1, 1.5), function(sd_u) {
  p0 <- prawdziwy(sd_u)
  ci <- t(replicate(1000, jeden_audyt(sd_u)))
  data.frame(SD_osoby = sd_u, ICC_latentne = round(sd_u^2 / (sd_u^2 + pi^2 / 3), 3), prawdziwy = round(p0, 3),
             pokrycie_naiwny = mean(ci[, 1] <= p0 & p0 <= ci[, 2]), pokrycie_klaster = mean(ci[, 3] <= p0 & p0 <= ci[, 4]),
             szer_naiwny = round(mean(ci[, 2] - ci[, 1]), 3), szer_klaster = round(mean(ci[, 4] - ci[, 3]), 3))
}))
print(wyniki, row.names = FALSE)
Wynik w R
 SD_osoby ICC_latentne prawdziwy pokrycie_naiwny pokrycie_klaster szer_naiwny szer_klaster
      0.0        0.000     0.585           0.945            0.978       0.096        0.119
      0.5        0.071     0.581           0.875            0.965       0.096        0.137
      1.0        0.233     0.572           0.762            0.959       0.096        0.173
      1.5        0.406     0.563           0.658            0.957       0.096        0.205
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 (funkcje pakietów base i stats oraz pakietów wymienionych niżej); rysunki przygotowano w pakietach ggplot2, patchwork i svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- clubSandwich (wersja 0.7.0): Pustejovsky, J. E. (2026). clubSandwich: Cluster-robust (sandwich) variance estimators with small-sample corrections [R package]. https://doi.org/10.32614/CRAN.package.clubSandwich
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- geepack (wersja 1.3.13): Halekoh, U., Højsgaard, S., & Yan, J. (2006). The R package geepack for generalized estimating equations. Journal of Statistical Software, 15(2), 1–11. https://doi.org/10.18637/jss.v015.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Arkusz bez kodu osoby. Bez niego nie policzysz poprawnego przedziału ani nie porównasz tych samych osób w dwóch audytach.
- Naiwny przedział Wilsona dla okazji. W przykładzie był prawie dwa razy węższy od poprawnego, a w symulacji przy umiarkowanych różnicach między osobami obejmował prawdę tylko w 76.2% powtórzeń.
- Kilka osób obserwowanych wiele razy. Odsetek zależy wtedy od nawyków tych kilku osób, a deff rośnie.
- Losowy efekt albo klastrowanie po czterech oddziałach. Przy tak małej liczbie klastrów oszacowanie wariancji jest niestabilne. Oddziały traktuj jak warstwy.
- Zgodność obserwatorów tylko dla wyniku „wykonano / nie”. Sprawdź też wykrywanie okazji i klasyfikację momentu. Podobny odsetek u obu obserwatorów niczego tu nie dowodzi.
- Inne warunki obserwacji przed szkoleniem i po nim. Zapowiedziany drugi audyt może pokazać poprawę wywołaną samą zapowiedzią.
- Wzrost po szkoleniu opisany jako jego skutek. Bez grupy porównawczej albo serii pomiarów pisz o zmianie, a nie o efekcie szkolenia.
Najczęstsze pytania
Jak policzyć odsetek przestrzegania higieny rąk z obserwacji?
Podziel liczbę okazji, w których wykonano higienę rąk, przez liczbę wszystkich zaobserwowanych okazji. Mianownikiem są okazje, a nie osoby. W przykładzie było to 220 z 400 okazji, czyli 55.0%. Przy każdej okazji zapisz kod osoby, bo bez niego nie policzysz poprawnego przedziału ufności.
Dlaczego przedział ufności dla odsetka przestrzegania ma uwzględniać osoby?
Okazje jednej osoby są do siebie podobne, bo zależą od jej nawyków. Naiwny przedział Wilsona traktuje je jak niezależne i jest za wąski. W przykładzie wyniósł [50.1%, 59.8%], a przedział z błędem odpornym na klastrowanie po osobie [45.9%, 63.8%]. W symulacji przy ICC = .233 naiwny przedział obejmował prawdziwy odsetek tylko w 76.2% powtórzeń.
Ilu osób i ile okazji potrzeba do audytu przestrzegania procedur?
Ważniejsza od liczby okazji jest liczba osób. Przy ośmiu okazjach od każdej z 50 osób masz więcej informacji niż przy 40 okazjach od 10 osób, choć okazji jest tyle samo. Policz liczbę okazji potrzebną do wybranej szerokości przedziału jak dla próby prostej i pomnóż ją przez przewidywany efekt schematu z pilotażu lub literatury.
Czy obserwacja ukryta daje lepszy wynik niż jawna w audycie higieny rąk?
Badania pokazują, że jawna obserwacja zwykle zawyża przestrzeganie, np. 45% wobec 29% bez wiedzy personelu w badaniu Eckmannsa i in. (2006). Obserwacja ukryta rodzi jednak pytania o zgodę obserwowanych, więc o jej dopuszczalności decyduje komisja bioetyczna i kierownictwo placówki. W pracy opisz rodzaj obserwacji i potraktuj możliwy efekt Hawthorne'a jako ograniczenie.
Jak porównać przestrzeganie procedur przed szkoleniem i po nim?
Obserwuj te same osoby w takich samych warunkach i porównaj odsetki modelem, który klastruje okazje po osobie, np. GEE albo regresją logistyczną z błędem CR2. Nie stosuj testu McNemara do okazji, bo okazje przed i po to różne zdarzenia. Bez grupy porównawczej pisz o zmianie, a nie o efekcie szkolenia.
Powiązane hasła
Przeczytaj też
Ewaluacja szkolenia w modelu Kirkpatricka
Cztery poziomy jako cztery pomiary: narzędzie, termin, schemat i analiza, krytyka modelu oraz korelacje między poziomami – z przykładem 120 osób w R.
Czytaj →PoradnikObserwacja jako metoda badawcza
System kategorii, arkusz do skopiowania, próbkowanie zdarzeniowe i czasowe, szkolenie obserwatorów, kappa i reaktywność – z symulacją w R i wzorem opisu.
Czytaj →PoradnikGEE czy model mieszany?
Efekty brzegowe a warunkowe, robocza macierz korelacji, błąd kanapkowy i CR2, braki MCAR i MAR oraz QIC – na jednym przykładzie w R.
Czytaj →PoradnikAnaliza dokumentacji medycznej – badanie retrospektywne
Pytanie, kryteria, karta zbierania danych, „brak wpisu” ≠ „nie”, kappa na podpróbie kart, braki, zgody, STROBE i RECORD – z przykładem w R.
Czytaj →Planujesz audyt z listą kontrolną do pracy dyplomowej?
Pomożemy zaplanować obserwację, policzyć odsetki z poprawnymi przedziałami i zgodność obserwatorów oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Eckmanns, T., Bessert, J., Behnke, M., Gastmeier, P., & Rüden, H. (2006). Compliance with antiseptic hand rub use in intensive care units: The Hawthorne effect. Infection Control & Hospital Epidemiology, 27(9), 931–934. https://doi.org/10.1086/507294
- Haas, J. P., & Larson, E. L. (2007). Measurement of compliance with hand hygiene. Journal of Hospital Infection, 66(1), 6–14. https://doi.org/10.1016/j.jhin.2006.11.013
- Killip, S., Mahfoud, Z., & Pearce, K. (2004). What is an intracluster correlation coefficient? Crucial concepts for primary care researchers. Annals of Family Medicine, 2(3), 204–208. https://doi.org/10.1370/afm.141 ● Otwarty dostęp
- Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- Pittet, D., Hugonnet, S., Harbarth, S., Mourouga, P., Sauvan, V., Touveneau, S., & Perneger, T. V. (2000). Effectiveness of a hospital-wide programme to improve compliance with hand hygiene. The Lancet, 356(9238), 1307–1312. https://doi.org/10.1016/s0140-6736(00)02814-2 ● Otwarty dostęp: pełny tekst
- Purssell, E., Drey, N., Chudleigh, J., Creedon, S., & Gould, D. J. (2020). The Hawthorne effect on adherence to hand hygiene in patient care. Journal of Hospital Infection, 106(2), 311–317. https://doi.org/10.1016/j.jhin.2020.07.028
- Pustejovsky, J. E., & Tipton, E. (2018). Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models. Journal of Business & Economic Statistics, 36(4), 672–683. https://doi.org/10.1080/07350015.2016.1247004 ● Otwarty dostęp: pełny tekst
- Sax, H., Allegranzi, B., Uçkay, I., Larson, E., Boyce, J., & Pittet, D. (2007). ‘My five moments for hand hygiene’: A user-centred design approach to understand, train, monitor and report hand hygiene. Journal of Hospital Infection, 67(1), 9–21. https://doi.org/10.1016/j.jhin.2007.06.004 ● Otwarty dostęp: pełny tekst
- Srigley, J. A., Furness, C. D., Baker, G. R., & Gardam, M. (2014). Quantification of the Hawthorne effect in hand hygiene compliance monitoring using an electronic monitoring system: A retrospective cohort study. BMJ Quality & Safety, 23(12), 974–980. https://doi.org/10.1136/bmjqs-2014-003080 ● Otwarty dostęp
Cytowania BibTeX
@article{eckmanns2006compliance, author={Eckmanns, Tim and Bessert, Jan and Behnke, Michael and Gastmeier, Petra and Rüden, Henning}, title={{Compliance with antiseptic hand rub use in intensive care units: The Hawthorne effect}}, journal={Infection Control \& Hospital Epidemiology}, year={2006}, volume={27}, number={9}, pages={931--934}, doi={10.1086/507294}}@article{haas2007measurement, author={Haas, Janet P. and Larson, Elaine L.}, title={{Measurement of compliance with hand hygiene}}, journal={Journal of Hospital Infection}, year={2007}, volume={66}, number={1}, pages={6--14}, doi={10.1016/j.jhin.2006.11.013}}@article{killip2004what, author={Killip, Shersten and Mahfoud, Ziyad and Pearce, Kevin}, title={{What is an intracluster correlation coefficient? Crucial concepts for primary care researchers}}, journal={Annals of Family Medicine}, year={2004}, volume={2}, number={3}, pages={204--208}, doi={10.1370/afm.141}}@article{liang1986longitudinal, author={Liang, Kung-Yee and Zeger, Scott L.}, title={{Longitudinal data analysis using generalized linear models}}, journal={Biometrika}, year={1986}, volume={73}, number={1}, pages={13--22}, doi={10.1093/biomet/73.1.13}}@article{pittet2000effectiveness, author={Pittet, Didier and Hugonnet, Stéphane and Harbarth, Stephan and Mourouga, Philippe and Sauvan, Valérie and Touveneau, Sylvie and Perneger, Thomas V.}, title={{Effectiveness of a hospital-wide programme to improve compliance with hand hygiene}}, journal={The Lancet}, year={2000}, volume={356}, number={9238}, pages={1307--1312}, doi={10.1016/s0140-6736(00)02814-2}}@article{purssell2020hawthorne, author={Purssell, E. and Drey, N. and Chudleigh, J. and Creedon, S. and Gould, D. J.}, title={{The Hawthorne effect on adherence to hand hygiene in patient care}}, journal={Journal of Hospital Infection}, year={2020}, volume={106}, number={2}, pages={311--317}, doi={10.1016/j.jhin.2020.07.028}}@article{pustejovsky2018small, author={Pustejovsky, James E. and Tipton, Elizabeth}, title={{Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models}}, journal={Journal of Business \& Economic Statistics}, year={2018}, volume={36}, number={4}, pages={672--683}, doi={10.1080/07350015.2016.1247004}}@article{sax2007my, author={Sax, H. and Allegranzi, B. and Uçkay, I. and Larson, E. and Boyce, J. and Pittet, D.}, title={{‘My five moments for hand hygiene’: A user-centred design approach to understand, train, monitor and report hand hygiene}}, journal={Journal of Hospital Infection}, year={2007}, volume={67}, number={1}, pages={9--21}, doi={10.1016/j.jhin.2007.06.004}}@article{srigley2014quantification, author={Srigley, Jocelyn A. and Furness, Colin D. and Baker, G. Ross and Gardam, Michael}, title={{Quantification of the Hawthorne effect in hand hygiene compliance monitoring using an electronic monitoring system: A retrospective cohort study}}, journal={BMJ Quality \& Safety}, year={2014}, volume={23}, number={12}, pages={974--980}, doi={10.1136/bmjqs-2014-003080}}