Obserwacja zamiast ankiety: kiedy
Ankieta mówi, co ludzie deklarują. Obserwacja rejestruje, co robią. W pracach z pedagogiki, logopedii, psychologii rozwojowej, pielęgniarstwa czy wychowania fizycznego bywa jedynym rozsądnym sposobem pomiaru: przedszkolak nie wypełni kwestionariusza, a nauczyciel źle oszacuje, ile minut lekcji uczeń spędza poza zadaniem. Bakeman i Quera (2011) opisują systematyczną obserwację jako metodę badania względnie naturalnego, spontanicznego zachowania, które rozwija się w czasie.
Nie myl obserwacji jako metody pomiaru z schematem obserwacyjnym. Ten drugi to rodzaj planu badania, w którym badacz niczym nie manipuluje, a dane mogą pochodzić z ankiet czy dokumentacji. Obserwacja jako metoda działa także w eksperymencie, np. gdy liczysz zachowania uczniów przed interwencją i po niej. Jak z takimi danymi pracuje się na konkretnych kierunkach, pokazują wpisy o statystyce w pracy z pedagogiki i logopedii.
System kategorii: co dokładnie liczysz
Podstawą jest system kategorii, czyli lista zachowań z definicjami. Bakeman i Quera (2011) zaczynają od niego swój podręcznik, bo od definicji zależy wszystko dalej, z rzetelnością włącznie. Dobra kategoria spełnia cztery warunki:
- Definicja obserwowalna. „Poza zadaniem: uczeń przez co najmniej 3 s nie patrzy na materiał ani na nauczyciela albo robi coś niezwiązanego z poleceniem” zamiast „brak zaangażowania”. To operacjonalizacja na poziomie zachowania.
- Przykłady i przypadki graniczne. Do każdej kategorii dopisz dwa–trzy trudne przypadki z rozstrzygnięciem, np. „wstaje, żeby wyrzucić papier na polecenie nauczyciela – praca nad zadaniem”.
- Kategorie wzajemnie wykluczające się. W danej chwili uczeń jest tylko w jednej kategorii danego wymiaru. Jeśli dwie rzeczy mogą zachodzić naraz (mówi i pisze), zrób z nich dwa osobne wymiary.
- Kategorie wyczerpujące. Dodaj kategorię „inne / nie widać”, żeby obserwator nie musiał zgadywać.
Kategorie jednego wymiaru tworzą zmienną na skali nominalnej. Definicje, kody i zasady rozstrzygania wątpliwości zapisz w instrukcji kodowania – to odpowiednik książki kodowej dla danych obserwacyjnych. Nie przesadzaj z liczbą kategorii: Kazdin (1977) wymienia złożoność kodów i obserwowanych zachowań wśród czynników, które wpływają na zgodność obserwatorów.
Próbkowanie zdarzeniowe i czasowe
Druga decyzja to reguła zapisu. Altmann (1974) w klasycznym przeglądzie opisała siedem metod próbkowania zachowań i pokazała, że różnią się podatnością na obciążenie. Wybór zależy od cech zachowania i od pytania badawczego. W pracach dyplomowych spotkasz głównie cztery metody:
| Metoda | Co zapisujesz | Wynik | Kiedy |
|---|---|---|---|
| Rejestracja zdarzeń (próbkowanie zdarzeniowe) | każde wystąpienie zachowania, czasem z momentem początku i końca | liczba zdarzeń, częstość na minutę, czas trwania | zachowania krótkie i wyraźnie oddzielone: zgłoszenia się, upadki, wypowiedzi |
| Interwał częściowy (PIR) | czy zachowanie wystąpiło choć przez chwilę w interwale, np. 10 s | odsetek interwałów z zachowaniem | gdy liczy się, czy zachowanie w ogóle się pojawiło; zawyża odsetek czasu |
| Interwał pełny (WIR) | czy zachowanie trwało przez cały interwał | odsetek interwałów z zachowaniem | zachowania, które mają trwać bez przerwy; zaniża odsetek czasu |
| Próbkowanie momentalne (MTS) | czy zachowanie trwa dokładnie w chwili sygnału, np. co 10 s | odsetek momentów, czyli oszacowanie odsetka czasu | zachowania trwające dłużej; kilka osób obserwowanych po kolei |
Trzy ostatnie metody to próbkowanie czasowe. Są tańsze od zapisu ciągłego, bo obserwator nie mierzy każdej sekundy, ale płaci się za to błędem. Powell, Martindale i Kulp (1975) porównali je z zapisem ciągłym. Interwał pełny systematycznie zaniżał wynik, interwał częściowy systematycznie go zawyżał, a błędy próbkowania momentalnego rozkładały się w obie strony. Im gęstsze próbki, tym mniejszy błąd.
Symulacja: jak bardzo myli się każda metoda
Zasymulowaliśmy w R 1000 lekcji po 20 minut dla dwóch zachowań, które trwają łącznie przez 20% lekcji. Pierwsze pojawia się w krótkich epizodach (średnio 4 s, przerwy średnio 16 s), jak odwracanie się do kolegi. Drugie trwa dłużej (średnio 30 s, przerwy średnio 120 s), jak rozmowa z sąsiadem z ławki. Każdą lekcję „zakodowaliśmy” trzema metodami z interwałem 10 s i 30 s.
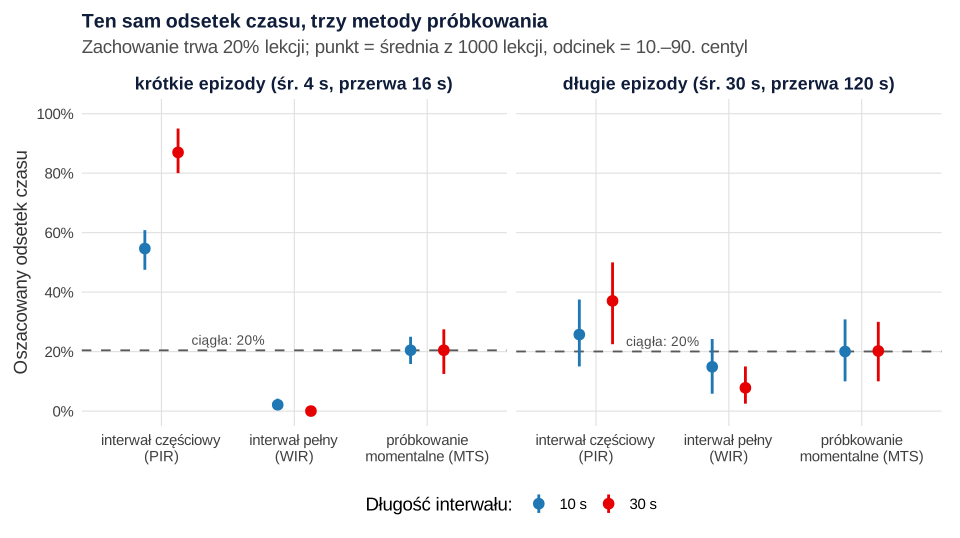
Próbkowanie momentalne trafiało średnio w prawdziwy odsetek we wszystkich czterech wariantach (20.0–20.5% przy rzeczywistych 20.0–20.4%). Interwał częściowy przy krótkich epizodach dał 54.7% przy interwale 10 s i 87.0% przy 30 s, czyli ponad czterokrotnie więcej niż w rzeczywistości. Interwał pełny prawie całkiem „zgubił” krótkie epizody (2.1% i 0.0%). Przy długich epizodach błędy były mniejsze, ale nadal systematyczne: 25.7% i 14.9% przy interwale 10 s. Potwierdza się wniosek Powella i in. (1975): błąd zależy od czasu trwania pojedynczego epizodu, więc nie jest stały. Jeśli interwencja skróci epizody, a nie zmieni łącznego czasu zachowania, interwał częściowy pokaże spadek, którego nie było.
Próbkowanie momentalne ma jednak swoją cenę. Przy interwale 30 s lekcja daje tylko 40 momentów, więc pojedynczy wynik jest mniej dokładny. Typowy błąd w jednej lekcji (SD różnicy względem zapisu ciągłego) wzrósł przy krótkich epizodach z 2.6 do 5.6 punktu procentowego. Ledford i in. (2015) opisali to samo w swojej symulacji: próbkowanie momentalne najlepiej odtwarza czas trwania, ale w krótkich sesjach zwiększa zmienność wyników, a oba systemy interwałowe mogą zniekształcać wielkość efektu. Wniosek praktyczny: krótszy interwał albo dłuższe sesje.
Interwał częściowy nie jest bezużyteczny, tylko mierzy co innego. Przy krótkich epizodach liczba zaznaczonych interwałów była bliska liczbie zdarzeń: epizody zaczynały się średnio 59.8 razy na lekcję, a interwał częściowy (10 s) zaznaczył średnio 65.6 interwału. Przy długich epizodach te liczby się rozjechały (8.1 wobec 30.9). Jeśli więc pytasz o częstość, rejestruj zdarzenia. Jeśli pytasz o czas trwania, wybierz zapis ciągły albo próbkowanie momentalne. Liczby zdarzeń analizuje się potem zwykle regresją dla zliczeń.
Arkusz obserwacji – wzór do skopiowania
Na górze jest metryczka sesji, niżej siatka interwałów. Poniższy wzór dotyczy próbkowania momentalnego co 10 s z jednym wymiarem (trzy kategorie) i rejestracją jednego zdarzenia. Przy nagraniach wideo ten sam układ odtworzysz w arkuszu kalkulacyjnym: jeden wiersz to jeden moment, a plik od razu nadaje się do R lub SPSS.
| Arkusz obserwacji – kod ucznia: ______ · klasa: ______ · data: ______ · sesja nr: ______ · obserwator: ______ · początek: ______ · nagranie / na żywo: ______ | ||||
|---|---|---|---|---|
| Nr | Czas | Kategoria w chwili sygnału (Z / R / P / N) | Zgłoszenia się w interwale (kreski) | Uwagi |
| 1 | 0:10 | |||
| 2 | 0:20 | |||
| 3 | 0:30 | |||
| 4 | 0:40 | |||
| 5 | 0:50 | |||
| 6 | 1:00 | |||
| … | … | |||
| 120 | 20:00 | |||
| Legenda: Z – praca nad zadaniem, R – rozmowa z rówieśnikiem, P – poza zadaniem, N – nie widać. Pełne definicje i przypadki graniczne: instrukcja kodowania, s. __. Sesja adaptacyjna: tak / nie. | ||||
W arkuszu wpisuj kody osób, a nie nazwiska. Listę łączącą kody z osobami przechowuj osobno (zob. anonimizacja i pseudonimizacja).
Obserwacja uczestnicząca – w skrócie
W obserwacji uczestniczącej badacz przebywa w badanej grupie, np. jako wolontariusz w świetlicy, i prowadzi notatki terenowe. Nie ma tu z góry ustalonych kategorii ani liczb. Notatki analizuje się jakościowo, np. analizą tematyczną, a wnioski wzmacnia triangulacją z wywiadami i dokumentami. Często występuje w studium przypadku. Jej jakość ocenia się kryteriami wiarygodności, a nie kappą. Dalej zajmujemy się tylko obserwacją systematyczną.
Szkolenie obserwatorów i pilotaż
Bakeman i Quera (2011) traktują szkolenie obserwatorów i ocenę rzetelności jako osobny etap pracy, a nie formalność na końcu. W pracy dyplomowej wystarczy prosty plan:
- Wspólna lektura instrukcji i kodowanie razem dwóch–trzech nagrań spoza próby, z omówieniem każdej rozbieżności.
- Niezależne kodowanie kolejnych nagrań treningowych i liczenie zgodności po każdym. Definicje poprawiasz tam, gdzie tabela zgodności pokazuje powtarzające się pomyłki.
- Kryterium zgodności, po którym obserwator zaczyna kodować dane właściwe, ustalone przed treningiem i zapisane w protokole.
- Kontrole zgodności w trakcie całego badania na losowo wybranych sesjach, bo z czasem obserwatorzy przesuwają własne rozumienie kategorii (dryf obserwatorów).
Ostatni punkt ma podstawy empiryczne. Romanczyk i in. (1973) pokazali, że gdy obserwatorzy wiedzieli, kiedy i przez kogo są sprawdzani, ich zgodność z tą osobą była wyraźnie wyższa, a przy ukrytej kontroli spadała. Kazdin (1977) wśród źródeł zawyżonej zgodności wymienia reaktywność samej kontroli, dryf obserwatorów oraz oczekiwania obserwatorów i informację zwrotną od badacza. Dlatego obserwatorzy nie powinni znać hipotez ani przydziału do grup (zob. efekt oczekiwań badacza), nie powinni wiedzieć, które sesje są kodowane podwójnie, a zgodność liczy badacz, nie sami obserwatorzy.
Jak wiele daje szkolenie, pokazuje nasz przykład (przepis 2 w sekcji z kodem). Przed szkoleniem dwie osoby zakodowały 60 momentów jednego nagrania. Zgodziły się w 58.3% przypadków, a κ = .33, 95% CI [.14, .52]. Po szkoleniu i doprecyzowaniu definicji, w badaniu właściwym na 120 momentach, zgodność wyniosła 85.0%, a κ = .74, 95% CI [.63, .84]. Trening najlepiej wpleść w badanie pilotażowe.
Zgodność obserwatorów: kappa, ICC i procent zgodności
Gdy obserwatorzy przypisują momenty lub interwały do kategorii, porównujesz ich zapis moment po momencie. Sam procent zgodności zawyża obraz, bo część zgodności jest przypadkowa. Kappa Cohena (Cohen, 1960) odejmuje zgodność oczekiwaną, wyliczoną z rozkładów brzegowych. W badaniu właściwym zgodność oczekiwana wyniosła .430, więc z 85.0% zgodności obserwowanej zostaje κ = (.850 − .430) / (1 − .430) = .74. Hallgren (2012) w przewodniku po rzetelności danych obserwacyjnych omawia cały proces: zaplanowanie badania zgodności, dobór statystyki, obliczenia, interpretację i raport. Dobór miary w skrócie:
| Co porównujesz | Miara |
|---|---|
| Kategorie w momentach lub interwałach, dwóch obserwatorów | kappa Cohena, procent zgodności i tabela zgodności |
| Kategorie uporządkowane, np. nasilenie 0–3 | kappa ważona |
| Wynik sesji: liczba zdarzeń, odsetek czasu, czas trwania | ICC w wersji zgodności absolutnej |
| Więcej obserwatorów albo niepełne podwójne kodowanie | alfa Krippendorffa |
Zgodność moment po momencie i zgodność wyniku sesji to dwie różne rzeczy. W przykładzie obserwator A zapisał „poza zadaniem” w 20.0% momentów, a obserwator B w 16.7%. Jeśli w analizie używasz odsetka czasu na sesję, policz także ICC dla tego wyniku, np. w kalkulatorze ICC. Kappę z własnej tabeli zgodności policzysz w kalkulatorze kappy. Interpretację wartości, paradoksy kappy przy rzadkich kategoriach i wybór formy ICC omawia wpis zgodność sędziów: kappa, ICC i alfa, więc tu ich nie powtarzamy.
Reaktywność: czy obserwowani zachowują się inaczej
Obserwacja może zmieniać to, co mierzy. Zmianę zachowania pod wpływem świadomości bycia badanym nazywa się efektem Hawthorne. Dowody są niejednoznaczne. W przeglądzie systematycznym McCambridge i in. (2014) stwierdzili, że udział w badaniu zmienia zachowanie, ale niewiele wiadomo o warunkach, mechanizmach i sile tego wpływu. Z kolei Johnson i Bolstad (1975) w badaniu rodzin obserwowanych w domu nie znaleźli różnic między nagraniami z obecnym i nieobecnym obserwatorem. Reaktywności nie da się więc z góry założyć ani wykluczyć. Trzeba ją ograniczać i opisać:
- pierwsze sesje traktuj jako adaptacyjne i nie włączaj ich do analizy;
- obserwator siedzi z boku, nie wchodzi w interakcje i przychodzi regularnie, a nie tylko „na pomiar”;
- kamera zamiast osoby, jeśli pozwalają na to zgody;
- porównaj wyniki pierwszych i ostatnich sesji – wyraźny trend może oznaczać przyzwyczajanie się do obserwacji.
Obserwacja w szkole, przedszkolu czy szpitalu, a zwłaszcza nagrywanie, wymaga świadomej zgody (u dzieci – zgody rodziców) i często zgody komisji etycznej.
Jak opisać obserwację w rozdziale metodologicznym
W opisie procedury podaj: kategorie (z odesłaniem do instrukcji w aneksie), metodę próbkowania i długość interwału, długość i liczbę sesji, sposób szkolenia, kryterium zgodności, odsetek sesji kodowanych podwójnie, wynik zgodności oraz to, jak ograniczano reaktywność. Wzór:
Wstaw własne liczby i odsetek sesji kodowanych podwójnie. Miejsce tego akapitu w strukturze rozdziału pokazuje wpis rozdział metodologiczny – jak go napisać.
Symulacja próbkowania i kappa w R
Przepis 1 symuluje zachowanie sekunda po sekundzie i „koduje” je trzema metodami próbkowania czasowego – z niego pochodzą liczby z rysunku 1. Przepis 2 symuluje dwie rundy kodowania przez dwóch obserwatorów i liczy kappę Cohena ręcznie oraz funkcją cohen.kappa() z pakietu psych. Wszystkie dane są symulowane.
1. Próbkowanie czasowe a zapis ciągły
R
# B270 – próbkowanie czasowe: interwał częściowy, interwał pełny i próbkowanie momentalne
# Dane symulowane, set.seed(2701): 1000 lekcji po 20 minut (1200 s) dla każdego zachowania.
# Zachowanie włącza się i wyłącza; czasy epizodów i przerw mają rozkład wykładniczy.
# Prawdziwy wynik = odsetek sekund, w których zachowanie trwało (obserwacja ciągła).
set.seed(2701)
dlugosc <- 1200

symuluj_lekcje <- function(sr_epizod, sr_przerwa) {
  stan <- logical(0); trwa <- runif(1) < sr_epizod / (sr_epizod + sr_przerwa)
  while (length(stan) < dlugosc) {
    ile <- max(1, round(rexp(1, 1 / ifelse(trwa, sr_epizod, sr_przerwa))))
    stan <- c(stan, rep(trwa, ile)); trwa <- !trwa
  }
  stan[1:dlugosc]
}

ocen <- function(stan, interwal) {
  m <- matrix(stan, nrow = interwal)            # kolumna = jeden interwał
  c(ciagla  = 100 * mean(stan),
    PIR     = 100 * mean(apply(m, 2, any)),       # choć przez chwilę w interwale
    WIR     = 100 * mean(apply(m, 2, all)),       # przez cały interwał
    MTS     = 100 * mean(m[interwal, ]),          # w chwili zakończenia interwału
    epizody = sum(diff(c(FALSE, stan)) == 1),     # liczba rozpoczętych epizodów (rejestracja zdarzeń)
    PIR_n   = sum(apply(m, 2, any)))              # liczba interwałów z zachowaniem
}

zachowania <- list("krótkie epizody (śr. 4 s, przerwa 16 s)" = c(4, 16),
                   "długie epizody (śr. 30 s, przerwa 120 s)" = c(30, 120))
wyniki <- do.call(rbind, lapply(names(zachowania), function(z) {
  lekcje <- replicate(1000, symuluj_lekcje(zachowania[[z]][1], zachowania[[z]][2]), simplify = FALSE)
  do.call(rbind, lapply(c(10, 30), function(iv) {
    o <- t(sapply(lekcje, ocen, interwal = iv))
    data.frame(zachowanie = factor(z, levels = names(zachowania)), interwal = iv, lekcja = seq_along(lekcje), o)
  }))
}))

# średni wynik metody, średni błąd (metoda − obserwacja ciągła) i typowy rozrzut błędu (SD)
podsumuj <- function(d) {
  out <- do.call(rbind, lapply(c("PIR", "WIR", "MTS"), function(m) {
    blad <- d[[m]] - d$ciagla
    data.frame(metoda = m, srednia = mean(d[[m]]), blad = mean(blad), sd_bledu = sd(blad))
  }))
  cbind(prawdziwy = mean(d$ciagla), out)
}
tab <- do.call(rbind, lapply(split(wyniki, list(wyniki$zachowanie, wyniki$interwal), lex.order = TRUE), function(d)
  cbind(zachowanie = as.character(d$zachowanie[1]), interwal = d$interwal[1], podsumuj(d))))
rownames(tab) <- NULL
print(transform(tab, prawdziwy = round(prawdziwy, 1), srednia = round(srednia, 1),
                blad = round(blad, 1), sd_bledu = round(sd_bledu, 1)))

# rejestracja zdarzeń a interwał częściowy: liczba epizodów w lekcji
k <- subset(wyniki, interwal == 10)
print(aggregate(cbind(epizody, PIR_n) ~ zachowanie, data = k, FUN = function(x) round(mean(x), 1)))
Wynik w R
                                 zachowanie interwal prawdziwy metoda srednia  blad sd_bledu
1   krótkie epizody (śr. 4 s, przerwa 16 s)       10      20.4    PIR    54.7  34.2      3.5
2   krótkie epizody (śr. 4 s, przerwa 16 s)       10      20.4    WIR     2.1 -18.3      2.4
3   krótkie epizody (śr. 4 s, przerwa 16 s)       10      20.4    MTS    20.5   0.0      2.6
4   krótkie epizody (śr. 4 s, przerwa 16 s)       30      20.4    PIR    87.0  66.5      4.9
5   krótkie epizody (śr. 4 s, przerwa 16 s)       30      20.4    WIR     0.0 -20.4      2.9
6   krótkie epizody (śr. 4 s, przerwa 16 s)       30      20.4    MTS    20.5   0.0      5.6
7  długie epizody (śr. 30 s, przerwa 120 s)       10      20.0    PIR    25.7   5.7      1.8
8  długie epizody (śr. 30 s, przerwa 120 s)       10      20.0    WIR    14.9  -5.2      1.7
9  długie epizody (śr. 30 s, przerwa 120 s)       10      20.0    MTS    20.0   0.0      1.0
10 długie epizody (śr. 30 s, przerwa 120 s)       30      20.0    PIR    37.1  17.0      5.0
11 długie epizody (śr. 30 s, przerwa 120 s)       30      20.0    WIR     7.8 -12.2      4.3
12 długie epizody (śr. 30 s, przerwa 120 s)       30      20.0    MTS    20.2   0.2      2.9
                                zachowanie epizody PIR_n
1  krótkie epizody (śr. 4 s, przerwa 16 s)    59.8  65.6
2 długie epizody (śr. 30 s, przerwa 120 s)     8.1  30.9
2. Zgodność dwóch obserwatorów: pilotaż i badanie właściwe
R
# B270 – zgodność dwóch obserwatorów: próbkowanie momentalne co 10 s, trzy kategorie
# Dane symulowane, set.seed(2702). Obserwatorzy A i B kodują niezależnie to samo nagranie lekcji.
# Runda 1: pilotaż przed szkoleniem (60 momentów). Runda 2: badanie właściwe (120 momentów).
suppressPackageStartupMessages(library(psych))
set.seed(2702)
kategorie <- c("praca nad zadaniem", "rozmowa z rówieśnikiem", "poza zadaniem")

koduj <- function(prawda, trafnosc) {          # z prawd. 1 − trafność obserwator myli kategorię
  sapply(prawda, function(k) if (runif(1) < trafnosc) k else sample(setdiff(kategorie, k), 1))
}
runda <- function(n, traf_A, traf_B) {
  prawda <- sample(kategorie, n, replace = TRUE, prob = c(.60, .25, .15))
  data.frame(A = factor(koduj(prawda, traf_A), levels = kategorie),
             B = factor(koduj(prawda, traf_B), levels = kategorie))
}
kappa_reka <- function(d) {
  tab <- table(A = d$A, B = d$B); N <- sum(tab)
  po <- sum(diag(tab)) / N
  pe <- sum(rowSums(tab) * colSums(tab)) / N^2
  list(tabela = tab, po = po, pe = pe, kappa = (po - pe) / (1 - pe))
}
pilot <- runda(60, .78, .72)
glowna <- runda(120, .94, .92)

for (nazwa in c("pilot", "glowna")) {
  d <- get(nazwa); w <- kappa_reka(d)
  cat("\n==", nazwa, "– n =", nrow(d), "momentów\n"); print(addmargins(w$tabela))
  cat(sprintf("zgodność obserwowana po = %.3f, oczekiwana pe = %.3f, kappa = %.3f\n", w$po, w$pe, w$kappa))
  ck <- cohen.kappa(data.frame(as.integer(d$A), as.integer(d$B)))
  print(round(ck$confid[1, ], 2))               # kappa nieważona: dolna granica, oszacowanie, górna granica
}
# odsetek czasu „poza zadaniem” według każdego obserwatora (badanie właściwe)
print(round(100 * prop.table(table(glowna$A))[3], 1)); print(round(100 * prop.table(table(glowna$B))[3], 1))
Wynik w R
== pilot – n = 60 momentów
                        B
A                        praca nad zadaniem rozmowa z rówieśnikiem poza zadaniem Sum
  praca nad zadaniem                     21                     10             3  34
  rozmowa z rówieśnikiem                  2                      7             3  12
  poza zadaniem                           5                      2             7  14
  Sum                                    28                     19            13  60
zgodność obserwowana po = 0.583, oczekiwana pe = 0.378, kappa = 0.330
   lower estimate    upper
    0.14     0.33     0.52

== glowna – n = 120 momentów
                        B
A                        praca nad zadaniem rozmowa z rówieśnikiem poza zadaniem Sum
  praca nad zadaniem                     65                      4             3  72
  rozmowa z rówieśnikiem                  2                     21             1  24
  poza zadaniem                           2                      6            16  24
  Sum                                    69                     31            20 120
zgodność obserwowana po = 0.850, oczekiwana pe = 0.430, kappa = 0.737
   lower estimate    upper
    0.63     0.74     0.84
poza zadaniem
           20
poza zadaniem
         16.7
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Odsetek interwałów z interwału częściowego opisany jako „procent czasu”. To dwie różne wielkości, a różnica bywa kilkukrotna (rysunek 1).
- Zmiana długości interwału między fazami badania. Razem z interwałem zmienia się błąd, więc porównanie faz traci sens.
- Kategorie bez definicji i przypadków granicznych. Obserwatorzy dopowiadają je sami, a zgodność spada.
- Zgodność liczona tylko na początku badania albo tylko na nagraniach treningowych. Nie wykryjesz dryfu obserwatorów.
- Obserwator, który zna hipotezę i przydział do grup. Jego oczekiwania mogą przesunąć zapis.
- Sama kappa bez tabeli zgodności. Tabela pokazuje, które kategorie się mylą, i podpowiada, co poprawić w instrukcji.
- Brak informacji o sesjach adaptacyjnych i zgodach w opisie procedury.
Plan całej analizy, od opisu próby po testy hipotez, znajdziesz w przewodniku po statystyce w pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził Twój system kategorii, plan próbkowania i obliczenia zgodności, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czym różni się próbkowanie zdarzeniowe od próbkowania czasowego w obserwacji?
W próbkowaniu zdarzeniowym zapisujesz każde wystąpienie zachowania, więc dostajesz liczbę zdarzeń, ich częstość i ewentualnie czas trwania. W próbkowaniu czasowym dzielisz sesję na interwały albo momenty i zaznaczasz tylko, czy zachowanie wystąpiło według przyjętej reguły. Daje to odsetek interwałów, który przy interwale częściowym i pełnym nie jest równy odsetkowi czasu.
Którą metodę próbkowania czasowego wybrać, żeby oszacować czas trwania zachowania?
Próbkowanie momentalne. W badaniu Powella i in. (1975) jego błędy rozkładały się w obie strony, podczas gdy interwał pełny systematycznie zaniżał, a częściowy zawyżał wynik. W naszej symulacji próbkowanie momentalne trafiało średnio w prawdziwe 20%, ale przy interwale 30 s i krótkiej lekcji pojedynczy wynik był mniej dokładny. Wybierz więc krótszy interwał albo dłuższe sesje.
Czy w pracy licencjackiej mogę sam(a) prowadzić obserwację bez drugiego obserwatora?
Możesz kodować całość sam(a), ale część sesji, najlepiej losowo wybraną i rozłożoną w czasie badania, powinna niezależnie zakodować druga przeszkolona osoba. Bez tego nie pokażesz, że wynik nie zależy od tego, kto kodował. W pracy podaj, jaki odsetek sesji kodowano podwójnie, oraz kappę z przedziałem ufności i procent zgodności.
Dlaczego obserwatorzy nie powinni wiedzieć, które sesje są sprawdzane?
Bo zgodność sprawdzana jawnie bywa zawyżona. Romanczyk i in. (1973) stwierdzili, że gdy obserwatorzy wiedzieli, kto i kiedy ich sprawdza, zgadzali się z tą osobą wyraźnie lepiej, a przy ukrytej kontroli zgodność spadała. Kazdin (1977) zalicza tę reaktywność kontroli i dryf obserwatorów do głównych źródeł artefaktów.
Czy w obserwacji uczestniczącej trzeba liczyć kappę?
Zwykle nie. Obserwacja uczestnicząca daje notatki terenowe analizowane jakościowo, a jej jakość opisuje się kryteriami wiarygodności, takimi jak triangulacja i refleksyjność badacza. Kappę liczy się wtedy, gdy kilka osób przypisuje te same fragmenty do z góry ustalonych kategorii.
Powiązane hasła
Przeczytaj też
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikBadanie jednego przypadku (single-case)
Schematy ABAB i wielokrotnej linii bazowej, analiza wizualna w liczbach, NAP, Tau-U i jego pułapki, test randomizacyjny, SCRIBE i kod R.
Czytaj →PoradnikRodzaje trafności – mapa dowodów
Tradycyjne nazwy trafności na mapie pięciu źródeł dowodów (Standards, 2014): jak zebrać dowód, jaka analiza, jak opisać w pracy i które 2–3 rodzaje dowodów zaplanować.
Czytaj →Prowadzisz obserwację do pracy i nie wiesz, jak policzyć zgodność?
Sprawdzimy system kategorii i plan próbkowania, policzymy zgodność obserwatorów i dalsze analizy oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altmann, J. (1974). Observational study of behavior: Sampling methods. Behaviour, 49(3–4), 227–266. https://doi.org/10.1163/156853974x00534
- Bakeman, R., & Quera, V. (2011). Sequential analysis and observational methods for the behavioral sciences. Cambridge University Press. https://doi.org/10.1017/cbo9781139017343
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Hallgren, K. A. (2012). Computing inter-rater reliability for observational data: An overview and tutorial. Tutorials in Quantitative Methods for Psychology, 8(1), 23–34. https://doi.org/10.20982/tqmp.08.1.p023 ● Otwarty dostęp
- Johnson, S. M., & Bolstad, O. D. (1975). Reactivity to home observation: A comparison of audio recorded behavior with observers present or absent. Journal of Applied Behavior Analysis, 8(2), 181–185. https://doi.org/10.1901/jaba.1975.8-181 ● Otwarty dostęp
- Kazdin, A. E. (1977). Artifact, bias, and complexity of assessment: The ABCs of reliability. Journal of Applied Behavior Analysis, 10(1), 141–150. https://doi.org/10.1901/jaba.1977.10-141 ● Otwarty dostęp
- Ledford, J. R., Ayres, K. M., Lane, J. D., & Lam, M. F. (2015). Identifying issues and concerns with the use of interval-based systems in single case research using a pilot simulation study. The Journal of Special Education, 49(2), 104–117. https://doi.org/10.1177/0022466915568975
- McCambridge, J., Witton, J., & Elbourne, D. R. (2014). Systematic review of the Hawthorne effect: New concepts are needed to study research participation effects. Journal of Clinical Epidemiology, 67(3), 267–277. https://doi.org/10.1016/j.jclinepi.2013.08.015 ● Otwarty dostęp
- Powell, J., Martindale, A., & Kulp, S. (1975). An evaluation of time-sample measures of behavior. Journal of Applied Behavior Analysis, 8(4), 463–469. https://doi.org/10.1901/jaba.1975.8-463 ● Otwarty dostęp
- Romanczyk, R. G., Kent, R. N., Diament, C., & O’Leary, K. D. (1973). Measuring the reliability of observational data: A reactive process. Journal of Applied Behavior Analysis, 6(1), 175–184. https://doi.org/10.1901/jaba.1973.6-175 ● Otwarty dostęp
Cytowania BibTeX
@article{altmann1974observational, author={Altmann, Jeanne}, title={{Observational study of behavior: Sampling methods}}, journal={Behaviour}, year={1974}, volume={49}, number={3–4}, pages={227--266}, doi={10.1163/156853974x00534}}@book{bakeman2011sequential, author={Bakeman, Roger and Quera, Vicenç}, title={{Sequential analysis and observational methods for the behavioral sciences}}, year={2011}, publisher={Cambridge University Press}, doi={10.1017/cbo9781139017343}}@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{hallgren2012computing, author={Hallgren, Kevin A.}, title={{Computing inter-rater reliability for observational data: An overview and tutorial}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2012}, volume={8}, number={1}, pages={23--34}, doi={10.20982/tqmp.08.1.p023}}@article{johnson1975reactivity, author={Johnson, Stephen M. and Bolstad, Orin D.}, title={{Reactivity to home observation: A comparison of audio recorded behavior with observers present or absent}}, journal={Journal of Applied Behavior Analysis}, year={1975}, volume={8}, number={2}, pages={181--185}, doi={10.1901/jaba.1975.8-181}}@article{kazdin1977artifact, author={Kazdin, Alan E.}, title={{Artifact, bias, and complexity of assessment: The ABCs of reliability}}, journal={Journal of Applied Behavior Analysis}, year={1977}, volume={10}, number={1}, pages={141--150}, doi={10.1901/jaba.1977.10-141}}@article{ledford2015identifying, author={Ledford, Jennifer R. and Ayres, Kevin M. and Lane, Justin D. and Lam, Man Fung}, title={{Identifying issues and concerns with the use of interval-based systems in single case research using a pilot simulation study}}, journal={The Journal of Special Education}, year={2015}, volume={49}, number={2}, pages={104--117}, doi={10.1177/0022466915568975}}@article{mccambridge2014systematic, author={McCambridge, Jim and Witton, John and Elbourne, Diana R.}, title={{Systematic review of the Hawthorne effect: New concepts are needed to study research participation effects}}, journal={Journal of Clinical Epidemiology}, year={2014}, volume={67}, number={3}, pages={267--277}, doi={10.1016/j.jclinepi.2013.08.015}}@article{powell1975evaluation, author={Powell, J. and Martindale, A. and Kulp, S.}, title={{An evaluation of time-sample measures of behavior}}, journal={Journal of Applied Behavior Analysis}, year={1975}, volume={8}, number={4}, pages={463--469}, doi={10.1901/jaba.1975.8-463}}@article{romanczyk1973measuring, author={Romanczyk, Raymond G. and Kent, Ronald N. and Diament, Charles and O'Leary, K. Daniel}, title={{Measuring the reliability of observational data: A reactive process}}, journal={Journal of Applied Behavior Analysis}, year={1973}, volume={6}, number={1}, pages={175--184}, doi={10.1901/jaba.1973.6-175}}