Pięć typowych projektów w pracy z logopedii
Prace z logopedii mają jedną wspólną cechę: osób badanych jest mało. Kilkanaścioro dzieci z gabinetu, jedna grupa przedszkolna, kilku pacjentów z afazją albo jedno dziecko obserwowane przez kilkanaście sesji terapii. Do tego dochodzą oceny wystawiane przez logopedów, np. ocena zrozumiałości mowy z nagrania, i wyniki prób, które dziecko wykonuje kilka razy. Takie dane wymagają innych decyzji niż sondaż wśród kilkuset osób. Tabela porządkuje pięć projektów, które omawiamy w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Dwie małe grupy | Czy dzieci z opóźnionym rozwojem mowy nazywają mniej obrazków niż rówieśnicy? | wynik próby, 10–15 osób w grupie | dokładny test Manna–Whitneya | korelacja rangowo-dwuseryjna, przesunięcie Hodgesa–Lehmanna |
| 2. Terapia: przed, po, odroczony | Czy po terapii wzrósł odsetek poprawnych realizacji głoski? | te same dzieci w 2–3 pomiarach | test Wilcoxona, test Friedmana | r dla par, W Kendalla |
| 3. Oceny sędziów | Czy logopedzi zgodnie oceniają zrozumiałość mowy? | oceny 2–3 sędziów dla tych samych nagrań | ICC, kappa ważona | ICC i κ z 95% CI |
| 4. Jeden pacjent a grupa kontrolna | Czy wynik pacjenta z afazją odbiega od wyników osób zdrowych? | wynik jednej osoby, 10–20 osób kontrolnych | test Crawforda–Howella | t i jednostronne p |
| 5. Badanie jednego przypadku | Czy poprawa zaczęła się wraz z terapią? | wiele pomiarów jednej osoby w fazach A i B | analiza wizualna, NAP | NAP, Tau |
Wszystkie dane w przykładach są symulowane. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem) i powtórzyć analizy. Podobne problemy, choć na większych próbach, omawiamy w poradnikach statystyka w pracy z pedagogiki i statystyka dla fizjoterapeuty.
Zanim zaczniesz: co oznacza mała próba
Mała próba to przede wszystkim mała moc testu. Aby test t wykrył średni efekt (d = 0.5) z mocą 80% przy α = .05, potrzeba 64 osób w każdej grupie. W pracy z logopedii takich liczebności zwykle nie ma. Button i in. (2013) pokazali, że niska moc szkodzi podwójnie. Zmniejsza szansę wykrycia prawdziwego efektu, a do tego wynik istotny rzadziej odzwierciedla prawdziwy efekt i zwykle przeszacowuje jego wielkość. Z tego wynikają trzy praktyczne zasady:
- Uzasadnij liczebność, zamiast udawać, że policzyłeś moc. Lakens (2022) opisuje kilka uczciwych sposobów, m.in. ograniczenie zasobów (tylu pacjentów było w poradni w czasie badania) i planowanie dokładności oszacowania. Wzory zdań znajdziesz w poradniku dobór liczebności próby.
- Raportuj wielkość efektu z przedziałem ufności. Przy 10–15 osobach przedział jest szeroki i to jest uczciwa informacja dla czytelnika. Wynik nieistotny w małej próbie nie dowodzi braku efektu.
- Pokaż dane surowe. Przy kilkunastu osobach wykres z każdą obserwacją mówi więcej niż średnia, a promotor od razu widzi, czy wynik nie zależy od jednego dziecka.
Testy nieparametryczne są w logopedii częste, ale nie dlatego, że „próba jest mała”. Sięgaj po nie, gdy wynik jest porządkowy (np. kategoria nasilenia), mocno skośny albo ma efekt sufitu, np. gdy większość dzieci nazywa prawie wszystkie obrazki. Przy małych próbach liczy się też to, że testy dokładne (oparte na wszystkich możliwych permutacjach rang) nie wymagają przybliżenia rozkładem normalnym. Ernst (2004) wyjaśnia, w jakich sytuacjach metody permutacyjne dają wnioskowanie dokładne i wolne od założeń o rozkładzie. Ogólne zasady wyboru testu rangowego opisujemy w poradniku testy nieparametryczne krok po kroku.
Badania z udziałem dzieci i pacjentów wymagają zgody opiekunów prawnych, a zwykle także opinii komisji etycznej lub komisji bioetycznej. Wymogi zależą od uczelni i placówki, więc sprawdź je u promotora, zanim zaczniesz zbierać dane. Nagrania głosu są danymi osobowymi, a ich przechowywanie i udostępnianie sędziom opisz w procedurze (zob. świadoma zgoda i RODO w badaniach).
Projekt 1. Dwie małe grupy: test Manna–Whitneya w wersji dokładnej
Przykład: 12 pięciolatków z opóźnionym rozwojem mowy i 14 rówieśników bez trudności rozwiązało autorską próbę słownikową (40 obrazków, wynik to liczba poprawnych nazw). Jeśli korzystasz ze standaryzowanego testu logopedycznego, wynik i jego interpretację bierz z podręcznika testu. Nie przeliczaj norm samodzielnie i pamiętaj, że normy testowe dotyczą populacji, na której je opracowano.
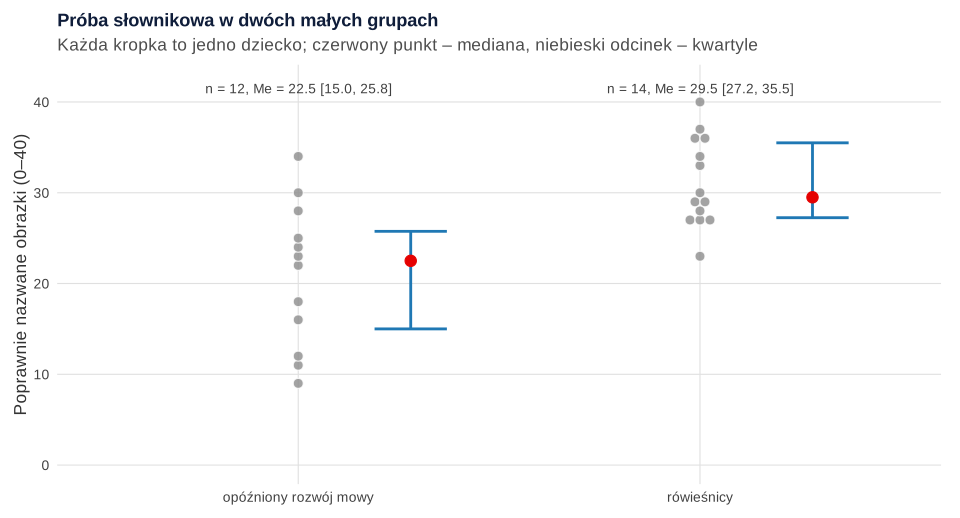
Dzieci z opóźnionym rozwojem mowy uzyskały medianę 22.5 punktu (Q1 = 15.00, Q3 = 25.75), a rówieśnicy – 29.5 (Q1 = 27.25, Q3 = 35.50). W pierwszej grupie wyniki są bardziej rozproszone (SD = 7.91 wobec 4.88). Test Manna–Whitneya w wersji dokładnej dał W = 24, Z = −3.09, p = .001. Wersja dokładna jest tu ważna, bo w danych są wyniki wiązane. Wtedy domyślny test w R przechodzi na przybliżenie normalne, a pakiet coin liczy rozkład dokładny także przy rangach wiązanych.
Wielkością efektu jest korelacja rangowo-dwuseryjna. Kerby (2014) pokazuje, że to po prostu różnica między odsetkiem par „korzystnych” i „niekorzystnych” dla jednej z grup. Tu r = −.71, 95% CI [−.87, −.42]. Znak ujemny oznacza, że w większości par dziecko z opóźnionym rozwojem mowy miało niższy wynik niż rówieśnik. Drugą miarą jest przesunięcie Hodgesa–Lehmanna: mediana wszystkich różnic między parami dzieci z obu grup wyniosła −10.5 punktu, 95% CI [−16, −4]. To liczba w jednostkach próby, łatwa do opisania w dyskusji.
Uważaj na jedno częste zdanie: „test Manna–Whitneya porównuje mediany”. Divine i in. (2018) wykazali na kontrprzykładach, że procedura ta nie testuje median, tylko prawdopodobieństwo, że losowa osoba z jednej grupy ma wynik wyższy niż losowa osoba z drugiej. Fay i Proschan (2010) omawiają różne zestawy założeń, przy których można interpretować wynik testu t i testu Wilcoxona–Manna–Whitneya. Mediany i kwartyle podawaj w opisie, ale wniosek formułuj jako „wyniki były wyższe”, a nie „mediany różniły się istotnie”.
Dla porównania: test t Welcha dał t(17.75) = −3.86, p = .001, g Hedgesa = −1.48, 95% CI [−2.35, −0.57]. Wniosek jest ten sam. Jeśli wynik jest ilościowy i nie ma wyraźnego efektu sufitu, test Welcha jest rozsądnym wyborem także przy kilkunastu osobach. Pokazujemy go w poradniku test t Studenta krok po kroku. Zwróć uwagę na szerokość przedziału dla g: od efektu średniego do bardzo dużego. Tak wygląda precyzja przy 26 osobach.
Projekt 2. Terapia w jednej grupie: przed, po i pomiar odroczony
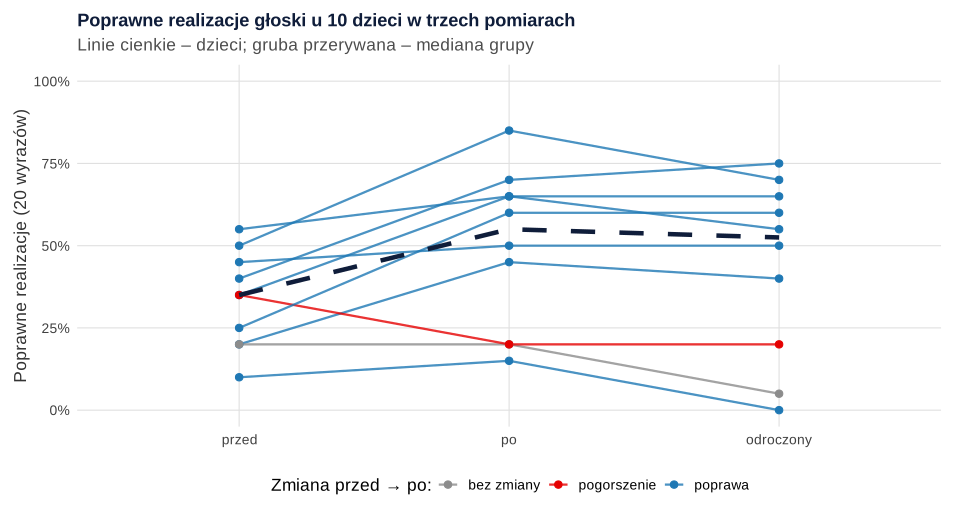
Przykład: 10 dzieci z zaburzeniem realizacji jednej głoski uczestniczyło w trzymiesięcznej terapii. Wynikiem był odsetek poprawnych realizacji głoski docelowej w 20 wyrazach, mierzony przed terapią, po jej zakończeniu i trzy miesiące później (pomiar odroczony). Mediany wyniosły 35.0% przed terapią, 55.0% po terapii i 52.5% w pomiarze odroczonym.
Przed i po: test Wilcoxona
Wynik po terapii był wyższy u ośmiorga dzieci, u jednego się nie zmienił, a u jednego się obniżył. Mediana zmiany wyniosła 17.5 punktu procentowego. Test znakowanych rang Wilcoxona w wersji dokładnej dał V = 41, Z = 2.25, p = .023. Dziecko z różnicą zerową zostało potraktowane metodą Pratta. Pratt (1959) pokazał, że zwykłe usuwanie zer przed rangowaniem może prowadzić do paradoksalnych wyników, i zaproponował rangowanie z zerami i dopiero potem pominięcie ich rang. Korelacja rangowo-dwuseryjna dla par wyniosła r = .82, 95% CI [.43, .95]. Przedział jest szeroki, bo dzieci było tylko dziesięcioro.
Trzy pomiary: test Friedmana
Gdy pomiarów jest więcej niż dwa, zamiast kilku testów Wilcoxona zacznij od testu Friedmana: χ²(2) = 6.53, p = .038. Wielkość efektu opisuje W Kendalla = .33. Porównania parami testem Wilcoxona z korektą Holma nie wskazały jednak żadnej istotnej różnicy. Dla pary przed–po p = .023 przed korektą i .070 po korekcie, a dla pozostałych par p = .188 po korekcie. Taki układ wyników jest typowy dla małych prób i nie ma w nim sprzeczności: test ogólny wykrywa, że pomiary się różnią, ale dziesięcioro dzieci to za mało, aby po korekcie wskazać konkretną parę. Napisz to wprost. Nie usuwaj korekty tylko dlatego, że „psuje” wynik. O wyborze korekty piszemy w poradniku poprawki na wielokrotne porównania.
Najważniejsze zastrzeżenie dotyczy schematu. To schemat pretest–posttest bez grupy kontrolnej. U dzieci w wieku przedszkolnym mowa rozwija się także bez terapii. Do tego dochodzą efekt uczenia się przy ponownym wykonaniu tej samej próby i regresja do średniej, jeśli do terapii kwalifikowano dzieci z najsłabszymi wynikami. Wzrostu nie można więc przypisać wyłącznie terapii. Jeśli chcesz ocenić, czy zmiana u konkretnego dziecka przekracza błąd pomiaru, użyj wskaźnika wiarygodnej zmiany. Pełną procedurę opisujemy w poradniku RCI, MDC i MCID.
Projekt 3. Oceny sędziów: ICC i kappa ważona
Wiele zmiennych w logopedii to oceny wystawiane przez specjalistę: zrozumiałość mowy, nasilenie zaburzenia, poprawność realizacji głoski w nagraniu. Zanim takie oceny trafią do analizy, pokaż, że są rzetelne, czyli że inny logopeda oceniłby nagrania podobnie. W praktyce planuje się to tak: dwóch lub trzech sędziów ocenia niezależnie te same nagrania (wszystkie albo losowo wybraną część), nie znając wyników innych sędziów ani grupy, z której pochodzi nagranie.
Ocena ilościowa: ICC
Trzech logopedów oceniło zrozumiałość mowy w 30 nagraniach na skali od 1 do 7. Średnie sędziów wyniosły 3.77, 4.00 i 3.57, więc jeden sędzia oceniał wyraźnie łagodniej. Dlatego wybieramy ICC w modelu dwuczynnikowym z losowymi sędziami i z definicją zgodności bezwzględnej, która „karze” stałe różnice między sędziami. Koo i Li (2016) wymagają, aby w pracy podać model, typ i definicję ICC, a interpretację oprzeć na 95% przedziale ufności. Dla pojedynczego sędziego ICC wyniosło .77, 95% CI [.62, .87], co według ich wytycznych odpowiada rzetelności umiarkowanej do dobrej. Dla średniej z trzech sędziów ICC wyniosło .91, 95% CI [.83, .95]. Którą wartość raportować? Tę, która odpowiada sposobowi użycia ocen. Jeśli w dalszej analizie użyjesz średniej z trzech sędziów, podaj ICC dla średniej. Jeśli w badaniu głównym nagrania oceni jeden logopeda, podaj ICC dla pojedynczego sędziego.
Kategorie porządkowe: kappa ważona
Dwóch logopedów przypisało 40 nagraniom kategorię nasilenia zaburzenia od 0 do 3. Zgodzili się w 72.5% przypadków, ale część tej zgodności wynika z przypadku. Kappa Cohena, która to koryguje, wyniosła .62, 95% CI [.43, .81]. Kategorie są jednak uporządkowane, a niemal wszystkie niezgodności dotyczyły sąsiednich kategorii. Cohen (1968) zaproponował na taką sytuację kappę ważoną, w której rozbieżność o jedną kategorię waży mniej niż o trzy. Z wagami kwadratowymi kappa wyniosła .86, 95% CI [.78, .94]. Zawsze podaj, jakich wag użyłeś. Sim i Wright (2005) omawiają czynniki wpływające na wartość kappy, m.in. częstość kategorii i różnice w sposobie oceniania między sędziami, a także liczebność potrzebną w badaniach rzetelności.
Ten wpis tylko sygnalizuje wybór miary. Kappę Fleissa, alfę Krippendorffa, paradoksy kappy i procedurę treningu sędziów opisujemy w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa. Plan badania powtarzalności pomiaru, z liczbą osób i powtórzeń, omawiamy w poradniku badanie rzetelności pomiaru klinicznego.
Projekt 4. Jeden pacjent a mała grupa kontrolna: test Crawforda–Howella
W logopedii klinicznej, np. przy afazji, często opisuje się jednego pacjenta i pyta, czy jego wynik odbiega od wyników osób zdrowych. Grupa porównawcza jest zwykle mała: kilkanaście osób dobranych pod względem wieku i wykształcenia. Typowy błąd to przeliczenie wyniku pacjenta na wynik z i odczytanie p z rozkładu normalnego, tak jakby średnia i odchylenie standardowe grupy kontrolnej były parametrami populacji. Crawford i Howell (1998) zalecają, aby przy małej próbie kontrolnej (N < 50) porównywać wynik osoby zmodyfikowanym testem t, w którym pacjent jest traktowany jak próba licząca jedną osobę.
Przykład: pacjent z afazją uzyskał 41 punktów w próbie nazywania, a 15 osób kontrolnych – średnio 51.33 (SD = 5.92). Test Crawforda–Howella dał t(14) = −1.69, p = .057 (jednostronnie). Błędne podejście z wynikiem z = −1.74 dałoby p = .041, czyli wynik „istotny”. Różnica jest niewielka, ale przy granicznych wynikach rozstrzyga o wniosku. Jednostronne p z tego testu można też czytać jako szacowany odsetek osób z populacji kontrolnej, które uzyskałyby wynik niższy niż pacjent, tu około 5.7%.
Projekt 5. Badanie jednego przypadku: schemat AB i NAP
Badanie jednego przypadku (single-case design) to coś więcej niż opis pacjenta. Wynik jednej osoby mierzy się wielokrotnie, najpierw bez terapii (faza A, linia bazowa), potem w trakcie terapii (faza B). Ocenia się, czy zmiana pojawia się wtedy, gdy zaczyna się interwencja. Byiers i in. (2012) przeglądają takie schematy w badaniach logopedycznych. Omawiają ich wymagania, zalety i wady oraz sposoby oceny efektu i uznają je za elastyczną alternatywę dla badań grupowych. Najprostszy jest schemat AB. Mocniejsze są schematy z wycofaniem interwencji (ABAB) i z wielokrotną linią bazową, w których terapia zaczyna się w różnym czasie u kilku osób lub dla kilku głosek. W schemacie AB poprawę mógł wywołać także rozwój dziecka albo zdarzenie zbieżne w czasie z początkiem terapii, więc wnioski z niego są słabsze.
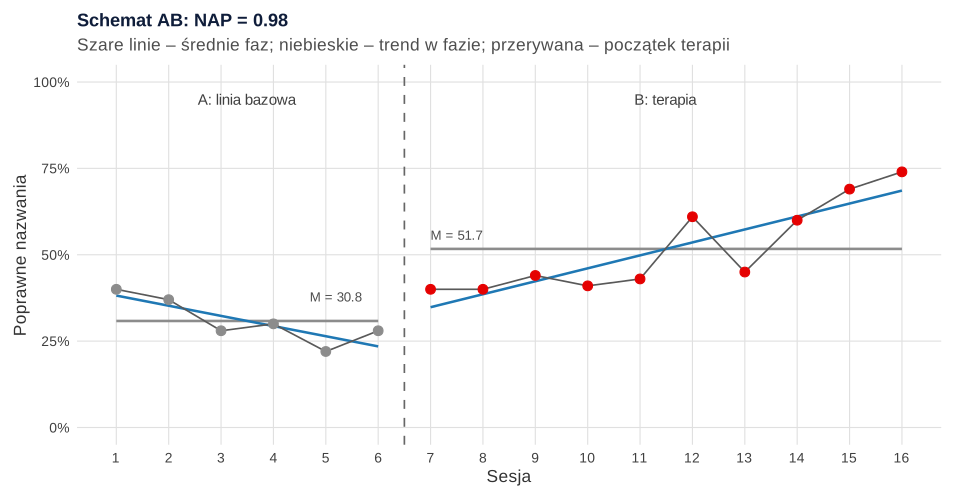
Podstawą jest analiza wizualna. Porównaj poziom (średnio 30.8% w fazie A i 51.7% w fazie B), trend (w linii bazowej wynik spadał o 2.94 punktu na sesję, w terapii rósł o 3.75), zmienność i to, jak szybko zmiana pojawiła się po wprowadzeniu terapii. Linia bazowa musi być stabilna albo zmierzać w kierunku przeciwnym do oczekiwanego, tak jak tutaj. Jeśli wyniki rosły już przed terapią, wzrostu w fazie B nie da się jej przypisać. Na rysunku widać też, że pierwsze sesje terapii nie odbiegają od najlepszych wyników z linii bazowej, a wyraźny wzrost zaczyna się po kilku sesjach.
Uzupełnieniem analizy wizualnej jest wskaźnik nienakładania się faz. Parker i Vannest (2009) zaproponowali NAP (nonoverlap of all pairs): odsetek wszystkich par „sesja z fazy A – sesja z fazy B”, w których wynik w fazie B jest wyższy (remisy liczy się po połowie). NAP to w gruncie rzeczy statystyka U Manna–Whitneya podzielona przez liczbę par. W teście na 200 opublikowanych kontrastach AB dorównywał innym wskaźnikom nienakładania albo je przewyższał. W przykładzie NAP = .98, a Tau = 2 × NAP − 1 = .97. Jest jednak zastrzeżenie: NAP nie uwzględnia trendu, a kolejne pomiary jednej osoby nie są niezależne, bo lepsze i gorsze dni dziecka przenoszą się na sąsiednie sesje (zob. szereg czasowy). Dlatego nie licz testu Manna–Whitneya na sesjach jak na niezależnych osobach.
Opis badania jednego przypadku możesz sprawdzić z listą SCRIBE 2016, która zawiera 26 punktów raportowania badań jednego przypadku w naukach behawioralnych (Tate i in., 2016). Szczególnie ważne są: dokładny opis uczestnika, schemat i jego uzasadnienie, liczba sesji w każdej fazie, sposób pomiaru zmiennej i jego rzetelność (np. drugi sędzia dla części sesji) oraz wykres wszystkich pomiarów.
Wielkość efektu i zapis APA: ściąga
Przy małych próbach wielkość efektu z przedziałem ufności jest ważniejsza niż sama wartość p. Tabela zbiera miary z przykładów w tym wpisie.
| Analiza | Wielkość efektu | Przykład zapisu |
|---|---|---|
| Test Manna–Whitneya (dokładny) | korelacja rangowo-dwuseryjna, przesunięcie Hodgesa–Lehmanna | W = 24, p = .001, r = −.71, 95% CI [−.87, −.42] |
| Test Wilcoxona (dokładny) | korelacja rangowo-dwuseryjna dla par | V = 41, p = .023, r = .82, 95% CI [.43, .95] |
| Test Friedmana | W Kendalla | χ²(2) = 6.53, p = .038, W = .33 |
| ICC | ICC z 95% CI, model i definicja | ICC(2,1) = .77, 95% CI [.62, .87] |
| Kappa ważona | κw z 95% CI, rodzaj wag | κw = .86, 95% CI [.78, .94] |
| Test Crawforda–Howella | szacowany odsetek populacji z niższym wynikiem | t(14) = −1.69, p = .057 (jednostronnie) |
| Schemat AB | NAP, Tau | NAP = .98, Tau = .97 |
W metodzie opisz każde narzędzie: autora, liczbę pozycji lub zadań, sposób liczenia wyniku i źródło norm, jeśli z nich korzystasz. Wzór takiego opisu znajdziesz w poradniku opis narzędzia badawczego – wzór. Autorską próbę (np. listę wyrazów lub obrazków) sprawdź wcześniej na kilkorgu dzieciach w badaniu pilotażowym.
Jeśli potrzebujesz pomocy w doborze analiz do małej próby albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Małe próby, sędziowie i jeden przypadek w R
Cztery przepisy odtwarzają liczby z projektów 1–4, a piąty zapisuje plik XLSX do pobrania. Każdy przepis analityczny tworzy własne dane symulowane, więc możesz go uruchomić osobno (przepis 5 korzysta z obiektów z przepisów 1–4). Testy dokładne liczy pakiet coin, wielkości efektu – effectsize, a ICC i kappę – psych. Pakiety irr i SingleCaseES nie były dostępne w środowisku obliczeń, dlatego NAP liczymy wprost ze wzoru.
1. Dwie małe grupy: dokładny test Manna–Whitneya i Hodges–Lehmann
R
# Projekt 1: dwie małe grupy – dzieci 5-letnie z opóźnionym rozwojem mowy (n = 12) i rówieśnicy (n = 14) (dane symulowane).
# Wynik: liczba poprawnie nazwanych obrazków w autorskiej próbie słownikowej (0–40).
suppressPackageStartupMessages({ library(coin); library(effectsize) })
set.seed(7401)
g1 <- pmin(40, pmax(0, round(rnorm(12, 22, 6.5))))
g2 <- pmin(40, pmax(0, round(rnorm(14, 29, 5))))
p1 <- data.frame(id = 1:26, grupa = factor(rep(c("opóźniony rozwój mowy", "rówieśnicy"), c(12, 14)),
                                             levels = c("opóźniony rozwój mowy", "rówieśnicy")), slownik = c(g1, g2))
opis <- function(x) c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)), M = mean(x), SD = sd(x))
round(t(sapply(split(p1$slownik, p1$grupa), opis)), 2)
# test Manna–Whitneya: dokładny rozkład (coin, poprawny także przy rangach wiązanych) i przesunięcie Hodgesa–Lehmanna
wilcox_test(slownik ~ grupa, data = p1, distribution = "exact", conf.int = TRUE)
wilcox.test(slownik ~ grupa, data = p1, exact = FALSE)$statistic   # statystyka W (U) do opisu
round(unlist(as.data.frame(rank_biserial(slownik ~ grupa, data = p1))[, c(1, 3, 4)]), 2)
# dla porównania: test t Welcha i g Hedgesa
t.test(slownik ~ grupa, data = p1)
round(unlist(as.data.frame(hedges_g(slownik ~ grupa, data = p1, pooled_sd = FALSE))[, c(1, 3, 4)]), 2)
# moc: ile osób w grupie trzeba, aby wykryć d = 0.5 z mocą 80% (test t, α = .05)?
ceiling(power.t.test(delta = 0.5, sd = 1, power = .80)$n)
Wynik w R
                       n   Me    Q1    Q3     M   SD
opóźniony rozwój mowy 12 22.5 15.00 25.75 21.00 7.91
rówieśnicy            14 29.5 27.25 35.50 31.14 4.88

	Exact Wilcoxon-Mann-Whitney Test

data:  slownik by grupa (opóźniony rozwój mowy, rówieśnicy)
Z = -3.0914, p-value = 0.001237
alternative hypothesis: true mu is not equal to 0
95 percent confidence interval:
 -16  -4
sample estimates:
difference in location
                 -10.5

 W
24
r_rank_biserial          CI_low         CI_high
          -0.71           -0.87           -0.42

	Welch Two Sample t-test

data:  slownik by grupa
t = -3.8575, df = 17.754, p-value = 0.001179
alternative hypothesis: true difference in means between group opóźniony rozwój mowy and group rówieśnicy is not equal to 0
95 percent confidence interval:
 -15.672553  -4.613161
sample estimates:
mean in group opóźniony rozwój mowy            mean in group rówieśnicy
                           21.00000                            31.14286

Hedges_g   CI_low  CI_high
   -1.48    -2.35    -0.57
[1] 64
2. Przed, po i odroczony: Wilcoxon, Friedman i W Kendalla
R
# Projekt 2: terapia w jednej grupie – 10 dzieci, odsetek poprawnych realizacji głoski docelowej w 20 wyrazach
# przed terapią, po 3 miesiącach terapii i 3 miesiące po jej zakończeniu (dane symulowane).
set.seed(7445)
przed <- round(pmin(100, pmax(0, rnorm(10, 35, 12))) / 5) * 5
po <- round(pmin(100, pmax(0, przed + rnorm(10, 20, 16))) / 5) * 5
odr <- round(pmin(100, pmax(0, po + rnorm(10, -4, 9))) / 5) * 5
p2 <- data.frame(id = 1:10, przed, po, odroczony = odr)
p2
round(sapply(p2[, -1], function(x) c(Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)))), 1)
# przed–po: test znakowanych rang Wilcoxona, dokładny, zera wg Pratta; korelacja rangowo-dwuseryjna dla par
wilcoxsign_test(po ~ przed, data = p2, distribution = "exact", zero.method = "Pratt")
wilcox.test(p2$po, p2$przed, paired = TRUE, exact = FALSE)$statistic
round(unlist(as.data.frame(rank_biserial(p2$po, p2$przed, paired = TRUE))[, c(1, 3, 4)]), 2)
median(p2$po - p2$przed)
# trzy pomiary: test Friedmana, W Kendalla i porównania parami (Wilcoxon z korektą Holma)
dl <- data.frame(id = factor(rep(p2$id, 3)), pomiar = factor(rep(c("przed", "po", "odroczony"), each = 10), levels = c("przed", "po", "odroczony")),
                 wynik = c(p2$przed, p2$po, p2$odroczony))
friedman.test(wynik ~ pomiar | id, data = dl)
round(unlist(as.data.frame(kendalls_w(wynik ~ pomiar | id, data = dl))[, c(1, 3, 4)]), 2)
pary <- list(c("przed", "po"), c("przed", "odroczony"), c("po", "odroczony"))
pw <- sapply(pary, function(pp) pvalue(wilcoxsign_test(as.formula(paste(pp[2], "~", pp[1])), data = p2, distribution = "exact", zero.method = "Pratt")))
data.frame(para = sapply(pary, paste, collapse = " – "), p = round(pw, 3), p_Holm = round(p.adjust(pw, "holm"), 3))
Wynik w R
   id przed po odroczony
1   1    35 65        65
2   2    45 50        50
3   3    10 15         0
4   4    55 65        55
5   5    40 70        75
6   6    50 85        70
7   7    20 45        40
8   8    20 20         5
9   9    35 20        20
10 10    25 60        60
   przed   po odroczony
Me  35.0 55.0      52.5
Q1  21.2 26.2      25.0
Q3  43.8 65.0      63.8

	Exact Wilcoxon-Pratt Signed-Rank Test

data:  y by x (pos, neg)
	 stratified by block
Z = 2.2498, p-value = 0.02344
alternative hypothesis: true mu is not equal to 0

 V
41
r_rank_biserial          CI_low         CI_high
           0.82            0.43            0.95
[1] 17.5

	Friedman rank sum test

data:  wynik and pomiar and id
Friedman chi-squared = 6.5294, df = 2, p-value = 0.03821

Kendalls_W     CI_low    CI_high
      0.33       0.11       1.00
               para     p p_Holm
1        przed – po 0.023  0.070
2 przed – odroczony 0.133  0.188
3    po – odroczony 0.094  0.188
3. Zgodność sędziów: ICC i kappa ważona
R
# Projekt 3: oceny sędziów – (a) trzech logopedów ocenia zrozumiałość 30 nagrań na skali 1–7,
# (b) dwóch logopedów kwalifikuje 40 nagrań do kategorii nasilenia 0–3 (dane symulowane).
set.seed(7403)
prawda <- rnorm(30, 4, 1.3)
oceny <- sapply(c(0, 0.3, -0.2), function(b) pmin(7, pmax(1, round(prawda + b + rnorm(30, 0, 0.6)))))
colnames(oceny) <- c("S1", "S2", "S3")
round(colMeans(oceny), 2)
icc <- psych::ICC(oceny, lmer = FALSE)
icc$results[c(2, 5), c("type", "ICC", "lower bound", "upper bound")]   # ICC2 (jeden sędzia) i ICC2k (średnia trzech)
set.seed(7404)
naszl <- sample(0:3, 40, TRUE, prob = c(.3, .35, .25, .1))
s2 <- pmin(3, pmax(0, naszl + sample(c(-1, 0, 1), 40, TRUE, prob = c(.12, .76, .12))))
tab <- table(sedzia_A = factor(naszl, 0:3), sedzia_B = factor(s2, 0:3)); tab
round(100 * sum(diag(tab)) / sum(tab), 1)                        # procent zgodności
k <- psych::cohen.kappa(cbind(naszl, s2))
round(k$confid, 2)                                               # kappa nieważona i ważona (wagi kwadratowe) z 95% CI
Wynik w R
  S1   S2   S3
3.77 4.00 3.57
                       type       ICC lower bound upper bound
Single_random_raters   ICC2 0.7683846   0.6242731   0.8722622
Average_random_raters ICC2k 0.9086967   0.8329023   0.9534572
        sedzia_B
sedzia_A  0  1  2  3
       0  7  2  0  0
       1  2 11  3  0
       2  0  1  6  3
       3  0  0  0  5
[1] 72.5
                 lower estimate upper
unweighted kappa  0.43     0.62  0.81
weighted kappa    0.78     0.86  0.94
4. Jeden przypadek: test Crawforda–Howella i NAP w schemacie AB
R
# Projekt 4: jedna osoba – (a) porównanie pacjenta z afazją z małą grupą kontrolną (test Crawforda–Howella),
# (b) schemat AB: 6 sesji linii bazowej i 10 sesji terapii, odsetek poprawnych nazwań (dane symulowane).
set.seed(7405)
kontrola <- round(rnorm(15, 52, 4.5)); pacjent <- 41
round(c(M = mean(kontrola), SD = sd(kontrola)), 2)
crawford_howell <- function(x, k) { n <- length(k); t <- (x - mean(k)) / (sd(k) * sqrt((n + 1) / n))
  c(t = t, df = n - 1, p_jednostr = pt(t, n - 1), p_dwustr = 2 * pt(-abs(t), n - 1)) }
round(crawford_howell(pacjent, kontrola), 3)
round(c(z_bledny = (pacjent - mean(kontrola)) / sd(kontrola), p_z_jednostr = pnorm((pacjent - mean(kontrola)) / sd(kontrola))), 3)
set.seed(7406)
A <- round(pmin(100, pmax(0, rnorm(6, 30, 6))))
Bf <- round(pmin(100, pmax(0, 28 + 3.8 * (1:10) + rnorm(10, 0, 7))))
p4 <- data.frame(sesja = 1:16, faza = rep(c("A", "B"), c(6, 10)), wynik = c(A, Bf))
p4$wynik
round(tapply(p4$wynik, p4$faza, function(x) c(M = mean(x), Me = median(x), min = min(x), max = max(x))) |> simplify2array(), 1)
# NAP (nonoverlap of all pairs): odsetek par (A, B), w których wynik B jest wyższy; remisy liczone po połowie
pary <- outer(Bf, A, "-")
nap <- (sum(pary > 0) + 0.5 * sum(pary == 0)) / length(pary)
round(c(NAP = nap, Tau = 2 * nap - 1), 2)
# trend linii bazowej (nachylenie na sesję) – czy wzrost nie zaczął się przed terapią?
round(coef(lm(wynik ~ sesja, data = subset(p4, faza == "A")))[2], 2)
round(coef(lm(wynik ~ sesja, data = subset(p4, faza == "B")))[2], 2)
Wynik w R
    M    SD
51.33  5.92
         t         df p_jednostr   p_dwustr
    -1.689     14.000      0.057      0.113
    z_bledny p_z_jednostr
      -1.744        0.041
 [1] 40 37 28 30 22 28 40 40 44 41 43 61 45 60 69 74
       A    B
M   30.8 51.7
Me  29.0 44.5
min 22.0 40.0
max 40.0 74.0
 NAP  Tau
0.98 0.97
sesja
-2.94
sesja
 3.75
5. Zapis danych do pliku XLSX
R
# Plik do pobrania: dane czterech projektów (autor w metadanych: Metodolog.pl)
library(openxlsx)
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z logopedii – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
ark <- list("1_dwie_grupy" = p1, "2_terapia" = p2, "3a_zrozumialosc" = data.frame(nagranie = 1:30, oceny),
            "3b_nasilenie" = data.frame(nagranie = 1:40, sedzia_A = naszl, sedzia_B = s2),
            "4a_crawford" = data.frame(osoba = c("pacjent", paste0("K", 1:15)), wynik = c(pacjent, kontrola)), "4b_schemat_AB" = p4)
for (a in names(ark)) { addWorksheet(wb, a); writeData(wb, a, ark[[a]]); freezePane(wb, a, firstRow = TRUE) }
addWorksheet(wb, "opis")
writeData(wb, "opis", c("Dane symulowane (R, set.seed 7401, 7445, 7403–7406) – metodolog.pl, wpis „Statystyka w pracy z logopedii”.",
                        "1_dwie_grupy: slownik = liczba poprawnie nazwanych obrazków w autorskiej próbie 0–40.",
                        "2_terapia: odsetek poprawnych realizacji głoski docelowej w 20 wyrazach (przed, po, odroczony).",
                        "3a_zrozumialosc: oceny zrozumiałości 1–7 trzech sędziów; 3b_nasilenie: kategorie 0–3 dwóch sędziów.",
                        "4a_crawford: wynik pacjenta i 15 osób kontrolnych; 4b_schemat_AB: faza A = linia bazowa, B = terapia."))
saveWorkbook(wb, "../statystyka-logopedia-dane-przyklad.xlsx", overwrite = TRUE)
spr <- readxl::excel_sheets("../statystyka-logopedia-dane-przyklad.xlsx"); spr
sapply(spr[1:6], function(a) nrow(readxl::read_excel("../statystyka-logopedia-dane-przyklad.xlsx", sheet = a)))
Wynik w R
[1] "1_dwie_grupy"    "2_terapia"       "3a_zrozumialosc" "3b_nasilenie"    "4a_crawford"
[6] "4b_schemat_AB"   "opis"
   1_dwie_grupy       2_terapia 3a_zrozumialosc    3b_nasilenie     4a_crawford   4b_schemat_AB
             26              10              30              40              16              16
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje wilcox.test(), t.test(), friedman.test(), power.t.test() i lm() z pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizach prac z logopedii
- „Wynik nieistotny, więc różnicy nie ma” przy 10–15 osobach. Mała próba ma małą moc, a brak istotności nie jest dowodem braku efektu (Button i in., 2013).
- Test nieparametryczny z odruchu i opis wyniku jako „różnica median”. Test Manna–Whitneya nie porównuje median (Divine i in., 2018).
- Przybliżone p zamiast dokładnego przy kilkunastu osobach i wynikach wiązanych.
- Kilka testów Wilcoxona bez testu ogólnego i bez korekty przy trzech lub więcej pomiarach.
- „Terapia była skuteczna” na podstawie pomiaru przed i po bez grupy kontrolnej, u dzieci, których mowa rozwija się z wiekiem.
- Brak rzetelności ocen, gdy zmienną jest ocena logopedy, albo podanie ICC bez modelu i definicji.
- Wynik z pacjenta względem małej grupy kontrolnej zamiast testu Crawforda–Howella.
- Test statystyczny na sesjach jednego dziecka traktowanych jak niezależne osoby, bez analizy wizualnej i bez oceny trendu w linii bazowej.
- Normy przeliczone samodzielnie albo przedruk zadań testu standaryzowanego w aneksie pracy bez zgody właściciela praw.
Najczęstsze pytania
Jaki test statystyczny wybrać do pracy z logopedii przy małej grupie dzieci?
Dwie niezależne grupy porównaj dokładnym testem Manna–Whitneya albo testem t Welcha, gdy wynik jest ilościowy i niezbyt skośny. Te same dzieci w dwóch pomiarach porównaj testem Wilcoxona, a w trzech – testem Friedmana. Zawsze dodaj wielkość efektu z 95% przedziałem ufności i pokaż wyniki każdego dziecka na wykresie.
Ile dzieci trzeba zbadać do pracy magisterskiej z logopedii?
Nie ma jednej liczby: do wykrycia średniego efektu testem t z mocą 80% potrzeba około 64 osób w grupie, czego w logopedii zwykle nie da się osiągnąć. Uzasadnij liczebność dostępnością pacjentów i czasem badania, podawaj przedziały ufności i formułuj wnioski ostrożnie. Przy bardzo małej liczbie osób rozważ schemat jednego przypadku z wieloma pomiarami.
Jak sprawdzić zgodność ocen dwóch logopedów?
Gdy oceny są liczbowe, np. zrozumiałość na skali 1–7, policz ICC i podaj jego model, typ i definicję. Gdy logopedzi przypisują kategorie uporządkowane, np. stopień nasilenia, policz kappę ważoną i podaj rodzaj wag. Część nagrań powinna być oceniona niezależnie przez obu sędziów, bez znajomości grupy dziecka.
Jak porównać wynik jednego pacjenta z afazją z grupą kontrolną?
Przy małej grupie kontrolnej użyj zmodyfikowanego testu t Crawforda i Howella, który traktuje pacjenta jak jednoosobową próbę. Nie przeliczaj wyniku na z i nie odczytuj p z rozkładu normalnego, bo przy kilkunastu osobach kontrolnych zawyża to istotność. Podaj średnią i odchylenie standardowe grupy kontrolnej oraz t, df i p.
Czym jest schemat AB w badaniu jednego przypadku w logopedii?
To wielokrotny pomiar jednej osoby najpierw bez terapii (faza A, linia bazowa), a potem w trakcie terapii (faza B). Efekt ocenia się wizualnie, porównując poziom, trend i zmienność w fazach, oraz wskaźnikiem nienakładania się faz, np. NAP. Schemat AB nie wyklucza wpływu rozwoju dziecka, więc mocniejsze są schematy z wycofaniem interwencji lub z wielokrotną linią bazową.
Powiązane hasła
Przeczytaj też
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikRCI, MDC i MCID
SEM, MDC95, RCI i kryteria Jacobsona–Truaxa, MCID z kotwicy i metod rozkładowych, analiza responderów z 95% CI i koszt dychotomizacji – z kodem R.
Czytaj →Piszesz pracę z logopedii i masz kilkanaście osób w badaniu?
Pomożemy dobrać analizy do małej próby, ocen sędziów albo badania jednego przypadku, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Byiers, B. J., Reichle, J., & Symons, F. J. (2012). Single-subject experimental design for evidence-based practice. American Journal of Speech-Language Pathology, 21(4), 397–414. https://doi.org/10.1044/1058-0360(2012/11-0036) ● Otwarty dostęp: pełny tekst
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Crawford, J. R., & Howell, D. C. (1998). Comparing an individual’s test score against norms derived from small samples. The Clinical Neuropsychologist, 12(4), 482–486. https://doi.org/10.1076/clin.12.4.482.7241
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Ernst, M. D. (2004). Permutation methods: A basis for exact inference. Statistical Science, 19(4), 676–685. https://doi.org/10.1214/088342304000000396 ● Otwarty dostęp
- Fay, M. P., & Proschan, M. A. (2010). Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules. Statistics Surveys, 4, 1–39. https://doi.org/10.1214/09-SS051 ● Otwarty dostęp
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Parker, R. I., & Vannest, K. (2009). An improved effect size for single-case research: Nonoverlap of all pairs. Behavior Therapy, 40(4), 357–367. https://doi.org/10.1016/j.beth.2008.10.006
- Pratt, J. W. (1959). Remarks on zeros and ties in the Wilcoxon signed rank procedures. Journal of the American Statistical Association, 54(287), 655–667. https://doi.org/10.1080/01621459.1959.10501526
- Sim, J., & Wright, C. C. (2005). The kappa statistic in reliability studies: Use, interpretation, and sample size requirements. Physical Therapy, 85(3), 257–268. https://doi.org/10.1093/ptj/85.3.257
- Tate, R. L., Perdices, M., Rosenkoetter, U., Shadish, W., Vohra, S., Barlow, D. H., Horner, R., Kazdin, A., Kratochwill, T., McDonald, S., Sampson, M., Shamseer, L., Togher, L., Albin, R., Backman, C., Douglas, J., Evans, J. J., Gast, D., Manolov, R., . . . Wilson, B. (2016). The Single-Case Reporting Guideline In BEhavioural Interventions (SCRIBE) 2016 statement. Archives of Scientific Psychology, 4(1), 1–9. https://doi.org/10.1037/arc0000026 ● Otwarty dostęp
Cytowania BibTeX
@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{byiers2012single, author={Byiers, Breanne J. and Reichle, Joe and Symons, Frank J.}, title={{Single-subject experimental design for evidence-based practice}}, journal={American Journal of Speech-Language Pathology}, year={2012}, volume={21}, number={4}, pages={397--414}, doi={10.1044/1058-0360(2012/11-0036)}}@article{cohen1968weighted, author={Cohen, Jacob}, title={{Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={4}, pages={213--220}, doi={10.1037/h0026256}}@article{crawford1998comparing, author={Crawford, John R. and Howell, David C.}, title={{Comparing an individual’s test score against norms derived from small samples}}, journal={The Clinical Neuropsychologist}, year={1998}, volume={12}, number={4}, pages={482--486}, doi={10.1076/clin.12.4.482.7241}}@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{ernst2004permutation, author={Ernst, Michael D.}, title={{Permutation methods: A basis for exact inference}}, journal={Statistical Science}, year={2004}, volume={19}, number={4}, pages={676--685}, doi={10.1214/088342304000000396}}@article{fay2010wilcoxon, author={Fay, Michael P. and Proschan, Michael A.}, title={{Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules}}, journal={Statistics Surveys}, year={2010}, volume={4}, pages={1--39}, doi={10.1214/09-ss051}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{parker2009improved, author={Parker, Richard I. and Vannest, Kimberly}, title={{An improved effect size for single-case research: Nonoverlap of all pairs}}, journal={Behavior Therapy}, year={2009}, volume={40}, number={4}, pages={357--367}, doi={10.1016/j.beth.2008.10.006}}@article{pratt1959remarks, author={Pratt, John W.}, title={{Remarks on zeros and ties in the Wilcoxon signed rank procedures}}, journal={Journal of the American Statistical Association}, year={1959}, volume={54}, number={287}, pages={655--667}, doi={10.1080/01621459.1959.10501526}}@article{sim2005kappa, author={Sim, Julius and Wright, Chris C.}, title={{The kappa statistic in reliability studies: Use, interpretation, and sample size requirements}}, journal={Physical Therapy}, year={2005}, volume={85}, number={3}, pages={257--268}, doi={10.1093/ptj/85.3.257}}@article{tate2016scribe, author={Tate, Robyn L. and Perdices, Michael and Rosenkoetter, Ulrike and Shadish, William and Vohra, Sunita and Barlow, David H. and Horner, Robert and Kazdin, Alan and Kratochwill, Thomas and McDonald, Skye and Sampson, Margaret and Shamseer, Larissa and Togher, Leanne and Albin, Richard and Backman, Catherine and Douglas, Jacinta and Evans, Jonathan J. and Gast, David and Manolov, Rumen and Mitchell, Geoffrey and Nickels, Lyndsey and Nikles, Jane and Ownsworth, Tamara and Rose, Miranda and Schmid, Christopher H. and Wilson, Barbara}, title={{The Single-Case Reporting Guideline In BEhavioural Interventions (SCRIBE) 2016 statement}}, journal={Archives of Scientific Psychology}, year={2016}, volume={4}, number={1}, pages={1--9}, doi={10.1037/arc0000026}}