Po co mapa rodzajów trafności
W podręcznikach i pracach dyplomowych pojawia się kilkanaście nazw: trafność treściowa, fasadowa, kryterialna, prognostyczna, diagnostyczna, teoretyczna, zbieżna, różnicowa, przyrostowa, ekologiczna, do tego sieć nomologiczna, metoda grup znanych i macierz MTMM. Łatwo odnieść wrażenie, że to osobne „trafności”, które trzeba po kolei „zaliczyć”. Tak nie jest.
Współcześnie trafność to stopień, w jakim dowody empiryczne wspierają interpretację wyników do zamierzonego użycia, a nie statystyczna właściwość testu (Hawkins i in., 2018). Kane (2013) dodaje, że walidujesz konkretną interpretację lub użycie wyniku, a im ambitniejsze twierdzenie, tym więcej dowodów potrzeba. Tradycyjne nazwy opisują więc rodzaje dowodów, a nie rodzaje trafności. Definicję i historię pojęcia znajdziesz w haśle trafność w psychometrii, a całą drogę budowy narzędzia w poradniku jak zbudować i zwalidować skalę psychometryczną.
Ten wpis jest mapą. Pokazuje, gdzie każda nazwa trafia w układzie pięciu źródeł dowodów, jak zebrać dany dowód, jaką analizą go sprawdzić i jak opisać go w pracy. Szczegóły są w osobnych hasłach i poradnikach, do których prowadzą linki.
Pięć źródeł dowodów według Standards
Punktem odniesienia są Standards for Educational and Psychological Testing (American Educational Research Association i in., 2014). Według omówienia Hawkinsa i in. (2018) wyróżniają one pięć źródeł dowodów trafności:
- Treść testu – związek tematów, sformułowań i formatu pozycji z konstruktem, a także sposób badania i punktowania.
- Procesy odpowiadania – procesy poznawcze i sposób rozumienia pozycji przez badanych i użytkowników wyników, porównane z zamierzoną interpretacją.
- Struktura wewnętrzna – czy wzajemne związki pozycji odpowiadają konstruktowi, na którym opiera się interpretacja.
- Związki z innymi zmiennymi – czy wzorzec związków wyniku ze zmiennymi zewnętrznymi jest taki, jakiego wymaga teoria.
- Konsekwencje użycia – zamierzone i niezamierzone skutki stosowania wyników.
Cook i Beckman (2006) streszczają to praktycznie: do struktury wewnętrznej należą rzetelność i struktura czynnikowa, a rzetelne wyniki są warunkiem koniecznym, ale niewystarczającym trafnej interpretacji. Messick (1995) opisał wcześniej podobny układ jako sześć aspektów jednej trafności teoretycznej, z osobnym aspektem uogólnialności. Hawkins i in. (2018) omawiają uogólnianie trafności w ramach związków z innymi zmiennymi.
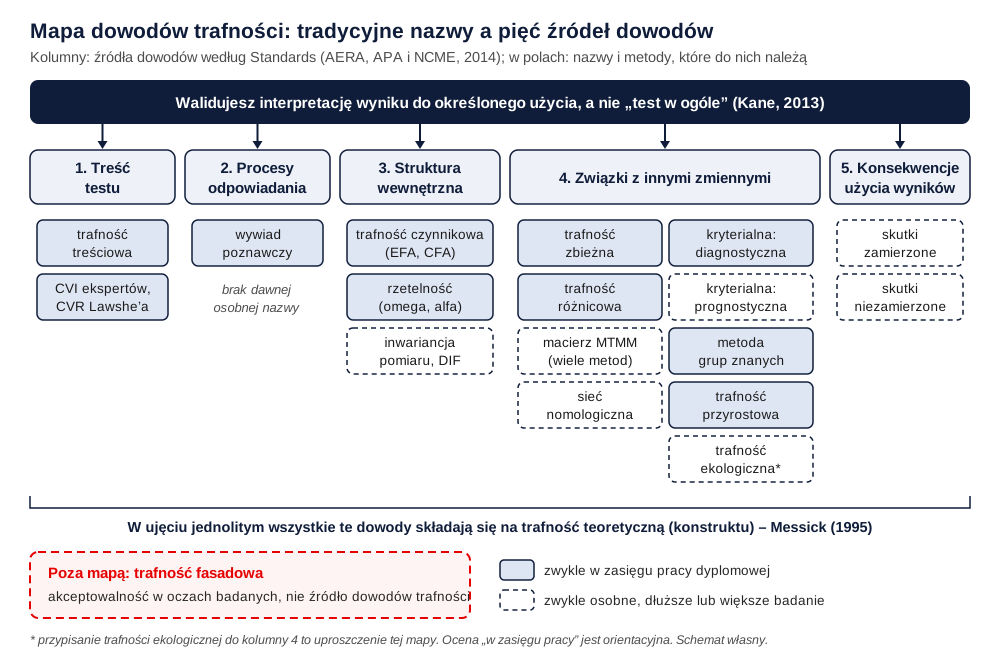
Tradycyjne nazwy na mapie
Klasyczny podział Cronbacha i Meehla (1955) obejmował cztery typy: trafność predykcyjną, równoczesną, treściową i teoretyczną. Dwie pierwsze opierają się na kryterium i różnią się tym, czy kryterium mierzy się później, czy w tym samym czasie co test. Dzisiejsze nazwy trafiają na mapę tak:
- Treść testu: trafność treściowa z ocenami ekspertów i wskaźnikami CVI oraz CVR Lawshe'a.
- Procesy odpowiadania: nie mają dawnej osobnej nazwy. Typowym dowodem jest wywiad poznawczy, który według Petersona i in. (2017) dostarcza dowodów opartych zarówno na treści, jak i na procesach odpowiadania.
- Struktura wewnętrzna: trafność czynnikowa (CFA, EFA), rzetelność, inwariancja pomiaru i DIF.
- Związki z innymi zmiennymi: największa grupa. Należą do niej trafność zbieżna i różnicowa, sprawdzane także macierzą MTMM (Campbell i Fiske, 1959), trafność kryterialna w dwóch odmianach: diagnostycznej (równoczesnej) i prognostycznej, a także metoda grup znanych, trafność przyrostowa, sieć nomologiczna i trafność ekologiczna. Przypisanie tej ostatniej do związków z innymi zmiennymi to uproszczenie naszej mapy.
- Konsekwencje: skutki użycia wyników, np. decyzji przesiewowych. Kane (2013) podkreśla, że ocena użycia wyników wymaga oceny jego konsekwencji, a poważne negatywne skutki mogą sprawić, że takie użycie jest nie do przyjęcia.
Trafność teoretyczna nie jest szóstą kolumną. W ujęciu jednolitym to parasol nad wszystkimi dowodami (Messick, 1995). Poza mapą zostaje trafność fasadowa: mówi o akceptowalności narzędzia, a nie o tym, co mierzy wynik. W naukach o zdrowiu spotkasz też terminologię COSMIN. Mokkink i in. (2010) opisują międzynarodowy konsensus co do taksonomii i definicji właściwości pomiarowych narzędzi, w którym dużo dyskusji dotyczyło miejsca responsywności. Jeśli piszesz pracę z pielęgniarstwa lub fizjoterapii, sprawdź, której terminologii używa Twoja dziedzina, i trzymaj się jednej.
Dowód → jak zebrać → analiza → jak opisać
Tabela zbiera wszystkie rodzaje dowodów w jednym miejscu. Kolumna „jak opisać” mówi, jakie informacje musi zawierać zdanie w rozdziale metodologicznym lub w wynikach.
| Dowód (źródło) | Jak zebrać | Analiza | Jak opisać w pracy |
|---|---|---|---|
| Trafność treściowa (treść) | panel ekspertów ocenia każdą pozycję względem pisemnej definicji konstruktu | I-CVI, S-CVI, CVR | kto oceniał i z jakimi kwalifikacjami, skala ocen, wskaźniki dla pozycji i skali, co zmieniono |
| Wywiad poznawczy (procesy odpowiadania) | rozmowy z osobami z grupy docelowej: głośne myślenie, pytania o rozumienie pozycji | jakościowe kodowanie problemów; tabela „problem → poprawka” | liczba osób i rund, typy problemów, zmienione pozycje |
| Trafność czynnikowa (struktura) | próba główna; model zapisany przed analizą | CFA (dla odpowiedzi porządkowych estymator WLSMV), EFA przy nowej skali; omega | model, estymator, CFI, TLI, RMSEA z CI, SRMR, zakres ładunków, omega |
| Inwariancja pomiaru, DIF (struktura) | dwie grupy lub dwa pomiary, każda podgrupa odpowiednio liczna | wielogrupowa CFA: poziom konfiguralny, metryczny, skalarny; testy DIF | osiągnięty poziom i co z niego wynika dla porównań średnich |
| Trafność zbieżna i różnicowa (związki) | w tym samym badaniu skale konstruktów bliskich i odległych | korelacje z 95% CI; w SEM AVE i HTMT | przewidywany i uzyskany kierunek i siła związku, rozbieżności |
| Macierz MTMM (związki) | co najmniej dwie cechy mierzone co najmniej dwiema metodami, np. samoopis i ocena bliskiej osoby | kryteria Campbella i Fiske'a, CFA-MTMM | układ cech i metod, porównanie korelacji w macierzy |
| Trafność diagnostyczna (związki) | kryterium w tym samym czasie, np. niezależna diagnoza kliniczna | korelacja z kryterium; krzywa ROC, AUC, czułość i swoistość | kryterium i kto je ustalał, AUC z CI, punkt odcięcia i sposób jego wyboru |
| Trafność prognostyczna (związki) | kryterium mierzone później, np. po semestrze | korelacja lub regresja z kryterium | odstęp czasu, ubytek próby, współczynnik trafności z CI |
| Metoda grup znanych (związki) | grupy, które według teorii różnią się konstruktem | d z CI dla hipotezy kierunkowej, ROC jako uzupełnienie | jak wyłoniono grupy, hipoteza, d [95% CI], czym jeszcze różnią się grupy |
| Trafność przyrostowa (związki) | nowa skala, istniejące predyktory i kryterium w jednym badaniu | ΔR² w regresji hierarchicznej | kolejność bloków, ΔR² z testem lub CI, rzetelność predyktorów kontrolnych |
| Sieć nomologiczna (związki) | kilka konstruktów wskazanych przez teorię | zestaw przewidywań; wzorzec korelacji lub model SEM | tabela „przewidywanie – wynik – ocena” |
| Trafność ekologiczna (związki) | kryterium z codziennych warunków: obserwacja, dzienniczki, oceny funkcjonowania | korelacja wyniku z miarami codziennego funkcjonowania | w jakich warunkach zebrano kryterium i jak daleko są od warunków testu |
| Konsekwencje (konsekwencje) | dane o decyzjach podejmowanych na podstawie wyniku | np. odsetki błędnych klasyfikacji w podgrupach | w pracy dyplomowej zwykle w dyskusji jako ograniczenie lub kierunek dalszych badań |
| Trafność fasadowa (poza mapą) | oceny respondentów w pilotażu | odsetek ocen wysokich z CI | jako akceptowalność narzędzia, nie dowód trafności |
Przy trafności zbieżnej i różnicowej szczegółowy przykład z AVE i HTMT jest w poradniku trafność zbieżna i różnicowa w CB-SEM. Pozostałe wiersze mają osobne poradniki: metoda grup znanych, macierz MTMM, trafność przyrostowa nowej skali, krzywa ROC i punkt odcięcia oraz analiza czynnikowa EFA i CFA. Hunsley i Meyer (2003) zwracają uwagę, że w badaniach trafności przyrostowej o wyniku decydują m.in. kolejność wprowadzania predyktorów i to, jak zinterpretujesz wielkość przyrostu.
Jak zaplanować walidację w pracy dyplomowej
Nikt nie oczekuje, że w pracy magisterskiej zbierzesz dowody ze wszystkich pięciu źródeł. Realny plan to dwa lub trzy rodzaje dowodów dobrane do tego, jak chcesz interpretować wynik. Zasada Kane'a (2013) działa tu praktycznie: jeśli wynik ma służyć tylko do korelacji w Twoim badaniu, wystarczy mniej dowodów niż wtedy, gdy proponujesz punkt odcięcia do przesiewu.
| Sytuacja | Dowody zwykle w zasięgu | Czego zwykle nie da się zrobić |
|---|---|---|
| Gotowe, zwalidowane narzędzie (większość prac) | dowody z publikacji źródłowej i adaptacji; we własnej próbie rzetelność (omega) i, jeśli próba pozwala, CFA; korelacje zgodne z hipotezami | pełnej walidacji od nowa – i nie jest potrzebna |
| Adaptacja lub tłumaczenie | treść (eksperci), procesy odpowiadania (wywiady poznawcze), struktura (CFA), jedna para związków zbieżnych i różnicowych | trafności prognostycznej i inwariancji między krajami |
| Nowa skala w pracy magisterskiej | treść, struktura, trafność zbieżna i różnicowa albo grupy znane | MTMM, kryterium mierzonego po czasie, konsekwencji |
| Doktorat lub artykuł | jak wyżej oraz inwariancja, kryterium (diagnostyczne lub prognostyczne), trafność przyrostowa, MTMM | konsekwencji użycia – zwykle osobny projekt |
Przy adaptacji przejdź też przez wpis adaptacja kulturowa kwestionariusza, a przy wywiadach przez wywiad poznawczy w pilotażu. Trzy decyzje warto podjąć, zanim zbierzesz dane:
- Dołóż do kwestionariusza miary porównawcze. Trafności zbieżnej, różnicowej ani przyrostowej nie sprawdzisz po fakcie, jeśli nie zmierzysz konstruktów bliskich i odległych. Clark i Watson (2019) zalecają sprawdzanie puli pozycji względem blisko powiązanych konstruktów już na etapie budowy skali.
- Zapisz przewidywania. Kierunek i przybliżona siła każdego związku, różnica między grupami, oczekiwany model czynnikowy. Bez tego każdy wynik da się ogłosić jako „potwierdzenie”.
- Dopasuj próbę do analiz. CFA, inwariancja i grupy znane mają własne wymagania co do liczebności, opisane w podlinkowanych poradnikach. Jeśli próba ich nie spełnia, zaplanuj skromniejszy zestaw dowodów i napisz o tym w ograniczeniach.
Akapit do rozdziału metodologicznego
Wzór poniżej łączy dowody z literatury z dowodami z własnego badania. Ogólną budowę rozdziału omawia wpis rozdział metodologiczny, a opis samego narzędzia – opis narzędzia badawczego. Uzupełnij nawiasy kwadratowe i usuń zdania o dowodach, których nie zbierałeś(-aś).
Ostatnie zdanie jest ważne: mówi recenzentowi, do jakiego użycia masz dowody, a do jakiego nie. Jeśli korzystasz z gotowego narzędzia, pierwsze zdania zastąp przeglądem dowodów z publikacji źródłowej, z podaniem autorów i populacji.
Najczęstsze błędy
- Alfa jako jedyny dowód. Flake i in. (2017) przejrzeli artykuły w Journal of Personality and Social Psychology i stwierdzili, że współczynnik α był często jedynym podawanym wskaźnikiem psychometrycznym. Rzetelność to tylko część dowodów o strukturze wewnętrznej.
- „Skala jest trafna”. Trafna lub nie jest interpretacja wyniku w danej populacji i do danego celu.
- Lista nazw bez danych. Wyliczenie „trafność treściowa, zbieżna, kryterialna” bez procedur i wyników nic nie dowodzi.
- Kryterium, które jest tym samym testem. Korelacja krótkiej i długiej wersji tej samej skali albo dwóch skal z niemal identycznymi pozycjami to słaby dowód trafności kryterialnej.
- Przewidywania dopisane po wynikach. Wtedy każda korelacja „potwierdza” trafność.
- Mylenie trafności narzędzia z trafnością badania. Trafność wewnętrzna i zewnętrzna dotyczą wniosków z całego badania, nie wyniku testu.
Pełną ścieżkę pracy ze skalą zbiera przewodnik po psychometrii i budowie skal. Jeśli chcesz, żeby ktoś sprawdził plan walidacji i opis dowodów trafności w Twojej pracy, zajrzyj do oferty analizy statystyczne dla studentów. Decyzje i wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Ile źródeł dowodów trafności trzeba pokazać w pracy magisterskiej?
Nie ma ustalonej liczby. Przy gotowym, zwalidowanym narzędziu zwykle wystarczy przegląd dowodów z publikacji źródłowej i rzetelność we własnej próbie. Przy nowej lub adaptowanej skali realny zestaw to dwa lub trzy źródła, najczęściej treść (oceny ekspertów), struktura wewnętrzna (CFA) i związki z innymi zmiennymi (trafność zbieżna i różnicowa albo grupy znane). Im ambitniejsza interpretacja, np. punkt odcięcia do przesiewu, tym więcej dowodów potrzeba (Kane, 2013).
Czy wysoka alfa Cronbacha świadczy o trafności skali?
Nie. Alfa dotyczy rzetelności, czyli tylko części dowodów o strukturze wewnętrznej. Rzetelne wyniki są warunkiem koniecznym, ale niewystarczającym trafnej interpretacji (Cook i Beckman, 2006). Flake i in. (2017) pokazali, że w opublikowanych artykułach alfa bywa jedynym podawanym wskaźnikiem psychometrycznym, i uznali to za słabą praktykę. Do alfy lub omegi dołóż choćby korelacje z miarami bliskich i odległych konstruktów.
Gdzie wśród pięciu źródeł dowodów mieści się trafność kryterialna?
W związkach z innymi zmiennymi, jako związek wyniku z kryterium. Gdy kryterium mierzysz w tym samym czasie, mówimy o trafności diagnostycznej (równoczesnej), a gdy później – o prognostycznej. W tej samej grupie dowodów są też trafność zbieżna i różnicowa, metoda grup znanych, trafność przyrostowa i sieć nomologiczna. Różnią się tym, co jest punktem odniesienia: inna miara, kryterium, grupy albo cała teoria.
Czym trafność ekologiczna różni się od trafności zewnętrznej?
Trafność ekologiczna w psychometrii dotyczy tego, czy wynik testu wiąże się z funkcjonowaniem w codziennych warunkach, poza sytuacją badania. Trafność zewnętrzna dotyczy całego badania: czy jego wnioski można uogólnić na inne osoby, miejsca i czasy. Pierwsza jest dowodem trafności narzędzia, druga cechą planu badania.
Czy w pracy można napisać, że skala „jest trafna”?
Lepiej tego unikać. Trafna lub nietrafna jest interpretacja wyniku w określonej populacji i do określonego celu, a dowody mogą ją wspierać mocniej lub słabiej. Napisz raczej, jakie dowody zebrano, z jakich źródeł i do jakiego użycia wyników one wystarczają, np. do celów badawczych, ale nie diagnostycznych.
Powiązane hasła
Przeczytaj też
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikTrafność fasadowa w psychometrii
Czym różni się od trafności treściowej, dlaczego nie jest dowodem trafności, jak ocenić ją w pilotażu na ocenach respondentów (przykład w R) i jak opisać ją w pracy.
Czytaj →PoradnikTrafność zbieżna i różnicowa: AVE i HTMT
AVE i rzetelność złożona z ładunków lavaan, HTMT z bootstrapem, krytyka Fornella–Larckera i co zrobić, gdy dwa konstrukty są trudne do odróżnienia.
Czytaj →PoradnikMetoda grup znanych
Dobór grup, hipotezy z kierunkiem i wielkością efektu, test Welcha i g Hedgesa z 95% CI, ROC jako uzupełnienie i pułapka grup różniących się wieloma cechami – z przykładem w R.
Czytaj →PoradnikTrafność przyrostowa nowej skali
ΔR² z bootstrapowym CI, wagi względne i analiza dominacji, pozorny przyrost przy nierzetelnych miarach kontrolnych, przykład w R i wzór opisu.
Czytaj →PoradnikMacierz MTMM: wiele cech i wiele metod
Kryteria Campbella i Fiske’a, modele CTCM, CTCU i CT-C(M−1) w lavaan, problemy z identyfikacją i przykład 3 cechy × 3 metody.
Czytaj →Planujesz walidację skali i nie wiesz, które dowody trafności zebrać?
Sprawdzimy plan walidacji, dobór miar porównawczych i analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016 ● Otwarty dostęp: pełny tekst
- Clark, L. A., & Watson, D. (2019). Constructing validity: New developments in creating objective measuring instruments. Psychological Assessment, 31(12), 1412–1427. https://doi.org/10.1037/pas0000626 ● Otwarty dostęp
- Cook, D. A., & Beckman, T. J. (2006). Current concepts in validity and reliability for psychometric instruments: Theory and application. The American Journal of Medicine, 119(2), 166.e7–166.e16. https://doi.org/10.1016/j.amjmed.2005.10.036
- Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957 ● Otwarty dostęp: pełny tekst
- Flake, J. K., Pek, J., & Hehman, E. (2017). Construct validation in social and personality research: Current practice and recommendations. Social Psychological and Personality Science, 8(4), 370–378. https://doi.org/10.1177/1948550617693063
- Hawkins, M., Elsworth, G. R., & Osborne, R. H. (2018). Application of validity theory and methodology to patient-reported outcome measures (PROMs): Building an argument for validity. Quality of Life Research, 27(7), 1695–1710. https://doi.org/10.1007/s11136-018-1815-6 ● Otwarty dostęp
- Hunsley, J., & Meyer, G. J. (2003). The incremental validity of psychological testing and assessment: Conceptual, methodological, and statistical issues. Psychological Assessment, 15(4), 446–455. https://doi.org/10.1037/1040-3590.15.4.446
- Kane, M. T. (2013). Validating the interpretations and uses of test scores. Journal of Educational Measurement, 50(1), 1–73. https://doi.org/10.1111/jedm.12000
- Messick, S. (1995). Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning. American Psychologist, 50(9), 741–749. https://doi.org/10.1037/0003-066x.50.9.741
- Mokkink, L. B., Terwee, C. B., Patrick, D. L., Alonso, J., Stratford, P. W., Knol, D. L., Bouter, L. M., & de Vet, H. C. W. (2010). The COSMIN study reached international consensus on taxonomy, terminology, and definitions of measurement properties for health-related patient-reported outcomes. Journal of Clinical Epidemiology, 63(7), 737–745. https://doi.org/10.1016/j.jclinepi.2010.02.006 ● Otwarty dostęp
- Peterson, C. H., Peterson, N. A., & Powell, K. G. (2017). Cognitive interviewing for item development: Validity evidence based on content and response processes. Measurement and Evaluation in Counseling and Development, 50(4), 217–223. https://doi.org/10.1080/07481756.2017.1339564
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{campbell1959convergent, author={Campbell, Donald T. and Fiske, Donald W.}, title={{Convergent and discriminant validation by the multitrait-multimethod matrix}}, journal={Psychological Bulletin}, year={1959}, volume={56}, number={2}, pages={81--105}, doi={10.1037/h0046016}}@article{clark2019constructing, author={Clark, Lee Anna and Watson, David}, title={{Constructing validity: New developments in creating objective measuring instruments}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1412--1427}, doi={10.1037/pas0000626}}@article{cook2006current, author={Cook, David A. and Beckman, Thomas J.}, title={{Current concepts in validity and reliability for psychometric instruments: Theory and application}}, journal={The American Journal of Medicine}, year={2006}, volume={119}, number={2}, pages={166.e7--166.e16}, doi={10.1016/j.amjmed.2005.10.036}}@article{cronbach1955construct, author={Cronbach, Lee J. and Meehl, Paul E.}, title={{Construct validity in psychological tests}}, journal={Psychological Bulletin}, year={1955}, volume={52}, number={4}, pages={281--302}, doi={10.1037/h0040957}}@article{flake2017construct, author={Flake, Jessica K. and Pek, Jolynn and Hehman, Eric}, title={{Construct validation in social and personality research: Current practice and recommendations}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={370--378}, doi={10.1177/1948550617693063}}@article{hawkins2018application, author={Hawkins, Melanie and Elsworth, Gerald R. and Osborne, Richard H.}, title={{Application of validity theory and methodology to patient-reported outcome measures (PROMs): Building an argument for validity}}, journal={Quality of Life Research}, year={2018}, volume={27}, number={7}, pages={1695--1710}, doi={10.1007/s11136-018-1815-6}}@article{hunsley2003incremental, author={Hunsley, John and Meyer, Gregory J.}, title={{The incremental validity of psychological testing and assessment: Conceptual, methodological, and statistical issues}}, journal={Psychological Assessment}, year={2003}, volume={15}, number={4}, pages={446--455}, doi={10.1037/1040-3590.15.4.446}}@article{kane2013validating, author={Kane, Michael T.}, title={{Validating the interpretations and uses of test scores}}, journal={Journal of Educational Measurement}, year={2013}, volume={50}, number={1}, pages={1--73}, doi={10.1111/jedm.12000}}@article{messick1995validity, author={Messick, Samuel}, title={{Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning}}, journal={American Psychologist}, year={1995}, volume={50}, number={9}, pages={741--749}, doi={10.1037/0003-066x.50.9.741}}@article{mokkink2010cosmin, author={Mokkink, Lidwine B. and Terwee, Caroline B. and Patrick, Donald L. and Alonso, Jordi and Stratford, Paul W. and Knol, Dirk L. and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{The COSMIN study reached international consensus on taxonomy, terminology, and definitions of measurement properties for health-related patient-reported outcomes}}, journal={Journal of Clinical Epidemiology}, year={2010}, volume={63}, number={7}, pages={737--745}, doi={10.1016/j.jclinepi.2010.02.006}}@article{peterson2017cognitive, author={Peterson, Christina Hamme and Peterson, N. Andrew and Powell, Kristen Gilmore}, title={{Cognitive interviewing for item development: Validity evidence based on content and response processes}}, journal={Measurement and Evaluation in Counseling and Development}, year={2017}, volume={50}, number={4}, pages={217--223}, doi={10.1080/07481756.2017.1339564}}