Po co mierzyć kilka cech kilkoma metodami
Nowa skala koreluje .60 z uznanym kwestionariuszem tego samego konstruktu. To wygląda na dowód trafności zbieżnej, ale jeśli oba narzędzia wypełniła ta sama osoba w jednej ankiecie, część tej korelacji może wynikać ze sposobu pomiaru: stylu odpowiadania, chęci dobrego wypadnięcia, nastroju. To wspólna wariancja metody. Jednometodowe badanie walidacyjne nie pozwala oddzielić jej od wariancji cechy.
Campbell i Fiske (1959) zaproponowali rozwiązanie, które do dziś jest podstawą oceny trafności teoretycznej: zmierz co najmniej dwie cechy co najmniej dwiema metodami i zestaw wszystkie korelacje w jednej macierzy wielu cech i wielu metod (MTMM). Na tle innych dowodów trafności, które porządkuje wpis rodzaje trafności – mapa dowodów, MTMM jest jedynym schematem, który jednocześnie sprawdza zbieżność, różnicowanie i siłę efektu metody. Prosty przykład 2 × 2 znajdziesz w haśle o trafności zbieżnej. Tu idziemy dalej: układ 3 × 3, formalne kryteria i modele CFA, w których cechy i metody są osobnymi czynnikami.
Jak zaplanować badanie MTMM
| Decyzja | Zalecenie | Dlaczego |
|---|---|---|
| Liczba cech i metod | co najmniej 3 × 3 | Kryteria Campbella i Fiske’a działają już przy 2 × 2, ale modele CFA-MTMM przy małych macierzach często zawodzą (Marsh i Bailey, 1991) |
| Metody | możliwie różne: samoopis, ocena bliskiej osoby, obserwacja, zadanie | Dwa kwestionariusze samoopisowe to w praktyce jedna metoda |
| Cechy | walidowana cecha i dwie cechy pokrewne, ale odrębne | Cechy zupełnie niezwiązane nie sprawdzą różnicowania |
| Rzetelność | wielopozycyjne skale z policzoną α lub ω | Niska rzetelność zaniża wszystkie korelacje w macierzy |
| Model analizy | wybrany przed zebraniem danych, z planem B | Klasyczny model CTCM często nie daje dopuszczalnego rozwiązania |
Przykład: trzy cechy osobowości, trzy źródła ocen
Czterysta osób (dane symulowane, set.seed(2711)) opisało swoją ekstrawersję (EKS), sumienność (SUM) i neurotyczność (NEU) czterema pozycjami 1–5 na każdą cechę. Te same cechy ocenił partner lub partnerka (PA) oraz przyjaciel lub przyjaciółka (PR). Daje to 9 miar: trzy cechy × trzy metody: samoopis (SO), ocena partnera i ocena przyjaciela. W symulacji ocena partnera ma najsilniejszy efekt metody (ogólnie życzliwa ocena przenosi się na wszystkie cechy), a przyjaciele słabo widzą neurotyczność. Dane możesz pobrać jako plik CSV (400 wierszy, 36 pozycji).
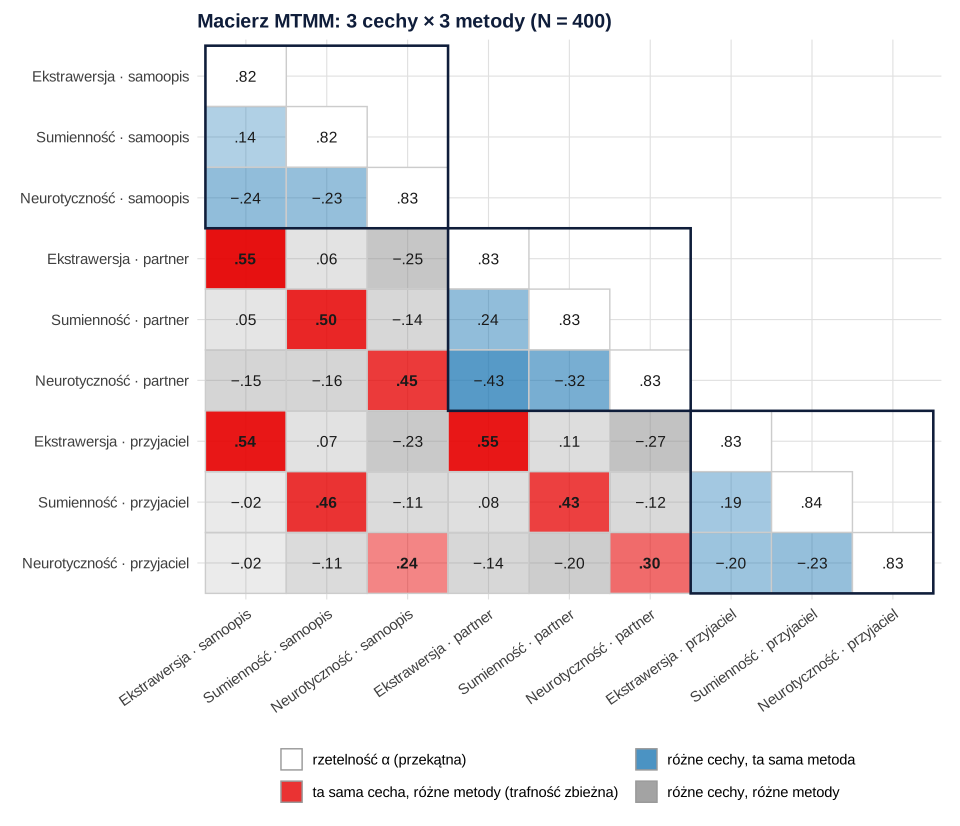
Macierz czyta się blokami. Bloki jednometodowe (w ramkach) zawierają rzetelności i korelacje różnych cech mierzonych tą samą metodą. Bloki różnometodowe mają na przekątnej korelacje tej samej cechy z dwóch źródeł – to przekątne trafności – a poza nią korelacje różnych cech z różnych źródeł. Średnia wartość bezwzględna korelacji wyniosła .45 na przekątnych trafności, .25 w trójkątach jednometodowych i .13 w trójkątach różnometodowych. Ogólny obraz jest więc dobry, ale kryteria trzeba sprawdzić komórka po komórce.
Cztery kryteria Campbella i Fiske’a
Campbell i Fiske (1959) opisali kryteria porównań wewnątrz macierzy. Ponieważ neurotyczność koreluje z pozostałymi cechami ujemnie, porównujemy wartości bezwzględne korelacji Pearsona.
| Kryterium | Co porównujesz | Wynik w przykładzie |
|---|---|---|
| 1. Zbieżność | korelacje na przekątnych trafności są wyraźnie różne od zera | wszystkie 9 od .24, 95% CI [.14, .33], do .55, 95% CI [.47, .61] |
| 2. Różnicowanie a tło | każda wartość trafności > korelacje w tym samym wierszu i kolumnie bloku różnometodowego | 36 z 36 porównań |
| 3. Różnicowanie a metoda | każda wartość trafności > korelacje różnych cech mierzonych tą samą metodą, w których udział biorą te same miary | 33 z 36 porównań |
| 4. Ten sam wzór | układ korelacji między cechami jest podobny we wszystkich trójkątach | znaki zgodne w 9 z 9, kolejność siły w 5 z 9 trójkątów |
Wszystkie trzy porażki kryterium 3 dotyczą neurotyczności w ocenie przyjaciela. Zgodność samoopisu z oceną przyjaciela (.24) nie przewyższa korelacji neurotyczności z ekstrawersją w samoopisie (−.24), a zgodność partnera z przyjacielem (.30) przegrywa z korelacjami neurotyczności z ekstrawersją (−.43) i sumiennością (−.32) w ocenach partnera. Innymi słowy, partner oceniający „dobrze” lub „źle” całą osobę łączy cechy silniej, niż dwóch oceniających zgadza się co do neurotyczności. Kryterium 4 wypada słabiej, bo korelacje różnych cech z różnych źródeł są bliskie zera i ich kolejność łatwo się odwraca; stały pozostaje kierunek (neurotyczność ujemnie z obiema cechami w każdym trójkącie).
Kryteria są czytelne, ale mają ograniczenia: porównania nie uwzględniają różnic w rzetelności miar, nie mają testów istotności i nie mówią, ile wariancji pochodzi z cechy, a ile z metody. Dlatego Widaman (1985) zaproponował zestaw hierarchicznie zagnieżdżonych modeli struktur kowariancji, w których trafność zbieżną, różnicową i wariancję metody sprawdza się porównaniami modeli.
Modele CFA-MTMM: cechy i metody jako czynniki
W modelach CFA-MTMM każdy wynik zależy od czynnika swojej cechy i od efektu swojej metody. Różnią się tym, jak modelują metodę. Wszystkie dopasowaliśmy w pakiecie lavaan (Rosseel, 2012) metodą największej wiarygodności na 9 wynikach skal:
| Model | Jak modeluje metodę | df | Wynik w przykładzie |
|---|---|---|---|
| CTCM (skorelowane cechy, skorelowane metody) | 3 czynniki metody, skorelowane ze sobą, nieskorelowane z cechami | 12 | brak zbieżności |
| CTUM (nieskorelowane metody) | 3 nieskorelowane czynniki metody | 15 | χ² = 26.85, CFI = .987, RMSEA = .044 |
| CTCU (skorelowane reszty) | bez czynników metody; reszty miar tej samej metody skorelowane | 15 | χ² = 26.85, CFI = .987, RMSEA = .044 |
| CT-C(M−1) | czynniki metody dla wszystkich metod poza metodą odniesienia (tu samoopis) | 17 | χ² = 22.37, CFI = .994, RMSEA = .028 |
Identyczne χ² modeli CTUM i CTCU nie są przypadkiem: przy trzech cechach trzy kowariancje reszt w obrębie metody i trzy ładunki nieskorelowanego czynnika metody odtwarzają ten sam zbiór kowariancji. Modele są równoważne i dopasowanie ich nie rozróżni. W modelu CTCU korelacje cech wyniosły .11 dla ekstrawersji i sumienności, −.42 dla ekstrawersji i neurotyczności oraz −.33 dla sumienności i neurotyczności, a w CT-C(M−1) odpowiednio .13, −.41 i −.33. Wszystkie leżą wyraźnie poniżej 1, więc cechy są odróżnialne. Szczegóły oceny trafności różnicowej w CFA opisuje wpis trafność zbieżna i różnicowa: AVE i HTMT.
Problemy z identyfikacją: dlaczego CTCM tak często zawodzi
CTCM jest najbardziej naturalnym modelem, ale ma złą sławę. Kenny i Kashy (1992) pokazali, że ważny szczególny przypadek tego modelu nie jest zidentyfikowany, a ponieważ większość danych MTMM jest do niego zbliżona, analizy cierpią na empiryczny brak identyfikacji: model formalnie ma dodatnie df, ale w konkretnych danych parametrów nie da się stabilnie oszacować. Marsh (1989) opisał w trzech badaniach częste źle określone rozwiązania i to, że tzw. czynniki metody wchłaniały też wariancję cech.
W naszym przykładzie lavaan zgłosił brak zbieżności. Po zwiększeniu limitu do 20 000 iteracji model „zbiegł” i wyglądał znakomicie: χ²(12) = 13.86, p = .310, CFI = .998, RMSEA = .020. Jednocześnie wariancja resztowa samoopisu sumienności wyniosła −595.59, a błędów standardowych nie dało się policzyć. To przypadek Heywooda, a nie dobry model. Przyczyna jest typowa: czynnik metody samoopisu jest słaby (w symulacji ładunki .25), więc jego trzy ładunki i trzy korelacje z innymi metodami są prawie nieokreślone.
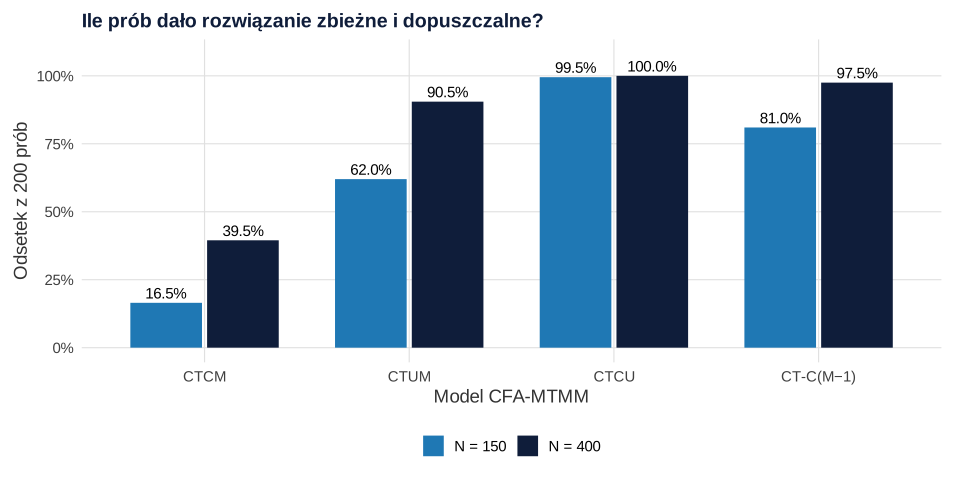
Żeby sprawdzić, czy to pech jednej próby, powtórzyliśmy losowanie 200 razy dla N = 150 i N = 400. CTCM dał dopuszczalne rozwiązanie tylko w 16.5% i 39.5% prób, choć dane pochodziły dokładnie z modelu z czynnikami cech i metod. Model skorelowanych reszt działał prawie zawsze (99.5% i 100%), CT-C(M−1) w 81.0% i 97.5% prób. Ten obraz jest zgodny z symulacjami Marsha i Baileya (1991), w których model skorelowanych reszt dawał rozwiązania dopuszczalne w 96–99% macierzy, a ogólny model z czynnikami metody w 22–24%. Planując badanie MTMM, policz liczebność próby symulacyjnie, tak jak we wpisie liczebność próby do SEM – symulacja Monte Carlo, i sprawdzaj nie tylko moc, ale też odsetek rozwiązań dopuszczalnych.
Czy wobec tego zawsze wybierać skorelowane reszty? Nie. Lance i in. (2002) zwracają uwagę na teoretyczne słabości tego modelu i zalecają traktować CTCM jako model preferowany, a skorelowane reszty jako wyjście awaryjne. Model CTCU zakłada nieskorelowane metody i nie daje czynnika metody, który można by powiązać z innymi zmiennymi (np. z aprobatą społeczną). Jeśli metody w rzeczywistości korelują, jak oceny partnera i przyjaciela, ta wspólna część może trafić do czynników cech.
Model CT-C(M−1): metoda odniesienia
Eid (2000) zaproponował model, który ma tyle czynników cech, ile cech, i o jeden czynnik metody mniej, niż jest metod. Model jest zidentyfikowany także w warunkach, w których inne modele CFA-MTMM nie są. Jedna metoda jest metodą odniesienia i definiuje czynnik cechy. Czynniki pozostałych metod opisują to, czym ich wyniki różnią się od wyniku przewidywanego z metody odniesienia. Eid i in. (2003) rozszerzyli ten model na wiele wskaźników na każdą kombinację cechy i metody, z efektami metody specyficznymi dla cech.
Wybraliśmy samoopis jako metodę odniesienia, bo walidujemy skalę samoopisową, a oceny innych osób traktujemy jako źródła porównawcze. Model był dobrze dopasowany: χ²(17) = 22.37, p = .171, CFI = .994, TLI = .988, RMSEA = .028, SRMR = .035. Z ładunków standaryzowanych liczy się dla każdej miary spójność (odsetek wyjaśnionej wariancji pochodzący z cechy) i specyficzność metody (odsetek z czynnika metody):
| Miara | Ładunek cechy | Ładunek metody | R² | Spójność | Specyficzność metody |
|---|---|---|---|---|---|
| Ekstrawersja · partner | .69 | .49 | .72 | .66 | .34 |
| Sumienność · partner | .61 | .44 | .56 | .65 | .35 |
| Neurotyczność · partner | .58 | −.53 | .62 | .54 | .46 |
| Ekstrawersja · przyjaciel | .68 | .42 | .64 | .72 | .28 |
| Sumienność · przyjaciel | .55 | .42 | .48 | .63 | .37 |
| Neurotyczność · przyjaciel | .32 | −.41 | .27 | .37 | .63 |
Ocena neurotyczności przez przyjaciela jest przede wszystkim „wiedzą przyjaciela”: tylko 37% jej wyjaśnionej wariancji pokrywa się z samoopisem. To ten sam problem, który w macierzy pokazało kryterium 3, ale teraz zmierzony. Przeciwne znaki ładunków metody dla neurotyczności i pozostałych cech oznaczają ogólnie życzliwą lub krytyczną ocenę całej osoby. Czynniki metody partnera i przyjaciela korelują .47: oceniający zewnętrzni dzielą perspektywę, której nie ma w samoopisie. Pamiętaj, że w tym modelu „cecha” oznacza cechę widzianą w samoopisie. Gdyby metodą odniesienia był partner, liczby i ich znaczenie by się zmieniły.
Jak opisać analizę MTMM
Podaj układ cech i metod, macierz z rzetelnościami na przekątnej (jako tabelę lub rysunek), wynik każdego kryterium w liczbach porównań, wszystkie dopasowane modele z informacją o zbieżności i dopuszczalności oraz uzasadnienie wyboru modelu i metody odniesienia. Tabelę dopasowania przygotujesz według wzoru tabeli dopasowania modelu CFA w APA.
Więcej o modelach z czynnikiem ogólnym i czynnikami specyficznymi, które bywają mylone z MTMM, znajdziesz we wpisie model bifactor i ESEM, a ogólny przebieg walidacji w przewodniku psychometria i budowa skal.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik mtmm-dane.csv (możesz go pobrać tutaj) i sprawdza kryteria Campbella i Fiske’a. Drugi dopasowuje cztery modele CFA-MTMM. Trzeci powtarza losowanie 200 razy i trwa kilka minut. Potrzebne są pakiety lavaan i MASS. Podstawy składni lavaan opisuje wpis CB-SEM w R (lavaan).
1. Macierz MTMM i kryteria Campbella i Fiske’a
R
# Dane symulowane: 400 osób; trzy cechy – ekstrawersja (EKS), sumienność (SUM), neurotyczność (NEU) –
# mierzone trzema metodami: samoopis (SO), ocena partnera (PA), ocena przyjaciela (PR); po 4 pozycje 1–5 na skalę
suppressPackageStartupMessages(library(lavaan))
set.seed(2711)
N <- 400
cechy <- c("EKS", "SUM", "NEU"); metody <- c("SO", "PA", "PR")
Phi_T <- matrix(c(1, .25, -.45,
                  .25, 1, -.35,
                  -.45, -.35, 1), 3, dimnames = list(cechy, cechy))
Phi_M <- matrix(c(1, 0, 0,
                  0, 1, .30,
                  0, .30, 1), 3, dimnames = list(metody, metody))     # oceniający zewnętrzni dzielą część perspektywy
T <- MASS::mvrnorm(N, rep(0, 3), Phi_T); M <- MASS::mvrnorm(N, rep(0, 3), Phi_M)
lT <- matrix(c(.85, .80, .75,       # ładunki cech: wiersze = cechy, kolumny = metody
               .85, .75, .70,
               .85, .65, .45), 3, byrow = TRUE, dimnames = list(cechy, metody))
lM <- matrix(c(.25, .50, .40,       # ładunki metody (efekt aureoli); dla NEU ujemne: „dobra ocena” = mniej neurotyczności
               .25, .50, .40,
               -.25, -.50, -.40), 3, byrow = TRUE, dimnames = list(cechy, metody))
dane <- data.frame(id = sprintf("o%03d", 1:N))
for (m in metody) for (t in cechy) {
  # wynik prawdziwy skali = cecha + metoda + część specyficzna dla tej skali (wariancja 1)
  wynik_prawdziwy <- lT[t, m] * T[, t] + lM[t, m] * M[, m] + sqrt(1 - lT[t, m]^2 - lM[t, m]^2) * rnorm(N)
  for (j in 1:4) {            # pozycja = wynik prawdziwy + błąd pozycji, zaokrąglona do skali 1–5
    poz <- wynik_prawdziwy + rnorm(N, 0, 0.8)
    dane[[paste(t, m, j, sep = "_")]] <- pmin(pmax(round(3 + 0.9 * poz), 1), 5)
  }
}
write.csv(dane, "mtmm-dane.csv", row.names = FALSE)

# Wyniki skal (średnie z 4 pozycji) i rzetelność α
miary <- as.vector(outer(cechy, metody, paste, sep = "_"))       # kolejność: cechy w obrębie metod
skale <- sapply(miary, function(v) rowMeans(dane[, paste(v, 1:4, sep = "_")]))
alfa <- sapply(miary, function(v) { x <- dane[, paste(v, 1:4, sep = "_")]; k <- 4
  k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) })
R <- cor(skale)
mtmm <- round(R, 2); diag(mtmm) <- round(alfa, 2)                # na przekątnej rzetelność α
print(mtmm)

# Typ każdej komórki: przekątna trafności (VD), różne cechy–ta sama metoda (HTMM), różne cechy–różne metody (HTHM)
cecha <- sub("_.*", "", miary); metoda <- sub(".*_", "", miary)
typ <- outer(seq_along(miary), seq_along(miary), Vectorize(function(i, j)
  if (i == j) "rzetelnosc" else if (cecha[i] == cecha[j]) "VD" else if (metoda[i] == metoda[j]) "HTMM" else "HTHM"))
dolny <- lower.tri(R)
round(tapply(abs(R[dolny]), typ[dolny], mean), 2)               # średnie wartości bezwzględne w typach komórek

# Kryterium 1: korelacje na przekątnej trafności z 95% CI
vd <- which(typ == "VD" & dolny, arr.ind = TRUE)
k1 <- data.frame(para = paste(miary[vd[, 2]], miary[vd[, 1]], sep = " – "), r = R[vd])
k1$dolny95 <- tanh(atanh(k1$r) - 1.96 / sqrt(N - 3)); k1$gorny95 <- tanh(atanh(k1$r) + 1.96 / sqrt(N - 3))
print(cbind(k1[1], round(k1[-1], 2)), row.names = FALSE)

# Kryteria 2 i 3: ile porównań |r| na przekątnej trafności > |r| w odpowiednich komórkach
k2 <- k3 <- c(spelnione = 0, wszystkie = 0)
for (w in seq_len(nrow(vd))) {
  i <- vd[w, 1]; j <- vd[w, 2]; v <- abs(R[i, j])
  hthm <- c(R[i, metoda == metoda[j] & cecha != cecha[i]], R[j, metoda == metoda[i] & cecha != cecha[j]])
  htmm <- c(R[i, metoda == metoda[i] & cecha != cecha[i]], R[j, metoda == metoda[j] & cecha != cecha[j]])
  k2 <- k2 + c(sum(v > abs(hthm)), length(hthm)); k3 <- k3 + c(sum(v > abs(htmm)), length(htmm))
  if (any(v <= abs(htmm))) cat("Kryterium 3 niespełnione dla", miary[j], "–", miary[i], "\n")
}
rbind(kryterium2 = k2, kryterium3 = k3)

# Kryterium 4: ten sam wzór korelacji między cechami we wszystkich trójkątach (3 jednometodowe + 6 różnometodowych)
wzor <- function(mi, mj) c(EKS_SUM = R[paste0("EKS_", mi), paste0("SUM_", mj)],
                           EKS_NEU = R[paste0("EKS_", mi), paste0("NEU_", mj)],
                           SUM_NEU = R[paste0("SUM_", mi), paste0("NEU_", mj)])
pary <- rbind(cbind(metody, metody), t(combn(metody, 2)), t(combn(metody, 2))[, 2:1])
trojkaty <- t(apply(pary, 1, function(p) wzor(p[1], p[2])))
rownames(trojkaty) <- paste(pary[, 1], pary[, 2], sep = "×")
print(round(trojkaty, 2))
# zgodność wzoru: te same znaki i ta sama kolejność wartości bezwzględnych co we wzorze średnim
sredni <- colMeans(trojkaty)
zgodny <- apply(trojkaty, 1, function(x) all(sign(x) == sign(sredni)) && identical(order(abs(x)), order(abs(sredni))))
c(zgodne_trojkaty = sum(zgodny), wszystkie = length(zgodny))
Wynik w R
       EKS_SO SUM_SO NEU_SO EKS_PA SUM_PA NEU_PA EKS_PR SUM_PR NEU_PR
EKS_SO   0.82   0.14  -0.24   0.55   0.05  -0.15   0.54  -0.02  -0.02
SUM_SO   0.14   0.82  -0.23   0.06   0.50  -0.16   0.07   0.46  -0.11
NEU_SO  -0.24  -0.23   0.83  -0.25  -0.14   0.45  -0.23  -0.11   0.24
EKS_PA   0.55   0.06  -0.25   0.83   0.24  -0.43   0.55   0.08  -0.14
SUM_PA   0.05   0.50  -0.14   0.24   0.83  -0.32   0.11   0.43  -0.20
NEU_PA  -0.15  -0.16   0.45  -0.43  -0.32   0.83  -0.27  -0.12   0.30
EKS_PR   0.54   0.07  -0.23   0.55   0.11  -0.27   0.83   0.19  -0.20
SUM_PR  -0.02   0.46  -0.11   0.08   0.43  -0.12   0.19   0.84  -0.23
NEU_PR  -0.02  -0.11   0.24  -0.14  -0.20   0.30  -0.20  -0.23   0.83
HTHM HTMM   VD
0.13 0.25 0.45
            para    r dolny95 gorny95
 EKS_SO – EKS_PA 0.55    0.48    0.62
 EKS_SO – EKS_PR 0.54    0.47    0.61
 SUM_SO – SUM_PA 0.50    0.42    0.57
 SUM_SO – SUM_PR 0.46    0.38    0.53
 NEU_SO – NEU_PA 0.45    0.36    0.52
 NEU_SO – NEU_PR 0.24    0.14    0.33
 EKS_PA – EKS_PR 0.55    0.47    0.61
 SUM_PA – SUM_PR 0.43    0.35    0.51
 NEU_PA – NEU_PR 0.30    0.21    0.39
Kryterium 3 niespełnione dla NEU_SO – NEU_PR
Kryterium 3 niespełnione dla NEU_PA – NEU_PR
           spelnione wszystkie
kryterium2        36        36
kryterium3        33        36
      EKS_SUM EKS_NEU SUM_NEU
SO×SO    0.14   -0.24   -0.23
PA×PA    0.24   -0.43   -0.32
PR×PR    0.19   -0.20   -0.23
SO×PA    0.05   -0.15   -0.16
SO×PR   -0.02   -0.02   -0.11
PA×PR    0.08   -0.14   -0.20
PA×SO    0.06   -0.25   -0.14
PR×SO    0.07   -0.23   -0.11
PR×PA    0.11   -0.27   -0.12
zgodne_trojkaty       wszystkie
              5               9
2. Modele CTCM, CTUM, CTCU i CT-C(M−1)
R
# CFA-MTMM na 9 wynikach skal z przepisu 1 (obiekt skale); estymator ML, wariancje czynników = 1
d9 <- as.data.frame(skale)
cechy_model <- '
  EKS =~ EKS_SO + EKS_PA + EKS_PR
  SUM =~ SUM_SO + SUM_PA + SUM_PR
  NEU =~ NEU_SO + NEU_PA + NEU_PR
'
# 1. CTCM: skorelowane cechy i skorelowane metody; cechy nieskorelowane z metodami
ctcm <- paste(cechy_model, '
  mSO =~ EKS_SO + SUM_SO + NEU_SO
  mPA =~ EKS_PA + SUM_PA + NEU_PA
  mPR =~ EKS_PR + SUM_PR + NEU_PR
  EKS ~~ 0*mSO + 0*mPA + 0*mPR
  SUM ~~ 0*mSO + 0*mPA + 0*mPR
  NEU ~~ 0*mSO + 0*mPA + 0*mPR
')
# 2. CTCU: skorelowane cechy, metoda jako skorelowane reszty w obrębie metody
ctcu <- paste(cechy_model, '
  EKS_SO ~~ SUM_SO + NEU_SO
  SUM_SO ~~ NEU_SO
  EKS_PA ~~ SUM_PA + NEU_PA
  SUM_PA ~~ NEU_PA
  EKS_PR ~~ SUM_PR + NEU_PR
  SUM_PR ~~ NEU_PR
')
# 3. CT-C(M-1): samoopis jako metoda odniesienia; czynniki metody tylko dla ocen partnera i przyjaciela
ctcm1 <- paste(cechy_model, '
  mPA =~ EKS_PA + SUM_PA + NEU_PA
  mPR =~ EKS_PR + SUM_PR + NEU_PR
  EKS ~~ 0*mPA + 0*mPR
  SUM ~~ 0*mPA + 0*mPR
  NEU ~~ 0*mPA + 0*mPR
')
# CTUM: jak CTCM, ale metody nieskorelowane
ctum <- paste(ctcm, '
  mSO ~~ 0*mPA + 0*mPR
  mPA ~~ 0*mPR
')
modele <- list(CTCM = ctcm, CTUM = ctum, CTCU = ctcu, "CT-C(M-1)" = ctcm1)
fity <- lapply(modele, function(m) cfa(m, data = d9, std.lv = TRUE, estimator = "ML"))

# Dopasowanie i sprawdzenie, czy rozwiązanie jest zbieżne i dopuszczalne (brak ujemnych wariancji, |r| ≤ 1)
ocena <- function(f) {
  zb <- lavInspect(f, "converged")
  dop <- zb && suppressWarnings(lavInspect(f, "post.check"))
  miary_dop <- c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr")
  ind <- if (zb) fitMeasures(f, miary_dop) else setNames(rep(NA, 7), miary_dop)
  c(round(ind, 3), zbiezny = zb, dopuszczalny = dop)
}
t(sapply(fity, ocena))

# CTCM jeszcze raz z limitem 20 000 iteracji: dobre dopasowanie, ale rozwiązanie niedopuszczalne
ctcm_dl <- cfa(ctcm, data = d9, std.lv = TRUE, estimator = "ML", control = list(iter.max = 20000))
ocena(ctcm_dl)
pe <- suppressWarnings(parameterEstimates(ctcm_dl, standardized = TRUE))
pe[pe$op == "~~" & pe$lhs == pe$rhs & pe$est < 0, c("lhs", "op", "rhs", "est", "se", "std.all")]

# Korelacje cech (standaryzowane) w trzech modelach
kor_cech <- function(f) { s <- standardizedSolution(f)
  s <- s[s$op == "~~" & s$lhs %in% c("EKS", "SUM", "NEU") & s$rhs %in% c("EKS", "SUM", "NEU") & s$lhs != s$rhs, ]
  setNames(round(s$est.std, 2), paste(s$lhs, s$rhs, sep = "–")) }
sapply(fity[c("CTCU", "CT-C(M-1)")], kor_cech)

# CT-C(M-1): ładunki standaryzowane, spójność (część wariancji prawdziwej z cechy) i specyficzność metody
s <- standardizedSolution(fity$"CT-C(M-1)")
lad <- s[s$op == "=~", c("lhs", "rhs", "est.std")]
tab <- data.frame(miara = names(d9))
tab$cecha <- sapply(tab$miara, function(v) lad$est.std[lad$rhs == v & lad$lhs %in% c("EKS", "SUM", "NEU")])
tab$metoda <- sapply(tab$miara, function(v) { x <- lad$est.std[lad$rhs == v & lad$lhs %in% c("mPA", "mPR")]; if (length(x)) x else 0 })
tab$R2 <- tab$cecha^2 + tab$metoda^2
tab$spojnosc <- tab$cecha^2 / tab$R2
tab$specyficznosc <- tab$metoda^2 / tab$R2
print(cbind(tab[1], round(tab[-1], 2)), row.names = FALSE)
round(s$est.std[s$lhs == "mPA" & s$op == "~~" & s$rhs == "mPR"], 2)   # korelacja czynników metody
Wynik w R
Warning: lavaan->lav_step11_estoptim():
   the optimizer warns that a solution has NOT been found!
           chisq df pvalue   cfi   tli rmsea  srmr zbiezny dopuszczalny
CTCM          NA NA     NA    NA    NA    NA    NA       0            0
CTUM      26.851 15  0.030 0.987 0.969 0.044 0.036       1            1
CTCU      26.851 15  0.030 0.987 0.969 0.044 0.036       1            1
CT-C(M-1) 22.368 17  0.171 0.994 0.988 0.028 0.035       1            1
Warning: lavaan->lav_model_vcov():
   Could not compute standard errors! The information matrix could not be
   inverted. This may be a symptom that the model is not identified.
Warning: lavaan->lav_object_post_check():
   some estimated ov variances are negative
       chisq           df       pvalue          cfi          tli        rmsea
      13.859       12.000        0.310        0.998        0.994        0.020
        srmr      zbiezny dopuszczalny
       0.024        1.000        0.000
      lhs op    rhs      est se  std.all
31 SUM_SO ~~ SUM_SO -595.593 NA -735.737
         CTCU CT-C(M-1)
EKS–SUM  0.11      0.13
EKS–NEU -0.42     -0.41
SUM–NEU -0.33     -0.33
  miara cecha metoda   R2 spojnosc specyficznosc
 EKS_SO  0.82   0.00 0.68     1.00          0.00
 SUM_SO  0.85   0.00 0.72     1.00          0.00
 NEU_SO  0.77   0.00 0.59     1.00          0.00
 EKS_PA  0.69   0.49 0.72     0.66          0.34
 SUM_PA  0.61   0.44 0.56     0.65          0.35
 NEU_PA  0.58  -0.53 0.62     0.54          0.46
 EKS_PR  0.68   0.42 0.64     0.72          0.28
 SUM_PR  0.55   0.42 0.48     0.63          0.37
 NEU_PR  0.32  -0.41 0.27     0.37          0.63
[1] 0.47
3. Symulacja: jak często model daje rozwiązanie dopuszczalne
R
# Jak często modele MTMM dają rozwiązanie zbieżne i dopuszczalne? 200 prób z tej samej populacji co w przepisie 1
generuj <- function(n) {
  T <- MASS::mvrnorm(n, rep(0, 3), Phi_T); M <- MASS::mvrnorm(n, rep(0, 3), Phi_M)
  out <- list()
  for (m in metody) for (t in cechy) {
    wp <- lT[t, m] * T[, t] + lM[t, m] * M[, m] + sqrt(1 - lT[t, m]^2 - lM[t, m]^2) * rnorm(n)
    poz <- sapply(1:4, function(j) pmin(pmax(round(3 + 0.9 * (wp + rnorm(n, 0, 0.8))), 1), 5))
    out[[paste(t, m, sep = "_")]] <- rowMeans(poz)
  }
  as.data.frame(out)
}
ok <- function(model, d) {
  f <- tryCatch(suppressWarnings(cfa(model, data = d, std.lv = TRUE, estimator = "ML")), error = function(e) NULL)
  !is.null(f) && lavInspect(f, "converged") && suppressWarnings(lavInspect(f, "post.check"))
}
set.seed(27113)
wyniki_sym <- do.call(rbind, lapply(c(150, 400), function(n) {
  r <- t(replicate(200, { d <- generuj(n); sapply(modele, ok, d = d) }))
  data.frame(N = n, model = names(modele), dopuszczalne_proc = round(100 * colMeans(r), 1))
}))
print(reshape(wyniki_sym, idvar = "model", timevar = "N", direction = "wide"), row.names = FALSE)
Wynik w R
     model dopuszczalne_proc.150 dopuszczalne_proc.400
      CTCM                  16.5                  39.5
      CTUM                  62.0                  90.5
      CTCU                  99.5                 100.0
 CT-C(M-1)                  81.0                  97.5
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Wiele metod”, które są jedną metodą. Dwa kwestionariusze samoopisowe z tej samej ankiety nie oddzielą cechy od metody.
- Raport samego kryterium 1. Wysoka zbieżność nic nie znaczy, jeśli korelacje różnych cech mierzonych tą samą metodą są równie wysokie.
- Ignorowanie ostrzeżeń lavaan. Dobre CFI przy ujemnej wariancji lub braku błędów standardowych to sygnał braku identyfikacji, a nie sukces.
- Zmiana modelu bez słowa. Jeśli CTCM zawiódł i przeszedłeś na CT-C(M−1) albo skorelowane reszty, napisz to i podaj powód.
- Interpretacja CT-C(M−1) jak CTCM. Czynnik cechy to cecha w metodzie odniesienia, a nie „prawdziwa” cecha niezależna od metody.
- Mała próba. Przy N = 150 nawet CT-C(M−1) dał w przykładzie rozwiązanie dopuszczalne tylko w 81.0% prób.
Najczęstsze pytania
Czy do modeli CFA-MTMM wystarczy układ 2 cechy × 2 metody?
Do samych kryteriów Campbella i Fiske’a tak, ale modele CFA-MTMM wymagają zwykle co najmniej trzech cech i trzech metod. W symulacjach Marsha i Baileya (1991) ogólny model z czynnikami metody najczęściej zawodził właśnie przy małych macierzach i małych próbach.
Co zrobić, gdy model CTCM nie jest zbieżny albo ma ujemną wariancję?
Nie usuwaj ostrzeżenia, zwiększając liczbę iteracji. W przykładzie po 20 000 iteracjach model miał świetne dopasowanie, ale ujemną wariancję resztową. Przejdź do modelu, który jest identyfikowany w Twoim układzie danych: CT-C(M−1) z metodą odniesienia (Eid, 2000) albo modelu skorelowanych reszt, i opisz tę decyzję.
Czym jest metoda odniesienia w modelu CT-C(M−1)?
To metoda, której nie przypisuje się czynnika metody, np. samoopis – dlatego model ma o jeden czynnik metody mniej, niż jest metod (Eid, 2000). Czynnik cechy jest wtedy zdefiniowany przez metodę odniesienia, a czynniki pozostałych metod opisują tę część ich wyników, której nie da się przewidzieć z tej cechy. Wybór metody odniesienia zmienia interpretację, więc uzasadnij go teoretycznie.
Czy model skorelowanych reszt jest lepszy od CTCM?
Częściej daje dopuszczalne rozwiązanie (Marsh i Bailey, 1991), ale zakłada, że metody są nieskorelowane, i nie daje czynnika metody, który można korelować z innymi zmiennymi. Lance i in. (2002) zalecają traktować go jako rozwiązanie zapasowe, gdy CTCM zawodzi.
Czy macierz MTMM można zrobić na jednej ankiecie?
Tylko wtedy, gdy metody naprawdę się różnią, np. różne formaty odpowiedzi lub różni respondenci. Dwa kwestionariusze samoopisowe wypełnione tego samego dnia to w praktyce jedna metoda, więc ich zgodność może wynikać ze wspólnej wariancji metody.
Powiązane hasła
Przeczytaj też
Rodzaje trafności – mapa dowodów
Tradycyjne nazwy trafności na mapie pięciu źródeł dowodów (Standards, 2014): jak zebrać dowód, jaka analiza, jak opisać w pracy i które 2–3 rodzaje dowodów zaplanować.
Czytaj →PoradnikTrafność zbieżna i różnicowa: AVE i HTMT
AVE i rzetelność złożona z ładunków lavaan, HTMT z bootstrapem, krytyka Fornella–Larckera i co zrobić, gdy dwa konstrukty są trudne do odróżnienia.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Planujesz walidację skali z kilkoma metodami pomiaru?
Pomożemy zaplanować układ cech i metod, wybrać model CFA-MTMM, który da się oszacować w Twoich danych, i przygotować opis wyników, który samodzielnie przedstawisz i obronisz przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016 ● Otwarty dostęp: pełny tekst
- Eid, M. (2000). A multitrait-multimethod model with minimal assumptions. Psychometrika, 65(2), 241–261. https://doi.org/10.1007/bf02294377
- Eid, M., Lischetzke, T., Nussbeck, F. W., & Trierweiler, L. I. (2003). Separating trait effects from trait-specific method effects in multitrait-multimethod models: A multiple-indicator CT-C(M-1) model. Psychological Methods, 8(1), 38–60. https://doi.org/10.1037/1082-989x.8.1.38
- Kenny, D. A., & Kashy, D. A. (1992). Analysis of the multitrait-multimethod matrix by confirmatory factor analysis. Psychological Bulletin, 112(1), 165–172. https://doi.org/10.1037/0033-2909.112.1.165
- Lance, C. E., Noble, C. L., & Scullen, S. E. (2002). A critique of the correlated trait-correlated method and correlated uniqueness models for multitrait-multimethod data. Psychological Methods, 7(2), 228–244. https://doi.org/10.1037/1082-989x.7.2.228
- Marsh, H. W. (1989). Confirmatory factor analyses of multitrait-multimethod data: Many problems and a few solutions. Applied Psychological Measurement, 13(4), 335–361. https://doi.org/10.1177/014662168901300402
- Marsh, H. W., & Bailey, M. (1991). Confirmatory factor analyses of multitrait-multimethod data: A comparison of alternative models. Applied Psychological Measurement, 15(1), 47–70. https://doi.org/10.1177/014662169101500106 ● Otwarty dostęp: pełny tekst
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Widaman, K. F. (1985). Hierarchically nested covariance structure models for multitrait-multimethod data. Applied Psychological Measurement, 9(1), 1–26. https://doi.org/10.1177/014662168500900101
Cytowania BibTeX
@article{campbell1959convergent, author={Campbell, Donald T. and Fiske, Donald W.}, title={{Convergent and discriminant validation by the multitrait-multimethod matrix}}, journal={Psychological Bulletin}, year={1959}, volume={56}, number={2}, pages={81--105}, doi={10.1037/h0046016}}@article{eid2000multitrait, author={Eid, Michael}, title={{A multitrait-multimethod model with minimal assumptions}}, journal={Psychometrika}, year={2000}, volume={65}, number={2}, pages={241--261}, doi={10.1007/bf02294377}}@article{eid2003separating, author={Eid, Michael and Lischetzke, Tanja and Nussbeck, Fridtjof W. and Trierweiler, Lisa I.}, title={{Separating trait effects from trait-specific method effects in multitrait-multimethod models: A multiple-indicator CT-C(M-1) model}}, journal={Psychological Methods}, year={2003}, volume={8}, number={1}, pages={38--60}, doi={10.1037/1082-989x.8.1.38}}@article{kenny1992analysis, author={Kenny, David A. and Kashy, Deborah A.}, title={{Analysis of the multitrait-multimethod matrix by confirmatory factor analysis}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={165--172}, doi={10.1037/0033-2909.112.1.165}}@article{lance2002critique, author={Lance, Charles E. and Noble, Carrie L. and Scullen, Steven E.}, title={{A critique of the correlated trait-correlated method and correlated uniqueness models for multitrait-multimethod data}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={228--244}, doi={10.1037/1082-989x.7.2.228}}@article{marsh1989confirmatory, author={Marsh, Herbert W.}, title={{Confirmatory factor analyses of multitrait-multimethod data: Many problems and a few solutions}}, journal={Applied Psychological Measurement}, year={1989}, volume={13}, number={4}, pages={335--361}, doi={10.1177/014662168901300402}}@article{marsh1991confirmatory, author={Marsh, Herbert W. and Bailey, Michael}, title={{Confirmatory factor analyses of multitrait-multimethod data: A comparison of alternative models}}, journal={Applied Psychological Measurement}, year={1991}, volume={15}, number={1}, pages={47--70}, doi={10.1177/014662169101500106}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{widaman1985hierarchically, author={Widaman, Keith F.}, title={{Hierarchically nested covariance structure models for multitrait-multimethod data}}, journal={Applied Psychological Measurement}, year={1985}, volume={9}, number={1}, pages={1--26}, doi={10.1177/014662168500900101}}