Na czym polega metoda grup znanych
Metoda grup znanych (ang. known-groups method) sprawdza, czy nowa skala odróżnia grupy, o których z teorii wiadomo, że różnią się mierzoną cechą. Jeśli skala mierzy lęk społeczny, osoby z rozpoznaną fobią społeczną powinny mieć w niej wyraźnie wyższe wyniki niż osoby bez rozpoznania. Jeśli różnicy nie ma, coś jest nie tak ze skalą albo z teorią. Krótką definicję podaje hasło metoda grup znanych, a ten wpis prowadzi przez całe badanie: od wyboru grup do zdania w rozdziale metodologicznym.
Cronbach i Meehl (1955) wymienili różnice między grupami wśród sposobów badania trafności konstruktu. Hattie i Cooksey (1984) ujęli to wprost: jednym z kryteriów trafności testu może być to, że jego wyniki różnicują grupy teoretycznie znane jako różne. Zaproponowali też procedurę opartą tylko na średnich, dzięki której nową próbę można porównać z wcześniejszymi badaniami. Metoda dostarcza więc dowodu trafności teoretycznej. W ujęciu Standards to jeden z dowodów opartych na relacjach z innymi zmiennymi (American Educational Research Association i in., 2014). Gdzie leży wśród pozostałych dowodów, pokazuje mapa rodzajów trafności.
Czym różni się od trafności kryterialnej? W badaniu kryterialnym pytasz, jak dokładnie wynik odtwarza konkretne kryterium, np. rozpoznanie, i z jaką czułością. W metodzie grup znanych pytasz, czy różnice między grupami mają kierunek i wielkość przewidziane przez teorię. Te same dane mogą służyć obu celom, ale hipotezy i wnioski są inne. Dlatego krzywa ROC jest tu tylko uzupełnieniem.
Jak wybrać grupy
Dobre grupy znane spełniają cztery warunki.
- Różnicę przewiduje teoria, a nie intuicja. Zapisz, dlaczego grupy powinny się różnić. „Pielęgniarki z oddziałów intensywnej terapii mają wyższe wypalenie” to dopiero hipoteza, którą trzeba uzasadnić wcześniejszymi badaniami.
- Przynależność do grupy ustalono niezależnie od skali. Rozpoznanie postawił klinicysta, który nie znał wyniku skali, albo grupę wyznacza obiektywny fakt, np. staż pracy. Nie wolno dzielić osób według wyniku nowej skali ani jej pozycji, bo wtedy różnica jest zapewniona z góry.
- Jest grupa „bliskiego sąsiada”. Porównanie osób z zaburzeniem z osobami zdrowymi prawie zawsze wychodzi. Trudniejszy i cenniejszy test to porównanie z grupą, która różni się mierzoną cechą, ale jest podobna pod innymi względami, np. osoby z innym zaburzeniem lękowym. Taki kontrast zbliża metodę do trafności różnicowej.
- Grupy obejmują realistyczne spektrum. Najcięższe przypadki z oddziału zestawione z wyselekcjonowanymi „zdrowymi ochotnikami” dadzą ogromny efekt, który nic nie mówi o działaniu skali w praktyce. Ransohoff i Feinstein (1978) pokazali, że za wąskie spektrum chorych i zdrowych daje fałszywie wysokie wskaźniki trafności testów diagnostycznych.
Liczebność ustal z góry, tak jak w każdym porównaniu dwóch grup. Przy spodziewanym efekcie dużym wystarczą mniejsze grupy, ale przy kontraście z bliskim sąsiadem efekt będzie umiarkowany. Grupy kliniczne są zwykle mniejsze od porównawczych i to nie jest problem, jeśli analizę dobierzesz do nierównych n.
Hipotezy kierunkowe zapisane przed analizą
Samo „grupy powinny się różnić” to za mało. Każda hipoteza powinna mieć trzy elementy: które grupy, który kierunek i jaką minimalną wielkość efektu uznasz za potwierdzenie. Wytyczne COSMIN zalecają formułować hipotezy z góry, łącznie z oczekiwanym kierunkiem i wielkością. Wśród ogólnych hipotez wymieniają istotne różnice między podgrupami o oczekiwanym wysokim i niskim poziomie konstruktu. Wynik uznają za wystarczający, gdy co najmniej 75% rezultatów zgadza się z hipotezami (Prinsen i in., 2018).
W przykładzie poniżej zapisano trzy hipotezy dla nowej skali lęku społecznego:
| Hipoteza | Porównanie | Oczekiwane g | Co sprawdza |
|---|---|---|---|
| H1 | fobia społeczna > bez rozpoznania | ≥ 0.80 | czy skala w ogóle wykrywa lęk społeczny |
| H2 | fobia społeczna > inne zaburzenie lękowe | ≥ 0.50 | czy mierzy lęk społeczny, a nie ogólny niepokój |
| H3 | inne zaburzenie lękowe > bez rozpoznania | 0.20–0.80 | czy kolejność grup jest zgodna z teorią |
Hipoteza H3 ma też górną granicę. Gdyby osoby z innym zaburzeniem lękowym różniły się od osób zdrowych tak samo jak osoby z fobią, skala mierzyłaby raczej ogólny lęk. Ponieważ kierunek jest zapisany z góry, można rozważyć test jednostronny. Zasady opisuje wpis test jednostronny czy dwustronny. My zostajemy przy dwustronnym, bo o decyzji i tak przesądza wielkość efektu. Jak zapisać hipotezy formalnie, wyjaśnia wpis hipotezy statystyczne H0 i H1.
Przykład: skala lęku społecznego
Wszystkie liczby pochodzą z jednego badania symulowanego. Nową skalę lęku społecznego (10 pozycji, odpowiedzi 1–5, wynik to średnia) wypełniło 60 osób z rozpoznaniem fobii społecznej i 60 osób z innym zaburzeniem lękowym, obie grupy z poradni. Do tego doszło 180 osób studiujących bez rozpoznania. Rozpoznania postawili klinicyści, którzy nie znali wyników skali. Wszyscy wypełnili też krótką skalę objawów depresji (0–27). Dane są w pliku CSV, a kod – w sekcji metoda grup znanych w R.
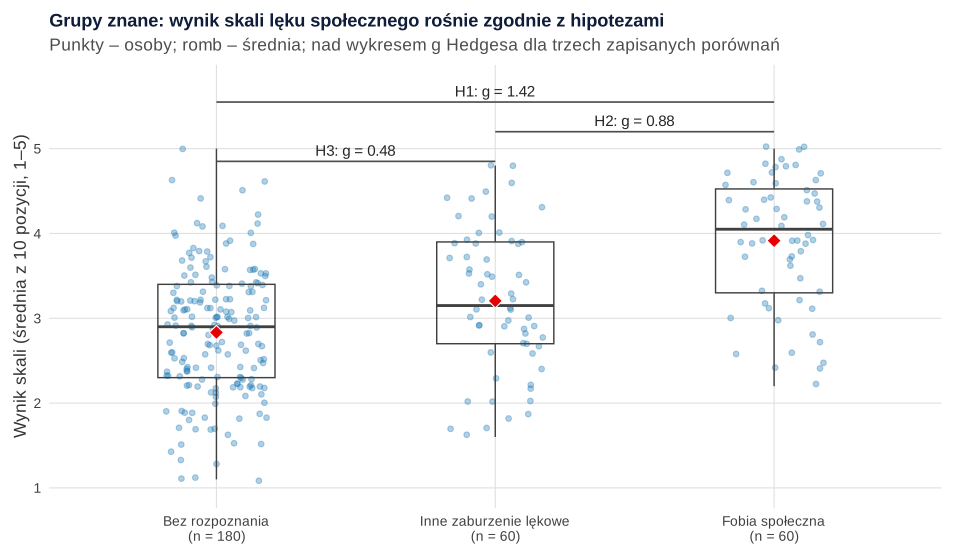
Zanim porównasz grupy, sprawdź rzetelność. Alfa Cronbacha w całej próbie wyniosła .94 (zob. alfa Cronbacha). Średnie układają się zgodnie z teorią: bez rozpoznania M = 2.83 (SD = 0.76), inne zaburzenie lękowe M = 3.21 (SD = 0.84), fobia społeczna M = 3.92 (SD = 0.77). Rysunek 1 pokazuje, że rozkłady mocno na siebie zachodzą. Grupy znane różnią się średnio, a nie każdą osobą.
Analiza: test Welcha i g Hedgesa z przedziałem ufności
Każdą hipotezę sprawdzasz osobnym porównaniem dwóch grup. Grupy mają różne liczebności i mogą mieć różne wariancje, dlatego domyślnym wyborem jest test t Welcha. Lepiej kontroluje błąd I rodzaju przy nierównych wariancjach, a gdy założenia są spełnione, traci niewiele (Delacre i in., 2017). Wartość p mówi jednak tylko, czy różnica jest różna od zera. O potwierdzeniu hipotezy decyduje wielkość efektu, czyli g Hedgesa (d Cohena z poprawką na małą próbę) z 95% przedziałem ufności. Lakens (2013) podkreśla, że wielkości efektu dla testów t trzeba nie tylko liczyć, lecz także raportować, żeby inni mogli je porównać i wykorzystać.
| Hipoteza | Różnica średnich | Test Welcha | g [95% CI] | Oczekiwane | Decyzja |
|---|---|---|---|---|---|
| H1: fobia > bez | 1.08 | t(99.9) = 9.48, p < .001 | 1.42 [1.10, 1.74] | ≥ 0.80 | potwierdzona |
| H2: fobia > inne | 0.71 | t(117.2) = 4.84, p < .001 | 0.88 [0.50, 1.25] | ≥ 0.50 | potwierdzona |
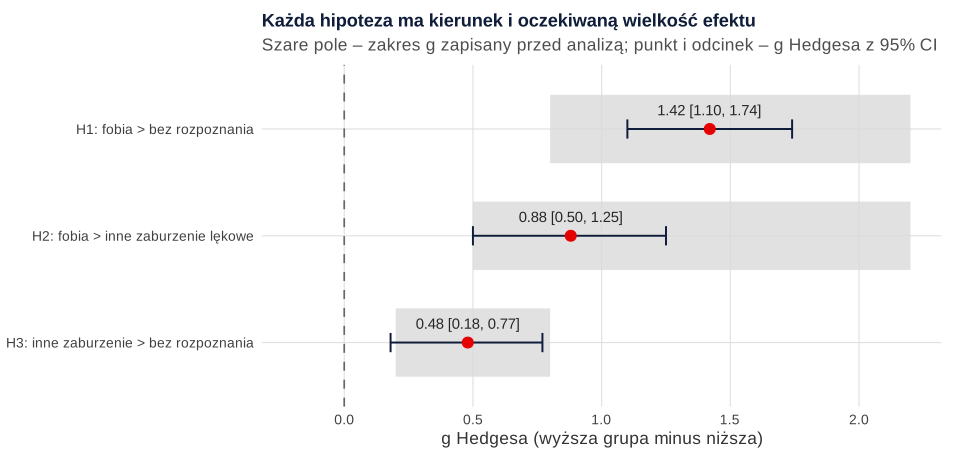
| H3: inne > bez | 0.37 | t(93.3) = 3.05, p = .003 | 0.48 [0.18, 0.77] | 0.20–0.80 | potwierdzona |
Wszystkie trzy hipotezy się potwierdziły (100%, powyżej progu 75%). Rysunek 2 pokazuje jednak, że przedziały ufności są szerokie. Dolna granica dla H2 wynosi dokładnie 0.50, czyli tyle, ile oczekiwany próg. Regułę decyzji zapisz więc z góry: czy wystarczy oszacowanie punktowe w oczekiwanym zakresie, czy cały przedział musi leżeć powyżej progu. Druga reguła jest bardziej wymagająca i przy 60 osobach w grupie H2 byłaby na granicy. Ogólne progi dla d (0.2, 0.5, 0.8) traktuj jako punkt wyjścia. Lepiej oprzeć oczekiwania na różnicach opisanych dla podobnych narzędzi.
Przy trzech grupach można też zacząć od jednoczynnikowej ANOVA Welcha. Do metody grup znanych lepiej jednak pasują zaplanowane kontrasty, bo każdy z nich odpowiada jednej hipotezie. Przy kilku zaplanowanych porównaniach, z których każde ma własną hipotezę, zapisz w planie analizy, czy stosujesz poprawkę na wielokrotne porównania.
Krzywa ROC jako uzupełnienie
Pole pod krzywą ROC (AUC) to prawdopodobieństwo, że losowo wybrana osoba z grupy „wyższej” uzyska wyższy wynik niż losowo wybrana osoba z grupy „niższej” (Hanley i McNeil, 1982). Dla porównania fobii z osobami bez rozpoznania AUC = .84, 95% CI [.77, .90], a dla fobii z innym zaburzeniem lękowym AUC = .73, 95% CI [.64, .82]. Przedziały policzono metodą DeLonga w pakiecie pROC (Robin i in., 2011). Przy rozkładach normalnych o równych wariancjach AUC i d mówią to samo innym językiem: AUC = Φ(d/√2). Dla g = 1.42 daje to .84, a dla 0.88 – .73.
AUC przydaje się, bo nie zależy od jednostek skali i dobrze znosi skośne rozkłady. W tym wpisie nie służy jednak do wyznaczania progu. Próg z indeksu Youdena (wynik ≥ 3.7, czułość .70, swoistość .87) jest tylko opisem tej próby. Trafność diagnostyczną bada się na próbie z realistycznym rozkładem osób, a nie na grupach dobranych do kontrastu (Ransohoff i Feinstein, 1978). Jak wyznaczyć i opisać punkt odcięcia, pokazuje wpis krzywa ROC i punkt odcięcia krok po kroku. Wpisu tutaj nie powtarzamy.
Pułapka: grupy różnią się nie tylko mierzoną cechą
To najważniejsze ograniczenie metody. Osoby z poradni różnią się od studentów wiekiem, nasileniem depresji, przyjmowanymi lekami, miejscem badania i motywacją do wypełniania ankiety. Różnica w wyniku skali może wynikać z każdej z tych cech, a nie z lęku społecznego. Technicznie to problem zmiennej zakłócającej, podobny jak w badaniu kliniczno-kontrolnym.
W przykładzie obie grupy kliniczne miały znacznie wyższą depresję niż studenci (g = 1.82 i 1.65), ale prawie nie różniły się nią między sobą (g = 0.18). Stąd wartość hipotezy H2. Różnicy między fobią a innym zaburzeniem lękowym (g = 0.88) nie da się wytłumaczyć ogólnym cierpieniem ani samym faktem leczenia. Gdy w modelu porównującym fobię z osobami bez rozpoznania uwzględniono depresję, różnica zmalała z 1.08 do 0.60 punktu (95% CI [0.33, 0.87]). Ta korekta nie jest jednak „prawdziwym” efektem. Depresja częściowo wynika z lęku społecznego, więc model odejmuje też część mierzonej cechy. Lepszym zabezpieczeniem jest dobra grupa porównawcza niż kowariant dopisany po fakcie.
Inne pułapki, na które warto uważać:
- Selekcja „superzdrowych”. W symulacji ta sama grupa z fobią porównana z losową próbą studentów dała medianę g = 1.50. Porównana z ochotnikami z dolnej połowy rozkładu lęku dała 3.29. Skala się nie zmieniła, zmieniła się tylko grupa porównawcza.
- Błędne koło. Jeśli rozpoznanie postawiono m.in. na podstawie podobnego kwestionariusza, różnica częściowo mierzy zgodność metod, a nie konstrukt. Jak oddzielić wpływ metody od cechy, pokazuje macierz MTMM.
- Różne znaczenie pozycji w grupach. Porównanie średnich zakłada, że skala mierzy to samo w każdej grupie. W większej pracy sprawdź to analizą opisaną we wpisie inwariancja pomiaru krok po kroku.
- Brak różnicy to nie dowód nietrafności. Mała próba, za słaby kontrast albo błędna teoria też dają wynik nieistotny. Według Cronbacha i Meehla (1955) nieudane przewidywanie podważa test albo teorię i trzeba to rozstrzygnąć nowymi danymi. Co napisać w takiej sytuacji, podpowiada wpis hipoteza się nie potwierdziła.
Metoda grup znanych to jeden dowód trafności, a nie cała walidacja. Pełny proces, od puli pozycji przez analizę czynnikową po trafność zbieżną, opisuje poradnik jak zbudować i zwalidować skalę psychometryczną.
Jak opisać metodę grup znanych w pracy
W rozdziale metodologicznym podaj grupy, sposób ustalenia przynależności i hipotezy z oczekiwaną wielkością efektu. W wynikach podaj średnie, test, g z przedziałem ufności i decyzję dla każdej hipotezy. Całość opisu narzędzia pokazuje wpis opis narzędzia badawczego – wzór.
Gotowe zdania do innych testów przygotuje generator opisu wyników w stylu APA, a test do innego układu grup podpowie kreator doboru testu. Pozostałe etapy pracy ze skalą zebrano w przewodniku psychometria i budowa skal. Jeśli chcesz, żeby ktoś sprawdził dobór grup i hipotez w Twojej pracy, możesz skorzystać z oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Metoda grup znanych w R
Przepis 1 tworzy dane, zapisuje je do pliku CSV, liczy alfę, statystyki opisowe, test t Welcha (t.test() domyślnie nie zakłada równych wariancji) i g Hedgesa z 95% CI funkcją hedges_g() z pakietu effectsize. Hipotezy są zapisane w tabeli przed analizą, a decyzja wynika z kierunku i oczekiwanego zakresu g. Przepis 2 dodaje AUC z pakietu pROC, a przepis 3 to symulacja wpływu doboru grupy porównawczej.
1. Hipotezy, test Welcha i g Hedgesa
R
# B268 – metoda grup znanych: nowa skala lęku społecznego (10 pozycji, 1–5, wynik = średnia)
# Dane symulowane, set.seed(2680): 60 osób z rozpoznaniem fobii społecznej, 60 osób z innym
# zaburzeniem lękowym (obie grupy z poradni) i 180 osób studiujących bez rozpoznania.
suppressPackageStartupMessages(library(effectsize))
set.seed(2680)
n <- c(fobia = 60, inne = 60, bez = 180)
grupa <- factor(rep(names(n), n), levels = c("bez", "inne", "fobia"))
theta <- rnorm(sum(n), c(bez = 0, inne = 0.6, fobia = 1.6)[as.character(grupa)], 1)
progi <- c(-1.3, -0.3, 0.6, 1.6)                        # progi kategorii odpowiedzi 1–5
pozycje <- sapply(1:10, function(j) {
  lat <- 0.75 * theta + rnorm(sum(n), 0, 0.66)
  findInterval(lat + rnorm(1, 0, 0.15), progi) + 1
})
colnames(pozycje) <- sprintf("p%02d", 1:10)
wynik <- round(rowMeans(pozycje), 2)
depresja <- round(pmin(27, pmax(0, 6 + 3 * c(bez = 0, inne = 1.9, fobia = 1.9)[as.character(grupa)] +
                                     1 * theta + rnorm(sum(n), 0, 3.5))))   # wynik 0–27, jak w PHQ-9
dane <- data.frame(id = seq_len(sum(n)), grupa, pozycje, wynik, depresja)
write.csv(dane, "../grupy-znane-dane-przyklad.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Krok 1. Rzetelność i statystyki opisowe w grupach
alfa <- function(X) { k <- ncol(X); k / (k - 1) * (1 - sum(apply(X, 2, var)) / var(rowSums(X))) }
cat(sprintf("alfa Cronbacha = %.2f\n", alfa(pozycje)))
opis <- aggregate(cbind(wynik, depresja) ~ grupa, dane, function(x) c(n = length(x), M = mean(x), SD = sd(x)))
print(do.call(data.frame, opis), digits = 3)

# Krok 2. Hipotezy zapisane przed analizą: kierunek i minimalna wielkość efektu (g Hedgesa)
hipotezy <- data.frame(
  H = c("H1", "H2", "H3"),
  wyzsza = c("fobia", "fobia", "inne"), nizsza = c("bez", "inne", "bez"),
  g_min = c(0.80, 0.50, 0.20), g_max = c(Inf, Inf, 0.80))

# Krok 3. Test t Welcha, g Hedgesa z 95% CI i decyzja dla każdej hipotezy
wyniki <- do.call(rbind, lapply(seq_len(nrow(hipotezy)), function(i) {
  h <- hipotezy[i, ]
  x <- dane$wynik[dane$grupa == h$wyzsza]; y <- dane$wynik[dane$grupa == h$nizsza]
  tt <- t.test(x, y)                                     # domyślnie wersja Welcha
  g <- hedges_g(x, y, ci = 0.95)
  data.frame(H = h$H, porownanie = paste(h$wyzsza, ">", h$nizsza),
             roznica = round(mean(x) - mean(y), 2), t = round(unname(tt$statistic), 2),
             df = round(unname(tt$parameter), 1), p = signif(tt$p.value, 2),
             g = round(g$Hedges_g, 2), CI_dol = round(g$CI_low, 2), CI_gora = round(g$CI_high, 2),
             oczekiwane = ifelse(is.finite(h$g_max), sprintf("%.2f–%.2f", h$g_min, h$g_max), sprintf("≥ %.2f", h$g_min)),
             potwierdzona = mean(x) > mean(y) & g$Hedges_g >= h$g_min & g$Hedges_g <= h$g_max)
}))
print(wyniki, row.names = FALSE)
cat(sprintf("Potwierdzone hipotezy: %d z %d (%.0f%%)\n", sum(wyniki$potwierdzona), nrow(wyniki),
            100 * mean(wyniki$potwierdzona)))

# Krok 4. Pułapka: grupy kliniczne różnią się też depresją
dep <- function(a, b) hedges_g(dane$depresja[dane$grupa == a], dane$depresja[dane$grupa == b])
cat(sprintf("Depresja, g: fobia vs bez = %.2f; inne vs bez = %.2f; fobia vs inne = %.2f\n",
            dep("fobia", "bez")$Hedges_g, dep("inne", "bez")$Hedges_g, dep("fobia", "inne")$Hedges_g))
# Różnica fobia – bez rozpoznania przy stałym poziomie depresji (model liniowy)
m0 <- lm(wynik ~ grupa, dane, subset = grupa %in% c("bez", "fobia"))
m1 <- lm(wynik ~ grupa + depresja, dane, subset = grupa %in% c("bez", "fobia"))
print(round(rbind(bez_korekty = coef(m0)["grupafobia"], z_korekta = coef(m1)["grupafobia"]), 2))
print(round(confint(m1)["grupafobia", ], 2))
Wynik w R
alfa Cronbacha = 0.94
  grupa wynik.n wynik.M wynik.SD depresja.n depresja.M depresja.SD
1   bez     180    2.83    0.757        180       5.83        3.70
2  inne      60    3.21    0.837         60      12.00        3.80
3 fobia      60    3.92    0.769         60      12.70        3.93
  H   porownanie roznica    t    df       p    g CI_dol CI_gora oczekiwane potwierdzona
 H1  fobia > bez    1.08 9.48  99.9 1.4e-15 1.42   1.10    1.74     ≥ 0.80         TRUE
 H2 fobia > inne    0.71 4.84 117.2 4.0e-06 0.88   0.50    1.25     ≥ 0.50         TRUE
 H3   inne > bez    0.37 3.05  93.3 2.9e-03 0.48   0.18    0.77  0.20–0.80         TRUE
Potwierdzone hipotezy: 3 z 3 (100%)
Depresja, g: fobia vs bez = 1.82; inne vs bez = 1.65; fobia vs inne = 0.18
            grupafobia
bez_korekty       1.08
z_korekta         0.60
 2.5 % 97.5 %
  0.33   0.87
2. Krzywa ROC jako uzupełnienie
R
# B268 – krzywa ROC jako uzupełnienie metody grup znanych (pROC)
# Wymaga obiektu dane z przepisu 1 (ten sam plik CSV: grupy-znane-dane-przyklad.csv)
suppressPackageStartupMessages(library(pROC))
if (!exists("dane")) dane <- read.csv("../grupy-znane-dane-przyklad.csv")
roc_para <- function(a, b) {
  d <- subset(dane, grupa %in% c(a, b))
  roc(factor(d$grupa, levels = c(b, a)), d$wynik, levels = c(b, a), direction = "<", quiet = TRUE)
}
r1 <- roc_para("fobia", "bez")     # grupa kliniczna wobec osób bez rozpoznania
r2 <- roc_para("fobia", "inne")    # fobia społeczna wobec innych zaburzeń lękowych
for (r in list(fobia_vs_bez = r1, fobia_vs_inne = r2)) {
  a <- ci.auc(r, method = "delong")
  cat(sprintf("AUC = %.2f, 95%% CI [%.2f, %.2f]\n", a[2], a[1], a[3]))
}
# Najlepszy próg według indeksu Youdena w porównaniu fobia vs bez rozpoznania (tylko opisowo)
print(round(coords(r1, "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity")), 2))
# Związek AUC z d przy rozkładach normalnych o równej wariancji: AUC = pnorm(d / sqrt(2))
cat(sprintf("pnorm(1.42 / sqrt(2)) = %.2f; pnorm(0.88 / sqrt(2)) = %.2f\n", pnorm(1.42 / sqrt(2)), pnorm(0.88 / sqrt(2))))
Wynik w R
AUC = 0.84, 95% CI [0.77, 0.90]
AUC = 0.73, 95% CI [0.64, 0.82]
  threshold sensitivity specificity
1      3.65         0.7        0.87
pnorm(1.42 / sqrt(2)) = 0.84; pnorm(0.88 / sqrt(2)) = 0.73
3. Symulacja: jak grupa porównawcza zmienia g
R
# B268 – jak dobór grupy porównawczej zmienia wielkość efektu (symulacja, set.seed(2683))
# Ten sam model pomiaru co w przepisie 1. Grupa z fobią społeczną (n = 60) porównana z:
# (a) losową próbą 180 osób studiujących albo (b) 180 „zdrowymi ochotnikami”, czyli osobami
# z dolnej połowy rozkładu lęku (tak działa wykluczanie każdego, kto zgłasza jakiekolwiek objawy).
suppressPackageStartupMessages(library(effectsize))
set.seed(2683)
progi <- c(-1.3, -0.3, 0.6, 1.6)
skala <- function(theta) rowMeans(sapply(1:10, function(j)
  findInterval(0.75 * theta + rnorm(length(theta), 0, 0.66), progi) + 1))
R <- 500
g <- t(replicate(R, {
  fobia <- skala(rnorm(60, 1.6, 1))
  populacja <- rnorm(5000, 0, 1)
  losowa <- skala(sample(populacja, 180))
  zdrowi <- skala(sample(populacja[populacja < median(populacja)], 180))
  c(losowa = hedges_g(fobia, losowa)$Hedges_g, zdrowi = hedges_g(fobia, zdrowi)$Hedges_g)
}))
print(round(apply(g, 2, quantile, c(.025, .5, .975)), 2))
Wynik w R
      losowa zdrowi
2.5%    1.20   2.74
50%     1.50   3.29
97.5%   1.85   3.79
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym metoda grup znanych różni się od trafności kryterialnej?
W trafności kryterialnej sprawdzasz, jak dokładnie wynik skali odtwarza konkretne kryterium, np. rozpoznanie, i podajesz czułość, swoistość lub korelację. W metodzie grup znanych sprawdzasz, czy różnice między grupami mają kierunek i wielkość przewidziane przez teorię. To dowód trafności teoretycznej. Te same dane mogą służyć obu celom, ale hipotezy są inne.
Ile grup potrzeba w metodzie grup znanych?
Wystarczą dwie, ale trzy dają znacznie więcej. Porównanie grupy klinicznej z osobami zdrowymi zwykle wychodzi łatwo. Trzecia grupa „bliskiego sąsiada”, np. osoby z innym zaburzeniem lękowym, sprawdza, czy skala mierzy właśnie tę cechę, a nie ogólne nasilenie objawów. W przykładzie ta różnica wyniosła g = 0.88.
Jaką wielkość efektu przyjąć w hipotezie grup znanych?
Najlepiej opartą na różnicach opisanych dla podobnych narzędzi w tych samych grupach. Gdy ich brak, zwykle oczekuje się efektu dużego (d ≥ 0.80) przy porównaniu z grupą bez rozpoznania i umiarkowanego (d ≥ 0.50) przy porównaniu z grupą podobną. Zapisz też regułę decyzji: czy wystarczy oszacowanie punktowe, czy cały 95% CI musi przekroczyć próg.
Czy w metodzie grup znanych wystarczy wartość p?
Nie. Istotna różnica może być zbyt mała, by świadczyć o trafności, zwłaszcza w dużej próbie. O potwierdzeniu hipotezy decydują kierunek i wielkość efektu zapisane przed analizą, np. g Hedgesa z 95% CI. Wytyczne COSMIN uznają wynik za wystarczający, gdy co najmniej 75% rezultatów zgadza się z hipotezami (Prinsen i in., 2018).
Co zrobić, gdy grupy znane różnią się też wiekiem lub innymi cechami?
Opisz te różnice w tabeli i oceń, czy mogą wyjaśnić wynik skali. Najlepszym zabezpieczeniem jest dobór grupy porównawczej podobnej pod tymi względami. Korekta o kowariant w modelu pomaga tylko wtedy, gdy kowariant nie jest skutkiem mierzonej cechy, bo inaczej odejmuje też część efektu, który chcesz pokazać.
Powiązane hasła
Przeczytaj też
Rodzaje trafności – mapa dowodów
Tradycyjne nazwy trafności na mapie pięciu źródeł dowodów (Standards, 2014): jak zebrać dowód, jaka analiza, jak opisać w pracy i które 2–3 rodzaje dowodów zaplanować.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →Walidujesz skalę w pracy i nie wiesz, jakie grupy porównać?
Sprawdzimy dobór grup znanych, zapis hipotez i analizę wielkości efektu oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957 ● Otwarty dostęp: pełny tekst
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Hattie, J., & Cooksey, R. W. (1984). Procedures for assessing the validities of tests using the “known-groups” method. Applied Psychological Measurement, 8(3), 295–305. https://doi.org/10.1177/014662168400800306 ● Otwarty dostęp: pełny tekst
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Prinsen, C. A. C., Mokkink, L. B., Bouter, L. M., Alonso, J., Patrick, D. L., de Vet, H. C. W., & Terwee, C. B. (2018). COSMIN guideline for systematic reviews of patient-reported outcome measures. Quality of Life Research, 27(5), 1147–1157. https://doi.org/10.1007/s11136-018-1798-3 ● Otwarty dostęp
- Ransohoff, D. F., & Feinstein, A. R. (1978). Problems of spectrum and bias in evaluating the efficacy of diagnostic tests. New England Journal of Medicine, 299(17), 926–930. https://doi.org/10.1056/nejm197810262991705
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77 ● Otwarty dostęp
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{cronbach1955construct, author={Cronbach, Lee J. and Meehl, Paul E.}, title={{Construct validity in psychological tests}}, journal={Psychological Bulletin}, year={1955}, volume={52}, number={4}, pages={281--302}, doi={10.1037/h0040957}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{hattie1984procedures, author={Hattie, John and Cooksey, Ray W.}, title={{Procedures for assessing the validities of tests using the “known-groups” method}}, journal={Applied Psychological Measurement}, year={1984}, volume={8}, number={3}, pages={295--305}, doi={10.1177/014662168400800306}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{prinsen2018cosmin, author={Prinsen, C. A. C. and Mokkink, L. B. and Bouter, L. M. and Alonso, J. and Patrick, D. L. and de Vet, H. C. W. and Terwee, C. B.}, title={{COSMIN guideline for systematic reviews of patient-reported outcome measures}}, journal={Quality of Life Research}, year={2018}, volume={27}, number={5}, pages={1147--1157}, doi={10.1007/s11136-018-1798-3}}@article{ransohoff1978problems, author={Ransohoff, David F. and Feinstein, Alvan R.}, title={{Problems of spectrum and bias in evaluating the efficacy of diagnostic tests}}, journal={New England Journal of Medicine}, year={1978}, volume={299}, number={17}, pages={926--930}, doi={10.1056/nejm197810262991705}}@article{robin2011proc, author={Robin, Xavier and Turck, Natacha and Hainard, Alexandre and Tiberti, Natalia and Lisacek, Frédérique and Sanchez, Jean-Charles and Müller, Markus}, title={{pROC: An open-source package for R and S+ to analyze and compare ROC curves}}, journal={BMC Bioinformatics}, year={2011}, volume={12}, number={1}, eid={77}, doi={10.1186/1471-2105-12-77}}