Czym jest trafność fasadowa
Trafność fasadowa (ang. face validity) to ocena tego, czy pozycje kwestionariusza na pierwszy rzut oka „wyglądają” na związane z tym, co narzędzie ma mierzyć. Holden (2010) definiuje ją jako stopień, w jakim osoby wypełniające test uznają jego treść i pozycje za stosowne i związane z sytuacją, w której test jest stosowany. Pytanie brzmi więc nie „czy skala mierzy lęk?”, ale „czy osobie badanej wydaje się, że pytania dotyczą lęku?”.
Oceniają ją zwykle ludzie spoza psychometrii: osoby badane, przyszli użytkownicy wyników albo laicy. Czasem pyta się też ekspertów, ale wtedy łatwo pomylić trafność fasadową z treściową. Allen i in. (2023) zwracają uwagę, że w różnych dziedzinach termin ten znaczy co innego i stąd bierze się wiele nieporozumień. W pracy zawsze więc napisz, kto oceniał i o co go zapytano.
Ten wpis nie omawia trafności w ogóle. Definicję i współczesne ujęcie znajdziesz w haśle trafność w psychometrii, a całą drogę od pomysłu do zwalidowanej skali opisuje poradnik jak zbudować i zwalidować skalę psychometryczną. Tutaj zajmujemy się tylko jednym, małym elementem tej drogi: co zrobić z trafnością fasadową w pracy magisterskiej lub doktorskiej, jak ją sprawdzić i jak o niej uczciwie napisać.
Trafność fasadowa a treściowa
Najczęstszy błąd w rozdziale metodologicznym to traktowanie obu pojęć jak synonimów. Różnią się tym, kto ocenia, o co się pyta i co z oceny wynika.
| Cecha | Trafność fasadowa | Trafność treściowa |
|---|---|---|
| Kto ocenia | osoby z grupy docelowej, laicy, użytkownicy | panel ekspertów z dziedziny konstruktu |
| Pytanie | czy pozycje wyglądają na związane z tematem i są zrozumiałe? | czy pozycje są trafne dla definicji konstruktu i czy razem pokrywają całą jego treść? |
| Sposób oceny | krótka ankieta ocen, komentarze, rozmowa po wypełnieniu | systematyczna ocena każdej pozycji według definicji konstruktu |
| Wskaźnik | średnia ocena i odsetek ocen wysokich (bez ustalonego standardu) | I-CVI i S-CVI, CVR Lawshe'a |
| Status | informacja o akceptowalności narzędzia | jedno ze źródeł dowodów trafności |
Różnica w statusie jest najważniejsza. Ekspert oceniający trafność treściową porównuje pozycje z pisemną definicją konstruktu i mówi, czego brakuje. Respondent oceniający trafność fasadową mówi, jak narzędzie odbiera. Obie informacje są potrzebne, ale tylko pierwsza jest dowodem, że treść narzędzia odpowiada konstruktowi.
Co mówią Standards: pięć źródeł dowodów trafności
Najważniejszym punktem odniesienia w psychometrii są Standards for Educational and Psychological Testing (American Educational Research Association i in., 2014). Traktują one trafność jako stopień, w jakim dowody wspierają określoną interpretację wyników, i porządkują te dowody według pięciu źródeł: treści testu, procesów odpowiadania, struktury wewnętrznej, związków z innymi zmiennymi oraz konsekwencji użycia wyników (Hawkins i in., 2018). Trafności fasadowej na tej liście nie ma.
Cook i Beckman (2006) piszą wprost, że nowsze ujęcia zastępują dawny podział na trafność fasadową, treściową i kryterialną jednym pojęciem trafności teoretycznej, wspieranym przez dowody z tych pięciu źródeł. Royal (2016) przejrzał artykuły w jednym czasopiśmie chirurgicznym i znalazł 30 prac, które podawały trafność fasadową jako część dowodów trafności. Jego zdaniem teoretycy trafności zgodnie uznają, że takiego rodzaju dowodu nie ma.
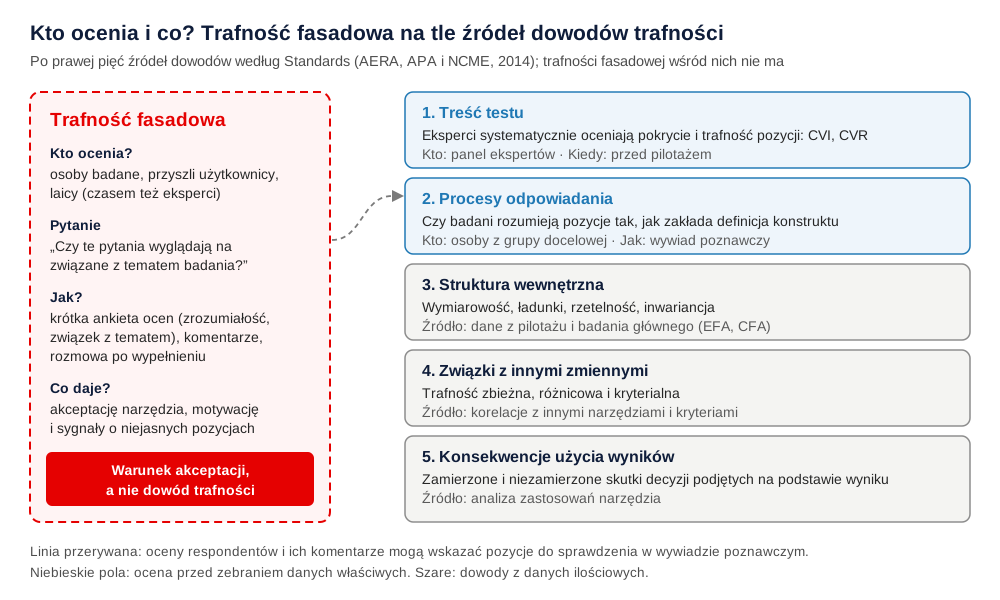
Rysunek pokazuje też, gdzie oceny respondentów mogą stać się czymś więcej. Jeśli zapytasz badanych nie tylko „czy to pasuje do tematu?”, ale także „jak rozumiesz to pytanie?”, zbierasz już dowody oparte na procesach odpowiadania. Peterson i in. (2017) opisują wywiad poznawczy właśnie jako źródło dowodów opartych na treści i na procesach odpowiadania. Krok po kroku prowadzi przez niego wpis wywiad poznawczy w pilotażu.
Argumenty za i przeciw
Skoro trafność fasadowa nie jest dowodem trafności, to po co ją oceniać? Bo dotyczy czegoś innego: tego, czy ludzie zechcą narzędzie wypełnić i potraktować poważnie.
Za:
- Akceptacja i motywacja. Pytania, które wydają się badanym bez sensu, mogą ich zniechęcać do starannego wypełnienia całego kwestionariusza. Narzędzie, które „wygląda poważnie”, łatwiej też przyjmują użytkownicy wyników, np. nauczyciele czy personel kliniki.
- Jakość odpowiedzi. Connell i in. (2018) pytali użytkowników usług zdrowia psychicznego o proponowane pozycje nowego narzędzia. Akceptowane pozycje miały być istotne, jednoznaczne, łatwe do odpowiedzi także w gorszym samopoczuciu, niewywołujące przykrości i nieoceniające. To, czy badani akceptowali pozycję, wiązało się z ich zdolnością lub zamiarem udzielenia trafnej i szczerej odpowiedzi.
- Wczesny sygnał problemów. Niska ocena zrozumiałości szybko wskazuje pozycje, które warto zbadać w wywiadzie poznawczym lub w badaniu pilotażowym.
Przeciw:
- Nie jest dowodem trafności. To, że pozycja wygląda na pytanie o lęk, nie znaczy, że wynik zależy od lęku. Dowodu dostarczają analiza struktury, trafność zbieżna, różnicowa i kryterialna.
- Przejrzystość ułatwia upiększanie odpowiedzi. Im bardziej oczywiste, czego dotyczy pozycja, tym łatwiej świadomie dopasować odpowiedź do oczekiwań. To ryzyko rośnie przy pytaniach drażliwych i w sytuacjach, w których od wyniku coś zależy, np. w rekrutacji. Paulhus (1984) pokazał, że zwłaszcza świadome zarządzanie wrażeniem nasila się, gdy odpowiedzi nie są anonimowe. Więcej w haśle aprobata społeczna.
- Brak ustalonych standardów. Nie ma powszechnie przyjętego wskaźnika ani progu. Każdy próg, np. 80% ocen wysokich, jest decyzją badacza i trzeba go ustalić przed zebraniem ocen.
Rozsądne stanowisko jest więc pośrodku. Oceń trafność fasadową, bo pomaga zbudować narzędzie, które ludzie zrozumieją i zechcą wypełnić. Nie wyciągaj z niej jednak wniosków o trafności pomiaru.
Jak ocenić trafność fasadową w praktyce
Nevo (1985) przedstawił dane, z których wynika, że trafność fasadową da się mierzyć rzetelnie, a nie tylko deklarować. W pracy dyplomowej wystarczy prosta, dobrze opisana procedura. Najczęściej łączy się ją z pilotażem.
- Wybierz osoby z grupy docelowej. Nie kolegów z seminarium, tylko ludzi podobnych do przyszłych respondentów. Liczbę osób dopasuj do możliwości, ale pamiętaj, że przy małej próbie odsetki mają szerokie przedziały ufności.
- Zadaj dwa krótkie pytania o każdą pozycję, np. o zrozumiałość (1–4) i o związek z tematem (1–4). Skala czterostopniowa nie ma środka, więc respondent musi się opowiedzieć. Dodaj pole na komentarz.
- Zapytaj o całość: czy kwestionariusz jako całość dotyczy tego, co zapowiada instrukcja.
- Ustal regułę decyzji przed zebraniem ocen, np. „pozycja do przeglądu, gdy mniej niż 80% ocen to 3 lub 4”. Wpisz ją do protokołu.
- Policz średnią i odsetek ocen 3–4 dla każdej pozycji, najlepiej z przedziałem ufności. Wynik pokaż w tabeli.
- Przejrzyj pozycje oznaczone regułą razem z komentarzami. Niejasne pozycje sprawdź w wywiadzie poznawczym, zanim cokolwiek usuniesz.
Jeśli adaptujesz istniejące narzędzie, ocena respondentów jest jednym z etapów adaptacji kulturowej kwestionariusza, obok tłumaczenia, oceny ekspertów i pilotażu. Nie zastępuje żadnego z nich.
Przykład: 24 oceny ośmiu pozycji
Dane są fikcyjne i wygenerowane w R. 24 osoby studiujące oceniły osiem pozycji nowej skali lęku przed wystąpieniami publicznymi. Każda pozycja dostała ocenę zrozumiałości i związku z tematem na skali od 1 do 4. Przed zebraniem ocen przyjęto regułę: pozycja idzie do przeglądu, gdy na którejkolwiek skali mniej niż 80% ocen to 3 lub 4.
| Pozycja | Zrozumiałość M | % ocen 3–4 [95% CI] | Związek z tematem M | % ocen 3–4 [95% CI] | Decyzja |
|---|---|---|---|---|---|
| P1 | 3.50 | 92 [73, 99] | 3.62 | 92 [73, 99] | zostaje |
| P2 | 3.58 | 96 [79, 100] | 3.46 | 96 [79, 100] | zostaje |
| P3 | 2.71 | 62 [41, 81] | 3.58 | 100 [86, 100] | do przeglądu |
| P4 | 3.46 | 88 [68, 97] | 3.62 | 96 [79, 100] | zostaje |
| P5 | 3.67 | 100 [86, 100] | 3.71 | 96 [79, 100] | zostaje |
| P6 | 3.54 | 96 [79, 100] | 3.08 | 67 [45, 84] | do przeglądu |
| P7 | 3.50 | 92 [73, 99] | 3.42 | 92 [73, 99] | zostaje |
| P8 | 3.38 | 83 [63, 95] | 3.54 | 83 [63, 95] | zostaje |
Jak czytać tabelę:
- P3 jest dla badanych niejasna (62% ocen 3–4), choć wszyscy uznali, że dotyczy tematu. To typowy kandydat do przeformułowania i sprawdzenia w wywiadzie poznawczym.
- P6 jest zrozumiała, ale co trzecia osoba nie widzi jej związku z tematem (67%). Nie usuwaj jej automatycznie. Jeśli eksperci uznali ją za trafną dla definicji konstruktu, niska ocena laików może być wręcz zaletą: trudniej świadomie „poprawić” na niej wynik. Wtedy wystarczy czasem lepsze wprowadzenie w instrukcji.
- P8 spełnia regułę (83%), ale dolna granica przedziału ufności to 63%. Przy 24 osobach jedna ocena zmienia odsetek o ponad 4 punkty procentowe, więc wynik blisko progu traktuj ostrożnie.
Pozostałe pozycje uzyskały od 83% do 100% ocen 3–4. Kwestionariusz jako całość za związany z tematem uznały 92% osób (M = 3.38). Kod, który odtwarza wszystkie liczby, jest poniżej.
Oceny trafności fasadowej w R
Kod używa tylko bazowego R. Dla każdej pozycji liczy średnią ocenę, odsetek ocen 3–4 i dokładny 95% przedział ufności dla odsetka (binom.test()), a potem stosuje regułę decyzji ustaloną przed zebraniem ocen. Własne dane wstaw jako macierze osoby × pozycje w miejsce obiektów zrozumialosc i zwiazek.
1. Odsetek ocen 3–4 z przedziałem ufności i reguła decyzji
R
# B249 – ocena trafności fasadowej przez respondentów (dane fikcyjne, set.seed(2490))
# 24 osoby z grupy docelowej oceniają 8 pozycji nowej skali lęku przed wystąpieniami
# na dwóch skalach 1–4: zrozumiałość (1 = zupełnie niezrozumiała, 4 = całkowicie
# zrozumiała) i związek z tematem (1 = nie ma związku z tematem, 4 = wyraźnie dotyczy tematu).
set.seed(2490)
n <- 24
pozycje <- paste0("P", 1:8)
dobra <- c(.02, .06, .32, .60)  # prawdopodobieństwa ocen 1, 2, 3, 4
slaba <- c(.12, .30, .38, .20)
ocen <- function(slabe) sapply(pozycje, function(p) sample(1:4, n, TRUE, if (p %in% slabe) slaba else dobra))
zrozumialosc <- ocen("P3")  # P3: niejasne sformułowanie
zwiazek <- ocen("P6")       # P6: pytanie, które wygląda na niezwiązane z tematem
# Podsumowanie pozycji: średnia i odsetek ocen 3–4 z dokładnym 95% CI
podsumuj <- function(m) {
  k <- colSums(m >= 3)
  ci <- sapply(k, function(x) binom.test(x, n)$conf.int * 100)
  data.frame(M = round(colMeans(m), 2), proc = round(100 * k / n), ci = sprintf("[%.0f, %.0f]", ci[1, ], ci[2, ]))
}
tab <- cbind(pozycja = pozycje, setNames(podsumuj(zrozumialosc), c("jasn_M", "jasn_proc", "jasn_CI")),
             setNames(podsumuj(zwiazek), c("zwiazek_M", "zwiazek_proc", "zwiazek_CI")))
# Reguła ustalona przed zebraniem ocen: pozycja do przeglądu, gdy mniej niż 80% ocen 3–4 na którejkolwiek skali
tab$decyzja <- ifelse(tab$jasn_proc < 80 | tab$zwiazek_proc < 80, "do przeglądu", "zostaje")
print(tab, row.names = FALSE)
# Zakres odsetków ocen 3–4 dla pozycji bez zastrzeżeń
ok <- tab$decyzja == "zostaje"
range(c(tab$jasn_proc[ok], tab$zwiazek_proc[ok]))
# Ocena całości: „Czy ten kwestionariusz dotyczy tego, jak czujesz się podczas wystąpień?” (1–4)
calosc <- sample(1:4, n, TRUE, c(.02, .08, .40, .50))
c(M = round(mean(calosc), 2), proc_34 = round(100 * mean(calosc >= 3)))
Wynik w R
 pozycja jasn_M jasn_proc   jasn_CI zwiazek_M zwiazek_proc zwiazek_CI      decyzja
      P1   3.50        92  [73, 99]      3.62           92   [73, 99]      zostaje
      P2   3.58        96 [79, 100]      3.46           96  [79, 100]      zostaje
      P3   2.71        62  [41, 81]      3.58          100  [86, 100] do przeglądu
      P4   3.46        88  [68, 97]      3.62           96  [79, 100]      zostaje
      P5   3.67       100 [86, 100]      3.71           96  [79, 100]      zostaje
      P6   3.54        96 [79, 100]      3.08           67   [45, 84] do przeglądu
      P7   3.50        92  [73, 99]      3.42           92   [73, 99]      zostaje
      P8   3.38        83  [63, 95]      3.54           83   [63, 95]      zostaje
[1]  83 100
      M proc_34
   3.38   92.00
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 bez dodatkowych pakietów; rysunek 1 to schemat przygotowany ręcznie. W pracy podaj wersję R, której faktycznie użyto (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
Jak opisać trafność fasadową w rozdziale metodologicznym
Opis trafi do podrozdziału o narzędziu albo o pilotażu. Podaj, kto oceniał, o co go pytano, jaką regułę przyjęto i co zmieniono. Ogólną budowę tej części pracy omawia wpis rozdział metodologiczny.
Zdania o ekspertach i wywiadach wpisz tylko wtedy, gdy te etapy naprawdę się odbyły. Jeśli korzystasz z gotowego, zwalidowanego narzędzia, oceny trafności fasadowej zwykle nie trzeba robić. Wystarczy opisać dowody trafności z publikacji źródłowej.
Czego nie pisać. Zdanie „skala ma trafność fasadową, więc jest trafna” zawiera błąd logiczny. Wygląd pozycji nie mówi nic o tym, czy wynik odzwierciedla konstrukt. Równie słabe są zdania „trafność fasadową potwierdził promotor” albo „pozycje mają oczywistą trafność fasadową”. Nie mówią, kto oceniał, jak i z jakim wynikiem. Jeśli chcesz napisać coś o trafności narzędzia, odwołaj się do dowodów z pięciu źródeł, np. analizy czynnikowej i korelacji z innymi skalami. Przykład takiej analizy znajdziesz we wpisie o trafności zbieżnej i różnicowej (AVE, HTMT).
Najczęstsze błędy
- Trafność fasadowa jako jedyny „dowód trafności”. To najczęstszy zarzut recenzentów wobec nowych skal w pracach dyplomowych.
- Mylenie z trafnością treściową. Opinia trzech kolegów o tym, że „pytania są w porządku”, to nie ocena ekspertów ani CVI.
- Ocena bez procedury. Brak liczby osób, pytań, skali ocen i reguły decyzji.
- Próg ustalony po obejrzeniu wyników. Wtedy reguła tylko potwierdza decyzje podjęte wcześniej.
- Usuwanie pozycji wyłącznie z powodu niskiej oceny laików. Pozycja może być trafna, choć nie wygląda na związaną z tematem. Decyzję oprzyj też na ocenie ekspertów i wywiadach.
- Sam odsetek przy bardzo małej próbie. Przy kilkunastu osobach podaj przedział ufności albo przynajmniej liczby osób.
- Pomylenie z trafnością badania. Trafność fasadowa dotyczy narzędzia, a nie wniosków z badania. Wnioski przyczynowe opisuje trafność wewnętrzna badania.
Pełną ścieżkę pracy ze skalą, od definicji konstruktu po rzetelność i trafność, zbiera przewodnik po psychometrii i budowie skal. Jeśli chcesz, żeby ktoś sprawdził plan pilotażu i opis narzędzia w Twojej pracy, możesz skorzystać z oferty analizy statystyczne dla studentów. Wyniki i decyzje musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy trafność fasadowa jest rodzajem trafności?
Nie w ujęciu współczesnej psychometrii. Standards for Educational and Psychological Testing (2014) porządkują dowody trafności według pięciu źródeł: treści, procesów odpowiadania, struktury wewnętrznej, związków z innymi zmiennymi i konsekwencji. Trafności fasadowej wśród nich nie ma. Nazwa przetrwała z dawnych podziałów i opisuje raczej akceptowalność narzędzia w oczach badanych niż dowód, że wynik mierzy konstrukt.
Kto powinien oceniać trafność fasadową kwestionariusza?
Przede wszystkim osoby podobne do przyszłych respondentów, a czasem także użytkownicy wyników, np. nauczyciele czy personel kliniki. Eksperci z dziedziny konstruktu oceniają co innego: trafność treściową, czyli dopasowanie pozycji do definicji konstruktu i pokrycie jego treści (CVI, CVR). W opisie zawsze podaj, kto oceniał i o co był pytany.
Czy w pracy magisterskiej muszę badać trafność fasadową?
Nie ma takiego obowiązku. Przy gotowym, zwalidowanym narzędziu zwykle wystarczy opisać dowody trafności z publikacji źródłowej. Przy nowej lub adaptowanej skali ocena respondentów w pilotażu jest dobrym, tanim krokiem, ale tylko obok oceny ekspertów, wywiadów poznawczych i analiz psychometrycznych, a nie zamiast nich.
Jaki próg przyjąć przy ocenie trafności fasadowej?
Nie ma powszechnie przyjętego progu. Popularne rozwiązanie to odsetek ocen 3–4 na czterostopniowej skali zrozumiałości i związku z tematem, z regułą typu „pozycja do przeglądu poniżej 80%”. Taki próg jest decyzją badacza, więc ustal go przed zebraniem ocen, zapisz w protokole i przy małej próbie podaj przedziały ufności.
Czy niska trafność fasadowa pozycji oznacza, że trzeba ją usunąć?
Nie automatycznie. Jeśli pozycja jest niezrozumiała, popraw ją i sprawdź w wywiadzie poznawczym. Jeśli jest zrozumiała, ale badani nie widzą jej związku z tematem, a eksperci uznali ją za trafną, możesz ją zostawić. Mniej oczywiste pozycje bywają nawet odporniejsze na świadome upiększanie odpowiedzi. Decyzję uzasadnij w pracy.
Powiązane hasła
Przeczytaj też
Wywiad poznawczy w pilotażu krok po kroku
Protokół do pobrania, dwie rundy wywiadów, arkusz kodowania według etapów odpowiadania, zliczenie problemów w R, poprawki pytań i wzór opisu w pracy.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAdaptacja kulturowa kwestionariusza
Dziesięć etapów według ITC: zgoda autora, przekład, CVI, wywiady poznawcze, pilotaż, CFA i inwariancja w R, rzetelność, trafność, normy i opis APA.
Czytaj →Budujesz lub adaptujesz kwestionariusz i nie wiesz, jak opisać jego trafność?
Sprawdzimy plan pilotażu i ocen respondentów, dobór dowodów trafności i analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Allen, M. S., Robson, D. A., & Iliescu, D. (2023). Face validity. European Journal of Psychological Assessment, 39(3), 153–156. https://doi.org/10.1027/1015-5759/a000777 ● Otwarty dostęp
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Connell, J., Carlton, J., Grundy, A., Taylor Buck, E., Keetharuth, A. D., Ricketts, T., Barkham, M., Robotham, D., Rose, D., & Brazier, J. (2018). The importance of content and face validity in instrument development: Lessons learnt from service users when developing the Recovering Quality of Life measure (ReQoL). Quality of Life Research, 27(7), 1893–1902. https://doi.org/10.1007/s11136-018-1847-y ● Otwarty dostęp
- Cook, D. A., & Beckman, T. J. (2006). Current concepts in validity and reliability for psychometric instruments: Theory and application. The American Journal of Medicine, 119(2), 166.e7–166.e16. https://doi.org/10.1016/j.amjmed.2005.10.036
- Hawkins, M., Elsworth, G. R., & Osborne, R. H. (2018). Application of validity theory and methodology to patient-reported outcome measures (PROMs): Building an argument for validity. Quality of Life Research, 27(7), 1695–1710. https://doi.org/10.1007/s11136-018-1815-6 ● Otwarty dostęp
- Holden, R. R. (2010). Face validity. In I. B. Weiner & W. E. Craighead (Eds.), The Corsini encyclopedia of psychology (4th ed., pp. 1–2). Wiley. https://doi.org/10.1002/9780470479216.corpsy0341
- Nevo, B. (1985). Face validity revisited. Journal of Educational Measurement, 22(4), 287–293. https://doi.org/10.1111/j.1745-3984.1985.tb01065.x
- Paulhus, D. L. (1984). Two-component models of socially desirable responding. Journal of Personality and Social Psychology, 46(3), 598–609. https://doi.org/10.1037/0022-3514.46.3.598
- Peterson, C. H., Peterson, N. A., & Powell, K. G. (2017). Cognitive interviewing for item development: Validity evidence based on content and response processes. Measurement and Evaluation in Counseling and Development, 50(4), 217–223. https://doi.org/10.1080/07481756.2017.1339564
- Royal, K. D. (2016). “Face validity” is not a legitimate type of validity evidence! The American Journal of Surgery, 212(5), 1026–1027. https://doi.org/10.1016/j.amjsurg.2016.02.018
Cytowania BibTeX
@article{allen2023face, author={Allen, Mark S. and Robson, Davina A. and Iliescu, Dragos}, title={{Face validity}}, journal={European Journal of Psychological Assessment}, year={2023}, volume={39}, number={3}, pages={153--156}, doi={10.1027/1015-5759/a000777}}@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{connell2018importance, author={Connell, Janice and Carlton, Jill and Grundy, Andrew and Taylor Buck, Elizabeth and Keetharuth, Anju Devianee and Ricketts, Thomas and Barkham, Michael and Robotham, Dan and Rose, Diana and Brazier, John}, title={{The importance of content and face validity in instrument development: Lessons learnt from service users when developing the Recovering Quality of Life measure (ReQoL)}}, journal={Quality of Life Research}, year={2018}, volume={27}, number={7}, pages={1893--1902}, doi={10.1007/s11136-018-1847-y}}@article{cook2006current, author={Cook, David A. and Beckman, Thomas J.}, title={{Current concepts in validity and reliability for psychometric instruments: Theory and application}}, journal={The American Journal of Medicine}, year={2006}, volume={119}, number={2}, pages={166.e7--166.e16}, doi={10.1016/j.amjmed.2005.10.036}}@article{hawkins2018application, author={Hawkins, Melanie and Elsworth, Gerald R. and Osborne, Richard H.}, title={{Application of validity theory and methodology to patient-reported outcome measures (PROMs): Building an argument for validity}}, journal={Quality of Life Research}, year={2018}, volume={27}, number={7}, pages={1695--1710}, doi={10.1007/s11136-018-1815-6}}@incollection{holden2010face, author={Holden, Ronald R.}, title={{Face validity}}, booktitle={The Corsini encyclopedia of psychology}, year={2010}, pages={1--2}, edition={4}, publisher={Wiley}, doi={10.1002/9780470479216.corpsy0341}}@article{nevo1985face, author={Nevo, Baruch}, title={{Face validity revisited}}, journal={Journal of Educational Measurement}, year={1985}, volume={22}, number={4}, pages={287--293}, doi={10.1111/j.1745-3984.1985.tb01065.x}}@article{paulhus1984two, author={Paulhus, Delroy L.}, title={{Two-component models of socially desirable responding}}, journal={Journal of Personality and Social Psychology}, year={1984}, volume={46}, number={3}, pages={598--609}, doi={10.1037/0022-3514.46.3.598}}@article{peterson2017cognitive, author={Peterson, Christina Hamme and Peterson, N. Andrew and Powell, Kristen Gilmore}, title={{Cognitive interviewing for item development: Validity evidence based on content and response processes}}, journal={Measurement and Evaluation in Counseling and Development}, year={2017}, volume={50}, number={4}, pages={217--223}, doi={10.1080/07481756.2017.1339564}}@article{royal2016face, author={Royal, Kenneth D.}, title={{“Face validity” is not a legitimate type of validity evidence!}}, journal={The American Journal of Surgery}, year={2016}, volume={212}, number={5}, pages={1026--1027}, doi={10.1016/j.amjsurg.2016.02.018}}