Czym jest trafność przyrostowa i kiedy jej potrzebujesz
Każda nowa skala musi kiedyś odpowiedzieć na pytanie recenzenta: „Co mierzy ta skala, czego nie mierzą już istniejące?”. Wysoka korelacja z kryterium nie wystarczy. Jeśli nowa miara przewiduje wypalenie tak samo dobrze jak znana skala, z którą jest silnie skorelowana, to jej przydatność jest wątpliwa. Trafność przyrostowa (ang. incremental validity) to stopień, w jakim miara wyjaśnia lub przewiduje badane zjawisko w porównaniu z innymi miarami (Haynes i Lench, 2003).
To jeden z dowodów trafności kryterialnej, a nie osobny rodzaj trafności. Jak łączy się z pozostałymi dowodami, pokazuje wpis rodzaje trafności – mapa dowodów. Hunsley i Meyer (2003) zauważyli, że w wielu obszarach psychologii stosowanej takich badań jest za mało. Tymczasem właśnie one uzasadniają, po co dokładać respondentom kolejne pytania.
W tym wpisie przechodzimy przez cały proces: plan badania, ΔR² z przedziałem ufności, wagi względne i analizę dominacji oraz pułapkę, którą jest błąd pomiaru w miarach kontrolnych. Mechanikę bloków, testu F zmiany i tabeli APA opisujemy we wpisie regresja hierarchiczna krok po kroku, więc tu jej nie powtarzamy.
Plan badania: kryterium, miary porównawcze i kolejność
Haynes i Lench (2003) podkreślają, że trafność przyrostowa jest warunkowa. Wynik zależy od tego, jakie kryterium wybierzesz, z jakimi miarami porównasz nową skalę i na jakiej próbie. Dlatego te trzy decyzje zapisz przed zebraniem danych, najlepiej w planie analizy.
| Decyzja | Pytanie kontrolne | Typowy błąd |
|---|---|---|
| Kryterium | Czy jest ważne samo w sobie i mierzone niezależnie od nowej skali? | kryterium z tego samego kwestionariusza i tego samego dnia |
| Miary porównawcze | Czy to najlepsze dostępne miary, z którymi nowa skala naprawdę konkuruje? | porównanie tylko z wiekiem i płcią albo ze słabą, krótką miarą |
| Kolejność bloków | Czy nowa skala wchodzi po miarach, ponad które ma działać? | kolejność dobrana po obejrzeniu wyników |
| Poziom wniosku | Czy pytasz o przewidywanie wynikami, czy o odrębność konstruktów? | wniosek o konstrukcie z regresji na nierzetelnych wynikach |
Hunsley i Meyer (2003) wymieniają trzy problemy, które najczęściej zniekształcają wyniki: kolejność wprowadzania predyktorów, interpretację wielkości przyrostu i artefakty wynikające z doboru kryterium. Jeśli nowa skala i kryterium to samoopisy wypełnione przez tę samą osobę w tym samym momencie, część ich związku może wynikać ze wspólnej metody pomiaru. Kryterium z innego źródła albo zmierzone później daje mocniejszy dowód, bliższy trafności prognostycznej. Zmienne demograficzne dodawaj do bloku kontrolnego tylko z uzasadnieniem (zob. czy kontrolować wiek i płeć).
Ważny jest też sam pomiar. Smith, Fischer i Fister (2003) zalecają badać trafność przyrostową na poziomie wąskich aspektów (faset) konstruktu, a nie tylko szerokiego wyniku ogólnego. Każdą fasetę trzeba przy tym mierzyć rzetelnie, kilkoma pozycjami. Szeroka skala łącząca kilka faset może ukryć to, że przyrost pochodzi tylko z jednej z nich.
Przykład: nowa skala perfekcjonizmu akademickiego
Zespół zbudował nową skalę perfekcjonizmu akademickiego (NSPA, 12–60 pkt). Chce wykazać, że przewiduje ona wypalenie studenckie ponad neurotyczność i ponad istniejącą skalę perfekcjonizmu ogólnego. Dane 320 osób studiujących są symulowane (set.seed(2721)), więc znamy prawdę: nowa skala ma własny, umiarkowany wkład. Możesz je pobrać jako plik CSV (320 wierszy: id, neur, perf, nspa, wyp).
| Zmienna | M | SD | 1 | 2 | 3 |
|---|---|---|---|---|---|
| 1. Neurotyczność | 23.80 | 6.27 | – | ||
| 2. Perfekcjonizm ogólny (istniejąca skala) | 59.94 | 12.31 | .29 | – | |
| 3. Perfekcjonizm akademicki (NSPA) | 36.64 | 7.96 | .25 | .56 | – |
| 4. Wypalenie (kryterium) | 44.58 | 10.10 | .43 | .36 | .42 |
Nowa skala koreluje z wypaleniem nieco silniej niż istniejąca (.42 wobec .36), ale obie są ze sobą skorelowane na poziomie .56. Sama korelacja nie rozstrzyga więc, czy NSPA wnosi coś nowego.
ΔR² z przedziałem ufności
W kroku 1 wprowadzamy neurotyczność i istniejącą skalę perfekcjonizmu, w kroku 2 – nową skalę. Model z kroku 1 wyjaśnia R² = .243 wariancji wypalenia, model z kroku 2 – .295. Przyrost wynosi ΔR² = .052, F(1, 316) = 23.30, p < .001. Odpowiada to f² = 0.074 (zob. f Cohena). W modelu pełnym nowa skala ma β = .28, a istniejąca β = .10. Porównanie b i β omawia wpis współczynniki standaryzowane czy niestandaryzowane.
Samo p nie mówi, jak dokładnie oszacowano przyrost. Dlatego dodaj przedział ufności z bootstrapu: losujesz osoby ze zwracaniem, dopasowujesz oba modele od nowa i liczysz ΔR² w każdej z 2000 prób. Przedział BCa wyniósł [.017, .103], a percentylowy [.017, .105]. Nawet ostrożne oszacowanie wskazuje więc, że nowa skala dodaje ponad 1.5% wyjaśnionej wariancji.
Zadaj też pytanie odwrotne: czy istniejąca skala wnosi coś ponad nową? Po dodaniu jej do modelu z neurotycznością i NSPA przyrost wynosi tylko ΔR² = .007, F(1, 316) = 3.05, p = .082, 95% CI BCa [.000, .027]. To mocny argument w dyskusji: nowa skala przejmuje prawie całą trafność starej, a odwrotnie tak nie jest. Przyrost zmiennej wprowadzonej jako ostatnia równa się kwadratowi jej korelacji semicząstkowej (sr²).
Wagi względne i analiza dominacji: inne pytanie
ΔR² przypisuje całą wariancję wspólną predyktorom z wcześniejszego bloku. Gdy miary są silnie skorelowane, recenzent może zapytać, jak ważna jest nowa skala na tle pozostałych. Na to pytanie odpowiadają miary ważności względnej. Johnson i LeBreton (2004) po przeglądzie wskaźników uznali analizę dominacji i wagi względne za najlepsze z dostępnych.
- Analiza dominacji (Budescu, 1993) porównuje przyrosty R² predyktora we wszystkich modelach z podzbiorami pozostałych zmiennych. Azen i Budescu (2003) uzupełnili ją o miary dominacji o różnej ścisłości i o bootstrap do oceny stabilności. Dominacja ogólna to średni przyrost predyktora, a suma tych średnich równa się R².
- Wagi względne (Johnson, 2000) dają prawie te same liczby, ale bez dopasowywania wszystkich podzbiorów. Predyktory zastępuje się zbiorem nieskorelowanych zmiennych najbliższych oryginałom, a wariancję wyjaśnianą przez te zmienne rozdziela się z powrotem na oryginalne predyktory. Metoda działa przy dowolnej liczbie predyktorów, a wagi także sumują się do R².
Żaden z używanych przez nas pakietów nie liczy tych miar, więc w przykładzie liczymy je kilkoma liniami bazowego R. Wagi względne wyniosły .136 dla neurotyczności (46% R²), .056 dla istniejącej skali (19%) i .104 dla NSPA (35%). Dominacja ogólna dała .134, .057 i .104, czyli prawie to samo. Bootstrapowy 95% CI dla wagi nowej skali to [.054, .165].
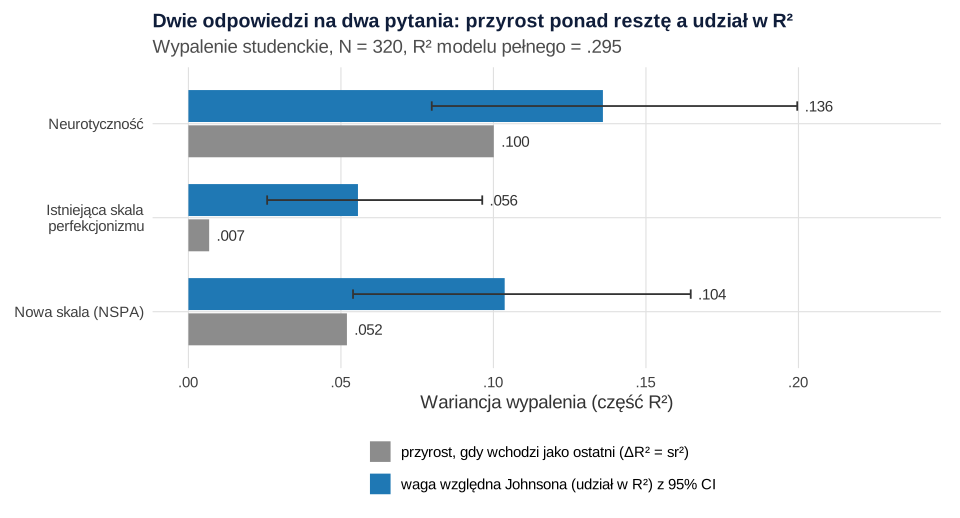
Rysunek pokazuje różnicę dwóch pytań. Istniejąca skala ma prawie zerowy przyrost (.007), ale jej waga względna jest wyraźnie większa (.056), bo dostaje część wariancji wspólnej z NSPA. Wagi nie są więc testem trafności przyrostowej. Różnica wag NSPA i istniejącej skali wyniosła .048, a jej 95% CI [−.012, .108] obejmuje zero. Na tej próbie nie da się zatem twierdzić, że nowa skala jest „ważniejsza” od starej, choć wyraźnie wnosi coś ponad nią. Johnson (2000) opisuje też sytuacje, w których jego metoda nie jest właściwa, więc przed użyciem sprawdź te zastrzeżenia. Przy silnej współliniowości zajrzyj też do wpisu wysoki VIF – co zrobić.
Błąd pomiaru w miarach kontrolnych: przyrost, którego nie ma
Regresja „kontroluje” wynik obserwowany, a nie konstrukt. Obserwowana korelacja dwóch miar zależy od ich prawdziwej korelacji i od rzetelności obu miar (Schmidt i Hunter, 1996). Jeśli miara kontrolna jest nierzetelna, usuwa tylko część wariancji swojego konstruktu. Reszta może trafić do nowej skali, o ile ta koreluje z konstruktem kontrolnym. Westfall i Yarkoni (2016) pokazali, że typowe strategie wykazywania przyrostowej trafności konstruktu mają z tego powodu bardzo wysoki odsetek błędów I rodzaju. Odsetek ten jest najwyższy przy dużych próbach i umiarkowanej rzetelności, czasem bliski 100%.
Sprawdziliśmy to symulacją. Kryterium zależy w niej tylko od konstruktu kontrolnego. Nowa skala mierzy konstrukt skorelowany z nim (r = .60), ale bez własnego wkładu, więc test ΔR² powinien wychodzić istotny w 5% prób.
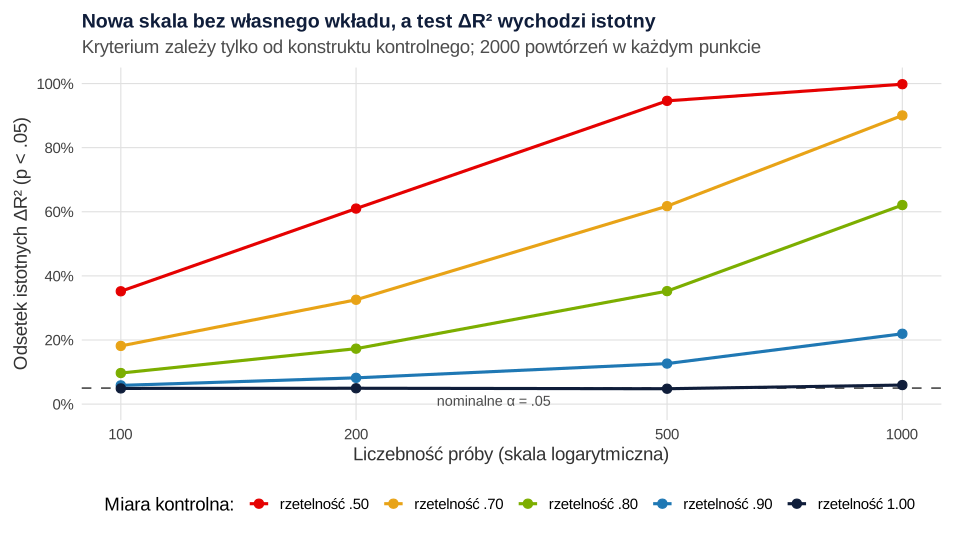
Przy rzetelności miary kontrolnej .70 fałszywy przyrost był istotny w 18% prób przy 100 osobach, w 62% przy 500 i w 90% przy 1000. Nawet przy rzetelności .90 odsetek przy 1000 osobach wyniósł 22%. Tylko pomiar bezbłędny dawał nominalne 5%. Większa próba nie pomaga, a wręcz szkodzi, bo test coraz pewniej wykrywa artefakt.
Rozwiązaniem jest model ze zmiennymi latentnymi. Westfall i Yarkoni (2016) omawiają podejścia oparte na SEM, które utrzymują błąd I rodzaju na właściwym poziomie. W symulacji konstrukt kontrolny mierzyliśmy trzema wskaźnikami, a ich średnia miała rzetelność około .70. Przy 300 osobach regresja na średniej dała fałszywie istotny przyrost w 41% powtórzeń, a model z konstruktem latentnym w lavaan – w 6%. Taki model wymaga kilku wskaźników każdego konstruktu i ma niższą moc.
Rozróżnij jednak dwa pytania. Jeśli twierdzisz, że wynik kwestionariusza A poprawia przewidywanie ponad wynik kwestionariusza B, regresja na wynikach obserwowanych odpowiada na nie poprawnie, bo w praktyce też będziesz używać wyników z błędem. Problem pojawia się, gdy z tej samej analizy wnioskujesz, że konstrukt A jest odrębny od konstruktu B. Ten sam mechanizm psuje kontrolę zmiennych zakłócających. W naszym przykładzie miary kontrolne mają rzetelność .80–.85, więc część ΔR² może być artefaktem. Wniosek o odrębności konstruktów warto więc sprawdzić modelem latentnym, a odrębność obu skal także trafnością różnicową (AVE, HTMT).
Jak opisać trafność przyrostową
W artykule podaj:
- kryterium, miary porównawcze i ich rzetelność (np. omega) oraz uzasadnienie ich wyboru;
- R² obu kroków, ΔR² z 95% CI, test F zmiany i f²;
- przyrost w kierunku odwrotnym (stara skala ponad nową);
- opcjonalnie wagi względne z CI, jeśli predyktory są silnie skorelowane;
- model latentny albo zastrzeżenie, jeśli wniosek dotyczy konstruktów.
Wielkość próby zaplanuj pod test F zmiany dla małego f² (zob. kalkulator mocy dla regresji). Jeśli chcesz pokazać, że nowa skala poprawia przewidywanie na nowych danych, dodaj walidację krzyżową (zob. modele predykcyjne – walidacja). Cały proces budowy narzędzia opisuje wpis jak zbudować i zwalidować skalę. Jeśli przygotowujesz artykuł walidacyjny, plan analiz i odpowiedź recenzentom możemy omówić w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane i zapisuje plik trafnosc-przyrostowa-dane.csv (możesz go pobrać tutaj), drugi liczy wagi względne i dominację, a trzeci powtarza symulację z rysunku 2. Potrzebne są pakiety boot i lavaan.
1. Regresja hierarchiczna i ΔR² z bootstrapowym CI
R
# Dane symulowane: czy nowa skala perfekcjonizmu akademickiego (NSPA) wyjaśnia wypalenie studenckie
# ponad neurotyczność i istniejącą skalę perfekcjonizmu ogólnego? N = 320 osób studiujących
suppressPackageStartupMessages(library(boot))
set.seed(2721)
n <- 320
# konstrukty prawdziwe (bez błędu pomiaru): neurotyczność, perfekcjonizm ogólny, perfekcjonizm akademicki
R_lat <- matrix(c(1, .30, .40,
                  .30, 1, .60,
                  .40, .60, 1), 3, byrow = TRUE)
lat <- matrix(rnorm(3 * n), n) %*% chol(R_lat)
wyp_lat <- .40 * lat[, 1] + .15 * lat[, 2] + .20 * lat[, 3] + rnorm(n, 0, .82)
# wyniki obserwowane = konstrukt + błąd pomiaru (rzetelność .85, .80, .85, .85), w punktach skal
obs <- function(x, rel, M, SD) round(M + SD * (sqrt(rel) * x / sd(x) + sqrt(1 - rel) * rnorm(n)))
dane <- data.frame(id = sprintf("s%03d", 1:n),
                   neur = obs(lat[, 1], .85, 24, 6),     # neurotyczność (8–40)
                   perf = obs(lat[, 2], .80, 60, 12),    # istniejąca skala perfekcjonizmu (15–105)
                   nspa = obs(lat[, 3], .85, 36, 8),     # nowa skala (12–60)
                   wyp  = obs(wyp_lat, .85, 45, 10))     # wypalenie – kryterium (15–75)
write.csv(dane, "trafnosc-przyrostowa-dane.csv", row.names = FALSE)

# Statystyki opisowe i korelacje
round(sapply(dane[-1], function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane[-1]), 2)

# Regresja hierarchiczna: krok 1 – miary istniejące, krok 2 – nowa skala
m1 <- lm(wyp ~ neur + perf, data = dane)
m2 <- lm(wyp ~ neur + perf + nspa, data = dane)
anova(m1, m2)
R2 <- c(krok1 = summary(m1)$r.squared, krok2 = summary(m2)$r.squared)
dR2 <- unname(R2[2] - R2[1])
round(c(R2, dR2 = dR2, f2 = dR2 / (1 - R2[[2]]),
        dR2_skoryg = summary(m2)$adj.r.squared - summary(m1)$adj.r.squared), 4)
# współczynniki modelu pełnego: b i β (z standaryzacji wszystkich zmiennych)
round(cbind(b = coef(m2)[-1], beta = coef(lm(scale(wyp) ~ scale(neur) + scale(perf) + scale(nspa), data = dane))[-1]), 3)

# Odwrotne pytanie: czy istniejąca skala wnosi coś ponad nową?
m1b <- lm(wyp ~ neur + nspa, data = dane)
anova(m1b, m2)
round(c(dR2_perf_ponad_nspa = summary(m2)$r.squared - summary(m1b)$r.squared), 4)

# Bootstrap ΔR² (2000 prób, osoby losowane ze zwracaniem): percentylowy i BCa 95% CI
dR2_boot <- function(d, i) {
  dd <- d[i, ]
  c(summary(lm(wyp ~ neur + perf + nspa, data = dd))$r.squared - summary(lm(wyp ~ neur + perf, data = dd))$r.squared,
    summary(lm(wyp ~ neur + perf + nspa, data = dd))$r.squared - summary(lm(wyp ~ neur + nspa, data = dd))$r.squared)
}
bt <- boot(dane, dR2_boot, R = 2000)
ci_nspa <- boot.ci(bt, type = c("perc", "bca"), index = 1)
ci_perf <- boot.ci(bt, type = c("perc", "bca"), index = 2)
round(rbind(nspa_ponad_istniejace = c(dR2 = bt$t0[1], perc = ci_nspa$percent[4:5], bca = ci_nspa$bca[4:5]),
            perf_ponad_nspa = c(dR2 = bt$t0[2], perc = ci_perf$percent[4:5], bca = ci_perf$bca[4:5])), 4)
Wynik w R
    neur  perf  nspa   wyp
M  23.80 59.94 36.64 44.58
SD  6.27 12.31  7.96 10.10
     neur perf nspa  wyp
neur 1.00 0.29 0.25 0.43
perf 0.29 1.00 0.56 0.36
nspa 0.25 0.56 1.00 0.42
wyp  0.43 0.36 0.42 1.00
Analysis of Variance Table

Model 1: wyp ~ neur + perf
Model 2: wyp ~ neur + perf + nspa
  Res.Df   RSS Df Sum of Sq      F    Pr(>F)
1    317 24649
2    316 22956  1    1692.5 23.298 2.164e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
     krok1      krok2        dR2         f2 dR2_skoryg
    0.2432     0.2952     0.0520     0.0737     0.0500
         b  beta
neur 0.536 0.333
perf 0.083 0.102
nspa 0.352 0.277
Analysis of Variance Table

Model 1: wyp ~ neur + nspa
Model 2: wyp ~ neur + perf + nspa
  Res.Df   RSS Df Sum of Sq      F  Pr(>F)
1    317 23178
2    316 22956  1    221.35 3.0469 0.08186 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
dR2_perf_ponad_nspa
             0.0068
                         dR2  perc1  perc2   bca1   bca2
nspa_ponad_istniejace 0.0520 0.0169 0.1051 0.0167 0.1034
perf_ponad_nspa       0.0068 0.0000 0.0281 0.0000 0.0273
2. Wagi względne Johnsona i analiza dominacji
R
# Wagi względne Johnsona (2000) i ogólna dominacja Budescu (1993) liczone ręcznie – bez dodatkowych pakietów
# Wymaga obiektów z przepisu 1 (dane, m2, boot)
predyktory <- c("neur", "perf", "nspa")

# Wagi względne: predyktory zastępujemy ortogonalnymi Z najbliższymi X (Λ = Rxx^1/2), regresja Y na Z,
# a udział każdego X to suma kwadratów ładunków Λ pomnożonych przez kwadraty wag Y na Z
wagi_wzgledne <- function(d) {
  Rxx <- cor(d[predyktory]); rxy <- cor(d[predyktory], d$wyp)
  e <- eigen(Rxx)
  Lambda <- e$vectors %*% diag(sqrt(e$values)) %*% t(e$vectors)
  beta_z <- solve(Lambda, rxy)
  setNames(as.vector(Lambda^2 %*% beta_z^2), predyktory)
}
rw <- wagi_wzgledne(dane)
round(rbind(waga = rw, procent_R2 = 100 * rw / sum(rw)), 3)
round(c(suma_wag = sum(rw), R2_modelu = summary(m2)$r.squared), 4)

# Ogólna dominacja: średni przyrost R² predyktora we wszystkich podzbiorach pozostałych predyktorów,
# najpierw uśredniony w obrębie rozmiaru podzbioru, potem po rozmiarach
r2 <- function(zm, d) if (length(zm) == 0) 0 else summary(lm(reformulate(zm, "wyp"), data = d))$r.squared
dominacja <- function(d) {
  sapply(predyktory, function(p) {
    inne <- setdiff(predyktory, p)
    mean(sapply(0:length(inne), function(k) {
      podzbiory <- if (k == 0) list(character(0)) else combn(inne, k, simplify = FALSE)
      mean(sapply(podzbiory, function(s) r2(c(s, p), d) - r2(s, d)))
    }))
  })
}
gd <- dominacja(dane)
round(rbind(dominacja_ogolna = gd, wagi_wzgledne = rw), 4)

# Przyrost każdego predyktora wprowadzonego jako ostatni (sr²) – dla porównania
round(sapply(predyktory, function(p) r2(predyktory, dane) - r2(setdiff(predyktory, p), dane)), 4)

# Bootstrap wag względnych (2000 prób): 95% CI percentylowe dla udziału każdej skali
set.seed(2722)
bt_rw <- boot(dane, function(d, i) wagi_wzgledne(d[i, ]), R = 2000)
ci_rw <- t(sapply(1:3, function(j) c(waga = bt_rw$t0[[j]], boot.ci(bt_rw, type = "perc", index = j)$percent[4:5])))
dimnames(ci_rw) <- list(predyktory, c("waga", "dolna", "gorna"))
round(ci_rw, 4)
# różnica wag: nowa skala − istniejąca skala perfekcjonizmu
roznica <- bt_rw$t[, 3] - bt_rw$t[, 2]
round(c(roznica = bt_rw$t0[3] - bt_rw$t0[2], quantile(roznica, c(.025, .975))), 4)
Wynik w R
             neur   perf   nspa
waga        0.136  0.056  0.104
procent_R2 46.040 18.831 35.129
 suma_wag R2_modelu
   0.2952    0.2952
                   neur   perf   nspa
dominacja_ogolna 0.1339 0.0574 0.1039
wagi_wzgledne    0.1359 0.0556 0.1037
  neur   perf   nspa
0.1001 0.0068 0.0520
       waga  dolna  gorna
neur 0.1359 0.0798 0.1996
perf 0.0556 0.0258 0.0963
nspa 0.1037 0.0540 0.1647
roznica.nspa         2.5%        97.5%
      0.0481      -0.0117       0.1083
3. Symulacja: błąd pomiaru miary kontrolnej
R
# Symulacja: pozorna trafność przyrostowa, gdy konstrukt kontrolny mierzysz z błędem (por. Westfall i Yarkoni, 2016)
# Prawda: kryterium zależy tylko od konstruktu kontrolnego C (β = .50); nowa skala mierzy konstrukt skorelowany z C (r = .60),
# ale NIE ma własnego wkładu. Test ΔR² nowej skali powinien być istotny w 5% powtórzeń
suppressPackageStartupMessages(library(lavaan))
set.seed(2723)
jedna_proba <- function(n, rel_c) {
  C <- rnorm(n); T <- .60 * C + rnorm(n, 0, .80)
  y <- .50 * C + rnorm(n, 0, sqrt(1 - .25))
  c_obs <- sqrt(rel_c) * C + sqrt(1 - rel_c) * rnorm(n)      # miara kontrolna o rzetelności rel_c
  t_obs <- sqrt(.85) * T + sqrt(.15) * rnorm(n)              # nowa skala o rzetelności .85
  # przy jednej dodanej zmiennej test F zmiany R² = test t jej współczynnika (F = t²)
  summary(lm(y ~ c_obs + t_obs))$coefficients["t_obs", 4] < .05
}
siatka <- expand.grid(rel_c = c(.50, .70, .80, .90, 1), n = c(100, 200, 500, 1000))
siatka$odsetek_istotnych <- mapply(function(n, r) mean(replicate(2000, jedna_proba(n, r))), siatka$n, siatka$rel_c)
print(reshape(siatka, idvar = "n", timevar = "rel_c", direction = "wide"), row.names = FALSE)

# Środek zaradczy: konstrukt kontrolny jako zmienna latentna z trzech wskaźników (każdy o rzetelności .44,
# średnia z trzech ma rzetelność ok. .70); 500 powtórzeń przy N = 300
porownanie <- function(n) {
  C <- rnorm(n); T <- .60 * C + rnorm(n, 0, .80)
  y <- .50 * C + rnorm(n, 0, sqrt(1 - .25))
  d <- data.frame(c1 = sqrt(.44) * C + sqrt(.56) * rnorm(n), c2 = sqrt(.44) * C + sqrt(.56) * rnorm(n),
                  c3 = sqrt(.44) * C + sqrt(.56) * rnorm(n), t_obs = sqrt(.85) * T + sqrt(.15) * rnorm(n), y = y)
  p_suma <- summary(lm(y ~ I((c1 + c2 + c3) / 3) + t_obs, data = d))$coefficients["t_obs", 4]
  fit <- sem("C =~ c1 + c2 + c3
              y ~ C + t_obs
              C ~~ t_obs", data = d)          # kowariancja konstruktu kontrolnego z nową skalą – wpisz ją jawnie
  pe <- parameterEstimates(fit)
  c(wynik_sumaryczny = p_suma < .05, zmienna_latentna = pe$pvalue[pe$lhs == "y" & pe$rhs == "t_obs"] < .05)
}
wyn <- replicate(500, porownanie(300))
round(rowMeans(wyn), 3)
Wynik w R
    n odsetek_istotnych.0.5 odsetek_istotnych.0.7 odsetek_istotnych.0.8
  100                 0.352                0.1815                0.0970
  200                 0.610                0.3255                0.1730
  500                 0.946                0.6175                0.3525
 1000                 0.998                0.9005                0.6210
 odsetek_istotnych.0.9 odsetek_istotnych.1
                0.0585              0.0490
                0.0820              0.0495
                0.1265              0.0480
                0.2195              0.0595
wynik_sumaryczny zmienna_latentna
           0.410            0.064
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), anova(), eigen()), z pakietami boot 1.3.32 (bootstrap, przedziały BCa) i lavaan 0.7.2 (model ze zmienną latentną); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3.32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (Version 1.3-32) [R package]. https://doi.org/10.32614/CRAN.package.boot
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównanie ze słabymi miarami. Przyrost ponad wiek i płeć nie jest dowodem trafności przyrostowej wobec istniejących skal.
- Kolejność bloków po fakcie. Nowa skala wchodzi po miarach, ponad które ma działać, i ta decyzja należy do planu.
- Samo p bez wielkości i CI. Przy dużej próbie nawet znikomy przyrost będzie istotny.
- Wagi względne jako test przyrostu. Wagi dzielą R², a przyrost mierzy ΔR².
- Wniosek o konstrukcie z regresji na nierzetelnych wynikach. Błąd pomiaru miary kontrolnej zawyża przyrost tym bardziej, im większa próba.
- Kryterium z tego samego kwestionariusza. Wspólna metoda może podnieść korelację nowej skali z kryterium.
Najczęstsze pytania
Jakie ΔR² wystarczy, żeby wykazać trafność przyrostową?
Nie ma progu, który by to rozstrzygał. Hunsley i Meyer (2003) zaliczają interpretację wielkości przyrostu do kluczowych problemów tych badań, a Haynes i Lench (2003) – że o wyborze miary decyduje też koszt zebrania danych i znaczenie zjawiska. Podaj ΔR² z 95% CI i f², porównaj go z przyrostem w odwrotnym kierunku i oceń, czy kilka procent wariancji ma znaczenie praktyczne w Twojej dziedzinie.
Czy wagi względne albo analiza dominacji zastępują regresję hierarchiczną?
Nie. ΔR² odpowiada na pytanie, ile nowa skala wnosi ponad pozostałe miary. Wagi względne (Johnson, 2000) i dominacja ogólna (Budescu, 1993) dzielą całe R² między predyktory, więc nowa skala dostaje także część wariancji wspólnej z innymi. Traktuj je jako uzupełnienie, gdy predyktory są silnie skorelowane, a nie jako test przyrostu.
Kiedy błąd pomiaru miar kontrolnych jest problemem?
Gdy wniosek dotyczy konstruktów, np. „perfekcjonizm akademicki to coś więcej niż ogólny perfekcjonizm”. Nierzetelna miara kontrolna usuwa tylko część wariancji konstruktu, więc pozostała część może trafić do nowej skali (Westfall i Yarkoni, 2016). W symulacji we wpisie przy rzetelności .70 i 500 osobach fałszywy przyrost wychodził istotny w 62% prób. Jeśli pytasz tylko, czy wynik kwestionariusza A poprawia przewidywanie ponad wynik kwestionariusza B, regresja na wynikach obserwowanych odpowiada na to pytanie wprost.
Co zrobić, gdy nowa skala i kryterium pochodzą z tego samego kwestionariusza?
Wspólna metoda (ta sama osoba, ten sam moment, ten sam format odpowiedzi) może podnosić korelację nowej skali z kryterium niezależnie od treści. Hunsley i Meyer (2003) zaliczają artefakty związane z doborem kryterium do kluczowych problemów tych badań. Jeśli możesz, użyj kryterium z innego źródła (oceny, dane administracyjne, ocena obserwatora) albo zmierzonego później.
Ilu osób potrzeba do badania trafności przyrostowej?
Moc liczysz dla testu F zmiany w bloku z nową skalą. Przyrosty są zwykle małe, więc planuj próbę pod f² rzędu 0.02–0.05, a nie pod całe R². Pamiętaj jednak, że duża próba nie chroni przed fałszywym przyrostem wynikającym z błędu pomiaru – w symulacji odsetek takich wyników rośnie razem z N.
Powiązane hasła
Przeczytaj też
Rodzaje trafności – mapa dowodów
Tradycyjne nazwy trafności na mapie pięciu źródeł dowodów (Standards, 2014): jak zebrać dowód, jaka analiza, jak opisać w pracy i które 2–3 rodzaje dowodów zaplanować.
Czytaj →PoradnikRegresja hierarchiczna krok po kroku
Plan bloków, wspólna próba dla wszystkich kroków, ΔR² i test F zmiany, f², interakcja w ostatnim kroku i tabela APA – z pełnym przykładem w R.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Walidujesz nową skalę i recenzent pyta, co wnosi ponad istniejące?
Pomożemy dobrać miary porównawcze i kryterium, policzyć ΔR² z przedziałem ufności, wagi względne i model ze zmiennymi latentnymi oraz wyjaśnimy wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Azen, R., & Budescu, D. V. (2003). The dominance analysis approach for comparing predictors in multiple regression. Psychological Methods, 8(2), 129–148. https://doi.org/10.1037/1082-989x.8.2.129
- Budescu, D. V. (1993). Dominance analysis: A new approach to the problem of relative importance of predictors in multiple regression. Psychological Bulletin, 114(3), 542–551. https://doi.org/10.1037/0033-2909.114.3.542
- Haynes, S. N., & Lench, H. C. (2003). Incremental validity of new clinical assessment measures. Psychological Assessment, 15(4), 456–466. https://doi.org/10.1037/1040-3590.15.4.456
- Hunsley, J., & Meyer, G. J. (2003). The incremental validity of psychological testing and assessment: Conceptual, methodological, and statistical issues. Psychological Assessment, 15(4), 446–455. https://doi.org/10.1037/1040-3590.15.4.446
- Johnson, J. W. (2000). A heuristic method for estimating the relative weight of predictor variables in multiple regression. Multivariate Behavioral Research, 35(1), 1–19. https://doi.org/10.1207/s15327906mbr3501_1
- Johnson, J. W., & LeBreton, J. M. (2004). History and use of relative importance indices in organizational research. Organizational Research Methods, 7(3), 238–257. https://doi.org/10.1177/1094428104266510
- Schmidt, F. L., & Hunter, J. E. (1996). Measurement error in psychological research: Lessons from 26 research scenarios. Psychological Methods, 1(2), 199–223. https://doi.org/10.1037/1082-989x.1.2.199
- Smith, G. T., Fischer, S., & Fister, S. M. (2003). Incremental validity principles in test construction. Psychological Assessment, 15(4), 467–477. https://doi.org/10.1037/1040-3590.15.4.467
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
Cytowania BibTeX
@article{azen2003dominance, author={Azen, Razia and Budescu, David V.}, title={{The dominance analysis approach for comparing predictors in multiple regression}}, journal={Psychological Methods}, year={2003}, volume={8}, number={2}, pages={129--148}, doi={10.1037/1082-989x.8.2.129}}@article{budescu1993dominance, author={Budescu, David V.}, title={{Dominance analysis: A new approach to the problem of relative importance of predictors in multiple regression}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={542--551}, doi={10.1037/0033-2909.114.3.542}}@article{haynes2003incremental, author={Haynes, Stephen N. and Lench, Heather C.}, title={{Incremental validity of new clinical assessment measures}}, journal={Psychological Assessment}, year={2003}, volume={15}, number={4}, pages={456--466}, doi={10.1037/1040-3590.15.4.456}}@article{hunsley2003incremental, author={Hunsley, John and Meyer, Gregory J.}, title={{The incremental validity of psychological testing and assessment: Conceptual, methodological, and statistical issues}}, journal={Psychological Assessment}, year={2003}, volume={15}, number={4}, pages={446--455}, doi={10.1037/1040-3590.15.4.446}}@article{johnson2000heuristic, author={Johnson, Jeff W.}, title={{A heuristic method for estimating the relative weight of predictor variables in multiple regression}}, journal={Multivariate Behavioral Research}, year={2000}, volume={35}, number={1}, pages={1--19}, doi={10.1207/s15327906mbr3501_1}}@article{johnson2004history, author={Johnson, Jeff W. and LeBreton, James M.}, title={{History and use of relative importance indices in organizational research}}, journal={Organizational Research Methods}, year={2004}, volume={7}, number={3}, pages={238--257}, doi={10.1177/1094428104266510}}@article{schmidt1996measurement, author={Schmidt, Frank L. and Hunter, John E.}, title={{Measurement error in psychological research: Lessons from 26 research scenarios}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={199--223}, doi={10.1037/1082-989x.1.2.199}}@article{smith2003incremental, author={Smith, Gregory T. and Fischer, Sarah and Fister, Suzannah M.}, title={{Incremental validity principles in test construction}}, journal={Psychological Assessment}, year={2003}, volume={15}, number={4}, pages={467--477}, doi={10.1037/1040-3590.15.4.467}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}