Pięć typowych projektów w pracy z ratownictwa medycznego
Prace dyplomowe z ratownictwa medycznego mają kilka źródeł danych, których nie spotkasz na innych kierunkach: dokumentację wyjazdów zespołów, zapis z manekina podczas symulacji, oceny instruktorów i rejestry zatrzymań krążenia. Do tego dochodzą klasyczne ankiety, np. o wiedzy z pierwszej pomocy przed kursem i po nim. Każde z tych źródeł ma swoje pułapki statystyczne. Czasy są skośne, symulacje mają pomiary powtarzane, a oceny instruktorów wymagają sprawdzenia zgodności. Tabela porządkuje pięć projektów omawianych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Czas dotarcia | Czy zespoły docierają szybciej w mieście niż poza nim? | czasy z dokumentacji wyjazdów | mediana i 90. percentyl, test Manna–Whitneya, regresja kwantylowa | przesunięcie Hodgesa–Lehmanna, korelacja rangowo-dwuseryjna |
| 2. Symulacja RKO | Czy informacja zwrotna z urządzenia poprawia jakość uciśnięć? | zapis z manekina, każdy student w obu warunkach | test t dla prób zależnych, model mieszany | dz, b z 95% CI |
| 3. Kurs pierwszej pomocy | Czy po kursie wiedza jest wyższa niż w grupie bez kursu? | test wiedzy przed i po, dwie grupy | ANCOVA, test McNemara | skorygowana różnica średnich, η²p |
| 4. Zgodność oceniających | Czy dwóch instruktorów ocenia scenariusze tak samo? | lista kontrolna i decyzja o zaliczeniu | ICC, metoda Blanda–Altmana, kappa Cohena | ICC, κ, granice zgodności |
| 5. Zatrzymanie krążenia | Od czego zależy powrót spontanicznego krążenia? | karty zdarzeń, wynik tak/nie | regresja logistyczna | OR z 95% CI |
Dane we wszystkich przykładach są symulowane. Możesz je pobrać jako plik XLSX (arkusz dla każdego projektu i arkusz z opisem zmiennych). Projekty z udziałem pacjentów w szpitalu omawiamy w poradniku statystyka w pracy z pielęgniarstwa, a ocenę ryzyka i testy diagnostyczne – w poradniku statystyka dla lekarza.
Zanim zaczniesz: źródło danych i zgody
Ustal, skąd pochodzą dane i kto pozwala z nich skorzystać. Dokumentacja medyczna wyjazdów i karty zdarzeń to dane wrażliwe. Do pracy potrzebujesz zgody podmiotu, który je przechowuje, a często także opinii komisji bioetycznej. Dane przed przekazaniem do analizy powinny zostać zanonimizowane lub spseudonimizowane. Badania z udziałem studentów, np. symulacje, wymagają świadomej zgody uczestników. Wymogi zależą od regulaminu uczelni i jednostki, więc ustal je z promotorem przed zebraniem danych.
Zdefiniuj każdą zmienną czasową. „Czas dotarcia” może liczyć się od przyjęcia zgłoszenia, od zadysponowania zespołu albo od wyjazdu ze stacji. Różnice sięgają kilku minut, więc w metodzie podaj dokładnie, od którego do którego momentu liczysz czas. To samo dotyczy symulacji: „czas do pierwszego uciśnięcia” trzeba liczyć od jasno opisanego zdarzenia w scenariuszu.
Opisz badanie symulacyjne według listy kontrolnej. Cheng i in. (2016) opracowali rozszerzenia list CONSORT i STROBE dla badań z wykorzystaniem symulacji medycznej. Wymagają one m.in. opisu scenariusza, sprzętu, sposobu pomiaru wyników i przygotowania oceniających. Przyda się też w pracy dyplomowej, bo podpowiada, czego promotor i recenzent będą szukać w metodzie.
Projekt 1. Czas dotarcia zespołu: mediana i 90. percentyl
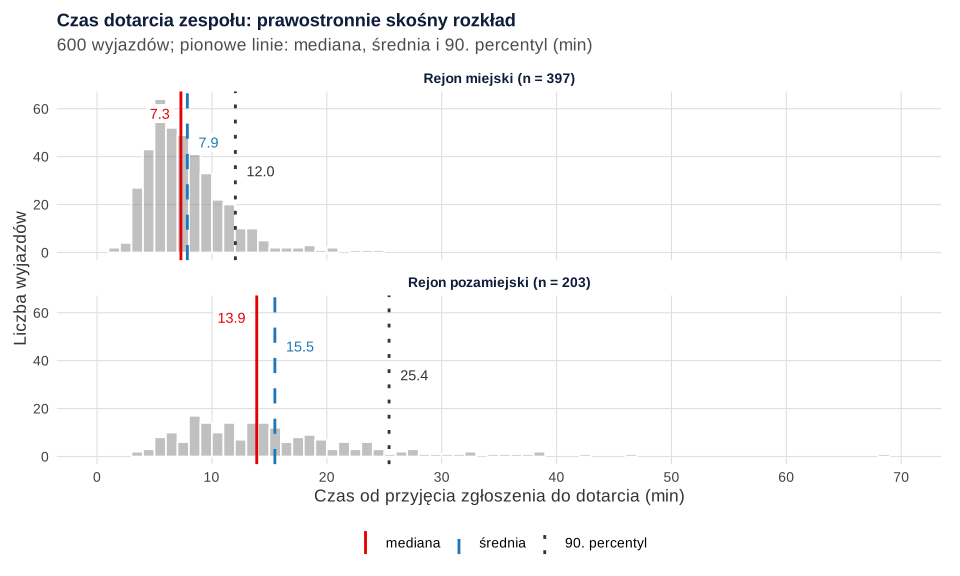
Przykład: 600 wyjazdów z dokumentacji jednej stacji, 397 w rejonie miejskim i 203 w rejonie pozamiejskim. Wynikiem jest czas od przyjęcia zgłoszenia do dotarcia na miejsce w minutach. Czasy dotarcia mają prawie zawsze rozkład prawostronnie skośny: większość wyjazdów trwa kilka minut, ale kilka dalekich lub opóźnionych tworzy długi ogon. Tu skośność wynosi 2.62.
| Rejon | n | M (SD) | Me (Q1–Q3) | 90. percentyl [95% CI] |
|---|---|---|---|---|
| Miejski | 397 | 7.86 (3.50) | 7.3 (5.4–9.4) | 12.0 [11.3, 13.1] |
| Pozamiejski | 203 | 15.48 (8.69) | 13.9 (9.6–18.9) | 25.4 [22.8, 29.5] |
Przy takim rozkładzie podstawową miarą jest mediana z kwartylami. Dla oceny działania systemu ważny jest też 90. percentyl, bo opisuje dojazdy najdłuższe, czyli te, które najbardziej obchodzą pacjenta. Przedział ufności dla percentyla policzysz metodą bootstrap. Średnią też podaj, ale nie jako jedyny opis. Wyjazd trwający 68 minut przesuwa ją wyraźnie w górę, a medianę prawie wcale.
Rejony porównuje test Manna–Whitneya: W = 13734, p < .001, korelacja rangowo-dwuseryjna r = .66, 95% CI [.60, .71]. Sama wartość p nie mówi, o ile minut zespoły docierają dłużej. Hart (2001) przypomina, że test ten nie porównuje median, tylko całe rozkłady, więc wynik trzeba opisać liczbami. Najprostsza liczba to estymator przesunięcia Hodgesa–Lehmanna, który R podaje razem z testem: poza miastem dojazd był dłuższy o 6.2 minuty, 95% CI [5.3, 7.1].
Gdy chcesz uwzględnić kilka czynników naraz, np. rejon i porę dnia, sięgnij po regresję kwantylową. Modeluje ona wybrany percentyl, a nie średnią. Dla mediany różnica między rejonami wyniosła 6.6 minuty (SE = 0.66), a dla 90. percentyla 13.8 minuty (SE = 1.72), przy kontroli pory dnia. Rejon pozamiejski wydłuża więc zwłaszcza najdłuższe dojazdy. Alternatywą jest transformacja logarytmiczna i zwykła regresja, ale wtedy wynik dotyczy średniej geometrycznej, co trzeba wyjaśnić w tekście. Usuwanie „za długich” wyjazdów jako obserwacji odstających jest błędem: to prawdziwe dane o działaniu systemu.
Projekt 2. Symulacja RKO: ten sam student w dwóch warunkach
Symulacje na manekinie pozwalają zrobić coś, czego w prawdziwej akcji nie da się zrobić: porównać tę samą osobę w dwóch warunkach. Przykład: 40 studentów wykonało dwa razy po 2 minuty uciśnięć klatki piersiowej, raz z urządzeniem dającym informację zwrotną w czasie rzeczywistym i raz bez niego. Kolejność warunków była losowa, a połowa osób zaczynała od próby z informacją zwrotną. To prosty schemat wewnątrzobiektowy z kontrbalansowaniem, który chroni przed efektem uczenia się i zmęczenia.
Manekin zapisał średnią głębokość uciśnięć (mm) w czterech odcinkach po 30 sekund, średnią częstotliwość (uciśnięcia na minutę) i odsetek uciśnięć o prawidłowej głębokości. Ostatnią zmienną liczy oprogramowanie manekina według zakresu ustawionego w urządzeniu. W metodzie podaj ten zakres i jego źródło. Zakres głębokości i częstotliwości uciśnięć u dorosłych podają wytyczne resuscytacji. Obecnie obowiązują wytyczne ERC 2025, które omawiają uciśnięcia klatki piersiowej, jakość RKO i wykorzystanie technologii (Smyth i in., 2025). Wartości progowe przepisz z wersji wytycznych obowiązującej w czasie badania.
Porównanie warunków: test t dla prób zależnych
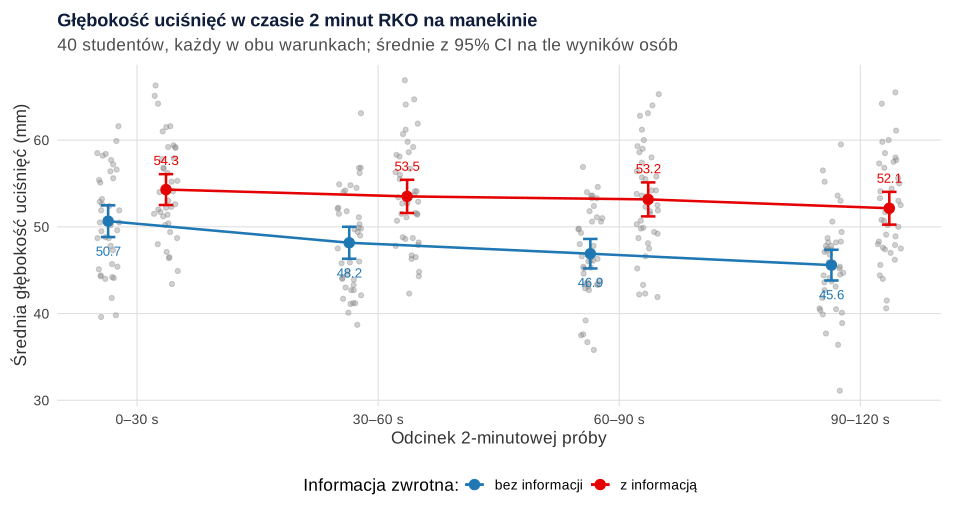
Średnia głębokość z 2 minut wyniosła 53.28 mm (SD = 5.47) z informacją zwrotną i 47.83 mm (SD = 5.12) bez niej. Test t dla prób zależnych: różnica 5.45 mm, 95% CI [4.00, 6.90], t(39) = 7.60, p < .001, dz = 1.18, 95% CI [0.78, 1.58]. Lakens (2013) zwraca uwagę, że w schemacie wewnątrzobiektowym trzeba napisać, którą miarę d podajesz. dz dzieli różnicę przez odchylenie standardowe różnic i zwykle jest większe niż d liczone na wynikach z jednego pomiaru. Częstotliwość uciśnięć z informacją zwrotną była niższa (111.65 vs 122.08 na minutę), różnica −10.43, 95% CI [−13.89, −6.96], t(39) = −6.09, p < .001.
Odsetek uciśnięć o prawidłowej głębokości jest ograniczony do 0–100% i ma u wielu osób wartości skrajne. Bezpieczniej porównać go testem Wilcoxona dla par (Whitley i Ball, 2002): mediana 69.0% z informacją zwrotną i 37.5% bez niej, V = 709, p < .001, korelacja rangowo-dwuseryjna r = .82, 95% CI [.66, .91].
Zmęczenie w czasie: model mieszany
Średnia z 2 minut ukrywa ważną rzecz: głębokość spada z każdym odcinkiem, bo ratownik się męczy. Każda osoba ma tu 8 pomiarów (2 warunki × 4 odcinki). Takie dane analizuje model mieszany z losowym wyrazem wolnym dla osoby i dla osoby w danym warunku. Bez informacji zwrotnej głębokość spadała o 1.65 mm na każde 30 sekund, 95% CI [1.29, 2.00]. Z informacją zwrotną spadek był mniejszy o 0.97 mm na odcinek, 95% CI [0.46, 1.47], p < .001, czyli wynosił około 0.68 mm. Kolejność warunków nie miała istotnego znaczenia (p = .519). Wybór między ANOVA z powtarzanymi pomiarami a modelem mieszanym omawiamy w poradniku ANOVA z powtarzanymi pomiarami czy model mieszany.
Wynik z manekina nie przenosi się wprost na pacjenta. W ograniczeniach napisz, że badanie dotyczyło jakości uciśnięć w warunkach symulacji, a nie wyników leczenia.
Projekt 3. Wiedza z pierwszej pomocy przed kursem i po nim
Studenci ratownictwa często prowadzą kursy pierwszej pomocy, np. dla uczniów albo pracowników, i badają ich efekty. Sam pomiar przed i po w jednej grupie pokazujemy w poradniku badanie wiedzy przed i po szkoleniu. Tu idziemy krok dalej, bo dodajemy grupę porównawczą. Przykład: 62 uczniów z klas, w których odbył się kurs, i 58 uczniów z klas bez kursu rozwiązało autorski test wiedzy (20 pytań, wynik 0–20) przed kursem i dwa tygodnie po nim.
| Grupa | n | Przed: M (SD) | Po: M (SD) | Po, skorygowana średnia [95% CI] |
|---|---|---|---|---|
| Kurs | 62 | 10.13 (2.77) | 13.44 (2.89) | 13.18 [12.62, 13.75] |
| Porównawcza | 58 | 9.43 (3.14) | 9.57 (3.39) | 9.84 [9.26, 10.42] |
Zamiast liczyć dwa osobne testy t albo porównywać różnice wyników, wprowadź wynik końcowy do ANCOVA z pomiarem wyjściowym jako współzmienną. Vickers i Altman (2001) pokazują, że to, które z prostszych podejść ma większą moc, zależy od korelacji między pomiarami. Van Breukelen (2006) wykazał, że w badaniach randomizowanych ANCOVA ma większą moc niż analiza różnic. Po uwzględnieniu wyniku wyjściowego grupa z kursem miała wynik wyższy o 3.34 punktu, 95% CI [2.53, 4.16], F(1, 117) = 66.35, p < .001, η²p = .36. Założenie homogeniczności nachyleń było spełnione: interakcja pomiaru wyjściowego z grupą F(1, 116) = 0.12, p = .730.
Trzy zastrzeżenia, które warto opisać w pracy:
- Grupy nie były losowane. Van Breukelen (2006) ostrzega, że gdy grupy różnią się na starcie, ANCOVA i analiza różnic mogą dawać sprzeczne wyniki. Tu różnica wyjściowa była niewielka (10.13 vs 9.43), ale napisz o niej. Logikę takiego schematu opisujemy w poradniku quasi-eksperyment i różnica w różnicach.
- Uczniowie są zagnieżdżeni w klasach. Jeśli kurs odbył się w dwóch klasach, a grupę porównawczą tworzą dwie inne, efekt kursu miesza się z różnicami między klasami. Przy wielu klasach użyj modelu z losowym efektem klasy (zob. efekt schematu).
- Test po dwóch tygodniach mierzy wiedzę, a nie umiejętności. Jeśli masz możliwość, dodaj ocenę praktyczną na manekinie albo pomiar odroczony.
Pojedyncze pytanie kluczowe, np. o kolejność czynności, porównasz w grupie z kursem testem McNemara. Poprawnie odpowiedziało 21.0% uczniów przed kursem i 87.1% po kursie. 41 osób zmieniło odpowiedź z błędnej na poprawną, a żadna z poprawnej na błędną: χ²(1) = 39.02, p < .001. Pełną procedurę ANCOVA z wykresem i tabelą pokazujemy w poradniku ANCOVA w badaniu przed i po.
Projekt 4. Zgodność dwóch instruktorów oceniających scenariusze
Jeśli wynikiem badania jest ocena wystawiona przez instruktora, np. punkty z listy kontrolnej po scenariuszu symulacyjnym, musisz pokazać, że ocena nie zależy od tego, kto ją wystawia. Przykład: dwóch instruktorów niezależnie oceniło 50 nagranych scenariuszy listą kontrolną (0–30 punktów) i każdy zdecydował, czy scenariusz zaliczyć. Instruktor A przyznał średnio 22.66 punktu (SD = 3.87), a instruktor B 23.72 (SD = 4.10).
Wynik punktowy: ICC i wykres Blanda–Altmana
Dla oceny ilościowej użyj korelacji wewnątrzklasowej. Koo i Li (2016) wymagają, aby w pracy podać model, typ i definicję ICC, bo różne wersje dają różne wartości. Gdy chcesz uogólnić wynik na innych instruktorów i liczy się zgodność absolutna, wybierz model dwuczynnikowy losowy, pojedynczy oceniający, zgodność absolutna: ICC = .85, 95% CI [.68, .92]. ICC spójności, który ignoruje stałą różnicę między oceniającymi, wyniósł .87, 95% CI [.79, .93]. Koo i Li (2016) proponują interpretować ICC na podstawie przedziału ufności, a nie samej wartości punktowej. Tu przedział obejmuje zarówno rzetelność umiarkowaną, jak i doskonałą, co przy 50 scenariuszach nie jest niczym wyjątkowym.
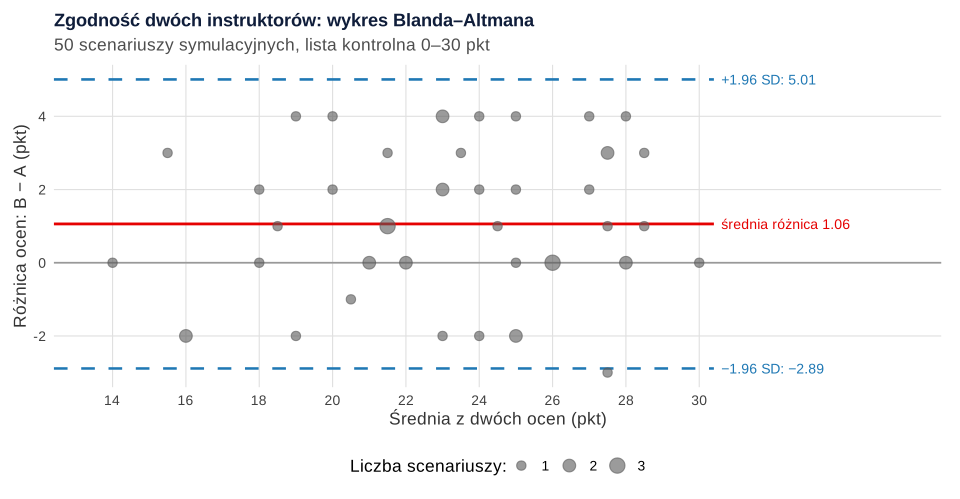
ICC nie powie, czy jeden z instruktorów ocenia surowiej. Pokaże to wykres Blanda–Altmana. Instruktor B przyznawał średnio o 1.06 punktu więcej, 95% CI [0.49, 1.63]. Granice zgodności wyniosły od −2.89 do 5.01 punktu: w 95% scenariuszy różnica ocen powinna mieścić się w tym zakresie. Czy to dużo, ocenisz merytorycznie. Przy progu zaliczenia w okolicach 18 punktów różnica 5 punktów może zmienić decyzję.
Decyzja o zaliczeniu: kappa i jej paradoks
Instruktorzy zgodzili się co do zaliczenia w 88% scenariuszy, a kappa Cohena wyniosła tylko .50, 95% CI [.16, .85]. To nie błąd obliczeń. Zaliczonych było 88% scenariuszy według A i 84% według B, więc duża część zgodności mogła wystąpić przypadkiem. Feinstein i Cicchetti (1990) opisali ten paradoks: przy silnie niezrównoważonych rozkładach brzegowych wysoki odsetek zgodności może iść w parze z niską kappą. Podaj więc obie liczby i tabelę 2 × 2. Szerszy przegląd miar zgodności, z kappą ważoną i alfą Krippendorffa, znajdziesz w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa, a praktyczne wskazówki obliczania i raportowania – u Hallgrena (2012).
Projekt 5. Zatrzymanie krążenia: analiza kart zdarzeń
Prace magisterskie często analizują retrospektywnie karty zdarzeń zespołów z pozaszpitalnym zatrzymaniem krążenia. Zanim zaczniesz, przejrzyj wzór Utstein. Perkins i in. (2015) w jego aktualizacji pogrupowali dane w czynniki systemu, przyjęcie zgłoszenia, cechy pacjenta, procesy resuscytacji i wyniki oraz zalecili standardowy szablon raportu. Dzięki temu porównasz swoje wyniki z innymi badaniami, a promotor zobaczy, że wiesz, jakie zmienne są standardem.
Przykład: 310 pacjentów, u których zespół podjął resuscytację. Wynikiem jest powrót spontanicznego krążenia (ROSC) przed przekazaniem do szpitala: wystąpił u 118 osób (38.1%). Odsetki w podgrupach pokazują, jak wynik zależy od dwóch czynników naraz:
| RKO świadków | Rytm niedefibrylacyjny | Rytm do defibrylacji |
|---|---|---|
| Nie | 18.9% | 50.0% |
| Tak | 46.0% | 68.3% |
Regresja logistyczna z czterema predyktorami wykazała, że ROSC był częstszy po RKO podjętej przez świadków (OR = 3.40, 95% CI [2.02, 5.74], p < .001) i przy rytmie do defibrylacji (OR = 3.55, 95% CI [2.04, 6.18], p < .001). Każda minuta czasu dotarcia wiązała się z mniejszą szansą ROSC (OR = 0.84, 95% CI [0.77, 0.91], p < .001). Wiek nie był istotnym predyktorem (OR = 1.15 na 10 lat, 95% CI [0.94, 1.41], p = .173). Pseudo-R² Nagelkerkego wyniósł .26, a pole pod krzywą ROC .76.
Dwie rzeczy sprawdź przed budową modelu. Po pierwsze, liczba zdarzeń na zmienną. Peduzzi i in. (1996) pokazali, że przy EPV poniżej 10 współczynniki są obciążone. Tu rzadszy wynik (ROSC) wystąpił 118 razy, co przy czterech predyktorach daje EPV = 29.5. Po drugie, braki danych. W kartach zdarzeń brakuje często czasu zatrzymania czy rytmu, a analiza samych kompletnych kart może zniekształcić wynik. Opisz, ile kart odrzucono i dlaczego (zob. mechanizmy braków danych). Pamiętaj też, że ROSC występuje tu w 38.1% przypadków, więc OR = 3.40 nie oznacza „ponad trzy razy częściej”. Interpretację ilorazów szans i tabelę wyników omawiamy w poradniku regresja logistyczna krok po kroku.
Wielkość efektu i opis metody
Tabela zbiera analizy i miary wielkości efektu z pięciu projektów. Przy każdym teście dopisz też kierunek wyniku słowami.
| Analiza | Wielkość efektu | Przykład zapisu |
|---|---|---|
| Test Manna–Whitneya | przesunięcie Hodgesa–Lehmanna, r | W = 13734, p < .001, r = .66, przesunięcie 6.2 min, 95% CI [5.3, 7.1] |
| Test t dla prób zależnych | dz z 95% CI | t(39) = 7.60, p < .001, dz = 1.18, 95% CI [0.78, 1.58] |
| Model mieszany | b z 95% CI | b = 0.97 mm na odcinek, 95% CI [0.46, 1.47], p < .001 |
| ANCOVA | skorygowana różnica, η²p | F(1, 117) = 66.35, p < .001, η²p = .36 |
| ICC i Bland–Altman | ICC z 95% CI, granice zgodności | ICC = .85, 95% CI [.68, .92]; granice od −2.89 do 5.01 |
| Kappa Cohena | κ i odsetek zgodności | 88% zgodności, κ = .50, 95% CI [.16, .85] |
| Regresja logistyczna | OR z 95% CI | OR = 3.40, 95% CI [2.02, 5.74], p < .001 |
Jeśli potrzebujesz pomocy w doborze analiz albo w wyjaśnieniu wyników przed obroną, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Pięć przepisów odtwarza wszystkie liczby z tego wpisu, a osobny skrypt b70-rysunki.R – rysunki. Każdy przepis tworzy własne dane symulowane, więc możesz go uruchomić osobno. Ostatni przepis zapisuje też plik XLSX do pobrania. Regresję kwantylową liczy pakiet quantreg, model mieszany – lme4 i lmerTest, ANCOVA – car i emmeans, a ICC i kappę – psych.
1. Projekt 1: czas dotarcia – mediana, 90. percentyl, test Manna–Whitneya i regresja kwantylowa
R
# Projekt 1: czas dotarcia zespołu ratownictwa medycznego (dane symulowane).
# 600 wyjazdów z dokumentacji jednej stacji: rejon miejski / pozamiejski, pora (dzień / noc),
# czas od przyjęcia zgłoszenia do dotarcia na miejsce (minuty). Rozkład prawostronnie skośny.
suppressPackageStartupMessages({ library(quantreg); library(boot) })
set.seed(7001)
n <- 600
rejon <- factor(sample(c("miejski", "pozamiejski"), n, TRUE, prob = c(.63, .37)), levels = c("miejski", "pozamiejski"))
pora <- factor(ifelse(runif(n) < .30, "noc", "dzień"), levels = c("dzień", "noc"))
czas <- round(exp(log(7.5) + 0.62 * (rejon == "pozamiejski") - 0.06 * (pora == "noc") + rnorm(n, 0, ifelse(rejon == "miejski", .42, .48))), 1)
p1 <- data.frame(id = 1:n, rejon, pora, czas_min = czas)

opis <- function(x) c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                      Q3 = unname(quantile(x, .75)), P90 = unname(quantile(x, .90)), max = max(x))
round(t(sapply(split(p1$czas_min, p1$rejon), opis)), 2)
round(c(skosnosc = psych::skew(p1$czas_min)), 2)
# 95% CI dla 90. percentyla (bootstrap percentylowy, 2000 powtórzeń)
set.seed(7011)
ci90 <- sapply(levels(p1$rejon), function(r) {
  x <- p1$czas_min[p1$rejon == r]
  b <- boot(x, function(d, i) quantile(d[i], .90), R = 2000)
  boot.ci(b, type = "perc")$percent[4:5] })
round(ci90, 1)
# Test Manna–Whitneya i estymator Hodgesa–Lehmanna przesunięcia z 95% CI
wilcox.test(czas_min ~ rejon, data = p1, conf.int = TRUE, exact = FALSE)
round(unlist(as.data.frame(effectsize::rank_biserial(czas_min ~ rejon, data = p1))[, c(1, 3, 4)]), 2)
# Regresja kwantylowa: różnica mediany i 90. percentyla między rejonami, z porą dnia
for (tau in c(.5, .9)) {
  q <- rq(czas_min ~ rejon + pora, tau = tau, data = p1)
  cat("tau =", tau, "\n"); print(round(summary(q, se = "boot", R = 1000)$coefficients, 2))
}
Wynik w R
              n     M   SD   Me   Q1   Q3   P90  max
miejski     397  7.86 3.50  7.3 5.40  9.4 12.04 24.8
pozamiejski 203 15.48 8.69 13.9 9.55 18.9 25.42 68.3
skosnosc
    2.62
     miejski pozamiejski
[1,]    11.3        22.8
[2,]    13.1        29.5

	Wilcoxon rank sum test with continuity correction

data:  czas_min by rejon
W = 13734, p-value < 2.2e-16
alternative hypothesis: true location shift is not equal to 0
95 percent confidence interval:
 -7.100030 -5.299985
sample estimates:
difference in location
             -6.199947

r_rank_biserial          CI_low         CI_high
          -0.66           -0.71           -0.60
tau = 0.5
                 Value Std. Error t value Pr(>|t|)
(Intercept)        7.5       0.25   29.76     0.00
rejonpozamiejski   6.6       0.66   10.05     0.00
poranoc           -0.8       0.44   -1.81     0.07
tau = 0.9
                 Value Std. Error t value Pr(>|t|)
(Intercept)       13.0       0.64   20.35     0.00
rejonpozamiejski  13.8       1.72    8.04     0.00
poranoc           -2.2       0.94   -2.34     0.02
2. Projekt 2: symulacja RKO – próby zależne i model mieszany
R
# Projekt 2: jakość uciśnięć klatki piersiowej w symulacji na manekinie (dane symulowane).
# 40 studentów ratownictwa; każdy wykonuje 2 minuty uciśnięć dwa razy: z urządzeniem
# informacji zwrotnej i bez niego, w losowej kolejności (schemat naprzemienny). Manekin zapisuje
# średnią głębokość (mm) w czterech odcinkach po 30 s, średnią częstotliwość (/min) i odsetek uciśnięć
# o prawidłowej głębokości według ustawień oprogramowania manekina.
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(effectsize) })
set.seed(7002)
N <- 40
osoba <- data.frame(id = 1:N, kolejnosc = sample(rep(c("z informacją najpierw", "bez informacji najpierw"), N / 2)),
                    u = rnorm(N, 0, 4.5))
p2l <- expand.grid(id = 1:N, warunek = c("bez informacji", "z informacją"), odcinek = 1:4)
p2l <- merge(p2l, osoba, by = "id")
vw <- expand.grid(id = 1:N, warunek = c("bez informacji", "z informacją")); vw$v <- rnorm(nrow(vw), 0, 3.0)
p2l <- merge(p2l, vw, by = c("id", "warunek"))
p2l$warunek <- factor(p2l$warunek, levels = c("bez informacji", "z informacją"))
p2l$glebokosc <- round(49 + p2l$u + p2l$v + 4.0 * (p2l$warunek == "z informacją") - 1.6 * (p2l$odcinek - 1) +
                         0.9 * (p2l$warunek == "z informacją") * (p2l$odcinek - 1) + rnorm(nrow(p2l), 0, 2.6), 1)
p2l <- p2l[order(p2l$id, p2l$warunek, p2l$odcinek), ]
# Dane na osobę i warunek (średnia z czterech odcinków)
p2 <- aggregate(glebokosc ~ id + warunek + kolejnosc, p2l, mean)
p2$czestotliwosc <- round(rnorm(nrow(p2), ifelse(p2$warunek == "z informacją", 112, 121), 7))
z <- 0.30 * (p2$glebokosc - 50)
p2$proc_prawidlowa <- round(100 * plogis(z + rnorm(nrow(p2), 0, .6)))
w <- reshape(p2, idvar = c("id", "kolejnosc"), timevar = "warunek", direction = "wide", sep = "_")
names(w) <- sub("z informacją", "z", sub("bez informacji", "bez", names(w)))
round(sapply(w[, -(1:2)], function(x) c(M = mean(x), SD = sd(x), Me = median(x))), 2)
# Głębokość: test t dla prób zależnych i d_z
t.test(w$glebokosc_z, w$glebokosc_bez, paired = TRUE)
round(unlist(as.data.frame(repeated_measures_d(w$glebokosc_z, w$glebokosc_bez, method = "z"))[, c(1, 3, 4)]), 2)
# Częstotliwość: test t dla prób zależnych
t.test(w$czestotliwosc_z, w$czestotliwosc_bez, paired = TRUE)
# Odsetek uciśnięć o prawidłowej głębokości: test Wilcoxona dla par i korelacja rangowo-dwuseryjna
wilcox.test(w$proc_prawidlowa_z, w$proc_prawidlowa_bez, paired = TRUE, exact = FALSE)
round(unlist(as.data.frame(rank_biserial(w$proc_prawidlowa_z, w$proc_prawidlowa_bez, paired = TRUE))[, c(1, 3, 4)]), 2)
# Zmęczenie w czasie: model mieszany warunek × odcinek; losowe wyrazy wolne dla osoby i dla osoby w warunku, efekt kolejności
p2l$odc0 <- p2l$odcinek - 1
mm <- lmer(glebokosc ~ warunek * odc0 + kolejnosc + (1 | id) + (1 | id:warunek), data = p2l)
round(summary(mm)$coefficients, 3)
round(confint(mm, parm = c("warunekz informacją", "odc0", "warunekz informacją:odc0"), method = "Wald"), 2)
round(tapply(p2l$glebokosc, list(p2l$warunek, p2l$odcinek), mean), 1)
Wynik w R
   glebokosc_bez czestotliwosc_bez proc_prawidlowa_bez glebokosc_z czestotliwosc_z proc_prawidlowa_z
M          47.83            122.08               38.17       53.28          111.65             63.02
SD          5.12              6.61               29.71        5.47            7.90             28.05
Me         48.05            122.00               37.50       52.67          112.00             69.00

	Paired t-test

data:  w$glebokosc_z and w$glebokosc_bez
t = 7.6042, df = 39, p-value = 3.219e-09
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 4.002156 6.902844
sample estimates:
mean difference
         5.4525

    d_z  CI_low CI_high
   1.18    0.78    1.58

	Paired t-test

data:  w$czestotliwosc_z and w$czestotliwosc_bez
t = -6.0884, df = 39, p-value = 3.904e-07
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -13.888416  -6.961584
sample estimates:
mean difference
        -10.425


	Wilcoxon signed rank test with continuity correction

data:  w$proc_prawidlowa_z and w$proc_prawidlowa_bez
V = 709, p-value = 8.783e-06
alternative hypothesis: true location shift is not equal to 0

r_rank_biserial          CI_low         CI_high
           0.82            0.66            0.91
                               Estimate Std. Error      df t value Pr(>|t|)
(Intercept)                      50.791      1.169  51.715  43.436    0.000
warunekz informacją               4.004      0.814  63.809   4.921    0.000
odc0                             -1.646      0.181 238.000  -9.081    0.000
kolejnoscz informacją najpierw   -0.992      1.526  38.000  -0.650    0.519
warunekz informacją:odc0          0.965      0.256 238.000   3.765    0.000
                         2.5 % 97.5 %
warunekz informacją       2.41   5.60
odc0                     -2.00  -1.29
warunekz informacją:odc0  0.46   1.47
                  1    2    3    4
bez informacji 50.7 48.2 46.9 45.6
z informacją   54.3 53.5 53.2 52.1
3. Projekt 3: kurs pierwszej pomocy – ANCOVA i test McNemara
R
# Projekt 3: wiedza z pierwszej pomocy przed kursem i po nim, z grupą porównawczą (dane symulowane).
# Uczniowie szkół średnich: grupa z kursem (n = 62) i grupa porównawcza bez kursu (n = 58);
# autorski test wiedzy 0–20 przed i 2 tygodnie po kursie; jedno pytanie kluczowe oceniane osobno (tak/nie).
suppressPackageStartupMessages({ library(car); library(emmeans); library(effectsize) })
set.seed(7003)
grupa <- factor(rep(c("porównawcza", "kurs"), c(58, 62)), levels = c("porównawcza", "kurs"))
n3 <- length(grupa)
przed <- pmin(20, pmax(0, round(rnorm(n3, 9.2 + 0.6 * (grupa == "kurs"), 3))))
po <- pmin(20, pmax(0, round(2.6 + 0.70 * przed + 4.3 * (grupa == "kurs") + rnorm(n3, 0, 2.3))))
klucz_przed <- rbinom(n3, 1, plogis(-1.0 + 0.12 * (przed - 9)))
klucz_po <- ifelse(grupa == "kurs", rbinom(n3, 1, .80), rbinom(n3, 1, plogis(-0.8 + 0.12 * (po - 9))))
klucz_po[klucz_przed == 1 & runif(n3) < .85] <- 1
p3 <- data.frame(id = 1:n3, grupa, przed, po, klucz_przed, klucz_po)
round(do.call(rbind, lapply(split(p3, p3$grupa), function(d) c(n = nrow(d), M_przed = mean(d$przed), SD_przed = sd(d$przed),
                                                              M_po = mean(d$po), SD_po = sd(d$po)))), 2)
# ANCOVA: wynik po kursie z pomiarem wyjściowym jako współzmienną
options(contrasts = c("contr.sum", "contr.poly"))
m3 <- lm(po ~ przed + grupa, data = p3)
a3 <- Anova(m3, type = 3); suppressMessages(print(a3))
suppressMessages(eta_squared(a3, partial = TRUE, alternative = "two.sided")) |> as.data.frame() |> (\(d) cbind(d[1], round(d[, c(2, 4, 5)], 3)))()
em3 <- emmeans(m3, ~ grupa); as.data.frame(em3) |> (\(d) cbind(d[1], round(d[2:6], 2)))()
summary(contrast(em3, "revpairwise"), infer = TRUE)
# Homogeniczność nachyleń: interakcja pomiaru wyjściowego z grupą
Anova(lm(po ~ przed * grupa, data = p3), type = 3)["przed:grupa", ]
options(contrasts = c("contr.treatment", "contr.poly"))
# Pytanie kluczowe w grupie z kursem: test McNemara
k <- subset(p3, grupa == "kurs")
tk <- table(przed = factor(k$klucz_przed, 0:1, c("błędna", "poprawna")), po = factor(k$klucz_po, 0:1, c("błędna", "poprawna"))); tk
round(100 * c(przed = mean(k$klucz_przed), po = mean(k$klucz_po)), 1)
mcnemar.test(tk)
Wynik w R
             n M_przed SD_przed  M_po SD_po
porównawcza 58    9.43     3.14  9.57  3.39
kurs        62   10.13     2.77 13.44  2.89
Anova Table (Type III tests)

Response: po
            Sum Sq  Df F value    Pr(>F)
(Intercept) 171.07   1  34.386 4.276e-08 ***
przed       581.39   1 116.863 < 2.2e-16 ***
grupa       330.11   1  66.353 4.655e-13 ***
Residuals   582.07 117
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  Parameter Eta2_partial CI_low CI_high
1     przed        0.500  0.376   0.598
2     grupa        0.362  0.230   0.478
        grupa emmean   SE  df lower.CL upper.CL
1 porównawcza   9.84 0.29 117     9.26    10.42
2        kurs  13.18 0.28 117    12.62    13.75
 contrast           estimate   SE  df lower.CL upper.CL t.ratio p.value
 kurs - porównawcza     3.34 0.41 117     2.53     4.16   8.146 <0.0001

Confidence level used: 0.95
Anova Table (Type III tests)

Response: po
            Sum Sq Df F value Pr(>F)
przed:grupa 0.5996  1  0.1196 0.7301
          po
przed      błędna poprawna
  błędna        8       41
  poprawna      0       13
przed    po
 21.0  87.1

	McNemar's Chi-squared test with continuity correction

data:  tk
McNemar's chi-squared = 39.024, df = 1, p-value = 4.185e-10
4. Projekt 4: zgodność instruktorów – ICC, Bland–Altman i kappa
R
# Projekt 4: zgodność dwóch instruktorów oceniających scenariusze symulacyjne (dane symulowane).
# 50 nagranych scenariuszy; każdy instruktor wypełnia listę kontrolną (0–30 pkt)
# i niezależnie decyduje: zaliczone / niezaliczone.
suppressPackageStartupMessages({ library(psych) })
set.seed(7004)
n4 <- 50
prawdziwy <- rnorm(n4, 22, 3.6)
ocena_A <- pmin(30, pmax(0, round(prawdziwy + rnorm(n4, 0, 1.3))))
ocena_B <- pmin(30, pmax(0, round(prawdziwy + 0.9 + rnorm(n4, 0, 1.3))))
zal_A <- as.integer(prawdziwy + rnorm(n4, 0, 1.5) > 18)
zal_B <- as.integer(prawdziwy + rnorm(n4, 0, 1.5) > 18)
p4 <- data.frame(scenariusz = 1:n4, ocena_A, ocena_B, zal_A, zal_B)
round(c(M_A = mean(ocena_A), SD_A = sd(ocena_A), M_B = mean(ocena_B), SD_B = sd(ocena_B)), 2)
# ICC: model dwuczynnikowy losowy, pojedynczy oceniający, zgodność absolutna (ICC2) i spójność (ICC3)
ic <- ICC(cbind(ocena_A, ocena_B), lmer = FALSE)
ic$results[c("Single_random_raters", "Single_fixed_raters"), c("type", "ICC", "F", "df1", "df2", "p", "lower bound", "upper bound")] |>
  transform(ICC = round(ICC, 3), F = round(F, 2), `lower bound` = round(`lower bound`, 3), `upper bound` = round(`upper bound`, 3))
# Bland–Altman: średnia różnica (B − A) i granice zgodności
r <- ocena_B - ocena_A
round(c(roznica_M = mean(r), SD = sd(r), dolna = mean(r) - 1.96 * sd(r), gorna = mean(r) + 1.96 * sd(r)), 2)
t.test(r)$conf.int |> round(2)
# Zaliczenie: tabela, procent zgodności i kappa Cohena
tz <- table(A = factor(zal_A, 0:1, c("nie", "tak")), B = factor(zal_B, 0:1, c("nie", "tak"))); tz
round(c(zgodnosc_proc = 100 * mean(zal_A == zal_B), zal_A_proc = 100 * mean(zal_A), zal_B_proc = 100 * mean(zal_B)), 1)
ck <- cohen.kappa(cbind(zal_A, zal_B)); round(ck$confid["unweighted kappa", ], 3)
Wynik w R
  M_A  SD_A   M_B  SD_B
22.66  3.87 23.72  4.10
                     type   ICC     F df1 df2            p lower bound upper bound
Single_random_raters ICC2 0.845 14.67  49  49 3.826484e-17       0.677       0.920
Single_fixed_raters  ICC3 0.872 14.67  49  49 3.826484e-17       0.785       0.925
roznica_M        SD     dolna     gorna
     1.06      2.01     -2.89      5.01
[1] 0.49 1.63
attr(,"conf.level")
[1] 0.95
     B
A     nie tak
  nie   4   2
  tak   4  40
zgodnosc_proc    zal_A_proc    zal_B_proc
           88            88            84
   lower estimate    upper
   0.161    0.503    0.846
5. Projekt 5: zatrzymanie krążenia – regresja logistyczna; plik do pobrania
R
# Projekt 5: retrospektywna analiza kart zdarzeń – pozaszpitalne zatrzymanie krążenia (dane symulowane).
# 310 pacjentów, u których zespół podjął resuscytację; wynik: powrót spontanicznego krążenia (ROSC)
# przed przekazaniem do szpitala; predyktory: RKO podjęta przez świadków, pierwszy rytm do defibrylacji,
# czas dotarcia (min) i wiek (na 10 lat). Na końcu: zapis pliku XLSX z danymi pięciu projektów.
suppressPackageStartupMessages({ library(openxlsx) })
set.seed(7005)
n5 <- 310
wiek <- round(pmin(95, pmax(25, rnorm(n5, 67, 13))))
swiadek_rko <- rbinom(n5, 1, .45)
rytm_defib <- rbinom(n5, 1, .24)
czas_dotarcia <- round(exp(rnorm(n5, log(9), .38)), 1)
lin <- -1.05 + 0.70 * swiadek_rko + 1.15 * rytm_defib - 0.09 * (czas_dotarcia - 9) - 0.12 * (wiek - 67) / 10
rosc <- rbinom(n5, 1, plogis(lin))
p5 <- data.frame(id = 1:n5, wiek, swiadek_rko, rytm_defib, czas_dotarcia, rosc)
c(ROSC = sum(rosc), N = n5, proc = round(100 * mean(rosc), 1), EPV = round(min(sum(rosc), n5 - sum(rosc)) / 4, 1))
round(100 * tapply(p5$rosc, list(swiadek_RKO = p5$swiadek_rko, rytm_do_defibrylacji = p5$rytm_defib), mean), 1)
m5 <- glm(rosc ~ swiadek_rko + rytm_defib + czas_dotarcia + I((wiek - 67) / 10), family = binomial, data = p5)
round(cbind(OR = exp(coef(m5)), exp(confint.default(m5)), p = summary(m5)$coefficients[, 4]), 3)
round(c(Nagelkerke_R2 = { ll0 <- logLik(update(m5, . ~ 1)); ll1 <- logLik(m5)
  (1 - exp(2 * (ll0 - ll1) / n5)) / (1 - exp(2 * ll0 / n5)) }, AUC = { pr <- fitted(m5)
  mean(outer(pr[rosc == 1], pr[rosc == 0], ">") + .5 * outer(pr[rosc == 1], pr[rosc == 0], "==")) }), 3)

# Plik do pobrania: dane pięciu projektów (autor w metadanych: Metodolog.pl)
e <- lapply(c("b70-1-czas-dotarcia.R", "b70-2-symulacja-rko.R", "b70-3-kurs-pierwszej-pomocy.R", "b70-4-zgodnosc-oceniajacych.R"),
            function(f) { en <- new.env(); invisible(capture.output(suppressMessages(source(f, local = en)))); en })
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z ratownictwa medycznego – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
ark <- list("1_czas_dotarcia" = e[[1]]$p1, "2_symulacja_RKO" = e[[2]]$p2l[, c("id", "kolejnosc", "warunek", "odcinek", "glebokosc")],
            "2_symulacja_RKO_osoby" = e[[2]]$p2, "3_kurs_pierwszej_pomocy" = e[[3]]$p3, "4_zgodnosc_oceniajacych" = e[[4]]$p4,
            "5_NZK_ROSC" = p5)
for (nm in names(ark)) { addWorksheet(wb, nm); writeData(wb, nm, ark[[nm]]); freezePane(wb, nm, firstRow = TRUE) }
addWorksheet(wb, "opis")
writeData(wb, "opis", c("Dane symulowane (R, set.seed 7001–7005) – metodolog.pl, wpis „Statystyka w pracy z ratownictwa medycznego”.",
                       "1_czas_dotarcia: czas_min = czas od przyjęcia zgłoszenia do dotarcia na miejsce (min).",
                       "2_symulacja_RKO: glebokosc = średnia głębokość uciśnięć (mm) w 30-sekundowym odcinku; arkusz _osoby: średnie z 2 minut,",
                       "   czestotliwosc = uciśnięcia/min, proc_prawidlowa = odsetek uciśnięć o prawidłowej głębokości wg oprogramowania manekina.",
                       "3_kurs_pierwszej_pomocy: przed, po = test wiedzy 0–20; klucz_przed, klucz_po = pytanie kluczowe (1 = poprawna odpowiedź).",
                       "4_zgodnosc_oceniajacych: ocena_A, ocena_B = lista kontrolna 0–30; zal_A, zal_B = decyzja o zaliczeniu (1 = tak).",
                       "5_NZK_ROSC: rosc = 1, gdy powrót spontanicznego krążenia; swiadek_rko, rytm_defib = 1 (tak); czas_dotarcia w min."))
saveWorkbook(wb, "../statystyka-ratownictwo-dane-przyklad.xlsx", overwrite = TRUE)
spr <- readxl::excel_sheets("../statystyka-ratownictwo-dane-przyklad.xlsx"); spr
sapply(spr[1:6], function(a) nrow(readxl::read_excel("../statystyka-ratownictwo-dane-przyklad.xlsx", sheet = a)))
Wynik w R
 ROSC     N  proc   EPV
118.0 310.0  38.1  29.5
           rytm_do_defibrylacji
swiadek_RKO    0    1
          0 18.9 50.0
          1 46.0 68.3
                     OR 2.5 % 97.5 %     p
(Intercept)       1.210 0.546  2.683 0.639
swiadek_rko       3.404 2.019  5.739 0.000
rytm_defib        3.545 2.035  6.177 0.000
czas_dotarcia     0.837 0.770  0.910 0.000
I((wiek - 67)/10) 1.152 0.940  1.414 0.173
Nagelkerke_R2           AUC
        0.259         0.763
[1] "1_czas_dotarcia"         "2_symulacja_RKO"         "2_symulacja_RKO_osoby"   "3_kurs_pierwszej_pomocy"
[5] "4_zgodnosc_oceniajacych" "5_NZK_ROSC"              "opis"
        1_czas_dotarcia         2_symulacja_RKO   2_symulacja_RKO_osoby 3_kurs_pierwszej_pomocy
                    600                     320                      80                     120
4_zgodnosc_oceniajacych              5_NZK_ROSC
                     50                     310
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje wilcox.test(), t.test(), lm(), mcnemar.test() i glm() z pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- quantreg (wersja 6.1): Koenker, R. (2025). quantreg: Quantile regression (R package version 6.1) [Computer software]. https://doi.org/10.32614/CRAN.package.quantreg
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizach prac z ratownictwa medycznego
- Sama średnia czasu dotarcia przy silnie skośnym rozkładzie. Podaj medianę, kwartyle i 90. percentyl.
- Usuwanie najdłuższych wyjazdów jako „odstających”. To prawdziwe dane o działaniu systemu, a nie błędy pomiaru.
- Brak definicji punktów czasowych, od których liczony jest czas dotarcia albo czas do pierwszego uciśnięcia.
- Test dla prób niezależnych w schemacie, w którym każdy student wykonał obie próby. Dane z jednej osoby są ze sobą powiązane.
- Średnia z całej próby RKO zamiast analizy w czasie, która pokazuje spadek jakości uciśnięć wraz ze zmęczeniem.
- Dwa osobne testy przed i po w grupach kursu i porównawczej zamiast jednej analizy różnicy między grupami, np. ANCOVA.
- Korelacja Pearsona jako miara zgodności oceniających. Wysoka korelacja nie wyklucza tego, że jeden instruktor stale ocenia wyżej. Użyj ICC zgodności absolutnej i wykresu Blanda–Altmana.
- Sama kappa bez odsetka zgodności i tabeli przy decyzjach, w których prawie wszyscy zaliczają.
- Wnioski o skuteczności leczenia z badania na manekinie albo z retrospektywnej analizy kart bez uwzględnienia czynników zakłócających.
Najczęstsze pytania
Jakie testy statystyczne wybrać do pracy licencjackiej z ratownictwa medycznego?
To zależy od źródła danych. Skośne czasy dotarcia porównasz testem Manna–Whitneya i opiszesz medianą oraz 90. percentylem, wyniki symulacji tej samej osoby w dwóch warunkach – testem t dla prób zależnych albo Wilcoxona, efekt kursu z grupą porównawczą – ANCOVA, zgodność instruktorów – ICC i kappą, a czynniki związane z ROSC – regresją logistyczną. Do każdego testu dołącz wielkość efektu.
Jak opisać czas dotarcia karetki w pracy dyplomowej?
Zdefiniuj, od którego do którego momentu liczysz czas, np. od przyjęcia zgłoszenia do dotarcia na miejsce. Rozkład czasów jest zwykle prawostronnie skośny, więc podaj medianę z kwartylami i 90. percentyl, a średnią tylko jako uzupełnienie. Grupy porównaj testem Manna–Whitneya z przesunięciem Hodgesa–Lehmanna albo regresją kwantylową.
Jak przeanalizować wyniki RKO na manekinie z informacją zwrotną i bez niej?
Jeśli każdy uczestnik wykonał obie próby w losowej kolejności, porównaj średnią głębokość testem t dla prób zależnych z dz, a odsetek uciśnięć o prawidłowej głębokości – testem Wilcoxona dla par. Spadek jakości w kolejnych odcinkach próby zbadaj modelem mieszanym z interakcją warunku i czasu. Zakres prawidłowej głębokości i częstotliwości podaj według wytycznych obowiązujących w czasie badania.
Dlaczego kappa jest niska, skoro instruktorzy zgadzali się w prawie wszystkich ocenach?
Kappa odejmuje zgodność przypadkową, a ta jest bardzo duża, gdy prawie wszyscy uczestnicy zaliczają scenariusz. Wtedy 88% zgodności może dać kappę około .50. Podaj w pracy kappę razem z odsetkiem zgodności i tabelą 2 × 2, a dla wyników punktowych użyj ICC i wykresu Blanda–Altmana.
Ile kart zdarzeń potrzeba do regresji logistycznej ROSC?
Liczy się nie liczba kart, tylko liczba rzadszego wyniku na każdą zmienną w modelu. Przy mniej niż około 10 zdarzeniach na zmienną współczynniki regresji logistycznej bywają obciążone. Jeśli ROSC wystąpił u 60 pacjentów, model nie powinien mieć więcej niż kilku predyktorów.
Powiązane hasła
Przeczytaj też
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikStatystyka w pracy z położnictwa
Wiedza ciężarnych, karmienie piersią, skale po porodzie i porównania grup położnic: plan analiz, RR i OR, Kaplan–Meier, APA i kod R.
Czytaj →Piszesz pracę z ratownictwa medycznego i nie wiesz, jak przeanalizować dane?
Pomożemy dobrać analizy do danych z dokumentacji, symulacji albo ankiety, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cheng, A., Kessler, D., Mackinnon, R., Chang, T. P., Nadkarni, V. M., Hunt, E. A., Duval-Arnould, J., Lin, Y., Cook, D. A., Pusic, M., Hui, J., Moher, D., Egger, M., & Auerbach, M. (2016). Reporting guidelines for health care simulation research: Extensions to the CONSORT and STROBE statements. BMJ Simulation and Technology Enhanced Learning, 2(3), 51–60. https://doi.org/10.1136/bmjstel-2016-000124 ● Otwarty dostęp: pełny tekst
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90158-l
- Hallgren, K. A. (2012). Computing inter-rater reliability for observational data: An overview and tutorial. Tutorials in Quantitative Methods for Psychology, 8(1), 23–34. https://doi.org/10.20982/tqmp.08.1.p023 ● Otwarty dostęp
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/s0895-4356(96)00236-3 ● Otwarty dostęp
- Perkins, G. D., Jacobs, I. G., Nadkarni, V. M., Berg, R. A., Bhanji, F., Biarent, D., Bossaert, L. L., Brett, S. J., Chamberlain, D., de Caen, A. R., Deakin, C. D., Finn, J. C., Gräsner, J.-T., Hazinski, M. F., Iwami, T., Koster, R. W., Lim, S. H., Ma, M. H.-M., McNally, B. F., … Nolan, J. P. (2015). Cardiac arrest and cardiopulmonary resuscitation outcome reports: Update of the Utstein resuscitation registry templates for out-of-hospital cardiac arrest. Resuscitation, 96, 328–340. https://doi.org/10.1016/j.resuscitation.2014.11.002
- Smyth, M. A., van Goor, S., Hansen, C. M., Fijačko, N., Nakagawa, N. K., Raffay, V., Ristagno, G., Rogers, J., Scquizzato, T., Smith, C. M., Spartinou, A., Keck, W., & Perkins, G. D. (2025). European Resuscitation Council Guidelines 2025 adult basic life support. Resuscitation, 215, Article 110771. https://doi.org/10.1016/j.resuscitation.2025.110771
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
- Whitley, E., & Ball, J. (2002). Statistics review 6: Nonparametric methods. Critical Care, 6(6), 509–513. https://doi.org/10.1186/cc1820 ● Otwarty dostęp
Cytowania BibTeX
@article{cheng2016reporting, author={Cheng, Adam and Kessler, David and Mackinnon, Ralph and Chang, Todd P. and Nadkarni, Vinay M. and Hunt, Elizabeth A. and Duval-Arnould, Jordan and Lin, Yiqun and Cook, David A. and Pusic, Martin and Hui, Joshua and Moher, David and Egger, Matthias and Auerbach, Marc}, title={{Reporting guidelines for health care simulation research: Extensions to the CONSORT and STROBE statements}}, journal={BMJ Simulation and Technology Enhanced Learning}, year={2016}, volume={2}, number={3}, pages={51--60}, doi={10.1136/bmjstel-2016-000124}}@article{feinstein1990high, author={Feinstein, Alvan R. and Cicchetti, Domenic V.}, title={{High agreement but low kappa: I. The problems of two paradoxes}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={6}, pages={543--549}, doi={10.1016/0895-4356(90)90158-l}}@article{hallgren2012computing, author={Hallgren, Kevin A.}, title={{Computing inter-rater reliability for observational data: An overview and tutorial}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2012}, volume={8}, number={1}, pages={23--34}, doi={10.20982/tqmp.08.1.p023}}@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{peduzzi1996simulation, author={Peduzzi, Peter and Concato, John and Kemper, Elizabeth and Holford, Theodore R. and Feinstein, Alvan R.}, title={{A simulation study of the number of events per variable in logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={1996}, volume={49}, number={12}, pages={1373--1379}, doi={10.1016/s0895-4356(96)00236-3}}@article{perkins2015cardiac, author={Perkins, Gavin D. and Jacobs, Ian G. and Nadkarni, Vinay M. and Berg, Robert A. and Bhanji, Farhan and Biarent, Dominique and Bossaert, Leo L. and Brett, Stephen J. and Chamberlain, Douglas and de Caen, Allan R. and Deakin, Charles D. and Finn, Judith C. and Gräsner, Jan-Thorsten and Hazinski, Mary Fran and Iwami, Taku and Koster, Rudolph W. and Lim, Swee Han and Ma, Matthew Huei-Ming and McNally, Bryan F. and Morley, Peter T. and Morrison, Laurie J. and Monsieurs, Koenraad G. and Montgomery, William and Nichol, Graham and Okada, Kazuo and Ong, Marcus Eng Hock and Travers, Andrew H. and Nolan, Jerry P.}, title={{Cardiac arrest and cardiopulmonary resuscitation outcome reports: Update of the Utstein resuscitation registry templates for out-of-hospital cardiac arrest}}, journal={Resuscitation}, year={2015}, volume={96}, pages={328--340}, doi={10.1016/j.resuscitation.2014.11.002}}@article{smyth2025european, author={Smyth, Michael A. and van Goor, Sander and Hansen, Carolina Malta and Fijačko, Nino and Nakagawa, Naomi Kondo and Raffay, Violetta and Ristagno, Giuseppe and Rogers, Jessica and Scquizzato, Tommaso and Smith, Christopher M. and Spartinou, Anastasia and Keck, Wolfgang and Perkins, Gavin D.}, title={{European Resuscitation Council Guidelines 2025 adult basic life support}}, journal={Resuscitation}, year={2025}, volume={215}, eid={110771}, doi={10.1016/j.resuscitation.2025.110771}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}@article{whitley2002statistics, author={Whitley, Elise and Ball, Jonathan}, title={{Statistics review 6: Nonparametric methods}}, journal={Critical Care}, year={2002}, volume={6}, number={6}, pages={509--513}, doi={10.1186/cc1820}}