Pięć typowych projektów w pracy z położnictwa
Prace dyplomowe z położnictwa dotyczą zwykle trzech okresów: ciąży, porodu i połogu. Badane są ciężarne, położnice, matki w pierwszych miesiącach po porodzie albo personel. Najczęściej jest to ankieta przeprowadzona raz, czyli schemat przekrojowy, ale w położnictwie często pojawia się też krótka obserwacja w czasie: kontakt z kobietą przy wypisie i telefonicznie po kilku tygodniach lub miesiącach. To już badanie kohortowe, które wymaga innych analiz niż zwykła ankieta. Tabela porządkuje pięć projektów omawianych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Wiedza ciężarnych | Czy szkoła rodzenia wiąże się z wiedzą o porodzie tak samo u pierwiastek i wieloródek? | autorski test wiedzy, dwa czynniki | ANOVA dwuczynnikowa z interakcją, efekty proste | η²p, d |
| 2. Wyłączne karmienie piersią przy wypisie | Czy kontakt „skóra do skóry” wiąże się z wyłącznym karmieniem? | wynik tak/nie, czynniki okołoporodowe | chi-kwadrat, regresja logistyczna | RR, OR, różnica ryzyka |
| 3. Czas karmienia piersią | Jak długo matki karmią piersią i od czego to zależy? | tydzień zakończenia karmienia, obserwacje utracone | Kaplan–Meier, test log-rank, model Coxa | HR |
| 4. Skale po porodzie | Czy nasilenie objawów depresyjnych różni się po porodzie siłami natury i cięciu cesarskim? | wynik skali przesiewowej, wsparcie partnera | test Manna–Whitneya, korelacja Spearmana, rzetelność | korelacja rangowo-dwuseryjna, ρ, α, ω |
| 5. Porównanie grup położnic | Czy ból w pierwszej dobie zależy od rodzaju porodu? | NRS 0–10, trzy grupy | test Kruskala–Wallisa z testem Dunna | ε² |
Wszystkie dane w przykładach są symulowane. Możesz je pobrać jako plik XLSX (arkusz dla każdego projektu i arkusz z opisem zmiennych) i powtórzyć analizy w swoim programie. Jeśli Twoja praca dotyczy raczej opieki nad pacjentem w szpitalu, zajrzyj też do poradnika statystyka w pracy z pielęgniarstwa. Projekty o rozpowszechnieniu zjawisk w populacji i standaryzacji wskaźników omawiamy w poradniku statystyka w pracy ze zdrowia publicznego.
Zanim zaczniesz: definicje, czas obserwacji i zgody
Zdefiniuj wynik, zanim zbierzesz dane. „Karmienie piersią” brzmi jednoznacznie, a w praktyce może oznaczać kilka różnych zachowań. Labbok i Krasovec (1990) zaproponowali schemat, który odróżnia karmienie pełne od częściowego, a pełne dzieli na wyłączne i prawie wyłączne. Wyodrębnili też karmienie symboliczne, które ma niewielkie znaczenie żywieniowe. Jeśli w ankiecie zapytasz tylko „czy karmi Pani piersią?”, matka karmiąca raz dziennie i matka karmiąca wyłącznie piersią udzielą tej samej odpowiedzi. Zapisz w metodzie, jaką definicję przyjmujesz i na jaki okres pyta pytanie (np. ostatnie 24 godziny, od urodzenia).
Ustal punkty pomiaru. Wiedzę ciężarnych bada się zwykle raz, w III trymestrze. Karmienie piersią i samopoczucie po porodzie wymagają co najmniej dwóch kontaktów: przy wypisie i po kilku tygodniach. Każdy kolejny kontakt to ryzyko, że część kobiet nie odpowie. Zaplanuj z góry, jak opiszesz utratę uczestniczek i co zrobisz z ich danymi. W projekcie 3 pokazujemy, że w analizie czasu do zdarzenia kobiety utracone z obserwacji nie muszą wypadać z analizy.
Załatw zgody przed pierwszym kontaktem z pacjentką. Badania kobiet w ciąży i w połogu oraz noworodków wymagają zwykle opinii komisji bioetycznej, zgody kierownictwa oddziału i świadomej zgody uczestniczki. Szczegóły zależą od regulaminu uczelni i placówki. Ustal je z promotorem, bo zgody nie da się uzyskać wstecz.
Projekt 1. Wiedza ciężarnych: szkoła rodzenia a parzystość
Przykład: 160 ciężarnych w III trymestrze rozwiązało autorski test wiedzy o porodzie i połogu (25 pytań, wynik 0–25). Zapytano je, czy uczestniczyły w zajęciach szkoły rodzenia, i czy jest to pierwszy poród (pierwiastki), czy kolejny (wieloródki). Średni wynik wyniósł 15.56 punktu (SD = 3.74, Me = 16). Punktację testu, rzetelność KR-20 i analizę trudności pytań opisujemy w poradniku ankieta wiedzy – analiza krok po kroku. Tu zajmujemy się pytaniem, które w położnictwie pada najczęściej: czy szkoła rodzenia „daje” wiedzę.
Kłopot polega na tym, że wieloródki mają już doświadczenie porodu i rzadziej chodzą na zajęcia. W próbie do szkoły rodzenia chodziło 47 z 86 pierwiastek i tylko 13 z 74 wieloródek. Porównanie „szkoła rodzenia tak/nie” bez uwzględnienia parzystości miesza więc dwa czynniki. Dlatego oba wprowadzamy do jednej analizy wariancji razem z ich interakcją.
| Grupa | n | M | SD |
|---|---|---|---|
| Pierwiastki bez szkoły rodzenia | 39 | 13.28 | 4.03 |
| Pierwiastki po szkole rodzenia | 47 | 16.15 | 3.56 |
| Wieloródki bez szkoły rodzenia | 61 | 16.41 | 3.26 |
| Wieloródki po szkole rodzenia | 13 | 16.23 | 3.17 |
ANOVA 2 × 2 (sumy kwadratów typu III, bo grupy są nierówne) wykazała istotną interakcję szkoły rodzenia i parzystości: F(1, 156) = 5.27, p = .023, η²p = .03, 95% CI [.00, .11]. Przy istotnej interakcji efekty główne mają ograniczony sens, więc liczymy efekty proste. U pierwiastek kobiety po szkole rodzenia uzyskały średnio o 2.87 punktu więcej, 95% CI [1.35, 4.38], t(156) = 3.74, p < .001, d = 0.81. U wieloródek różnicy praktycznie nie było: −0.18 punktu, 95% CI [−2.32, 1.96], t(156) = −0.17, p = .869.
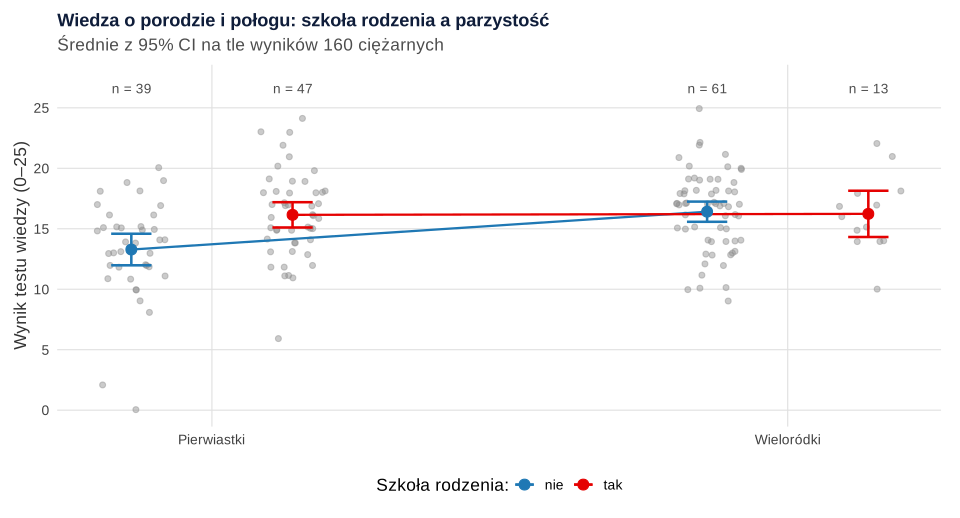
Wnioski formułuj ostrożnie. Kobiety same decydują o udziale w zajęciach, więc grupy mogą różnić się wykształceniem, motywacją albo dostępem do opieki. W pracy napisz, że „wiedza była wyższa u pierwiastek uczestniczących w szkole rodzenia”, a nie że „szkoła rodzenia zwiększa wiedzę”. Druga uwaga dotyczy małej grupy 13 wieloródek: wynik „brak różnicy” wynika tu także z małej precyzji, co widać po szerokim przedziale ufności. Jak czytać i raportować ANOVA z dwoma czynnikami, pokazujemy w poradniku ANOVA krok po kroku, a kolejne wielkości efektu (η²p i d) objaśnia Lakens (2013).
Projekt 2. Wyłączne karmienie piersią przy wypisie: RR, OR i regresja logistyczna
Przykład: 240 położnic jednego szpitala. Zapisano, czy w pierwszej godzinie po porodzie miał miejsce kontakt „skóra do skóry”, rodzaj porodu i parzystość. Wynikiem jest wyłączne karmienie piersią w dniu wypisu (tak/nie), zdefiniowane w protokole badania. Wyłącznie piersią karmiło 162 z 240 kobiet.
| Kontakt „skóra do skóry” | Wyłączne karmienie: tak | Wyłączne karmienie: nie | Razem |
|---|---|---|---|
| Tak | 125 (76.2%) | 39 (23.8%) | 164 |
| Nie | 37 (48.7%) | 39 (51.3%) | 76 |
Test chi-kwadrat niezależności potwierdza związek: χ²(1) = 17.95, p < .001. Sama istotność nie mówi jednak, jak duża jest różnica. W tabeli 2 × 2 masz do wyboru trzy miary:
- Różnica ryzyka: 76.2% − 48.7% = 27.5 punktu procentowego, 95% CI [14.6, 40.5]. Najłatwiej ją zrozumieć i dobrze nadaje się do dyskusji praktycznej.
- Ryzyko względne (RR): 1.57, 95% CI [1.22, 2.00]. Wyłączne karmienie było o 57% częstsze po kontakcie „skóra do skóry”.
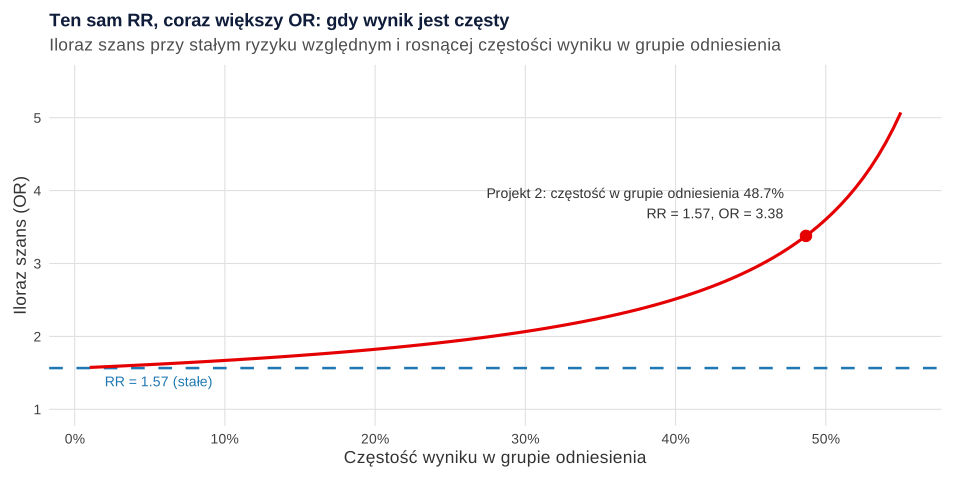
- Iloraz szans (OR): 3.38, 95% CI [1.90, 6.01]. To stosunek szans, a nie prawdopodobieństw (Bland i Altman, 2000).
OR = 3.38 i RR = 1.57 opisują te same dane, a różnią się ponad dwukrotnie. Davies i in. (1998) pokazali, że iloraz szans odczytany jako ryzyko względne zawsze zawyża efekt, a rozbieżność rośnie wraz z częstością wyniku. Wyłączne karmienie przy wypisie dotyczy tu dwóch trzecich kobiet, więc „OR = 3.38” nie wolno przetłumaczyć na „ponad trzy razy częściej”. Rysunek 2 pokazuje, jak przy stałym RR rośnie OR, gdy wynik staje się częstszy.
Kilka czynników naraz: regresja logistyczna
Kontakt „skóra do skóry” odbywa się rzadziej po cięciu cesarskim, a rodzaj porodu też może wiązać się z karmieniem. Niezależny związek każdego czynnika oceni regresja logistyczna. Po uwzględnieniu rodzaju porodu i parzystości kontakt „skóra do skóry” pozostał związany z wyłącznym karmieniem: OR = 2.92, 95% CI [1.59, 5.38], p = .001. Pierwiastki rzadziej karmiły wyłącznie piersią (OR = 0.46, 95% CI [0.26, 0.81], p = .008), a związek z cięciem cesarskim nie osiągnął istotności (OR = 0.56, 95% CI [0.30, 1.02], p = .058).
Ponieważ wynik jest częsty, warto podać też skorygowane ryzyko względne. Daje je model Poissona z odpornymi błędami standardowymi: RR = 1.47, 95% CI [1.16, 1.87]. Takie zdanie łatwiej przełożyć na praktykę niż iloraz szans.
Przed dodaniem kolejnych zmiennych policz, ile masz zdarzeń. Peduzzi i in. (1996) w symulacjach pokazali, że przy mniej niż 10 zdarzeniach na zmienną (EPV) współczynniki regresji logistycznej są obciążone, a przedziały ufności mają niewłaściwe pokrycie. Liczy się rzadszy wynik: tu 78 kobiet niekarmiących wyłącznie piersią. Przy trzech predyktorach daje to EPV = 26, ale przy dziesięciu zmiennych z metryczki byłoby to już tylko 7.8. Założenia modelu, interpretację i tabelę wyników omawiamy w poradniku regresja logistyczna krok po kroku.
Projekt 3. Jak długo matki karmią piersią: analiza czasu do zdarzenia
Te same 240 kobiet obserwowano przez 26 tygodni po porodzie, pytając, kiedy zakończyły karmienie piersią. W tym czasie karmienie zakończyło 78 kobiet. Pozostałe 162 to obserwacje cenzurowane: 132 karmiły nadal w 26. tygodniu, a z 30 kontakt urwał się wcześniej. Clark i in. (2003) przypominają, że analiza przeżycia jest potrzebna właśnie wtedy, gdy wynik to czas do zdarzenia, a u części osób zdarzenie nie wystąpiło do końca obserwacji.
Najczęstszy błąd w takich pracach to średnia „liczba tygodni karmienia” liczona tylko z kobiet, które już zakończyły karmienie, albo usunięcie kobiet utraconych z obserwacji. Obie decyzje zaniżają czas karmienia. Krzywa Kaplana–Meiera wykorzystuje informację o każdej kobiecie do chwili, w której ostatnio wiadomo było, że karmi.
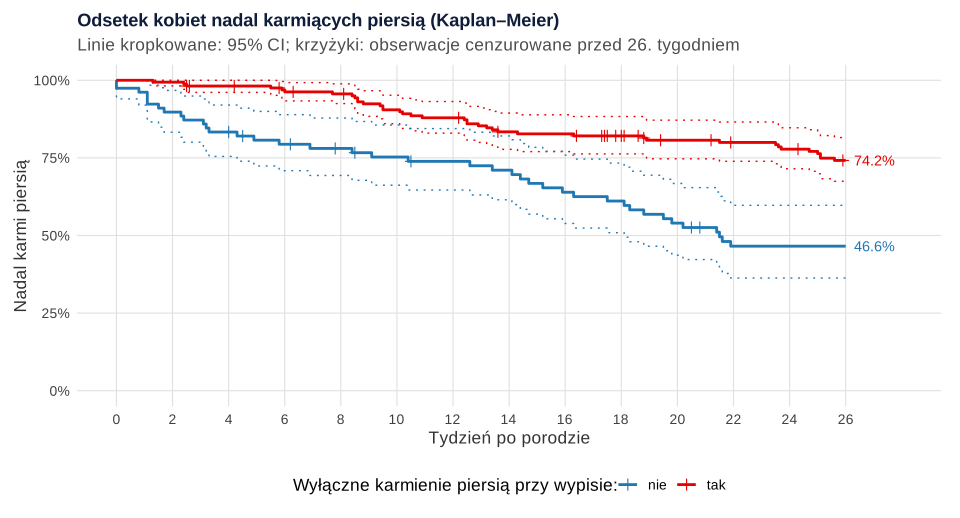
W grupie karmiącej wyłącznie piersią przy wypisie (n = 162) w 12. tygodniu nadal karmiło 87.9%, 95% CI [83.0, 93.2], a w 26. tygodniu 74.2%, 95% CI [67.5, 81.5]. W grupie pozostałej (n = 78) odsetki te wyniosły 73.9%, 95% CI [64.6, 84.4], i 46.6%, 95% CI [36.3, 59.7]. Mediana czasu karmienia w drugiej grupie wyniosła 21.5 tygodnia. W pierwszej grupie mediany nie da się wyznaczyć, bo do końca obserwacji karmienia nie zakończyła nawet połowa kobiet. W pracy napisz więc „mediana nie została osiągnięta”, a nie podawaj w jej miejsce średniej.
Krzywe porównuje test log-rank: χ²(1) = 20.4, p < .001. Bland i Altman (2004) zwracają uwagę, że test log-rank nie podaje wielkości różnicy. Do tego służy iloraz hazardów z modelu Coxa: HR = 0.37, 95% CI [0.24, 0.58], p < .001. W każdym momencie obserwacji „ryzyko” zakończenia karmienia było u kobiet karmiących wyłącznie piersią przy wypisie o około 63% mniejsze. Test założenia proporcjonalnych hazardów nie wskazał na jego naruszenie (p = .290). Pełną procedurę, z modelem wieloczynnikowym, pokazujemy w poradniku analiza przeżycia: Kaplan–Meier i model Coxa.
Projekt 4. Skale przesiewowe po porodzie: wynik, rzetelność i porównania
W pracach z położnictwa często wykorzystuje się standaryzowane kwestionariusze: skale objawów depresyjnych po porodzie, lęku przed porodem, poczucia własnej skuteczności w karmieniu piersią czy oceny doświadczenia porodu. Przykładem narzędzia przesiewowego jest Edynburska Skala Depresji Poporodowej (EPDS). Cox i in. (1987) opisali ją jako 10-pozycyjną skalę samoopisową do wykrywania depresji poporodowej. W badaniu walidacyjnym 84 matek miała zadowalającą czułość i swoistość, a wypełnienie zajmowało około 5 minut.
Zasady, które dotyczą każdego takiego narzędzia:
- Sposób liczenia wyniku i punkt odcięcia bierz z publikacji autorów lub walidacji wersji, której używasz, i cytuj to źródło. Próg przesiewowy w polskiej wersji może różnić się od progu z oryginału, a w różnych badaniach przyjmowano różne progi. Nie wpisuj progu „z internetu”. Jak policzyć wynik zgodnie z kluczem, pokazujemy w poradniku jak policzyć wynik kwestionariusza.
- Wynik powyżej progu to nie rozpoznanie. Skala przesiewowa wskazuje kobiety, które wymagają dalszej oceny specjalisty. Pisz „wynik wskazujący na nasilone objawy depresyjne”, a nie „depresja poporodowa u 18% badanych”. W protokole badania zaplanuj też, co zrobisz, gdy uczestniczka uzyska wysoki wynik, np. jak przekażesz informację o możliwości konsultacji.
- Nie przedrukowuj pozycji w aneksie. Podaj liczbę pozycji, skalę odpowiedzi, kierunek punktacji i źródło. Polskie wersje części narzędzi są rozpowszechniane przez autorów adaptacji lub wydawców, więc sprawdź warunki ich użycia. Wzór opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór.
Przykład: 196 kobiet z kohorty z projektu 2 wypełniło 6–8 tygodni po porodzie symulowaną skalę objawów depresyjnych (10 pozycji, każda punktowana 0–3, wynik 0–30, wyższy oznacza więcej objawów) i ocenę wsparcia partnera (średnia 1–5). Liczby nie dotyczą żadnego konkretnego kwestionariusza.
Wynik był prawostronnie skośny (skośność = 0.93): M = 7.34, SD = 6.50, ale Me = 6, Q1–Q3: 2–11. Przy takim rozkładzie podaj medianę i kwartyle obok średniej. Zanim zaczniesz porównywać grupy, sprawdź spójność wewnętrzną w swojej próbie: α Cronbacha = .90, ω McDonalda = .90. Rzetelność z artykułu walidacyjnego nie zastępuje rzetelności w Twoich danych.
Kobiety po cięciu cesarskim (n = 61, Me = 8, Q1–Q3: 3–15) miały wyższe wyniki niż kobiety po porodzie siłami natury (n = 135, Me = 5, Q1–Q3: 2–10.5). Test Manna–Whitneya: W = 3347, p = .036, korelacja rangowo-dwuseryjna r = .19, 95% CI [.01, .35]. Hart (2001) zwraca uwagę, że ten test nie porównuje samych median, lecz całe rozkłady, dlatego opisz ich kształt, a nie tylko wartość p. Wynik skali słabo i ujemnie korelował ze wsparciem partnera: korelacja Spearmana ρ = −.18, p = .014.
Skalę objawów możesz analizować także jako odsetek wyników przesiewowo dodatnich. Wtedy podaj go z przedziałem ufności dla proporcji i porównuj grupy testem chi-kwadrat. Testy licz jednak przede wszystkim na wyniku punktowym. Altman i Royston (2006) pokazali, że zamiana zmiennej ciągłej na dwie kategorie powoduje utratę informacji i mocy.
Projekt 5. Porównanie trzech grup położnic: ból w pierwszej dobie
Przykład: 150 położnic oceniło w pierwszej dobie ból w skali NRS od 0 do 10. Porównujemy trzy grupy: poród siłami natury bez nacięcia krocza (n = 60), poród siłami natury z nacięciem (n = 45) i cięcie cesarskie (n = 45). Mediany wyniosły odpowiednio 3 (Q1–Q3: 2–4), 4 (3–5) i 5 (4–6).
Wynik NRS ma tylko 11 możliwych wartości i wiele wyników wiązanych, więc wybieramy test Kruskala–Wallisa: χ²(2) = 28.10, p < .001, ε² = .19. Istotny wynik mówi tylko, że grupy się różnią. Które pary się różnią, wskaże test Dunna (Dunn, 1964) z poprawką Holma:
| Porównanie | z | p (Holm) |
|---|---|---|
| SN z nacięciem vs SN bez nacięcia | 3.25 | .002 |
| Cięcie cesarskie vs SN bez nacięcia | 5.18 | < .001 |
| Cięcie cesarskie vs SN z nacięciem | 1.81 | .071 |
Ból był większy po nacięciu krocza i po cięciu cesarskim niż po porodzie siłami natury bez nacięcia. Między dwiema pierwszymi grupami różnica nie była istotna. Pamiętaj, że w pierwszej dobie ból zależy też od leczenia przeciwbólowego. Jeśli możesz, zapisz je w karcie badania i opisz w ograniczeniach. Analizę skal bólu, w tym klinicznie istotną zmianę, opisujemy w poradniku jak analizować skale bólu NRS i VAS, a test Kruskala–Wallisa i porównania parami krok po kroku – w poradniku testy nieparametryczne krok po kroku.
Wielkość efektu i opis metody
Każdy wynik testu uzupełnij miarą wielkości efektu i jej przedziałem ufności. Tabela zbiera miary z pięciu projektów.
| Analiza | Wielkość efektu | Przykład zapisu |
|---|---|---|
| ANOVA dwuczynnikowa | η²p, d dla efektów prostych | F(1, 156) = 5.27, p = .023, η²p = .03 |
| Chi-kwadrat 2 × 2 | różnica ryzyka, RR | χ²(1) = 17.95, p < .001, RR = 1.57, 95% CI [1.22, 2.00] |
| Regresja logistyczna | OR z 95% CI | OR = 2.92, 95% CI [1.59, 5.38], p = .001 |
| Kaplan–Meier i model Coxa | odsetek w danym tygodniu, HR | χ²(1) = 20.4, p < .001, HR = 0.37, 95% CI [0.24, 0.58] |
| Test Manna–Whitneya | korelacja rangowo-dwuseryjna | W = 3347, p = .036, r = .19, 95% CI [.01, .35] |
| Test Kruskala–Wallisa | ε² | χ²(2) = 28.10, p < .001, ε² = .19 |
Większość prac z położnictwa to badania obserwacyjne, więc w części metodologicznej przyda się lista STROBE. Ma 22 punkty dotyczące m.in. opisu uczestników, zmiennych, źródeł danych i metod statystycznych (von Elm i in., 2007). Szczególnie ważne są w położnictwie trzy punkty: kryteria włączenia (np. tydzień ciąży, ciąża pojedyncza), liczba kobiet zaproszonych, odmawiających i utraconych z obserwacji oraz definicja każdego wyniku.
Jeśli nie wiesz, którą analizę wybrać do swojego projektu albo jak odpowiedzieć na uwagi promotora, możesz skonsultować to ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Trzy przepisy odtwarzają wszystkie liczby z tego wpisu, a osobny skrypt b69-rysunki.R – rysunki. Każdy przepis tworzy własne dane symulowane, więc możesz go uruchomić osobno. Ostatni przepis zapisuje też plik XLSX do pobrania. ANOVA typu III liczy pakiet car, efekty proste – emmeans, analizę przeżycia – survival, a test Dunna – PMCMRplus.
1. Projekt 1: wiedza ciężarnych – ANOVA 2 × 2 i efekty proste
R
# Projekt 1: wiedza ciężarnych o porodzie i połogu a szkoła rodzenia i parzystość (dane symulowane).
# 160 ciężarnych w III trymestrze; autorski test wiedzy 0–25 pkt; udział w szkole rodzenia (tak/nie);
# parzystość (pierwiastka / wieloródka). Schemat 2 × 2 z nierównymi liczebnościami.
suppressPackageStartupMessages({ library(car); library(emmeans); library(effectsize) })
set.seed(6901)
n <- 160
parzystosc <- factor(sample(c("pierwiastka", "wieloródka"), n, TRUE, prob = c(.55, .45)), levels = c("pierwiastka", "wieloródka"))
szkola <- factor(ifelse(runif(n) < ifelse(parzystosc == "pierwiastka", .55, .25), "tak", "nie"), levels = c("nie", "tak"))
wiek <- round(pmin(44, pmax(19, rnorm(n, 30, 4.5))))
lp <- 13 + 3.5 * (parzystosc == "wieloródka") + 3.8 * (szkola == "tak") - 3.0 * (szkola == "tak") * (parzystosc == "wieloródka")
wiedza <- pmin(25, pmax(0, round(lp + rnorm(n, 0, 3.6))))
p1 <- data.frame(id = 1:n, wiek, parzystosc, szkola_rodzenia = szkola, wiedza)

round(c(M = mean(p1$wiedza), SD = sd(p1$wiedza), Me = median(p1$wiedza)), 2)
opis <- aggregate(wiedza ~ parzystosc + szkola_rodzenia, p1, function(x) c(n = length(x), M = mean(x), SD = sd(x)))
do.call(data.frame, opis) |> transform(wiedza.M = round(wiedza.M, 2), wiedza.SD = round(wiedza.SD, 2))
# ANOVA dwuczynnikowa (typ III, kontrasty sumujące się do zera – nierówne liczebności)
options(contrasts = c("contr.sum", "contr.poly"))
m1 <- lm(wiedza ~ szkola_rodzenia * parzystosc, data = p1)
a1 <- Anova(m1, type = 3); suppressMessages(print(a1))
suppressMessages(eta_squared(a1, partial = TRUE, ci = .95, alternative = "two.sided")) |> as.data.frame() |> (\(d) cbind(d[1], round(d[, c(2, 4, 5)], 3)))()
# Efekty proste: szkoła rodzenia osobno u pierwiastek i wieloródek
em <- emmeans(m1, ~ szkola_rodzenia | parzystosc)
summary(contrast(em, "revpairwise"), infer = TRUE) |> as.data.frame() |> (\(d) cbind(d[1:2], round(d[3:9], 3)))()
s <- sigma(m1); round(c(sigma = s, d_pierw = summary(contrast(em, "revpairwise"))$estimate[1] / s,
                        d_wielo = summary(contrast(em, "revpairwise"))$estimate[2] / s), 2)
options(contrasts = c("contr.treatment", "contr.poly"))
Wynik w R
    M    SD    Me
15.56  3.74 16.00
   parzystosc szkola_rodzenia wiedza.n wiedza.M wiedza.SD
1 pierwiastka             nie       39    13.28      4.03
2  wieloródka             nie       61    16.41      3.26
3 pierwiastka             tak       47    16.15      3.56
4  wieloródka             tak       13    16.23      3.17
Anova Table (Type III tests)

Response: wiedza
                            Sum Sq  Df   F value  Pr(>F)
(Intercept)                27474.6   1 2187.9664 < 2e-16 ***
szkola_rodzenia               51.5   1    4.1026 0.04452 *
parzystosc                    73.5   1    5.8501 0.01673 *
szkola_rodzenia:parzystosc    66.2   1    5.2687 0.02304 *
Residuals                   1958.9 156
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                   Parameter Eta2_partial CI_low CI_high
1            szkola_rodzenia        0.026  0.000   0.093
2                 parzystosc        0.036  0.001   0.110
3 szkola_rodzenia:parzystosc        0.033  0.000   0.105
   contrast  parzystosc estimate    SE  df lower.CL upper.CL t.ratio p.value
1 tak - nie pierwiastka    2.867 0.768 156    1.351    4.383   3.735   0.000
2 tak - nie  wieloródka   -0.179 1.082 156   -2.317    1.959  -0.165   0.869
  sigma d_pierw d_wielo
   3.54    0.81   -0.05
2. Projekty 2 i 3: karmienie piersią – RR, OR, regresja logistyczna i Kaplan–Meier
R
# Projekty 2 i 3: karmienie piersią w kohorcie położnic (dane symulowane).
# 240 położnic jednego szpitala; kontakt „skóra do skóry” w pierwszej godzinie (tak/nie), rodzaj porodu,
# parzystość; wynik 1: wyłączne karmienie piersią przy wypisie; wynik 2: czas do zakończenia karmienia piersią
# (tygodnie, obserwacja do 26. tygodnia, część kobiet utracona z obserwacji = obserwacje cenzurowane).
suppressPackageStartupMessages({ library(survival) })
set.seed(6902)
n <- 240
skora <- factor(ifelse(runif(n) < .62, "tak", "nie"), levels = c("nie", "tak"))
porod <- factor(ifelse(runif(n) < ifelse(skora == "tak", .25, .55), "cięcie cesarskie", "siłami natury"),
                levels = c("siłami natury", "cięcie cesarskie"))
pierwiastka <- factor(ifelse(runif(n) < .48, "tak", "nie"), levels = c("nie", "tak"))
lin <- 0.35 + 1.05 * (skora == "tak") - 0.55 * (porod == "cięcie cesarskie") - 0.35 * (pierwiastka == "tak")
wylaczne <- rbinom(n, 1, plogis(lin))
p2 <- data.frame(id = 1:n, skora_do_skory = skora, porod, pierwiastka, wylaczne_wypis = wylaczne)

# Projekt 2: tabela 2 × 2, chi-kwadrat, RR, OR i różnica ryzyka
tab <- table(skora = p2$skora_do_skory, wylaczne = factor(p2$wylaczne_wypis, 0:1, c("nie", "tak"))); tab
round(100 * prop.table(tab, 1), 1)
chisq.test(tab, correct = FALSE)
a <- tab["tak", "tak"]; b <- tab["tak", "nie"]; c <- tab["nie", "tak"]; d <- tab["nie", "nie"]
p_t <- a / (a + b); p_n <- c / (c + d)
RR <- p_t / p_n; se_lrr <- sqrt(1 / a - 1 / (a + b) + 1 / c - 1 / (c + d))
OR <- (a * d) / (b * c); se_lor <- sqrt(1 / a + 1 / b + 1 / c + 1 / d)
RD <- p_t - p_n; se_rd <- sqrt(p_t * (1 - p_t) / (a + b) + p_n * (1 - p_n) / (c + d))
round(rbind(RR = c(RR, exp(log(RR) + c(-1, 1) * 1.96 * se_lrr)),
            OR = c(OR, exp(log(OR) + c(-1, 1) * 1.96 * se_lor)),
            RD_proc = 100 * c(RD, RD + c(-1, 1) * 1.96 * se_rd)), 2)
# Regresja logistyczna: skorygowany OR (zdarzenia na zmienną: liczba rzadszego wyniku / liczba predyktorów)
m2 <- glm(wylaczne_wypis ~ skora_do_skory + porod + pierwiastka, family = binomial, data = p2)
round(cbind(OR = exp(coef(m2)), exp(confint.default(m2)), p = summary(m2)$coefficients[, 4]), 3)
c(zdarzenia_rzadsze = min(sum(p2$wylaczne_wypis), sum(1 - p2$wylaczne_wypis)), predyktory = 3,
  EPV = round(min(sum(p2$wylaczne_wypis), sum(1 - p2$wylaczne_wypis)) / 3, 1))
# Skorygowane ryzyko względne: model Poissona z odpornymi błędami standardowymi (sandwich)
m2p <- glm(wylaczne_wypis ~ skora_do_skory + porod + pierwiastka, family = poisson, data = p2)
se_r <- sqrt(diag(sandwich::vcovHC(m2p, type = "HC0")))
round(exp(cbind(RR = coef(m2p), lo = coef(m2p) - 1.96 * se_r, hi = coef(m2p) + 1.96 * se_r))[2, ], 2)

# Projekt 3: czas karmienia piersią – Kaplan–Meier, log-rank i model Coxa
set.seed(6903)
hazard <- 0.030 * exp(-0.75 * p2$wylaczne_wypis)
t_zak <- rexp(n, hazard)                                  # tygodnie do zakończenia karmienia
t_utr <- ifelse(runif(n) < .14, runif(n, 2, 26), Inf)      # utrata z obserwacji
p2$tydzien <- round(pmin(t_zak, t_utr, 26), 1)
p2$zakonczenie <- as.integer(t_zak <= pmin(t_utr, 26))
p2$wylaczne_f <- factor(p2$wylaczne_wypis, 0:1, c("nie", "tak"))
c(zdarzenia = sum(p2$zakonczenie), cenzurowane = sum(p2$zakonczenie == 0),
  utracone = sum(p2$zakonczenie == 0 & p2$tydzien < 26))
km <- survfit(Surv(tydzien, zakonczenie) ~ wylaczne_f, data = p2); print(km)
sk <- summary(km, times = c(12, 26)); round(data.frame(grupa = sk$strata, t = sk$time, S = sk$surv, lo = sk$lower, hi = sk$upper)[, -1], 3) |> cbind(grupa = sk$strata)
survdiff(Surv(tydzien, zakonczenie) ~ wylaczne_f, data = p2)
cx <- coxph(Surv(tydzien, zakonczenie) ~ wylaczne_f, data = p2)
round(c(HR = exp(coef(cx)), exp(confint(cx)), p = summary(cx)$coefficients[, 5]), 3)
cox.zph(cx)
Wynik w R
     wylaczne
skora nie tak
  nie  39  37
  tak  39 125
     wylaczne
skora  nie  tak
  nie 51.3 48.7
  tak 23.8 76.2

	Pearson's Chi-squared test

data:  tab
X-squared = 17.949, df = 1, p-value = 2.269e-05

         [,1]  [,2]  [,3]
RR       1.57  1.22  2.00
OR       3.38  1.90  6.01
RD_proc 27.54 14.55 40.53
                         OR 2.5 % 97.5 %     p
(Intercept)           1.946 1.022  3.706 0.043
skora_do_skorytak     2.924 1.588  5.384 0.001
porodcięcie cesarskie 0.555 0.302  1.020 0.058
pierwiastkatak        0.455 0.255  0.813 0.008
zdarzenia_rzadsze        predyktory               EPV
               78                 3                26
  RR   lo   hi
1.47 1.16 1.87
  zdarzenia cenzurowane    utracone
         78         162          30
Call: survfit(formula = Surv(tydzien, zakonczenie) ~ wylaczne_f, data = p2)

                 n events median 0.95LCL 0.95UCL
wylaczne_f=nie  78     39   21.5    18.1      NA
wylaczne_f=tak 162     39     NA      NA      NA
   t     S    lo    hi          grupa
1 12 0.739 0.646 0.844 wylaczne_f=nie
2 26 0.466 0.363 0.597 wylaczne_f=nie
3 12 0.879 0.830 0.932 wylaczne_f=tak
4 26 0.742 0.675 0.815 wylaczne_f=tak
Call:
survdiff(formula = Surv(tydzien, zakonczenie) ~ wylaczne_f, data = p2)

                 N Observed Expected (O-E)^2/E (O-E)^2/V
wylaczne_f=nie  78       39     21.3     14.76      20.4
wylaczne_f=tak 162       39     56.7      5.54      20.4

 Chisq= 20.4  on 1 degrees of freedom, p= 6e-06
HR.wylaczne_ftak                                                  p
           0.373            0.239            0.582            0.000
           chisq df    p
wylaczne_f  1.14  1 0.29
GLOBAL      1.14  1 0.29
3. Projekty 4 i 5: skala po porodzie i ból w trzech grupach; plik do pobrania
R
# Projekty 4 i 5: skala przesiewowa objawów depresyjnych po porodzie i ból po porodzie (dane symulowane).
# Projekt 4: 196 kobiet z kohorty z projektu 2 odpowiedziało 6–8 tygodni po porodzie; symulowana skala
# 10 pozycji 0–3 (wynik 0–30, wyższy = więcej objawów) i wsparcie partnera (średnia 1–5). Narzędzie opisane ogólnie.
# Projekt 5: 150 położnic w 1. dobie: ból w skali NRS 0–10 według rodzaju porodu (trzy grupy).
suppressPackageStartupMessages({ library(psych); library(effectsize); library(PMCMRplus); library(openxlsx) })
set.seed(6904)
n4 <- 196
porod4 <- factor(ifelse(runif(n4) < .36, "cięcie cesarskie", "siłami natury"), levels = c("siłami natury", "cięcie cesarskie"))
wsparcie <- round(pmin(5, pmax(1, rnorm(n4, 3.9, .7))) * 4) / 4
cecha <- rnorm(n4, -0.45 * (wsparcie - 3.9) + 0.25 * (porod4 == "cięcie cesarskie"), 1)
poz <- sapply(1:10, function(j) findInterval(0.75 * cecha + rnorm(n4, 0, .75), c(0.1, 1.0, 1.9)))
p4 <- data.frame(id = 1:n4, porod = porod4, wsparcie_partnera = wsparcie, poz)
names(p4)[4:13] <- sprintf("e%02d", 1:10)
p4$wynik <- rowSums(poz)
round(c(M = mean(p4$wynik), SD = sd(p4$wynik), Me = median(p4$wynik), Q1 = unname(quantile(p4$wynik, .25)),
        Q3 = unname(quantile(p4$wynik, .75)), skosnosc = psych::skew(p4$wynik)), 2)
round(c(alfa = psych::alpha(poz, warnings = FALSE)$total$raw_alpha,
        omega = suppressWarnings(psych::omega(poz, nfactors = 1, plot = FALSE))$omega.tot), 2)
round(tapply(p4$wynik, p4$porod, function(x) c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                                              Q3 = unname(quantile(x, .75)))) |> simplify2array() |> t(), 2)
wilcox.test(wynik ~ porod, data = p4, exact = FALSE)
round(unlist(as.data.frame(rank_biserial(wynik ~ porod, data = p4))[, c(1, 3, 4)]), 2)
cor.test(p4$wynik, p4$wsparcie_partnera, method = "spearman", exact = FALSE)

# Projekt 5: ból w 1. dobie po porodzie (NRS 0–10) w trzech grupach
set.seed(6905)
grupa <- factor(rep(c("SN bez nacięcia", "SN z nacięciem krocza", "cięcie cesarskie"), c(60, 45, 45)),
                levels = c("SN bez nacięcia", "SN z nacięciem krocza", "cięcie cesarskie"))
bol <- pmin(10, pmax(0, round(c(3.0, 4.1, 4.9)[as.integer(grupa)] + rnorm(150, 0, 1.7))))
p5 <- data.frame(id = 1:150, grupa, bol_NRS = bol)
round(tapply(p5$bol_NRS, p5$grupa, function(x) c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                                                Q3 = unname(quantile(x, .75)), M = mean(x))) |> simplify2array() |> t(), 2)
kruskal.test(bol_NRS ~ grupa, data = p5)
round(unlist(as.data.frame(rank_epsilon_squared(bol_NRS ~ grupa, data = p5))[, c(1, 3, 4)]), 2)
dn <- kwAllPairsDunnTest(bol_NRS ~ grupa, data = p5, p.adjust.method = "holm"); summary(dn)

# Plik do pobrania: dane pięciu projektów (autor w metadanych: Metodolog.pl)
e1 <- new.env(); e2 <- new.env()
invisible(capture.output(suppressMessages({ source("b69-1-wiedza-ciezarnych.R", local = e1); source("b69-2-karmienie-piersia.R", local = e2) })))
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z położnictwa – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
ark <- list("1_wiedza_ciezarnych" = e1$p1,
            "2_3_karmienie_piersia" = e2$p2[, c("id", "skora_do_skory", "porod", "pierwiastka", "wylaczne_wypis", "tydzien", "zakonczenie")],
            "4_skala_po_porodzie" = p4, "5_bol_po_porodzie" = p5)
for (nm in names(ark)) { addWorksheet(wb, nm); writeData(wb, nm, ark[[nm]]); freezePane(wb, nm, firstRow = TRUE) }
addWorksheet(wb, "opis")
writeData(wb, "opis", c("Dane symulowane (R, set.seed 6901–6905) – metodolog.pl, wpis „Statystyka w pracy z położnictwa”.",
                       "1_wiedza_ciezarnych: wiedza = wynik autorskiego testu 0–25; szkola_rodzenia i parzystosc = czynniki schematu 2 × 2.",
                       "2_3_karmienie_piersia: wylaczne_wypis = 1, gdy wyłączne karmienie piersią przy wypisie; tydzien = czas obserwacji (tyg.);",
                       "   zakonczenie = 1, gdy karmienie piersią zakończono w czasie obserwacji, 0 = obserwacja cenzurowana.",
                       "4_skala_po_porodzie: e01–e10 = pozycje symulowanej skali 0–3; wynik = suma 0–30; wsparcie_partnera = średnia 1–5.",
                       "5_bol_po_porodzie: bol_NRS = natężenie bólu w 1. dobie (0–10); grupa = rodzaj porodu."))
saveWorkbook(wb, "../statystyka-poloznictwo-dane-przyklad.xlsx", overwrite = TRUE)
spr <- readxl::excel_sheets("../statystyka-poloznictwo-dane-przyklad.xlsx"); spr
sapply(spr[1:4], function(a) nrow(readxl::read_excel("../statystyka-poloznictwo-dane-przyklad.xlsx", sheet = a)))
Wynik w R
       M       SD       Me       Q1       Q3 skosnosc
    7.34     6.50     6.00     2.00    11.00     0.93
Loading required namespace: GPArotation
Omega_h for 1 factor is not meaningful, just omega_t
 alfa omega
  0.9   0.9
                   n Me Q1   Q3
siłami natury    135  5  2 10.5
cięcie cesarskie  61  8  3 15.0

	Wilcoxon rank sum test with continuity correction

data:  wynik by porod
W = 3347, p-value = 0.03576
alternative hypothesis: true location shift is not equal to 0

r_rank_biserial          CI_low         CI_high
          -0.19           -0.35           -0.01

	Spearman's rank correlation rho

data:  p4$wynik and p4$wsparcie_partnera
S = 1474784, p-value = 0.01403
alternative hypothesis: true rho is not equal to 0
sample estimates:
     rho
-0.17523

                       n Me Q1 Q3    M
SN bez nacięcia       60  3  2  4 3.10
SN z nacięciem krocza 45  4  3  5 4.38
cięcie cesarskie      45  5  4  6 5.00

	Kruskal-Wallis rank sum test

data:  bol_NRS by grupa
Kruskal-Wallis chi-squared = 28.103, df = 2, p-value = 7.899e-07

rank_epsilon_squared               CI_low              CI_high
                0.19                 0.11                 1.00

	Pairwise comparisons using Dunn's all-pairs test

data: bol_NRS by grupa
alternative hypothesis: two.sided
P value adjustment method: holm
H0
                                              z value  Pr(>|z|)
SN z nacięciem krocza - SN bez nacięcia == 0    3.245  0.002349  **
cięcie cesarskie - SN bez nacięcia == 0         5.178 6.721e-07 ***
cięcie cesarskie - SN z nacięciem krocza == 0   1.808  0.070554   .
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] "1_wiedza_ciezarnych"   "2_3_karmienie_piersia" "4_skala_po_porodzie"   "5_bol_po_porodzie"
[5] "opis"
  1_wiedza_ciezarnych 2_3_karmienie_piersia   4_skala_po_porodzie     5_bol_po_porodzie
                  160                   240                   196                   150
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), chisq.test(), glm(), wilcox.test(), cor.test() i kruskal.test() z pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- survival (wersja 3.8-6): Therneau, T. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended [R package]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizach prac z położnictwa
- Brak definicji karmienia piersią albo pytanie bez okresu odniesienia. Wynik „karmi piersią” nie mówi wtedy, czy karmienie jest wyłączne, czy częściowe.
- Iloraz szans czytany jako „ile razy częściej” przy wyniku, który dotyczy połowy lub większości kobiet. Podaj obok OR także różnicę ryzyka albo RR.
- Średni czas karmienia liczony bez obserwacji cenzurowanych. Usunięcie kobiet, które nadal karmią albo nie odpowiedziały, zaniża czas karmienia. Użyj metody Kaplana–Meiera.
- Porównanie „szkoła rodzenia tak/nie” bez uwzględnienia parzystości i wniosek przyczynowy z badania, w którym kobiety same wybrały udział w zajęciach.
- Próg skali przesiewowej z nieznanego źródła i opis wyniku powyżej progu jako rozpoznania.
- Kilkanaście predyktorów w regresji logistycznej przy kilkudziesięciu zdarzeniach. Policz EPV, zanim zbudujesz model.
- Kilkadziesiąt testów „wszystko ze wszystkim” na zmiennych z metryczki zamiast kilku hipotez zapisanych przed analizą.
- Brak opisu utraty uczestniczek między wypisem a kolejnymi kontaktami. Podaj, ile kobiet odpowiedziało w każdym punkcie pomiaru.
Najczęstsze pytania
Jakie testy statystyczne wybrać do pracy licencjackiej z położnictwa?
To zależy od pytania i rodzaju wyniku. Wynik testu wiedzy w kilku grupach porównasz analizą wariancji (z interakcją, gdy grupy wyznaczają dwa czynniki), wynik tak/nie – testem chi-kwadrat i regresją logistyczną, czas do zakończenia karmienia piersią – metodą Kaplana–Meiera i testem log-rank, a skośne wyniki skal i ocenę bólu – testami Manna–Whitneya albo Kruskala–Wallisa. Do każdego testu dołącz wielkość efektu.
Jak policzyć, ile tygodni matki karmią piersią, gdy część nie odpowiedziała na ankietę?
Nie licz średniej tylko z kobiet, które zakończyły karmienie, i nie usuwaj tych, z którymi urwał się kontakt. Potraktuj je jako obserwacje cenzurowane i użyj krzywej Kaplana–Meiera: poda ona odsetek kobiet nadal karmiących w wybranym tygodniu i medianę czasu karmienia, jeśli zostanie osiągnięta. Grupy porównaj testem log-rank, a wielkość różnicy podaj jako iloraz hazardów z modelu Coxa.
Czy iloraz szans 3 oznacza, że karmienie piersią jest trzy razy częstsze?
Nie. Iloraz szans to stosunek szans, a nie prawdopodobieństw. Przy częstym wyniku, takim jak karmienie piersią przy wypisie, jest wyraźnie większy od ryzyka względnego: w przykładzie z tego wpisu OR wynosi 3.38, a RR tylko 1.57. Obok OR podaj ryzyko względne albo różnicę odsetków.
Jak opisać w pracy wynik skali depresji poporodowej?
Policz wynik i zastosuj próg według publikacji autorów albo walidacji wersji, której używasz, i zacytuj to źródło. Wynik powyżej progu opisz jako wynik przesiewowy wskazujący na nasilone objawy, a nie jako rozpoznanie depresji. Testy licz na wyniku punktowym, podaj medianę i kwartyle przy skośnym rozkładzie oraz rzetelność skali w swojej próbie.
Czy porównanie wiedzy kobiet po szkole rodzenia i bez niej dowodzi jej skuteczności?
Nie, bo kobiety same decydują o udziale w zajęciach i mogą różnić się np. wykształceniem, motywacją albo doświadczeniem poprzednich porodów. Uwzględnij przynajmniej parzystość w analizie wariancji z interakcją, a wnioski formułuj jako związek, np. wyższą wiedzę u pierwiastek uczestniczących w zajęciach.
Powiązane hasła
Przeczytaj też
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →Piszesz pracę z położnictwa i nie wiesz, jak przeanalizować dane?
Pomożemy dobrać analizy do Twojego projektu, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiała samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Royston, P. (2006). The cost of dichotomising continuous variables. BMJ, 332(7549), 1080. https://doi.org/10.1136/bmj.332.7549.1080 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Bland, J. M., & Altman, D. G. (2004). The logrank test. BMJ, 328(7447), 1073. https://doi.org/10.1136/bmj.328.7447.1073 ● Otwarty dostęp
- Clark, T. G., Bradburn, M. J., Love, S. B., & Altman, D. G. (2003). Survival analysis part I: Basic concepts and first analyses. British Journal of Cancer, 89(2), 232–238. https://doi.org/10.1038/sj.bjc.6601118 ● Otwarty dostęp
- Cox, J. L., Holden, J. M., & Sagovsky, R. (1987). Detection of postnatal depression: Development of the 10-item Edinburgh Postnatal Depression Scale. British Journal of Psychiatry, 150(6), 782–786. https://doi.org/10.1192/bjp.150.6.782
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- Labbok, M., & Krasovec, K. (1990). Toward consistency in breastfeeding definitions. Studies in Family Planning, 21(4), 226–230. https://doi.org/10.2307/1966617
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/s0895-4356(96)00236-3 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2006cost, author={Altman, Douglas G. and Royston, Patrick}, title={{The cost of dichotomising continuous variables}}, journal={BMJ}, year={2006}, volume={332}, number={7549}, pages={1080}, doi={10.1136/bmj.332.7549.1080}}@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{bland2004logrank, author={Bland, J. Martin and Altman, Douglas G.}, title={{The logrank test}}, journal={BMJ}, year={2004}, volume={328}, number={7447}, pages={1073}, doi={10.1136/bmj.328.7447.1073}}@article{clark2003survival, author={Clark, T. G. and Bradburn, M. J. and Love, S. B. and Altman, D. G.}, title={{Survival analysis part I: Basic concepts and first analyses}}, journal={British Journal of Cancer}, year={2003}, volume={89}, number={2}, pages={232--238}, doi={10.1038/sj.bjc.6601118}}@article{cox1987detection, author={Cox, J. L. and Holden, J. M. and Sagovsky, R.}, title={{Detection of postnatal depression: Development of the 10-item Edinburgh Postnatal Depression Scale}}, journal={British Journal of Psychiatry}, year={1987}, volume={150}, number={6}, pages={782--786}, doi={10.1192/bjp.150.6.782}}@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@article{labbok1990toward, author={Labbok, Miriam and Krasovec, Katherine}, title={{Toward consistency in breastfeeding definitions}}, journal={Studies in Family Planning}, year={1990}, volume={21}, number={4}, pages={226--230}, doi={10.2307/1966617}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{peduzzi1996simulation, author={Peduzzi, Peter and Concato, John and Kemper, Elizabeth and Holford, Theodore R. and Feinstein, Alvan R.}, title={{A simulation study of the number of events per variable in logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={1996}, volume={49}, number={12}, pages={1373--1379}, doi={10.1016/s0895-4356(96)00236-3}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}