Jeden szpital, cała kadra na liście
Ankieta wśród pielęgniarek, położnych albo ratowników z jednego szpitala to jeden z najczęstszych projektów w pracach z pielęgniarstwa i zarządzania w ochronie zdrowia. Ma jedną cechę, której nie ma ankieta w mediach społecznościowych: znasz populację. Dział kadr wie, ile osób pracuje na każdym oddziale i jaki mają staż. Z tego wynikają cztery pytania, których nie zadaje się przy zwykłej ankiecie: czy zbadałeś(-aś) próbę, czy całą populację; czy przy badaniu wszystkich w ogóle liczyć testy; jak uwzględnić w przedziale ufności to, że odpowiedziało 43% z zaledwie 420 osób; jak pokazać wyniki małego oddziału, nie ujawniając, kto co odpowiedział.
Ten wpis odpowiada na te pytania. Nie powtarza ogólnych zasad opisu próby – te są w poradnikach jak opisać charakterystykę próby i tabela 1 – charakterystyka próby. Typowe projekty z tej dziedziny zebraliśmy w przeglądzie statystyka w pracy z pielęgniarstwa.
Przykład przewodni (wymyślony, dane symulowane). Szpital zatrudnia 420 pielęgniarek na siedmiu oddziałach. Studentka wysyła ankietę do wszystkich i dostaje 180 odpowiedzi (42.9%). Pyta m.in., czy respondentka rozważa odejście z pracy w ciągu roku (tak/nie), i mierzy zadowolenie z pracy skalą 1–5 (średnia z pięciu pozycji). Dział kadr udostępnił liczebności według oddziału i stażu – bez danych osobowych. Ponieważ dane są symulowane, znamy też prawdziwe wartości w całej kadrze: odejście rozważa 29.5% pielęgniarek, a średnie zadowolenie wynosi 3.27. W prawdziwym badaniu tych liczb nie znasz – przykład pokazuje, jak daleko od nich mogą być wyniki ankiety.
Populacja czy próba: kogo naprawdę badasz?
Zacznij od precyzyjnej definicji populacji: „pielęgniarki i pielęgniarze zatrudnieni w szpitalu na stanowiskach pielęgniarskich w dniu rozesłania ankiety, z wyłączeniem osób na urlopach długoterminowych”. Lista z działu kadr pełni rolę operatu: wiesz, kogo zaprosić i ilu jest uprawnionych. Taki operat to rzadki luksus – wykorzystaj go.
W praktyce spotkasz trzy sytuacje, a każda wymaga innego opisu:
| Sytuacja | Jak ją nazwać w pracy | Co z niepewnością |
|---|---|---|
| Zaproszono wszystkich, odpowiedzieli niemal wszyscy | Badanie pełne (całej populacji) | Wyniki opisują kadrę; testy zależą od przyjętego stanowiska (następna sekcja) |
| Wylosowano część osób z listy i prawie wszyscy odpowiedzieli | Dobór losowy prosty (lub warstwowy według oddziałów) | Przedział ufności z poprawką na skończoną populację |
| Zaproszono wszystkich, odpowiedziała część (np. 43%) | Badanie pełne z brakiem odpowiedzi | Przedział z poprawką opisuje tylko błąd losowy przy założeniu, że respondenci są podobni do reszty; główne ryzyko to błąd braku odpowiedzi |
Najczęstsza jest sytuacja trzecia. Nie nazywaj jej „próbą losową” ani „próbą reprezentatywną”. To populacja, z której wybrała się sama część osób – i od tego, kto się wybrał, zależy więcej niż od liczby respondentów.
Badanie całej kadry: czy liczyć testy i przedziały ufności?
Załóżmy, że odpowiedziały wszystkie 420 osoby. W symulowanej kadrze odejście rozważa 44.4% pielęgniarek OIT i 27.8% pielęgniarek interny. Czy test χ² jest potrzebny? Promotorzy i recenzenci odpowiadają różnie, bo za każdą odpowiedzią stoi inne rozumienie celu badania. Berk, Western i Weiss (1995) zwrócili uwagę, że wnioskowanie statystyczne często stosuje się do danych, które nie są próbą w zwykłym sensie – obejmują wszystko, co istnieje. Taki komplet jednostek nazwali populacją pozorną (ang. apparent population).
Stanowisko opisowe. Interesuje Cię ta kadra, w tym szpitalu, w tym miesiącu. Zbadałeś(-aś) wszystkich, więc 44.4% i 27.8% to wartości w populacji, a nie oszacowania. Różnica 16.6 punktu procentowego po prostu istnieje. Przedział ufności dla odsetka w kadrze ma szerokość zero – to widać we wzorze z poprawką w dalszej części wpisu. Test istotności nie ma tu czego testować. Raportujesz liczebności, odsetki i różnice oraz oceniasz, czy są duże z praktycznego punktu widzenia.
Stanowisko modelowe. Interesuje Cię proces, który wytwarza dane, np. „czy krótki staż wiąże się z myśleniem o odejściu”. Obecna kadra jest jedną z możliwych realizacji tego procesu: za rok część osób odejdzie, przyjdą nowe, a odpowiedzi tych samych osób zmieniłyby się z miesiąca na miesiąc. Różnica 16.6 punktu przy 45 i 90 osobach na oddział może być przypadkowa w tym sensie, że ten sam proces dałby inną różnicę. Wtedy liczysz zwykłe testy i przedziały – bez poprawki na skończoną populację, bo wnioskujesz o procesie, a nie o 420 osobach.
Oba stanowiska są do obrony. Błędem jest ich mieszanie: najpierw piszesz, że zbadałeś(-aś) całą populację, a potem traktujesz wartość p jako dowód, że „różnica występuje w populacji”. Wybierz stanowisko, zapisz je w metodzie jednym zdaniem i trzymaj się go w wynikach. W pracy dyplomowej praktyczny kompromis wygląda tak: pytania opisowe („jaki odsetek kadry…”) raportujesz jako wartości w kadrze, a hipotezy o związkach („staż a intencja odejścia”) testujesz w podejściu modelowym, z zastrzeżeniem, że wnioski dotyczą szpitali podobnych do badanego.
Odsetek odpowiedzi i porównanie z kadrą
Przy znanej kadrze możesz policzyć wskaźnik odpowiedzi nie tylko dla całego szpitala, ale też dla każdego oddziału. To pierwsza tabela, którą warto pokazać promotorowi. W przykładzie odpowiedziało 42.9% kadry, ale na pediatrii 56.0%, a na OIT tylko 17.8% (8 z 45 osób) – rysunek 1.
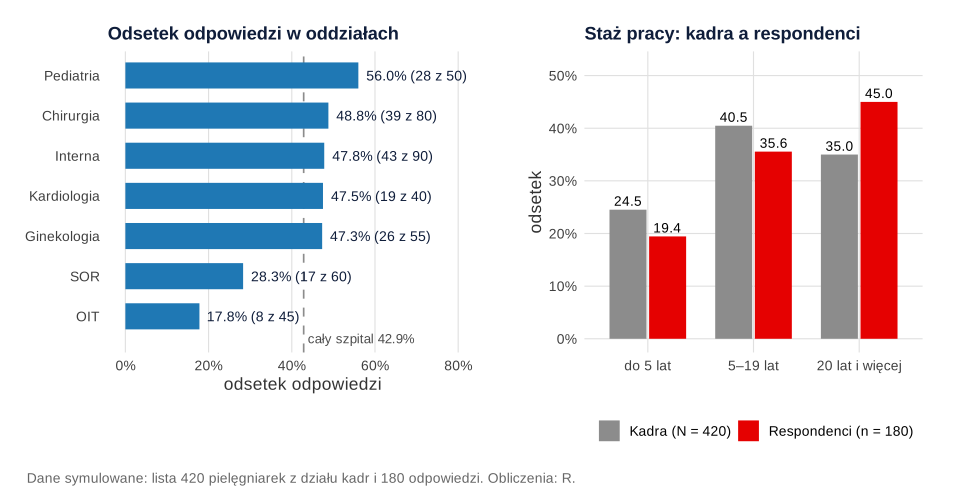
Porównanie struktury respondentów z kadrą pokazuje, kogo brakuje. Osoby ze stażem 20 lat i więcej stanowiły 35.0% kadry, ale 45.0% respondentów; OIT to 10.7% kadry i tylko 4.4% respondentów. Sposób takiego porównania – odsetki obok siebie, różnice w punktach procentowych, ostrożnie z testem zgodności – opisuje poradnik o charakterystyce próby. Tutaj ważniejsze jest, co z tego wynika dla wyników.
Sam niski odsetek odpowiedzi nie przesądza o obciążeniu. Groves (2006) pokazał, że brak odpowiedzi może, ale nie musi, obciążać wyniki, a metaanaliza Grovesa i Peytchevej (2008) sprawdzała, w jakich warunkach odsetek braku odpowiedzi wiąże się z obciążeniem, a w jakich nie. Problem pojawia się wtedy, gdy decyzja o udziale zależy od mierzonej cechy. W symulacji osoby myślące o odejściu odpowiadały rzadziej (29.8% wobec 48.3% pozostałych). Wśród respondentów odejście rozważało więc 20.6% osób, a w całej kadrze 29.5% – ankieta zaniżyła wynik o 8.9 punktu procentowego. Średnie zadowolenie respondentów (3.41) było wyższe niż w kadrze (3.27).
Czy 43% to mało? W metaanalizie badań ankietowych wśród pracowników ochrony zdrowia Cho, Johnson i VanGeest (2013) oszacowali średni odsetek odpowiedzi na .53, z wyraźnym trendem spadkowym. Wyższy odsetek wiązał się z ankietą pocztową zamiast internetowej, z zachętami pieniężnymi i z jednym–dwoma przypomnieniami. W szpitalu oznacza to przede wszystkim: zaplanuj przypomnienia i dotrzyj do oddziałów pracujących w systemie zmianowym (wersja papierowa z zamykaną urną bywa skuteczniejsza niż sam link). Jak opisać same wskaźniki i ich mianowniki, pokazuje hasło o wskaźniku odpowiedzi.
Ważenie do struktury kadry – krótko
Skoro znasz strukturę kadry według oddziału i stażu, możesz nadać respondentom wagi, tak żeby ważona próba miała tę samą strukturę. W przykładzie użyto rakingu na dwóch zmiennych. Wagi wahały się od 1.45 do 6.62 (największe dostały osoby z OIT), a efekt ważenia Kisha wyniósł 1.18. Po ważeniu odsetek rozważających odejście wzrósł z 20.6% do 23.6%, 95% CI [18.6%, 28.6%].
To bliżej prawdziwych 29.5%, ale nadal za mało – przedział nawet nie obejmuje wartości w kadrze. Wagi wyrównały oddziały i staż, ale nie mogły naprawić tego, że w obrębie każdego oddziału i grupy stażu rzadziej odpowiadały osoby myślące o odejściu. To ogólna zasada: ważenie koryguje tylko te różnice, które przechodzą przez zmienne użyte do ważenia. Pełną procedurę opisuje wpis ważenie danych sondażowych krok po kroku. W pracy dyplomowej zwykle wystarczy porównanie z kadrą, wynik nieważony jako główny i ważony jako analiza wrażliwości.
Poprawka na skończoną populację (FPC)
Klasyczny wzór na błąd standardowy zakłada, że próba to znikomy ułamek ogromnej populacji. Gdy odpowiada 180 z 420 osób, to założenie nie pasuje: zbadałeś(-aś) 42.9% kadry, więc o pozostałych wiesz więcej, niż sugeruje wzór. Uwzględnia to poprawka na skończoną populację (ang. finite population correction, FPC), opisana w podręcznikach metod doboru próby, np. u Lohr (2021):
N to liczebność kadry, n – liczba respondentów, a SE – zwykły błąd standardowy: √[p(1 − p)/n] dla odsetka i s/√n dla średniej. Przy N = 420 i n = 180 czynnik pod pierwiastkiem wynosi 0.573, a sam pierwiastek 0.757: przedział jest o prawie jedną czwartą węższy. Gdy n = N, czynnik wynosi 0 i przedział znika – to formalny zapis stanowiska opisowego z poprzedniej sekcji. Gdy próba to mały ułamek populacji (np. 400 osób z całego kraju), czynnik jest bliski 1 i poprawkę się pomija – tak jak w haśle margines błędu w sondażu.
| Wynik (n = 180, N = 420) | Oszacowanie | 95% CI bez poprawki | 95% CI z poprawką |
|---|---|---|---|
| Rozważa odejście w ciągu roku | 20.6% | [14.7%, 26.5%] | [16.1%, 25.0%] |
| Rozważa odejście – przedział dokładny (hipergeometryczny) | 37 z 180 | – | [16.4%, 25.5%], czyli 69–107 osób w kadrze |
| Zadowolenie z pracy (1–5) | M = 3.41, SD = 0.62 | [3.32, 3.50] | [3.34, 3.48] |
Przedział hipergeometryczny odpowiada na pytanie wprost: ile osób w 420-osobowej kadrze może rozważać odejście, skoro wśród 180 wylosowanych jest ich 37? Korzysta z rozkładu hipergeometrycznego (losowanie bez zwracania) i przy małej kadrze lub skrajnych odsetkach jest bezpieczniejszy niż wzór przybliżony. Oba przedziały liczy kod na końcu wpisu; ten sam wynik daje pakiet survey z argumentem fpc.
Czy poprawka działa? W symulacji wylosowaliśmy z tej samej kadry 5000 razy po 180 osób – tym razem losowo i bez braku odpowiedzi. Przedział z poprawką obejmował prawdziwy odsetek w 94.6% prób, czyli tak, jak powinien. Przedział bez poprawki – w 98.5%: jest za szeroki, a jego nominalne 95% to w praktyce prawie 99%.
Ważne zastrzeżenie. Poprawka opisuje błąd losowy przy założeniu, że respondenci są jak losowa próba z kadry. Przy 43% odpowiedzi i samodzielnym zgłaszaniu się to założenie jest wątpliwe. W przykładzie węższy przedział [16.1%, 25.0%] wcale nie obejmuje prawdziwych 29.5%. Poprawka zwiększa precyzję, a nie trafność. Podawaj ją, ale w dyskusji opisz ryzyko błędu braku odpowiedzi – to ono jest tu największym źródłem błędu (zob. całkowity błąd badania sondażowego).
Te same przedziały dla własnych danych policzysz w kalkulatorze przedziału ufności z poprawką na skończoną populację.
Ilu respondentów potrzebujesz przy małej kadrze?
Z tej samej poprawki wynika wzór na liczebność. Najpierw liczysz n0 jak dla dużej populacji, a potem je zmniejszasz:
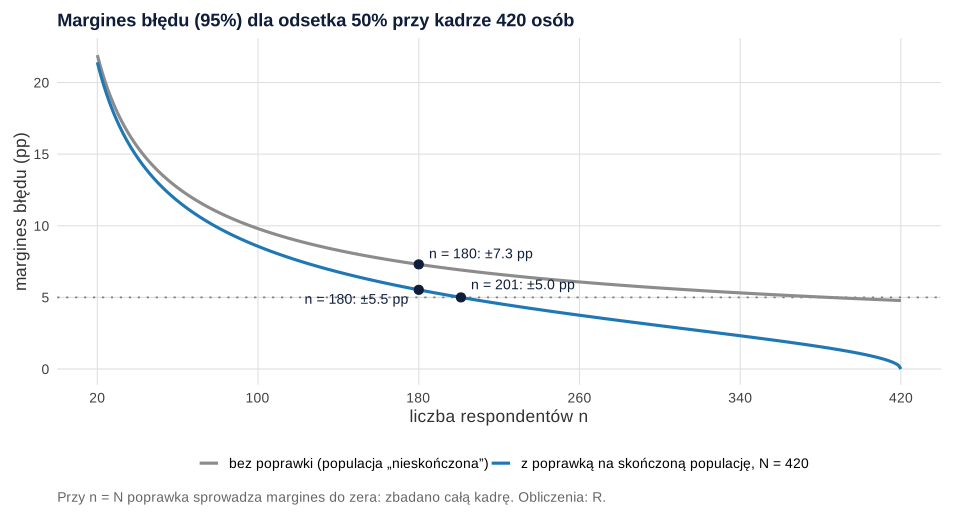
Dla marginesu ±5 punktów procentowych przy odsetku 50% potrzeba 201 odpowiedzi z kadry 420 osób, 278 z kadry 1000 osób i 384 przy populacji milionowej. Bez poprawki wyszłoby 385 osób – prawie cała kadra. Te same wartości dla 1000 osób i bardzo dużych populacji podaje popularna w pracach dyplomowych tabela Krejciego i Morgana (1970), wyliczona z podobnego wzoru. Tabela nie jest więc osobną metodą, tylko gotowym wynikiem tego rachunku dla jednego założenia: ±5 punktów i odsetka 50%. Gdy chcesz porównywać oddziały, liczy się liczebność w najmniejszym porównywanym oddziale, a nie w całym szpitalu. Własne warianty policzysz w kalkulatorze liczebności próby.
W małej populacji nie zaprosisz więcej osób, niż jest w kadrze. Rachunek z wpisu ile zaproszeń wysłać odwraca się: zamiast liczby zaproszeń liczysz potrzebny odsetek odpowiedzi. Żeby uzyskać 201 odpowiedzi z 420 osób, musi odpowiedzieć co najmniej 47.9% kadry. W przykładzie zabrakło 21 ankiet. Margines dla 180 odpowiedzi wynosi ±5.5 punktu (z poprawką), a nie ±7.3, jak podałby wzór dla dużej populacji. Napisz to w metodzie wprost – to uczciwsze niż twierdzenie, że „próba jest reprezentatywna, bo przekroczyła wymagane minimum”.
Anonimowość w małych oddziałach
W ankiecie wśród współpracowników anonimowość jest warunkiem szczerych odpowiedzi, a nie formalnością. Na oddziale, z którego odpowiedziało 8 osób, połączenie trzech pytań metryczki (oddział, staż, wykształcenie) może wskazać konkretną osobę. Pielęgniarka oddziałowa też to wie. Dlatego już przy projektowaniu ankiety:
- Zbieraj tylko te cechy, których użyjesz. Staż w szerokich przedziałach zamiast w latach, bez daty urodzenia i stanowiska, jeśli na oddziale jest jedna osoba na danym stanowisku. Kompromisy przy przedziałach stażu i wieku omawia wpis metryczka: jak zakodować wiek, staż i wykształcenie, a zasady minimalizacji – hasło metryczka. Miejsce metryczki też ma znaczenie: w eksperymencie na internetowej ankiecie pracowników amerykańskiej administracji zdrowia weteranów umieszczenie pytań demograficznych na początku zwiększyło odsetek odpowiedzi na te pytania, bez wpływu na odpowiedzi na pozostałe pytania i ich średnie (Teclaw i in., 2012).
- Ustal regułę raportowania przed analizą. Popularna reguła brzmi: nie pokazuj komórek tabeli z liczebnością od 1 do 4 i nie raportuj wyników dla grup poniżej 5 osób. Próg 5 jest umowny – ustal go z promotorem i komisją, a w pracy podaj go jawnie.
- Pamiętaj o ujawnieniu przez odejmowanie. Jeśli ukryjesz komórkę, ale podasz sumę wiersza, ukrytą liczbę da się odjąć. W przykładzie po samym ukryciu komórek < 5 każdą ukrytą wartość można odtworzyć z sumy wiersza – także na OIT, gdzie ukryte są obie komórki, ale suma wynosi 8, więc każda musi wynosić 4.
- Łącz oddziały według charakteru pracy, nie według wyniku. Najprostsze rozwiązanie to połączenie małych oddziałów w grupy ustalone przed analizą. Zasady łączenia kategorii omawia wpis łączenie kategorii odpowiedzi przed analizą.
W przykładzie siedem oddziałów połączono w trzy grupy: zachowawcze (interna, kardiologia, pediatria), zabiegowe (chirurgia, ginekologia) oraz intensywne i SOR (OIT, SOR). Najmniejsza komórka liczy teraz 7 osób.
| Grupa oddziałów | Respondenci (n) | Rozważa odejście, n (%) |
|---|---|---|
| Zachowawcze (interna, kardiologia, pediatria) | 90 | 14 (15.6) |
| Zabiegowe (chirurgia, ginekologia) | 65 | 16 (24.6) |
| Intensywne i SOR (OIT, SOR) | 25 | 7 (28.0) |
W podejściu modelowym różnica między grupami nie była istotna statystycznie, χ²(2, N = 180) = 2.88, p = .237, V Craméra = .13. Najmniejsza liczebność oczekiwana wyniosła 5.1, więc warunek z wpisu test chi-kwadrat krok po kroku jest spełniony. Pamiętaj jednak o poprzednich sekcjach: najrzadziej odpowiadały właśnie oddziały intensywne, a osoby myślące o odejściu odpowiadały rzadziej. Różnice między grupami mogą więc być w kadrze inne niż wśród respondentów.
Anonimowość to także technika: formularz wymagający logowania kontem firmowym albo zapisujący adresy e-mail nie jest anonimowy, nawet jeśli tak napisano we wstępie. Odróżnij anonimizację od pseudonimizacji (hasło anonimizacja i pseudonimizacja danych).
Zgoda dyrekcji i komisji
Ankieta wśród personelu wymaga zwykle dwóch zgód: zgody dyrekcji szpitala na przeprowadzenie badania (i na udostępnienie zbiorczych danych kadrowych do porównania) oraz – zależnie od wymogów uczelni – opinii komisji bioetycznej. Wymogi różnią się między uczelniami, więc sprawdź je w regulaminie swojej uczelni i u promotora. Uczestnik powinien wiedzieć, kto prowadzi badanie, kto zobaczy wyniki i w jakiej postaci (zob. świadoma zgoda i RODO w badaniach). Jeśli dyrekcja oczekuje raportu, ustal z góry, że dostanie wyniki zbiorcze według tych samych reguł co w pracy, bez wyników małych oddziałów. Unikaj rozdawania ankiet przez przełożonych – to presja, która podnosi odsetek odpowiedzi kosztem szczerości.
Gotowy opis do metody i wyników
Wzór na podstawie przykładu. Uzupełnij nawiasy kwadratowe i usuń zdania, które Cię nie dotyczą.
Jak ułożyć cały rozdział wyników ankiety z wieloma pytaniami, pokazuje wpis jak opisać wyniki ankiety z 30 pytaniami.
Najczęstsze błędy
- „Próba reprezentatywna”, bo odpowiedziało 180 osób. Liczba odpowiedzi nie mówi nic o tym, kto nie odpowiedział. Pokaż odsetek odpowiedzi w oddziałach i porównanie z kadrą.
- Brak definicji populacji. Bez daty i kryteriów nie wiadomo, czy N = 420 obejmuje osoby na urlopach, kontraktach i w zastępstwach.
- Mieszanie stanowisk. „Zbadano całą populację” w metodzie i „różnica jest istotna, więc występuje w populacji” w wynikach.
- Wzór dla dużej populacji przy małej kadrze. Przedział i wymagana liczebność są wtedy zawyżone (385 zamiast 201 osób).
- Poprawka jako lek na wszystko. Węższy przedział nie usuwa błędu braku odpowiedzi.
- Tabele z komórkami 1–4 i sumami wierszy. Ukrycie komórki nic nie daje, jeśli da się ją odjąć od sumy.
- Łączenie oddziałów po zobaczeniu wyników. Grupy ustal przed analizą według charakteru pracy.
- Wyniki dla dyrekcji w podziale na małe oddziały. Obietnica anonimowości dotyczy także raportu dla szpitala.
Jeśli chcesz, żeby ktoś sprawdził z Tobą definicję populacji, przedziały z poprawką i reguły raportowania małych grup, zobacz pomoc w analizie dla studentów.
Ankieta wśród personelu szpitala w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy symulowaną kadrę 420 pielęgniarek i 180 odpowiedzi, a dane respondentów zapisuje w pliku CSV w folderze nadrzędnym (../). Drugi liczy przedziały ufności z poprawką na skończoną populację, ważenie i liczebność próby, trzeci – tabele z regułą ukrywania małych komórek. Przepisy uruchamiaj po kolei z jednego folderu. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane respondentów możesz pobrać: ankieta-personelu-szpitala-respondenci.csv (180 osób: oddział, staż, rozważanie odejścia 0/1, zadowolenie 1–5).
Kadra 420 osób i 180 odpowiedzi: odsetek odpowiedzi i struktura
R
# B437 – ankieta wśród pielęgniarek jednego szpitala: kadra (N = 420), respondenci (n = 180)
# Dane symulowane. Kadra to fikcyjna lista z działu kadr: oddział i staż pracy każdej osoby.
set.seed(4371)

oddzialy <- c(Interna = 90, Chirurgia = 80, SOR = 60, Ginekologia = 55,
              Pediatria = 50, OIT = 45, Kardiologia = 40)
N <- sum(oddzialy)
kadra <- data.frame(id = 1:N, oddzial = factor(rep(names(oddzialy), oddzialy), levels = names(oddzialy)))
kadra$staz <- factor(sample(c("do 5 lat", "5–19 lat", "20 lat i więcej"), N, replace = TRUE,
                            prob = c(.25, .40, .35)),
                     levels = c("do 5 lat", "5–19 lat", "20 lat i więcej"))

# Cechy mierzone w ankiecie (w prawdziwym badaniu znane tylko u respondentów)
ef_oddz <- c(Interna = 0, Chirurgia = 0, SOR = .6, Ginekologia = -.3, Pediatria = -.2, OIT = .4, Kardiologia = 0)
lp <- -1.1 + .7 * (kadra$staz == "do 5 lat") - .5 * (kadra$staz == "20 lat i więcej") + ef_oddz[as.character(kadra$oddzial)]
kadra$odejscie <- rbinom(N, 1, plogis(lp))                 # 1 = rozważa odejście w ciągu roku
zad <- 3.4 - .6 * kadra$odejscie + .15 * (kadra$staz == "20 lat i więcej") + rnorm(N, 0, .55)
kadra$zadowolenie <- pmin(5, pmax(1, round(zad * 5) / 5))  # średnia z 5 pozycji 1–5

# Kto odpowiada: niżej OIT i SOR (praca zmianowa), wyżej długi staż, rzadziej osoby myślące o odejściu
sklonnosc <- exp(c(Interna = 0, Chirurgia = 0, SOR = -.5, Ginekologia = .2, Pediatria = .3, OIT = -1.2,
                   Kardiologia = .1)[as.character(kadra$oddzial)] +
                 .5 * (kadra$staz == "20 lat i więcej") - .6 * kadra$odejscie)
kadra$odpowiedz <- 0
kadra$odpowiedz[sample(N, 180, prob = sklonnosc)] <- 1
resp <- subset(kadra, odpowiedz == 1)
n <- nrow(resp)
cat(sprintf("Kadra N = %d, respondenci n = %d, odsetek odpowiedzi %.1f%%, frakcja n/N = %.3f\n",
            N, n, 100 * n / N, n / N))

# 1. Odsetek odpowiedzi według oddziału
rr <- data.frame(oddzial = names(oddzialy), kadra = as.vector(oddzialy),
                 respondenci = as.vector(table(resp$oddzial)))
rr$odsetek_odp <- round(100 * rr$respondenci / rr$kadra, 1)
print(rr, row.names = FALSE)

# 2. Struktura respondentów a struktura kadry (dane kadrowe są znane dla wszystkich)
struktura <- function(zm) {
  k <- prop.table(table(kadra[[zm]])); r <- prop.table(table(resp[[zm]]))
  data.frame(zmienna = zm, kategoria = names(k), kadra_proc = round(100 * as.vector(k), 1),
             resp_proc = round(100 * as.vector(r), 1), roznica_pp = round(100 * as.vector(r - k), 1))
}
str_tab <- rbind(struktura("oddzial"), struktura("staz"))
print(str_tab, row.names = FALSE)

# 3. Wartości w całej kadrze – znane tylko dlatego, że dane są symulowane
cat(sprintf("Cała kadra: rozważa odejście %.1f%%, zadowolenie M = %.2f\n",
            100 * mean(kadra$odejscie), mean(kadra$zadowolenie)))
cat("Cała kadra – odsetek rozważających odejście według oddziału (%):\n")
print(round(100 * tapply(kadra$odejscie, kadra$oddzial, mean), 1))
cat(sprintf("Respondenci: rozważa odejście %.1f%%, zadowolenie M = %.2f\n",
            100 * mean(resp$odejscie), mean(resp$zadowolenie)))
cat(sprintf("Odsetek odpowiedzi: wśród rozważających odejście %.1f%%, wśród pozostałych %.1f%%\n",
            100 * mean(kadra$odpowiedz[kadra$odejscie == 1]), 100 * mean(kadra$odpowiedz[kadra$odejscie == 0])))

# Zapis: dane respondentów do pobrania (folder strony) i dane kadrowe do kolejnych przepisów
write.csv(resp[, c("id", "oddzial", "staz", "odejscie", "zadowolenie")],
          "../ankieta-personelu-szpitala-respondenci.csv", row.names = FALSE, fileEncoding = "UTF-8")
write.csv(kadra[, c("id", "oddzial", "staz")], "b437-kadra.csv", row.names = FALSE, fileEncoding = "UTF-8")
write.csv(kadra, "b437-kadra-pelna-symulacja.csv", row.names = FALSE, fileEncoding = "UTF-8")
write.csv(rr, "b437-odsetek-odpowiedzi.csv", row.names = FALSE, fileEncoding = "UTF-8")
Wynik w R
Kadra N = 420, respondenci n = 180, odsetek odpowiedzi 42.9%, frakcja n/N = 0.429
     oddzial kadra respondenci odsetek_odp
     Interna    90          43        47.8
   Chirurgia    80          39        48.8
         SOR    60          17        28.3
 Ginekologia    55          26        47.3
   Pediatria    50          28        56.0
         OIT    45           8        17.8
 Kardiologia    40          19        47.5
 zmienna       kategoria kadra_proc resp_proc roznica_pp
 oddzial         Interna       21.4      23.9        2.5
 oddzial       Chirurgia       19.0      21.7        2.6
 oddzial             SOR       14.3       9.4       -4.8
 oddzial     Ginekologia       13.1      14.4        1.3
 oddzial       Pediatria       11.9      15.6        3.7
 oddzial             OIT       10.7       4.4       -6.3
 oddzial     Kardiologia        9.5      10.6        1.0
    staz        do 5 lat       24.5      19.4       -5.1
    staz        5–19 lat       40.5      35.6       -4.9
    staz 20 lat i więcej       35.0      45.0       10.0
Cała kadra: rozważa odejście 29.5%, zadowolenie M = 3.27
Cała kadra – odsetek rozważających odejście według oddziału (%):
    Interna   Chirurgia         SOR Ginekologia   Pediatria         OIT
       27.8        35.0        23.3        32.7        10.0        44.4
Kardiologia
       35.0
Respondenci: rozważa odejście 20.6%, zadowolenie M = 3.41
Odsetek odpowiedzi: wśród rozważających odejście 29.8%, wśród pozostałych 48.3%
Przedziały z poprawką na skończoną populację, ważenie i liczebność
R
# B437 – przedziały ufności z poprawką na skończoną populację (FPC), liczebność próby, ważenie
# Uruchom po b437-1-kadra-i-odpowiedzi.R (korzysta z zapisanych plików CSV).
suppressPackageStartupMessages(library(survey))
resp  <- read.csv("../ankieta-personelu-szpitala-respondenci.csv", fileEncoding = "UTF-8")
kadra <- read.csv("b437-kadra.csv", fileEncoding = "UTF-8")
N <- nrow(kadra); n <- nrow(resp); z <- qnorm(.975)
fpc <- (N - n) / (N - 1)                       # czynnik poprawki dla wariancji
cat(sprintf("N = %d, n = %d, (N - n)/(N - 1) = %.3f, pierwiastek = %.3f\n", N, n, fpc, sqrt(fpc)))

# 1. Proporcja: „rozważam odejście z pracy w ciągu roku”
p <- mean(resp$odejscie)
se0 <- sqrt(p * (1 - p) / n); se1 <- se0 * sqrt(fpc)
cat(sprintf("odsetek = %.3f; SE bez FPC = %.4f, z FPC = %.4f\n", p, se0, se1))
cat(sprintf("95%% CI bez FPC: [%.1f%%, %.1f%%] (±%.1f pp)\n", 100 * (p - z * se0), 100 * (p + z * se0), 100 * z * se0))
cat(sprintf("95%% CI z FPC:   [%.1f%%, %.1f%%] (±%.1f pp)\n", 100 * (p - z * se1), 100 * (p + z * se1), 100 * z * se1))

# Przedział dokładny z rozkładu hipergeometrycznego: ile osób (M) w kadrze 420 może rozważać odejście?
x <- sum(resp$odejscie); M <- 0:N
gorny_ok <- phyper(x, M, N - M, n) > .025          # P(X <= x | M) > .025
dolny_ok <- phyper(x - 1, M, N - M, n, lower.tail = FALSE) > .025   # P(X >= x | M) > .025
Mz <- range(M[gorny_ok & dolny_ok])
cat(sprintf("Hipergeometryczny 95%% CI (x = %d z n = %d): od %d do %d osób w kadrze, czyli [%.1f%%, %.1f%%]\n",
            x, n, Mz[1], Mz[2], 100 * Mz[1] / N, 100 * Mz[2] / N))

# 2. Średnia: zadowolenie z pracy (1–5)
m <- mean(resp$zadowolenie); s <- sd(resp$zadowolenie); tkr <- qt(.975, n - 1)
cat(sprintf("Zadowolenie M = %.2f, SD = %.2f\n", m, s))
cat(sprintf("95%% CI bez FPC: [%.2f, %.2f]; z FPC: [%.2f, %.2f]\n",
            m - tkr * s / sqrt(n), m + tkr * s / sqrt(n),
            m - tkr * s / sqrt(n) * sqrt(fpc), m + tkr * s / sqrt(n) * sqrt(fpc)))

# 3. To samo w pakiecie survey: fpc = wielkość populacji
resp$N <- N
d <- svydesign(ids = ~1, fpc = ~N, data = resp)
print(svymean(~odejscie + zadowolenie, d))
# survey stosuje czynnik (1 - n/N) i wariancję z dzielnikiem n - 1 – przy n = 180 wynik jest ten sam

# 4. Ważenie (raking) do struktury kadry: oddział i staż
pop_o <- data.frame(oddzial = names(table(kadra$oddzial)), Freq = as.vector(table(kadra$oddzial)))
pop_s <- data.frame(staz = names(table(kadra$staz)), Freq = as.vector(table(kadra$staz)))
dw <- rake(d, list(~oddzial, ~staz), list(pop_o, pop_s))
w <- weights(dw)
cat(sprintf("Wagi: min %.2f, max %.2f; efekt ważenia Kisha 1 + CV^2 = %.2f\n",
            min(w), max(w), 1 + (sd(w) / mean(w))^2))
est <- svymean(~odejscie, dw); ci <- confint(est)
cat(sprintf("Odejście po ważeniu: %.1f%%, 95%% CI [%.1f%%, %.1f%%]\n", 100 * coef(est), 100 * ci[1], 100 * ci[2]))
emz <- svymean(~zadowolenie, dw)
cat(sprintf("Zadowolenie po ważeniu: M = %.2f (SE = %.3f)\n", coef(emz), SE(emz)))

# 5. Gdyby odpowiedziały wszystkie 420 osoby (badanie całej kadry)
cat(sprintf("n = N: (N - n)/(N - 1) = %.0f, więc SE z FPC = 0 – wynik jest wartością w kadrze\n", (N - N) / (N - 1)))

# 6. Liczebność próby przy małej populacji (margines ±5 pp, p = .5, 95%)
n0 <- z^2 * .25 / .05^2
n_fpc <- function(Npop) n0 / (1 + (n0 - 1) / Npop)
for (Npop in c(420, 1000, 1e6)) cat(sprintf("N = %7.0f: potrzeba %d odpowiedzi\n", Npop, ceiling(n_fpc(Npop))))
cat(sprintf("Bez poprawki: %d. Przy N = 420 potrzebny odsetek odpowiedzi co najmniej %.1f%% całej kadry\n",
            ceiling(n0), 100 * ceiling(n_fpc(420)) / 420))
moe <- function(nn, Npop, pp = .5) z * sqrt(pp * (1 - pp) / nn * (Npop - nn) / (Npop - 1))
cat(sprintf("Margines przy n = 180 z N = 420 (p = .5): ±%.1f pp; bez poprawki ±%.1f pp\n",
            100 * moe(180, 420), 100 * z * sqrt(.25 / 180)))

# 7. Symulacja: 5000 losowych prób po 180 osób z jednej kadry 420 (dobór losowy, bez braku odpowiedzi)
set.seed(4372)
pelna <- read.csv("b437-kadra-pelna-symulacja.csv", fileEncoding = "UTF-8")
P <- mean(pelna$odejscie)
sym <- t(replicate(5000, {
  y <- pelna$odejscie[sample(N, n)]; pp <- mean(y); e0 <- sqrt(pp * (1 - pp) / n)
  c(bez = abs(pp - P) <= z * e0, z_fpc = abs(pp - P) <= z * e0 * sqrt(fpc), pp = pp)
}))
cat(sprintf("Pokrycie 95%% CI: bez FPC %.1f%%, z FPC %.1f%%; SD oszacowań %.4f (wzór z FPC %.4f)\n",
            100 * mean(sym[, "bez"]), 100 * mean(sym[, "z_fpc"]), sd(sym[, "pp"]),
            sqrt(P * (1 - P) / n * fpc)))

# Dane do rysunku: szerokość marginesu w funkcji n przy N = 420
szer <- data.frame(n = 20:420)
szer$bez_fpc <- 100 * z * sqrt(.25 / szer$n)
szer$z_fpc <- 100 * moe(szer$n, 420)
write.csv(szer, "b437-margines-n.csv", row.names = FALSE)
Wynik w R
N = 420, n = 180, (N - n)/(N - 1) = 0.573, pierwiastek = 0.757
odsetek = 0.206; SE bez FPC = 0.0301, z FPC = 0.0228
95% CI bez FPC: [14.7%, 26.5%] (±5.9 pp)
95% CI z FPC:   [16.1%, 25.0%] (±4.5 pp)
Hipergeometryczny 95% CI (x = 37 z n = 180): od 69 do 107 osób w kadrze, czyli [16.4%, 25.5%]
Zadowolenie M = 3.41, SD = 0.62
95% CI bez FPC: [3.32, 3.50]; z FPC: [3.34, 3.48]
               mean     SE
odejscie    0.20556 0.0228
zadowolenie 3.40667 0.0348
Wagi: min 1.45, max 6.62; efekt ważenia Kisha 1 + CV^2 = 1.18
Odejście po ważeniu: 23.6%, 95% CI [18.6%, 28.6%]
Zadowolenie po ważeniu: M = 3.37 (SE = 0.038)
n = N: (N - n)/(N - 1) = 0, więc SE z FPC = 0 – wynik jest wartością w kadrze
N =     420: potrzeba 201 odpowiedzi
N =    1000: potrzeba 278 odpowiedzi
N = 1000000: potrzeba 384 odpowiedzi
Bez poprawki: 385. Przy N = 420 potrzebny odsetek odpowiedzi co najmniej 47.9% całej kadry
Margines przy n = 180 z N = 420 (p = .5): ±5.5 pp; bez poprawki ±7.3 pp
Pokrycie 95% CI: bez FPC 98.5%, z FPC 94.6%; SD oszacowań 0.0258 (wzór z FPC 0.0257)
Komórki poniżej 5 osób i łączenie oddziałów
R
# B437 – anonimowość w małych oddziałach: komórki < 5, ukrywanie i łączenie oddziałów
# Uruchom po b437-1-kadra-i-odpowiedzi.R.
resp <- read.csv("../ankieta-personelu-szpitala-respondenci.csv", fileEncoding = "UTF-8")
kol <- c("Interna", "Chirurgia", "SOR", "Ginekologia", "Pediatria", "OIT", "Kardiologia")
resp$oddzial <- factor(resp$oddzial, levels = kol)
resp$odejscie_t <- factor(resp$odejscie, 0:1, c("nie", "tak"))
PROG <- 5   # reguła ustalona przed analizą: nie pokazujemy liczebności 1–4

tab <- table(resp$oddzial, resp$odejscie_t)
cat("Tabela robocza (tylko do analizy, nie do pracy):\n"); print(addmargins(tab, 2))

# Ukrycie komórek 1–4 (zero nie identyfikuje nikogo, ale też je oznaczamy, jeśli brzeg jest mały)
maskuj <- function(t, prog = PROG) {
  out <- matrix(as.character(t), nrow(t), dimnames = dimnames(t))
  out[t > 0 & t < prog] <- paste0("<", prog)
  out
}
cat("\nPo ukryciu komórek < 5:\n"); print(cbind(maskuj(tab), razem = rowSums(tab)), quote = FALSE)
cat("\nUwaga: przy podanej sumie wiersza ukrytą komórkę da się odjąć (np. OIT: razem 8).\n")
ukryte <- which(tab > 0 & tab < PROG, arr.ind = TRUE)
for (i in seq_len(nrow(ukryte)))
  cat(sprintf("  %s, odejście = %s: liczba osób %d – da się ją odtworzyć z sumy wiersza\n",
              rownames(tab)[ukryte[i, 1]], colnames(tab)[ukryte[i, 2]], tab[ukryte[i, 1], ukryte[i, 2]]))

# Rozwiązanie zaplanowane przed analizą: łączenie oddziałów według charakteru pracy
zach <- "Zachowawcze (interna, kardiologia, pediatria)"
grupa <- c(Interna = zach, Kardiologia = zach, Pediatria = zach,
           Chirurgia = "Zabiegowe (chirurgia, ginekologia)", Ginekologia = "Zabiegowe (chirurgia, ginekologia)",
           SOR = "Intensywne i SOR (OIT, SOR)", OIT = "Intensywne i SOR (OIT, SOR)")
resp$grupa <- factor(grupa[as.character(resp$oddzial)], levels = unique(grupa[kol]))
tab2 <- table(resp$grupa, resp$odejscie_t)
wyn <- data.frame(grupa = rownames(tab2), n = as.vector(rowSums(tab2)), tak = as.vector(tab2[, "tak"]))
wyn$proc_tak <- round(100 * wyn$tak / wyn$n, 1)
cat("\nPo połączeniu oddziałów:\n"); print(wyn, row.names = FALSE)
cat(sprintf("Najmniejsza komórka po połączeniu: %d\n", min(tab2)))

# Porównanie grup oddziałów (test opisowy; przy próbie z jednej kadry – zob. tekst)
ch <- chisq.test(tab2)
cat(sprintf("chi^2(%d, N = %d) = %.2f, p = %s; najmniejsza liczebność oczekiwana %.1f\n",
            ch$parameter, sum(tab2), ch$statistic, sub("^0", "", sprintf("%.3f", ch$p.value)), min(ch$expected)))
v <- sqrt(ch$statistic / (sum(tab2) * (min(dim(tab2)) - 1)))
cat(sprintf("V Cramera = %.2f\n", v))
Wynik w R
Tabela robocza (tylko do analizy, nie do pracy):

              nie tak Sum
  Interna      31  12  43
  Chirurgia    27  12  39
  SOR          14   3  17
  Ginekologia  22   4  26
  Pediatria    27   1  28
  OIT           4   4   8
  Kardiologia  18   1  19

Po ukryciu komórek < 5:
            nie tak razem
Interna     31  12  43
Chirurgia   27  12  39
SOR         14  <5  17
Ginekologia 22  <5  26
Pediatria   27  <5  28
OIT         <5  <5  8
Kardiologia 18  <5  19

Uwaga: przy podanej sumie wiersza ukrytą komórkę da się odjąć (np. OIT: razem 8).
  OIT, odejście = nie: liczba osób 4 – da się ją odtworzyć z sumy wiersza
  SOR, odejście = tak: liczba osób 3 – da się ją odtworzyć z sumy wiersza
  Ginekologia, odejście = tak: liczba osób 4 – da się ją odtworzyć z sumy wiersza
  Pediatria, odejście = tak: liczba osób 1 – da się ją odtworzyć z sumy wiersza
  OIT, odejście = tak: liczba osób 4 – da się ją odtworzyć z sumy wiersza
  Kardiologia, odejście = tak: liczba osób 1 – da się ją odtworzyć z sumy wiersza

Po połączeniu oddziałów:
                                         grupa  n tak proc_tak
 Zachowawcze (interna, kardiologia, pediatria) 90  14     15.6
            Zabiegowe (chirurgia, ginekologia) 65  16     24.6
                   Intensywne i SOR (OIT, SOR) 25   7     28.0
Najmniejsza komórka po połączeniu: 7
chi^2(2, N = 180) = 2.88, p = .237; najmniejsza liczebność oczekiwana 5.1
V Cramera = 0.13
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem survey; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed rozesłaniem ankiety i przed analizą sprawdź…
- Czy populacja ma definicję z datą i kryteriami, a dział kadr poda N według oddziału i stażu?
- Czy masz zgodę dyrekcji i – jeśli uczelnia jej wymaga – opinię komisji bioetycznej?
- Czy formularz jest naprawdę anonimowy (bez logowania i zapisu adresów e-mail)?
- Czy metryczka zawiera tylko potrzebne cechy, w przedziałach, które nie identyfikują osób?
- Czy zaplanowano przypomnienia i dotarcie do oddziałów pracujących w systemie zmianowym?
- Czy wiesz, jaki odsetek odpowiedzi daje zakładaną precyzję (np. 201 z 420 osób dla ±5 pp)?
- Czy stanowisko (opisowe czy modelowe) i reguła raportowania grup < 5 są zapisane przed analizą?
- Czy grupy oddziałów do łączenia są ustalone według charakteru pracy, zanim zobaczysz wyniki?
Najczęstsze pytania
Czy przy ankiecie wśród wszystkich pielęgniarek szpitala trzeba liczyć istotność statystyczną?
To zależy od celu. Jeśli opisujesz tę kadrę w tym momencie, a odpowiedzieli prawie wszyscy, odsetki są wartościami w populacji i testy nie są potrzebne – liczy się wielkość różnic. Jeśli wnioskujesz o procesie (np. czy krótki staż wiąże się z myśleniem o odejściu także w innych szpitalach), licz zwykłe testy. Stanowisko zapisz w metodzie i stosuj konsekwentnie.
Ile odpowiedzi potrzebuję, jeśli w szpitalu pracuje 420 pielęgniarek?
Dla marginesu błędu ±5 punktów procentowych przy odsetku 50% i poziomie ufności 95% potrzeba 201 odpowiedzi, czyli co najmniej 47.9% kadry. Wzór dla dużej populacji dałby 385 osób. Jeśli chcesz porównywać oddziały, licz liczebność dla najmniejszego porównywanego oddziału.
Czy poprawkę na skończoną populację można stosować, gdy ankietę wypełnili ochotnicy?
Można ją podać, ale z zastrzeżeniem. Poprawka zawęża przedział, zakładając, że respondenci są jak losowa próba z kadry. Nie chroni przed błędem braku odpowiedzi: w przykładzie przedział z poprawką [16.1%, 25.0%] nie objął prawdziwych 29.5%, bo osoby rozważające odejście odpowiadały rzadziej. W dyskusji opisz to ryzyko.
Jak pokazać wyniki oddziału, z którego ankietę wypełniło tylko kilka osób?
Nie pokazuj ich osobno. Ustal przed analizą próg (często 5 osób) i połącz małe oddziały w grupy według charakteru pracy, np. zachowawcze, zabiegowe, intensywne. Samo ukrycie komórki nie wystarcza, jeśli podajesz sumę wiersza – wtedy ukrytą liczbę da się odjąć.
Czy 43% odpowiedzi w ankiecie wśród personelu medycznego to mało?
To wynik nieco poniżej średniej .53 z metaanalizy ankiet wśród pracowników ochrony zdrowia (Cho i in., 2013). Ważniejsze od samej liczby jest to, kto nie odpowiedział: porównaj odsetek odpowiedzi w oddziałach i strukturę respondentów z danymi kadrowymi, a w dyskusji opisz możliwy kierunek obciążenia.
Powiązane hasła
Przeczytaj też
Wielkość próby a wielkość populacji w obrazkach
Mapy populacji, krzywe marginesu błędu dla N od 200 do 38 mln, 1000 sondaży w mieście i w kraju, mała populacja i efektywne n – sześć rysunków z R.
Czytaj →PoradnikBadanie na studentach i ankieta na zajęciach
Co wolno wnioskować z próby studenckiej, wąski zakres zmiennych, grupy ćwiczeniowe jako skupienia, symulacje w R i zdania do Metody.
Czytaj →PoradnikBadanie we własnym miejscu pracy
Swoi pacjenci, uczniowie, zespół: zagrożenia, kto ma zbierać dane, symulacja aprobaty społecznej w R i zdania do Metody oraz Ograniczeń.
Czytaj →PoradnikZgoda placówki na badanie – wzór pisma
Do kogo pisać, co zawrzeć w piśmie, trzy fikcyjne warianty dla szpitala, szkoły i firmy oraz co zrobić po odmowie lub braku odpowiedzi.
Czytaj →PoradnikWniosek do komisji bioetycznej – jak opisać badanie
Metoda językiem zrozumiałym dla komisji: rekrutacja, procedura, liczebność, dane, wypełniony fikcyjny przykład i poprawione fragmenty.
Czytaj →PoradnikIle zaproszeń wysłać w sondażu
Od marginesu błędu do liczby zaproszeń: efekt schematu, wagi, kwalifikacja, kontakt i odpowiedź, podgrupy oraz ryzyko niedoboru w R.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikŁączenie kategorii odpowiedzi – kiedy i jak
Likert 5 na 3, „nie wiem”, małe kategorie metryczki, łączenie pod wynik w symulacji i alternatywy: test Fishera, trend, regresja porządkowa – z kodem R.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →Robisz ankietę wśród personelu swojego szpitala?
Pomożemy zdefiniować populację, policzyć przedziały z poprawką na skończoną populację i ułożyć tabele, które nie ujawniają odpowiedzi małych oddziałów – w R lub SPSS, z wyjaśnieniem, które pozwoli Ci samodzielnie obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Berk, R. A., Western, B., & Weiss, R. E. (1995). Statistical inference for apparent populations. Sociological Methodology, 25, 421. https://doi.org/10.2307/271073
- Cho, Y. I., Johnson, T. P., & VanGeest, J. B. (2013). Enhancing surveys of health care professionals: A meta-analysis of techniques to improve response. Evaluation & the Health Professions, 36(3), 382–407. https://doi.org/10.1177/0163278713496425
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Groves, R. M., & Peytcheva, E. (2008). The impact of nonresponse rates on nonresponse bias: A meta-analysis. Public Opinion Quarterly, 72(2), 167–189. https://doi.org/10.1093/poq/nfn011 ● Otwarty dostęp: pełny tekst
- Krejcie, R. V., & Morgan, D. W. (1970). Determining sample size for research activities. Educational and Psychological Measurement, 30(3), 607–610. https://doi.org/10.1177/001316447003000308
- Lohr, S. L. (2021). Sampling: Design and analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429298899
- Teclaw, R., Price, M. C., & Osatuke, K. (2012). Demographic question placement: Effect on item response rates and means of a Veterans Health Administration survey. Journal of Business and Psychology, 27(3), 281–290. https://doi.org/10.1007/s10869-011-9249-y
Cytowania BibTeX
@article{berk1995statistical, author={Berk, Richard A. and Western, Bruce and Weiss, Robert E.}, title={{Statistical inference for apparent populations}}, journal={Sociological Methodology}, year={1995}, volume={25}, pages={421}, doi={10.2307/271073}}@article{cho2013enhancing, author={Cho, Young Ik and Johnson, Timothy P. and VanGeest, Jonathan B.}, title={{Enhancing surveys of health care professionals: A meta-analysis of techniques to improve response}}, journal={Evaluation \& the Health Professions}, year={2013}, volume={36}, number={3}, pages={382--407}, doi={10.1177/0163278713496425}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{groves2008impact, author={Groves, R. M. and Peytcheva, E.}, title={{The impact of nonresponse rates on nonresponse bias: A meta-analysis}}, journal={Public Opinion Quarterly}, year={2008}, volume={72}, number={2}, pages={167--189}, doi={10.1093/poq/nfn011}}@article{krejcie1970determining, author={Krejcie, Robert V. and Morgan, Daryle W.}, title={{Determining sample size for research activities}}, journal={Educational and Psychological Measurement}, year={1970}, volume={30}, number={3}, pages={607--610}, doi={10.1177/001316447003000308}}@book{lohr2021sampling, author={Lohr, Sharon L.}, title={{Sampling: Design and analysis (3rd ed.)}}, year={2021}, publisher={Chapman and Hall/CRC}, doi={10.1201/9780429298899}}@article{teclaw2012demographic, author={Teclaw, Robert and Price, Mark C. and Osatuke, Katerine}, title={{Demographic question placement: Effect on item response rates and means of a Veterans Health Administration survey}}, journal={Journal of Business and Psychology}, year={2012}, volume={27}, number={3}, pages={281--290}, doi={10.1007/s10869-011-9249-y}}