Duża populacja, duża próba?
„Uczelnia ma 30 tysięcy studentów, a ja tylko 200 ankiet – to chyba za mało?” Intuicja podpowiada, że próba powinna stanowić „przyzwoity procent” populacji. Rachunek mówi co innego: przy losowaniu precyzja zależy prawie wyłącznie od liczby zbadanych osób, a wielkość populacji ma znaczenie dopiero wtedy, gdy próba obejmuje jej sporą część. Pokazujemy to na sześciu rysunkach: od „mapy” populacji, przez krzywe marginesu błędu, po 1000 sondaży w mieście i w kraju.
Populacje są fikcyjne, więc prawdziwe wartości znamy. Wzory na liczebność są we wpisie dobór liczebności próby i w haśle liczebność próby w ankiecie. Tu zajmujemy się obrazem: kiedy wielkość populacji zmienia wynik, a kiedy nie.
Zastrzeżenie: wszystko poniżej dotyczy doboru losowego, czyli sytuacji, w której znasz listę populacji (operat losowania) i losujesz z niej osoby. W pracy dyplomowej zwykle masz próbę dostępną (ankieta na grupach studenckich, wśród znajomych). Wtedy margines z poniższych wzorów jest tylko orientacyjny, a o wnioskach decyduje to, kto odpowiedział. Co wolno napisać o takiej próbie, wyjaśnia wpis dobór próby w pracy dyplomowej.
Rysunek 1: ta sama próba na trzech mapach
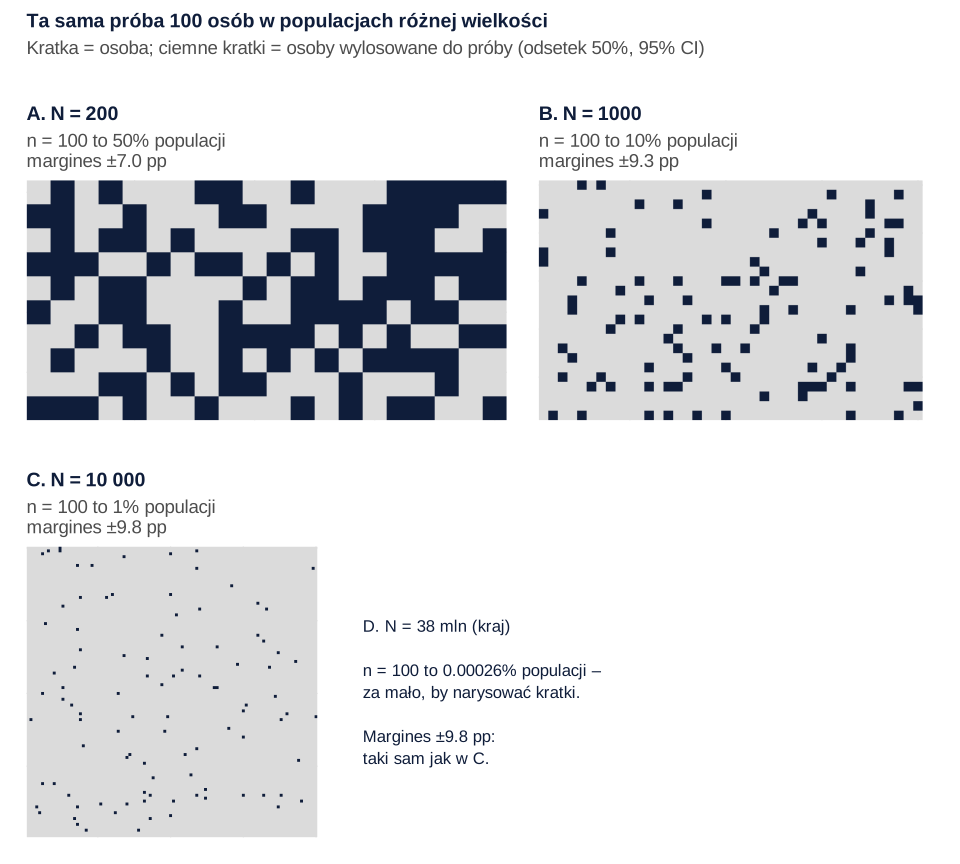
set.seed(589)).Co widać. Kratka to osoba z fikcyjnej populacji, ciemne kratki – 100 osób wylosowanych bez zwracania. Próba zajmuje połowę mapy A, co dziesiątą kratkę mapy B i co setną mapy C. Mimo to margines błędu dla odsetka 50% (95% przedział ufności) wynosi odpowiednio ±6.95, ±9.30 i ±9.75 punktu procentowego (pp). Dla kraju liczącego 38 mln mieszkańców 100 osób to 0.00026% populacji, a margines to ±9.80 pp – praktycznie tyle samo co dla populacji 10 000 osób. Wyraźnie mniejszy margines daje tylko mapa A, bo tam zbadaliśmy połowę wszystkich.
Czego ten wykres nie pokazuje. Precyzja zależy od liczby ciemnych kratek, nie od ich gęstości na mapie. Rysunek nie pokazuje też, czy wylosowane osoby odpowiedziały – w realnym badaniu część ciemnych kratek zostałaby pusta (rysunek 6).
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: margines błędu a liczebność próby
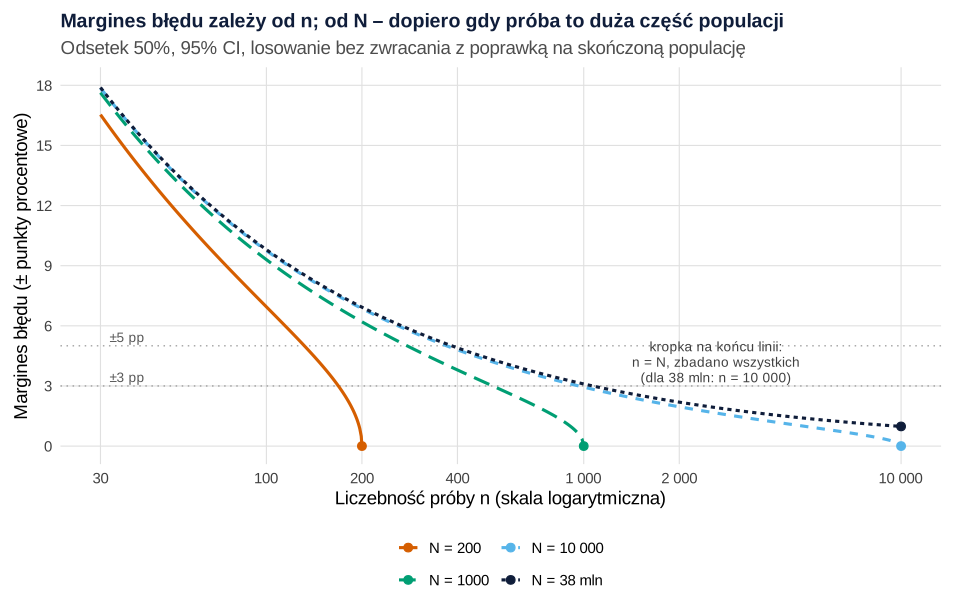
Co widać. Cztery krzywe pokazują margines błędu dla odsetka 50% w zależności od liczebności próby n, przy populacji N = 200, 1000, 10 000 i 38 mln. Na początku krzywe biegną razem: przy n = 200 margines dla populacji 1000, 10 000 i 38 mln wynosi ±6.2, ±6.9 i ±6.9 pp. Rozchodzą się dopiero wtedy, gdy próba staje się sporą częścią populacji. Wtedy każda opada do zera w punkcie n = N, bo po zbadaniu wszystkich nie ma już błędu losowania. Odpowiada za to poprawka na skończoną populację (ang. finite population correction, FPC), opisywana w podręcznikach doboru próby (Lohr, 2021): błąd standardowy mnożymy przez √[(N − n)/(N − 1)]. Dla kraju poprawka jest praktycznie równa 1. Krzywa dla 38 mln jest więc zwykłą krzywą „bez poprawki”: przy n = 400 daje ±4.9 pp, a przy n = 1000 ±3.1 pp.
Jak może zmylić. Oś pozioma jest logarytmiczna. Margines maleje z pierwiastkiem z n: żeby go zmniejszyć o połowę, trzeba mniej więcej czterokrotnie zwiększyć próbę (więcej we wpisie przedział ufności w obrazkach). Krzywe dotyczą najgorszego przypadku – odsetka 50%.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: 1000 sondaży w mieście i w kraju
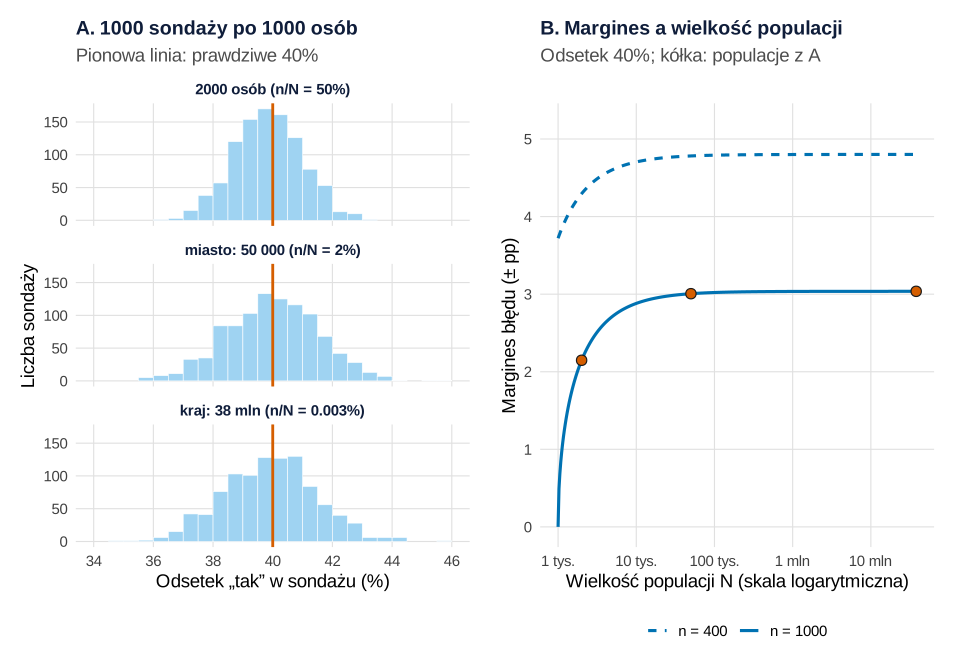
set.seed(589)).Co widać. Panel A: po 1000 fikcyjnych sondaży na losowych próbach 1000 osób w populacji 2000 osób, w mieście (50 000) i w kraju (38 mln). Prawdziwy odsetek osób uprawiających sport co najmniej raz w tygodniu to 40%. Histogramy dla miasta i kraju są niemal identyczne. Odchylenie standardowe 1000 oszacowań wyniosło 1.539 i 1.540 pp, a wzór daje 1.534 i 1.549 pp. Węższy jest tylko histogram dla 2000 osób (SD = 1.131 pp, wzór z poprawką: 1.096 pp), bo sondaż obejmował połowę populacji. W przedziale ±1.96 błędu standardowego od prawdziwych 40% znalazło się 94.2%, 95.6% i 96.2% sondaży. Błąd Monte Carlo tych odsetków wynosi 0.6–0.7 pp, więc wszystkie trzy są zgodne z nominalnymi 95%.
Panel B pokazuje to samo bez losowania: przy n = 1000 margines rośnie z wielkością populacji tylko do kilkudziesięciu tysięcy osób, a potem jest płaski (miasto ±3.01 pp, kraj ±3.04 pp). Dlatego 1000 losowo wybranych osób daje podobną precyzję dla miasta i dla kraju. Do oceny smaku zupy liczy się wielkość łyżki, a nie garnka – pod warunkiem że zupa jest zamieszana, czyli losowanie jest prawdziwe.
Jak może zmylić. Płaska krzywa obowiązuje tylko dla próby losowej. Meng (2018) pokazał, że błąd średniej z dowolnego zbioru danych zależy od korelacji między badaną cechą a tym, czy osoba trafiła do danych. Dobór losowy utrzymuje tę korelację na znikomym poziomie, ale gdy jej nie kontrolujemy, błąd względem zwykłego 1/√n rośnie z pierwiastkiem z N. Autor nazywa to prawem dużych populacji. Ankietę z samoselekcją pokazują wpisy sondaż w obrazkach i dobór nielosowy w obrazkach.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: 120 pielęgniarek – kiedy zbadać wszystkich
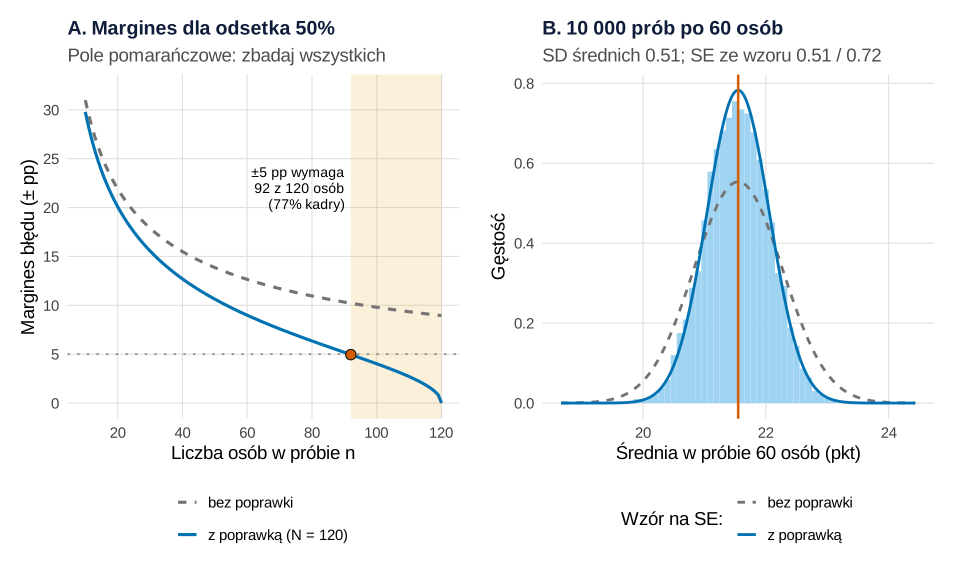
set.seed(589)).Co widać. Fikcyjny szpital zatrudnia 120 pielęgniarek. Panel A pokazuje margines błędu dla odsetka 50% bez poprawki (linia przerywana) i z poprawką (ciągła). Przy 60 osobach wzór bez poprawki daje ±12.65 pp, a z poprawką ±8.98 pp. Próba to połowa kadry, więc różnica jest duża. Żeby uzyskać margines ±5 pp, trzeba zbadać 92 z 120 osób, czyli 77% kadry. Wzór bez poprawki „żąda” 385 osób. Jeśli spodziewasz się, że odpowie 60% zaproszonych, trzeba by zaprosić 154 osoby – więcej, niż liczy cała kadra. W pomarańczowym polu losowanie traci sens: zaproś wszystkich i opisz badanie jako pełne. Lakens (2022) wymienia zbadanie (prawie) całej populacji jako pierwszy z sześciu sposobów uzasadnienia liczebności próby.
Panel B: 10 000 razy losowaliśmy bez zwracania 60 osób i liczyliśmy średni wynik fikcyjnej skali wypalenia (0–40 pkt; w całej kadrze M = 21.55, SD = 5.58). Odchylenie standardowe 10 000 średnich wyniosło 0.514. Wzór z poprawką daje 0.510, a bez poprawki 0.721. W kolejnych 10 000 próbach 95% przedział t z poprawką objął prawdziwą średnią w 95.02% przypadków (błąd Monte Carlo 0.22 pp), a bez poprawki w 99.34% (0.08 pp). Przedział bez poprawki jest więc niepotrzebnie szeroki.
Czego ten wykres nie pokazuje. Symulacja zakłada, że wylosowani odpowiadają. Gdy zaprosisz wszystkich, a odpowie część, poprawka zawęża przedział, ale nie usuwa obciążenia, jeśli odpowiedziały głównie osoby zainteresowane tematem. Jak to opisać i czy przy badaniu całej kadry w ogóle liczyć testy, omawia wpis o ankiecie w jednym szpitalu. Berk, Western i Weiss (1995) nazywają takie dane, obejmujące wszystkie istniejące jednostki, populacją pozorną i pytają, jak wtedy rozumieć wnioskowanie. Własne liczby policzysz w kalkulatorze przedziału z poprawką na skończoną populację.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: dlaczego nie „10% populacji”
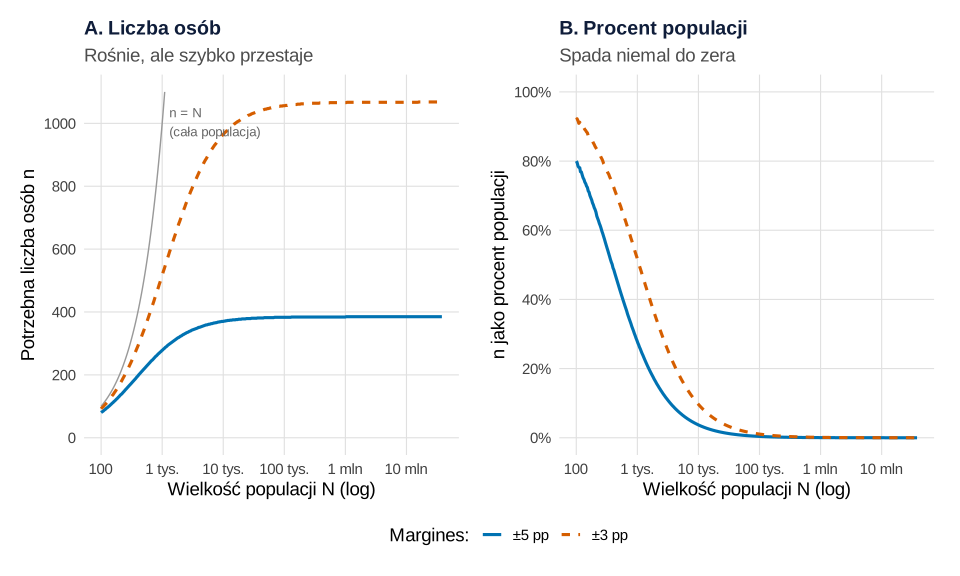
Co widać. Panel A pokazuje, ilu osób potrzeba do marginesu ±5 i ±3 pp (odsetek 50%, 95% CI) w zależności od wielkości populacji. Krzywe szybko się wypłaszczają. Dla ±5 pp potrzeba 132 osób przy N = 200, 278 przy 1000, 370 przy 10 000 i 385 przy 38 mln. Dla ±3 pp potrzeba 517 osób przy 1000 i 1068 przy 38 mln. Z tego samego rachunku (odsetek 50%, ±5 pp, poprawka na skończoną populację) wyliczono znaną tabelę Krejciego i Morgana (1970); dla bardzo dużych populacji podaje ona około 384 osób. Panel B przelicza to na procent populacji. Przy 200 osobach jest to 66%, przy 1000 – 27.8%, przy 10 000 – 3.7%, a przy 38 mln – tysięczna część procenta.
Stąd prosty wniosek: żaden stały procent populacji nie gwarantuje stałej precyzji. Reguła „10% populacji” daje 20 osób i margines ±20.8 pp w populacji 200 osób, ±9.3 pp przy 1000 osób, ±2.9 pp przy 10 000 i ±0.9 pp przy 100 000 (wtedy 10 000 ankiet to marnowanie wysiłku). Liczebność ustalaj z wymaganej precyzji albo z analizy mocy. Pomogą w tym kalkulator liczebności próby i wpis ile osób do ankiety w pracy licencjackiej.
Jak może zmylić. Krzywe dotyczą jednego odsetka w całej próbie. Gdy porównujesz podgrupy, np. wydziały, licz liczebność dla najmniejszej z nich. A 385 osób „wystarcza na każdą populację” tylko przy losowaniu i pełnej realizacji próby.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: prawdziwe n jest mniejsze niż liczba zaproszeń
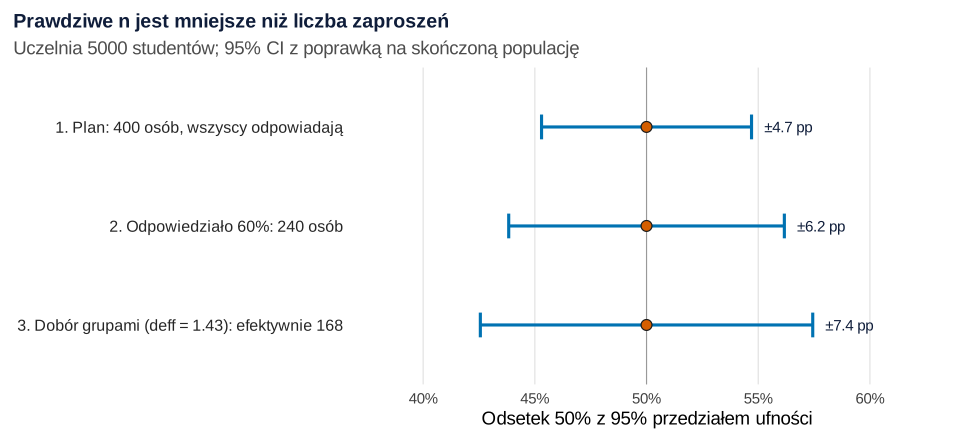
Co widać. Fikcyjna uczelnia ma 5000 studentów. Losujemy 25 całych grup ćwiczeniowych po 16 osób (400 zaproszeń). Gdyby wszyscy odpowiedzieli, a osoby losowano pojedynczo, margines dla odsetka 50% wyniósłby ±4.7 pp. Odpowiada jednak 60%, czyli 240 osób, i margines rośnie do ±6.2 pp. Osoby z jednej grupy są do siebie podobne: przy korelacji wewnątrzgrupowej .05 i średnio 9.6 respondenta w grupie efekt schematu wynosi deff = 1 + (9.6 − 1) × .05 = 1.43. Efektywna liczebność to 240/1.43 ≈ 168 osób, a margines ±7.4 pp. Poprawka na populację 5000 osób zmienia te marginesy tylko o 0.1–0.2 pp.
Czego ten wykres nie pokazuje. Odsetek odpowiedzi zmniejsza tu tylko liczebność. Groves (2006) zwraca uwagę, że brak odpowiedzi może, ale nie musi, powodować obciążenie oszacowań. W syntezie badań obciążenie występowało jednak często, a jego korekta po badaniu wymaga dobrych zmiennych pomocniczych. Tego żaden margines nie pokazuje. O błędzie braku odpowiedzi i ważeniu piszemy w próbie reprezentatywnej w obrazkach, a o losowaniu grup – w schematach losowania w obrazkach. ICC i odsetek odpowiedzi przyjęliśmy ręcznie. Jak zaplanować liczbę zaproszeń przy niepewnym odsetku odpowiedzi, opisuje wpis ile zaproszeń wysłać.
Podpis do pracy:
Zdanie do Metody:
Co z tego przenieść do pracy
- Nie uzasadniaj próby procentem populacji. Podaj wymaganą precyzję (margines) albo analizę mocy i wynikającą z niej liczbę osób (rysunek 5).
- Duża populacja nie jest przeszkodą. Przy 400 osobach margines jest prawie taki sam dla 10 000 i 38 mln osób (rysunki 2–3). Poprawkę podawaj, gdy próba to wyraźna część populacji.
- Mała populacja – zbadaj wszystkich. Gdy potrzebna liczba osób zbliża się do całej populacji albo ją przekracza po uwzględnieniu odsetka odpowiedzi, losowanie nic nie daje (rysunek 4).
- Licz na efektywne n, nie na liczbę zaproszeń. Odsetek odpowiedzi i losowanie grup zmniejszają liczebność bardziej niż poprawka na populację (rysunek 6).
- Próba dostępna to inna sytuacja. Jeśli nie losowałeś(-aś), napisz to wprost i nie wnioskuj o całej populacji tylko dlatego, że ankiet jest dużo. Zasady eksportu rysunków są we wpisie wykresy w pracy dyplomowej.
Kod R wszystkich rysunków i liczb
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje motyw, paletę i funkcję margines(), z których korzystają następne. Każdy przepis tworzy obiekt wykresu (p1–p6); wpisz jego nazwę, żeby go wyświetlić, a do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG.
Wszystkie populacje są fikcyjne. Ręcznie ustaliliśmy: wielkości populacji (200, 1000, 10 000, 50 000 i 38 mln oraz 120 osób), prawdziwy odsetek 40% w przepisie 3, parametry skali wypalenia (średnia 22 i SD 6 pkt przed zaokrągleniem) w przepisie 4 oraz w przepisie 6 – liczbę grup, odsetek odpowiedzi 60% i korelację wewnątrzgrupową .05. Każdy blok, który losuje (przepisy 1, 3 i 4), zaczyna od set.seed(589); przepis 4 ustawia to ziarno ponownie przed drugą symulacją. Ziarno ustaliliśmy raz i go nie zmienialiśmy. Symulacje mają 1000 powtórzeń (przepis 3) i 2 × 10 000 powtórzeń (przepis 4). Populację 120 pielęgniarek pobierzesz jako plik wielkosc-proby-populacja-120-pielegniarek.csv (kolumny osoba i wynik).
1. Motyw, paleta, funkcja margines() i mapy populacji: Rysunek 1
R
# Rysunek 1. Ta sama próba (n = 100) w trzech populacjach: 200, 1000 i 10 000 osób
options(width = 100)
library(ggplot2)
library(patchwork)

# Krótki motyw i paleta Okabe–Ito (sprawdzona w symulacji deuteranopii; kolor wspiera rodzaj linii i kształt)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol_N <- c("N = 200" = "#D55E00", "N = 1000" = "#009E73", "N = 10 000" = "#56B4E9", "N = 38 mln" = "#0f1d3a")
lin_N <- c("N = 200" = "solid", "N = 1000" = "42", "N = 10 000" = "22", "N = 38 mln" = "11")

# Margines błędu (połowa szerokości 95% CI) dla odsetka przy próbie n z populacji N, w punktach procentowych.
# Poprawka na skończoną populację: pierwiastek z (N − n) / (N − 1); przy n = N margines spada do zera.
margines <- function(n, N = Inf, odsetek = 0.5, ufnosc = 0.95) {
  fpc <- sqrt(pmax(N - n, 0) / (N - 1))
  fpc[is.infinite(N)] <- 1                       # N = Inf: bez poprawki
  100 * qnorm(1 - (1 - ufnosc) / 2) * sqrt(odsetek * (1 - odsetek) / n) * fpc
}

# Trzy fikcyjne populacje jako „mapy”: każda kratka to jedna osoba; z każdej losujemy bez zwracania 100 osób
set.seed(589)                                   # ziarno ustalone raz, bez dobierania pod wynik
populacje <- data.frame(N = c(200, 1000, 10000), kolumny = c(20, 40, 100))
n_proby <- 100
mapy <- lapply(seq_len(nrow(populacje)), function(i) {
  N <- populacje$N[i]; k <- populacje$kolumny[i]
  d <- data.frame(osoba = 1:N, x = (0:(N - 1)) %% k + 1, y = (0:(N - 1)) %/% k + 1)
  d$w_probie <- d$osoba %in% sample(N, n_proby)          # losowanie bez zwracania
  d
})
podsum <- data.frame(N = populacje$N, n = n_proby,
                     odsetek_populacji = 100 * n_proby / populacje$N,
                     margines_bez_poprawki = margines(n_proby),
                     margines_z_poprawka = margines(n_proby, populacje$N))
podsum <- rbind(podsum, data.frame(N = 38e6, n = n_proby, odsetek_populacji = 100 * n_proby / 38e6,
                                   margines_bez_poprawki = margines(n_proby), margines_z_poprawka = margines(n_proby, 38e6)))
podsum$odsetek_populacji <- signif(podsum$odsetek_populacji, 3)
podsum$margines_bez_poprawki <- round(podsum$margines_bez_poprawki, 2)
podsum$margines_z_poprawka <- round(podsum$margines_z_poprawka, 2)
format(podsum, scientific = FALSE, big.mark = " ")

rysuj_mape <- function(d, tytul, podtytul) {
  ggplot(d, aes(x, y, fill = w_probie)) +
    geom_raster() +
    scale_fill_manual(values = c("FALSE" = "grey86", "TRUE" = "#0f1d3a"),
                      labels = c("FALSE" = "poza próbą", "TRUE" = "w próbie"), name = NULL) +
    coord_fixed(expand = FALSE) +
    labs(title = tytul, subtitle = podtytul, x = NULL, y = NULL) + motyw +
    theme(axis.text = element_blank(), panel.grid = element_blank(), legend.position = "none")
}
opis_mapy <- function(i) sprintf("n = 100 to %s%% populacji\nmargines ±%.1f pp", format(podsum$odsetek_populacji[i]),
                                 podsum$margines_z_poprawka[i])
pA <- rysuj_mape(mapy[[1]], "A. N = 200", opis_mapy(1))
pB <- rysuj_mape(mapy[[2]], "B. N = 1000", opis_mapy(2))
pC <- rysuj_mape(mapy[[3]], "C. N = 10 000", opis_mapy(3))
pD <- ggplot() +
  annotate("text", x = 0, y = 0.5, hjust = 0, size = 4.4, lineheight = 1.1, colour = "#0f1d3a",
           label = sprintf("D. N = 38 mln (kraj)\n\nn = 100 to %.5f%% populacji –\nza mało, by narysować kratki.\n\nMargines ±%.1f pp:\ntaki sam jak w C.",
                           podsum$odsetek_populacji[4], podsum$margines_z_poprawka[4])) +
  xlim(0, 1) + ylim(0, 1) + theme_void()
p1 <- (pA + pB) / (pC + pD) +
  plot_annotation(title = "Ta sama próba 100 osób w populacjach różnej wielkości",
                  subtitle = "Kratka = osoba; ciemne kratki = osoby wylosowane do próby (odsetek 50%, 95% CI)",
                  theme = motyw)
# p1   # zapis: ggsave("wielkosc-proby-mapa-populacji.svg", p1, width = 10, height = 9)
Wynik w R
           N   n odsetek_populacji margines_bez_poprawki margines_z_poprawka
1        200 100         50.000000                   9.8                6.95
2      1 000 100         10.000000                   9.8                9.30
3     10 000 100          1.000000                   9.8                9.75
4 38 000 000 100          0.000263                   9.8                9.80
2. Krzywe marginesu błędu: Rysunek 2
R
# Rysunek 2. Margines błędu odsetka 50% w funkcji liczebności próby dla czterech wielkości populacji
# (kontynuacja: motyw, kol_N, lin_N i margines() z bloku 1)
wielkosci <- c("N = 200" = 200, "N = 1000" = 1000, "N = 10 000" = 1e4, "N = 38 mln" = 38e6)
d2 <- do.call(rbind, lapply(names(wielkosci), function(et) {
  N <- wielkosci[[et]]
  n <- unique(round(10^seq(log10(30), log10(min(N, 1e4)), length.out = 300)))
  data.frame(populacja = et, n = n, margines = margines(n, N))
}))
d2$populacja <- factor(d2$populacja, levels = names(wielkosci))

# Tabela: margines (pp) przy wybranych n; NA = próba większa niż populacja
n_tab <- c(50, 100, 200, 400, 1000, 2000)
tab2 <- sapply(wielkosci, function(N) { m <- margines(pmin(n_tab, N), N); m[n_tab > N] <- NA; m })
rownames(tab2) <- paste("n =", n_tab)
round(tab2, 2)

koniec <- do.call(rbind, lapply(split(d2, d2$populacja), function(d) d[nrow(d), ]))   # ostatni punkt linii
p2 <- ggplot(d2, aes(n, margines, colour = populacja, linetype = populacja)) +
  geom_hline(yintercept = c(3, 5), colour = "grey55", linewidth = 0.4, linetype = "dotted") +
  geom_line(linewidth = 1.1) +
  geom_point(data = koniec, size = 2.6) +
  annotate("text", x = 32, y = c(3, 5), label = c("±3 pp", "±5 pp"), vjust = -0.4, hjust = 0, size = 3.6, colour = "grey35") +
  annotate("text", x = 2600, y = 4.2, hjust = 0.5, size = 3.6, lineheight = 0.95, colour = "grey25",
           label = "kropka na końcu linii:\nn = N, zbadano wszystkich\n(dla 38 mln: n = 10 000)") +
  scale_x_log10(breaks = c(30, 100, 200, 400, 1000, 2000, 1e4), labels = scales::label_number(big.mark = " ")) +
  scale_y_continuous(limits = c(0, 18), breaks = seq(0, 18, 3)) +
  scale_colour_manual(values = kol_N, name = NULL) + scale_linetype_manual(values = lin_N, name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Liczebność próby n (skala logarytmiczna)", y = "Margines błędu (± punkty procentowe)",
       title = "Margines błędu zależy od n; od N – dopiero gdy próba to duża część populacji",
       subtitle = "Odsetek 50%, 95% CI, losowanie bez zwracania z poprawką na skończoną populację") + motyw
# p2   # zapis: ggsave("wielkosc-proby-margines-a-n.svg", p2, width = 10, height = 6.4)
Wynik w R
         N = 200 N = 1000 N = 10 000 N = 38 mln
n = 50     12.03    13.51      13.83      13.86
n = 100     6.95     9.30       9.75       9.80
n = 200     0.00     6.20       6.86       6.93
n = 400       NA     3.80       4.80       4.90
n = 1000      NA     0.00       2.94       3.10
n = 2000      NA       NA       1.96       2.19
3. 1000 sondaży w trzech populacjach: Rysunek 3
R
# Rysunek 3. 1000 sondaży po n = 1000 osób: populacja 2000 osób, miasto 50 000 i kraj 38 mln
# (kontynuacja: motyw, margines() z bloku 1)
set.seed(589)                                   # ziarno ustalone raz, bez dobierania pod wynik
p_prawdziwe <- 0.40                             # fikcyjnie: 40% osób uprawia sport co najmniej raz w tygodniu
n_sondazu <- 1000; R <- 1000
miejsca <- c("2000 osób (n/N = 50%)" = 2000, "miasto: 50 000 (n/N = 2%)" = 5e4, "kraj: 38 mln (n/N = 0.003%)" = 38e6)
# rhyper() losuje liczbę osób „tak” w próbie bez zwracania z populacji o N osobach, w tym 40% „tak”
d3 <- do.call(rbind, lapply(names(miejsca), function(et) {
  N <- miejsca[[et]]; tak <- round(p_prawdziwe * N)
  data.frame(populacja = et, N = N, odsetek = 100 * rhyper(R, m = tak, n = N - tak, k = n_sondazu) / n_sondazu)
}))
d3$populacja <- factor(d3$populacja, levels = names(miejsca))

# Rozrzut 1000 oszacowań (SD) i margines z symulacji (1.96 × SD) vs wzór bez poprawki i z poprawką
wyn3 <- do.call(rbind, lapply(split(d3, d3$populacja), function(d) {
  N <- d$N[1]; se_bez <- 100 * sqrt(p_prawdziwe * (1 - p_prawdziwe) / n_sondazu)
  data.frame(N = N, srednia = mean(d$odsetek), SD_symulacja = sd(d$odsetek),
             SE_wzor_bez_poprawki = se_bez, SE_wzor_z_poprawka = se_bez * sqrt((N - n_sondazu) / (N - 1)),
             margines_symulacja = 1.96 * sd(d$odsetek),
             w_przedziale_95 = mean(abs(d$odsetek - 100 * p_prawdziwe) <= qnorm(.975) * se_bez * sqrt((N - n_sondazu) / (N - 1))))
}))
wyn3$blad_MC_pp <- 100 * sqrt(wyn3$w_przedziale_95 * (1 - wyn3$w_przedziale_95) / R)   # błąd Monte Carlo odsetka
round(wyn3[, -1], 3)

# Panel B: margines dla n = 1000 (i n = 400) w funkcji wielkości populacji N
dB <- expand.grid(N = round(10^seq(log10(1000), log10(38e6), length.out = 400)), n = c(400, 1000))
dB <- dB[dB$N >= dB$n, ]
dB$margines <- margines(dB$n, dB$N, odsetek = p_prawdziwe)
dB$proba <- factor(paste("n =", dB$n), levels = c("n = 400", "n = 1000"))
punkty3 <- data.frame(N = unname(miejsca), margines = margines(n_sondazu, unname(miejsca), odsetek = p_prawdziwe))
format(transform(punkty3, margines = round(margines, 2)), scientific = FALSE, big.mark = " ")

p3a <- ggplot(d3, aes(odsetek)) +
  geom_histogram(binwidth = 0.5, boundary = 0, fill = "#9FD3F2", colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 100 * p_prawdziwe, colour = "#D55E00", linewidth = 1) +
  facet_wrap(~ populacja, ncol = 1) +
  scale_x_continuous(limits = c(34, 46), breaks = seq(34, 46, 2)) +
  labs(x = "Odsetek „tak” w sondażu (%)", y = "Liczba sondaży",
       title = "A. 1000 sondaży po 1000 osób",
       subtitle = "Pionowa linia: prawdziwe 40%") + motyw
p3b <- ggplot(dB, aes(N, margines, linetype = proba)) +
  geom_line(colour = "#0072B2", linewidth = 1.1) +
  geom_point(data = punkty3, aes(N, margines), inherit.aes = FALSE, shape = 21, size = 3.2,
             fill = "#D55E00", colour = "grey10") +
  scale_x_log10(breaks = c(1e3, 1e4, 1e5, 1e6, 1e7), labels = c("1 tys.", "10 tys.", "100 tys.", "1 mln", "10 mln")) +
  scale_y_continuous(limits = c(0, 5.2), breaks = 0:5) +
  scale_linetype_manual(values = c("n = 400" = "22", "n = 1000" = "solid"), name = NULL) +
  labs(x = "Wielkość populacji N (skala logarytmiczna)", y = "Margines błędu (± pp)",
       title = "B. Margines a wielkość populacji",
       subtitle = "Odsetek 40%; kółka: populacje z A") + motyw
p3 <- p3a + p3b
# p3   # zapis: ggsave("wielkosc-proby-miasto-i-kraj.svg", p3, width = 10, height = 7)
Wynik w R
                            srednia SD_symulacja SE_wzor_bez_poprawki SE_wzor_z_poprawka
2000 osób (n/N = 50%)        39.888        1.131                1.549              1.096
miasto: 50 000 (n/N = 2%)    40.054        1.539                1.549              1.534
kraj: 38 mln (n/N = 0.003%)  39.959        1.540                1.549              1.549
                            margines_symulacja w_przedziale_95 blad_MC_pp
2000 osób (n/N = 50%)                    2.218           0.942      0.739
miasto: 50 000 (n/N = 2%)                3.016           0.956      0.649
kraj: 38 mln (n/N = 0.003%)              3.018           0.962      0.605
           N margines
1      2 000     2.15
2     50 000     3.01
3 38 000 000     3.04
4. Populacja 120 osób: poprawka i symulacja: Rysunek 4
R
# Rysunek 4. Mała populacja: 120 pielęgniarek jednego szpitala
# (kontynuacja: motyw, margines() z bloku 1)
set.seed(589)                                   # ziarno ustalone raz, bez dobierania pod wynik
N_mala <- 120
# Fikcyjna populacja: wynik skali wypalenia 0–40 pkt (parametry 22 i 6 pkt ustawione ręcznie)
kadra <- data.frame(osoba = 1:N_mala, wynik = pmin(pmax(round(rnorm(N_mala, mean = 22, sd = 6)), 0), 40))
# write.csv(kadra, "wielkosc-proby-populacja-120-pielegniarek.csv", row.names = FALSE)   # ten sam plik CSV
mu <- mean(kadra$wynik); S <- sd(kadra$wynik)    # prawdziwa średnia i SD populacji (znane, bo dane są fikcyjne)
round(c(N = N_mala, srednia_populacji = mu, SD_populacji = S), 3)

# Panel A: ile osób potrzeba do marginesu ±5 pp (odsetek 50%) z poprawką i bez niej
n0 <- qnorm(.975)^2 * 0.25 / 0.05^2              # wzór dla bardzo dużej populacji
n_fpc <- ceiling(n0 / (1 + (n0 - 1) / N_mala))   # z poprawką na skończoną populację
c(n_bez_poprawki = ceiling(n0), n_z_poprawka = n_fpc, odsetek_kadry = round(100 * n_fpc / N_mala, 1),
  zaproszenia_przy_60_proc_odpowiedzi = ceiling(n_fpc / 0.60))
round(c(margines_n60_bez = margines(60), margines_n60_z = margines(60, N_mala),
        margines_n100_z = margines(100, N_mala)), 2)

# Panel B: 10 000 prób po 60 osób losowanych bez zwracania; rozkład średnich vs dwa wzory na błąd standardowy
n_mala <- 60; R4 <- 10000
srednie <- replicate(R4, mean(sample(kadra$wynik, n_mala)))
se_bez <- S / sqrt(n_mala)
se_z <- S / sqrt(n_mala) * sqrt(1 - n_mala / N_mala)   # to samo co SD_N/√n × √[(N − n)/(N − 1)]
round(c(SD_srednich_symulacja = sd(srednie), SE_wzor_bez_poprawki = se_bez, SE_wzor_z_poprawka = se_z), 3)

# Pokrycie 95% przedziału t (z próby) bez poprawki i z poprawką – 10 000 nowych prób, błąd Monte Carlo
set.seed(589)
trafienia <- replicate(R4, {
  x <- sample(kadra$wynik, n_mala); se <- sd(x) / sqrt(n_mala); t <- qt(.975, n_mala - 1)
  c(bez = abs(mean(x) - mu) <= t * se, z = abs(mean(x) - mu) <= t * se * sqrt(1 - n_mala / N_mala))
})
pokrycie <- rowMeans(trafienia)
round(rbind(pokrycie_proc = 100 * pokrycie, blad_MC_pp = 100 * sqrt(pokrycie * (1 - pokrycie) / R4)), 2)

dA <- data.frame(n = rep(10:N_mala, 2), rodzaj = rep(c("bez poprawki", "z poprawką (N = 120)"), each = N_mala - 9))
dA$margines <- ifelse(dA$rodzaj == "bez poprawki", margines(dA$n), margines(dA$n, N_mala))
p4a <- ggplot(dA, aes(n, margines, linetype = rodzaj, colour = rodzaj)) +
  annotate("rect", xmin = n_fpc, xmax = N_mala, ymin = -Inf, ymax = Inf, fill = "#E69F00", alpha = 0.15) +
  geom_hline(yintercept = 5, colour = "grey55", linetype = "dotted") +
  geom_line(linewidth = 1.1) +
  annotate("point", x = n_fpc, y = margines(n_fpc, N_mala), size = 3.2, shape = 21, fill = "#D55E00", colour = "grey10") +
  annotate("text", x = n_fpc - 2, y = 22, hjust = 1, size = 3.7, lineheight = 0.95,
           label = sprintf("±5 pp wymaga\n%d z 120 osób\n(%.0f%% kadry)", n_fpc, 100 * n_fpc / N_mala)) +
  scale_colour_manual(values = c("bez poprawki" = "grey45", "z poprawką (N = 120)" = "#0072B2"), name = NULL) +
  scale_linetype_manual(values = c("bez poprawki" = "22", "z poprawką (N = 120)" = "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 120, 20)) + scale_y_continuous(limits = c(0, 32), breaks = seq(0, 30, 5)) +
  labs(x = "Liczba osób w próbie n", y = "Margines błędu (± pp)", title = "A. Margines dla odsetka 50%",
       subtitle = "Pole pomarańczowe: zbadaj wszystkich") + motyw +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1))
siatka4 <- seq(mu - 4 * se_bez, mu + 4 * se_bez, length.out = 300)
krzywe4 <- data.frame(x = rep(siatka4, 2), wzor = rep(c("bez poprawki", "z poprawką"), each = 300),
                      y = c(dnorm(siatka4, mu, se_bez), dnorm(siatka4, mu, se_z)))
p4b <- ggplot(data.frame(srednia = srednie), aes(srednia)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.1, fill = "#9FD3F2", colour = NA) +
  geom_line(data = krzywe4, aes(x, y, linetype = wzor, colour = wzor), linewidth = 1) +
  geom_vline(xintercept = mu, colour = "#D55E00", linewidth = 0.9) +
  scale_colour_manual(values = c("bez poprawki" = "grey45", "z poprawką" = "#0072B2"), name = "Wzór na SE:") +
  scale_linetype_manual(values = c("bez poprawki" = "22", "z poprawką" = "solid"), name = "Wzór na SE:") +
  labs(x = "Średnia w próbie 60 osób (pkt)", y = "Gęstość",
       title = "B. 10 000 prób po 60 osób",
       subtitle = sprintf("SD średnich %.2f; SE ze wzoru %.2f / %.2f", sd(srednie), se_z, se_bez)) + motyw +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1))
p4 <- p4a + p4b
# p4   # zapis: ggsave("wielkosc-proby-mala-populacja.svg", p4, width = 10, height = 6)
Wynik w R
                N srednia_populacji      SD_populacji
          120.000            21.550             5.583
                     n_bez_poprawki                        n_z_poprawka
                              385.0                                92.0
                      odsetek_kadry zaproszenia_przy_60_proc_odpowiedzi
                               76.7                               154.0
margines_n60_bez   margines_n60_z  margines_n100_z
           12.65             8.98             4.02
SD_srednich_symulacja  SE_wzor_bez_poprawki    SE_wzor_z_poprawka
                0.514                 0.721                 0.510
                bez     z
pokrycie_proc 99.34 95.02
blad_MC_pp     0.08  0.22
5. Potrzebne n i procent populacji: Rysunek 5
R
# Rysunek 5. Ile osób potrzeba do marginesu ±5 i ±3 pp – w liczbach i jako procent populacji
# (kontynuacja: motyw, margines() z bloku 1)
potrzebne_n <- function(N, e, odsetek = 0.5) {         # n0 dla dużej populacji, potem poprawka na skończoną populację
  n0 <- qnorm(.975)^2 * odsetek * (1 - odsetek) / e^2
  ceiling(n0 / (1 + (n0 - 1) / N))
}
N_tab <- c(120, 200, 500, 1000, 2000, 5000, 10000, 1e5, 1e6, 38e6)
tab5 <- data.frame(N = N_tab, n_5pp = potrzebne_n(N_tab, 0.05), n_3pp = potrzebne_n(N_tab, 0.03))
tab5$proc_5pp <- round(100 * tab5$n_5pp / tab5$N, 3); tab5$proc_3pp <- round(100 * tab5$n_3pp / tab5$N, 3)
format(tab5, scientific = FALSE, big.mark = " ")

# Reguła „10% populacji” – jaki margines daje w populacjach różnej wielkości?
N_10 <- c(200, 1000, 10000, 1e5)
format(data.frame(N = N_10, n = N_10 / 10, margines_pp = round(margines(N_10 / 10, N_10), 2)), scientific = FALSE, big.mark = " ")

d5 <- expand.grid(N = round(10^seq(log10(100), log10(38e6), length.out = 400)), e = c(0.05, 0.03))
d5$n <- potrzebne_n(d5$N, d5$e)
d5$procent <- 100 * d5$n / d5$N
d5$margines <- factor(ifelse(d5$e == 0.05, "±5 pp", "±3 pp"), levels = c("±5 pp", "±3 pp"))
osx <- scale_x_log10(breaks = c(100, 1e3, 1e4, 1e5, 1e6, 1e7),
                     labels = c("100", "1 tys.", "10 tys.", "100 tys.", "1 mln", "10 mln"))
kol5 <- c("±5 pp" = "#0072B2", "±3 pp" = "#D55E00"); lin5 <- c("±5 pp" = "solid", "±3 pp" = "22")
p5a <- ggplot(d5, aes(N, n, colour = margines, linetype = margines)) +
  geom_line(data = data.frame(N = 100:1100, n = 100:1100), aes(N, n), inherit.aes = FALSE,
            colour = "grey60", linewidth = 0.5) +
  geom_line(linewidth = 1.1) +
  annotate("text", x = 1300, y = 1050, label = "n = N\n(cała populacja)", hjust = 0, vjust = 1, size = 3.5, colour = "grey40") +
  osx + scale_y_continuous(limits = c(0, 1100), breaks = seq(0, 1000, 200)) +
  scale_colour_manual(values = kol5, name = "Margines:") + scale_linetype_manual(values = lin5, name = "Margines:") +
  coord_cartesian(clip = "off") +
  labs(x = "Wielkość populacji N (log)", y = "Potrzebna liczba osób n",
       title = "A. Liczba osób", subtitle = "Rośnie, ale szybko przestaje") + motyw
p5b <- ggplot(d5, aes(N, procent, colour = margines, linetype = margines)) +
  geom_line(linewidth = 1.1) +
  osx + scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20), labels = function(x) paste0(x, "%")) +
  scale_colour_manual(values = kol5, name = "Margines:") + scale_linetype_manual(values = lin5, name = "Margines:") +
  labs(x = "Wielkość populacji N (log)", y = "n jako procent populacji",
       title = "B. Procent populacji", subtitle = "Spada niemal do zera") + motyw
p5 <- (p5a + p5b) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
# p5   # zapis: ggsave("wielkosc-proby-procent-populacji.svg", p5, width = 10, height = 6)
Wynik w R
            N n_5pp n_3pp proc_5pp proc_3pp
1         120    92   108   76.667   90.000
2         200   132   169   66.000   84.500
3         500   218   341   43.600   68.200
4       1 000   278   517   27.800   51.700
5       2 000   323   697   16.150   34.850
6       5 000   357   880    7.140   17.600
7      10 000   370   965    3.700    9.650
8     100 000   383 1 056    0.383    1.056
9   1 000 000   384 1 066    0.038    0.107
10 38 000 000   385 1 068    0.001    0.003
        N      n margines_pp
1     200     20       20.84
2   1 000    100        9.30
3  10 000  1 000        2.94
4 100 000 10 000        0.93
6. Odsetek odpowiedzi i efekt schematu: Rysunek 6
R
# Rysunek 6. Od liczby zaproszonych do efektywnej liczebności: braki odpowiedzi i efekt schematu
# (kontynuacja: motyw, margines() z bloku 1; ten blok nic nie losuje – same rachunki)
N_uczelnia <- 5000                               # fikcyjna uczelnia: 5000 studentów
grupy <- 25; zaproszeni <- 400                   # wylosowane całe grupy ćwiczeniowe (25 grup po 16 osób)
odsetek_odp <- 0.60; ICC <- 0.05                 # założenia ustawione ręcznie: 60% odpowiedzi, ICC = .05
odpowiedzi <- zaproszeni * odsetek_odp
m <- odpowiedzi / grupy                          # średnio respondentów w grupie
deff <- 1 + (m - 1) * ICC                        # efekt schematu dla doboru zespołowego (przybliżenie)
n_eff <- odpowiedzi / deff
etapy <- data.frame(
  etap = c("1. Plan: 400 osób, wszyscy odpowiadają", "2. Odpowiedziało 60%: 240 osób",
           sprintf("3. Dobór grupami (deff = %.2f): efektywnie %.0f", deff, n_eff)),
  n = c(zaproszeni, odpowiedzi, n_eff))
etapy$margines_bez_poprawki <- margines(etapy$n)
etapy$margines_z_poprawka <- margines(etapy$n, N_uczelnia)
round(c(m = m, deff = deff, n_eff = n_eff), 2)
etapy[, -1] <- round(etapy[, -1], 2); etapy

etapy$etap <- factor(etapy$etap, levels = rev(etapy$etap))
p6 <- ggplot(etapy, aes(y = etap)) +
  geom_vline(xintercept = 50, colour = "grey60", linewidth = 0.4) +
  geom_errorbar(aes(xmin = 50 - margines_z_poprawka, xmax = 50 + margines_z_poprawka),
                width = 0.25, linewidth = 1.1, colour = "#0072B2", orientation = "y") +
  geom_point(aes(x = 50), shape = 21, size = 3.4, fill = "#D55E00", colour = "grey10") +
  geom_text(aes(x = 50 + margines_z_poprawka, label = sprintf("±%.1f pp", margines_z_poprawka)),
            hjust = -0.25, size = 4, colour = "#0f1d3a") +
  scale_x_continuous(limits = c(38, 62), breaks = seq(40, 60, 5), labels = function(x) paste0(x, "%")) +
  labs(x = "Odsetek 50% z 95% przedziałem ufności", y = NULL,
       title = "Prawdziwe n jest mniejsze niż liczba zaproszeń",
       subtitle = "Uczelnia 5000 studentów; 95% CI z poprawką na skończoną populację") +
  motyw + theme(plot.title.position = "plot", panel.grid.major.y = element_blank(), axis.text.y = element_text(size = 12, colour = "grey15"))
# p6   # zapis: ggsave("wielkosc-proby-efektywne-n.svg", p6, width = 10, height = 4.6)
Wynik w R
     m   deff  n_eff
  9.60   1.43 167.83
                                            etap      n margines_bez_poprawki margines_z_poprawka
1         1. Plan: 400 osób, wszyscy odpowiadają 400.00                  4.90                4.70
2                 2. Odpowiedziało 60%: 240 osób 240.00                  6.33                6.17
3 3. Dobór grupami (deff = 1.43): efektywnie 168 167.83                  7.56                7.44
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("mapa: w próbie / poza próbą (rysunek 1)" = c("#0f1d3a", "grey86"),
                "4 populacje (rysunek 2)" = c("#D55E00", "#009E73", "#56B4E9", "#0f1d3a"),
                "histogram, prawda, krzywa (rysunki 3–4)" = c("#9FD3F2", "#D55E00", "#0072B2", "grey45"),
                "±5 i ±3 pp (rysunek 5)" = c("#0072B2", "#D55E00"),
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
zestawy <- lapply(zestawy, function(k) rgb(t(col2rgb(k)), maxColorValue = 255))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                        widzenie_typowe deuteranopia protanopia
mapa: w próbie / poza próbą (rysunek 1)            79.2         79.9       77.6
4 populacje (rysunek 2)                            59.5         48.8       37.3
histogram, prawda, krzywa (rysunki 3–4)            40.5         39.5       38.2
±5 i ±3 pp (rysunek 5)                            114.6        108.3       91.9
czerwony – zielony (dla porównania)               121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie bez zwracania, rozkład hipergeometryczny i kwantyle – pakiety base i stats). Rysunki wykonano w ggplot2 z opisami osi z pakietu scales, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Próba stanowi X% populacji, więc jest wystarczająca”. Procent populacji nie mówi o precyzji (rysunek 5).
- Pominięcie poprawki, gdy zbadano połowę populacji. Przedział wychodzi wtedy niepotrzebnie szeroki (rysunek 4).
- Margines policzony z liczby zaproszeń zamiast z liczby odpowiedzi i bez efektu schematu (rysunek 6).
Najczęstsze pytania
Czy większa populacja wymaga większej próby?
Przy doborze losowym – prawie nie, gdy populacja liczy kilkadziesiąt tysięcy osób lub więcej. Dla odsetka 50% i 95% CI margines ±5 pp wymaga 370 osób przy populacji 10 000 i 385 przy 38 mln. Liczebność rośnie wyraźnie tylko w małych populacjach: 132 osoby przy 200 i 278 przy 1000. W 1000 symulowanych sondaży po 1000 osób rozrzut wyników był niemal taki sam w mieście 50 000 osób i w kraju 38 mln (SD 1.539 i 1.540 pp).
Czy próba stanowiąca 10% populacji wystarczy?
Stały procent populacji nie gwarantuje precyzji. Przy populacji 200 osób 10% to 20 osób i margines ±20.8 pp, przy 1000 osób – ±9.3 pp, przy 10 000 – ±2.9 pp, a przy 100 000 – ±0.9 pp. Liczebność ustalaj z wymaganej precyzji albo z analizy mocy, a nie z procentu populacji.
Od jakiego odsetka populacji w próbie warto uwzględnić poprawkę na skończoną populację?
Poprawka mnoży błąd standardowy przez √[(N − n)/(N − 1)], więc liczy się, gdy próba to wyraźna część populacji. Przy 100 osobach z 10 000 (1%) zmienia margines z ±9.80 na ±9.75 pp, przy 100 z 1000 (10%) – na ±9.30 pp, a przy 100 z 200 (50%) – na ±6.95 pp. W symulacji z populacją 120 osób przedział t bez poprawki objął średnią w 99.34% prób zamiast 95%, a z poprawką – w 95.02%.
Czy w małej populacji lepiej losować próbę, czy zbadać wszystkich?
Gdy potrzebna liczba osób zbliża się do wielkości populacji, losowanie traci sens. W kadrze 120 pielęgniarek margines ±5 pp wymaga 92 osób (77%), a przy oczekiwanych 60% odpowiedzi trzeba by zaprosić 154 osoby – więcej, niż liczy kadra. Zaproś wtedy wszystkich i opisz badanie jako pełne; zbadanie (prawie) całej populacji to jeden z uznanych sposobów uzasadnienia liczebności (Lakens, 2022).
Dlaczego efektywna liczebność próby jest mniejsza niż liczba ankiet?
Bo precyzję obniżają braki odpowiedzi i efekt schematu. W przykładzie z 400 zaproszeń w 25 grupach ćwiczeniowych odpowiedziało 240 osób (60%), a przy korelacji wewnątrzgrupowej .05 efekt schematu wyniósł 1.43, więc efektywnie zostało około 168 osób. Margines dla odsetka 50% wzrósł z ±4.7 do ±7.4 pp. Brak odpowiedzi może też obciążyć wynik, czego margines nie pokazuje.
Powiązane hasła
Przeczytaj też
Kalkulator przedziału ufności z poprawką na skończoną populację
Odsetek i średnia z populacji o znanej wielkości: przedział bez poprawki i z poprawką FPC, przedział dokładny, odsetek odpowiedzi i potrzebna liczebność.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikAnkieta wśród personelu jednego szpitala
Populacja czy próba, odsetek odpowiedzi w oddziałach, poprawka na skończoną populację w przedziale ufności, liczebność przy małej kadrze i anonimowość małych oddziałów – z przykładem w R.
Czytaj →PoradnikSondaż w obrazkach
Margines błędu a n i odsetek 50%, 1000 sondaży, różnica dwóch odsetków, duża ankieta online z błędem i liczba zaproszeń – sześć rysunków z R.
Czytaj →PoradnikSchematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →Nie wiesz, ile osób zbadać w swojej populacji?
Pomożemy ustalić liczebność próby z wymaganej precyzji lub analizy mocy, policzyć margines błędu z poprawką na skończoną populację i opisać dobór próby w rozdziale Metoda – tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Berk, R. A., Western, B., & Weiss, R. E. (1995). Statistical inference for apparent populations. Sociological Methodology, 25, 421. https://doi.org/10.2307/271073
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Krejcie, R. V., & Morgan, D. W. (1970). Determining sample size for research activities. Educational and Psychological Measurement, 30(3), 607–610. https://doi.org/10.1177/001316447003000308
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lohr, S. L. (2021). Sampling: Design and analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429298899
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election. The Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-aoas1161sf ● Otwarty dostęp
Cytowania BibTeX
@article{berk1995statistical, author={Berk, Richard A. and Western, Bruce and Weiss, Robert E.}, title={{Statistical inference for apparent populations}}, journal={Sociological Methodology}, year={1995}, volume={25}, pages={421}, doi={10.2307/271073}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{krejcie1970determining, author={Krejcie, Robert V. and Morgan, Daryle W.}, title={{Determining sample size for research activities}}, journal={Educational and Psychological Measurement}, year={1970}, volume={30}, number={3}, pages={607--610}, doi={10.1177/001316447003000308}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@book{lohr2021sampling, author={Lohr, Sharon L.}, title={{Sampling: Design and analysis (3rd ed.)}}, year={2021}, publisher={Chapman and Hall/CRC}, doi={10.1201/9780429298899}}@article{meng2018statistical, author={Meng, Xiao-Li}, title={{Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election}}, journal={The Annals of Applied Statistics}, year={2018}, volume={12}, number={2}, pages={685--726}, doi={10.1214/18-aoas1161sf}}