Ile osób to nie to samo co ile zaproszeń
Analiza mocy albo margines błędu mówi, ilu ukończonych ankiet potrzebujesz do analizy. Do skrzynek trafia jednak liczba zaproszeń, a między jedną a drugą liczbą stoją mnożnik utraty precyzji i trzy rodzaje strat w terenie. Prostą kalkulację „liczba osób ÷ odsetek odpowiedzi” dla pracy dyplomowej pokazujemy we wpisie gdzie znaleźć respondentów do ankiety, a sposoby uzasadnienia liczebności – w poradniku dobór liczebności próby i we wpisie o planowaniu liczebności na precyzję.
Ten wpis jest dla badacza, który losuje próbę z operatu (listy szkół, przychodni, pracowników) i musi podać liczbę zaproszeń w protokole lub wniosku grantowym. Przykład to sondaż nauczycieli w regionie: ok. 24 000 osób w ok. 1500 szkołach, średnio 16 nauczycieli na szkołę. Losujesz szkoły, a w wylosowanej szkole zapraszasz wszystkich nauczycieli z listy (dobór wielostopniowy z pełnym drugim stopniem). Celem jest odsetek nauczycieli z wysokim wypaleniem z marginesem ±3 pp (95%) dla regionu i ±5 pp dla szkół wiejskich. Wszystkie wartości wejściowe to założenia planistyczne; w praktyce bierzesz je z pilotażu, poprzednich edycji badania albo z literatury.
Łańcuch obliczeń krok po kroku
Klasyczne podręczniki doboru próby wyprowadzają liczebność z wariancji estymatora w danym schemacie (Kish, 1965; Lohr, 2021). Do planowania wystarczy sześć kroków:
Tu d to margines błędu, N – liczebność populacji, k – odsetek osób z listy, które kwalifikują się do badania, c – odsetek kwalifikujących się, do których zaproszenie dotarło, a r – odsetek odpowiedzi wśród osób, do których dotarło. Valliant, Dever i Kreuter (2018) poświęcają wpływowi takich wskaźników realizacji na liczebność próby osobny rozdział podręcznika.
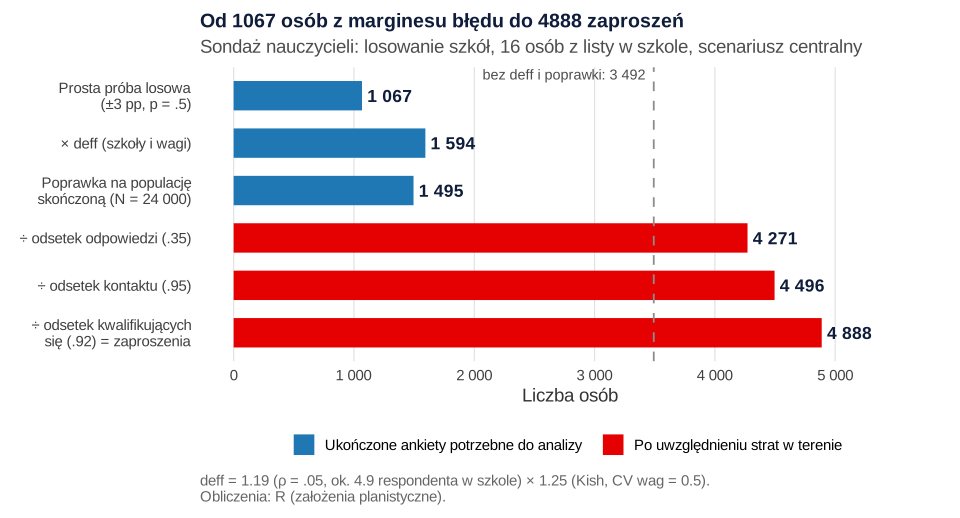
| Krok | Założenie | Wynik |
|---|---|---|
| 1. Prosta próba losowa | ±3 pp, p = .5, 95% | 1067 |
| 2. × efekt schematu | 1.19 (szkoły) × 1.25 (wagi) | 1594 |
| 3. Poprawka na populację skończoną | N = 24 000 | 1495 ukończonych ankiet |
| 4. ÷ odsetek odpowiedzi | r = .35 | 4271 |
| 5. ÷ odsetek kontaktu | c = .95 | 4496 |
| 6. ÷ odsetek kwalifikujących się | k = .92 | 4888 zaproszeń (306 szkół) |
Gdyby pominąć efekt schematu i poprawkę na populację, wyszłoby 3492 zaproszenia. Różnica nie wynika z ostrożności, tylko z dwóch źródeł utraty precyzji, które w tym planie naprawdę występują.
Efekt schematu: szkoły i wagi
Efekt schematu (deff) ma tu dwa składniki. Pierwszy to zgrupowanie: nauczyciele z jednej szkoły odpowiadają podobnie, więc deff = 1 + (m − 1)ρ, gdzie ρ to korelacja wewnątrzklasowa. Pojęcie efektu schematu upowszechnił klasyczny podręcznik Kisha (1965).
W miejsce m wstaw liczbę respondentów w grupie, a nie liczbę zaproszonych. W szkole zapraszasz 16 osób, ale przy odsetkach .92, .95 i .35 odpowie średnio 4.9. Przy ρ = .05 deff wynosi więc 1.19. Gdyby wstawić 16 zaproszonych, wyszłoby 1.75 i plan byłby niepotrzebnie zawyżony. Wynika z tego mniej oczywisty wniosek: niższy odsetek odpowiedzi zmniejsza liczbę respondentów w szkole, a więc i efekt klastrów. Liczbę zaproszeń zwiększa jednak znacznie silniej. Jeśli szkoły bardzo różnią się wielkością, wzór zaniża deff. Eldridge, Ashby i Kerry (2006) pokazali w badaniach z randomizacją klastrów, że poprawkę na nierówne klastry można pominąć dopiero przy współczynniku zmienności ich liczebności poniżej 0.23. Wartość ρ weź z wcześniejszych badań o podobnym schemacie albo przelicz w kalkulatorze ICC i efektu schematu.
Drugi składnik to wagi. Korekta braku odpowiedzi i raking różnicują wagi, a to obniża efektywną liczebność próby. Przybliżenie Kisha, 1 + CV² (CV – współczynnik zmienności wag), przy CV = 0.5 daje 1.25. Jak powstają wagi i jak liczyć ich koszt po zebraniu danych, opisujemy we wpisie ważenie danych sondażowych. W planowaniu oba składniki zwykle się mnoży.
Poprawka na populację skończoną w tym miejscu to uproszczenie. W doborze grupowym dotyczy ona właściwie frakcji wylosowanych szkół, a dokładniejsze wzory dla prób wielostopniowych podają Valliant i in. (2018). W przykładzie poprawka zmniejszyła potrzebną liczbę ankiet z 1594 do 1495.
Kwalifikacja, kontakt, odpowiedź: trzy mianowniki
Zamiast jednego „zwrotu” planuj trzy odsetki. Każdy ma inny mianownik, inne źródło danych i inaczej reaguje na Twoje działania:
- Kwalifikacja (k). Lista ze szkoły zawiera osoby na urlopach, przeniesione albo spoza populacji. Ten odsetek poprawia lepszy operat, a nie przypomnienia.
- Kontakt (c). Część adresów jest nieaktualna albo wiadomości nie docierają. Ten odsetek znasz po pierwszej wysyłce.
- Odpowiedź (r). Udział osób, do których zaproszenie dotarło. Na ten odsetek wpływają długość ankiety, zapowiedź badania, przypomnienia i zachęty, a metoda Dillmana zbiera te elementy w jeden plan kontaktów.
Rozdział odpowiada logice standardowych definicji AAPOR. Odróżniają one wskaźnik odpowiedzi od wskaźnika współpracy, opisują kryteria niekwalifikowania się i sposób liczenia odmów oraz braku kontaktu, a stowarzyszenie zaleca podawanie wskaźnika odpowiedzi według jednego z wzorów AAPOR (American Association for Public Opinion Research [AAPOR], b.d.). Warianty wskaźnika odpowiedzi różnią się głównie tym, jak liczą ankiety częściowe i przypadki o nieznanej kwalifikacji. W planie wybierz jeden wariant i używaj go w kalkulacji i w raporcie. Podstawowe miary opisuje hasło wskaźnik odpowiedzi.
Skąd brać wartości? Najlepiej z pilotażu albo poprzedniej edycji tego samego badania. Średnie z literatury traktuj jako zakres, a nie jako liczbę do wzoru. Metaanaliza ankiet internetowych w opublikowanych badaniach edukacyjnych dała średni odsetek odpowiedzi 44.1% (Wu i in., 2022). Inna metaanaliza wykazała, że ankiety internetowe uzyskują średnio o ok. 12 pp mniej odpowiedzi niż inne tryby, a różnica zależy m.in. od zapowiedzi badania, sposobu rekrutacji i liczby kontaktów (Daikeler i in., 2020).
Sam odsetek odpowiedzi nie mówi, czy wyniki są obciążone. Brak odpowiedzi może, ale nie musi wywoływać obciążenia (Groves, 2006), a AAPOR (b.d.) zaznacza, że związek odsetka odpowiedzi z jakością oszacowań jest mniej jasny, niż dawniej zakładano. Więcej zaproszeń zwiększa precyzję, ale nie usuwa błędu braku odpowiedzi. Bilans obu rodzajów błędu omawia wpis o całkowitym błędzie badania sondażowego.
Podgrupy: planuj dla najmniejszej
Jeśli wynik ma być podany osobno dla szkół wiejskich (30% nauczycieli, ok. 7200 osób), łańcuch liczysz najpierw dla tej podgrupy. Margines ±5 pp wymaga tam 532 ukończonych ankiet. Przy doborze proporcjonalnym wieś to 30% próby, więc potrzebujesz razem 1774 ankiet i 5800 zaproszeń. To dużo więcej, niż wymaga cel dla całego regionu.
Alternatywa to warstwowanie z nadreprezentacją wsi: 532 ankiety ze szkół wiejskich i tyle z miejskich, ile trzeba do ±3 pp dla regionu po ważeniu. Wystarczy 979 ankiet z miast, razem 1511 ankiet i 4941 zaproszeń. Koszt nierównej alokacji to dodatkowy efekt ważenia, tutaj tylko 1.01, bo udział wsi w próbie niewiele odbiega od udziału w populacji. Przy silniejszej nadreprezentacji ten efekt rośnie, więc licz go zawsze. Gdy w podgrupach planujesz porównania i testy, a nie same oszacowania, liczebność wyznacza analiza mocy dla mniejszej grupy (zob. ile osób do ankiety).
Scenariusze zamiast jednej liczby
Każde założenie łańcucha jest niepewne, dlatego w protokole podaj co najmniej trzy scenariusze. Poniżej zmieniają się jednocześnie ρ, zróżnicowanie wag i trzy odsetki.
| Scenariusz | Założenia (ρ; CV wag; k, c, r) | Respondenci w szkole | deff (szkoły × wagi) | Ankiety | Zaproszenia |
|---|---|---|---|---|---|
| Pesymistyczny | .08; 0.6; .88, .92, .25 | 3.2 | 1.18 × 1.36 | 1598 | 7896 |
| Centralny | .05; 0.5; .92, .95, .35 | 4.9 | 1.19 × 1.25 | 1495 | 4888 |
| Optymistyczny | .03; 0.4; .95, .98, .45 | 6.7 | 1.17 × 1.16 | 1368 | 3266 |
Rozpiętość od 3266 do 7896 zaproszeń wynika głównie z odsetka odpowiedzi. Efekt klastrów prawie się nie zmienia: w scenariuszu pesymistycznym wyższe ρ równoważy mniejsza liczba respondentów w szkole.
Ryzyko niedoboru: odsetek odpowiedzi jako zakres
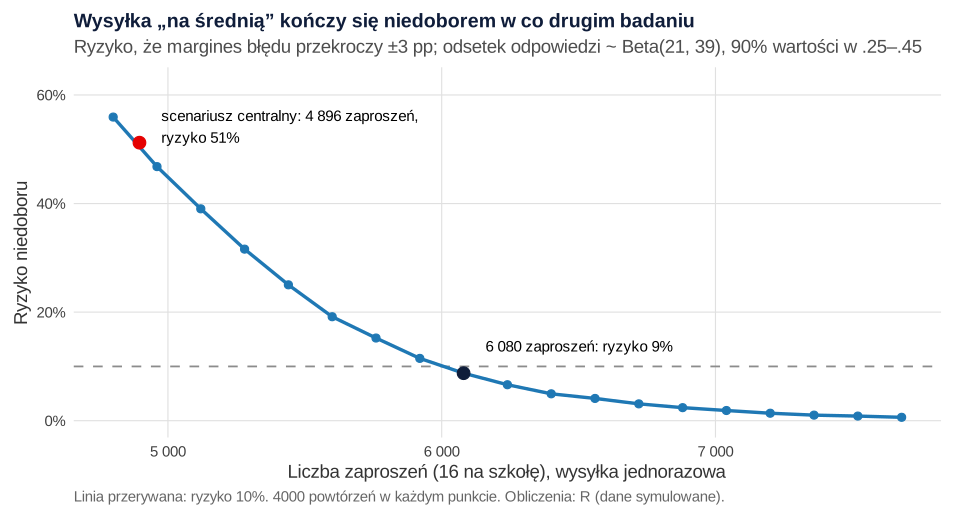
Scenariusze pokazują skrajności, ale nie mówią, jak prawdopodobny jest niedobór. Opisz więc odsetek odpowiedzi rozkładem. W przykładzie to rozkład beta ze średnią .35, w którym 90% wartości mieści się między .25 a .45, czyli w zakresie, który w praktyce bierzesz z pilotażu i poprzednich edycji badania. Symulacja 10 000 badań pokazuje, co daje wysyłka 4896 zaproszeń do 306 szkół. Mediana liczby ankiet wyniosła 1486, ale 90% wyników mieściło się między 1078 a 1934. Margines błędu przekroczył ±3 pp w 51.2% badań. Plan „na średnią” to więc rzut monetą.
Ta sama symulacja na siatce wielkości próby pokazuje, ile trzeba dołożyć. Przy 380 szkołach (6080 zaproszeniach) ryzyko spadło do 8.8%, a w niezależnym powtórzeniu wyniosło 9.1%. Przy 400 szkołach wyniosło 5.0%. Jednorazowa wysyłka z 90-procentową pewnością wymaga więc 6080 zaproszeń zamiast 4896.
Wysyłka etapowa z przypomnieniami
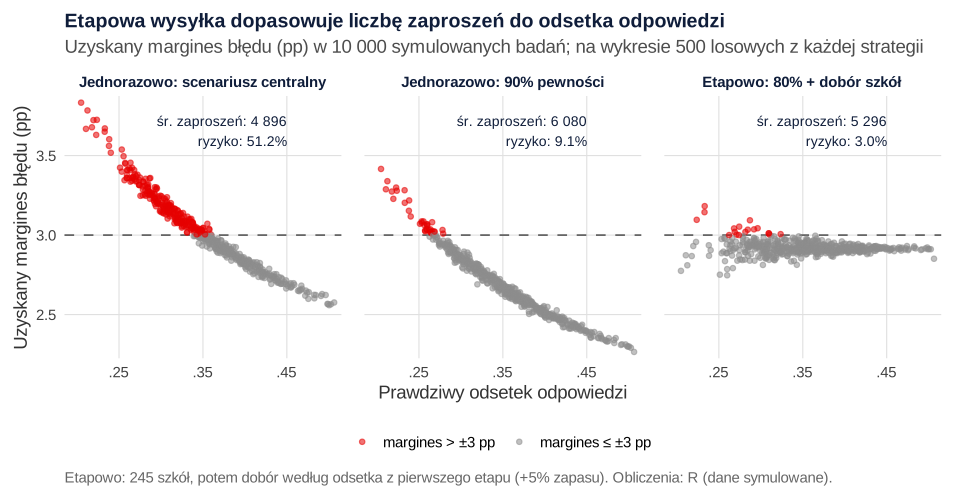
Zapas nie musi trafić do skrzynek od razu. Przed badaniem wylosuj z operatu pełną listę szkół i podziel ją na losowe porcje. Najpierw wyślij zaproszenia do 80% scenariusza centralnego (245 szkół) i przeprowadź pełny cykl przypomnień. Po zamknięciu tego etapu oszacuj odsetek odpowiedzi, przelicz łańcuch i otwórz tyle kolejnych porcji, ile trzeba, z 5-procentowym zapasem szkół. Ponieważ porcje są losowe, próba pozostaje próbą losową. W symulacji przyjęto, że w drugim etapie odsetek odpowiedzi może się przesunąć o kilka punktów, np. bliżej końca semestru.
Wysyłka etapowa wymagała średnio 5296 zaproszeń (90% badań: od 4208 do 6768), a ryzyko niedoboru wyniosło 3.0%. Jednorazowa wysyłka 6080 zaproszeń dała ryzyko 9.1% i średnio 1854 ankiety, czyli wyraźnie ponad potrzebę. Etapy kosztują czas, bo drugi etap ma ten sam cykl przypomnień co pierwszy. Nie zamykaj też badania w chwili osiągnięcia liczby ankiet, bo osoby odpowiadające szybko mogą różnić się od pozostałych. Czas odpowiedzi i moment wypełnienia warto przy tym zapisywać jako paradane, a w badaniu z kilkoma pomiarami tę samą logikę stosuje się do strat między falami (zob. ankieta w kilku falach).
Jak opisać plan liczby zaproszeń
Podaj cel precyzji, schemat, wartości ρ i CV wag ze źródłem, trzy odsetki ze źródłem, wynikową liczbę ukończonych ankiet i zaproszeń oraz to, co zrobisz, gdy odsetek odpowiedzi okaże się niższy.
Jeśli chcesz sprawdzić założenia łańcucha, policzyć scenariusze dla własnego operatu albo przygotować opis do wniosku, pomagamy w tym w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi korzysta z funkcji lancuch() i obiektu centr z pierwszego). Wystarczają funkcje podstawowe R; całość liczy się w kilka sekund. Zmień argumenty funkcji lancuch() na wartości ze swojego badania.
1. Łańcuch od marginesu błędu do zaproszeń, scenariusze i podgrupa
R
# Krok 1. Od marginesu błędu do liczby zaproszeń (sondaż nauczycieli, założenia planistyczne)
# Plan: losujemy szkoły, zapraszamy wszystkich nauczycieli z listy wylosowanej szkoły (średnio 16 osób).
lancuch <- function(moe = 0.03, pi0 = 0.5, N = 24000, rho = 0.05, cv_wag = 0.5, na_szkole = 16,
                    kwal = 0.92, kontakt = 0.95, odp = 0.35, ufnosc = 0.95) {
  z <- qnorm(1 - (1 - ufnosc) / 2)
  n0 <- z^2 * pi0 * (1 - pi0) / moe^2               # prosta próba losowa z populacji nieskończonej
  m <- na_szkole * kwal * kontakt * odp         # oczekiwana liczba respondentów w jednej szkole
  deff_klastry <- 1 + (m - 1) * rho             # zgrupowanie w szkołach
  deff_wagi <- 1 + cv_wag^2                     # Kish: zróżnicowanie wag
  n1 <- n0 * deff_klastry * deff_wagi
  n2 <- n1 / (1 + (n1 - 1) / N)                 # poprawka na populację skończoną
  ukonczone <- ceiling(n2)
  zaproszenia <- ceiling(ukonczone / (odp * kontakt * kwal))
  c(n0 = n0, m = m, deff_klastry = deff_klastry, deff_wagi = deff_wagi, po_deff = n1, po_fpc = n2,
    ukonczone = ukonczone, po_odp = ukonczone / odp, po_kontakcie = ukonczone / (odp * kontakt),
    zaproszenia = zaproszenia, szkoly = ceiling(zaproszenia / na_szkole))
}

# A. Scenariusz centralny krok po kroku: ±3 pp dla odsetka nauczycieli z wysokim wypaleniem
centr <- lancuch()
round(centr, 2)
cat("Błąd: deff z liczbą zaproszonych (16) zamiast respondentów w szkole:", round(1 + (16 - 1) * 0.05, 2), "\n")
cat("Bez deff i bez poprawki na populację (tylko ÷ odsetki):",
    ceiling(ceiling(centr[["n0"]]) / (0.35 * 0.95 * 0.92)), "zaproszeń\n")

# B. Scenariusze: pesymistyczny, centralny, optymistyczny
scen <- list(pesymistyczny = list(rho = 0.08, cv_wag = 0.6, kwal = 0.88, kontakt = 0.92, odp = 0.25),
             centralny     = list(),
             optymistyczny = list(rho = 0.03, cv_wag = 0.4, kwal = 0.95, kontakt = 0.98, odp = 0.45))
tab_scen <- t(sapply(scen, function(s) do.call(lancuch, s)[c("m", "deff_klastry", "deff_wagi", "ukonczone",
                                                             "zaproszenia", "szkoly")]))
print(round(tab_scen, 2))
write.csv(round(tab_scen, 3), "scenariusze.csv")

# C. Podgrupa: nauczyciele szkół wiejskich (30% populacji, 7200 osób) z marginesem ±5 pp
wies <- lancuch(moe = 0.05, N = 7200)
miasto_cel <- lancuch()                          # cała populacja: ±3 pp
n_wies <- wies[["ukonczone"]]
cat("Ukończone ankiety potrzebne na wsi:", n_wies, "\n")
cat("Dobór proporcjonalny (wieś = 30% próby): razem", ceiling(n_wies / 0.30), "ukończonych ankiet\n")

# Nadreprezentacja wsi: wieś n_wies, miasto tyle, ile trzeba do ±3 pp dla całości.
# Wagi warstw W_h / (n_h / n) dokładają efekt nierównej alokacji (Kish: 1 + CV² wag).
moe_calosc <- function(n_wies, n_miasto, W = c(0.30, 0.70), N = 24000, pi0 = 0.5, deff_inne = NULL) {
  n <- n_wies + n_miasto
  w <- c(rep(W[1] / (n_wies / n), n_wies), rep(W[2] / (n_miasto / n), n_miasto))
  deff_alok <- n * sum(w^2) / sum(w)^2        # = 1 + CV² wag
  if (is.null(deff_inne)) deff_inne <- miasto_cel[["deff_klastry"]] * miasto_cel[["deff_wagi"]]
  n_ef <- n / (deff_inne * deff_alok)
  c(n = n, deff_alok = deff_alok, moe = qnorm(.975) * sqrt(pi0 * (1 - pi0) / n_ef * (1 - n / N)))
}
n_miasto <- n_wies
while (moe_calosc(n_wies, n_miasto)[["moe"]] > 0.03) n_miasto <- n_miasto + 1
round(moe_calosc(n_wies, n_miasto), 4)
cat("Nadreprezentacja wsi: wieś", n_wies, "+ miasto", n_miasto, "=", n_wies + n_miasto, "ukończonych ankiet\n")
zapr <- function(n) ceiling(n / (0.35 * 0.95 * 0.92))
cat("Zaproszenia: proporcjonalnie", zapr(ceiling(n_wies / 0.30)), "| z nadreprezentacją", zapr(n_wies) + zapr(n_miasto), "\n")
Wynik w R
          n0            m deff_klastry    deff_wagi      po_deff       po_fpc
     1067.07         4.89         1.19         1.25      1593.57      1494.40
   ukonczone       po_odp po_kontakcie  zaproszenia       szkoly
     1495.00      4271.43      4496.24      4888.00       306.00
Błąd: deff z liczbą zaproszonych (16) zamiast respondentów w szkole: 1.75
Bez deff i bez poprawki na populację (tylko ÷ odsetki): 3492 zaproszeń
                 m deff_klastry deff_wagi ukonczone zaproszenia szkoly
pesymistyczny 3.24         1.18      1.36      1598        7896    494
centralny     4.89         1.19      1.25      1495        4888    306
optymistyczny 6.70         1.17      1.16      1368        3266    205
Ukończone ankiety potrzebne na wsi: 532
Dobór proporcjonalny (wieś = 30% próby): razem 1774 ukończonych ankiet
        n deff_alok       moe
1511.0000    1.0119    0.0300
Nadreprezentacja wsi: wieś 532 + miasto 979 = 1511 ukończonych ankiet
Zaproszenia: proporcjonalnie 5800 | z nadreprezentacją 4941
2. Niepewny odsetek odpowiedzi, ryzyko niedoboru i wysyłka etapowa
R
# Krok 2. Niepewny odsetek odpowiedzi: ile ukończonych ankiet naprawdę dostaniesz?
# (wymaga funkcji lancuch() i obiektu centr z kroku 1)
# Odsetek odpowiedzi nie jest znany: opisujemy go rozkładem beta o średniej .35 i 90% wartości w ok. .25–.45
a <- 21; b <- 39
round(c(srednia = a / (a + b), q05 = qbeta(.05, a, b), q95 = qbeta(.95, a, b)), 3)

# Jedno badanie: wylosowane szkoły, w każdej 16 osób z listy; uzyskany margines błędu przy p = .5
uzyskany_moe <- function(n, szkoly, rho = 0.05, cv_wag = 0.5, N = 24000) {
  deff <- (1 + (n / szkoly - 1) * rho) * (1 + cv_wag^2)       # deff zależy od uzyskanej liczby osób w szkole
  qnorm(.975) * sqrt(0.25 * deff / n * (1 - n / N))
}
badanie <- function(szkoly, r) {
  zapr <- 16 * szkoly
  kontakt <- rbinom(1, rbinom(1, zapr, 0.92), 0.95)        # kwalifikujący się i osiągalni
  n <- rbinom(1, kontakt, r)
  c(zaproszenia = zapr, kontakt = kontakt, n = n, moe = uzyskany_moe(n, szkoly))
}

# A. Wysyłka jednorazowa według scenariusza centralnego (306 szkół)
set.seed(3721)
R <- 10000
r_los <- rbeta(R, a, b)
sim_A <- t(sapply(r_los, function(r) badanie(centr[["szkoly"]], r)))
round(quantile(sim_A[, "n"], c(.05, .25, .5, .75, .95)))
ryzyko <- function(moe) c(ryzyko = mean(moe > 0.03), blad_MC = sqrt(mean(moe > 0.03) * (1 - mean(moe > 0.03)) / length(moe)))
round(ryzyko(sim_A[, "moe"]), 3)

# B. Ile szkół, żeby z prawdopodobieństwem 90% uzyskać margines ≤ 3 pp?
siatka <- seq(300, 480, by = 10)
set.seed(3722)
r_siatka <- rbeta(4000, a, b)
ryz_siatka <- sapply(siatka, function(s) mean(sapply(r_siatka, function(r) badanie(s, r)[["moe"]]) > 0.03))
print(data.frame(szkoly = siatka, zaproszenia = 16 * siatka, ryzyko_niedoboru = round(ryz_siatka, 3))[seq(1, 19, 2), ],
      row.names = FALSE)
szkoly_90 <- siatka[which(ryz_siatka <= 0.10)[1]]
cat("Wysyłka jednorazowa z 90% pewnością:", szkoly_90, "szkół,", 16 * szkoly_90, "zaproszeń\n")

# C. Wysyłka etapowa: najpierw 80% scenariusza centralnego, po przypomnieniach dobieramy szkoły
#    według odsetka odpowiedzi zaobserwowanego w pierwszym etapie, z zapasem 5% szkół;
#    w drugim etapie odsetek może się nieco zmienić (SD = 3 pp), np. bliżej końca semestru
etapowo <- function(r, zapas = 0.05) {
  s1 <- round(0.8 * centr[["szkoly"]])
  e1 <- badanie(s1, r)
  r_obs <- e1[["n"]] / e1[["kontakt"]]
  s_cel <- ceiling((1 + zapas) * lancuch(odp = r_obs)[["szkoly"]])
  s2 <- max(0, s_cel - s1)
  r2 <- min(max(r + rnorm(1, 0, 0.03), 0.05), 0.95)
  e2 <- if (s2 > 0) badanie(s2, r2) else c(zaproszenia = 0, kontakt = 0, n = 0)
  n <- e1[["n"]] + e2[["n"]]
  c(zaproszenia = e1[["zaproszenia"]] + e2[["zaproszenia"]], n = n, moe = uzyskany_moe(n, s1 + s2))
}
set.seed(3723)
sim_C <- t(sapply(r_los, etapowo))
set.seed(3724)
sim_B <- t(sapply(r_los, function(r) badanie(szkoly_90, r)))
porown <- rbind(jednorazowo_centralnie = c(mean(sim_A[, "zaproszenia"]), mean(sim_A[, "n"]), ryzyko(sim_A[, "moe"])),
                jednorazowo_90proc    = c(mean(sim_B[, "zaproszenia"]), mean(sim_B[, "n"]), ryzyko(sim_B[, "moe"])),
                etapowo               = c(mean(sim_C[, "zaproszenia"]), mean(sim_C[, "n"]), ryzyko(sim_C[, "moe"])))
colnames(porown)[1:2] <- c("sr_zaproszen", "sr_ukonczonych")
print(round(porown, 3))
round(quantile(sim_C[, "zaproszenia"], c(.05, .5, .95)))
# Zapis do rysunku 3: podsumowanie i po 500 losowych badań z każdej strategii
write.csv(round(porown, 4), "strategie-podsumowanie.csv")
set.seed(3725)
wiersze <- sample(R, 500)
moe_all <- c(sim_A[wiersze, "moe"], sim_B[wiersze, "moe"], sim_C[wiersze, "moe"])
write.csv(data.frame(strategia = rep(c("A", "B", "C"), each = 500), r = round(rep(r_los[wiersze], 3), 4),
                     moe = round(moe_all, 5), niedobor = as.integer(moe_all > 0.03)),
          "symulacja-strategii.csv", row.names = FALSE)
write.csv(data.frame(szkoly = siatka, ryzyko = ryz_siatka), "ryzyko-siatka.csv", row.names = FALSE)
Wynik w R
srednia     q05     q95
  0.350   0.252   0.453
  5%  25%  50%  75%  95%
1078 1310 1486 1666 1934
 ryzyko blad_MC
  0.512   0.005
 szkoly zaproszenia ryzyko_niedoboru
    300        4800            0.559
    320        5120            0.390
    340        5440            0.250
    360        5760            0.152
    380        6080            0.088
    400        6400            0.050
    420        6720            0.031
    440        7040            0.019
    460        7360            0.010
    480        7680            0.006
Wysyłka jednorazowa z 90% pewnością: 380 szkół, 6080 zaproszeń
                       sr_zaproszen sr_ukonczonych ryzyko blad_MC
jednorazowo_centralnie     4896.000       1493.188  0.512   0.005
jednorazowo_90proc         6080.000       1854.162  0.091   0.003
etapowo                    5296.118       1574.889  0.030   0.002
  5%  50%  95%
4208 5184 6768
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (wyłącznie funkcje pakietów base i stats); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Efekt klastrów z liczby zaproszonych. W przykładzie dałoby to deff 1.75 zamiast 1.19. Liczy się liczba respondentów w grupie.
- Jeden „zwrot” zamiast trzech odsetków. Nie wiesz wtedy, czy poprawić operat, adresy czy plan przypomnień, a wskaźnika z raportu nie da się porównać z innymi badaniami.
- Liczebność dla całej próby przy wynikach w podgrupach. O liczbie zaproszeń decyduje najmniejsza podgrupa, dla której podajesz wynik.
- Jedna wartość odsetka odpowiedzi bez zapasu. Plan według średniej kończy się niedoborem mniej więcej w co drugim badaniu.
- Zastępowanie osób, które nie odpowiedziały, „podobnymi” spoza losowania. Dodatkowe zaproszenia bierz tylko z wcześniej wylosowanych porcji, inaczej próba przestaje być losowa.
- Więcej zaproszeń jako lekarstwo na brak odpowiedzi. Większa próba zawęża przedział, ale nie usuwa obciążenia, jeśli osoby odpowiadające różnią się od pozostałych.
Najczęstsze pytania
Ile zaproszeń do ankiety wysłać, żeby uzyskać zaplanowaną liczbę odpowiedzi?
Potrzebną liczbę ukończonych ankiet podziel przez iloczyn trzech odsetków: osób kwalifikujących się z listy, osób, do których zaproszenie dotarło, i osób, które odpowiedziały. Przy 1495 ankietach i odsetkach .92, .95 i .35 wychodzi 4888 zaproszeń. Ponieważ odsetek odpowiedzi jest niepewny, dodaj zapas albo wysyłaj etapami.
Czy efekt schematu liczy się z liczby zaproszonych, czy respondentów w grupie?
Z liczby respondentów w grupie, bo to ich odpowiedzi są do siebie podobne. W przykładzie w szkole zapraszano 16 nauczycieli, ale odpowiadało średnio 4.9, więc efekt schematu przy ρ = .05 wynosił 1.19, a nie 1.75. Niższy odsetek odpowiedzi zmniejsza więc efekt klastrów, choć zwiększa liczbę zaproszeń.
Jak uwzględnić ważenie w planowaniu liczebności próby?
Pomnóż liczebność przez przybliżony efekt ważenia Kisha, 1 + CV², gdzie CV to współczynnik zmienności wag. Przy CV = 0.5 to 1.25, czyli o jedną czwartą więcej ukończonych ankiet. Wartość CV weź z podobnego badania albo z symulacji wag na danych pilotażowych.
Jak zaplanować liczebność sondażu, gdy wyniki mają być podane osobno dla podgrup?
Policz liczebność dla najmniejszej ważnej podgrupy, a potem sprawdź, ile to oznacza dla całej próby. W przykładzie ±5 pp dla szkół wiejskich wymagało 532 ankiet; przy doborze proporcjonalnym dało to 1774 ankiety, a z nadreprezentacją wsi i wagami 1511.
Co zrobić, gdy nie wiadomo, jaki będzie odsetek odpowiedzi w sondażu?
Opisz go zakresem z pilotażu lub wcześniejszych badań i policz ryzyko niedoboru dla kilku liczb zaproszeń. Bezpieczniej jest wysłać najpierw część próby, po przypomnieniach oszacować odsetek odpowiedzi i dobrać kolejne losowe porcje z rezerwy.
Powiązane hasła
Przeczytaj też
Sondaż w obrazkach
Margines błędu a n i odsetek 50%, 1000 sondaży, różnica dwóch odsetków, duża ankieta online z błędem i liczba zaproszeń – sześć rysunków z R.
Czytaj →PoradnikLiczebność próby z precyzji (AIPE)
Planowanie liczebności na szerokość przedziału ufności dla proporcji, d Cohena i korelacji, z pewnością osiągnięcia celu i kodem R.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikCałkowity błąd badania sondażowego (TSE)
Pokrycie, brak odpowiedzi, pomiar i ważenie w jednym rachunku MSE: symulacja czterech planów za ten sam budżet i opis ograniczeń.
Czytaj →Planujesz sondaż i musisz uzasadnić liczbę zaproszeń we wniosku?
Pomożemy policzyć łańcuch od precyzji do liczby zaproszeń, dobrać efekt schematu i scenariusze odsetka odpowiedzi oraz przygotować opis planu, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- American Association for Public Opinion Research. (b.d.). Response rates – An overview. Pobrano 11 listopada 2026 z https://aapor.org/response-rates/ ● Otwarty dostęp
- Daikeler, J., Bošnjak, M., & Lozar Manfreda, K. (2020). Web versus other survey modes: An updated and extended meta-analysis comparing response rates. Journal of Survey Statistics and Methodology, 8(3), 513–539. https://doi.org/10.1093/jssam/smz008
- Eldridge, S. M., Ashby, D., & Kerry, S. (2006). Sample size for cluster randomized trials: Effect of coefficient of variation of cluster size and analysis method. International Journal of Epidemiology, 35(5), 1292–1300. https://doi.org/10.1093/ije/dyl129 ● Otwarty dostęp
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Kish, L. (1965). Survey sampling. Wiley.
- Lohr, S. L. (2021). Sampling: Design and analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429298899
- Valliant, R., Dever, J. A., & Kreuter, F. (2018). Practical tools for designing and weighting survey samples (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-93632-1
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, Article 100206. https://doi.org/10.1016/j.chbr.2022.100206 ● Otwarty dostęp
Cytowania BibTeX
@misc{aaporresponseratesnd, author={{American Association for Public Opinion Research}}, title={{Response rates – An overview}}, url={https://aapor.org/response-rates/}}@article{daikeler2020web, author={Daikeler, Jessica and Bošnjak, Michael and Lozar Manfreda, Katja}, title={{Web versus other survey modes: An updated and extended meta-analysis comparing response rates}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={3}, pages={513--539}, doi={10.1093/jssam/smz008}}@article{eldridge2006sample, author={Eldridge, Sandra M. and Ashby, Deborah and Kerry, Sally}, title={{Sample size for cluster randomized trials: Effect of coefficient of variation of cluster size and analysis method}}, journal={International Journal of Epidemiology}, year={2006}, volume={35}, number={5}, pages={1292--1300}, doi={10.1093/ije/dyl129}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@book{kish1965survey, author={Kish, Leslie}, title={{Survey sampling}}, year={1965}, publisher={Wiley}}@book{lohr2021sampling, author={Lohr, Sharon L.}, title={{Sampling: Design and analysis (3rd ed.)}}, year={2021}, publisher={Chapman and Hall/CRC}, doi={10.1201/9780429298899}}@book{valliant2018practical, author={Valliant, Richard and Dever, Jill A. and Kreuter, Frauke}, title={{Practical tools for designing and weighting survey samples (2nd ed.)}}, year={2018}, publisher={Springer}, doi={10.1007/978-3-319-93632-1}}@article{wu2022response, author={Wu, Meng-Jia and Zhao, Kelly and Fils-Aime, Francisca}, title={{Response rates of online surveys in published research: A meta-analysis}}, journal={Computers in Human Behavior Reports}, year={2022}, volume={7}, eid={100206}, doi={10.1016/j.chbr.2022.100206}}