Co to jest raking?
Raking, czyli ważenie iteracyjne (ang. raking, iterative proportional fitting), to metoda budowy wag, po której ważone rozkłady kilku zmiennych w próbie zgadzają się ze znanymi rozkładami w populacji. Zwykle chodzi o płeć, wiek i wykształcenie. W odróżnieniu od poststratyfikacji w komórkach pełnego krzyżowania raking potrzebuje tylko rozkładów brzegowych. Nie rozbija też próby na wiele małych komórek (Battaglia i in., 2009). Deville i Särndal (1992) pokazali, że uogólniony raking jest szczególnym przypadkiem ważenia kalibracyjnego.
Jak to działa?
Zaczynasz od wag równych 1 albo od wag schematu losowania. Potem po kolei dla każdej zmiennej mnożysz wagi w kategorii przez iloraz: udział w populacji / ważony udział w próbie. Dopasowanie do wieku psuje trochę dopasowanie do płci, więc cykl się powtarza, aż wagi przestaną się zmieniać. Zwykle wystarcza kilka cykli. Skrajne wagi zwiększają wariancję oszacowań, dlatego przycina się je do ustalonego progu. Programy do rakingu oferują kilka sposobów przycinania i diagnostykę wag (Kolenikov, 2014). Koszt ważenia mierzy efekt ważenia Kisha: deff = 1 + CV² wag. Efektywna liczebność to n / deff.
Przykład
W fikcyjnej ankiecie online 600 osób było za dużo kobiet, młodych i osób z wyższym wykształceniem. Raking według trzech rozkładów brzegowych zbiegł się w 6 cyklach. Wagi wahały się od 0.18 do 9.53, deff = 2.42, a efektywna liczebność spadła do 248 osób. Odsetek osób ufających instytucji zmienił się z 45.3% bez wag na 39.2% po rakingu. Po przycięciu wag do 5 deff spadł do 2.11, a wynik wyniósł 39.6%.
Na rysunku
Rysunek pokazuje próbę z przykładu (600 osób, set.seed(3341)) i to, co raking robi z jej rozkładami brzegowymi w kolejnych cyklach.
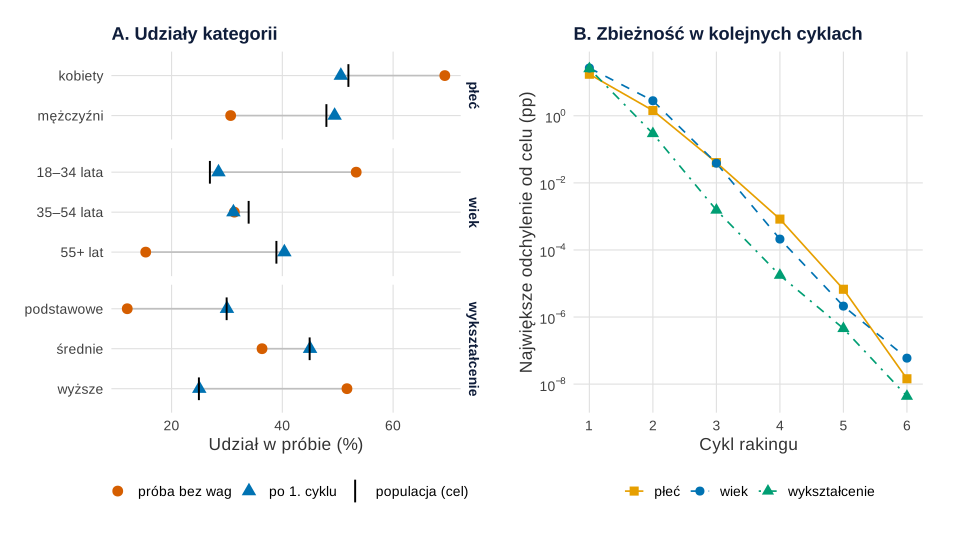
set.seed(3341)).Co widać. W panelu A kółka to próba bez wag: kobiet jest 69.3% zamiast 52%, osób w wieku 18–34 lat 53.3% zamiast 27%, a osób z wyższym wykształceniem 51.7% zamiast 25%. Już po pierwszym cyklu trójkąty leżą blisko kresek populacji. Wykształcenie zgadza się dokładnie, bo było korygowane jako ostatnie. Płeć (50.6% kobiet) i wiek (31.2% osób w wieku 35–54 lat zamiast 34%) rozjechały się jednak trochę przy kolejnych krokach. Panel B pokazuje, jak daleko od celu jest każdy rozkład brzegowy tuż przed jego korektą. W drugim cyklu odchylenie wynosi jeszcze 2.8 pp dla wieku, w trzecim około 0.04 pp, a w szóstym poniżej 10−7 pp. Każdy cykl zmniejsza odchylenie mniej więcej 10–100 razy, dlatego procedura zatrzymała się po 6 cyklach.
Na co uważać. Zbieżność dotyczy tylko rozkładów brzegowych. Rozkład łączny, np. odsetek młodych kobiet z wyższym wykształceniem, nie musi zgadzać się z populacją, bo raking go nie zna. Rysunek nie pokazuje też ceny ważenia: wagi od 0.18 do 9.53 i deff = 2.42 z przykładu. Nie mówi też nic o obciążeniu wyniku zależnym od cech spoza modelu wag. Wykres w panelu A to odmiana wykresu hantlowego. Raking i poststratyfikację na tych samych danych z symulacją wielu badań porównuje wpis Próba reprezentatywna w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Rozkłady brzegowe przed rakingiem i po nim oraz zbieżność kolejnych cykli
library(ggplot2)
library(patchwork)

kol <- c("próba bez wag" = "#D55E00", "po 1. cyklu" = "#0072B2", "populacja (cel)" = "#000000")  # Okabe–Ito
ksz <- c("próba bez wag" = 16, "po 1. cyklu" = 17, "populacja (cel)" = 124)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(3341)                                # te same dane co w przykładzie w haśle
n <- 600
d <- data.frame(plec = sample(c("K", "M"), n, TRUE, prob = c(.68, .32)),
                wiek = sample(c("18-34", "35-54", "55+"), n, TRUE, prob = c(.50, .32, .18)),
                wyks = sample(c("podst", "srednie", "wyzsze"), n, TRUE, prob = c(.12, .38, .50)))
cele <- list(plec = c(K = .52, M = .48),
             wiek = c("18-34" = .27, "35-54" = .34, "55+" = .39),
             wyks = c(podst = .30, srednie = .45, wyzsze = .25))
udzialy <- function(w, z) tapply(w, d[[z]], sum) / sum(w)

# Raking jak w przykładzie; przed każdym krokiem zapisujemy, jak daleko (w pp) jest brzeg od celu
w <- rep(1, n); odchyl <- NULL
for (it in 1:100) {
  w_stare <- w
  for (z in names(cele)) {
    odchyl <- rbind(odchyl, data.frame(cykl = it, zmienna = z,
                    pp = 100 * max(abs(udzialy(w, z) - cele[[z]]))))
    w <- w * (cele[[z]] / udzialy(w, z))[d[[z]]]
  }
  if (it == 1) w1 <- w                         # wagi po pierwszym cyklu
  if (max(abs(w - w_stare)) < 1e-6) break
}
it                                             # liczba cykli do zbieżności
signif(xtabs(pp ~ zmienna + cykl, odchyl), 2)  # odchylenie brzegu od celu (pp) przed korektą

# Panel A: udziały kategorii (kolejność kategorii jak w danych)
brzegi <- do.call(rbind, lapply(names(cele), function(z) data.frame(
  zmienna = z, kat = names(cele[[z]]),
  "próba bez wag" = as.numeric(udzialy(rep(1, n), z)[names(cele[[z]])]),
  "po 1. cyklu" = as.numeric(udzialy(w1, z)[names(cele[[z]])]),
  "populacja (cel)" = as.numeric(cele[[z]]), check.names = FALSE)))
print(cbind(brzegi[1:2], round(100 * brzegi[3:5], 1)), row.names = FALSE)
dl <- reshape(brzegi, direction = "long", varying = names(kol), v.names = "udzial",
              timevar = "stan", times = names(kol))
dl$stan <- factor(dl$stan, names(kol))
etyk <- c(K = "kobiety", M = "mężczyźni", "18-34" = "18–34 lata", "35-54" = "35–54 lata", "55+" = "55+ lat",
          podst = "podstawowe", srednie = "średnie", wyzsze = "wyższe")
dl$et <- factor(etyk[dl$kat], rev(etyk))
dl$zm <- factor(dl$zmienna, names(cele), c("płeć", "wiek", "wykształcenie"))
pA <- ggplot(dl, aes(100 * udzial, et)) +
  geom_line(aes(group = et), colour = "grey75") +
  geom_point(aes(colour = stan, shape = stan, size = stan)) +
  scale_colour_manual(NULL, values = kol) + scale_shape_manual(NULL, values = ksz) +
  scale_size_manual(NULL, values = c(3.4, 3.4, 6)) +
  facet_grid(zm ~ ., scales = "free_y", space = "free_y") +
  labs(title = "A. Udziały kategorii", x = "Udział w próbie (%)", y = NULL) + motyw

# Panel B: odchylenie od celu przed korektą danej zmiennej w kolejnych cyklach (skala log)
odchyl$zmienna <- factor(odchyl$zmienna, names(cele), c("płeć", "wiek", "wykształcenie"))
pB <- ggplot(subset(odchyl, pp > 0), aes(cykl, pp, colour = zmienna, shape = zmienna, linetype = zmienna)) +
  geom_line() + geom_point(size = 2.8) +
  scale_y_log10("Największe odchylenie od celu (pp)", breaks = 10^seq(-8, 2, 2),
                labels = function(x) parse(text = paste0("10^", log10(x)))) +
  scale_x_continuous("Cykl rakingu", breaks = 1:it) +
  scale_colour_manual(NULL, values = c("#E69F00", "#0072B2", "#009E73")) +
  scale_shape_manual(NULL, values = c(15, 16, 17)) + scale_linetype_manual(NULL, values = c(1, 2, 4)) +
  labs(title = "B. Zbieżność w kolejnych cyklach") + motyw
p1 <- pA | pB
p1
Wynik w R
[1] 6
       cykl
zmienna       1       2       3       4       5       6
   plec 1.7e+01 1.4e+00 4.0e-02 8.3e-04 6.7e-06 1.4e-08
   wiek 2.7e+01 2.8e+00 3.9e-02 2.1e-04 2.1e-06 5.9e-08
   wyks 2.5e+01 2.9e-01 1.5e-03 1.8e-05 4.5e-07 4.3e-09
 zmienna     kat próba bez wag po 1. cyklu populacja (cel)
    plec       K          69.3        50.6              52
    plec       M          30.7        49.4              48
    wiek   18-34          53.3        28.5              27
    wiek   35-54          31.3        31.2              34
    wiek     55+          15.3        40.4              39
    wyks   podst          12.0        30.0              30
    wyks srednie          36.3        45.0              45
    wyks  wyzsze          51.7        25.0              25
Jak opisać w pracy
Na co uważać
- Raking poprawia tylko to, co wiąże się ze zmiennymi ważącymi. Nie usuwa błędu braku odpowiedzi zależnego od cech spoza modelu wag.
- Przycinanie łamie dopasowanie. Po przycięciu udział osób 55+ wyniósł 37.1% zamiast 39%. Po przycięciu można powtórzyć raking.
- Ważenie poszerza przedziały ufności. Podawaj margines błędu liczony z efektywnej liczebności, podobnie jak przy efekcie schematu.
Pełny proces, od wag schematu po błędy standardowe, opisuje wpis Ważenie danych sondażowych krok po kroku. Gotowe wagi w ESS czy PGSS omawia poradnik o analizie danych z dużych badań sondażowych.
Raking w bazowym R
Kod tworzy fikcyjną próbę, dopasowuje wagi pętlą do trzech rozkładów brzegowych, przycina je i liczy efekt ważenia Kisha. Nie wymaga żadnego pakietu.
Iteracyjne dopasowanie wag do płci, wieku i wykształcenia
R
set.seed(3341)
n <- 600                                    # fikcyjna ankieta online
d <- data.frame(plec = sample(c("K", "M"), n, TRUE, prob = c(.68, .32)),
                wiek = sample(c("18-34", "35-54", "55+"), n, TRUE, prob = c(.50, .32, .18)),
                wyks = sample(c("podst", "srednie", "wyzsze"), n, TRUE, prob = c(.12, .38, .50)))
d$ufa <- rbinom(n, 1, plogis(-0.4 + 0.5 * (d$wyks == "wyzsze") - 0.4 * (d$wiek == "55+")))
cele <- list(plec = c(K = .52, M = .48),               # rozkłady brzegowe w populacji
             wiek = c("18-34" = .27, "35-54" = .34, "55+" = .39),
             wyks = c(podst = .30, srednie = .45, wyzsze = .25))
w <- rep(1, n)
for (it in 1:100) {
  w_stare <- w
  for (z in names(cele)) {                  # dopasuj po kolei każdy rozkład brzegowy
    udz <- tapply(w, d[[z]], sum) / sum(w)
    w <- w * (cele[[z]] / udz)[d[[z]]]
  }
  if (max(abs(w - w_stare)) < 1e-6) break
}
w <- w / mean(w)
w_p <- pmin(w, 5)                            # przycięcie wag do 5
deff <- function(w) length(w) * sum(w^2) / sum(w)^2   # efekt ważenia Kisha = 1 + CV²
round(c(iteracje = it, w_min = min(w), w_max = max(w), deff = deff(w), n_eff = n / deff(w),
        deff_przyc = deff(w_p), ufa_bez_wag = mean(d$ufa),
        ufa_raking = weighted.mean(d$ufa, w), ufa_przyc = weighted.mean(d$ufa, w_p)), 3)
round(tapply(w_p, d$wiek, sum) / sum(w_p), 3)  # po przycięciu brzegi lekko się rozjeżdżają
Wynik w R
   iteracje       w_min       w_max        deff       n_eff  deff_przyc
      6.000       0.180       9.534       2.420     247.917       2.106
ufa_bez_wag  ufa_raking   ufa_przyc
      0.453       0.392       0.396
18-34 35-54   55+
0.278 0.351 0.371
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats). Rysunek 1 przygotowano w pakietach ggplot2 i patchwork. Pakiet survey, standardowe narzędzie do ważenia i błędów standardowych w sondażach, nie był użyty. W pracy podaj wersję R, której faktycznie użyto (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym raking różni się od wag poststratyfikacyjnych?
Poststratyfikacja wymaga udziałów populacji w każdej komórce krzyżowania zmiennych, np. płeć × wiek × wykształcenie. Raking potrzebuje tylko rozkładów każdej zmiennej osobno i nie tworzy pustych ani bardzo małych komórek.
Do jakiej wartości przycinać wagi po rakingu?
Nie ma jednego progu. Ustal go przed analizą (w przykładzie 5 przy średniej wadze 1), podaj go razem z liczbą przyciętych wag i sprawdź, jak bardzo rozjechały się rozkłady brzegowe.
Co zrobić, gdy raking się nie zbiega?
Zwykle któraś kategoria ma w próbie bardzo mało osób albo docelowe rozkłady są ze sobą sprzeczne. Połącz rzadkie kategorie, sprawdź źródło danych populacyjnych i ogranicz liczbę zmiennych ważących.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Ważenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikAnaliza danych z ESS, PGSS i Diagnozy Społecznej
Dostęp i rejestracja, wagi dweight, pspwght i anweight, warstwy i klastry, błędy standardowe ze schematu i regresja w R z wzorem opisu.
Czytaj →PoradnikPanel internetowy a próba losowa
Sieć ładowarek: panel 20.8%, prawda 12.8%. Raking, kalibracja do próby losowej, efektywna liczebność i 1000 badań – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Battaglia, M. P., Hoaglin, D. C., & Frankel, M. R. (2009). Practical considerations in raking survey data. Survey Practice, 2(5), 1–10. https://doi.org/10.29115/sp-2009-0019 ● Otwarty dostęp
- Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
- Kolenikov, S. (2014). Calibrating survey data using iterative proportional fitting (raking). The Stata Journal, 14(1), 22–59. https://doi.org/10.1177/1536867x1401400104 ● Otwarty dostęp
Cytowania BibTeX
@article{battaglia2009practical, author={Battaglia, Michael P. and Hoaglin, David C. and Frankel, Martin R.}, title={{Practical considerations in raking survey data}}, journal={Survey Practice}, year={2009}, volume={2}, number={5}, pages={1--10}, doi={10.29115/sp-2009-0019}}@article{deville1992calibration, author={Deville, Jean-Claude and Särndal, Carl-Erik}, title={{Calibration estimators in survey sampling}}, journal={Journal of the American Statistical Association}, year={1992}, volume={87}, number={418}, pages={376--382}, doi={10.1080/01621459.1992.10475217}}@article{kolenikov2014calibrating, author={Kolenikov, Stanislav}, title={{Calibrating survey data using iterative proportional fitting (raking)}}, journal={The Stata Journal}, year={2014}, volume={14}, number={1}, pages={22--59}, doi={10.1177/1536867x1401400104}}