Całkowity błąd badania sondażowego: dwie strony jednego wyniku
Margines błędu z raportu sondażu mówi tylko o jednym źródle niepewności: o tym, że wylosowano tę, a nie inną próbę. Wynik może jednak odbiegać od prawdy także dlatego, że części populacji nie było na liście, że część osób nie odpowiedziała albo że odpowiedziała nieszczerze. Rama całkowitego błędu badania sondażowego (total survey error, TSE) zbiera te źródła w jednym rachunku. Groves i Lyberg (2010) opisują ją jako ramę pojęciową dla statystycznych własności wyników z badań próbkowych. Wyrosła z luk między warunkami, w których próba probabilistyczna daje nieobciążone oszacowania, a praktyką realizacji badań. Jej najtrwalszą wartością jest etap projektowania, gdy szuka się równowagi między kosztami a różnymi błędami.
Wpis rodzaje badań ankietowych pokazuje na symulacji, jak błąd pokrycia i autoselekcja przesuwają wynik ankiety studenckiej. Tu liczymy wszystkie składniki naraz i porównujemy plany o tym samym koszcie.
Błędy porządkuje się zwykle na dwóch ścieżkach, od konstruktu i od populacji do końcowej liczby w raporcie. Podręcznik Grovesa i in. (2009) omawia kolejne ogniwa obu ścieżek: operat losowania, schemat doboru, budowę i ocenę pytań, tryb zbierania danych, pracę ankieterów, brak odpowiedzi i opracowanie danych.
| Strona | Źródło błędu | Pytanie kontrolne |
|---|---|---|
| Reprezentacja (kogo mierzymy) | Pokrycie | Czy operat losowania obejmuje całą populację docelową? |
| Dobór (losowanie) | Jak duży jest błąd losowy przy tym schemacie i tej liczebności? | |
| Brak odpowiedzi i autoselekcja | Czy udział w badaniu wiąże się z badaną cechą? | |
| Korekty (ważenie, imputacja) | Czy zmienne korygujące tłumaczą udział i ile kosztują w wariancji? | |
| Pomiar (co mierzymy) | Trafność | Czy pytanie mierzy konstrukt, o który chodzi? |
| Błąd pomiaru | Czy respondent rozumie pytanie, pamięta odpowiedź i chce ją podać? | |
| Opracowanie | Czy kodowanie, czyszczenie i przekształcenia nie zmieniają odpowiedzi? |
Obciążenie, wariancja i błąd średniokwadratowy
Każde źródło błędu może działać na dwa sposoby. Obciążenie to systematyczne przesunięcie: gdybyśmy powtórzyli to samo badanie wiele razy, średnia z oszacowań nadal odbiegałaby od prawdy (zob. estymator nieobciążony). Wariancja to rozrzut oszacowań między takimi powtórzeniami. Miarą łączną jest błąd średniokwadratowy:
Losowanie, dobór osób do ankieterów czy losowe pomyłki w odpowiedziach dokładają głównie wariancję. Ona maleje, gdy rośnie próba. Pokrycie, brak odpowiedzi zależny od badanej cechy i aprobata społeczna dokładają głównie obciążenie. Ono od liczebności nie zależy. Margines błędu i przedział ufności opisują tylko pierwszą część rachunku.
Meng (2018) zapisał błąd średniej z dowolnego zbioru danych, losowego lub nie, jako iloczyn trzech czynników:
Tu ρR,Y to korelacja między wartością cechy a faktem znalezienia się w danych (jakość danych), f = n/N to odsetek populacji w danych (ilość), a σY to odchylenie standardowe cechy (trudność problemu). Losowanie utrzymuje tę korelację na poziomie rzędu 1/√N. Gdy tej kontroli brak, o wielkości zbioru świadczy względna wielkość f, a nie liczba rekordów. Meng nazywa to paradoksem dużych danych. W jego przykładzie z wyborów prezydenckich w USA w 2016 roku samodzielne deklaracje około 2.3 mln osób miały taki błąd średniokwadratowy jak prosta próba losowa z około 400 osób.
Przykład: cztery plany za ten sam budżet
Zasymulowano populację 100 000 dorosłych. Celem badania jest odsetek osób pijących alkohol w sposób ryzykowny. W populacji wynosi on 16.23%. Z internetu korzysta 85.18% osób, częściej młodsze i z wyższym wykształceniem. Wśród internautów odsetek pijących ryzykownie wynosi 17.19%. Młodsi piją ryzykownie częściej i rzadziej odpowiadają na zaproszenia. Osoby pijące ryzykownie także odpowiadają nieco rzadziej. Część z nich zaprzecza, gdy pada pytanie, a przy ankieterze zaprzecza częściej. Takie zniekształcenie odpowiedzi drażliwych opisuje Krumpal (2013): zachowania niepożądane są zaniżane, a skala zjawiska zależy m.in. od techniki zbierania danych. Kreuter i in. (2008) pokazali, że ankieta internetowa daje trafniejsze odpowiedzi drażliwe niż wywiad telefoniczny.
Budżet wynosi 30 000 umownych jednostek kosztu. Wszystkie oszacowania ważono do struktury populacji według wieku (trzy grupy) i wykształcenia (zob. ważenie danych sondażowych).
| Plan | Koszt | Respondenci (jedno badanie) | Odsetek ważony |
|---|---|---|---|
| A. Losowanie 5000 osób z rejestru, ankieta internetowa z wersją papierową; odpowiada średnio 35.1% | 6 na wylosowaną osobę | 1737 | 14.01% |
| B. Losowanie 2143 osób, intensywny kontakt (przypomnienia, zachęta); odpowiada średnio 61.0% | 14 na wylosowaną osobę | 1302 | 14.50% |
| C. Losowanie 6667 osób, wywiad telefoniczny z ankieterem; odpowiada średnio 18.4% | 4.5 na wylosowaną osobę | 1204 | 10.05% |
| D. Panel internetowy z samodzielnymi zgłoszeniami (opt-in) | 2 na wywiad | 15 137 | 20.23% |
Prawdziwy odsetek to 16.23%. W planie A pakiet survey podaje 14.01%, 95% CI [12.30, 15.71], przy efekcie schematu z ważenia równym 1.11 (zob. efekt schematu). Przedział nie obejmuje prawdy, bo opisuje tylko wariancję. Panel D ma prawie dziewięć razy więcej respondentów niż plan A, a myli się w drugą stronę.
Skąd bierze się błąd każdego planu
Każdy plan powtórzono 1000 razy. Obciążenie rozłożono na kolejne ogniwa: pokrycie (kto mógł trafić do badania), dobór i udział (kto odpowiedział), pomiar (co zgłosił) i ważenie (co zmieniła korekta). Błąd Monte Carlo obciążenia wynosił najwyżej 0.032 punktu procentowego.
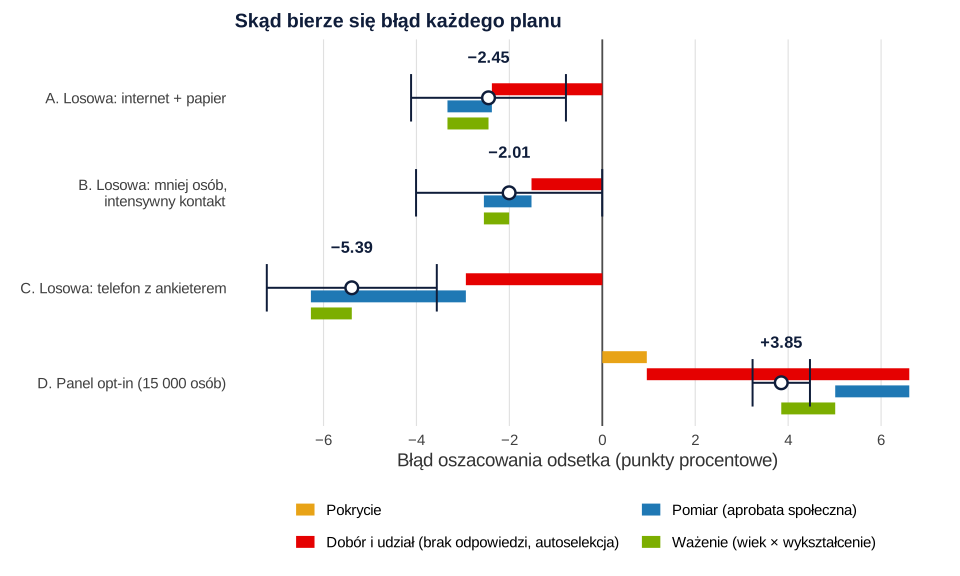
| Plan | Pokrycie | Dobór i udział | Pomiar | Ważenie | Obciążenie | SD | RMSE |
|---|---|---|---|---|---|---|---|
| A. Losowa, internet + papier | 0.00 | −2.38 | −0.96 | +0.88 | −2.45 | 0.85 | 2.59 |
| B. Losowa, intensywny kontakt | 0.00 | −1.52 | −1.02 | +0.54 | −2.01 | 1.02 | 2.25 |
| C. Losowa, telefon | 0.00 | −2.94 | −3.34 | +0.88 | −5.39 | 0.93 | 5.47 |
| D. Panel opt-in | +0.96 | +5.65 | −1.59 | −1.16 | +3.85 | 0.32 | 3.86 |
Z tabeli wynikają cztery obserwacje.
- Ważenie naprawia tylko to, co tłumaczą zmienne korygujące. W planie A brak odpowiedzi obniżył wynik o 2.38 punktu. Ważenie oddało 0.88 punktu, czyli część wynikającą z tego, że młodsi rzadziej odpowiadają. Część zależna od samego picia została. Groves (2006) zwraca uwagę, że korekta braku odpowiedzi po badaniu wymaga dobrych zmiennych pomocniczych (zob. błąd braku odpowiedzi).
- Wyższy odsetek odpowiedzi pomógł, bo dotarł do osób podobnych do nierespondentów. W planie B składnik udziału spadł do −1.52. Groves (2006) przypomina jednak, że brak odpowiedzi może, ale nie musi obciążać wyników. Więcej odpowiedzi pomaga tylko wtedy, gdy dodatkowy wysiłek dociera do osób, które różnią się w badanej cesze.
- Tryb z ankieterem kosztuje w pomiarze. W planie C składnik pomiaru wyniósł −3.34 punktu, ponad trzy razy więcej niż w ankietach samodzielnych. Więcej o rozdzielaniu takich efektów piszemy w tekście ankieta mieszana i efekt trybu, a o zmienności między ankieterami w haśle efekt ankietera.
- Błędy o przeciwnych znakach częściowo się znoszą. W panelu D autoselekcja zawyżyła wynik o 5.65 punktu, a aprobata społeczna i ważenie obniżyły go razem o 2.75. Bethlehem (2010) wskazuje, że samoselekcja w ankietach internetowych prowadzi do niewiarygodnych oszacowań. Mercer i in. (2017) opisują, od czego zależy wielkość tego obciążenia. Bez dodatkowych danych nie wiadomo, ile wynosi ani w którą stronę działa.
Ten sam budżet, różny błąd średniokwadratowy
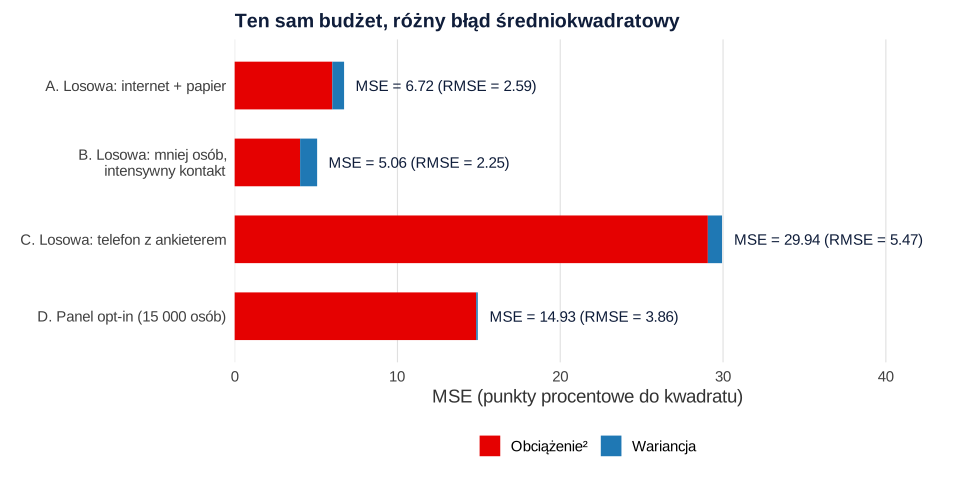
Rysunek 2 rozkłada MSE każdego planu na obciążenie² i wariancję. W planach losowych obciążenie odpowiada za 79–97% MSE, a w panelu D za 99.3%. Najmniejszy błąd ma plan B, choć zebrał średnio o około 450 wywiadów mniej niż plan A. Jego RMSE wynosi 2.25 punktu wobec 2.59 w planie A i 3.86 w panelu z 15 000 osób.
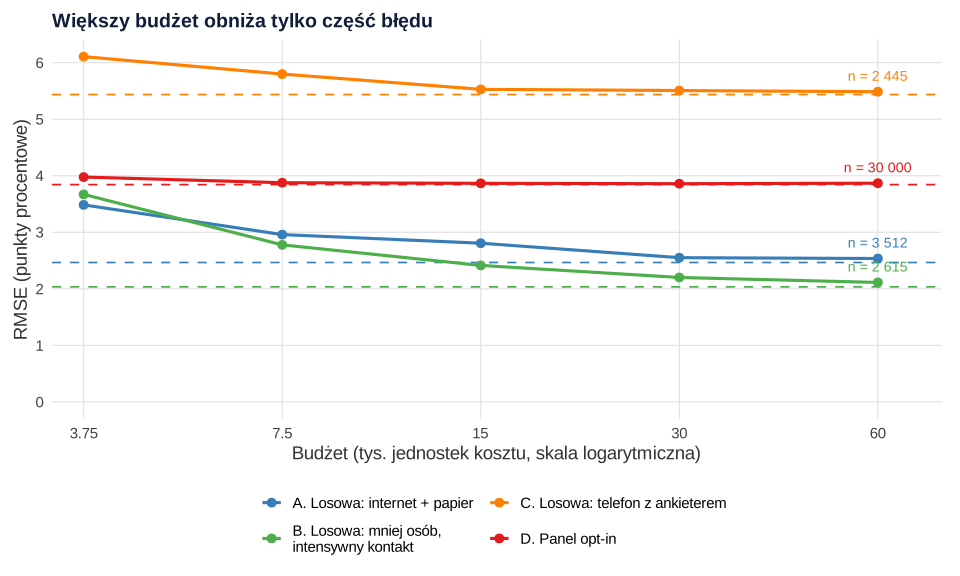
Rysunek 3 pokazuje RMSE przy budżecie od 3750 do 60 000 jednostek. Linie przerywane to wartość bezwzględna obciążenia, czyli podłoga, której żadna liczebność nie przebije. Plan A przy 3512 wywiadach ma RMSE 2.54, a plan B przy 2615 wywiadach 2.11. Panel D przy 30 000 wywiadów ma RMSE 3.87, prawie tak samo jak przy 1876 (3.98). Przy najmniejszym budżecie plan A był jeszcze lepszy od B (3.48 wobec 3.67), bo wtedy przeważa wariancja. Kolejność planów zależy więc od budżetu.
Tożsamość Menga pozwala to policzyć dla jednego badania. W panelu D, przed ważeniem i na prawdziwych wartościach cechy, korelacja między udziałem a piciem wyniosła ρ = .078, a odsetek populacji w danych f = .151. Iloczyn daje błąd 6.82 punktu, dokładnie taki jak bezpośrednie porównanie. Taki błąd ma prosta próba losowa z około 29 osób. Pozornie mała korelacja odebrała 15 000 wywiadom niemal całą wartość.
Jak zaplanować badanie według TSE
Biemer (2010) opisuje TSE jako ramę optymalizacji badania: maksymalizację jakości danych w granicach budżetu. Wpisuje ją też w szersze pojęcie jakości, obejmujące m.in. przydatność dla użytkownika, dostępność i porównywalność. W praktyce planowanie sprowadza się do kilku kroków.
- Nazwij statystykę kluczową. Odsetek w populacji, średnia, różnica grup i współczynnik regresji mają różną wrażliwość na dobór.
- Wypisz źródła błędu i oceń kierunek oraz rząd wielkości każdego z nich. Korzystaj z literatury, wcześniejszych edycji i pilotażu.
- Policz plany w jednostkach kosztu. Dla każdego wariantu oszacuj liczbę wywiadów, wariancję (z efektem schematu) i założone obciążenie. Tak powstaje tabela jak wyżej, choćby z trzema scenariuszami: optymistycznym, typowym i pesymistycznym. Przeliczenie precyzji na liczbę zaproszeń opisuje wpis ile zaproszeń wysłać.
- Wydawaj tam, gdzie obciążenie jest największe. Gdy obciążenie² przeważa nad wariancją, następny budżet przeznacz na pokrycie, odsetek odpowiedzi w trudnych grupach albo lepszy pomiar, a nie na kolejne wywiady.
- Zaplanuj dane do oceny błędów. Zmienne z operatu dla respondentów i nierespondentów, kontakt z próbą nierespondentów, paradane, eksperymenty z wersjami pytań (split-ballot) albo porównanie z danymi zewnętrznymi. Groves i Lyberg (2010) zauważają, że oszacowanie wszystkich składników jest kosztowne i większość badań tego nie robi. Wybierz więc te, które najbardziej zagrażają kluczowej statystyce.
| Źródło błędu | Sygnał ryzyka | Działanie w projekcie | Co zebrać do oceny |
|---|---|---|---|
| Pokrycie | Operat pomija grupę o innej wartości cechy (np. osoby bez internetu) | Drugi operat albo drugi tryb dla pominiętych | Udział pominiętych w populacji i ich cechy z innych źródeł |
| Dobór | Mała próba, klastry, zróżnicowane wagi | Warstwowanie, więcej jednostek pierwszego stopnia | Efekt schematu i efektywna liczebność |
| Brak odpowiedzi i autoselekcja | Temat badania może wpływać na decyzję o udziale | Neutralne zaproszenie, przypomnienia i dodatkowy kontakt w grupach o niskim udziale | Zmienne z operatu dla wszystkich wylosowanych, porównanie wczesnych i późnych respondentów |
| Ważenie | Duży rozrzut wag, zmienne korygujące słabo związane z cechą | Zmienne korygujące związane i z udziałem, i z cechą; raking zamiast wielu małych komórek | Wynik z wagami i bez, efekt schematu z wag |
| Trafność i pomiar | Pytanie drażliwe, długi okres przypominania, obecność ankietera | Tryb samodzielny, wywiad poznawczy w pilotażu, techniki pośrednie | Eksperymenty z wersjami pytań, porównanie z danymi administracyjnymi |
| Opracowanie | Ręczne kodowanie, przekodowania, reguły wykluczeń | Książka kodowa i skrypt czyszczenia przed zebraniem danych | Liczba rekordów na każdym etapie, zgodność kodujących |
Wybór między dużą próbą wygodną a mniejszą probabilistyczną nie ma odpowiedzi uniwersalnej. Cornesse i in. (2020) zauważają, że zaufanie do prób losowych opiera się na teorii statystycznej, a trafność wniosków z prób nieprobabilistycznych zależy od modeli korygujących. Jeśli statystyka kluczowa to odsetek w populacji, a temat może wpływać na udział, przewaga liczebności zwykle znika (zob. błąd selekcji). Przy eksperymencie ankietowym próba wygodna bywa rozsądnym kompromisem.
Jak opisać ograniczenia według TSE
Zamiast ogólnika „próba nie była reprezentatywna” przejdź po obu stronach ramy. Przy każdym źródle podaj, co zrobiono, jaki jest prawdopodobny kierunek błędu i czego nie da się wykluczyć. Wzory ogólnych sformułowań znajdziesz we wpisie ograniczenia badania – jak opisać, a zapis dla planu A wygląda tak:
Jeśli przygotowujesz badanie sondażowe do grantu albo publikacji i chcesz porównać plany w jednostkach kosztu, możemy wspólnie przygotować taki rachunek w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi korzysta z populacji i funkcji z pierwszego). Drugi przepis powtarza każde badanie 1000 razy, a siatkę budżetów 500 razy, więc liczy się kilkadziesiąt sekund. Potrzebny pakiet: survey.
1. Populacja, cztery plany i jedno badanie z każdego
R
# Krok 1. Populacja, cztery plany badania za ten sam budżet i jedno badanie z każdego planu (dane symulowane)
# Cel: odsetek dorosłych pijących alkohol w sposób ryzykowny (prawdziwa wartość znana, bo populację tworzymy sami).
suppressPackageStartupMessages(library(survey))

set.seed(3711)
N <- 100000
wiek <- round(runif(N, 18, 80))
wyzsze <- rbinom(N, 1, plogis(0.2 - 0.03 * (wiek - 45)))
u <- rnorm(N)                                        # cecha niezmierzona: towarzyski styl życia
internet <- rbinom(N, 1, plogis(2.2 - 0.07 * (wiek - 45) + 1.0 * wyzsze + 0.4 * u))
y <- rbinom(N, 1, plogis(-1.6 - 0.025 * (wiek - 45) - 0.3 * wyzsze + 0.7 * u))   # prawdziwe ryzykowne picie
kom <- interaction(cut(wiek, c(17, 34, 54, 80), labels = c("18-34", "35-54", "55-80")), wyzsze)   # 6 komórek do wag
pop <- data.frame(wiek, wyzsze, u, internet, y, kom)
P <- mean(y)
udzial <- prop.table(table(kom))                     # struktura populacji (np. z danych statystyki publicznej)
round(c(N = N, odsetek_prawdziwy = 100 * P, internet = 100 * mean(internet),
        odsetek_wsrod_internautow = 100 * mean(y[internet == 1])), 2)

# Cztery plany za ten sam budżet: 30 000 jednostek kosztu (koszty umowne, nie ceny)
# A–C: losowanie z pełnego operatu osób; koszt liczony na osobę wylosowaną (zaproszenia, przypomnienia, telefony).
# D: panel internetowy z samodzielnymi zgłoszeniami; koszt na wywiad zrealizowany.
# czulosc = P(przyzna się | pije ryzykownie): ankieta samodzielna 0.90, wywiad z ankieterem 0.75.
plany <- data.frame(
  plan = c("A_losowa_internet_papier", "B_losowa_intensywny_kontakt", "C_losowa_telefon", "D_panel_opt_in"),
  koszt = c(6, 14, 4.5, 2),
  wyraz_wolny = c(-0.9, 0.2, -1.8, NA),       # skłonność do udziału (odpowiada ok. 35% w A, 60% w B, 18% w C)
  czulosc = c(0.93, 0.93, 0.75, 0.93))
BUDZET <- 30000
n_plan <- setNames(round(BUDZET / plany$koszt), plany$plan)   # A–C: liczba wylosowanych; D: liczba wywiadów
n_plan

# Jedno badanie z planu
badanie <- function(plan, n) {
  k <- plany[plany$plan == plan, ]
  if (plan != "D_panel_opt_in") {
    s <- pop[sample.int(N, n), ]
    odp <- rbinom(n, 1, plogis(k$wyraz_wolny + 0.02 * (s$wiek - 45) + 0.4 * s$wyzsze - 0.15 * s$y))   # udział zależy też od y
    s <- s[odp == 1, ]
  } else {                                     # tylko internauci; zgłaszają się częściej młodsi, towarzyscy i pijący
    zgl <- with(pop, internet * plogis(-0.03 * (wiek - 45) + 0.6 * u + 0.4 * y))
    s <- pop[runif(N) < n * zgl / sum(zgl), ]
  }
  s$zgloszone <- rbinom(nrow(s), 1, s$y * k$czulosc)   # aprobata społeczna: część pijących zaprzecza
  s
}
oszacuj <- function(s) {                       # surowo i z wagami poststratyfikacyjnymi (wiek × wykształcenie)
  c(n = nrow(s), surowy = mean(s$zgloszone), wazony = sum(udzial * tapply(s$zgloszone, s$kom, mean)))
}

set.seed(3712)
proby <- lapply(plany$plan, function(p) badanie(p, n_plan[[p]])); names(proby) <- plany$plan
tab <- t(sapply(proby, oszacuj))
round(cbind(n = tab[, "n"], 100 * tab[, c("surowy", "wazony")], prawda = 100 * P), 2)

# To samo z pakietem survey: wagi poststratyfikacyjne, błąd standardowy i efekt schematu (deff) dla planu A
s <- proby[["A_losowa_internet_papier"]]
proj <- svydesign(ids = ~1, data = s, weights = ~1)
proj_w <- postStratify(proj, ~kom, data.frame(kom = names(udzial), Freq = as.numeric(udzial) * N))
w <- weights(proj_w)
est <- svymean(~zgloszone, proj_w, deff = TRUE)
round(c(odsetek = 100 * coef(est), SE = 100 * SE(est), ci = 100 * confint(est), deff = deff(est),
        deff_Kisha = 1 + (sd(w) / mean(w))^2 * (length(w) - 1) / length(w)), 3)

# Tożsamość Menga (2018) dla panelu D, na prawdziwych wartościach y: błąd = ρ(R, Y) · √((1 − f) / f) · σ(Y)
d <- proby[["D_panel_opt_in"]]
R <- integer(N); R[as.integer(rownames(d))] <- 1L
fr <- mean(R); rho <- cor(R, pop$y); sigma <- sqrt(mean((pop$y - P)^2))   # fr = n / N
round(c(blad_bezposrednio = mean(d$y) - P, blad_z_tozsamosci = rho * sqrt((1 - fr) / fr) * sigma,
        rho = rho, f = fr, n_efektywne = fr / (1 - fr) / rho^2), 4)
Wynik w R
                        N         odsetek_prawdziwy                  internet
                100000.00                     16.23                     85.18
odsetek_wsrod_internautow
                    17.19
   A_losowa_internet_papier B_losowa_intensywny_kontakt
                       5000                        2143
           C_losowa_telefon              D_panel_opt_in
                       6667                       15000
                                n surowy wazony prawda
A_losowa_internet_papier     1737  13.18  14.01  16.23
B_losowa_intensywny_kontakt  1302  13.82  14.50  16.23
C_losowa_telefon             1204   9.47  10.05  16.23
D_panel_opt_in              15137  21.37  20.23  16.23
odsetek.zgloszone                SE               ci1               ci2
           14.007             0.870            12.303            15.712
   deff.zgloszone        deff_Kisha
            1.110             1.053
blad_bezposrednio blad_z_tozsamosci               rho                 f
           0.0682            0.0682            0.0781            0.1514
      n_efektywne
          29.2186
2. Składniki błędu, MSE i RMSE przy rosnącym budżecie
R
# Krok 2. Powtórzenia Monte Carlo: rozkład obciążenia na źródła błędu, MSE = obciążenie² + wariancja
# i RMSE przy rosnącym budżecie (wymaga obiektów i funkcji z kroku 1)
skladniki <- function(plan, n) {
  s <- badanie(plan, n)
  pokryci <- if (plan == "D_panel_opt_in") pop$internet == 1 else rep(TRUE, N)
  c(pokrycie = mean(pop$y[pokryci]) - P,                       # kto w ogóle mógł trafić do badania
    dobor_i_udzial = mean(s$y) - mean(pop$y[pokryci]),          # kto odpowiedział (brak odpowiedzi, autoselekcja)
    pomiar = mean(s$zgloszone) - mean(s$y),                     # jak odpowiedział (aprobata społeczna)
    wazenie = oszacuj(s)[["wazony"]] - mean(s$zgloszone),       # co zmieniła poststratyfikacja
    oszacowanie = oszacuj(s)[["wazony"]], n = nrow(s))
}

# A. Plany za ten sam budżet, 1000 powtórzeń każdego
set.seed(3713)
mc <- lapply(plany$plan, function(p) t(replicate(1000, skladniki(p, n_plan[[p]])))); names(mc) <- plany$plan
wyn <- t(sapply(mc, function(m) {
  x <- m[, "oszacowanie"]; obc <- mean(x) - P; mse <- mean((x - P)^2)
  c(n = mean(m[, "n"]), colMeans(m[, 1:4]), obciazenie = obc, SD = sd(x),
    MSE = mse, RMSE = sqrt(mse), udzial_obc2_w_MSE = obc^2 / mse,
    pokrycie_95 = mean(abs(x - P) < qnorm(0.975) * sd(x)))   # jak często x ± 1.96 SD obejmuje prawdę
}))
round(100 * wyn[, c("pokrycie", "dobor_i_udzial", "pomiar", "wazenie", "obciazenie", "SD", "RMSE")], 2)
round(wyn[, c("n", "udzial_obc2_w_MSE", "pokrycie_95")], 3)
# błąd Monte Carlo obciążenia (w punktach procentowych)
round(100 * sapply(mc, function(m) sd(m[, "oszacowanie"]) / sqrt(nrow(m))), 3)

# B. RMSE przy budżecie od 3750 do 60 000 jednostek, 500 powtórzeń na punkt
mnozniki <- c(0.125, 0.25, 0.5, 1, 2)
set.seed(3714)
siatka <- do.call(rbind, lapply(plany$plan, function(p) do.call(rbind, lapply(mnozniki, function(m) {
  x <- replicate(500, { s <- badanie(p, n_plan[[p]] * m); c(oszacuj(s)[["wazony"]], nrow(s)) })
  data.frame(plan = p, budzet = BUDZET * m, n = mean(x[2, ]), obciazenie = 100 * (mean(x[1, ]) - P),
             SD = 100 * sd(x[1, ]), RMSE = 100 * sqrt(mean((x[1, ] - P)^2)))
}))))
print(transform(siatka, n = round(n), obciazenie = round(obciazenie, 2), SD = round(SD, 2), RMSE = round(RMSE, 2)),
      row.names = FALSE)
write.csv(siatka, "rmse-budzet.csv", row.names = FALSE)
write.csv(data.frame(plan = rownames(wyn), round(wyn, 6)), "skladniki-bledu.csv", row.names = FALSE)
Wynik w R
                            pokrycie dobor_i_udzial pomiar wazenie obciazenie
A_losowa_internet_papier        0.00          -2.38  -0.96    0.88      -2.45
B_losowa_intensywny_kontakt     0.00          -1.52  -1.02    0.54      -2.01
C_losowa_telefon                0.00          -2.94  -3.34    0.88      -5.39
D_panel_opt_in                  0.96           5.65  -1.59   -1.16       3.85
                              SD RMSE
A_losowa_internet_papier    0.85 2.59
B_losowa_intensywny_kontakt 1.02 2.25
C_losowa_telefon            0.93 5.47
D_panel_opt_in              0.32 3.86
                                    n udzial_obc2_w_MSE pokrycie_95
A_losowa_internet_papier     1755.840             0.893       0.185
B_losowa_intensywny_kontakt  1308.133             0.794       0.477
C_losowa_telefon             1225.421             0.971       0.000
D_panel_opt_in              14993.091             0.993       0.000
   A_losowa_internet_papier B_losowa_intensywny_kontakt
                      0.027                       0.032
           C_losowa_telefon              D_panel_opt_in
                      0.030                       0.010
                        plan budzet     n obciazenie   SD RMSE
    A_losowa_internet_papier   3750   219      -2.52 2.41 3.48
    A_losowa_internet_papier   7500   439      -2.39 1.74 2.96
    A_losowa_internet_papier  15000   878      -2.54 1.20 2.81
    A_losowa_internet_papier  30000  1755      -2.41 0.84 2.55
    A_losowa_internet_papier  60000  3512      -2.46 0.60 2.54
 B_losowa_intensywny_kontakt   3750   162      -2.27 2.89 3.67
 B_losowa_intensywny_kontakt   7500   327      -1.97 1.96 2.78
 B_losowa_intensywny_kontakt  15000   654      -1.96 1.41 2.41
 B_losowa_intensywny_kontakt  30000  1310      -1.97 0.98 2.20
 B_losowa_intensywny_kontakt  60000  2615      -2.00 0.69 2.11
            C_losowa_telefon   3750   153      -5.47 2.73 6.11
            C_losowa_telefon   7500   307      -5.50 1.84 5.80
            C_losowa_telefon  15000   611      -5.34 1.43 5.53
            C_losowa_telefon  30000  1223      -5.43 0.92 5.51
            C_losowa_telefon  60000  2445      -5.45 0.66 5.49
              D_panel_opt_in   3750  1876       3.85 1.00 3.98
              D_panel_opt_in   7500  3752       3.82 0.67 3.88
              D_panel_opt_in  15000  7498       3.84 0.47 3.87
              D_panel_opt_in  30000 14993       3.85 0.30 3.86
              D_panel_opt_in  60000 30000       3.86 0.19 3.87
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (funkcje losujące i tapply() z pakietów base i stats) z pakietem survey; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Margines błędu jako cały błąd badania. Przedział ufności opisuje wariancję z losowania. W przykładzie przedział ±1.96 SD wokół oszacowania z planu A obejmował prawdę w 18.5% powtórzeń zamiast w 95%.
- „Duża próba, więc wynik jest pewny”. Przy obciążeniu z doboru większa próba zawęża przedział wokół złej wartości. W panelu D 30 000 wywiadów dało RMSE 3.87, a 1876 – 3.98.
- Odsetek odpowiedzi jako miara jakości. Liczy się to, czy udział zależy od badanej cechy, a nie sam odsetek.
- Ważenie demografią jako lekarstwo na wszystko. Wagi usuwają tylko tę część obciążenia, którą tłumaczą zmienne korygujące, i podnoszą wariancję.
- Pomijanie strony pomiaru. Doskonała próba z pytaniem, na które ludzie odpowiadają nieszczerze, daje obciążony wynik, jak w planie C.
- Sumowanie błędów „na oko”. Składniki mogą mieć przeciwne znaki i się znosić. Zgodność wyniku z innym badaniem nie dowodzi, że żadnego obciążenia nie ma.
Najczęstsze pytania
Co to jest całkowity błąd badania sondażowego (TSE)?
To rama, która zbiera wszystkie źródła różnicy między wynikiem sondażu a prawdziwą wartością w populacji: pokrycie, dobór, brak odpowiedzi i korekty po stronie reprezentacji oraz trafność, błąd pomiaru i opracowanie danych po stronie pomiaru. Łączną miarą jest błąd średniokwadratowy, czyli obciążenie do kwadratu plus wariancja.
Czy margines błędu w sondażu obejmuje wszystkie błędy?
Nie. Margines błędu i przedział ufności opisują tylko wariancję z losowania. W symulacji przedział ±1.96 SD wokół wyniku losowej ankiety internetowej obejmował prawdziwy odsetek w 18.5% powtórzeń zamiast w 95%, bo brak odpowiedzi i aprobata społeczna przesunęły wynik o 2.45 punktu procentowego.
Czy duża próba internetowa jest lepsza od małej próby losowej?
Nie musi. Większa próba zmniejsza wariancję, ale nie obciążenie z autoselekcji. W przykładzie panel opt-in miał RMSE 3.87 punktu przy 30 000 wywiadów i 3.98 przy 1876, a losowa próba z intensywnym kontaktem przy 1308 respondentach – 2.25. Meng (2018) pokazuje, że o wartości takich danych decyduje korelacja udziału z badaną cechą i odsetek populacji w danych.
Na co wydać budżet badania sondażowego?
Najpierw oszacuj, czy w MSE przeważa obciążenie, czy wariancja. Gdy przeważa obciążenie, przeznacz środki na pokrycie, dodatkowy kontakt z grupami o niskim udziale i lepszy pomiar, np. tryb samodzielny przy pytaniach drażliwych. Wywiady dokładaj dopiero wtedy, gdy dominuje wariancja.
Jak opisać ograniczenia badania według TSE?
Przejdź po kolei przez pokrycie, dobór, brak odpowiedzi, ważenie i pomiar. Przy każdym źródle podaj, co zrobiono, jaki jest prawdopodobny kierunek błędu i czego nie da się wykluczyć. Zaznacz, że przedział ufności uwzględnia tylko błąd losowy, a jeśli kilka źródeł działa w jednym kierunku, napisz, czy wynik jest raczej dolnym, czy górnym oszacowaniem.
Powiązane hasła
Przeczytaj też
Rodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikIle zaproszeń wysłać w sondażu
Od marginesu błędu do liczby zaproszeń: efekt schematu, wagi, kwalifikacja, kontakt i odpowiedź, podgrupy oraz ryzyko niedoboru w R.
Czytaj →Planujesz badanie sondażowe i musisz uzasadnić wybór próby?
Pomożemy porównać plany w jednostkach kosztu, oszacować obciążenie i wariancję, przygotować wagi oraz opis ograniczeń, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Biemer, P. P. (2010). Total survey error: Design, implementation, and evaluation. Public Opinion Quarterly, 74(5), 817–848. https://doi.org/10.1093/poq/nfq058 ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Groves, R. M., & Lyberg, L. (2010). Total survey error: Past, present, and future. Public Opinion Quarterly, 74(5), 849–879. https://doi.org/10.1093/poq/nfq065
- Groves, R. M., Fowler, F. J., Jr., Couper, M. P., Lepkowski, J. M., Singer, E., & Tourangeau, R. (2009). Survey methodology (2nd ed.). Wiley.
- Kreuter, F., Presser, S., & Tourangeau, R. (2008). Social desirability bias in CATI, IVR, and web surveys: The effects of mode and question sensitivity. Public Opinion Quarterly, 72(5), 847–865. https://doi.org/10.1093/poq/nfn063 ● Otwarty dostęp
- Krumpal, I. (2013). Determinants of social desirability bias in sensitive surveys: A literature review. Quality & Quantity, 47(4), 2025–2047. https://doi.org/10.1007/s11135-011-9640-9 ● Otwarty dostęp
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election. The Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-aoas1161sf ● Otwarty dostęp
- Mercer, A. W., Kreuter, F., Keeter, S., & Stuart, E. A. (2017). Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference. Public Opinion Quarterly, 81(S1), 250–271. https://doi.org/10.1093/poq/nfw060 ● Otwarty dostęp
Cytowania BibTeX
@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{biemer2010total, author={Biemer, Paul P.}, title={{Total survey error: Design, implementation, and evaluation}}, journal={Public Opinion Quarterly}, year={2010}, volume={74}, number={5}, pages={817--848}, doi={10.1093/poq/nfq058}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{groves2010total, author={Groves, Robert M. and Lyberg, Lars}, title={{Total survey error: Past, present, and future}}, journal={Public Opinion Quarterly}, year={2010}, volume={74}, number={5}, pages={849--879}, doi={10.1093/poq/nfq065}}@book{groves2009survey, author={Groves, Robert M. and Fowler, Jr., Floyd J. and Couper, Mick P. and Lepkowski, James M. and Singer, Eleanor and Tourangeau, Roger}, title={{Survey methodology}}, year={2009}, edition={2}, publisher={Wiley}}@article{kreuter2008social, author={Kreuter, F. and Presser, S. and Tourangeau, R.}, title={{Social desirability bias in CATI, IVR, and web surveys: The effects of mode and question sensitivity}}, journal={Public Opinion Quarterly}, year={2008}, volume={72}, number={5}, pages={847--865}, doi={10.1093/poq/nfn063}}@article{krumpal2013determinants, author={Krumpal, Ivar}, title={{Determinants of social desirability bias in sensitive surveys: A literature review}}, journal={Quality \& Quantity}, year={2013}, volume={47}, number={4}, pages={2025--2047}, doi={10.1007/s11135-011-9640-9}}@article{meng2018statistical, author={Meng, Xiao-Li}, title={{Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election}}, journal={The Annals of Applied Statistics}, year={2018}, volume={12}, number={2}, pages={685--726}, doi={10.1214/18-aoas1161sf}}@article{mercer2017theory, author={Mercer, Andrew W. and Kreuter, Frauke and Keeter, Scott and Stuart, Elizabeth A.}, title={{Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={250--271}, doi={10.1093/poq/nfw060}}