Co to jest estymator nieobciążony?
Estymator nieobciążony (ang. unbiased estimator) to reguła szacowania parametru θ, której wartość oczekiwana równa się θ: E(θ̂) = θ. W wielu hipotetycznych próbach średnio trafia więc w parametr, choć w pojedynczej próbie może się od niego różnić. Różnica E(θ̂) − θ to obciążenie (ang. bias). Szersze tło, czyli różnicę między estymatorem a oszacowaniem oraz efektywność i zgodność, opisuje hasło estymacja punktowa.
Obciążenie to tylko część błędu. Błąd średniokwadratowy łączy je z rozrzutem: MSE = wariancja estymatora + obciążenie².
Obciążone i nieobciążone estymatory
- Średnia z próby jest nieobciążonym estymatorem średniej populacji.
- Wariancja z dzielnikiem n − 1 jest nieobciążona, a z dzielnikiem n średnio zaniża σ² o czynnik (n − 1)/n. Wersję z n daje m.in. metoda największej wiarygodności; różnicę wyjaśniają stopnie swobody.
- Odchylenie standardowe z n − 1 jest lekko zaniżone: pierwiastek nie zachowuje nieobciążoności.
- Eta kwadrat zawyża efekt w populacji. Kelley (1935) zauważył, że stosunek korelacyjny z próby różni się od wartości w populacji systematycznie, i zaproponował nieobciążoną miarę ε. Albers i Lakens (2018) odradzają η² w analizie mocy opartej na danych pilotażowych; lepsze są ε² i omega kwadrat.
Przykład w R
W 100 000 próbach po 5 obserwacji z rozkładu o σ² = 1 średnia wariancja z dzielnikiem n − 1 wyniosła 1.001, a z dzielnikiem n – 0.801 (teoretycznie 0.8). MSE był jednak mniejszy dla wersji obciążonej: 0.356 wobec 0.494. Średnie SD wyniosło 0.941, zgodnie z teoretycznym czynnikiem 0.940.
Na rysunku
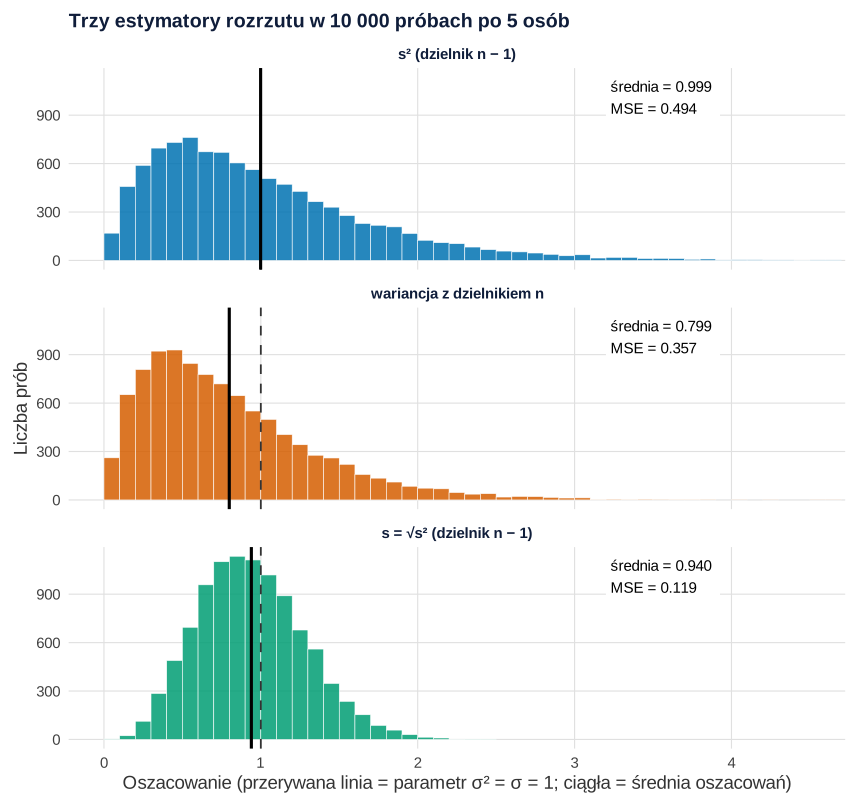
set.seed(4792)).Co widać. Każdy panel to 10 000 oszacowań z prób po pięć osób z rozkładu N(0, 1), więc parametr wynosi σ² = σ = 1 (przerywana linia). Średnia wariancji s² z dzielnikiem n − 1 wyniosła 0.999 (błąd Monte Carlo ±0.007), czyli estymator trafia w parametr. Wariancja z dzielnikiem n ma średnią 0.799: obciążenie wynosi −0.20, tyle, ile przewiduje czynnik (n − 1)/n = 0.8. Odchylenie standardowe, czyli pierwiastek z s², wyszło średnio 0.940 (±0.003) – nieobciążoność wariancji nie przenosi się na SD. Liczebność n = 5 wybrano ręcznie, żeby obciążenie było dobrze widoczne; ziarna nie zmieniano.
Na co uważać. Nieobciążony nie znaczy „zwykle trafny”. Rozkład s² jest prawoskośny, więc w 59.1% prób (±0.5 pp) s² wyszło poniżej 1, a średnią do parametru podciągają rzadsze, duże oszacowania. Wersja z dzielnikiem n ma mniejszy błąd średniokwadratowy (0.357 wobec 0.494), bo mniejszy rozrzut z nawiązką rekompensuje jej obciążenie. Rysunek nie rozstrzyga więc, który estymator jest lepszy: brak obciążenia liczy się, gdy wyniki wielu badań się uśrednia, a mały MSE – gdy liczy się trafność pojedynczego oszacowania. Ten kompromis rozwija hasło efektywność estymatora, a zachowanie przy rosnącym n – estymator zgodny. Skąd bierze się skośny kształt rozkładu s² (rozkład χ²), pokazuje wpis Skąd się biorą rozkłady t, χ² i F.
Podpis do pracy:
Kod rysunku losuje dane z ustalonym ziarnem set.seed(4792) i liczy się w kilka sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Wariancja z dzielnikiem n − 1 i n oraz SD w 10 000 próbach po n = 5
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("#0072B2", "#D55E00", "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "none", plot.background = element_rect(fill = "white", colour = NA))

# 10 000 prób po n = 5 z N(0, 1): prawdziwe σ² = 1 i σ = 1
set.seed(4792)
n <- 5; R <- 10000
s2  <- replicate(R, var(rnorm(n)))   # dzielnik n − 1
v_n <- s2 * (n - 1) / n              # dzielnik n
s   <- sqrt(s2)                      # SD z dzielnikiem n − 1

est <- list("s² (dzielnik n − 1)" = s2, "wariancja z dzielnikiem n" = v_n, "s = √s² (dzielnik n − 1)" = s)
podsum <- data.frame(estymator = names(est), prawda = 1,
  srednia = sapply(est, mean), blad_MC = sapply(est, function(x) sd(x) / sqrt(R)),
  obciazenie = sapply(est, mean) - 1, SD = sapply(est, sd),
  MSE = sapply(est, function(x) mean((x - 1)^2)),
  proc_ponizej_prawdy = sapply(est, function(x) 100 * mean(x < 1)),
  se_proc = sapply(est, function(x) 100 * sqrt(mean(x < 1) * (1 - mean(x < 1)) / R)), row.names = NULL)
print(format(podsum, digits = 3), row.names = FALSE)
c(teoria_sr_vn = (n - 1) / n,
  teoria_sr_s = sqrt(2 / (n - 1)) * gamma(n / 2) / gamma((n - 1) / 2))   # c4

# Rysunek: histogram każdego estymatora; przerywana linia = parametr (1),
# ciągła linia i etykieta = średnia z 10 000 prób
dl <- data.frame(estymator = factor(rep(names(est), each = R), levels = names(est)), wartosc = unlist(est))
podsum$estymator <- factor(podsum$estymator, levels = names(est))
podsum$etykieta <- sprintf("średnia = %.3f\nMSE = %.3f", podsum$srednia, podsum$MSE)
p <- ggplot(dl, aes(wartosc, fill = estymator)) +
  geom_histogram(binwidth = 0.1, boundary = 0, colour = "white", linewidth = 0.2, alpha = 0.85) +
  geom_vline(xintercept = 1, linetype = "dashed", colour = "grey20") +
  geom_vline(aes(xintercept = srednia), data = podsum, colour = "black", linewidth = 1.1) +
  geom_label(aes(x = 3.2, y = Inf, label = etykieta), data = podsum, inherit.aes = FALSE,
             vjust = 1.2, hjust = 0, size = 4, linewidth = 0, fill = "white") +
  facet_wrap(~ estymator, ncol = 1) +
  scale_fill_manual(values = kol) +
  coord_cartesian(xlim = c(0, 4.5)) +
  labs(title = "Trzy estymatory rozrzutu w 10 000 próbach po 5 osób",
       x = "Oszacowanie (przerywana linia = parametr σ² = σ = 1; ciągła = średnia oszacowań)",
       y = "Liczba prób") +
  motyw
p
Wynik w R
                 estymator prawda srednia blad_MC obciazenie    SD   MSE
       s² (dzielnik n − 1)      1   0.999 0.00703   -0.00134 0.703 0.494
 wariancja z dzielnikiem n      1   0.799 0.00563   -0.20107 0.563 0.357
  s = √s² (dzielnik n − 1)      1   0.940 0.00340   -0.06034 0.340 0.119
 proc_ponizej_prawdy se_proc
                59.1   0.492
                71.1   0.453
                59.1   0.492
teoria_sr_vn  teoria_sr_s
   0.8000000    0.9399856
Jak opisać w pracy
Na co uważać
- Nieobciążony to nie trafny. Pojedyncze oszacowanie z małej próby może być daleko od parametru.
- Obciążenie a próba. Nieobciążoność estymatora nie chroni przed błędem selekcji – jeśli próba jest stronnicza, średnia też będzie.
Estymator nieobciążony w R
Kod symuluje wiele małych prób z rozkładu normalnego i porównuje wariancję z dzielnikiem n − 1 i n pod względem obciążenia i błędu średniokwadratowego oraz sprawdza obciążenie odchylenia standardowego.
Obciążenie i MSE wariancji z próby
R
set.seed(4791)                          # 100 000 prób po n = 5 z N(0, 1), σ² = 1
n <- 5
s2 <- replicate(100000, var(rnorm(n)))  # dzielnik n − 1
v_n <- s2 * (n - 1) / n                 # dzielnik n
round(c(sr_s2 = mean(s2), sr_vn = mean(v_n),
        MSE_s2 = mean((s2 - 1)^2), MSE_vn = mean((v_n - 1)^2),
        sr_SD = mean(sqrt(s2)),
        c4 = sqrt(2 / (n - 1)) * gamma(n / 2) / gamma((n - 1) / 2)), 3)
Wynik w R
 sr_s2  sr_vn MSE_s2 MSE_vn  sr_SD     c4
 1.001  0.801  0.494  0.356  0.941  0.940
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego dzielnik n − 1 daje nieobciążoną wariancję?
Odchylenia liczymy od średniej z próby, która leży bliżej danych niż średnia populacji, więc suma kwadratów jest średnio za mała. Podzielenie jej przez n − 1 zamiast n dokładnie to wyrównuje.
Czy odchylenie standardowe z próby jest estymatorem nieobciążonym?
Nie. Nawet przy dzielniku n − 1 jest lekko zaniżone, bo pierwiastek z nieobciążonej wariancji nie jest nieobciążony. Przy n = 5 średnie SD wynosi około 0.94σ, a w większych próbach różnica szybko maleje.
Czy estymator nieobciążony jest zawsze lepszy od obciążonego?
Nie zawsze. Estymator z niewielkim obciążeniem, ale mniejszym rozrzutem może mieć mniejszy błąd średniokwadratowy (MSE). Dlatego ocenia się oba aspekty: obciążenie i precyzję.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004 ● Otwarty dostęp
- Kelley, T. L. (1935). An unbiased correlation ratio measure. Proceedings of the National Academy of Sciences, 21(9), 554–559. https://doi.org/10.1073/pnas.21.9.554 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{albers2018power, author={Albers, Casper and Lakens, Daniël}, title={{When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={74}, pages={187--195}, doi={10.1016/j.jesp.2017.09.004}}@article{kelley1935unbiased, author={Kelley, Truman L.}, title={{An unbiased correlation ratio measure}}, journal={Proceedings of the National Academy of Sciences}, year={1935}, volume={21}, number={9}, pages={554--559}, doi={10.1073/pnas.21.9.554}}