Co to jest estymator zgodny?
Estymator zgodny (ang. consistent estimator) to reguła szacowania parametru θ, której wyniki skupiają się coraz bliżej θ, gdy rośnie liczebność próby n. Formalnie: dla każdej, nawet bardzo małej odległości ε prawdopodobieństwo, że estymator chybi θ o więcej niż ε, dąży do zera. To zbieżność według prawdopodobieństwa. Wystarczy, by obciążenie i wariancja estymatora malały do zera. Wariancja malejąca do zera oznacza też, że do zera maleje jego błąd standardowy.
Klasyczny przykład to średnia z próby: z prawa wielkich liczb zbliża się do wartości oczekiwanej. Seneta (2013) śledzi to twierdzenie od Jakuba Bernoullego, który pytał też, jak duża próba wystarczy do zadanej precyzji. Wald (1949) zajął się warunkami zgodności estymatora największej wiarygodności.
Zgodność a nieobciążoność
To dwie różne własności. Estymator nieobciążony średnio trafia w θ przy każdym n, a zgodny trafia coraz dokładniej, gdy n rośnie. Estymator może być:
- obciążony, ale zgodny – np. odchylenie standardowe z próby albo maksimum z próby jako estymator górnej granicy rozkładu;
- nieobciążony, ale niezgodny – np. oszacowanie z jednej obserwacji, które nie poprawia się, gdy dobieramy osoby.
Szerzej o cechach dobrego estymatora piszemy w haśle estymacja punktowa.
Przykład w R
Losowaliśmy po 10 000 prób z rozkładu jednostajnego na przedziale od 0 do θ = 10. Maksimum z próby zawsze leży poniżej 10, więc jest obciążone: średnio wynosiło 8.33, 9.81 i 9.98 przy n = 5, 50 i 500 (obciążenie teoretyczne −θ/(n + 1), czyli −1.67, −0.20 i −0.02). Odsetek prób, w których chybiło o więcej niż 0.5, spadł z .777 do .072 i do zera. Podwojona pierwsza obserwacja jest nieobciążona (średnio 9.96–10.11), ale chybiała o ponad 0.5 w około 95% prób przy każdym n.
Na rysunku
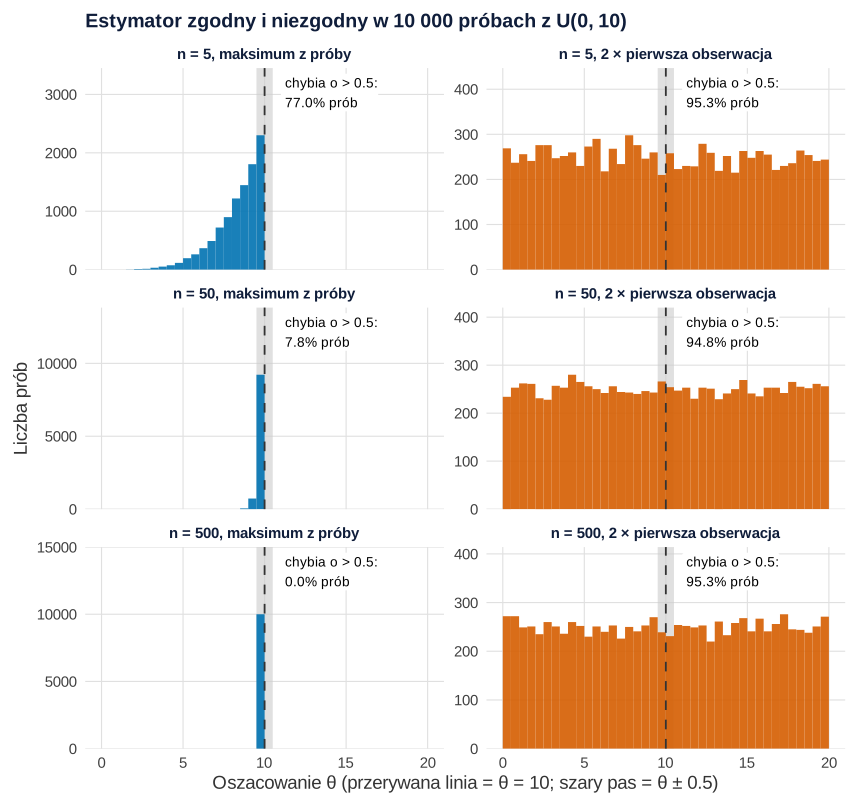
set.seed(4942)).Co widać. Rysunek powtarza przykład z hasła na 10 000 nowych próbach (inne ziarno, więc liczby nieco różnią się od tych powyżej). Maksimum z próby (lewa kolumna) zawsze leży poniżej θ = 10 i przy n = 5 jest wyraźnie zaniżone (średnio 8.35), ale z każdym dziesięciokrotnym zwiększeniem próby jego rozkład ściska się przy θ: SD spada z 1.40 do 0.19 i 0.02, a odsetek oszacowań chybiających o więcej niż 0.5 – z 77.0% (±0.4 pp) do 7.8% (±0.3 pp) i do zera. Podwojona pierwsza obserwacja (prawa kolumna) ma średnią bliską 10 (od 9.88 do 10.01), ale jej rozkład przy każdym n jest taki sam: płaski od 0 do 20, z SD od 5.78 do 5.82, i chybia w 94.8–95.3% prób. Wartość θ, próg 0.5 i liczebności ustawiono ręcznie tak jak w przykładzie; ziarna nie zmieniano.
Na co uważać. Oś pionowa ma w każdym panelu inną skalę: wysoki słupek przy n = 500 znaczy tylko tyle, że prawie wszystkie oszacowania mieszczą się w jednym przedziale o szerokości 0.5. Rysunek pokazuje zgodność w sytuacji idealnej – losowej próby z dobrze określonego rozkładu. Nie pokazuje, co dzieje się przy próbie stronniczej: rozkład też by się zwężał, tyle że wokół niewłaściwej wartości. Wąski rozkład przy dużym n nie jest więc dowodem trafności. Zawężanie się rozkładu średniej i mediany pokazuje hasło estymacja punktowa, a średnią bieżącą w kolejnych losowaniach – prawo wielkich liczb.
Podpis do pracy:
Kod rysunku losuje dane z ustalonym ziarnem set.seed(4942) i liczy się w kilka sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Dwa estymatory górnej granicy θ rozkładu U(0, 10) przy n = 5, 50 i 500
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("maksimum z próby" = "#0072B2", "2 × pierwsza obserwacja" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "none", plot.background = element_rect(fill = "white", colour = NA))

theta <- 10; R <- 10000; ns <- c(5, 50, 500)
set.seed(4942)
dl <- do.call(rbind, lapply(ns, function(n) {
  x <- matrix(runif(R * n, 0, theta), nrow = R)          # R prób po n obserwacji
  rbind(data.frame(n = n, estymator = "maksimum z próby", wartosc = apply(x, 1, max)),
        data.frame(n = n, estymator = "2 × pierwsza obserwacja", wartosc = 2 * x[, 1]))
}))

# Średnia, SD i odsetek oszacowań chybiających θ o więcej niż 0.5 (z błędem Monte Carlo)
podsum <- aggregate(wartosc ~ estymator + n, dl, function(w) c(srednia = mean(w), SD = sd(w),
  P_chybia = mean(abs(w - theta) > 0.5), se_P = sqrt(mean(abs(w - theta) > 0.5) * (1 - mean(abs(w - theta) > 0.5)) / R)))
podsum <- data.frame(podsum[1:2], round(podsum$wartosc, 3))
print(podsum, row.names = FALSE)

# Rysunek: histogramy (przedziały co 0.5, oś Y osobna w każdym panelu); szary pas = θ ± 0.5, przerywana linia = θ
dl$estymator <- factor(dl$estymator, levels = names(kol))
dl$panel <- factor(paste("n =", dl$n), levels = paste("n =", ns))
podsum$estymator <- factor(podsum$estymator, levels = names(kol))
podsum$panel <- factor(paste("n =", podsum$n), levels = paste("n =", ns))
podsum$etykieta <- sprintf("chybia o > 0.5:\n%.1f%% prób", 100 * podsum$P_chybia)
p <- ggplot(dl, aes(wartosc, fill = estymator)) +
  annotate("rect", xmin = theta - 0.5, xmax = theta + 0.5, ymin = -Inf, ymax = Inf, fill = "grey80", alpha = 0.6) +
  geom_histogram(binwidth = 0.5, boundary = 0, alpha = 0.9) +
  geom_vline(xintercept = theta, linetype = "dashed", colour = "grey20") +
  geom_label(aes(x = 11, y = Inf, label = etykieta), data = podsum, inherit.aes = FALSE,
             vjust = 1.15, hjust = 0, size = 3.6, linewidth = 0, fill = "white") +
  facet_wrap(~ panel + estymator, ncol = 2, scales = "free_y", labeller = label_wrap_gen(width = 40, multi_line = FALSE)) +
  scale_fill_manual(values = kol) +
  scale_x_continuous(breaks = seq(0, 20, 5), limits = c(0, 20)) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.5))) +   # miejsce na etykiety
  labs(title = "Estymator zgodny i niezgodny w 10 000 próbach z U(0, 10)",
       x = "Oszacowanie θ (przerywana linia = θ = 10; szary pas = θ ± 0.5)", y = "Liczba prób") +
  motyw
p
Wynik w R
               estymator   n srednia    SD P_chybia  se_P
 2 × pierwsza obserwacja   5   9.879 5.781    0.953 0.002
        maksimum z próby   5   8.346 1.401    0.770 0.004
 2 × pierwsza obserwacja  50  10.012 5.790    0.948 0.002
        maksimum z próby  50   9.804 0.194    0.078 0.003
 2 × pierwsza obserwacja 500  10.010 5.816    0.953 0.002
        maksimum z próby 500   9.980 0.020    0.000 0.000
Jak opisać w pracy
Na co uważać
- Zgodność to własność graniczna. Nie mówi, ile osób wystarczy – przy n = 5 maksimum chybiało w 78% prób.
- Zgodność zależy od założeń. Przy próbie stronniczej estymator zbiega do wartości w badanej grupie, a nie w populacji.
- Nieobciążoność nie zastępuje zgodności. Lepszy bywa estymator lekko obciążony, którego błąd szybko maleje z n.
Estymator zgodny w R
Kod porównuje w symulacji dwa estymatory górnej granicy rozkładu jednostajnego: obciążone, ale zgodne maksimum z próby i nieobciążoną, ale niezgodną podwojoną pierwszą obserwację.
Obciążenie i trafność dwóch estymatorów przy rosnącym n
R
set.seed(4941)
theta <- 10                                  # rozkład jednostajny U(0, 10)
n <- c(5, 50, 500)
wyniki <- t(sapply(n, function(k) {
  maks <- replicate(10000, max(runif(k, 0, theta)))  # estymator: maksimum z próby
  x1   <- replicate(10000, runif(1, 0, theta) * 2)   # estymator: 2 * pierwsza obserwacja
  c(n = k,
    sr_maks = mean(maks), obc_teor = -theta / (k + 1),     # obciążenie −θ/(n + 1)
    P_maks = mean(abs(maks - theta) > 0.5),                # P(|błąd| > 0.5)
    sr_2x1 = mean(x1), P_2x1 = mean(abs(x1 - theta) > 0.5))
}))
round(wyniki, 3)
Wynik w R
       n sr_maks obc_teor P_maks sr_2x1 P_2x1
[1,]   5   8.326   -1.667  0.777  9.962 0.950
[2,]  50   9.806   -0.196  0.072  9.967 0.945
[3,] 500   9.980   -0.020  0.000 10.105 0.954
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy estymator obciążony może być zgodny?
Tak, jeśli obciążenie maleje do zera wraz z n. Maksimum z próby z rozkładu jednostajnego U(0, 10) zaniżało granicę średnio o 1.67 przy n = 5 i tylko o 0.02 przy n = 500.
Czy każdy estymator nieobciążony jest zgodny?
Nie. Podwojona pierwsza obserwacja z U(0, 10) średnio trafia w 10, ale nie korzysta z reszty próby i chybiała o ponad 0.5 w około 95% prób, niezależnie od n.
Jak sprawdzić, czy estymator jest zgodny?
Wystarczy pokazać, że jego obciążenie i wariancja dążą do zera, gdy rośnie n. W praktyce pomaga symulacja: odsetek oszacowań odległych od parametru powinien maleć wraz z liczebnością próby.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Seneta, E. (2013). A tricentenary history of the law of large numbers. Bernoulli, 19(4), 1088–1121. https://doi.org/10.3150/12-bejsp12 ● Otwarty dostęp: pełny tekst
- Wald, A. (1949). Note on the consistency of the maximum likelihood estimate. The Annals of Mathematical Statistics, 20(4), 595–601. https://doi.org/10.1214/aoms/1177729952 ● Otwarty dostęp
Cytowania BibTeX
@article{seneta2013tricentenary, author={Seneta, Eugene}, title={{A tricentenary history of the law of large numbers}}, journal={Bernoulli}, year={2013}, volume={19}, number={4}, pages={1088--1121}, doi={10.3150/12-bejsp12}}@article{wald1949note, author={Wald, Abraham}, title={{Note on the consistency of the maximum likelihood estimate}}, journal={The Annals of Mathematical Statistics}, year={1949}, volume={20}, number={4}, pages={595--601}, doi={10.1214/aoms/1177729952}}