Co to jest prawo wielkich liczb?
Prawo wielkich liczb (ang. law of large numbers) mówi, że średnia z coraz większej liczby niezależnych obserwacji z tego samego rozkładu zbliża się do wartości oczekiwanej w populacji. Dla zmiennej 0/1 oznacza to, że odsetek sukcesów zbliża się do prawdopodobieństwa p. Seneta (2013) śledzi historię tego twierdzenia od Jakuba Bernoulliego (1713). Bernoulli pytał też praktycznie: jak duża próba wystarczy, by osiągnąć zadaną dokładność? Warunkiem jest istnienie skończonej wartości oczekiwanej.
Prawo wielkich liczb a centralne twierdzenie graniczne
Prawo wielkich liczb mówi, dokąd zmierza średnia: do μ. Centralne twierdzenie graniczne mówi, jaki kształt ma rozkład średnich wokół μ – w przybliżeniu normalny, z rozrzutem równym błędowi standardowemu σ/√n. Dzięki pierwszemu średnia z próby losowej jest estymatorem zgodnym (por. estymator nieobciążony), dzięki drugiemu liczymy przedziały ufności.
Przykład
W symulacji w R rzucaliśmy „monetą” o prawdopodobieństwie sukcesu 0.3. W jednej serii odsetek sukcesów po 10, 100, 1000 i 10 000 próbach wyniósł 0.400, 0.350, 0.303 i 0.302. Liczba sukcesów ponad oczekiwane np nie malała jednak: 1, 5, 3, a na końcu 23. W 2000 powtórzeniach odchylenie standardowe odsetka spadało z 0.148 do 0.005, zgodnie ze wzorem √(p(1 − p)/n). Dla rozkładu Cauchy'ego, który nie ma wartości oczekiwanej, średnia skakała (−0.37, 0.25, 1.77, 0.28) i się nie stabilizowała.
Na rysunku
Przykład wyżej śledził jedną serię. Rysunek pokazuje 20 serii naraz: średnią bieżącą, czyli średnią z pierwszych n obserwacji, liczoną po każdej kolejnej obserwacji. Symulowaliśmy 1000 serii po 5000 obserwacji, a na wykresie jest 20 pierwszych. Prawdopodobieństwo sukcesu 0.3, długość serii i ich liczbę ustawiliśmy ręcznie; ziarno 4581 ustalono raz i nie zmieniano go.
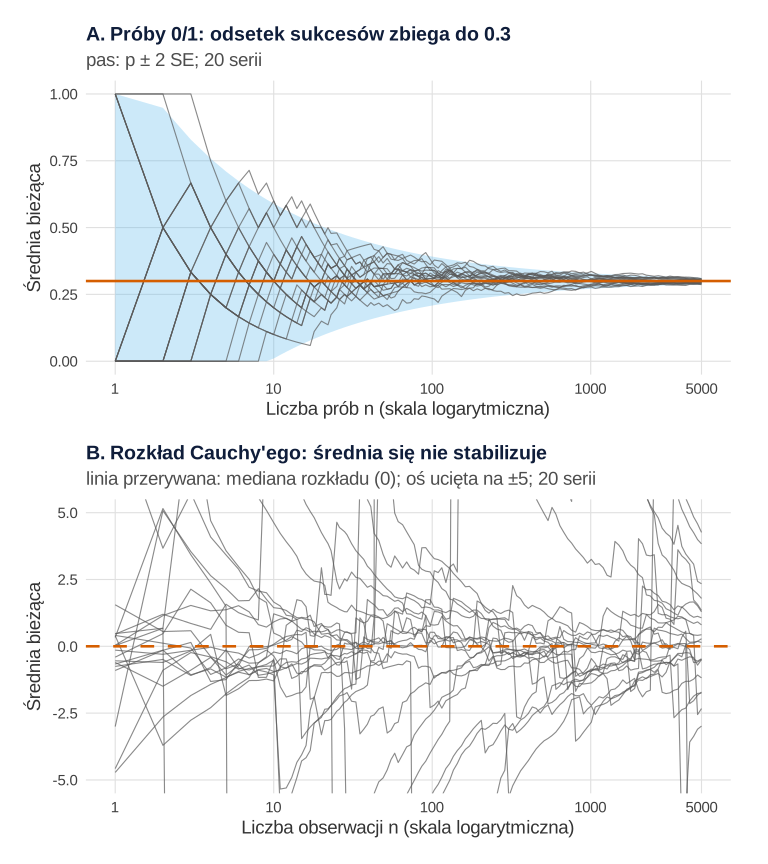
set.seed(4581)).Co widać. Na panelu A ścieżki zbiegają do 0.3, a lejek zwęża się jak 1/√n: jego połowa szerokości to 0.290 przy n = 10, 0.092 przy 100, 0.029 przy 1000 i 0.013 przy 5000. W lejku mieści się stale około 95% serii: 96.6% przy n = 100 i 95.3% przy 5000 (błąd Monte Carlo ok. 0.7 pp). Przy n = 10 – 92.3%, bo przy tak małym n odsetek przyjmuje tylko kilka wartości. Panel B: w rozkładzie Cauchy’ego nie ma wartości oczekiwanej, więc nic się nie zwęża. Odsetek serii, w których |średnia| przekracza 1, wynosi 51.4% przy n = 10 i 49.2% przy n = 5000 (błąd MC ok. 1.6 pp) – teoretycznie zawsze 50%, bo średnia z Cauchy’ego ma ten sam rozkład co jedna obserwacja.
Na co uważać. Skala logarytmiczna rozciąga początek serii – większość obserwacji leży w prawej części wykresu. Panel B ma oś uciętą na ±5. Rysunek nie pokazuje, kiedy próba jest „dość duża”: to zależy od wymaganej dokładności, a nie od kształtu ścieżek.
Podpis do pracy:
Kod poniżej odtwarza rysunek i odsetki z tej sekcji (cały liczy się w kilka sekund). Jest samowystarczalny: kolory i prosty motyw definiuje sam, a losowanie zaczyna się od własnego set.seed(4581). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Średnia bieżąca w 1000 seriach: próby 0/1 (prawdopodobieństwo sukcesu 0.3) i rozkład Cauchy'ego
# Na wykresie 20 pierwszych serii; liczby liczone ze wszystkich 1000
library(ggplot2)
library(patchwork)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))
set.seed(4581)
p <- 0.3; n_max <- 5000; serie <- 1000
x <- matrix(rbinom(n_max * serie, 1, p), nrow = n_max)          # kolumna = jedna seria prób 0/1
y <- matrix(rcauchy(n_max * serie), nrow = n_max)               # Cauchy: brak wartości oczekiwanej
sr_x <- apply(x, 2, cumsum) / seq_len(n_max)                    # średnia bieżąca po 1, 2, ..., n_max
sr_y <- apply(y, 2, cumsum) / seq_len(n_max)

# Odsetek serii w lejku p ± 2·SE (SE = √(p(1 − p)/n)) z błędem Monte Carlo
# oraz odsetek serii Cauchy'ego, w których |średnia| > 1 (teoretycznie zawsze .5)
n_tab <- c(10, 100, 1000, 5000)
se <- sqrt(p * (1 - p) / n_tab)
w_lejku <- sapply(seq_along(n_tab), function(i) mean(abs(sr_x[n_tab[i], ] - p) <= 2 * se[i]))
cauchy_ponad_1 <- sapply(n_tab, function(n) mean(abs(sr_y[n, ]) > 1))
round(data.frame(n = n_tab, granice_lejka = 2 * se, w_lejku, bladMC_w_lejku = sqrt(w_lejku * (1 - w_lejku) / serie),
                 cauchy_ponad_1, bladMC_cauchy = sqrt(cauchy_ponad_1 * (1 - cauchy_ponad_1) / serie)), 3)

# Do rysunku: 20 serii w ok. 150 punktach rozłożonych równomiernie na skali logarytmicznej
pkt <- unique(round(10^seq(0, log10(n_max), length.out = 150)))
do_wykresu <- function(m) data.frame(n = rep(pkt, 20), seria = rep(1:20, each = length(pkt)),
                                     srednia = as.vector(m[pkt, 1:20]))
lejek <- data.frame(n = pkt, dol = p - 2 * sqrt(p * (1 - p) / pkt), gora = p + 2 * sqrt(p * (1 - p) / pkt))
pa <- ggplot(do_wykresu(sr_x), aes(n, srednia, group = seria)) +
  geom_ribbon(data = lejek, aes(x = n, ymin = pmax(dol, 0), ymax = pmin(gora, 1)), inherit.aes = FALSE,
              fill = "#56B4E9", alpha = 0.3) +
  geom_line(colour = "grey35", alpha = 0.7, linewidth = 0.4) +
  geom_hline(yintercept = p, colour = "#D55E00", linewidth = 0.9) +
  scale_x_log10(breaks = c(1, 10, 100, 1000, 5000)) +
  labs(title = "A. Próby 0/1: odsetek sukcesów zbiega do 0.3",
       subtitle = "pas: p ± 2 SE; 20 serii", x = "Liczba prób n (skala logarytmiczna)", y = "Średnia bieżąca") + motyw
pb <- ggplot(do_wykresu(sr_y), aes(n, srednia, group = seria)) +
  geom_line(colour = "grey35", alpha = 0.7, linewidth = 0.4) +
  geom_hline(yintercept = 0, colour = "#D55E00", linewidth = 0.9, linetype = "dashed") +
  scale_x_log10(breaks = c(1, 10, 100, 1000, 5000)) +
  coord_cartesian(ylim = c(-5, 5)) +                             # pojedyncze skoki wychodzą poza oś
  labs(title = "B. Rozkład Cauchy'ego: średnia się nie stabilizuje",
       subtitle = "linia przerywana: mediana rozkładu (0); oś ucięta na ±5; 20 serii",
       x = "Liczba obserwacji n (skala logarytmiczna)", y = "Średnia bieżąca") + motyw
p1 <- pa / pb
p1   # zapis: ggsave("prawo-wielkich-liczb-sciezki-sredniej.svg", p1, width = 8, height = 9)
Wynik w R
     n granice_lejka w_lejku bladMC_w_lejku cauchy_ponad_1 bladMC_cauchy
1   10         0.290   0.923          0.008          0.514         0.016
2  100         0.092   0.966          0.006          0.483         0.016
3 1000         0.029   0.955          0.007          0.508         0.016
4 5000         0.013   0.953          0.007          0.492         0.016
Jak opisać w pracy
Na co uważać
- Prawo „małych” liczb. Tversky i Kahneman (1971) pokazali, że nawet badacze uważają małe próby za równie reprezentatywne jak duże i przeceniają szansę powtórzenia wyniku. Ile to „dużo”, rozstrzyga dobór liczebności próby.
- Błąd hazardzisty. Nic się nie „wyrównuje”: maleje odchylenie odsetka, a nie liczby sukcesów, której rozkład opisuje rozkład dwumianowy.
- Duża próba nielosowa. Średnia zbiega wtedy do wartości w badanej grupie, a nie w populacji – liczebność nie usuwa błędu systematycznego.
Prawo wielkich liczb w R
Kod symuluje jedną długą serię prób 0/1 i 2000 powtórzeń dla kilku liczebności, porównuje rozrzut odsetka z wartością teoretyczną i pokazuje rozkład Cauchy'ego, dla którego prawo wielkich liczb nie działa.
Odsetek sukcesów, jego rozrzut i średnia z rozkładu Cauchy'ego przy rosnącym n
R
set.seed(4580)
p <- 0.3                                    # prawdziwe prawdopodobieństwo sukcesu
n <- c(10, 100, 1000, 10000)
x <- rbinom(max(n), 1, p)                   # jedna długa seria prób 0/1
y <- rcauchy(max(n))                        # rozkład Cauchy'ego: brak wartości oczekiwanej
sd_srednich <- sapply(n, function(k) sd(rbinom(2000, k, p) / k))  # 2000 powtórzeń
data.frame(n = n,
           odsetek = round(cumsum(x)[n] / n, 3),       # średnia z jednej serii
           nadwyzka = cumsum(x)[n] - p * n,            # sukcesy ponad oczekiwane n * p
           sd_obs  = round(sd_srednich, 4),            # rozrzut średnich w powtórzeniach
           sd_teor = round(sqrt(p * (1 - p) / n), 4),  # sqrt(p(1 - p)/n)
           cauchy  = round(cumsum(y)[n] / n, 3))
Wynik w R
      n odsetek nadwyzka sd_obs sd_teor cauchy
1    10   0.400        1 0.1482  0.1449 -0.370
2   100   0.350        5 0.0462  0.0458  0.252
3  1000   0.303        3 0.0146  0.0145  1.770
4 10000   0.302       23 0.0046  0.0046  0.283
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w tej sekcji nie wymagają dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się prawo wielkich liczb od centralnego twierdzenia granicznego?
Prawo wielkich liczb mówi, że średnia z próby zbliża się do średniej w populacji. Centralne twierdzenie graniczne opisuje kształt rozkładu średnich wokół niej: w przybliżeniu normalny, z rozrzutem σ/√n.
Czy prawo wielkich liczb oznacza, że po serii porażek musi przyjść sukces?
Nie. Kolejne próby są niezależne i nie „nadrabiają” wcześniejszych. Maleje tylko odchylenie odsetka od p, a różnica między liczbą sukcesów a oczekiwaną może nawet rosnąć.
Od jakiej liczebności próby działa prawo wielkich liczb?
Twierdzenie nie podaje progu. Dokładność średniej opisuje błąd standardowy σ/√n, więc potrzebną liczebność wyznacza się z oczekiwanej precyzji, np. szerokości przedziału ufności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Centralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Seneta, E. (2013). A tricentenary history of the law of large numbers. Bernoulli, 19(4), 1088–1121. https://doi.org/10.3150/12-bejsp12 ● Otwarty dostęp: pełny tekst
- Tversky, A., & Kahneman, D. (1971). Belief in the law of small numbers. Psychological Bulletin, 76(2), 105–110. https://doi.org/10.1037/h0031322
Cytowania BibTeX
@article{seneta2013tricentenary, author={Seneta, Eugene}, title={{A tricentenary history of the law of large numbers}}, journal={Bernoulli}, year={2013}, volume={19}, number={4}, pages={1088--1121}, doi={10.3150/12-bejsp12}}@article{tversky1971belief, author={Tversky, Amos and Kahneman, Daniel}, title={{Belief in the law of small numbers}}, journal={Psychological Bulletin}, year={1971}, volume={76}, number={2}, pages={105--110}, doi={10.1037/h0031322}}