Co to jest rozkład Cauchy’ego?
Rozkład Cauchy’ego (ang. Cauchy distribution) to symetryczny, jednomodalny rozkład ciągły o bardzo ciężkich ogonach, z gęstością f(x) = 1 / {πγ[1 + ((x − x0)/γ)2]}. Parametr położenia x0 to mediana, a parametr skali γ – połowa rozstępu międzykwartylowego. Z daleka wygląda jak rozkład normalny, ale nie ma wartości oczekiwanej ani wariancji: odpowiednie całki są rozbieżne. Historię tego rozkładu i jego rolę we wczesnym sporze statystycznym opisuje Stigler (1974).
Skąd się bierze
- Iloraz dwóch zmiennych normalnych. Jeśli Z1 i Z2 są niezależne i mają rozkład N(0, 1), to Z1/Z2 ma standardowy rozkład Cauchy’ego.
- Rozkład t z jednym stopniem swobody. To skrajny przypadek rozkładu t-Studenta; im mniej stopni swobody, tym mniej momentów rozkładu istnieje.
Przykład w R
W 10 000 losowaniach ze standardowego rozkładu Cauchy’ego kwartyle wyniosły −1.017, −0.008 i 0.963 – zgodnie z teorią (−1, 0, 1). Średnia z pierwszych 100, 1000 i 10 000 obserwacji wynosiła −2.621, −0.313 i 0.061 i skakała przy każdej skrajnej wartości, a mediana (−0.200, 0.033, −0.008) stabilnie zbliżała się do 0. Wynik dalej niż 3 jednostki skali od środka pojawia się z prawdopodobieństwem .2048, w rozkładzie normalnym – .0027 (3 SD). Iloraz dwóch zmiennych N(0, 1) przekraczał 1 co do modułu w 49.5% przypadków, czyli prawie tak, jak przewiduje teoria (50%).
Na rysunku
Rysunek 1 zestawia rozkład Cauchy’ego z normalnym i z rozkładem t o 3 stopniach swobody. Rysunek 2 pokazuje skutki: w panelu A na próbie z przykładu wyżej (ziarno 5011), w panelu B na 1000 symulowanych badaniach (ziarno 5012).
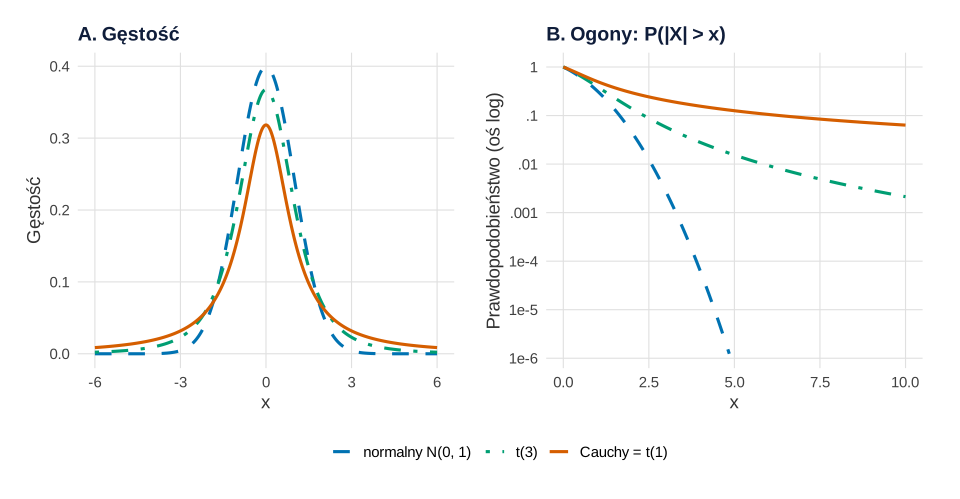
Co widać. Na panelu A różnice wydają się niewielkie. Panel B pokazuje ogony: wynik dalszy niż 5 jednostek od środka ma w rozkładzie Cauchy’ego prawdopodobieństwo .126, w t(3) – .015, w normalnym praktycznie zero.
Na co uważać. Wykres gęstości ukrywa ogony, które decydują o zachowaniu średniej. Do oceny ogonów używaj osi logarytmicznej albo wykresu kwantylowego.
Podpis do pracy:
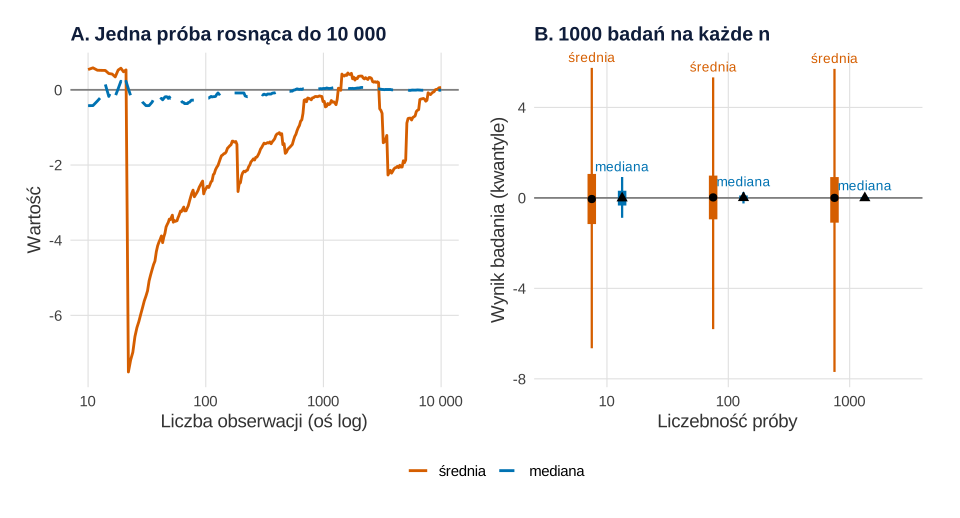
set.seed(5011) i set.seed(5012)).Co widać. W panelu A mediana szybko układa się przy zerze, a średnia po każdej skrajnej obserwacji skacze i nie zbliża się do żadnej wartości – prawo wielkich liczb tu nie działa. Panel B pokazuje to samo na 1000 badaniach: rozstęp międzykwartylowy średnich wynosi 2.22 przy n = 10, 1.94 przy n = 100 i 2.02 przy n = 1000, czyli tyle, ile dla pojedynczej obserwacji (2). Odsetek badań ze średnią dalej niż 1 od zera to 53.2%, 48.4% i 49.5% (błąd Monte Carlo ok. 1.6 pp; teoria: 50%). IQR median spada z 0.66 do 0.07.
Na co uważać. Pozorna stabilizacja średniej na kilkuset obserwacjach nic nie znaczy – kolejna skrajna wartość może ją przesunąć w dowolnej chwili (panel A).
Podpis do pracy:
Na stronie rysunki mają motyw serwisu (krój czcionki, siatka); dane, geometrie i skale są takie same jak w kodzie poniżej. Liczebności 10, 100 i 1000 oraz liczbę 1000 badań ustalono ręcznie; ziaren nie zmieniano.
Kod R rysunków 1 i 2
# Rysunki 1–2: Cauchy na tle rozkładu normalnego i t(3); średnia, która się nie stabilizuje
library(ggplot2)
library(patchwork)
kol <- c("#0072B2", "#009E73", "#D55E00")                    # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))
rozklady <- c("normalny N(0, 1)", "t(3)", "Cauchy = t(1)")
skale <- list(scale_colour_manual(values = kol, name = NULL),
              scale_linetype_manual(values = c("dashed", "dotdash", "solid"), name = NULL))

# Rysunek 1. A: gęstości; B: P(|X| > x) na osi logarytmicznej
x <- seq(-6, 6, by = 0.02)
gest <- data.frame(x = rep(x, 3), f = c(dnorm(x), dt(x, 3), dcauchy(x)),
                   rozklad = factor(rep(rozklady, each = length(x)), levels = rozklady))
u <- seq(0, 10, by = 0.05)
ogon <- data.frame(x = rep(u, 3), P = c(2 * pnorm(-u), 2 * pt(-u, 3), 2 * pcauchy(-u)),
                   rozklad = factor(rep(rozklady, each = length(u)), levels = rozklady))
round(sapply(c(x3 = 3, x5 = 5, x10 = 10), function(v)
  c(normalny = 2 * pnorm(-v), t3 = 2 * pt(-v, 3), cauchy = 2 * pcauchy(-v))), 5)
p1a <- ggplot(gest, aes(x, f, colour = rozklad, linetype = rozklad)) +
  geom_line(linewidth = 1.1) + skale +
  labs(title = "A. Gęstość", x = "x", y = "Gęstość") + motyw
p1b <- ggplot(subset(ogon, P > 1e-6), aes(x, P, colour = rozklad, linetype = rozklad)) +
  geom_line(linewidth = 1.1) + skale +
  scale_y_log10(breaks = 10^(0:-6), labels = c("1", ".1", ".01", ".001", "1e-4", "1e-5", "1e-6")) +
  labs(title = "B. Ogony: P(|X| > x)", x = "x", y = "Prawdopodobieństwo (oś log)") + motyw
p1 <- p1a + p1b + plot_layout(guides = "collect") & theme(legend.position = "bottom")

# Rysunek 2A. Średnia i mediana bieżąca w próbie z przykładu (to samo ziarno)
set.seed(5011)
xc <- rcauchy(10000)
n_siatka <- unique(round(10^seq(1, 4, length.out = 300)))
biez <- data.frame(n = rep(n_siatka, 2),
                   wartosc = c(sapply(n_siatka, function(n) mean(xc[1:n])),
                               sapply(n_siatka, function(n) median(xc[1:n]))),
                   miara = factor(rep(c("średnia", "mediana"), each = length(n_siatka)),
                                  levels = c("średnia", "mediana")))
p2a <- ggplot(biez, aes(n, wartosc, colour = miara, linetype = miara)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kol[c(3, 1)], name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_log10(breaks = c(10, 100, 1000, 10000), labels = c("10", "100", "1000", "10 000")) +
  labs(title = "A. Jedna próba rosnąca do 10 000", x = "Liczba obserwacji (oś log)",
       y = "Wartość") + motyw

# Rysunek 2B. 1000 badań na n = 10, 100, 1000: rozkład średnich i median
set.seed(5012)
badania <- do.call(rbind, lapply(c(10, 100, 1000), function(n) {
  proby <- matrix(rcauchy(1000 * n), nrow = 1000)
  data.frame(n = n, srednia = rowMeans(proby), mediana = apply(proby, 1, median))
}))
podsum <- do.call(rbind, lapply(split(badania, badania$n), function(d) {
  p <- mean(abs(d$srednia) > 1)
  data.frame(n = d$n[1], IQR_srednich = IQR(d$srednia), IQR_median = IQR(d$mediana),
             odsetek_sr_poza_1 = p, blad_MC = sqrt(p * (1 - p) / nrow(d)))
}))
round(podsum, 3)
dl <- rbind(data.frame(n = badania$n, wartosc = badania$srednia, miara = "średnia"),
            data.frame(n = badania$n, wartosc = badania$mediana, miara = "mediana"))
kw <- aggregate(wartosc ~ n + miara, data = dl,                # kwantyle 5, 25, 50, 75 i 95%
                FUN = function(v) quantile(v, c(.05, .25, .5, .75, .95)))
kw <- data.frame(kw[, c("n", "miara")], kw$wartosc)
names(kw)[3:7] <- c("q05", "q25", "q50", "q75", "q95")
kw$miara <- factor(kw$miara, levels = c("średnia", "mediana"))
kw <- kw[order(kw$miara, kw$n), ]
data.frame(kw[, 1:2], round(kw[, 3:7], 2), row.names = NULL)
p2b <- ggplot(kw, aes(factor(n), q50, colour = miara)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_linerange(aes(ymin = q05, ymax = q95), linewidth = 0.8, position = position_dodge(0.5)) +
  geom_linerange(aes(ymin = q25, ymax = q75), linewidth = 3, position = position_dodge(0.5)) +
  geom_point(aes(shape = miara), size = 2.5, colour = "black", position = position_dodge(0.5)) +
  geom_text(aes(y = q95, label = miara), vjust = -0.6, size = 3.6, position = position_dodge(0.5)) +
  scale_colour_manual(values = kol[c(3, 1)], guide = "none") +
  scale_shape_manual(values = c(16, 17), guide = "none") +
  labs(title = "B. 1000 badań na każde n", x = "Liczebność próby",
       y = "Wynik badania (kwantyle)") + motyw
p2 <- p2a + p2b + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1
p2
Wynik w R
              x3      x5     x10
normalny 0.00270 0.00000 0.00000
t3       0.05767 0.01539 0.00213
cauchy   0.20483 0.12567 0.06345
        n IQR_srednich IQR_median odsetek_sr_poza_1 blad_MC
10     10        2.216      0.655             0.532   0.016
100   100        1.936      0.209             0.484   0.016
1000 1000        2.016      0.069             0.495   0.016
     n   miara   q05   q25   q50  q75  q95
1   10 średnia -6.65 -1.16 -0.05 1.06 5.75
2  100 średnia -5.80 -0.95  0.02 0.99 5.33
3 1000 średnia -7.70 -1.09  0.00 0.92 5.71
4   10 mediana -0.88 -0.34 -0.01 0.32 0.92
5  100 mediana -0.24 -0.10  0.00 0.11 0.26
6 1000 mediana -0.09 -0.03  0.00 0.03 0.08
Jak opisać w pracy
Na co uważać
- Średnia nie pomaga. Średnia z n obserwacji ma ten sam rozkład Cauchy’ego co jedna obserwacja, więc nie działa ani prawo wielkich liczb, ani centralne twierdzenie graniczne.
- Mediana to nie wszystko. Rothenberg i in. (1964) pokazali, że średnia ze środkowej ćwiartki uporządkowanej próby ma mniejszą asymptotyczną wariancję niż mediana – to bliska krewna średniej ucinanej.
- Odchylenie standardowe z próby nic nie mówi. Do opisu rozrzutu używaj rozstępu międzykwartylowego.
Rozkład Cauchy’ego w R
Kod losuje próbę ze standardowego rozkładu Cauchy’ego, porównuje średnią i medianę przy rosnącym n, liczy prawdopodobieństwo wyniku skrajnego i sprawdza, że iloraz dwóch zmiennych normalnych oraz rozkład t z jednym stopniem swobody to rozkład Cauchy’ego.
Kwartyle, średnia i mediana, ogony
R
set.seed(5011)
x <- rcauchy(10000)                           # standardowy Cauchy: x0 = 0, gamma = 1
round(quantile(x, c(.25, .5, .75)), 3)        # kwartyle ok. -1, 0, 1 (IQR = 2 * gamma)
sapply(c(n100 = 100, n1000 = 1000, n10000 = 10000),
       function(n) round(c(M = mean(x[1:n]), Me = median(x[1:n])), 3))
round(c(cauchy = 2 * pcauchy(-3), normalny = 2 * pnorm(-3)), 4)  # P(|X| > 3)
z <- rnorm(10000) / rnorm(10000)               # iloraz dwóch N(0, 1)
round(mean(abs(z) > 1), 3)                    # dla Cauchy'ego teoretycznie .5
all.equal(dt(1.7, df = 1), dcauchy(1.7))      # t z 1 df to rozkład Cauchy'ego
Wynik w R
   25%    50%    75%
-1.017 -0.008  0.963
     n100  n1000 n10000
M  -2.621 -0.313  0.061
Me -0.200  0.033 -0.008
  cauchy normalny
  0.2048   0.0027
[1] 0.495
[1] TRUE
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w przykładzie nie wymagają dodatkowych pakietów; rysunki 1 i 2 wykonano w pakiecie ggplot2, a panele złożono pakietem patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego rozkład Cauchy’ego nie ma średniej?
Całka z x·f(x) jest rozbieżna, bo ogony maleją zbyt wolno. Średnia z próby ma wtedy ten sam rozkład co jedna obserwacja i nie zbliża się do żadnej liczby przy rosnącym n.
Jakim parametrem opisać środek rozkładu Cauchy’ego?
Parametrem położenia x₀, który jest medianą. Dobrym estymatorem jest mediana z próby, a jeszcze lepszym – średnia ze środkowej ćwiartki uporządkowanych obserwacji.
Jak wylosować dane z rozkładu Cauchy’ego w R?
Funkcją rcauchy(n, location, scale). Gęstość daje dcauchy(), dystrybuantę pcauchy(), a kwantyle qcauchy(); dt(x, df = 1) zwraca tę samą gęstość.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Rothenberg, T. J., Fisher, F. M., & Tilanus, C. B. (1964). A note on estimation from a Cauchy sample. Journal of the American Statistical Association, 59(306), 460–463. https://doi.org/10.1080/01621459.1964.10482170
- Stigler, S. M. (1974). Studies in the history of probability and statistics. XXXIII: Cauchy and the witch of Agnesi: An historical note on the Cauchy distribution. Biometrika, 61(2), 375–380. https://doi.org/10.1093/biomet/61.2.375
Cytowania BibTeX
@article{rothenberg1964note, author={Rothenberg, Thomas J. and Fisher, Franklin M. and Tilanus, C. B.}, title={{A note on estimation from a Cauchy sample}}, journal={Journal of the American Statistical Association}, year={1964}, volume={59}, number={306}, pages={460--463}, doi={10.1080/01621459.1964.10482170}}@article{stigler1974cauchy, author={Stigler, Stephen M.}, title={{Studies in the history of probability and statistics. XXXIII: Cauchy and the witch of Agnesi: An historical note on the Cauchy distribution}}, journal={Biometrika}, year={1974}, volume={61}, number={2}, pages={375--380}, doi={10.1093/biomet/61.2.375}}