Fikcyjna uczelnia, w której znamy prawdę
„Pracuje 47% studentów, margines błędu ±4.9 punktu procentowego” – takie zdanie zna każdy, kto czytał wyniki sondażu. Definicję i wzór znajdziesz w haśle margines błędu w sondażu. Tu pokazujemy, skąd ta liczba się bierze i kiedy przestaje cokolwiek znaczyć. Potrzebujemy do tego populacji, w której znamy prawdziwy wynik. W prawdziwym badaniu takiej wiedzy nie ma, dlatego populację wylosowaliśmy w R.
To 50 000 studentów pięciu wydziałów jednego miasta. Każdy ma przypisaną płeć i status zatrudnienia: nie pracuje, pracuje dorywczo albo na etat. Szanse pracy na wydziałach, udział kobiet (58%) i różnicę między płciami ustawiliśmy ręcznie, żeby populacja nie była jednorodna: odsetek pracujących waha się od 35.5% na wydziale medycznym do 60.5% na ekonomicznym. Wynik całej populacji to P = 49.93% pracujących. Każde „badanie” to próba losowa albo ankieta z tej populacji, a porównujemy jego wynik z P. Populację losuje ziarno 2026, wszystkie badania – ziarno 587. Ziaren nie dobieraliśmy pod wynik. Przy odsetkach z wielu powtórzeń podajemy błąd Monte Carlo. Te same pomysły dla średniej pokazuje wpis przedział ufności w obrazkach.
Rysunek 1: populacja jako mapa, próba jako punkty
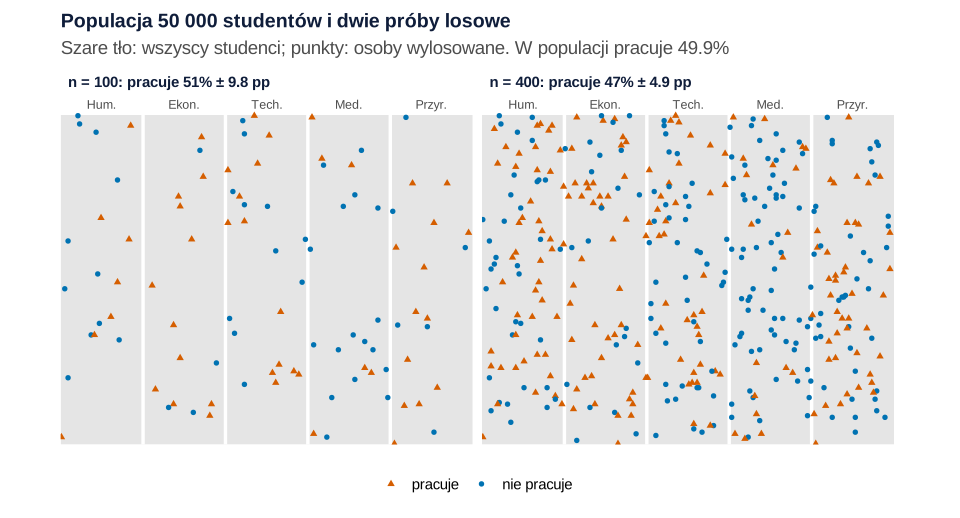
set.seed(2026) dla populacji, set.seed(587) dla prób).Co widać. Szare pole to wszyscy studenci, po jednym polu siatki na osobę, w pięciu pasach wydziałów. Punkty to osoby wylosowane: trójkąt – pracuje, kółko – nie pracuje. W próbie 100 osób pracuje 51%, w próbie 400 osób – 47.2%. Obie liczby różnią się od P, ale obie mieszczą się w swoim marginesie (±9.8 i ±4.9 punktu procentowego, dalej: pp).
Czego ten wykres nie pokazuje. Tego, że to szczęśliwy przypadek. Inna próba dałaby inny wynik, a margines mówi tylko, jak daleko zwykle odbiegają takie wyniki od P. Mapa nie pokazuje też braków odpowiedzi: tu każdy wylosowany odpowiedział. Kiedy tak nie jest, przechodzimy do rysunków 5 i 6. Inne sposoby losowania na podobnej mapie omawia wpis schematy losowania w obrazkach.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: margines a liczebność i wynik 50%
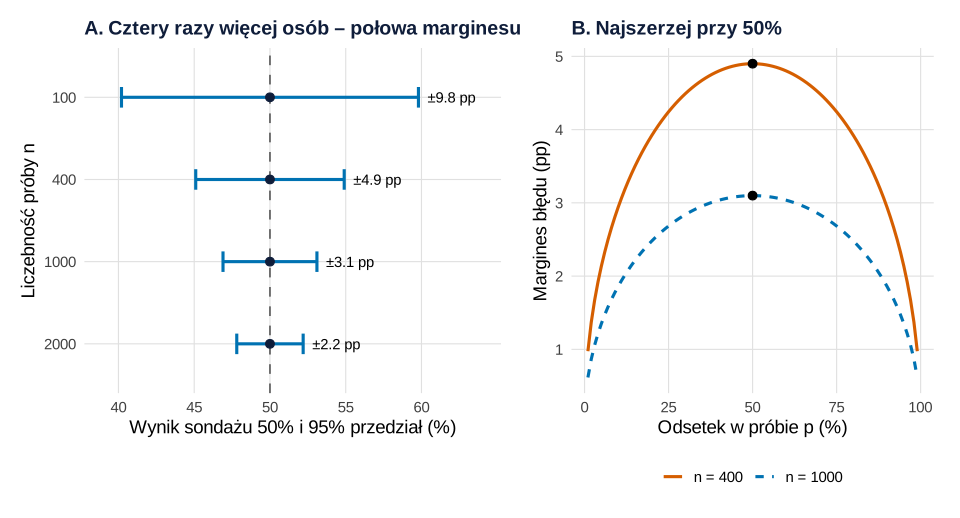
Co widać. Margines błędu to połowa szerokości 95% przedziału ufności dla odsetka: 1.96 × √(p(1 − p)/n). Przy wyniku 50% wynosi ±9.80 pp dla n = 100, ±4.90 dla 400, ±3.10 dla 1000 i ±2.19 dla 2000. Cztery razy więcej osób daje dokładnie połowę marginesu, dwadzieścia razy więcej – margines węższy √20 = 4.47 raza. Panel B pokazuje, dlaczego sondaże podają margines „dla 50%”: iloczyn p(1 − p) jest wtedy największy. Przy n = 1000 margines wynosi ±3.10 pp dla 50%, ±2.48 dla 20% i tylko ±1.35 dla 5%.
Jak może zmylić. Panel A wygląda tak, jakby duża próba „przybliżała” do prawdy. Przybliża tylko wtedy, gdy dobór jest losowy, a jedynym źródłem błędu jest przypadek – resztę opisuje wpis o całkowitym błędzie badania sondażowego. Wzór nie uwzględnia też wielkości populacji. Przy 50 000 studentów poprawka na skończoną populację dla n = 2000 wynosi 0.98, więc prawie nic nie zmienia. Kiedy zaczyna mieć znaczenie, pokazuje wpis wielkość próby a wielkość populacji, a policzysz ją w kalkulatorze z poprawką na skończoną populację. Przy losowaniu warstwowym albo całych grup margines zmienia efekt schematu.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: 1000 sondaży tym samym schematem
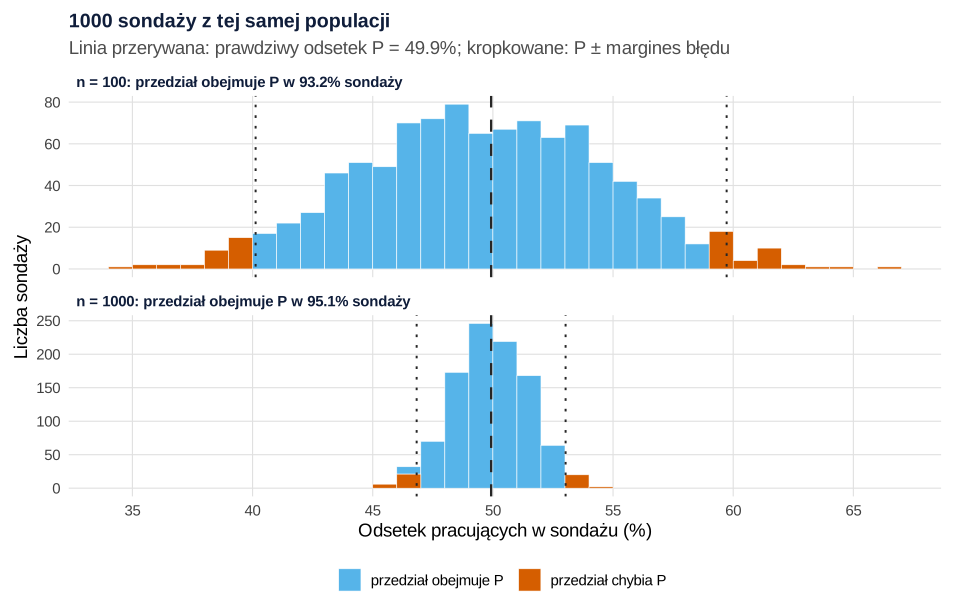
set.seed(587)).Co widać. Ten sam sondaż powtórzyliśmy 1000 razy: górny panel dla 100 osób, dolny dla 1000. Środek obu rozkładów leży przy P (średnio 50.12% i 49.95%), więc schemat nie jest obciążony. Różni je rozrzut: odchylenie standardowe wyników wyniosło 5.15 pp przy n = 100 i 1.56 pp przy n = 1000. To prawie dokładnie błąd standardowy ze wzoru (5.00 i 1.58). Przy 100 osobach pojedyncze sondaże dawały od 34% do 67% pracujących. Przedział „wynik ± margines” objął P w 93.2% sondaży przy n = 100 (błąd Monte Carlo 0.80 pp) i w 95.1% przy n = 1000 (0.68 pp).
Czego ten wykres nie pokazuje. Że prosty wzór bywa zawodny dla rzadkich cech. Dla cechy, którą ma 4.98% studentów (w danych: dziecko na utrzymaniu), w 10 000 sondaży po 100 osób przedział ze wzoru (przedział Walda) objął prawdziwą wartość tylko w 87.62% przypadków, a przedział Wilsona – w 96.97% (błąd Monte Carlo około 0.22 pp). Przy 1000 osobach oba działały poprawnie (95.54% i 95.20%). Zgadza się to z pracami, w których przedział Walda miał nieregularne i zbyt niskie pokrycie, a przedział Wilsona – bliskie nominalnemu (Agresti i Coull, 1998; Brown i in., 2001). Gotowy przedział Wilsona policzysz w kalkulatorze przedziału ufności.
Podpis do pracy:
Zdanie do Wyników (w pracy z symulacją):
Rysunek 4: różnica dwóch odsetków w jednym sondażu
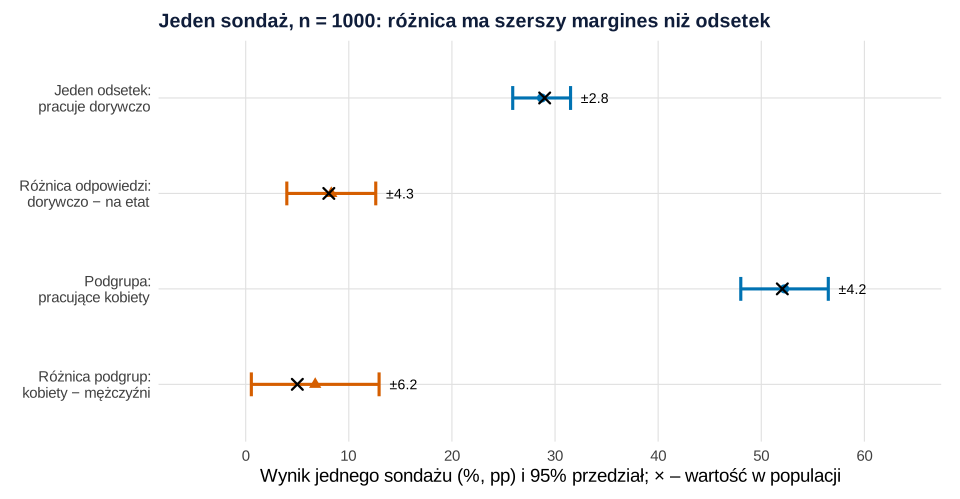
set.seed(587)).Co widać. Jeden sondaż, 1000 osób. Dorywczo pracuje 28.70% (±2.80 pp), na etat – 20.40%, więc różnica wynosi 8.30 pp. Jej margines to ±4.31 pp, około półtora raza więcej niż margines jednego odsetka (w 1000 powtórzeniach średnio 1.55 raza). Obie liczby pochodzą od tych samych osób, a odpowiedzi się wykluczają: każda osoba „dorywczo” to osoba, której brakuje w „na etat”. Dlatego błędy obu odsetków idą w przeciwne strony i sumują się w różnicy. Druga sytuacja to porównanie podgrup. Pracuje 52.26% z 532 kobiet (±4.24 pp), a wśród 468 mężczyzn – 45.51%. Różnica 6.74 pp ma margines ±6.19 pp, dwa razy szerszy niż margines odsetka w całej próbie (±3.10 pp). W 1000 powtórzeniach rozrzut każdego oszacowania zgadzał się ze wzorami (np. 6.42 wobec 6.26 pp dla różnicy podgrup).
Jak może zmylić. W raportach z sondaży podaje się zwykle jeden margines, „±3.1 pp dla całej próby”. Nie dotyczy on ani podgrup, ani różnic. Scott i Seber (1983) zwracali uwagę, że różnicę dwóch odsetków z tego samego sondażu porównuje się bardzo często i że warto o niej uczyć już na kursach wstępnych. Różnicę podgrup sprawdzisz testem dla dwóch proporcji. Prawdziwa różnica płci (5.01 pp) też mieściła się w przedziale.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: duża próba z błędem
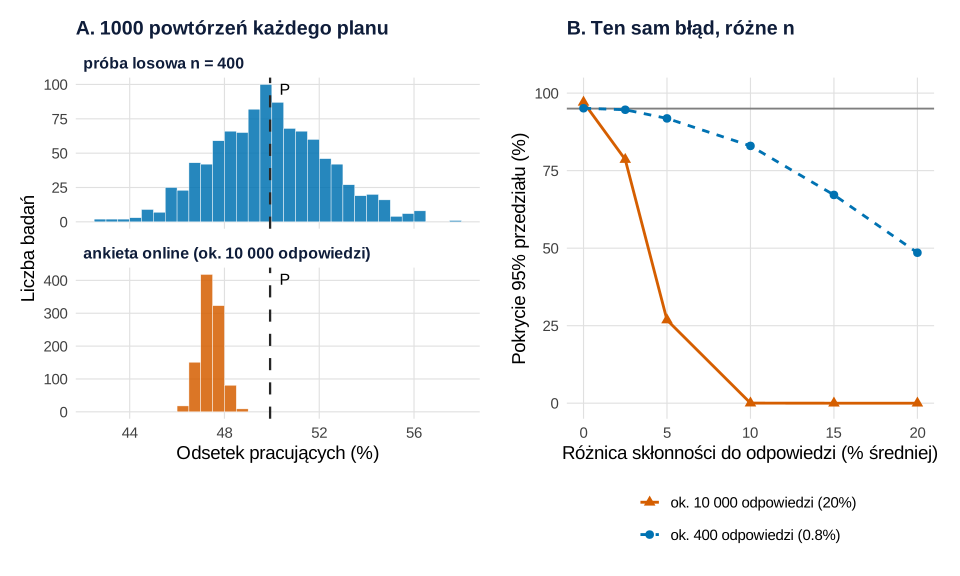
set.seed(587)).Teraz link do ankiety online dostają wszyscy studenci. Odpowiada mniej więcej co piąty, ale pracujący nieco rzadziej: 19% zamiast 21%. Te dwa odsetki ustawiliśmy ręcznie. Ankieta zbiera około 10 000 odpowiedzi. Porównujemy ją z małą próbą losową 400 osób.
| Plan | Średnio odpowiedzi | Obciążenie | Podawany margines | Pokrycie 95% przedziału | Pierwiastek z błędu średniokwadratowego |
|---|---|---|---|---|---|
| Ankieta online | 9996 | −2.52 pp | ±0.98 pp | 0.0% | 2.56 pp |
| Próba losowa | 400 | 0.10 pp | ±4.89 pp | 95.8% | 2.40 pp |
Co widać. Ankieta online daje wąski słupek wyników przy 47.4%, a nie przy P. Jej margines ±0.98 pp jest pięć razy węższy niż w próbie losowej, a mimo to nie objął P w żadnym z 1000 powtórzeń. Pod względem błędu średniokwadratowego 10 000 odpowiedzi było wartych tyle, co około 381 osób wylosowanych. Meng (2018) zapisał ten błąd jako iloczyn trzech liczb: korelacji między cechą a faktem odpowiedzi, czynnika √((N − n)/n) i odchylenia standardowego cechy. W jednej z naszych ankiet korelacja wyniosła zaledwie −0.027, a iloczyn dał dokładnie obserwowany błąd −2.73 pp. Panel B pokazuje paradoks z jego tytułu. Przy tej samej względnej różnicy w skłonności do odpowiedzi (5%) przedział z ankiety na 10 000 osób obejmował P w 26.83% powtórzeń, a z ankiety na 400 osób – w 91.84% (10 000 powtórzeń; błąd Monte Carlo do 0.5 pp). Im większe n, tym węższy przedział wokół złej wartości. Meng (2018) ujął to krótko: im więcej danych, tym pewniej się mylimy.
Czego ten wykres nie pokazuje. Że w prawdziwej ankiecie nie znasz ani P, ani skłonności do odpowiedzi – obciążenia nie zobaczysz w samych danych. Przy braku samoselekcji pokrycie dużej ankiety wyniosło 97.03%, a nie 95%, bo odpowiada aż 20% populacji i wzór bez poprawki na skończoną populację zawyża margines. Szerzej o próbie wygodnej, której obciążenie nie maleje z n, piszemy we wpisie dobór nielosowy w obrazkach.
Podpis do pracy:
Zdanie do Ograniczeń:
Rysunek 6: ile zaproszeń wysłać
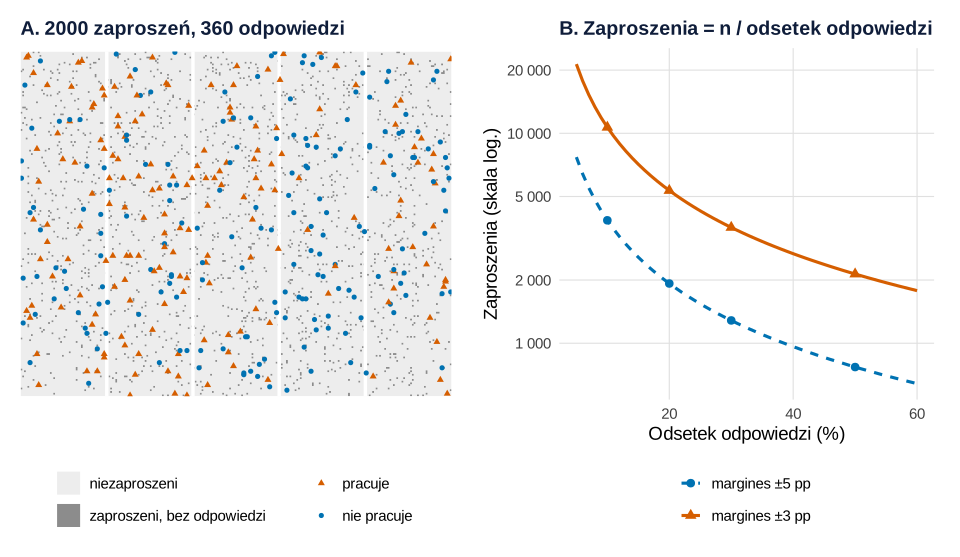
set.seed(587)).Co widać. Panel A to jedna wysyłka: 2000 losowo wybranych osób dostało zaproszenie, odpowiedziało 360 (18%; zakładaliśmy 20%). Ciemnoszare pola to zaproszeni, którzy nie odpowiedzieli. Z 360 odpowiedzi margines wynosi ±5.16 pp, a nie planowane ±4.9. Panel B to proste dzielenie: liczba potrzebnych odpowiedzi przez spodziewany wskaźnik odpowiedzi. Margines ±5 pp wymaga 385 odpowiedzi, ±3 pp – 1068.
| Cel | Odpowiedzi | 10% | 20% | 30% | 50% |
|---|---|---|---|---|---|
| ±5 pp | 385 | 3850 | 1925 | 1284 | 770 |
| ±3 pp | 1068 | 10 680 | 5340 | 3560 | 2136 |
Czego ten wykres nie pokazuje. Że odsetek odpowiedzi to zakres, a nie pewnik – wpis ile zaproszeń wysłać pokazuje, jak planować z zapasem i wysyłać etapami. Nie pokazuje też jakości odpowiedzi. Tu odpowiadali losowo wybrani zaproszeni, więc 360 osób to wciąż próba losowa. Groves (2006) zwraca uwagę, że niski odsetek odpowiedzi może, ale nie musi prowadzić do obciążenia. Liczy się to, czy odpowiadający różnią się od pozostałych badaną cechą (rysunek 5). Jak to sprawdzać i korygować ważeniem, pokazuje wpis próba reprezentatywna w obrazkach.
Podpis do pracy:
Zdanie do Metody:
Co napisać w pracy, gdy próba nie jest losowa
W pracy dyplomowej zwykle nie ma listy całej populacji, z której można by losować. Częściej jest link do ankiety rozesłany na grupach studenckich, czyli próba wygodna z samoselekcją. To nic wstydliwego, ale wtedy margines błędu i rysunki 1–3 Twojej próby nie dotyczą: wzór zakłada losowanie. Opisz dobór uczciwie, podaj liczebność i rozkład podstawowych cech, a wnioski formułuj o badanej grupie, nie o „studentach w Polsce”. Co wolno z takiej próby wnioskować, omawia wpis dobór próby w pracy dyplomowej. Przykładowe zdanie do Metody:
Liczba 214 jest przykładowa – wstaw własną. Nawet w dobrze zaprojektowanych sondażach losowych prawdziwy błąd bywa większy niż podawany margines. W analizie 4221 sondaży przedwyborczych przeciętny błąd był mniej więcej dwa razy większy, niż wynikało z marginesów (Shirani-Mehr i in., 2018). Margines opisuje tylko przypadek losowania.
Kod R wszystkich rysunków i liczb
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje motyw, paletę, populację i funkcję moe(), z których korzystają następne. Każdy przepis tworzy obiekt wykresu (p1–p6); wpisz jego nazwę, żeby go wyświetlić, a do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG.
Dane są fikcyjne. Ręcznie ustaliliśmy: liczbę studentów (50 000), udział kobiet (58%), odsetki pracy dorywczej i na etat na wydziałach (od 12% do 34%) i ich przesunięcie dla płci, częstość rzadkiej cechy (5%), odsetki odpowiedzi w ankiecie online (19% i 21%) i w wysyłce zaproszeń (20%) oraz siatkę różnic skłonności do odpowiedzi na rysunku 5B. Populację losuje set.seed(2026), a każdy blok, który losuje próby, zaczyna od set.seed(587) – dwa ziarna, żeby losowanie prób nie korzystało z tych samych liczb losowych co budowa populacji. Ziaren nie dobieraliśmy pod wynik. Rysunki 3, 4 i 5A opierają się na 1000 powtórzeń, a odsetki pokrycia przedziałów Walda i Wilsona oraz rysunek 5B – na 10 000 powtórzeń. Jeden sondaż z rysunku 4 (1000 osób) pobierzesz jako plik sondaz-jedna-proba-1000.csv (kolumny wydzial, plec, status i pracuje: 1 – pracuje, 0 – nie).
1. Motyw, paleta, populacja i dwie próby na mapie: Rysunek 1
R
# Rysunek 1. Fikcyjna populacja 50 000 studentów jako mapa i dwie próby losowe (n = 100 i n = 400)
options(width = 100)
library(ggplot2)
library(patchwork)

# Krótki motyw i paleta Okabe–Ito (sprawdzona w symulacji deuteranopii; kolor zawsze wspiera kształt)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol <- c(pracuje = "#D55E00", "nie pracuje" = "#0072B2", jasny = "#56B4E9", ciemny = "#0f1d3a")
ksz <- c(pracuje = 17, "nie pracuje" = 16)

# Populacja fikcyjna: 50 000 studentów pięciu wydziałów jednego miasta, ułożonych na siatce 250 × 200
set.seed(2026)                                  # ziarno populacji (osobne niż ziarno badań 587, by strumienie losowań się nie pokrywały)
N <- 50000
wydzialy <- c("Humanistyczny", "Ekonomiczny", "Techniczny", "Medyczny", "Przyrodniczy")
pop <- expand.grid(x = 1:250, y = 1:200)
pop$wydzial <- factor(wydzialy[(pop$x - 1) %/% 50 + 1], levels = wydzialy)
pop$plec <- ifelse(runif(N) < 0.58, "kobieta", "mężczyzna")
# Status zatrudnienia: odsetki ustawione ręcznie (inne na każdym wydziale), żeby populacja nie była jednorodna
p_dor <- c(Humanistyczny = .34, Ekonomiczny = .30, Techniczny = .28, Medyczny = .24, Przyrodniczy = .30)
p_eta <- c(Humanistyczny = .20, Ekonomiczny = .30, Techniczny = .24, Medyczny = .12, Przyrodniczy = .18)
u <- runif(N)
pd <- p_dor[as.character(pop$wydzial)] + ifelse(pop$plec == "kobieta", .02, -.03)
pe <- p_eta[as.character(pop$wydzial)]
pop$status <- factor(ifelse(u < pe, "na etat", ifelse(u < pe + pd, "dorywczo", "nie pracuje")),
                     levels = c("nie pracuje", "dorywczo", "na etat"))
pop$pracuje <- as.integer(pop$status != "nie pracuje")
pop$dziecko <- rbinom(N, 1, 0.05)               # rzadka cecha (ok. 5%) do sprawdzenia przedziałów Walda i Wilsona

# Prawdziwe wartości w populacji – w prawdziwym badaniu ich nie znamy
P <- mean(pop$pracuje)
round(c(N = N, P_pracuje = 100 * P, dorywczo = 100 * mean(pop$status == "dorywczo"),
        na_etat = 100 * mean(pop$status == "na etat"), kobiety = 100 * mean(pop$plec == "kobieta"),
        dziecko = 100 * mean(pop$dziecko)), 2)
round(100 * tapply(pop$pracuje, pop$wydzial, mean), 1)

# Margines błędu (95%) dla odsetka przy prostym losowaniu: 1.96 × √(p(1 − p)/n)
moe <- function(p, n) qnorm(.975) * sqrt(p * (1 - p) / n)

# Dwie próby losowe bez zwracania z tej samej populacji
proby <- do.call(rbind, lapply(c(100, 400), function(n) {
  set.seed(587)                                 # każda próba od tego samego ziarna
  d <- pop[sample.int(N, n), ]
  d$n <- n
  d
}))
proby$odp <- factor(ifelse(proby$pracuje == 1, "pracuje", "nie pracuje"), levels = c("pracuje", "nie pracuje"))
wyn1 <- aggregate(pracuje ~ n, proby, function(x) c(proc = 100 * mean(x), moe_pp = 100 * moe(mean(x), length(x))))
wyn1 <- data.frame(n = wyn1$n, round(wyn1$pracuje, 1))
wyn1

etyk <- setNames(sprintf("n = %d: pracuje %.0f%% ± %.1f pp", wyn1$n, wyn1$proc, wyn1$moe_pp), wyn1$n)
granice <- data.frame(x = c(50.5, 100.5, 150.5, 200.5))
nazwy <- data.frame(x = seq(25.5, 225.5, 50), y = 207, lab = c("Hum.", "Ekon.", "Tech.", "Med.", "Przyr."))
p1 <- ggplot() +
  geom_raster(data = pop, aes(x, y), fill = "grey90") +            # cała populacja: jasnoszare tło
  geom_vline(data = granice, aes(xintercept = x), colour = "white", linewidth = 1.2) +
  geom_point(data = proby, aes(x, y, colour = odp, shape = odp), size = 1.5) +
  geom_text(data = nazwy, aes(x, y, label = lab), size = 3.3, colour = "grey30") +
  facet_wrap(~ n, labeller = as_labeller(etyk)) +
  scale_colour_manual(values = kol, breaks = c("pracuje", "nie pracuje"), name = NULL) +
  scale_shape_manual(values = ksz, breaks = c("pracuje", "nie pracuje"), name = NULL) +
  coord_fixed(expand = FALSE, ylim = c(0.5, 212)) +
  labs(x = NULL, y = NULL, title = "Populacja 50 000 studentów i dwie próby losowe",
       subtitle = sprintf("Szare tło: wszyscy studenci; punkty: osoby wylosowane. W populacji pracuje %.1f%%", 100 * P)) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank(), strip.text = element_text(hjust = 0))
# p1   # wyświetl; zapis: ggsave("sondaz-mapa-populacji-proby.svg", p1, width = 10, height = 5.4)
Wynik w R
        N P_pracuje  dorywczo   na_etat   kobiety   dziecko
 50000.00     49.93     28.99     20.93     57.79      4.98
Humanistyczny   Ekonomiczny    Techniczny      Medyczny  Przyrodniczy
         54.1          60.5          51.9          35.5          47.7
    n proc moe_pp
1 100 51.0    9.8
2 400 47.2    4.9
2. Margines błędu a n i odsetek: Rysunek 2
R
# Rysunek 2. Margines błędu przy p = 50% dla n = 100, 400, 1000 i 2000 oraz margines w funkcji odsetka
# (kontynuacja: moe, kol, motyw, N z bloku 1; bez losowania – same wzory)
ns <- c(100, 400, 1000, 2000)
tab2 <- data.frame(n = ns, moe_pp = 100 * moe(.5, ns))
tab2$wzgledem_n100 <- tab2$moe_pp[1] / tab2$moe_pp
tab2$pierwiastek_n_przez_100 <- sqrt(ns / 100)
tab2$poprawka_N50000 <- sqrt((N - ns) / (N - 1))  # poprawka na skończoną populację (tu prawie 1)
round(tab2, 3)
round(100 * moe(c(.05, .10, .20, .30, .50), 1000), 2)   # n = 1000: margines dla p = 5, 10, 20, 30 i 50%
ceiling((qnorm(.975) / c(.05, .03, .02))^2 * .25)       # n potrzebne do ±5, ±3 i ±2 pp przy p = 50%

d2a <- data.frame(n = factor(ns, levels = rev(ns)), dolna = 50 - tab2$moe_pp, gorna = 50 + tab2$moe_pp)
d2a$lab <- sprintf("±%.1f pp", tab2$moe_pp)
p2a <- ggplot(d2a, aes(y = n)) +
  geom_vline(xintercept = 50, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 1.1, colour = kol[["nie pracuje"]]) +
  geom_point(aes(x = 50), size = 2.6, colour = kol[["ciemny"]]) +
  geom_text(aes(x = gorna + 0.6, label = lab), hjust = 0, size = 3.9) +
  scale_x_continuous(limits = c(39, 64), breaks = seq(40, 60, 5)) +
  labs(x = "Wynik sondażu 50% i 95% przedział (%)", y = "Liczebność próby n",
       title = "A. Cztery razy więcej osób – połowa marginesu") + motyw

d2b <- expand.grid(p = seq(0.01, 0.99, by = 0.01), n = c(400, 1000))
d2b$moe_pp <- 100 * moe(d2b$p, d2b$n)
d2b$n <- factor(d2b$n, labels = c("n = 400", "n = 1000"))
p2b <- ggplot(d2b, aes(100 * p, moe_pp, colour = n, linetype = n)) +
  geom_line(linewidth = 1.1) +
  annotate("point", x = 50, y = 100 * moe(.5, c(400, 1000)), size = 2.6) +
  scale_colour_manual(values = c(kol[["pracuje"]], kol[["nie pracuje"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 100, 25)) +
  labs(x = "Odsetek w próbie p (%)", y = "Margines błędu (pp)",
       title = "B. Najszerzej przy 50%") + motyw
p2 <- p2a + p2b + plot_layout(widths = c(1.15, 1))
# p2   # zapis: ggsave("sondaz-margines-a-liczebnosc.svg", p2, width = 10, height = 5.4)
Wynik w R
     n moe_pp wzgledem_n100 pierwiastek_n_przez_100 poprawka_N50000
1  100  9.800         1.000                   1.000           0.999
2  400  4.900         2.000                   2.000           0.996
3 1000  3.099         3.162                   3.162           0.990
4 2000  2.191         4.472                   4.472           0.980
[1] 1.35 1.86 2.48 2.84 3.10
[1]  385 1068 2401
3. 1000 sondaży i pokrycie przedziałów Walda i Wilsona: Rysunek 3
R
# Rysunek 3. 1000 sondaży tym samym schematem (losowanie proste, n = 100 i n = 1000) – rozkład wyników
# (kontynuacja: pop, N, P, moe, kol, ksz, motyw z bloku 1)
set.seed(587)
S <- 1000
d3 <- do.call(rbind, lapply(c(100, 1000), function(n) {
  p_hat <- replicate(S, mean(pop$pracuje[sample.int(N, n)]))
  m <- moe(p_hat, n)                            # margines liczony z każdego sondażu osobno
  data.frame(n = n, sondaz = 1:S, p_hat = p_hat, trafia = abs(p_hat - P) <= m)
}))
tab3 <- do.call(rbind, lapply(split(d3, d3$n), function(d) {
  pok <- mean(d$trafia)
  data.frame(n = d$n[1], srednia_proc = 100 * mean(d$p_hat), SD_pp = 100 * sd(d$p_hat),
             wzor_SE_pp = 100 * sqrt(P * (1 - P) / d$n[1]), trafia_proc = 100 * pok,
             blad_MC_pp = 100 * sqrt(pok * (1 - pok) / S), min_proc = 100 * min(d$p_hat), max_proc = 100 * max(d$p_hat))
}))
round(tab3, 2)

# Pokrycie przedziału Walda (p ± 1.96 SE) i Wilsona w 10 000 sondaży: odsetek pracujących (ok. 52%) i rzadka cecha (ok. 5%)
set.seed(587)
R <- 10000
pokrycie <- function(cecha, n) {
  Pc <- mean(cecha); k <- rhyper(R, sum(cecha), N - sum(cecha), n)   # liczba „tak” w próbie bez zwracania
  ph <- k / n; z <- qnorm(.975)
  wald <- abs(ph - Pc) <= z * sqrt(ph * (1 - ph) / n)
  srodek <- (ph + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(ph * (1 - ph) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  wilson <- abs(srodek - Pc) <= pol
  c(n = n, P_proc = 100 * Pc, Wald_proc = 100 * mean(wald), Wilson_proc = 100 * mean(wilson),
    blad_MC_pp = 100 * sqrt(.95 * .05 / R))
}
round(rbind(pracuje_n100 = pokrycie(pop$pracuje, 100), dziecko_n100 = pokrycie(pop$dziecko, 100),
            dziecko_n1000 = pokrycie(pop$dziecko, 1000)), 2)

d3$wynik <- factor(ifelse(d3$trafia, "przedział obejmuje P", "przedział chybia P"),
                   levels = c("przedział obejmuje P", "przedział chybia P"))
etyk3 <- setNames(sprintf("n = %d: przedział obejmuje P w %.1f%% sondaży", tab3$n, tab3$trafia_proc), tab3$n)
pasy <- data.frame(n = rep(tab3$n, 2), x = 100 * c(P - moe(P, tab3$n), P + moe(P, tab3$n)))
p3 <- ggplot(d3, aes(100 * p_hat, fill = wynik)) +
  geom_histogram(binwidth = 1, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(data = pasy, aes(xintercept = x), linetype = "dotted", colour = "grey15", linewidth = 0.7) +
  geom_vline(xintercept = 100 * P, linetype = "dashed", colour = "grey15", linewidth = 0.8) +
  facet_wrap(~ n, ncol = 1, scales = "free_y", labeller = as_labeller(etyk3)) +
  scale_fill_manual(values = c("przedział obejmuje P" = kol[["jasny"]], "przedział chybia P" = kol[["pracuje"]]), name = NULL) +
  scale_x_continuous(breaks = seq(30, 75, 5)) +
  labs(x = "Odsetek pracujących w sondażu (%)", y = "Liczba sondaży",
       title = "1000 sondaży z tej samej populacji",
       subtitle = sprintf("Linia przerywana: prawdziwy odsetek P = %.1f%%; kropkowane: P ± margines błędu", 100 * P)) +
  motyw + theme(strip.text = element_text(hjust = 0))
# p3   # zapis: ggsave("sondaz-1000-sondazy.svg", p3, width = 10, height = 6.4)
Wynik w R
        n srednia_proc SD_pp wzor_SE_pp trafia_proc blad_MC_pp min_proc max_proc
100   100        50.12  5.15       5.00        93.2       0.80     34.0     67.0
1000 1000        49.95  1.56       1.58        95.1       0.68     45.2     54.4
                 n P_proc Wald_proc Wilson_proc blad_MC_pp
pracuje_n100   100  49.93     94.61       94.61       0.22
dziecko_n100   100   4.98     87.62       96.97       0.22
dziecko_n1000 1000   4.98     95.54       95.20       0.22
4. Różnica dwóch odsetków w jednym sondażu: Rysunek 4
R
# Rysunek 4. Różnica dwóch odsetków w jednym sondażu: dwie odpowiedzi na to samo pytanie i dwie podgrupy
# (kontynuacja: pop, N, moe, kol, motyw z bloku 1)
set.seed(587)
n <- 1000
s1 <- pop[sample.int(N, n), ]                   # jeden sondaż – ten sam co w pliku CSV
# write.csv(s1[, c("wydzial", "plec", "status", "pracuje")], "sondaz-jedna-proba-1000.csv", row.names = FALSE)
z <- qnorm(.975)
oszacuj <- function(s) {
  m <- nrow(s); pd <- mean(s$status == "dorywczo"); pe <- mean(s$status == "na etat")
  k <- s$plec == "kobieta"; pk <- mean(s$pracuje[k]); pm <- mean(s$pracuje[!k])
  c(dorywczo = pd, roznica_dor_eta = pd - pe, kobiety = pk, roznica_k_m = pk - pm,
    se_dorywczo = sqrt(pd * (1 - pd) / m),
    se_dor_eta = sqrt((pd + pe - (pd - pe)^2) / m),            # te same osoby: odpowiedzi wykluczają się
    se_kobiety = sqrt(pk * (1 - pk) / sum(k)),
    se_k_m = sqrt(pk * (1 - pk) / sum(k) + pm * (1 - pm) / sum(!k)),   # dwie rozłączne podgrupy
    n_kobiety = sum(k), n_mezczyzni = sum(!k))
}
o <- oszacuj(s1)
prawda <- c(dorywczo = mean(pop$status == "dorywczo"),
            roznica_dor_eta = mean(pop$status == "dorywczo") - mean(pop$status == "na etat"),
            kobiety = mean(pop$pracuje[pop$plec == "kobieta"]),
            roznica_k_m = mean(pop$pracuje[pop$plec == "kobieta"]) - mean(pop$pracuje[pop$plec != "kobieta"]))
tab4 <- data.frame(co = names(prawda), wynik_proc = 100 * o[1:4], moe_pp = 100 * z * o[5:8], prawda_proc = 100 * prawda)
tab4$dolna <- tab4$wynik_proc - tab4$moe_pp; tab4$gorna <- tab4$wynik_proc + tab4$moe_pp
round(tab4[-1], 2)
round(c(na_etat_proc = 100 * mean(s1$status == "na etat"), mezczyzni_pracuje_proc = 100 * mean(s1$pracuje[s1$plec != "kobieta"]),
        moe_calej_proby_pp = 100 * moe(mean(s1$pracuje), n), o[c("n_kobiety", "n_mezczyzni")]), 2)

# Kontrola: 1000 sondaży po 1000 osób – rozrzut każdego oszacowania (1.96 × SD) a margines ze wzoru
set.seed(587)
sym <- t(replicate(1000, oszacuj(pop[sample.int(N, n), ])))
kontrola <- data.frame(co = names(prawda), moe_wzor_pp = 100 * z * colMeans(sym[, 5:8]),
                       moe_symulacja_pp = 100 * z * apply(sym[, 1:4], 2, sd))
kontrola$stosunek_do_jednego_odsetka <- kontrola$moe_wzor_pp / kontrola$moe_wzor_pp[1]
round(kontrola[-1], 2)

etyk4 <- c(dorywczo = "Jeden odsetek:\npracuje dorywczo", roznica_dor_eta = "Różnica odpowiedzi:\ndorywczo − na etat",
           kobiety = "Podgrupa:\npracujące kobiety", roznica_k_m = "Różnica podgrup:\nkobiety − mężczyźni")
tab4$co <- factor(etyk4[tab4$co], levels = rev(etyk4))
tab4$rodzaj <- ifelse(grepl("Różnica", tab4$co), "różnica", "odsetek")
p4a <- ggplot(tab4, aes(y = co)) +
  geom_errorbar(aes(xmin = wynik_proc - moe_pp, xmax = wynik_proc + moe_pp, colour = rodzaj), width = 0.25, linewidth = 1.1) +
  geom_point(aes(x = wynik_proc, colour = rodzaj, shape = rodzaj), size = 2.8) +
  geom_point(aes(x = prawda_proc), shape = 4, size = 3, stroke = 1.2, colour = "black") +
  geom_text(aes(x = wynik_proc + moe_pp + 1, label = sprintf("±%.1f", moe_pp)), hjust = 0, size = 3.7) +
  scale_colour_manual(values = c(odsetek = kol[["nie pracuje"]], "różnica" = kol[["pracuje"]]), guide = "none") +
  scale_shape_manual(values = c(odsetek = 16, "różnica" = 17), guide = "none") +
  scale_x_continuous(limits = c(-5, 64), breaks = seq(0, 60, 10)) +
  labs(x = "Wynik jednego sondażu (%, pp) i 95% przedział; × – wartość w populacji", y = NULL,
       title = "Jeden sondaż, n = 1000: różnica ma szerszy margines niż odsetek") + motyw
p4 <- p4a
# p4   # zapis: ggsave("sondaz-roznica-dwoch-odsetkow.svg", p4, width = 10, height = 5.2)
Wynik w R
                wynik_proc moe_pp prawda_proc dolna gorna
dorywczo             28.70   2.80       28.99 25.90 31.50
roznica_dor_eta       8.30   4.31        8.06  3.99 12.61
kobiety              52.26   4.24       52.04 48.01 56.50
roznica_k_m           6.74   6.19        5.01  0.55 12.94
          na_etat_proc mezczyzni_pracuje_proc     moe_calej_proby_pp              n_kobiety
                 20.40                  45.51                   3.10                 532.00
           n_mezczyzni
                468.00
            moe_wzor_pp moe_symulacja_pp stosunek_do_jednego_odsetka
se_dorywczo        2.81             2.79                        1.00
se_dor_eta         4.35             4.27                        1.55
se_kobiety         4.07             4.13                        1.45
se_k_m             6.26             6.42                        2.23
5. Ankieta online z samoselekcją a próba losowa, tożsamość Menga: Rysunek 5
R
# Rysunek 5. Paradoks dużych danych: ankieta online z lekką samoselekcją vs mała próba losowa
# (kontynuacja: pop, N, P, moe, kol, motyw z bloku 1)
Np <- sum(pop$pracuje); Nn <- N - Np           # pracujący i niepracujący w populacji
z <- qnorm(.975)
# Ankieta online: link dostają wszyscy; odpowiada średnio 20% osób, pracujący nieco rzadziej (19% vs 21%).
# Odsetki odpowiedzi ustawiono ręcznie. Dla odsetka pracujących wystarczy wylosować, ilu pracujących
# i ilu niepracujących odpowie (rbinom) – to dokładnie to samo, co losować odpowiedź osoba po osobie.
online <- function(S, r_p, r_n) {
  kp <- rbinom(S, Np, r_p); kn <- rbinom(S, Nn, r_n)
  data.frame(n = kp + kn, p_hat = kp / (kp + kn))
}
losowa <- function(S, n) data.frame(n = n, p_hat = rhyper(S, Np, Nn, n) / n)   # losowanie proste bez zwracania

set.seed(587)
S <- 1000
d5 <- rbind(cbind(schemat = "ankieta online (ok. 10 000 odpowiedzi)", online(S, .19, .21)),
            cbind(schemat = "próba losowa n = 400", losowa(S, 400)))
d5$pokrywa <- abs(d5$p_hat - P) <= moe(d5$p_hat, d5$n)
tab5 <- do.call(rbind, lapply(split(d5, d5$schemat), function(d) {
  mse <- mean((d$p_hat - P)^2)
  data.frame(sr_n = mean(d$n), srednia_proc = 100 * mean(d$p_hat), obciazenie_pp = 100 * (mean(d$p_hat) - P),
             SD_pp = 100 * sd(d$p_hat), RMSE_pp = 100 * sqrt(mse), sr_margines_pp = 100 * mean(moe(d$p_hat, d$n)),
             pokrycie_proc = 100 * mean(d$pokrywa), n_efektywne = P * (1 - P) / mse)
}))
round(tab5, 2)

# Tożsamość Menga dla jednej ankiety: błąd = ρ(R, Y) × √((1 − f)/f) × σ_Y
set.seed(587)
odp <- rbinom(N, 1, ifelse(pop$pracuje == 1, .19, .21))      # kto odpowiedział (R = 1)
f <- mean(odp); rho <- cor(odp, pop$pracuje); sigma <- sqrt(P * (1 - P))
round(c(n = sum(odp), f = f, rho = rho, blad_pp = 100 * (mean(pop$pracuje[odp == 1]) - P),
        rho_razy_czynnik_pp = 100 * rho * sqrt((1 - f) / f) * sigma), 4)

# Pokrycie nominalnego 95% przedziału, gdy rośnie względna różnica skłonności do odpowiedzi
# (10 000 powtórzeń; średni odsetek odpowiedzi 20% → ok. 10 000 osób albo 0.8% → ok. 400 osób)
set.seed(587)
R <- 10000
siatka <- expand.grid(delta = c(0, .025, .05, .10, .15, .20), sredni = c(.20, .008))
siatka$pokrycie <- mapply(function(delta, sredni) {
  d <- online(R, sredni * (1 - delta / 2), sredni * (1 + delta / 2))
  mean(abs(d$p_hat - P) <= moe(d$p_hat, d$n))
}, siatka$delta, siatka$sredni)
siatka$blad_MC_pp <- 100 * sqrt(siatka$pokrycie * (1 - siatka$pokrycie) / R)
siatka$wielkosc <- ifelse(siatka$sredni == .20, "ok. 10 000 odpowiedzi (20%)", "ok. 400 odpowiedzi (0.8%)")
data.frame(roznica_proc = 100 * siatka$delta, sredni_RR_proc = 100 * siatka$sredni,
           pokrycie_proc = round(100 * siatka$pokrycie, 2), blad_MC_pp = round(siatka$blad_MC_pp, 2))

d5$schemat <- factor(d5$schemat, levels = c("próba losowa n = 400", "ankieta online (ok. 10 000 odpowiedzi)"))
p5a <- ggplot(d5, aes(100 * p_hat, fill = schemat)) +
  geom_histogram(binwidth = 0.5, boundary = 0, colour = "white", linewidth = 0.15, position = "identity", alpha = 0.85) +
  geom_vline(xintercept = 100 * P, linetype = "dashed", colour = "grey15", linewidth = 0.8) +
  annotate("text", x = 100 * P + 0.4, y = Inf, label = "P", vjust = 1.5, hjust = 0, size = 4.2) +
  facet_wrap(~ schemat, ncol = 1, scales = "free_y") +
  scale_fill_manual(values = c(kol[["nie pracuje"]], kol[["pracuje"]]), guide = "none") +
  scale_x_continuous(breaks = seq(40, 64, 4)) +
  labs(x = "Odsetek pracujących (%)", y = "Liczba badań", title = "A. 1000 powtórzeń każdego planu") + motyw +
  theme(strip.text = element_text(hjust = 0, size = rel(0.85)))
p5b <- ggplot(siatka, aes(100 * delta, 100 * pokrycie, colour = wielkosc, shape = wielkosc, linetype = wielkosc)) +
  geom_hline(yintercept = 95, colour = "grey50") +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["pracuje"]], kol[["nie pracuje"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  scale_y_continuous(limits = c(0, 100)) +
  labs(x = "Różnica skłonności do odpowiedzi (% średniej)", y = "Pokrycie 95% przedziału (%)",
       title = "B. Ten sam błąd, różne n") + motyw
p5 <- p5a + p5b + plot_layout(widths = c(1.1, 1))
# p5   # zapis: ggsave("sondaz-duza-proba-z-bledem.svg", p5, width = 10, height = 6)
Wynik w R
                                          sr_n srednia_proc obciazenie_pp SD_pp RMSE_pp
ankieta online (ok. 10 000 odpowiedzi) 9996.29        47.40         -2.52  0.44    2.56
próba losowa n = 400                    400.00        50.03          0.10  2.40    2.40
                                       sr_margines_pp pokrycie_proc n_efektywne
ankieta online (ok. 10 000 odpowiedzi)           0.98           0.0      381.17
próba losowa n = 400                             4.89          95.8      433.09
                  n                   f                 rho             blad_pp rho_razy_czynnik_pp
          9865.0000              0.1973             -0.0271             -2.7288             -2.7288
   roznica_proc sredni_RR_proc pokrycie_proc blad_MC_pp
1           0.0           20.0         97.03       0.17
2           2.5           20.0         78.57       0.41
3           5.0           20.0         26.83       0.44
4          10.0           20.0          0.03       0.02
5          15.0           20.0          0.00       0.00
6          20.0           20.0          0.00       0.00
7           0.0            0.8         95.11       0.22
8           2.5            0.8         94.63       0.23
9           5.0            0.8         91.84       0.27
10         10.0            0.8         82.97       0.38
11         15.0            0.8         67.16       0.47
12         20.0            0.8         48.53       0.50
6. Liczba zaproszeń i jedna wysyłka na mapie: Rysunek 6
R
# Rysunek 6. Ile zaproszeń wysłać: mapa zaproszonych i odpowiadających oraz liczba zaproszeń a odsetek odpowiedzi
# (kontynuacja: pop, N, moe, kol, ksz, motyw, granice z bloku 1)
z <- qnorm(.975)
n_cel <- ceiling(z^2 * .25 / c(.05, .03)^2)     # odpowiedzi potrzebne do ±5 i ±3 pp przy p = 50%
names(n_cel) <- c("margines ±5 pp", "margines ±3 pp")
n_cel
rr <- c(.10, .20, .30, .50)                     # zakładany odsetek odpowiedzi (response rate)
zapr <- outer(n_cel, rr, function(n, r) ceiling(n / r)); colnames(zapr) <- paste0("RR ", 100 * rr, "%")
zapr

# Jedna wysyłka: 2000 losowo wybranych zaproszeń, każdy odpowiada z prawdopodobieństwem 20% (ustawionym ręcznie)
set.seed(587)
zapr_id <- sample.int(N, 2000)
odp6 <- rbinom(2000, 1, .20)
d6 <- pop[zapr_id[odp6 == 1], ]
d6$odp <- factor(ifelse(d6$pracuje == 1, "pracuje", "nie pracuje"), levels = c("pracuje", "nie pracuje"))
round(c(zaproszenia = 2000, odpowiedzi = nrow(d6), RR_proc = 100 * mean(odp6),
        pracuje_proc = 100 * mean(d6$pracuje), moe_pp = 100 * moe(mean(d6$pracuje), nrow(d6))), 2)

tlo <- pop[, c("x", "y")]
tlo$kto <- "niezaproszeni"
tlo$kto[zapr_id[odp6 == 0]] <- "zaproszeni, bez odpowiedzi"
p6a <- ggplot() +
  geom_raster(data = tlo, aes(x, y, fill = kto)) +
  geom_vline(data = granice, aes(xintercept = x), colour = "white", linewidth = 1.2) +
  geom_point(data = d6, aes(x, y, colour = odp, shape = odp), size = 1.4) +
  scale_fill_manual(values = c(niezaproszeni = "grey93", "zaproszeni, bez odpowiedzi" = "grey55"), name = NULL) +
  scale_colour_manual(values = kol, breaks = c("pracuje", "nie pracuje"), name = NULL) +
  scale_shape_manual(values = ksz, breaks = c("pracuje", "nie pracuje"), name = NULL) +
  guides(fill = guide_legend(ncol = 1, order = 1), colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  coord_fixed(expand = FALSE) +
  labs(x = NULL, y = NULL, title = sprintf("A. 2000 zaproszeń, %d odpowiedzi", nrow(d6))) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank(), legend.text = element_text(size = rel(0.8)))

d6b <- expand.grid(rr = seq(.05, .60, by = .01), cel = names(n_cel))
d6b$zaproszenia <- ceiling(n_cel[as.character(d6b$cel)] / d6b$rr)
d6b$cel <- factor(d6b$cel, levels = names(n_cel))
p6b <- ggplot(d6b, aes(100 * rr, zaproszenia, colour = cel, linetype = cel)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = subset(d6b, round(100 * rr) %in% c(10, 20, 30, 50)), aes(shape = cel), size = 2.6) +
  scale_colour_manual(values = c(kol[["nie pracuje"]], kol[["pracuje"]]), name = NULL) +
  scale_linetype_manual(values = c("22", "solid"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_y_log10(breaks = c(500, 1000, 2000, 5000, 10000, 20000), labels = scales::label_number(big.mark = " ")) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Odsetek odpowiedzi (%)", y = "Zaproszenia (skala log.)", title = "B. Zaproszenia = n / odsetek odpowiedzi") + motyw
p6 <- p6a + p6b + plot_layout(widths = c(1.15, 1))
# p6   # zapis: ggsave("sondaz-zaproszenia-i-odpowiedzi.svg", p6, width = 10, height = 5.8)
Wynik w R
margines ±5 pp margines ±3 pp
           385           1068
               RR 10% RR 20% RR 30% RR 50%
margines ±5 pp   3850   1925   1284    770
margines ±3 pp  10680   5340   3560   2136
 zaproszenia   odpowiedzi      RR_proc pracuje_proc       moe_pp
     2000.00       360.00        18.00        49.72         5.16
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("pracuje / nie pracuje na mapie (rysunki 1, 6A)" = c("#D55E00", "#0072B2", "grey90"),
                "obejmuje / chybia (rysunek 3)" = c("#56B4E9", "#D55E00"),
                "dwa plany lub dwie liczebności (rysunki 2B, 4, 5, 6B)" = c("#D55E00", "#0072B2"),
                "tło mapy: niezaproszeni / bez odpowiedzi (rysunek 6A)" = c("grey93", "grey55"),
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
zestawy <- lapply(zestawy, function(k) rgb(t(col2rgb(k)), maxColorValue = 255))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                      widzenie_typowe deuteranopia protanopia
pracuje / nie pracuje na mapie (rysunki 1, 6A)                   61.2         65.0       56.4
obejmuje / chybia (rysunek 3)                                   113.6        101.1       89.0
dwa plany lub dwie liczebności (rysunki 2B, 4, 5, 6B)           114.6        108.3       91.9
tło mapy: niezaproszeni / bez odpowiedzi (rysunek 6A)            35.5         35.5       35.5
czerwony – zielony (dla porównania)                             121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie prób, rozkład dwumianowy i hipergeometryczny – pakiet stats). Rysunki wykonano w ggplot2 z etykietami osi z pakietu scales, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Margines błędu przy próbie wygodnej. Wzór zakłada losowanie (rysunek 5).
- Jeden margines dla wszystkiego. Podgrupy i różnice mają szersze marginesy (rysunek 4).
- „Różnica mniejsza niż margines, więc jej nie ma” albo odwrotnie – porównuj z marginesem różnicy, nie odsetka.
- Wiara, że duża próba „naprawia” dobór. Duża ankieta z samoselekcją daje wąski przedział wokół złej wartości (rysunek 5).
- Przedział Walda dla rzadkiej cechy przy małym n. Użyj przedziału Wilsona (rysunek 3).
- Liczebność zaplanowana bez odsetka odpowiedzi. Potrzebne odpowiedzi to nie to samo co zaproszenia (rysunek 6); szerzej – ile osób do ankiety w pracy licencjackiej.
- Rysunek bez podpisu, co oznaczają wąsy. Zasady podpisów są we wpisie wykresy w pracy dyplomowej.
Najczęstsze pytania
Jak margines błędu sondażu zależy od liczby badanych?
Maleje z pierwiastkiem z n. Przy wyniku 50% i poziomie ufności 95% wynosi ±9.8 punktu procentowego dla 100 osób, ±4.9 dla 400, ±3.1 dla 1000 i ±2.2 dla 2000. Połowę marginesu daje czterokrotnie większa próba. Wzór zakłada próbę losową; przy próbie wygodnej marginesu się nie podaje.
Dlaczego sondaże podają margines błędu dla wyniku 50%?
Bo jest wtedy największy: iloczyn p(1 − p) we wzorze osiąga maksimum przy 50%. Przy 1000 osobach margines wynosi ±3.1 punktu dla 50%, ±2.5 dla 20% i ±1.4 dla 5%. Podanie marginesu „dla 50%” to więc bezpieczna górna granica dla wszystkich odsetków w sondażu.
Jaki jest margines błędu różnicy dwóch odsetków z jednego sondażu?
Większy niż margines jednego odsetka. W symulowanym sondażu 1000 osób margines odsetka pracujących dorywczo wynosił ±2.8 punktu, a różnicy „dorywczo − na etat” – ±4.3 punktu, bo obie odpowiedzi pochodzą od tych samych osób i wykluczają się. Różnica dwóch podgrup (532 kobiety i 468 mężczyzn) miała margines ±6.2 punktu.
Czy duża ankieta internetowa ma mały margines błędu?
Formalnie tak, ale ten margines nie opisuje jej błędu. W symulacji ankieta online z około 10 000 odpowiedzi, w której pracujący odpowiadali nieco rzadziej (19% zamiast 21%), dawała margines ±0.98 punktu, a jej przedział nie objął prawdziwej wartości w żadnym z 1000 powtórzeń. Pod względem błędu średniokwadratowego była warta tyle, co około 380 osób wylosowanych. Meng (2018) nazwał to zjawisko paradoksem dużych danych.
Ile zaproszeń wysłać, żeby uzyskać margines błędu ±5 punktów procentowych?
Potrzebujesz 385 odpowiedzi, więc liczbę zaproszeń dostajesz, dzieląc 385 przez spodziewany odsetek odpowiedzi: przy 20% to 1925 zaproszeń, przy 10% – 3850. Dla ±3 punktów potrzeba 1068 odpowiedzi, czyli 5340 zaproszeń przy 20%. Odsetek odpowiedzi warto planować jako zakres, z zapasem.
Powiązane hasła
Przeczytaj też
Ile zaproszeń wysłać w sondażu
Od marginesu błędu do liczby zaproszeń: efekt schematu, wagi, kwalifikacja, kontakt i odpowiedź, podgrupy oraz ryzyko niedoboru w R.
Czytaj →PoradnikCałkowity błąd badania sondażowego (TSE)
Pokrycie, brak odpowiedzi, pomiar i ważenie w jednym rachunku MSE: symulacja czterech planów za ten sam budżet i opis ograniczeń.
Czytaj →PoradnikDobór nielosowy w obrazkach
Próba wygodna, celowa, kwotowa, kula śnieżna i samoselekcja na mapie fikcyjnej uczelni oraz 1000 badań każdym sposobem – sześć rysunków z R.
Czytaj →PoradnikWielkość próby a wielkość populacji w obrazkach
Mapy populacji, krzywe marginesu błędu dla N od 200 do 38 mln, 1000 sondaży w mieście i w kraju, mała populacja i efektywne n – sześć rysunków z R.
Czytaj →PoradnikNPS – przedział ufności i porównania
Przedział ufności NPS ze wzoru i bootstrapu, liczba ankiet do wykrycia zmiany i porównanie dwóch NPS na przykładzie salonów optycznych – z kodem R.
Czytaj →Planujesz sondaż albo ankietę do pracy?
Pomożemy dobrać liczebność i liczbę zaproszeń, policzyć przedziały dla odsetków i ich różnic oraz uczciwie opisać dobór próby i jego ograniczenia – tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A., & Coull, B. A. (1998). Approximate is better than “exact” for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election. The Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-aoas1161sf ● Otwarty dostęp
- Scott, A. J., & Seber, G. A. F. (1983). Difference of proportions from the same survey. The American Statistician, 37(4a), 319–320. https://doi.org/10.1080/00031305.1983.10483130
- Shirani-Mehr, H., Rothschild, D., Goel, S., & Gelman, A. (2018). Disentangling bias and variance in election polls. Journal of the American Statistical Association, 113(522), 607–614. https://doi.org/10.1080/01621459.2018.1448823
Cytowania BibTeX
@article{agresti1998approximate, author={Agresti, Alan and Coull, Brent A.}, title={{Approximate is better than “exact” for interval estimation of binomial proportions}}, journal={The American Statistician}, year={1998}, volume={52}, number={2}, pages={119--126}, doi={10.1080/00031305.1998.10480550}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{meng2018statistical, author={Meng, Xiao-Li}, title={{Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election}}, journal={The Annals of Applied Statistics}, year={2018}, volume={12}, number={2}, pages={685--726}, doi={10.1214/18-aoas1161sf}}@article{scott1983difference, author={Scott, Alastair J. and Seber, George A. F.}, title={{Difference of proportions from the same survey}}, journal={The American Statistician}, year={1983}, volume={37}, number={4a}, pages={319--320}, doi={10.1080/00031305.1983.10483130}}@article{shirani2018disentangling, author={Shirani-Mehr, Houshmand and Rothschild, David and Goel, Sharad and Gelman, Andrew}, title={{Disentangling bias and variance in election polls}}, journal={Journal of the American Statistical Association}, year={2018}, volume={113}, number={522}, pages={607--614}, doi={10.1080/01621459.2018.1448823}}