Przykład: salony optyczne pytają „czy NPS naprawdę spadł?”
Fikcyjna sieć salonów optycznych po każdej wizycie wysyła klientowi SMS z jednym pytaniem: „Jak bardzo prawdopodobne jest, że polecisz nasz salon znajomemu?” (0 – wcale, 10 – na pewno). Z odpowiedzi liczy Net Promoter Score (NPS). Dyrektorka marketingu porównuje dwa salony – w galerii handlowej i na osiedlu – w II i III kwartale. Ma trzy pytania: jak dokładny jest każdy NPS, czy zmiany między kwartałami są prawdziwe i ile ankiet trzeba zebrać, żeby zauważyć zmianę o 5 albo 10 punktów?
Dane są fikcyjne, więc znamy prawdę. Przed pierwszym uruchomieniem ręcznie ustaliliśmy rozkład odpowiedzi 0–10 w każdej z czterech komórek. Prawdziwy NPS wynosi 35 i 30 w galerii (spadek o 5 punktów) oraz 15 i 24 na osiedlu (wzrost o 9). Liczba ankiet: 420 i 450 w galerii, 180 i 210 na osiedlu. Ziarno 624 ustalono raz i nie zmieniano go. Jedną rzecz dodaliśmy po pierwszym uruchomieniu (opis przy rysunku 6). Dane 1260 ankiet pobierzesz jako nps-salony-optyczne.csv.
Rysunek 1: jak powstaje NPS
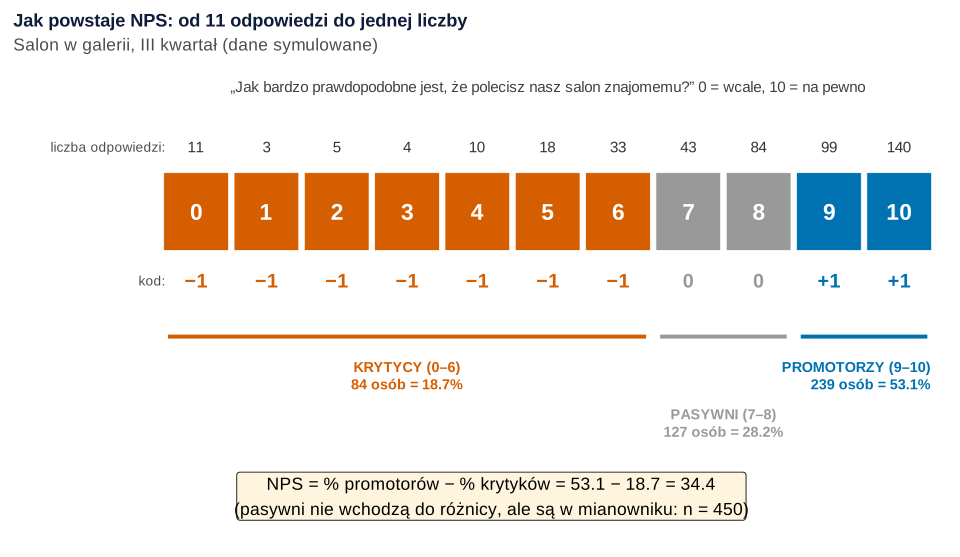
set.seed(624)).Co widać. W galerii w III kwartale odpowiedziało 450 klientów. Oceny 0–6 to krytycy (84 osoby, 18.7%), 7–8 to pasywni (127, 28.2%), a 9–10 to promotorzy (239, 53.1%). NPS = 53.1 − 18.7 = 34.4. Pod kafelkami jest najważniejszy trik: NPS to zwykła średnia zmiennej, która przyjmuje +1 dla promotora, 0 dla pasywnego i −1 dla krytyka (razy 100). Dzięki temu da się policzyć jego błąd standardowy, przedział ufności i różnicę dwóch wyników.
Jak może zmylić. Kafelki 0 i 6 mają ten sam kod −1, a 7 i 8 – zero. Klient, który w kolejnym kwartale da 6 zamiast 2, „nie istnieje” dla NPS. Pomysł jednego pytania pochodzi od Reichhelda (2003), który twierdził, że ono najlepiej zapowiada wzrost firmy. Późniejsze badania tego nie potwierdziły – o tym w pułapkach.
Podpis do pracy:
Rysunek 2: rozkład odpowiedzi 0–10
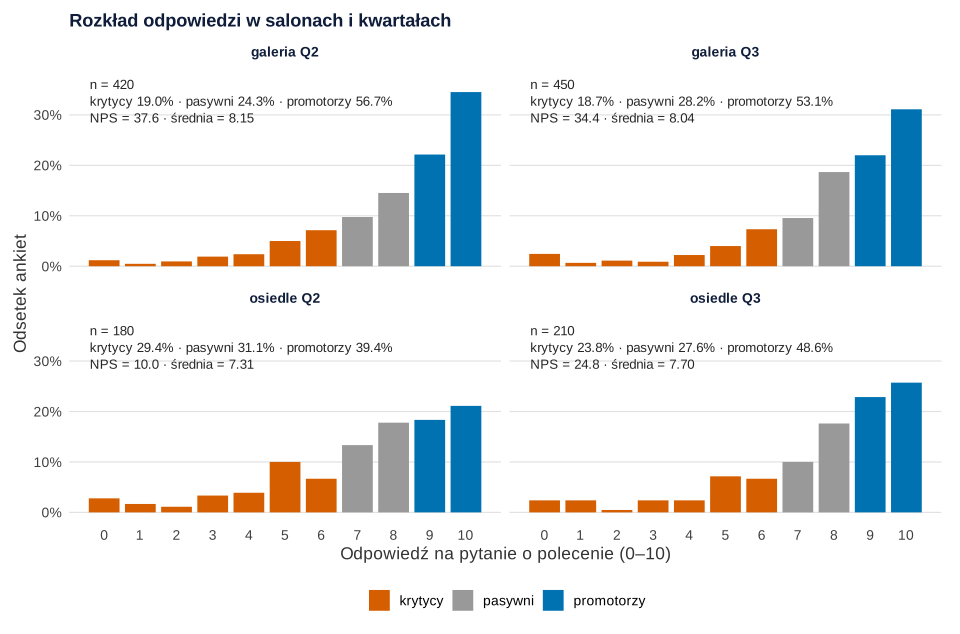
Co widać. NPS galerii wyniósł 37.6 w II i 34.4 w III kwartale. Na osiedlu wzrósł z 10.0 do 24.8, bo odsetek krytyków spadł z 29.4% do 23.8%, a promotorów wzrósł z 39.4% do 48.6%. Średnie na skali 0–10 idą w tę samą stronę: 8.15 i 8.04 w galerii, 7.31 i 7.70 na osiedlu.
Jak może zmylić. Sam NPS nie pokazuje, gdzie leżą odpowiedzi. Od 6.7% do 7.3% ankiet to „6”, czyli krytycy o włos od progu, a od 14.5% do 18.7% to „8”, o krok od promotora. Niewielka zmiana nastrojów tych osób potrafi przesunąć NPS o kilka punktów. Dlatego zawsze pokazuj rozkład, a nie tylko wynik. Pojedyncze pytanie 0–10 to skala porządkowa – o tym, kiedy wolno liczyć z niej średnią, piszemy we wpisie średnia czy mediana na skali Likerta.
Podpis do pracy:
Rysunek 3: przedział ufności – wzór i bootstrap
Skoro NPS jest średnią zmiennej +1/0/−1, jego wariancja wynika z rozkładu wielomianowego trzech grup:
pP i pK to odsetki promotorów i krytyków jako ułamki. To przedział Walda, czyli przybliżenie normalne. Druga droga to bootstrap: losujemy ze zwracaniem 2000 nowych prób po n odpowiedzi z naszej próby, w każdej liczymy NPS, a przedział wyznaczają 2.5. i 97.5. percentyl. Metodę zaproponował Efron (1979); jak wygląda krok po kroku, pokazuje wpis bootstrap – wizualizacja na obrazkach.
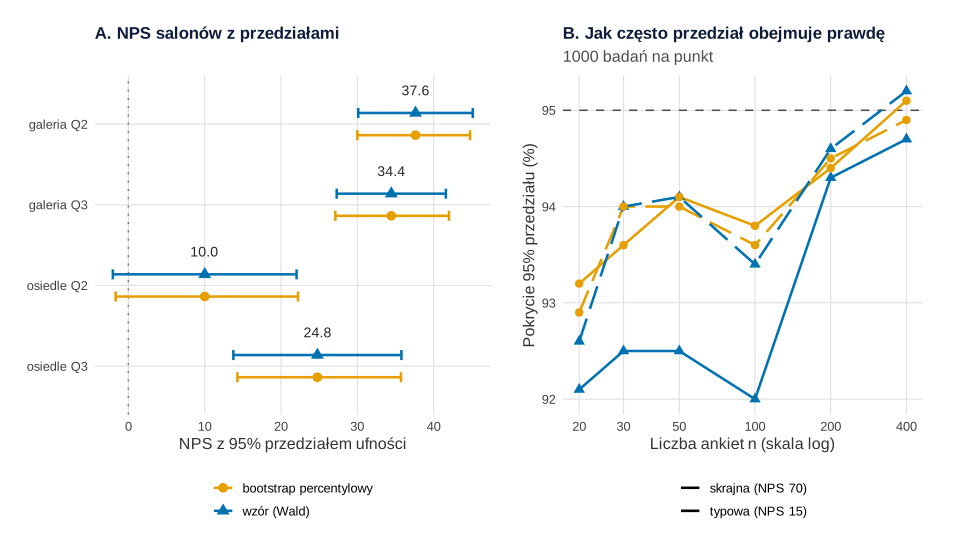
set.seed(624)).Co widać. Panel A: obie metody dają prawie te same przedziały. Galeria w III kwartale: 34.4, 95% CI [27.3, 41.6] ze wzoru i [27.1, 42.0] z bootstrapu. Osiedle w II kwartale: 10.0 [−2.0, 22.0] – przy 180 ankietach przedział obejmuje zero i ma 24 punkty szerokości. Panel B: 1000 badań dla każdej liczby ankiet. W typowej populacji (NPS 15) oba przedziały obejmowały prawdę w 92.6–95.2% badań. W skrajnej (74% promotorów, 4% krytyków, NPS 70) wzór przy n ≤ 100 trafiał w 92.0–92.5% przypadków, a bootstrap w 93.2–94.1% (błąd Monte Carlo około 0.8 pp).
Jak może zmylić. Bootstrap nie jest magicznie lepszy – przy małych próbach oba przedziały są nieco za wąskie. Rocks (2016) porównał kilka metod na dużej bazie wyników NPS firm; najlepiej wypadły odmiany skorygowanego przedziału Walda i przedział oparty na teście score. Przy kilkuset ankietach wybór metody nie ma znaczenia. Ma znaczenie przy kilkudziesięciu – wtedy podaj przedział i napisz wprost, że jest szeroki. Podobną logikę dla pojedynczego odsetka opisuje hasło przedział ufności dla proporcji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ile ankiet potrzeba
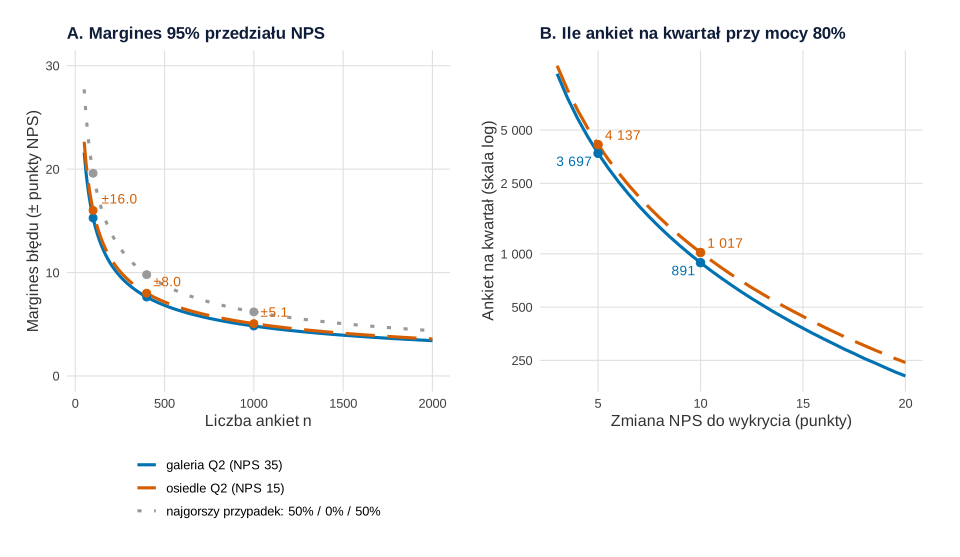
set.seed(624)).Co widać. Panel A: margines błędu (połowa 95% przedziału) maleje z pierwiastkiem z n. Przy rozkładzie osiedla wynosi ±16.0 punktu dla 100 ankiet, ±8.0 dla 400 i ±5.1 dla 1000. Najgorszy przypadek – połowa promotorów i połowa krytyków – daje ±19.6, ±9.8 i ±6.2. W najgorszym przypadku margines NPS jest dokładnie dwa razy szerszy niż margines pojedynczego odsetka 50% przy tej samej liczbie osób (por. sondaż w obrazkach), bo NPS biegnie od −100 do 100, a nie od 0 do 100%.
Panel B: ile ankiet na kwartał trzeba, żeby różnicę NPS wykryć z mocą 80% (α = .05, test dwustronny). Założyliśmy, że zmiana polega na przejściu części krytyków do promotorów. Zmiana o 10 punktów wymaga 891 ankiet na kwartał w galerii, a o 5 punktów – 3697. W 1000 symulowanych par badań przy tych liczebnościach test wykrył zmianę w 81.1% i 79.8% przypadków (błąd Monte Carlo 1.2–1.3 pp), więc wzór działa.
Jak może zmylić. Galeria zbiera około 435 ankiet na kwartał, osiedle około 195. Przy takich liczbach najmniejsza zmiana wykrywalna z mocą 80% to 14.1 punktu w galerii i 22.2 na osiedlu. Prawdziwy spadek galerii (5 punktów) był więc praktycznie niewykrywalny. Jak brak mocy zawyża „udane” wyniki, pokazuje wpis moc testu w obrazkach, a ogólne zasady opisuje hasło liczebność próby w ankiecie.
Zdanie do Metody:
Rysunek 5: czy NPS się zmienił?
Różnica dwóch NPS z niezależnych prób (inni klienci w każdym kwartale lub salonie) ma błąd standardowy SEróżnicy = √(SE1² + SE2²). Iloraz różnicy i SE daje test z. Bootstrap robi to samo przez losowanie: w każdej z 2000 prób liczymy oba NPS i ich różnicę.
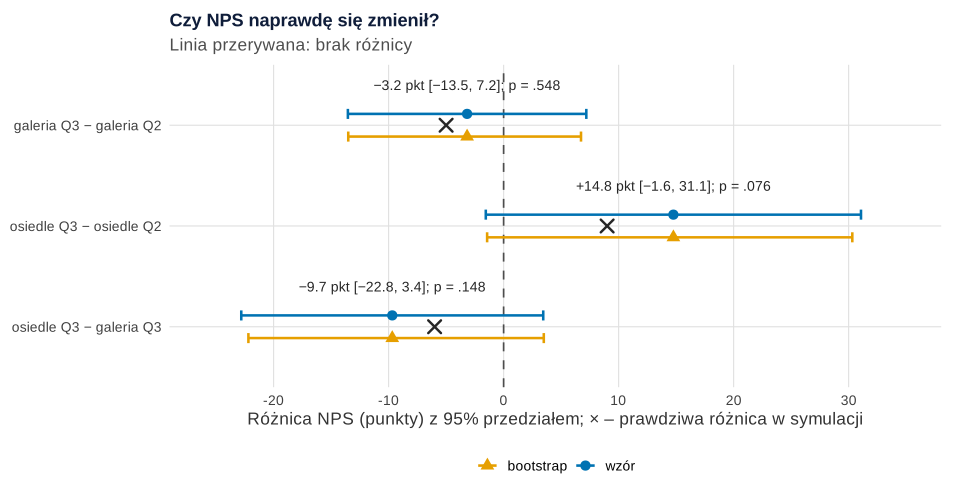
set.seed(624)).Co widać. Galeria: −3.2 punktu, 95% CI [−13.5, 7.2], p = .548. Osiedle: +14.8 punktu [−1.6, 31.1], p = .076. Osiedle wobec galerii w III kwartale: −9.7 [−22.8, 3.4], p = .148. Przedziały bootstrapowe są prawie takie same. Wszystkie trzy przedziały obejmują zero i wszystkie obejmują prawdziwą różnicę (−5, +9 i −6 punktów).
Jak może zmylić. „Osiedle poprawiło NPS o prawie 15 punktów!” brzmi jak sukces, ale dane zgadzają się zarówno z niewielkim spadkiem, jak i z wzrostem o 31 punktów. Prawdziwy wzrost wynosi 9, a próba go „przestrzeliła”. Druga pułapka: nie oceniaj różnicy po nakładaniu się przedziałów pojedynczych NPS – policz przedział różnicy wprost. Gdy te same osoby odpowiadają w obu kwartałach, próby nie są niezależne i powyższy wzór nie pasuje. Śledzenie wskaźnika w wielu falach opisuje wpis badanie trackingowe marki.
Zdanie do Wyników:
Rysunek 6: ten sam NPS, różne rozkłady – i NPS czy średnia?
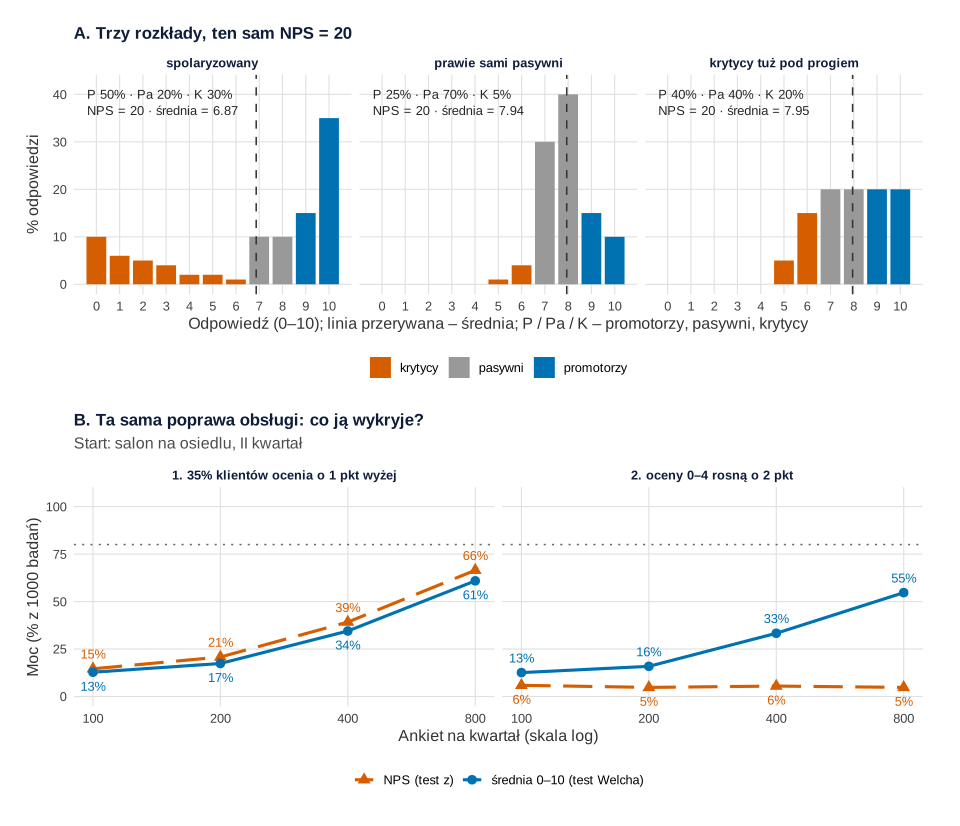
set.seed(624)).Co widać. Panel A: trzy ręcznie dobrane rozkłady dają NPS = 20. Spolaryzowany ma średnią 6.87 i SD 3.61. „Prawie sami pasywni” – średnią 7.94 i SD 1.05. „Krytycy tuż pod progiem” – 7.95. Różni się też precyzja: przy 200 ankietach SE NPS wynosi 6.16, 3.61 i 5.29 punktu. Ten sam wynik może więc oznaczać zupełnie różnych klientów i różną pewność.
Panel B: dwie poprawy obsługi, 1000 badań na każdą liczbę ankiet. Przy pierwszej 35% klientów ocenia salon o punkt wyżej. NPS rośnie o 9.5 punktu, średnia o 0.27, i NPS wykrywa ją nawet nieco częściej: przy 800 ankietach na kwartał 66.5% wobec 60.9% dla średniej (test Welcha). Wiele osób stoi tu tuż pod progami 6/7 i 8/9. Przy drugiej najbardziej niezadowoleni (oceny 0–4) oceniają o 2 punkty wyżej, ale wciąż są krytykami. Średnia rośnie o 0.24, a NPS wcale. Średnia wykrywa tę poprawę w 54.7% badań, NPS w 4.8%, czyli tyle, ile wynosi α.
Jak może zmylić. Drugą poprawę dodaliśmy po pierwszym uruchomieniu. Przy samej pierwszej NPS wypadał lepiej, a chcieliśmy pokazać, od czego to zależy. NPS widzi tylko przejścia przez progi; średnia widzi każdy ruch na skali. Zamiana skali na kategorie zwykle kosztuje informację i moc (MacCallum i in., 2002; zob. dychotomizacja zmiennych ciągłych). Raportuj więc oba: NPS dla działu marketingu, średnią i rozkład dla analizy.
Podpis do pracy:
Co z tym zrobić w marketingu
- Nie ogłaszaj spadku galerii. −3.2 punktu przy przedziale [−13.5, 7.2] to „bez wyraźnej zmiany”. Przy 435 ankietach na kwartał wiarygodnie zobaczysz dopiero zmianę o około 14 punktów.
- Osiedle: obiecujące, ale niepewne. Sprawdź kolejny kwartał albo połącz dwa kwartały, zanim nagrodzisz zespół.
- Raport kwartalny: NPS z przedziałem, liczba ankiet, odsetki trzech grup i średnia 0–10. Zmianę podawaj z przedziałem różnicy, a nie jako dwie liczby obok siebie.
- Plan liczby ankiet zrób przed celem. Cel „+5 punktów NPS w kwartał” wymaga około 3700 ankiet na kwartał w jednym salonie. Lepiej postawić cel roczny albo cel na średnią.
- Szukaj przyczyn w pytaniach o konkretne aspekty wizyty, a nie w samym NPS – pomoże analiza kluczowych czynników satysfakcji. Gdy porównujesz wiele salonów o różnej liczbie ankiet, zobacz, jak ranking psują małe próby we wpisie o ocenach gwiazdkowych.
Jak opisać w pracy
W Metodzie podaj treść pytania, skalę, granice grup (0–6, 7–8, 9–10), sposób i czas zbierania odpowiedzi, odsetek odpowiedzi oraz metodę przedziałów. W Wynikach podaj NPS z 95% CI, n i odsetki trzech grup, a przy porównaniach – różnicę z przedziałem i p. W Ograniczeniach napisz, że NPS jest jednym pytaniem, a odpowiadają nie wszyscy klienci (błąd braku odpowiedzi). Inne projekty z ankiet konsumenckich znajdziesz we wpisie statystyka w pracy z marketingu.
Tabela wyników: salon, kwartał, n, odsetki krytyków, pasywnych i promotorów, NPS z 95% CI, średnia (SD). Pod tabelą – różnice z przedziałami.
Kod R: NPS, przedziały, liczebność i porównania
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, funkcje i dane, z których korzystają kolejne. Wystarczą pakiety ggplot2 i patchwork; NPS, przedziały, bootstrap (rmultinom()) i testy liczy bazowy R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 4 (bootstrap i 1000 badań na punkt), 5 (sprawdzenie mocy, 1000 par badań), 6 (bootstrap różnic) i 7 (duża próba i 1000 badań na punkt); każdy losujący blok zaczyna się od własnego set.seed(624). Ziarno 624 ustalono raz i nie zmieniano go. Ręcznie ustalono: rozkłady odpowiedzi 0–10 w czterech komórkach, liczby ankiet (420, 450, 180, 210), populację skrajną do sprawdzenia pokrycia (4% krytyków, 22% pasywnych, 74% promotorów), liczby prób bootstrapowych (2000; 999 w symulacji pokrycia), sposób zmiany NPS w obliczeniach liczebności (połowa zmiany to ubytek krytyków, połowa – przyrost promotorów), trzy rozkłady o NPS = 20 i dwie poprawy ocen; drugą poprawę dodano po pierwszym uruchomieniu. Całość liczy się w około 6 sekund.
1. Paleta, dane i NPS w czterech komórkach
R
# Fikcyjna sieć salonów optycznych: ankieta SMS po wizycie z pytaniem o polecenie (0–10), dwa salony i dwa kwartały (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
kol_grup <- c(krytycy = kol[["cynober"]], pasywni = kol[["szary"]], promotorzy = kol[["niebieski"]])
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (przed pierwszym uruchomieniem): rozkład odpowiedzi 0–10 (%) i liczba ankiet
rozklady <- rbind(
  "galeria Q2" = c(2, 1, 1, 2, 2, 5, 6, 10, 17, 22, 32),   # prawdziwy NPS 35
  "galeria Q3" = c(2, 1, 1, 2, 3, 5, 7, 10, 18, 21, 30),   # prawdziwy NPS 30 (spadek o 5 pkt)
  "osiedle Q2" = c(3, 1, 2, 3, 3, 7, 8, 12, 19, 19, 23),   # prawdziwy NPS 15
  "osiedle Q3" = c(2, 1, 1, 2, 3, 6, 7, 12, 20, 21, 25))   # prawdziwy NPS 24 (wzrost o 9 pkt)
colnames(rozklady) <- 0:10
liczba_ankiet <- c("galeria Q2" = 420, "galeria Q3" = 450, "osiedle Q2" = 180, "osiedle Q3" = 210)
prawdziwy_nps <- rowSums(rozklady[, 10:11]) - rowSums(rozklady[, 1:7])
prawdziwy_nps

grupa_nps <- function(x) factor(ifelse(x <= 6, "krytycy", ifelse(x <= 8, "pasywni", "promotorzy")),
                                c("krytycy", "pasywni", "promotorzy"))
# NPS, błąd standardowy z wariancji zmiennej +1 / 0 / −1 i przedział Walda (przybliżenie normalne)
nps_opis <- function(x) {
  n <- length(x); pP <- mean(x >= 9); pK <- mean(x <= 6)
  nps <- 100 * (pP - pK); se <- 100 * sqrt((pP + pK - (pP - pK)^2) / n)
  c(n = n, krytycy = 100 * pK, pasywni = 100 * (1 - pP - pK), promotorzy = 100 * pP,
    NPS = nps, SE = se, od = nps - 1.96 * se, do = nps + 1.96 * se, srednia = mean(x))
}

set.seed(624)                                    # ziarno ustalone raz, bez dobierania pod wynik
ankiety <- do.call(rbind, lapply(rownames(rozklady), function(k)
  data.frame(salon = sub(" .*", "", k), kwartal = sub(".* ", "", k),
             ocena = sample(0:10, liczba_ankiet[[k]], replace = TRUE, prob = rozklady[k, ]))))
ankiety$id <- seq_len(nrow(ankiety))
ankiety$grupa <- grupa_nps(ankiety$ocena)
write.csv(ankiety[, c("id", "salon", "kwartal", "ocena", "grupa")], "nps-salony-optyczne.csv", row.names = FALSE)

ankiety$komorka <- paste(ankiety$salon, ankiety$kwartal)
wyniki <- t(sapply(split(ankiety$ocena, ankiety$komorka), nps_opis))
round(wyniki, 2)
Wynik w R
galeria Q2 galeria Q3 osiedle Q2 osiedle Q3
        35         30         15         24
             n krytycy pasywni promotorzy   NPS   SE    od    do srednia
galeria Q2 420   19.05   24.29      56.67 37.62 3.83 30.12 45.12    8.15
galeria Q3 450   18.67   28.22      53.11 34.44 3.65 27.29 41.60    8.04
osiedle Q2 180   29.44   31.11      39.44 10.00 6.14 -2.04 22.04    7.31
osiedle Q3 210   23.81   27.62      48.57 24.76 5.62 13.75 35.77    7.70
2. Jak powstaje NPS: Rysunek 1
R
# Rysunek 1. Jak powstaje NPS: skala 0–10, trzy grupy, kody +1 / 0 / −1 i rachunek (grafika z prostokątów i tekstu)
# Korzysta z obiektów przepisu 1: ankiety, kol, kol_grup, motyw. Niczego nie losuje.
library(ggplot2)

g3 <- subset(ankiety, salon == "galeria" & kwartal == "Q3")
skala <- data.frame(ocena = 0:10, liczba = as.vector(table(factor(g3$ocena, 0:10))))
skala$grupa <- grupa_nps(skala$ocena)
skala$kod <- c(krytycy = "−1", pasywni = "0", promotorzy = "+1")[as.character(skala$grupa)]
ile <- table(g3$grupa); n <- nrow(g3); proc <- 100 * ile / n
nps <- proc[["promotorzy"]] - proc[["krytycy"]]
klamry <- data.frame(od = c(-0.4, 6.6, 8.6), do = c(6.4, 8.4, 10.4), grupa = names(kol_grup),
                     x = c(3, 7.5, 10.45), y = c(1.1, 0.55, 1.1), hjust = c(0.5, 0.5, 1),
                     tekst = sprintf("%s (%s)\n%d osób = %.1f%%", c("KRYTYCY", "PASYWNI", "PROMOTORZY"),
                                     c("0–6", "7–8", "9–10"), as.vector(ile), as.vector(proc)))
p1 <- ggplot() +
  geom_tile(data = skala, aes(ocena, 3, fill = grupa), width = 0.92, height = 0.9, colour = "white") +
  geom_text(data = skala, aes(ocena, 3, label = ocena), colour = "white", fontface = "bold", size = 6) +
  geom_text(data = skala, aes(ocena, 3.75, label = liczba), size = 4, colour = "grey20") +
  annotate("text", x = -0.45, y = 3.75, label = "liczba odpowiedzi:", hjust = 1, size = 3.6, colour = "grey30") +
  geom_text(data = skala, aes(ocena, 2.2, label = kod, colour = grupa), size = 5.2, fontface = "bold") +
  annotate("text", x = -0.45, y = 2.2, label = "kod:", hjust = 1, size = 3.6, colour = "grey30") +
  geom_segment(data = klamry, aes(x = od, xend = do, y = 1.55, yend = 1.55, colour = grupa), linewidth = 1.4) +
  geom_text(data = klamry, aes(x, y, label = tekst, colour = grupa, hjust = hjust), size = 3.8, fontface = "bold",
            lineheight = 1.0) +
  annotate("label", x = 4.2, y = -0.3, size = 4.6, linewidth = 0.3, fill = "#FFF4DD",
           label = sprintf("NPS = %% promotorów − %% krytyków = %.1f − %.1f = %.1f\n(pasywni nie wchodzą do różnicy, ale są w mianowniku: n = %d)",
                           proc[["promotorzy"]], proc[["krytycy"]], nps, n)) +
  annotate("text", x = 5, y = 4.45, size = 4, colour = "grey25",
           label = "„Jak bardzo prawdopodobne jest, że polecisz nasz salon znajomemu?”  0 = wcale, 10 = na pewno") +
  scale_fill_manual(values = kol_grup, guide = "none") +
  scale_colour_manual(values = kol_grup, guide = "none") +
  coord_cartesian(xlim = c(-2.6, 10.6), ylim = c(-0.85, 4.7), expand = FALSE) +
  labs(title = "Jak powstaje NPS: od 11 odpowiedzi do jednej liczby",
       subtitle = "Salon w galerii, III kwartał (dane symulowane)") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("nps-jak-powstaje.svg", p1, width = 10, height = 5.8)
3. Rozkład odpowiedzi: Rysunek 2
R
# Rysunek 2. Rozkład odpowiedzi 0–10 w dwóch salonach i dwóch kwartałach
# Korzysta z obiektów przepisu 1: ankiety, wyniki, grupa_nps(), kol_grup, motyw. Niczego nie losuje.
library(ggplot2)

proc <- as.data.frame(prop.table(table(komorka = ankiety$komorka, ocena = factor(ankiety$ocena, 0:10)), 1) * 100)
proc$ocena <- as.integer(as.character(proc$ocena))
proc$grupa <- grupa_nps(proc$ocena)
opis <- data.frame(komorka = rownames(wyniki),
                   tekst = sprintf("n = %d\nkrytycy %.1f%% · pasywni %.1f%% · promotorzy %.1f%%\nNPS = %.1f · średnia = %.2f",
                                   wyniki[, "n"], wyniki[, "krytycy"], wyniki[, "pasywni"], wyniki[, "promotorzy"],
                                   wyniki[, "NPS"], wyniki[, "srednia"]))
# Odsetek ocen 6 i 8 – tuż pod progami kategorii
round(sapply(split(ankiety$ocena, ankiety$komorka), function(x) 100 * c(ocena_6 = mean(x == 6), ocena_8 = mean(x == 8))), 1)
p2 <- ggplot(proc, aes(ocena, Freq, fill = grupa)) +
  geom_col(width = 0.85) +
  geom_text(data = opis, aes(x = -0.4, y = 37, label = tekst), inherit.aes = FALSE, hjust = 0, vjust = 1,
            size = 3.5, colour = "grey15", lineheight = 1.05) +
  facet_wrap(~komorka, ncol = 2) +
  scale_fill_manual(values = kol_grup, name = NULL) +
  scale_x_continuous(breaks = 0:10) + scale_y_continuous(limits = c(0, 38), labels = function(x) paste0(x, "%")) +
  labs(x = "Odpowiedź na pytanie o polecenie (0–10)", y = "Odsetek ankiet",
       title = "Rozkład odpowiedzi w salonach i kwartałach") +
  motyw + theme(panel.grid.major.x = element_blank())
p2   # zapis: ggsave("nps-rozklad-odpowiedzi.svg", p2, width = 10, height = 6.6)
Wynik w R
        galeria Q2 galeria Q3 osiedle Q2 osiedle Q3
ocena_6        7.1        7.3        6.7        6.7
ocena_8       14.5       18.7       17.8       17.6
4. Przedział ufności i jego pokrycie: Rysunek 3
R
# Rysunek 3. Przedział ufności NPS: wzór (wariancja wielomianowa) i bootstrap; pokrycie w 1000 badań
# Korzysta z obiektów przepisu 1: ankiety, wyniki, rozklady, nps_opis(), kol, motyw.
library(ggplot2)
library(patchwork)

# Bootstrap: losujemy ze zwracaniem n odpowiedzi z próby. Dla NPS wystarczą liczebności trzech grup,
# więc każdą próbę bootstrapową daje jeden rzut rozkładu wielomianowego (szybciej niż sample() na osobach).
nps_boot <- function(liczby, B = 2000) {          # liczby = c(krytycy, pasywni, promotorzy)
  m <- rmultinom(B, sum(liczby), liczby / sum(liczby))
  100 * (m[3, ] - m[1, ]) / sum(liczby)
}
set.seed(624)
komorki <- rownames(wyniki)
przedzialy <- do.call(rbind, lapply(komorki, function(k) {
  liczby <- as.vector(table(ankiety$grupa[ankiety$komorka == k]))
  b <- nps_boot(liczby)
  data.frame(komorka = k, NPS = wyniki[k, "NPS"], wald_od = wyniki[k, "od"], wald_do = wyniki[k, "do"],
             boot_od = quantile(b, .025), boot_do = quantile(b, .975), boot_SE = sd(b), row.names = NULL)
}))
print(transform(przedzialy, NPS = round(NPS, 1), wald_od = round(wald_od, 1), wald_do = round(wald_do, 1),
                boot_od = round(boot_od, 1), boot_do = round(boot_do, 1), boot_SE = round(boot_SE, 2)), row.names = FALSE)

# Pokrycie: 1000 badań przy różnych n w dwóch populacjach (typowa: osiedle Q2, NPS 15; skrajna: NPS 70)
populacje <- list("typowa (NPS 15)" = c(sum(rozklady["osiedle Q2", 1:7]), sum(rozklady["osiedle Q2", 8:9]),
                                       sum(rozklady["osiedle Q2", 10:11])) / 100,
                  "skrajna (NPS 70)" = c(.04, .22, .74))
set.seed(624)
R <- 1000
pokrycie <- do.call(rbind, lapply(names(populacje), function(pop) do.call(rbind, lapply(c(20, 30, 50, 100, 200, 400), function(n) {
  p <- populacje[[pop]]; prawda <- 100 * (p[3] - p[1])
  traf <- t(replicate(R, {
    l <- as.vector(rmultinom(1, n, p)); pK <- l[1] / n; pP <- l[3] / n
    nps <- 100 * (pP - pK); se <- 100 * sqrt((pP + pK - (pP - pK)^2) / n)
    b <- quantile(nps_boot(l, B = 999), c(.025, .975))
    c(wald = abs(nps - prawda) <= 1.96 * se, bootstrap = b[[1]] <= prawda & prawda <= b[[2]])
  }))
  data.frame(populacja = pop, n = n, metoda = c("wzór (Wald)", "bootstrap percentylowy"),
             pokrycie = 100 * colMeans(traf), blad_MC = 100 * sqrt(colMeans(traf) * (1 - colMeans(traf)) / R))
}))))
print(transform(pokrycie, pokrycie = round(pokrycie, 1), blad_MC = round(blad_MC, 2)), row.names = FALSE)

# Rysunek 3A: przedziały w czterech komórkach
dl <- rbind(data.frame(komorka = przedzialy$komorka, metoda = "wzór (Wald)", NPS = przedzialy$NPS,
                       od = przedzialy$wald_od, do = przedzialy$wald_do),
            data.frame(komorka = przedzialy$komorka, metoda = "bootstrap percentylowy", NPS = przedzialy$NPS,
                       od = przedzialy$boot_od, do = przedzialy$boot_do))
dl$komorka <- factor(dl$komorka, rev(komorki))
kol_met <- c("wzór (Wald)" = kol[["niebieski"]], "bootstrap percentylowy" = kol[["pomarancz"]])
pA <- ggplot(dl, aes(NPS, komorka, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0, colour = "grey50", linetype = "dotted") +
  geom_errorbar(aes(xmin = od, xmax = do), width = 0.25, orientation = "y", linewidth = 0.9,
                position = position_dodge(width = 0.55)) +
  geom_point(size = 3, position = position_dodge(width = 0.55)) +
  geom_text(data = subset(dl, metoda == "wzór (Wald)"), aes(label = sprintf("%.1f", NPS)), colour = "grey15",
            nudge_y = 0.42, size = 3.7, show.legend = FALSE) +
  scale_colour_manual(values = kol_met, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "NPS z 95% przedziałem ufności", y = NULL, title = "A. NPS salonów z przedziałami") +
  motyw + theme(legend.direction = "vertical")
pB <- ggplot(pokrycie, aes(n, pokrycie, colour = metoda, shape = metoda, linetype = populacja)) +
  geom_hline(yintercept = 95, colour = "grey30", linetype = "dashed") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_x_log10(breaks = c(20, 30, 50, 100, 200, 400)) +
  scale_colour_manual(values = kol_met, guide = "none") + scale_shape_manual(values = c(16, 17), guide = "none") +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  labs(x = "Liczba ankiet n (skala log)", y = "Pokrycie 95% przedziału (%)",
       title = "B. Jak często przedział obejmuje prawdę", subtitle = "1000 badań na punkt") +
  motyw + theme(legend.direction = "vertical")
p3 <- pA + pB + plot_layout(widths = c(1.1, 1))
p3   # zapis: ggsave("nps-przedzial-ufnosci.svg", p3, width = 10, height = 5.8)
Wynik w R
    komorka  NPS wald_od wald_do boot_od boot_do boot_SE
 galeria Q2 37.6    30.1    45.1    30.0    44.8    3.78
 galeria Q3 34.4    27.3    41.6    27.1    42.0    3.71
 osiedle Q2 10.0    -2.0    22.0    -1.7    22.2    6.14
 osiedle Q3 24.8    13.8    35.8    14.3    35.7    5.47
        populacja   n                 metoda pokrycie blad_MC
  typowa (NPS 15)  20            wzór (Wald)     92.6    0.83
  typowa (NPS 15)  20 bootstrap percentylowy     92.9    0.81
  typowa (NPS 15)  30            wzór (Wald)     94.0    0.75
  typowa (NPS 15)  30 bootstrap percentylowy     94.0    0.75
  typowa (NPS 15)  50            wzór (Wald)     94.1    0.75
  typowa (NPS 15)  50 bootstrap percentylowy     94.0    0.75
  typowa (NPS 15) 100            wzór (Wald)     93.4    0.79
  typowa (NPS 15) 100 bootstrap percentylowy     93.6    0.77
  typowa (NPS 15) 200            wzór (Wald)     94.6    0.71
  typowa (NPS 15) 200 bootstrap percentylowy     94.5    0.72
  typowa (NPS 15) 400            wzór (Wald)     95.2    0.68
  typowa (NPS 15) 400 bootstrap percentylowy     94.9    0.70
 skrajna (NPS 70)  20            wzór (Wald)     92.1    0.85
 skrajna (NPS 70)  20 bootstrap percentylowy     93.2    0.80
 skrajna (NPS 70)  30            wzór (Wald)     92.5    0.83
 skrajna (NPS 70)  30 bootstrap percentylowy     93.6    0.77
 skrajna (NPS 70)  50            wzór (Wald)     92.5    0.83
 skrajna (NPS 70)  50 bootstrap percentylowy     94.1    0.75
 skrajna (NPS 70) 100            wzór (Wald)     92.0    0.86
 skrajna (NPS 70) 100 bootstrap percentylowy     93.8    0.76
 skrajna (NPS 70) 200            wzór (Wald)     94.3    0.73
 skrajna (NPS 70) 200 bootstrap percentylowy     94.4    0.73
 skrajna (NPS 70) 400            wzór (Wald)     94.7    0.71
 skrajna (NPS 70) 400 bootstrap percentylowy     95.1    0.68
5. Margines błędu i liczba ankiet: Rysunek 4
R
# Rysunek 4. Szerokość przedziału NPS w funkcji n i liczba ankiet do wykrycia zmiany o 5 lub 10 punktów
# Korzysta z obiektów przepisu 1: rozklady, liczba_ankiet, kol, motyw.
library(ggplot2)
library(patchwork)

trzy <- function(k) c(krytycy = sum(rozklady[k, 1:7]), pasywni = sum(rozklady[k, 8:9]), promotorzy = sum(rozklady[k, 10:11])) / 100
war <- function(p) unname(p[3] + p[1] - (p[3] - p[1])^2)      # wariancja zmiennej +1 / 0 / −1
profile <- list("galeria Q2 (NPS 35)" = trzy("galeria Q2"), "osiedle Q2 (NPS 15)" = trzy("osiedle Q2"),
                "najgorszy przypadek: 50% / 0% / 50%" = c(.5, 0, .5))
round(sapply(profile, war), 3)

# A. Margines błędu (połowa 95% przedziału) w punktach NPS
siatkaA <- expand.grid(n = seq(50, 2000, by = 10), profil = names(profile))
siatkaA$margines <- 1.96 * 100 * sqrt(sapply(profile, war)[as.character(siatkaA$profil)] / siatkaA$n)
subset(transform(siatkaA, margines = round(margines, 1)), n %in% c(100, 200, 400, 1000))

# B. Ankiet na grupę do wykrycia zmiany NPS o d punktów (moc 80%, alfa = .05, dwustronnie, dwie niezależne próby).
# Zmiana: d/2 punktu procentowego krytyków przechodzi do promotorów (np. d = 10: 5% krytyków mniej, 5% promotorów więcej).
po_zmianie <- function(p, d) p + c(-d / 200, 0, d / 200)
n_na_grupe <- function(p, d) ceiling((qnorm(.975) + qnorm(.80))^2 * (war(p) + war(po_zmianie(p, d))) / (d / 100)^2)
siatkaB <- expand.grid(d = seq(3, 20, by = 0.5), profil = names(profile)[1:2])
siatkaB$n <- mapply(function(d, pr) n_na_grupe(profile[[pr]], d), siatkaB$d, as.character(siatkaB$profil))
subset(siatkaB, d %in% c(5, 10, 15))

# Sprawdzenie symulacją: 1000 par badań przy wyliczonym n (profil galerii), test z dla różnicy dwóch NPS
set.seed(624)
R <- 1000
spr <- t(sapply(c(5, 10), function(d) {
  p0 <- profile[[1]]; p1 <- po_zmianie(p0, d); n <- n_na_grupe(p0, d)
  istotne <- replicate(R, {
    a <- rmultinom(1, n, p0)[, 1] / n; b <- rmultinom(1, n, p1)[, 1] / n
    roz <- 100 * ((b[3] - b[1]) - (a[3] - a[1]))
    se <- 100 * sqrt(war(a) / n + war(b) / n)
    abs(roz / se) > qnorm(.975)
  })
  c(zmiana = d, n_na_grupe = n, moc_proc = 100 * mean(istotne), blad_MC = 100 * sqrt(mean(istotne) * (1 - mean(istotne)) / R))
}))
round(spr, 2)
# Najmniejsza zmiana wykrywalna z mocą 80% przy liczbie ankiet z jednego kwartału (galeria ok. 435, osiedle ok. 195)
mde <- function(p, n) uniroot(function(d) n_na_grupe(p, d) - n, c(1, 60))$root
round(c(galeria = mde(profile[[1]], 435), osiedle = mde(profile[[2]], 195)), 1)

kol_pr <- setNames(unname(kol[c("niebieski", "cynober", "szary")]), names(profile))
pA <- ggplot(siatkaA, aes(n, margines, colour = profil, linetype = profil)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = subset(siatkaA, n %in% c(100, 400, 1000)), size = 2.4, show.legend = FALSE) +
  geom_text(data = subset(siatkaA, n %in% c(100, 400, 1000) & profil == names(profile)[2]),
            aes(label = sprintf("±%.1f", margines)), hjust = -0.25, vjust = -0.7, size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = kol_pr, name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = NULL) +
  scale_y_continuous(limits = c(0, 30)) +
  labs(x = "Liczba ankiet n", y = "Margines błędu (± punkty NPS)", title = "A. Margines 95% przedziału NPS") +
  motyw + theme(legend.direction = "vertical")
pB <- ggplot(siatkaB, aes(d, n, colour = profil, linetype = profil)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = subset(siatkaB, d %in% c(5, 10)), size = 2.6, show.legend = FALSE) +
  geom_text(data = subset(siatkaB, d %in% c(5, 10) & profil == names(profile)[1]),
            aes(label = format(n, big.mark = " ")), hjust = 1.2, vjust = 1.3, size = 3.6, show.legend = FALSE) +
  geom_text(data = subset(siatkaB, d %in% c(5, 10) & profil == names(profile)[2]),
            aes(label = format(n, big.mark = " ")), hjust = -0.2, vjust = -0.5, size = 3.6, show.legend = FALSE) +
  scale_y_log10(breaks = c(100, 250, 500, 1000, 2500, 5000), labels = function(x) format(x, big.mark = " ")) +
  scale_colour_manual(values = kol_pr, guide = "none") +
  scale_linetype_manual(values = c("solid", "longdash"), guide = "none") +
  labs(x = "Zmiana NPS do wykrycia (punkty)", y = "Ankiet na kwartał (skala log)",
       title = "B. Ile ankiet na kwartał przy mocy 80%") + motyw
p4 <- pA + pB + plot_layout(widths = c(1, 1))
p4   # zapis: ggsave("nps-liczebnosc-proby.svg", p4, width = 10, height = 5.8)
Wynik w R
                galeria Q2 (NPS 35)                 osiedle Q2 (NPS 15)
                              0.607                               0.667
najgorszy przypadek: 50% / 0% / 50%
                              1.000
       n                              profil margines
6    100                 galeria Q2 (NPS 35)     15.3
16   200                 galeria Q2 (NPS 35)     10.8
36   400                 galeria Q2 (NPS 35)      7.6
96  1000                 galeria Q2 (NPS 35)      4.8
202  100                 osiedle Q2 (NPS 15)     16.0
212  200                 osiedle Q2 (NPS 15)     11.3
232  400                 osiedle Q2 (NPS 15)      8.0
292 1000                 osiedle Q2 (NPS 15)      5.1
398  100 najgorszy przypadek: 50% / 0% / 50%     19.6
408  200 najgorszy przypadek: 50% / 0% / 50%     13.9
428  400 najgorszy przypadek: 50% / 0% / 50%      9.8
488 1000 najgorszy przypadek: 50% / 0% / 50%      6.2
    d              profil    n
5   5 galeria Q2 (NPS 35) 3697
15 10 galeria Q2 (NPS 35)  891
25 15 galeria Q2 (NPS 35)  380
40  5 osiedle Q2 (NPS 15) 4137
50 10 osiedle Q2 (NPS 15) 1017
60 15 osiedle Q2 (NPS 15)  443
     zmiana n_na_grupe moc_proc blad_MC
[1,]      5       3697     79.8    1.27
[2,]     10        891     81.1    1.24
galeria osiedle
   14.1    22.2
6. Porównanie dwóch NPS: Rysunek 5
R
# Rysunek 5. Porównanie dwóch NPS: kwartał do kwartału i salon z salonem (przedział różnicy: wzór i bootstrap)
# Korzysta z obiektów przepisu 1: ankiety, wyniki, prawdziwy_nps, kol, motyw.
library(ggplot2)

pary <- list(c("galeria Q3", "galeria Q2"), c("osiedle Q3", "osiedle Q2"), c("osiedle Q3", "galeria Q3"))
liczby <- function(k) as.vector(table(ankiety$grupa[ankiety$komorka == k]))
set.seed(624)
B <- 2000
roznice <- do.call(rbind, lapply(pary, function(pr) {
  a <- wyniki[pr[1], ]; b <- wyniki[pr[2], ]
  d <- a[["NPS"]] - b[["NPS"]]; se <- sqrt(a[["SE"]]^2 + b[["SE"]]^2)   # próby niezależne: wariancje się sumują
  la <- liczby(pr[1]); lb <- liczby(pr[2])
  ma <- rmultinom(B, sum(la), la / sum(la)); mb <- rmultinom(B, sum(lb), lb / sum(lb))
  db <- 100 * ((ma[3, ] - ma[1, ]) / sum(la) - (mb[3, ] - mb[1, ]) / sum(lb))
  data.frame(porownanie = paste(pr[1], "−", pr[2]), roznica = d, SE = se, od = d - 1.96 * se, do = d + 1.96 * se,
             z = d / se, p = 2 * pnorm(-abs(d / se)), boot_od = quantile(db, .025), boot_do = quantile(db, .975),
             prawdziwa = prawdziwy_nps[[pr[1]]] - prawdziwy_nps[[pr[2]]], row.names = NULL)
}))
print(transform(roznice, roznica = round(roznica, 1), SE = round(SE, 2), od = round(od, 1), do = round(do, 1),
                z = round(z, 2), p = round(p, 4), boot_od = round(boot_od, 1), boot_do = round(boot_do, 1)), row.names = FALSE)

# Pułapka: „przedziały się nakładają, więc nie ma różnicy” – sprawdzamy, czy nakładają się przedziały pojedynczych NPS
nakladanie <- sapply(pary, function(pr) wyniki[pr[1], "od"] < wyniki[pr[2], "do"] & wyniki[pr[2], "od"] < wyniki[pr[1], "do"])
setNames(nakladanie, roznice$porownanie)

dl <- rbind(data.frame(porownanie = roznice$porownanie, metoda = "wzór", roznica = roznice$roznica, od = roznice$od, do = roznice$do),
            data.frame(porownanie = roznice$porownanie, metoda = "bootstrap", roznica = roznice$roznica,
                       od = roznice$boot_od, do = roznice$boot_do))
dl$porownanie <- factor(dl$porownanie, rev(roznice$porownanie))
roznice$porownanie_f <- factor(roznice$porownanie, levels(dl$porownanie))
roznice$etykieta <- gsub("-", "−", sprintf("%+.1f pkt [%.1f, %.1f]; p %s", roznice$roznica, roznice$od, roznice$do,
                                           ifelse(roznice$p < .001, "< .001", sub("0\\.", ".", sprintf("= %.3f", roznice$p)))))
p5 <- ggplot(dl, aes(roznica, porownanie, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0, colour = "grey30", linetype = "dashed") +
  geom_errorbar(aes(xmin = od, xmax = do), width = 0.2, orientation = "y", linewidth = 0.9,
                position = position_dodge(width = 0.45)) +
  geom_point(size = 3.2, position = position_dodge(width = 0.45)) +
  geom_point(data = roznice, aes(prawdziwa, porownanie_f), inherit.aes = FALSE, shape = 4, size = 3.6, stroke = 1.3,
             colour = "grey15") +
  geom_text(data = roznice, aes(roznica, porownanie_f, label = etykieta), inherit.aes = FALSE, nudge_y = 0.4,
            size = 3.7, colour = "grey15") +
  scale_colour_manual(values = c("wzór" = kol[["niebieski"]], "bootstrap" = kol[["pomarancz"]]), name = NULL) +
  scale_shape_manual(values = c("wzór" = 16, "bootstrap" = 17), name = NULL) +
  scale_x_continuous(limits = c(-26, 35), breaks = seq(-20, 30, 10)) +
  labs(x = "Różnica NPS (punkty) z 95% przedziałem; × – prawdziwa różnica w symulacji", y = NULL,
       title = "Czy NPS naprawdę się zmienił?", subtitle = "Linia przerywana: brak różnicy") + motyw
p5   # zapis: ggsave("nps-porownanie-dwoch-wynikow.svg", p5, width = 10, height = 5.2)
Wynik w R
              porownanie roznica   SE    od   do     z      p boot_od boot_do
 galeria Q3 − galeria Q2    -3.2 5.29 -13.5  7.2 -0.60 0.5483   -13.5     6.7
 osiedle Q3 − osiedle Q2    14.8 8.32  -1.6 31.1  1.77 0.0761    -1.4    30.3
 osiedle Q3 − galeria Q3    -9.7 6.70 -22.8  3.4 -1.45 0.1483   -22.2     3.5
 prawdziwa
        -5
         9
        -6
galeria Q3 − galeria Q2 osiedle Q3 − osiedle Q2 osiedle Q3 − galeria Q3
                   TRUE                    TRUE                    TRUE
7. Ten sam NPS i moc: Rysunek 6
R
# Rysunek 6. Ten sam NPS przy różnych rozkładach i moc: NPS czy średnia na skali 0–10?
# Korzysta z obiektów przepisu 1: rozklady, grupa_nps(), kol, kol_grup, motyw.
library(ggplot2)
library(patchwork)

# A. Trzy rozkłady ustalone ręcznie tak, by każdy dawał NPS = 20 (odsetki odpowiedzi 0–10)
trzy_rozklady <- rbind("spolaryzowany" = c(10, 6, 5, 4, 2, 2, 1, 10, 10, 15, 35),
                       "prawie sami pasywni" = c(0, 0, 0, 0, 0, 1, 4, 30, 40, 15, 10),
                       "krytycy tuż pod progiem" = c(0, 0, 0, 0, 0, 5, 15, 20, 20, 20, 20))
opis_rozkladu <- function(p, n = 200) {            # p w procentach; SE NPS dla n = 200 ankiet
  p <- p / 100; pK <- sum(p[1:7]); pP <- sum(p[10:11])
  c(promotorzy = 100 * pP, pasywni = 100 * (1 - pP - pK), krytycy = 100 * pK, NPS = 100 * (pP - pK), srednia = sum(0:10 * p), SD = sqrt(sum((0:10)^2 * p) - sum(0:10 * p)^2),
    SE_NPS_n200 = 100 * sqrt((pP + pK - (pP - pK)^2) / n))
}
round(t(apply(trzy_rozklady, 1, opis_rozkladu)), 2)

# B. Dwie poprawy obsługi i dwa sposoby ich wykrycia. Start: rozkład salonu na osiedlu w II kwartale.
# Poprawa 1: każdy klient z prawdopodobieństwem .35 ocenia salon o 1 punkt wyżej (najwyżej 10).
# Poprawa 2: najbardziej niezadowoleni (oceny 0–4) oceniają o 2 punkty wyżej – nadal są krytykami.
p0 <- rozklady["osiedle Q2", ] / 100
poprawy <- list("1. 35% klientów ocenia o 1 pkt wyżej" = function(x) pmin(x + rbinom(length(x), 1, .35), 10),
                "2. oceny 0–4 rosną o 2 pkt" = function(x) ifelse(x <= 4, x + 2, x))
nps <- function(x) 100 * (mean(x >= 9) - mean(x <= 6))
set.seed(624)
duza <- sample(0:10, 1e6, replace = TRUE, prob = p0)                  # prawdziwe zmiany z dużej próby
round(t(sapply(poprawy, function(f) { po <- f(duza)
  c(zmiana_NPS = nps(po) - nps(duza), zmiana_sredniej = mean(po) - mean(duza), d_Cohena = (mean(po) - mean(duza)) / sd(duza)) })), 3)

set.seed(624)
R <- 1000
se_nps <- function(x) 100 * sqrt((mean(x >= 9) + mean(x <= 6) - (mean(x >= 9) - mean(x <= 6))^2) / length(x))
moc <- do.call(rbind, lapply(names(poprawy), function(pw) do.call(rbind, lapply(c(100, 200, 400, 800), function(n) {
  wynik <- t(replicate(R, {
    a <- sample(0:10, n, replace = TRUE, prob = p0); b <- poprawy[[pw]](sample(0:10, n, replace = TRUE, prob = p0))
    z <- (nps(b) - nps(a)) / sqrt(se_nps(a)^2 + se_nps(b)^2)
    c(NPS = abs(z) > qnorm(.975), srednia = t.test(b, a)$p.value < .05)   # t.test: test Welcha
  }))
  data.frame(poprawa = pw, n = n, miara = c("NPS (test z)", "średnia 0–10 (test Welcha)"), moc = 100 * colMeans(wynik),
             blad_MC = 100 * sqrt(colMeans(wynik) * (1 - colMeans(wynik)) / R))
}))))
print(transform(moc, moc = round(moc, 1), blad_MC = round(blad_MC, 2)), row.names = FALSE)

dA <- do.call(rbind, lapply(rownames(trzy_rozklady), function(k)
  data.frame(rozklad = k, ocena = 0:10, proc = trzy_rozklady[k, ], grupa = grupa_nps(0:10))))
dA$rozklad <- factor(dA$rozklad, rownames(trzy_rozklady))
sr <- data.frame(rozklad = factor(rownames(trzy_rozklady), rownames(trzy_rozklady)),
                 t(apply(trzy_rozklady, 1, opis_rozkladu)))
pA <- ggplot(dA, aes(ocena, proc, fill = grupa)) +
  geom_col(width = 0.85) +
  geom_vline(data = sr, aes(xintercept = srednia), linetype = "dashed", colour = "grey20") +
  geom_text(data = sr, aes(x = -0.4, y = 41, label = sprintf("P %.0f%% · Pa %.0f%% · K %.0f%%\nNPS = %.0f · średnia = %.2f",
                                                       promotorzy, pasywni, krytycy, NPS, srednia)),
            inherit.aes = FALSE, hjust = 0, vjust = 1, size = 3.4, colour = "grey15", lineheight = 1.05) +
  facet_wrap(~rozklad, ncol = 3) +
  scale_fill_manual(values = kol_grup, name = NULL) +
  scale_x_continuous(breaks = 0:10) + scale_y_continuous(limits = c(0, 42)) +
  labs(x = "Odpowiedź (0–10); linia przerywana – średnia; P / Pa / K – promotorzy, pasywni, krytycy", y = "% odpowiedzi",
       title = "A. Trzy rozkłady, ten sam NPS = 20") + motyw +
  theme(panel.grid.major.x = element_blank(), axis.text.x = element_text(size = 8.5))
moc$wyzej <- ifelse(ave(moc$moc, moc$poprawa, moc$n, FUN = max) == moc$moc, -1.1, 2)   # etykieta wyższej linii nad punktem
pB <- ggplot(moc, aes(n, moc, colour = miara, shape = miara, linetype = miara)) +
  geom_hline(yintercept = 80, colour = "grey40", linetype = "dotted") +
  geom_line(linewidth = 1.1) + geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.0f%%", moc), vjust = wyzej), size = 3.4, show.legend = FALSE) +
  facet_wrap(~poprawa) +
  scale_x_log10(breaks = c(100, 200, 400, 800)) + scale_y_continuous(limits = c(0, 105)) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) + scale_linetype_manual(values = c("longdash", "solid"), name = NULL) +
  labs(x = "Ankiet na kwartał (skala log)", y = "Moc (% z 1000 badań)",
       title = "B. Ta sama poprawa obsługi: co ją wykryje?", subtitle = "Start: salon na osiedlu, II kwartał") + motyw
p6 <- pA / pB + plot_layout(heights = c(1, 1))
p6   # zapis: ggsave("nps-ten-sam-wynik-rozne-rozklady.svg", p6, width = 10, height = 8.6)
Wynik w R
                        promotorzy pasywni krytycy NPS srednia   SD SE_NPS_n200
spolaryzowany                   50      20      30  20    6.87 3.61        6.16
prawie sami pasywni             25      70       5  20    7.94 1.05        3.61
krytycy tuż pod progiem         40      40      20  20    7.95 1.50        5.29
                                     zmiana_NPS zmiana_sredniej d_Cohena
1. 35% klientów ocenia o 1 pkt wyżej       9.48           0.269    0.108
2. oceny 0–4 rosną o 2 pkt                 0.00           0.240    0.096
                              poprawa   n                      miara  moc
 1. 35% klientów ocenia o 1 pkt wyżej 100               NPS (test z) 14.6
 1. 35% klientów ocenia o 1 pkt wyżej 100 średnia 0–10 (test Welcha) 12.8
 1. 35% klientów ocenia o 1 pkt wyżej 200               NPS (test z) 20.8
 1. 35% klientów ocenia o 1 pkt wyżej 200 średnia 0–10 (test Welcha) 17.4
 1. 35% klientów ocenia o 1 pkt wyżej 400               NPS (test z) 39.2
 1. 35% klientów ocenia o 1 pkt wyżej 400 średnia 0–10 (test Welcha) 34.5
 1. 35% klientów ocenia o 1 pkt wyżej 800               NPS (test z) 66.5
 1. 35% klientów ocenia o 1 pkt wyżej 800 średnia 0–10 (test Welcha) 60.9
           2. oceny 0–4 rosną o 2 pkt 100               NPS (test z)  5.9
           2. oceny 0–4 rosną o 2 pkt 100 średnia 0–10 (test Welcha) 12.6
           2. oceny 0–4 rosną o 2 pkt 200               NPS (test z)  4.8
           2. oceny 0–4 rosną o 2 pkt 200 średnia 0–10 (test Welcha) 15.9
           2. oceny 0–4 rosną o 2 pkt 400               NPS (test z)  5.5
           2. oceny 0–4 rosną o 2 pkt 400 średnia 0–10 (test Welcha) 33.3
           2. oceny 0–4 rosną o 2 pkt 800               NPS (test z)  4.8
           2. oceny 0–4 rosną o 2 pkt 800 średnia 0–10 (test Welcha) 54.7
 blad_MC
    1.12
    1.06
    1.28
    1.20
    1.54
    1.50
    1.49
    1.54
    0.75
    1.05
    0.68
    1.16
    0.72
    1.49
    0.68
    1.57
8. Czy kolory są czytelne przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (krytycy / promotorzy)" = c("#D55E00", "#0072B2"),
             "cynober – szary (krytycy / pasywni)" = c("#D55E00", "#999999"),
             "niebieski – szary (promotorzy / pasywni)" = c("#0072B2", "#999999"),
             "niebieski – pomarańczowy (wzór / bootstrap)" = c("#0072B2", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                            widzenie_typowe deuteranopia
cynober – niebieski (krytycy / promotorzy)            114.6        108.3
cynober – szary (krytycy / pasywni)                    77.2         62.9
niebieski – szary (promotorzy / pasywni)               44.9         48.9
niebieski – pomarańczowy (wzór / bootstrap)           120.2        121.5
czerwony – zielony (do unikania)                      121.7         21.1
                                            protanopia
cynober – niebieski (krytycy / promotorzy)        91.9
cynober – szary (krytycy / pasywni)               56.0
niebieski – szary (promotorzy / pasywni)          40.6
niebieski – pomarańczowy (wzór / bootstrap)      109.3
czerwony – zielony (do unikania)                  31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, rozkład wielomianowy, test Welcha i rozkład normalny – pakiety base i stats). Rysunki wykonano w ggplot2, panele połączono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- NPS bez przedziału – przy 180 ankietach przedział ma 24 punkty szerokości.
- Zmiana bez przedziału różnicy – różnica dwóch NPS ma błąd większy niż każdy z nich.
- Cele kwartalne niemożliwe do sprawdzenia – zmiana o 5 punktów wymaga tysięcy ankiet na okres.
- Sam NPS bez rozkładu i średniej – ten sam wynik daje bardzo różne rozkłady, a poprawa poniżej progu jest dla NPS niewidoczna.
- NPS jako prognoza wzrostu firmy – na danych firm średnia satysfakcja przewidywała przyszłe wyniki, a miary oparte na intencji polecenia prawie wcale (Morgan i Rego, 2006). Sama intencja polecenia nie wystarczała też do przewidywania lojalności klientów (Keiningham i in., 2007), a w trzech branżach NPS nie zapowiadał wzrostu przychodów (Dawes, 2024).
- Porównania z innymi firmami – inny sposób zbierania ankiet (SMS zaraz po wizycie vs e-mail po miesiącu) zmienia rozkład bardziej niż jakość obsługi.
Pomoc przy analizie ankiety klientów: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak policzyć przedział ufności NPS – wzorem czy bootstrapem?
Zakoduj odpowiedzi 9–10 jako +1, 7–8 jako 0, a 0–6 jako −1. NPS to średnia tych kodów razy 100, a SE = 100 × √{[pP + pK − (pP − pK)²] / n}; 95% CI = NPS ± 1.96 × SE. Dla 450 ankiet z NPS 34.4 daje to [27.3, 41.6]. Bootstrap percentylowy dał niemal ten sam przedział.
Ile ankiet potrzeba, żeby wykryć zmianę NPS?
Przy mocy 80% i α = .05 w przykładzie zmiana o 10 punktów wymagała 891 ankiet na każdy okres, a o 5 punktów – 3697. Dokładna liczba zależy od rozkładu odpowiedzi, ale rząd wielkości jest podobny: kilkaset ankiet pozwala zauważyć dopiero zmiany o kilkanaście punktów.
Jak sprawdzić, czy NPS istotnie się zmienił?
Policz różnicę dwóch NPS i jej błąd standardowy √(SE1² + SE2²), gdy próby są niezależne. Przedział to różnica ± 1.96 × SE, a iloraz różnicy i SE daje test z. W przykładzie wzrost o 14.8 punktu miał 95% CI [−1.6, 31.1], p = .076 – nie był istotny.
Czy lepiej raportować NPS czy średnią ocen 0–10?
Najlepiej oba, z rozkładem odpowiedzi. NPS reaguje tylko na przejścia przez progi 6/7 i 8/9. W symulacji poprawa ocen najbardziej niezadowolonych klientów (z 0–4 na 2–6) nie zmieniła NPS, a średnia wykryła ją w 54.7% badań po 800 ankiet. Na danych firm średnia satysfakcja lepiej przewidywała przyszłe wyniki niż miary oparte na poleceniach (Morgan i Rego, 2006).
Czy przedział bootstrapowy dla NPS jest lepszy od wzoru?
Przy kilkuset ankietach oba dają prawie to samo. Przy kilkudziesięciu oba są nieco za wąskie: w symulacji obejmowały prawdziwy NPS w 92–94% badań zamiast 95%. W porównaniu metod najlepiej wypadły odmiany skorygowanego przedziału Walda i przedział score (Rocks, 2016).
Powiązane hasła
Przeczytaj też
Statystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikBadanie trackingowe marki
Osiem fal badania marki: odsetki z wagami i deff, różnica fala do fali, trend, średnia krocząca i fałszywe alarmy przy wielu wskaźnikach – z kodem R.
Czytaj →PoradnikKluczowe czynniki satysfakcji
Ankieta gości hotelu: korelacje, β przy współliniowości, wagi względne i dominacja, macierz ważność–ocena i bootstrap rankingu z kodem R.
Czytaj →PoradnikCSAT, CES czy NPS – który przewiduje odejście
8000 kontaktów z obsługą światłowodu: krzywe ROC, test DeLonga, kalibracja i przyrost AUC trzech wskaźników – z kodem R.
Czytaj →Analizujesz NPS w pracy z marketingu?
Pomożemy policzyć NPS z przedziałami, porównać okresy i grupy, zaplanować liczbę ankiet i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dawes, J. G. (2024). Net Promoter and revenue growth: An examination across three industries. Australasian Marketing Journal, 32(1), 4–18. https://doi.org/10.1177/14413582221132039
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Keiningham, T. L., Cooil, B., Aksoy, L., Andreassen, T. W., & Weiner, J. (2007). The value of different customer satisfaction and loyalty metrics in predicting customer retention, recommendation, and share-of-wallet. Managing Service Quality: An International Journal, 17(4), 361–384. https://doi.org/10.1108/09604520710760526
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- Morgan, N. A., & Rego, L. L. (2006). The value of different customer satisfaction and loyalty metrics in predicting business performance. Marketing Science, 25(5), 426–439. https://doi.org/10.1287/mksc.1050.0180
- Reichheld, F. F. (2003). The one number you need to grow. Harvard Business Review, 81(12), 46–54. https://pubmed.ncbi.nlm.nih.gov/14712543/
- Rocks, B. (2016). Interval estimation for the “net promoter score”. The American Statistician, 70(4), 365–372. https://doi.org/10.1080/00031305.2016.1158124 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{dawes2024net, author={Dawes, John G.}, title={{Net Promoter and revenue growth: An examination across three industries}}, journal={Australasian Marketing Journal}, year={2024}, volume={32}, number={1}, pages={4--18}, doi={10.1177/14413582221132039}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{keiningham2007value, author={Keiningham, Timothy L. and Cooil, Bruce and Aksoy, Lerzan and Andreassen, Tor W. and Weiner, Jay}, title={{The value of different customer satisfaction and loyalty metrics in predicting customer retention, recommendation, and share-of-wallet}}, journal={Managing Service Quality: An International Journal}, year={2007}, volume={17}, number={4}, pages={361--384}, doi={10.1108/09604520710760526}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{morgan2006value, author={Morgan, Neil A. and Rego, Lopo Leotte}, title={{The value of different customer satisfaction and loyalty metrics in predicting business performance}}, journal={Marketing Science}, year={2006}, volume={25}, number={5}, pages={426--439}, doi={10.1287/mksc.1050.0180}}@article{reichheld2003one, author={Reichheld, Frederick F.}, title={{The one number you need to grow}}, journal={Harvard Business Review}, year={2003}, volume={81}, number={12}, pages={46--54}, url={https://pubmed.ncbi.nlm.nih.gov/14712543/}}@article{rocks2016interval, author={Rocks, Brendan}, title={{Interval estimation for the “net promoter score”}}, journal={The American Statistician}, year={2016}, volume={70}, number={4}, pages={365--372}, doi={10.1080/00031305.2016.1158124}}